يَعِد مدرِّب الترتيب الجماعي بشيء واحد: كلمات مفتاحية كثيرة في تقرير واحد. وما يحتويه التقرير يتحدد تقريباً بالكامل بإعداد لا يغيّره معظم الناس أبداً، وهو مدى العمق الذي يذهب إليه الفحص.
شغّلنا الكلمات الخمسين نفسها مرتين متتاليتين في 12 سبتمبر 2026، على محرك البحث نفسه والموقع نفسه والجهاز نفسه. كان الفرق الوحيد هو العمق.
عند العمق 10 وجد الفحص نطاقنا في كلمة واحدة من الخمسين. وعند العمق 100 وجده في 22 منها.
الكلمات نفسها. الساعة نفسها. الواجهة نفسها. هذا الفرق ليس دقة، لأن كلا التشغيلين كان دقيقاً. إنه مجال الرؤية، وهو يغيّر الرقم الرئيسي بمعامل 22.
ما الذي شغّلناه
خمسون كلمة مفتاحية مسحوبة من قائمة استعلامات Search Console الخاصة بنا، ومُرشَّحة إلى استعلامات بالحروف اللاتينية حتى تطابق مجموعة النتائج الأمريكية بالإنجليزية. استخدم كلا التشغيلين طلبات Google العضوية الحيّة بدقة سطح المكتب، وثمانية عمال متزامنين، ومهلة 300 ثانية لكل طلب.
الإعداد | التشغيل A | التشغيل B |
|---|---|---|
الكلمات المفتاحية | 50 | 50 |
العمق المطلوب | 10 | 100 |
الموقع واللغة | الولايات المتحدة، الإنجليزية | الولايات المتحدة، الإنجليزية |
الجهاز | سطح المكتب | سطح المكتب |
التزامن | 8 | 8 |
سجّلنا زمن الاستجابة لكل طلب، والتكلفة المفوترة، وعدد النتائج العضوية، وما إذا ظهر نطاقنا.
النتيجة 1: الكلمات نفسها، إجابتان مختلفتان
المقياس | العمق 10 | العمق 100 |
|---|---|---|
الكلمات المفحوصة | 50 | 50 |
الطلبات التي أعادت نتيجة قابلة للاستخدام | 50 | 43 |
الطلبات التي فشلت | 0 | 7 |
الكلمات التي ظهر فيها نطاقنا | 1 | 22 |
داخل أفضل 3 | 1 | 1 |
داخل أفضل 20 | 1 | 1 |
داخل أفضل 100 | 1 | 20 |
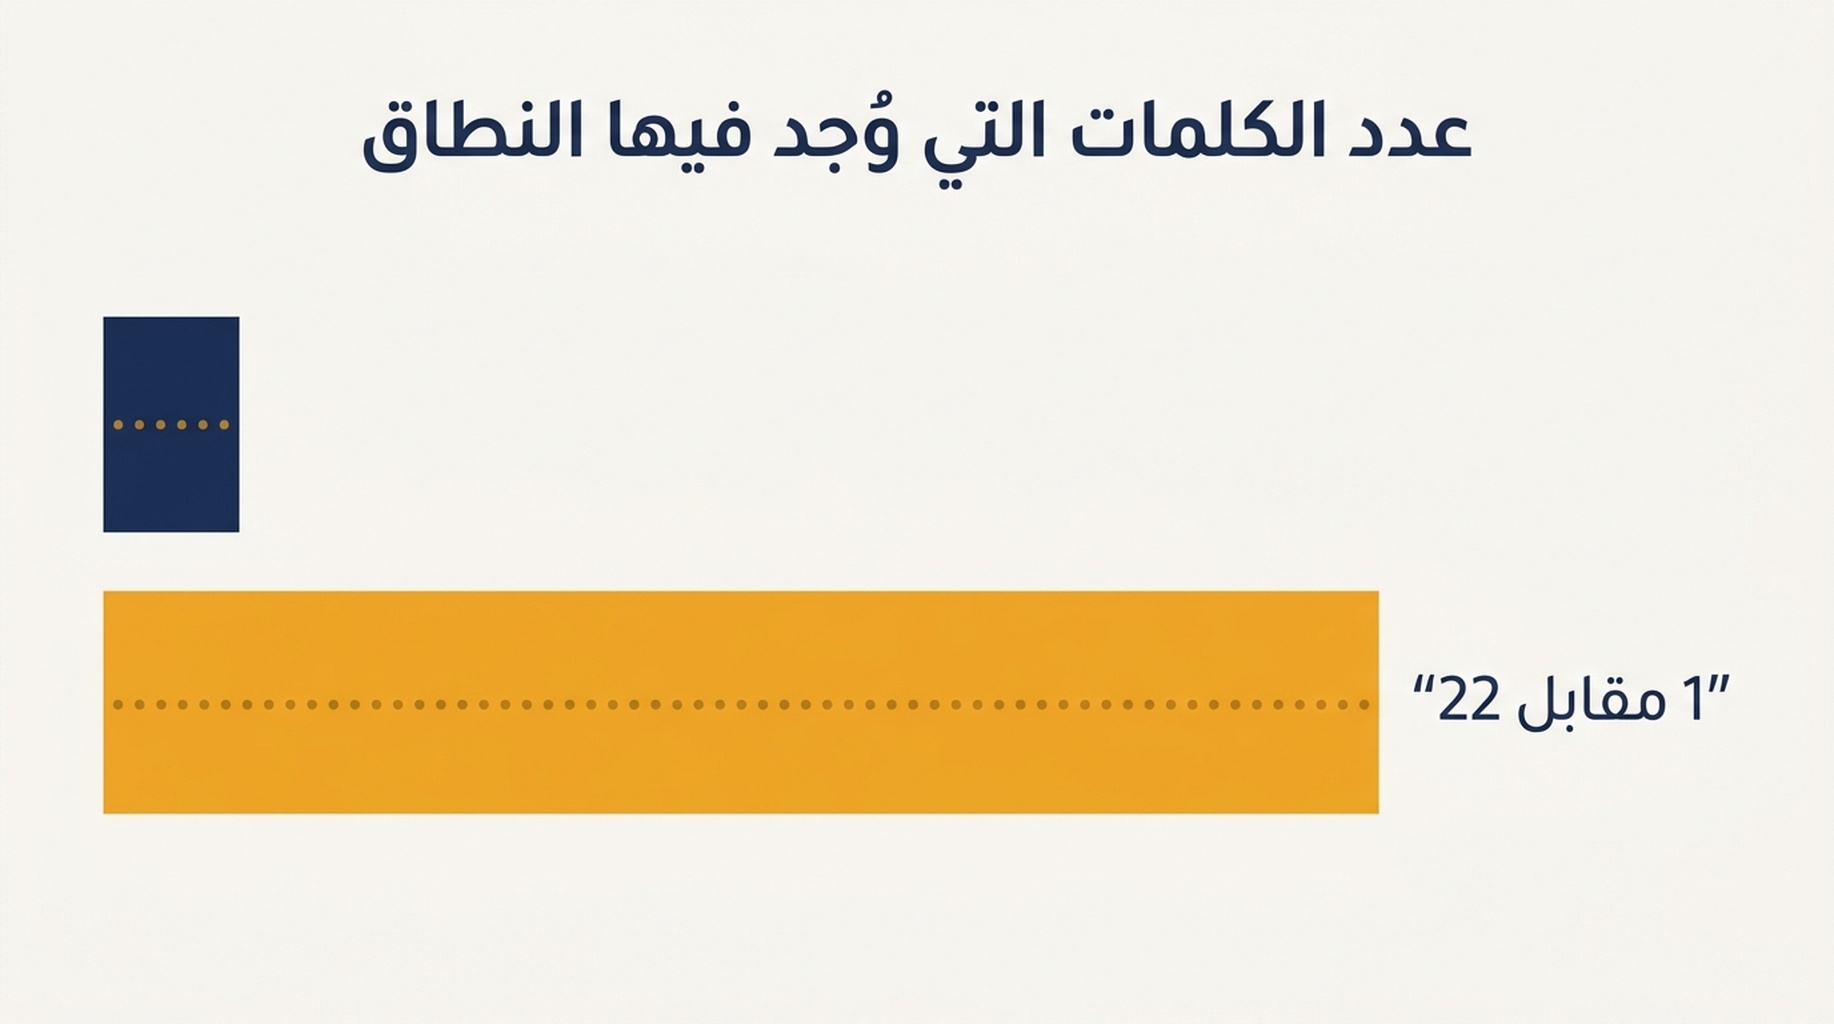
لم تتغيّر مجموعة الكلمات بين التشغيلين. الإعداد الوحيد الذي تغيّر هو العمق.
اقرأ هذا بتمعّن، لأن شكله هو الدرس كله. عند العمق 10 بدا ظهورنا في هذه المجموعة بنسبة 2 بالمئة. وعند العمق 100 بدا بنسبة 44 بالمئة. لا أحد الرقمين خاطئ، وواحد فقط منهما مفيد.
لم تتحرك صورة أعلى الصفحة إلا قليلاً. بقيت كلمة واحدة داخل أفضل 10 في كلا التشغيلين. وكل ما أضافه الفحص الأعمق كان بين الموضع 20 والموضع 100، وهو بالضبط النطاق الذي يخفيه مدرّب الترتيب الجماعي الافتراضي. إذا كانت خطتك مبنية على مدرّب ترتيب مضبوط على الصفحة الأولى، فخط الأساس عندك ليس قياساً لظهورك، بل قياس لظهورك داخل الصفحة الأولى، وعلى مجموعة الكلمات هذه يفترقان بمقدار 21 كلمة.
تفصيل صغير إضافي: اثنتان من الكلمات الـ22 التي وُجدت في التشغيل العميق كانتا خارج الموضع المطلق 100. تُعيد الواجهة قليلاً بعد العمق المطلوب، لذا قد يحتوي تقرير "أفضل 100" على مواضع تتجاوز 100. اعزلها إذا كانت التسمية تهمّك.
النتيجة 2: التكلفة تنمو مع العمق بنسبة سبعة إلى واحد تقريباً
المقياس | العمق 10 | العمق 100 |
|---|---|---|
إجمالي التكلفة المفوترة | $0.1000 | $0.6230 |
التكلفة لكل كلمة | $0.0020 | $0.0125 |
النتائج العضوية المُعادة لكل كلمة | نحو 12 | نحو 97 |
كلّف تشغيل العمق 100 ستة أضعاف تشغيل العمق 10 ونصف للكلمات الخمسين نفسها، واشترى الفرق الكلمات الـ21 الإضافية التي ظهر فيها نطاقنا.
هذه النسبة هي الجواب الصادق على أكثر سؤال يُطرح عن المدقّق الجماعي: هل يستحق الأمر أن تدفع مقابل نتائج أكثر. يستحق ذلك إذا كنت مرتّباً بعد الصفحة الأولى. أما إذا كانت كلماتك داخل أفضل 10، فالتشغيل الأعمق يعيد في معظمه صفوفاً لن تقرأها أبداً.
هناك إعداد وسط، وهو عادةً الإعداد الصحيح. يكلّف العمق 20 مبلغ $0.0035 لكل كلمة في تسعيرنا السابق، أي أكثر بـ75 بالمئة من العمق 10، لكنه خصم بنسبة 75 بالمئة مقابل العمق 100. وموقع في النطاق بين الموضع 20 والموضع 50 يلتقط العمق 20 عنده معظم الحركة المفيدة بجزء يسير من التكلفة.
كانت التكلفة المفوترة أقل أيضاً من السعر لكل كلمة المتوقع، لأن الطلبات السبعة الفاشلة لم تُحاسَب. هذه هي نسبة الفشل تظهر في الفاتورة، وسنصل إليها قريباً.
النتيجة 3: التقرير يخفي أيضاً ما إذا كان AI Overview موجوداً
العمق ليس الشيء الوحيد الذي يحذفه تقرير المواضع فقط.
سجّلنا أنواع عناصر SERP في كل طلب في التشغيلين. في تشغيل العمق 10 أعادت 48 استعلاماً من أصل 50 مقتطف AI Overview. وفي تشغيل العمق 100 فعل ذلك 42 من 43 طلباً ناجحاً.
التشغيل | الاستعلامات التي فيها AI Overview | الاستعلامات المفحوصة |
|---|---|---|
العمق 10 | 48 | 50 |
العمق 100 | 42 | 43 طلباً ناجحاً |
سيبدو هذا الرقم خاطئاً لكل من قرأ لقطتنا السابقة التي وجدت مقتطفات AI Overview في 4 من 40 استعلاماً في موضوع SEO. كلاهما صحيح، والفرق في مجموعة الاستعلامات لا في الطريقة.
مجموعة الـ40 استعلاماً كانت قائمة في موضوع SEO: أدوات الترتيب، والتدقيق، وتحديثات الخوارزمية، و15 استعلاماً تسمّي أداة أو واجهة. أما مجموعة الـ50 هذه فجاءت من قائمة استعلامات Search Console الخاصة بنا، التي تغلب عليها صياغات المنفعة والمقارنة طويلة الذيل. الاستعلامات التي يحصل الموقع فعلاً على ظهور فيها تختلف في الشكل عن الاستعلامات التي يكتبها فريق SEO، ووجود AI Overview يتبع هذا الشكل.
النقطة العملية للفحص الجماعي أضيق وأكثر إزعاجاً. مدرّب الترتيب الجماعي يعيد مواضع. ولا يعيد العنصر الذي يجلس الآن فوق الموضع 1، وفي مجموعة الاستعلامات التي نملكها فعلاً كان ذلك العنصر موجوداً في 96 بالمئة منها.
النتيجة 4: الوقت هو زمن الاستجابة مقسوماً على التزامن
الفحص الجماعي ليس لحظياً، والسبب هو زمن استجابة الطلب لا أي معالجة تتحكم بها.
المقياس | العمق 10 | العمق 100 |
|---|---|---|
الزمن الفعلي عند 8 عمال | 62.0 ثانية | 135.9 ثانية |
أسرع طلب | 2.6 ثانية | 8.1 ثانية |
الطلب الوسيط | 8.3 ثانية | 19.2 ثانية |
أبطأ طلب | 22.0 ثانية | 40.3 ثانية |
مجموع أزمنة كل الطلبات | 451 ثانية | 998 ثانية |
يخرج من هذا أمران.
تضاعف وسيط زمن الاستجابة أكثر من مرتين مع العمق، من 8.3 إلى 19.2 ثانية. البحث الأعمق يستغرق فعلاً وقتاً أطول في التجميع، ولهذا يفشل مدرّب الترتيب الجماعي ذو المهلة القصيرة في التشغيلات العميقة لا في الضحلة.
الزمن الفعلي يحدده التزامن لا سرعة الواجهة. شغّل الكلمات الخمسين واحدة تلو الأخرى فيستغرق فحص العمق 10 نحو 7.5 دقائق؛ وعند ثمانية عمال يستغرق دقيقة واحدة. إذا لم يكن في مدرّب الترتيب الجماعي تحكم في التزامن، فذلك هو الإعداد الوحيد الجدير بالسؤال، لأنه يساوي معامل ثمانية في الزمن المنقضي دون أي فرق في التكلفة.
النتيجة 5: التشغيل الأعمق فشل بنسبة 14 بالمئة
فشلت سبعة من طلبات العمق 100 الخمسين. ولم يفشل أي طلب من طلبات العمق 10.
التشغيل | الإخفاقات | نسبة الفشل |
|---|---|---|
العمق 10 | 0 من 50 | 0 بالمئة |
العمق 100 | 7 من 50 | 14 بالمئة |
ولأن الطلبات الفاشلة لم تُحاسَب، كلّف تشغيل العمق 100 أيضاً أقل من الـ$0.70 الذي توقعه سعر الكلمة، ولهذا جاءت التكلفة الفعلية لكل كلمة عند $0.0125 لا $0.014.
هذا هو الجزء من الفحص الجماعي الذي نادراً ما تعرضه التقارير. الأداة التي تعيد المحاولة بصمت ستغطيه. والأداة التي لا تفعل ذلك ستُبلّغ عن ترتيبك بأقل من الحقيقة بهدوء، وتتجمّع الإخفاقات في أبطأ الطلبات، وهي الطلبات العميقة التي دفعت مقابلها أكثر.
كانت رسالة الخطأ متطابقة في الطلبات السبعة: اكتملت المهمة بنتائج جزئية، ولم يمكن جلب بعض الصفحات بعد محاولات إعادة عدة، والصفحات التي لم تُعد لم تُحاسَب. هذا هو السلوك الصحيح من مزوّد، وهو أيضاً سبب إبلاغ الفحص الجماعي بأقل من الحقيقة بدل أن ينهار. الصفحة الفاشلة ليست كلمة لا تحتل فيها مرتبة. إنها مجهول، والتقرير الذي يرسمها خلية فارغة قد حوّل المجهول إلى نفي بهدوء.
إذا بنيت حلقتك الخاصة، فسجّل الإخفاقات كنتيجة من الدرجة الأولى بدل إسقاطها، وأعد محاولة الإخفاقات مرة واحدة قبل إصدار التقرير.
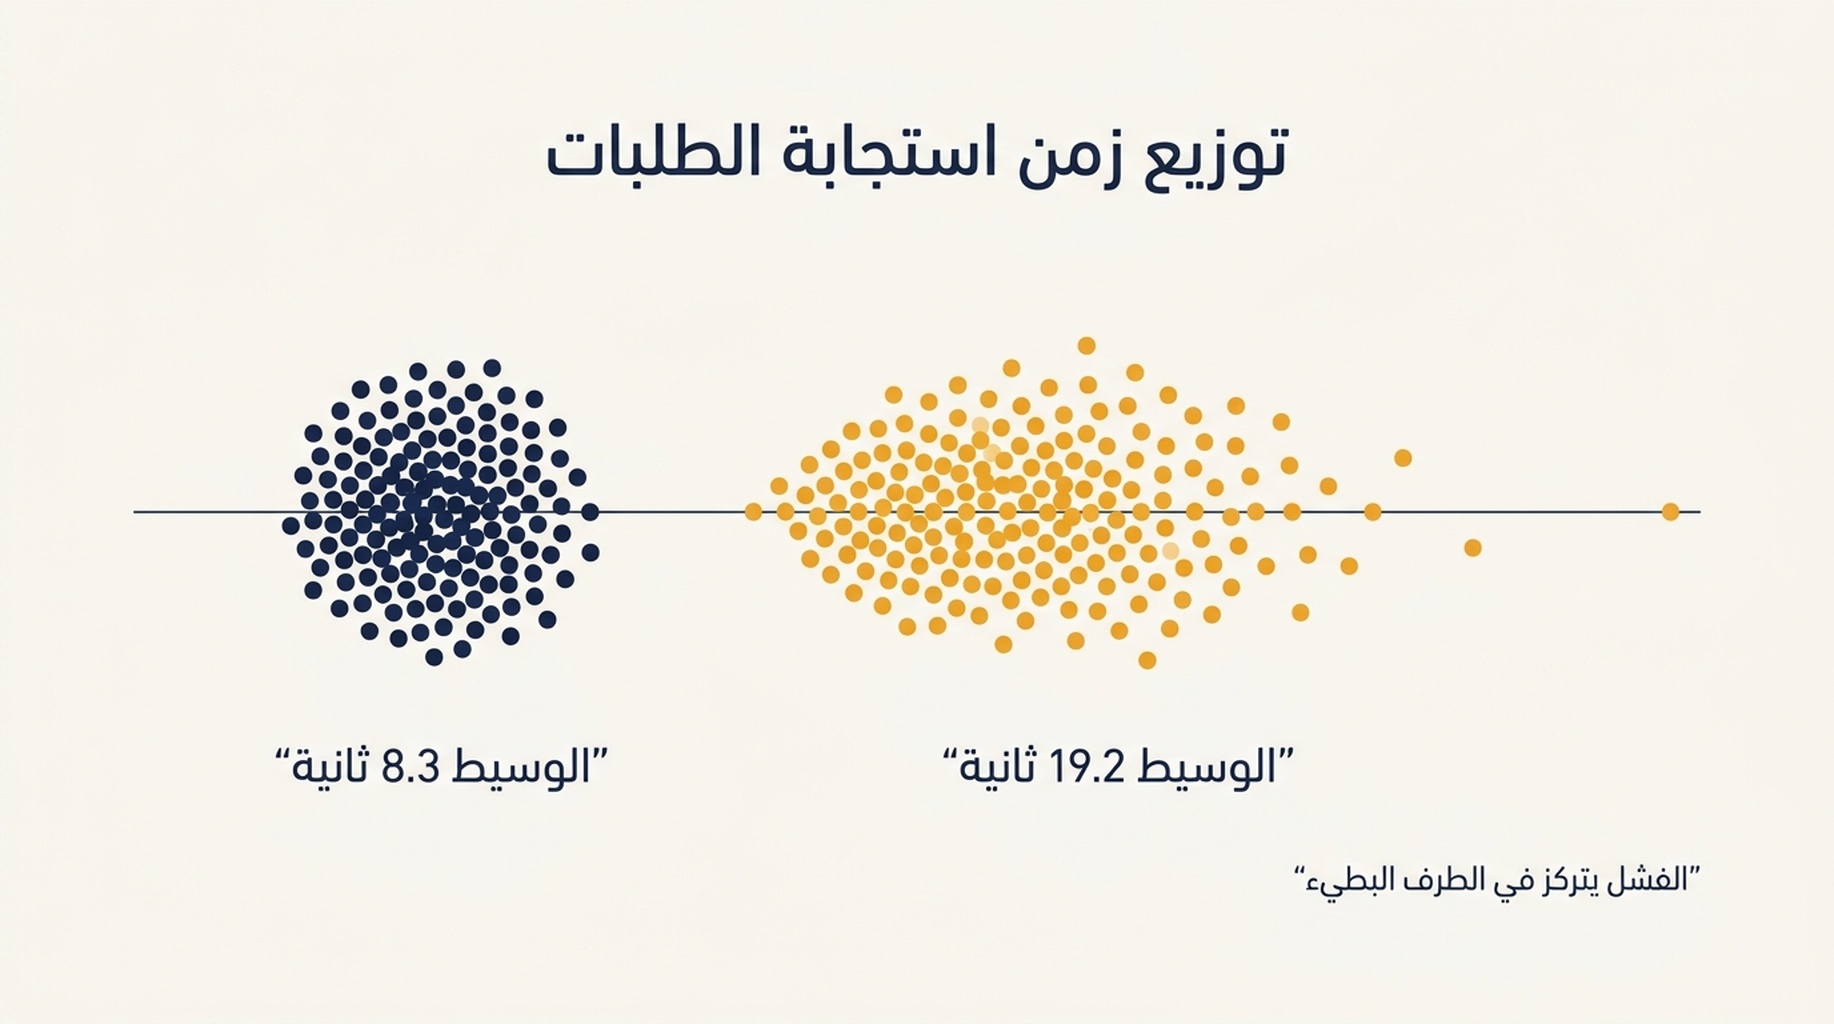
الطلبات الأعمق تستغرق وقتاً أطول، وتتجمّع الإخفاقات عند الطرف البطيء من التوزيع.
ما يعنيه هذا للرقم على لوحة تحكمك
أنتجت الكلمات الخمسون نفسها رقمين قابلين للدفاع عنهما للظهور، 2 بالمئة و44 بالمئة، ولم يفصلهما سوى إعداد عمق. وهذا تذبذب أكبر من معظم تغيّرات الترتيب التي ستنفق ربعاً كاملاً في تفسيرها.
تتبع من ذلك ثلاث قواعد.
اضبط العمق من موضعك في الترتيب لا من القيمة الافتراضية للأداة. اسحب توزيع مواضعك أولاً. إذا كانت معظم كلماتك بين الموضع 20 والموضع 60، فلن يُبلّغ العمق 10 عن شيء تقريباً وستستنتج أن لديك مشكلة ظهور لا تملكها.
أبلغ عن العمق إلى جانب الرقم. تقرير ترتيب بلا إعداد عمق غير قابل لإعادة الإنتاج. وكذلك الموقع واللغة والجهاز.
تعامل مع "غير موجود" كبيانات لا كخطأ. ثماني وعشرون من الكلمات الخمسين لم تُعد نتيجة لنطاقنا عند العمق 100، وهذا هو الجواب الصادق. أما المدقّق الذي يخفي هذه الصفوف فهو يقصّر قائمة كلماتك في أقل اتجاه مفيد.
تحقّق مما إذا كان التقرير يتضمن ميزات SERP أصلاً. في مجموعة الكلمات هذه كان AI Overview موجوداً في 96 بالمئة من الاستعلامات. ولا يمكن لتصدير المواضع فقط أن يُظهر ذلك، ولن يضيفه أي إعداد عمق.
إذا كان الهدف رقماً يمكن الدفاع عنه مع الوقت، فسؤال العمق يقع تحت سؤال التقارير. تغطي ملاحظاتنا حول إلى أي مدى يقدّم Google النتائج فعلاً أين يقع السقف، ويغطي تشغيل مصدر أول طرف ومصدر حيّ معاً الإعداد الذي يبقيك صادقاً في شأنه، ويغطي ما يمكن أن يخبرك به Search Console ولا تستطيع فحصاً حياً معرفته النصف الذي لم يلمسه هذا التشغيل إطلاقاً.
الحدود
حدّان يستحقان الذكر.
خمسون كلمة من ممتلكة واحدة عيّنة صغيرة، وانقسام 2 بالمئة مقابل 44 بالمئة خاص بموقع تقع كلماته في مواضع عميقة. أما ممتلكة تحتل أفضل 10 في معظم قائمتها فلن ترى تقريباً أي فرق بين التشغيلين، وستكون تدفع أكثر من اللازم مقابل العمق.
زمن الاستجابة يعتمد على المزوّد والموقع واللحظة. الثواني المطلقة هنا لن تنتقل، لكن النسبة بين العمقين يجب أن تصمد تقريباً، لأن الفرق عمل حقيقي لا تذبذب شبكة.
الأسئلة الشائعة
أي عمق ينبغي أن يستخدم مدرّب الترتيب الجماعي؟ اضبطه من توزيع مواضعك. العمق 10 يكفي إذا كنت مرتّباً في أفضل 10. ويغطي العمق 20 معظم النطاق العملي بمبلغ $0.0035 لكل كلمة. أما العمق 100 فيكلّف $0.014 ولا يستحق إلا إذا كنت تتتبع مواضع بعد 50 فعلاً.
كم يستغرق فحص 50 كلمة؟ نحو دقيقة عند ثمانية عمال متزامنين لفحص ضحل، ونحو 2.3 دقيقة لفحص عميق. وبالتشغيل التسلسلي يستغرق الفحصان نفسهما 7.5 و16.6 دقيقة، لذا يساوي التزامن معامل ثمانية في الزمن المنقضي.
لماذا فشل الفحص الأعمق أكثر؟ الطلبات الأعمق تستغرق وقتاً أطول في التجميع، بوسيط 19.2 ثانية مقابل 8.3 للتشغيل الضحل، لذا ترتفع احتمالات اصطدامها بمهلة عميل أو مزوّد. سجّل الإخفاقات وأعد محاولتها بدل إسقاطها.
هل مدرّب الترتيب الجماعي دقيق إذا قال إن كلمتي غير موجودة؟ نعم عادةً. في تشغيلنا لم يكن لـ28 من 50 كلمة أي نتيجة لنطاقنا داخل 100 موضع. تحقّق من إعداد العمق قبل أن تتعامل مع صف ناقص كمشكلة بيانات.
هل فحص كلمات أكثر يكلّف أكثر من الفحص الأعمق؟ العمق يحرّك الفاتورة لكل كلمة، لكن الكلمات تضاعف الإجمالي. الانتقال من 50 إلى 500 كلمة عند العمق 10 يكلّف عشرة أضعاف ويستغرق عشرة أضعاف، بينما يكلّف العمق 100 سبعة أضعاف لكل كلمة. سعّر العمق الذي تحتاجه، ثم اشترِ عدد الكلمات الذي تستطيع مراجعته.
رأي Auspia: قبل أن تغيّر صفحة واحدة، تحقّق من إعداد العمق في مدرّب الترتيب الجماعي لديك. إنه أرخص تفسير لرقم ظهور مفاجئ، وقد شكّل في اختبارنا فارقاً بمعامل 22 بين تشغيلين يفصلهما دقائق. اضبط العمق من توزيع المواضع، وسجّل الإخفاقات، وأبقِ الإعداد في التقرير ليكون رقم الربع القادم قابلاً للمقارنة.
الكاتب/ة: بينيت هايز، محلل GEO تطبيقي يغطي أكثر من 400 مراجعة تنفيذ في Auspia. كتابة عن تنفيذ البحث العملي، والقياس، والتفاصيل التي تغيّر تقريراً.