Con cosa finirai
Una mappa delle citazioni è un registro delle pagine che un motore di IA ha davvero pescato quando ha risposto alle domande dei tuoi acquirenti. Non se il tuo brand è comparso nella risposta. Ma da quali fonti quella risposta è stata assemblata.
Ho fatto girare questa cosa in abbastanza categorie da sapere che il primo risultato di solito è imbarazzante. I team danno per scontato che sia il proprio sito a sostenere quelle risposte. Spesso non lo è. In una categoria B2B, le pagine del fornitore stesso valevano una frazione minima, mentre un sito di recensioni che nessuno aveva reclamato faceva la maggior parte del lavoro.
È questo il punto di farlo. Smettere di tirare a indovinare e iniziare a guardare le pagine reali.
Alla fine di questo percorso avrai:
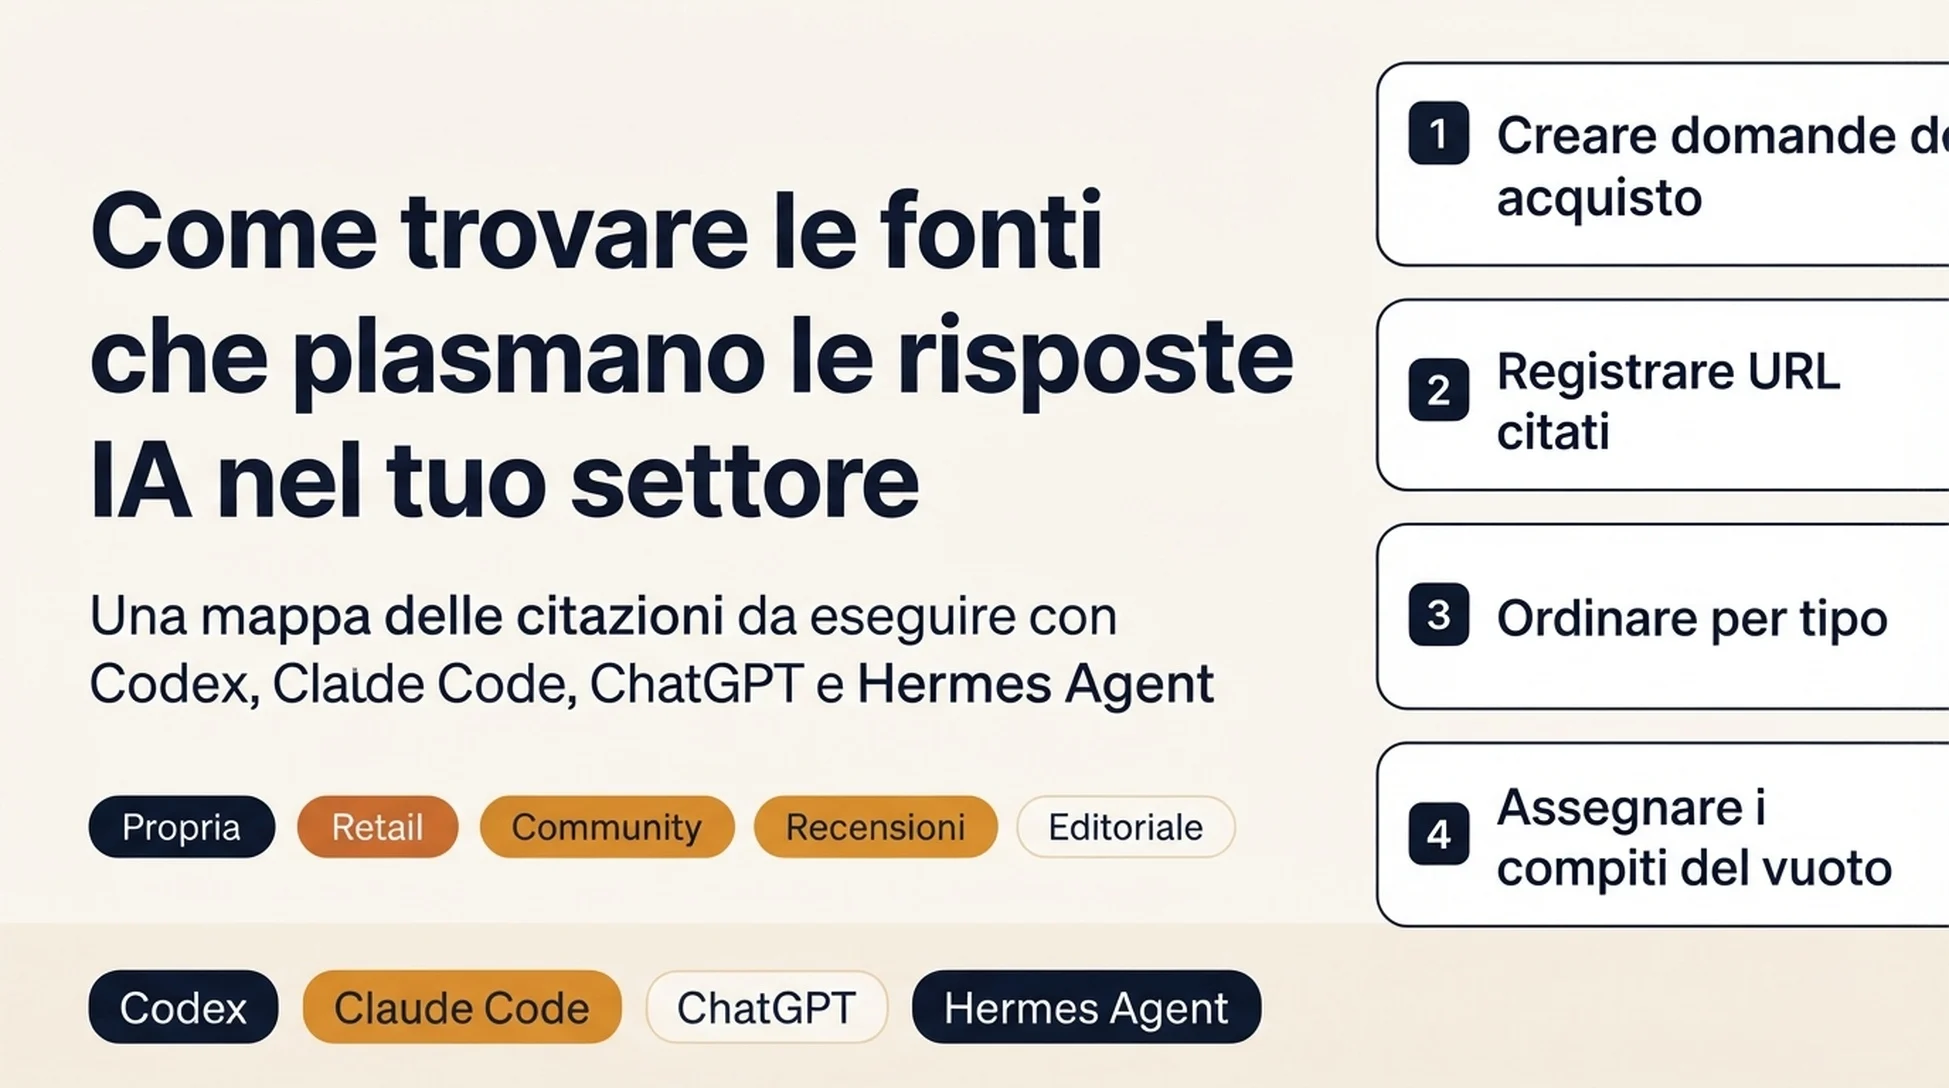
- Da 10 a 20 domande d'acquisto reali per una categoria di prodotto o servizio, scritte come le formulerebbe un cliente
- Ogni domanda eseguita nei motori di IA che i tuoi acquirenti usano davvero, con le fonti citate registrate e datate
- Quelle fonti ordinate per tipo, così vedi da dove arrivano le risposte della tua categoria
- Una lista breve di pagine in cui un concorrente è citato e tu no, ciascuna con un prossimo passo legittimo
- Responsabili e una data di revisione, così la mappa non marcisce in una cartella condivisa
Per chi è: un responsabile interno SEO, GEO o contenuti, oppure uno strategist di agenzia che può raccomandare un lavoro anche quando lo esegue qualcun altro. Nessuno strumento a pagamento è obbligatorio, anche se aiuta su larga scala.
Prerequisiti: un browser, un foglio di calcolo e il permesso di lettura sul tuo sito. Per le versioni con agente, un'installazione funzionante dell'agente scelto e una cartella a cui puntarlo.
Tempo: circa due ore per la prima passata su una categoria. Di queste, circa 45 minuti sono esecuzione di prompt e copia di fonti. Quei 45 minuti sono esattamente la parte che vale la pena affidare a un agente, e il resto è la parte che richiede il tuo giudizio.
Cosa significa finito: sai nominare i tre o quattro tipi di fonte che sostengono le risposte della tua categoria, sai indicare pagine precise in cui tu manchi e un concorrente c'è, e sai passare a qualcuno un compito con un URL allegato. Se hai solo una lista di domini e la vaga sensazione che Reddit conti, non hai finito.
La posizione di Auspia: la maggior parte dei team va dritta a "ci servono più menzioni del brand" perché non ha mai guardato da cosa è stata davvero composta la risposta. La mappa trasforma quell'istinto vago in una pagina su cui si può agire.
Prima di iniziare: le due decisioni che determinano tutto
Due scelte determinano cosa produce il resto. Entrambe sono facili da sbagliare ed entrambe sono fastidiose da disfare dopo.
Scegli una categoria, non l'intera attività. Un'azienda che vende software e gestisce anche un ramo servizi ha due ecosistemi di fonti diversi. Mapparli entrambi insieme produce una media che non descrive né l'uno né l'altro. Prendi la categoria con più ricavi in gioco e lascia il resto al trimestre successivo.
Scegli i motori con criterio. Google AI Overview, ChatGPT, Perplexity e Gemini non attingono dallo stesso pozzo. Una fonte che ha perso peso in un motore può continuare a contare in un altro. Eseguine almeno due. Se non sai quali due, chiedi al team vendite quale interfaccia citano i clienti, oppure guarda il traffico di referral proveniente da domini di IA.
Traccia un confine adesso. Questo è un esercizio di osservazione, non di prova. Stai registrando cosa un motore ha restituito in un certo giorno. Le risposte cambiano tra un'esecuzione e l'altra, quindi una singola osservazione è un dato, non una tendenza. Data tutto, altrimenti l'intero file diventa inutile dopo un mese.
Passo 1: costruire il set di domande
Scrivi da 10 a 20 domande che un cliente farebbe al momento della scelta. Non parole chiave. Domande, nelle parole del cliente.
Questo è il passo che la gente salta in fretta, ed è il passo che decide se il resto vale la pena. Un set di domande costruito da export di parole chiave produce una mappa di come le persone cercano. Un set costruito da note di chiamate commerciali produce una mappa di come le persone comprano. Non sono la stessa lista.
Materiali da cui partire:
- Le domande pre-acquisto più frequenti che riceve il team vendite
- I ticket di assistenza dei primi 30 giorni dopo l'acquisto
- Il blocco "altre domande" delle tue principali query commerciali
- La tua ricerca di parole chiave, riscritta in forma di domanda
- Le ricerche comparative dei concorrenti che fanno i tuoi acquirenti
Mescola le forme delle domande, perché ognuna tira su fonti diverse.
Forma della domanda | Esempio | Fonti che di solito emergono |
|---|---|---|
Aderenza alla categoria | "A cosa deve guardare un'azienda logistica di medie dimensioni scegliendo uno strumento di routing?" | Liste editoriali, siti di recensioni |
Confronto diretto | "Strumento A o strumento B per un team di 20 persone?" | Pagine comparative, thread di community |
Rischio e obiezione | "Lo strumento A è davvero abbastanza sicuro per dati sanitari?" | Forum, analisi di conformità, documentazione del fornitore |
Prezzo e valore | "Quanto costa davvero lo strumento A per utente?" | Pagine prezzi, thread di community, siti di recensioni |
Implementazione | "Quanto tempo serve per migrare dallo strumento B?" | Documentazione, tutorial YouTube, forum |
Risultato atteso: un foglio di calcolo con una riga per domanda, una colonna per la forma della domanda e una per il motore in cui la eseguirai.
Controllo di qualità: rileggi la lista e chiediti se un acquirente reale digiterebbe ciascuna. Se una domanda ha senso solo per chi conosce già la tassonomia del tuo prodotto, riscrivila. Dieci domande che un acquirente farebbe davvero battono cinquanta che suonano come un export di parole chiave.
Percorso di recupero: se non arrivi a dieci domande, hai un problema di ricerca, non di mappatura. Tira fuori le ultime 20 note di chiamate commerciali o gli ultimi 50 ticket di assistenza ed estrai domande da lì prima di continuare.
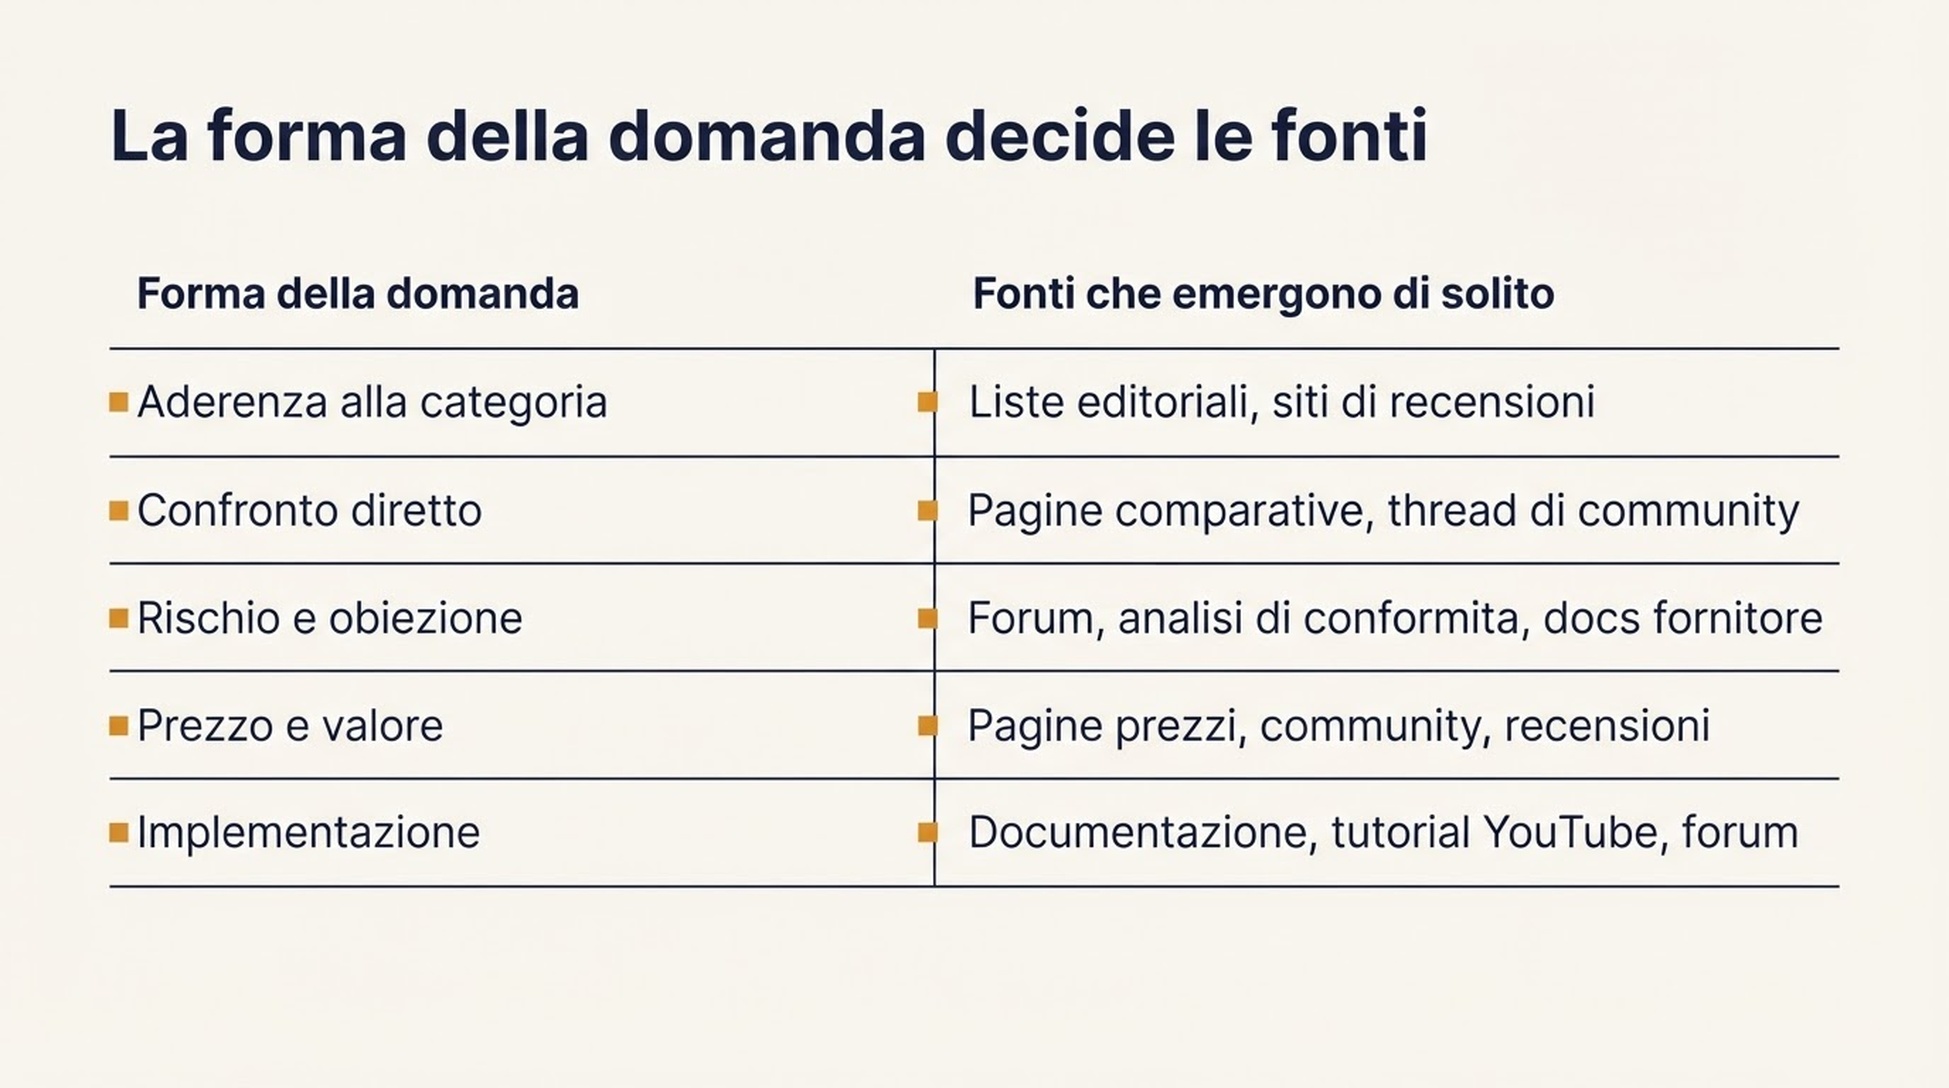
La forma della domanda è la variabile nascosta. Una domanda di confronto diretto e una di rischio sullo stesso prodotto non restituiscono le stesse fonti.
Passo 2: eseguire le domande e catturare le fonti
Qui c'è il nucleo meccanico, ed è qui che il lavoro manuale crolla. Fai cinque domande a mano per capire come deve apparire il risultato. Poi automatizza il resto.
Per ogni domanda, in ogni motore:
- Apri una conversazione nuova. Il contesto precedente cambia cosa recupera il motore.
- Fai la domanda esattamente come l'hai scritta.
- Apri il pannello delle citazioni o la lista delle fonti. Nella maggior parte dei motori è una piccola icona vicino alla risposta, non una lista visibile.
- Registra ogni URL citato, più il dominio e il tipo di fonte.
- Annota la data, il motore e se la risposta ha citato qualcosa o no.
Registra con questa struttura:
Campo | Perché conta |
|---|---|
ID domanda | Collega ogni osservazione alla domanda d'acquisto |
Motore | Permette di separare i pattern per motore più avanti |
Data e ora | Le risposte derivano; una riga senza data è inutile dopo un mese |
URL citato | La pagina reale, non solo il dominio |
Dominio | Per raggruppare e contare le frequenze |
Tipo di fonte | propria, retail/marketplace, community, directory di recensioni, editoriale |
Concorrente presente | Sì/no, e quale |
Nostro brand presente | Nella risposta, nelle fonti, in entrambe o in nessuna |
L'ultima riga merita una pausa. Un brand può essere nominato nella risposta senza che nessuna delle sue pagine venga citata. Può anche essere citato senza comparire in modo evidente. Sono due segnali diversi, e se segui solo "siamo comparsi?", li leggerai male entrambi. Ho visto team festeggiare una menzione che veniva da una pagina che argomentava contro di loro.
Risultato atteso: una tabella lunga, una riga per fonte citata, per domanda e per motore.
Controllo di qualità: su almeno tre righe, clicca e conferma che la pagina citata sostenga davvero l'affermazione per cui è stata citata. I motori a volte citano una pagina che menziona l'argomento senza rispondere alla domanda. Quelle righe sono rumore e vanno segnalate.
Percorso di recupero: se un motore non restituisce citazioni per una domanda, è una scoperta, non un fallimento. Registralo come zero fonti e vai avanti. Le domande a cui si risponde senza recupero sono domande che il tuo contenuto non può influenzare.
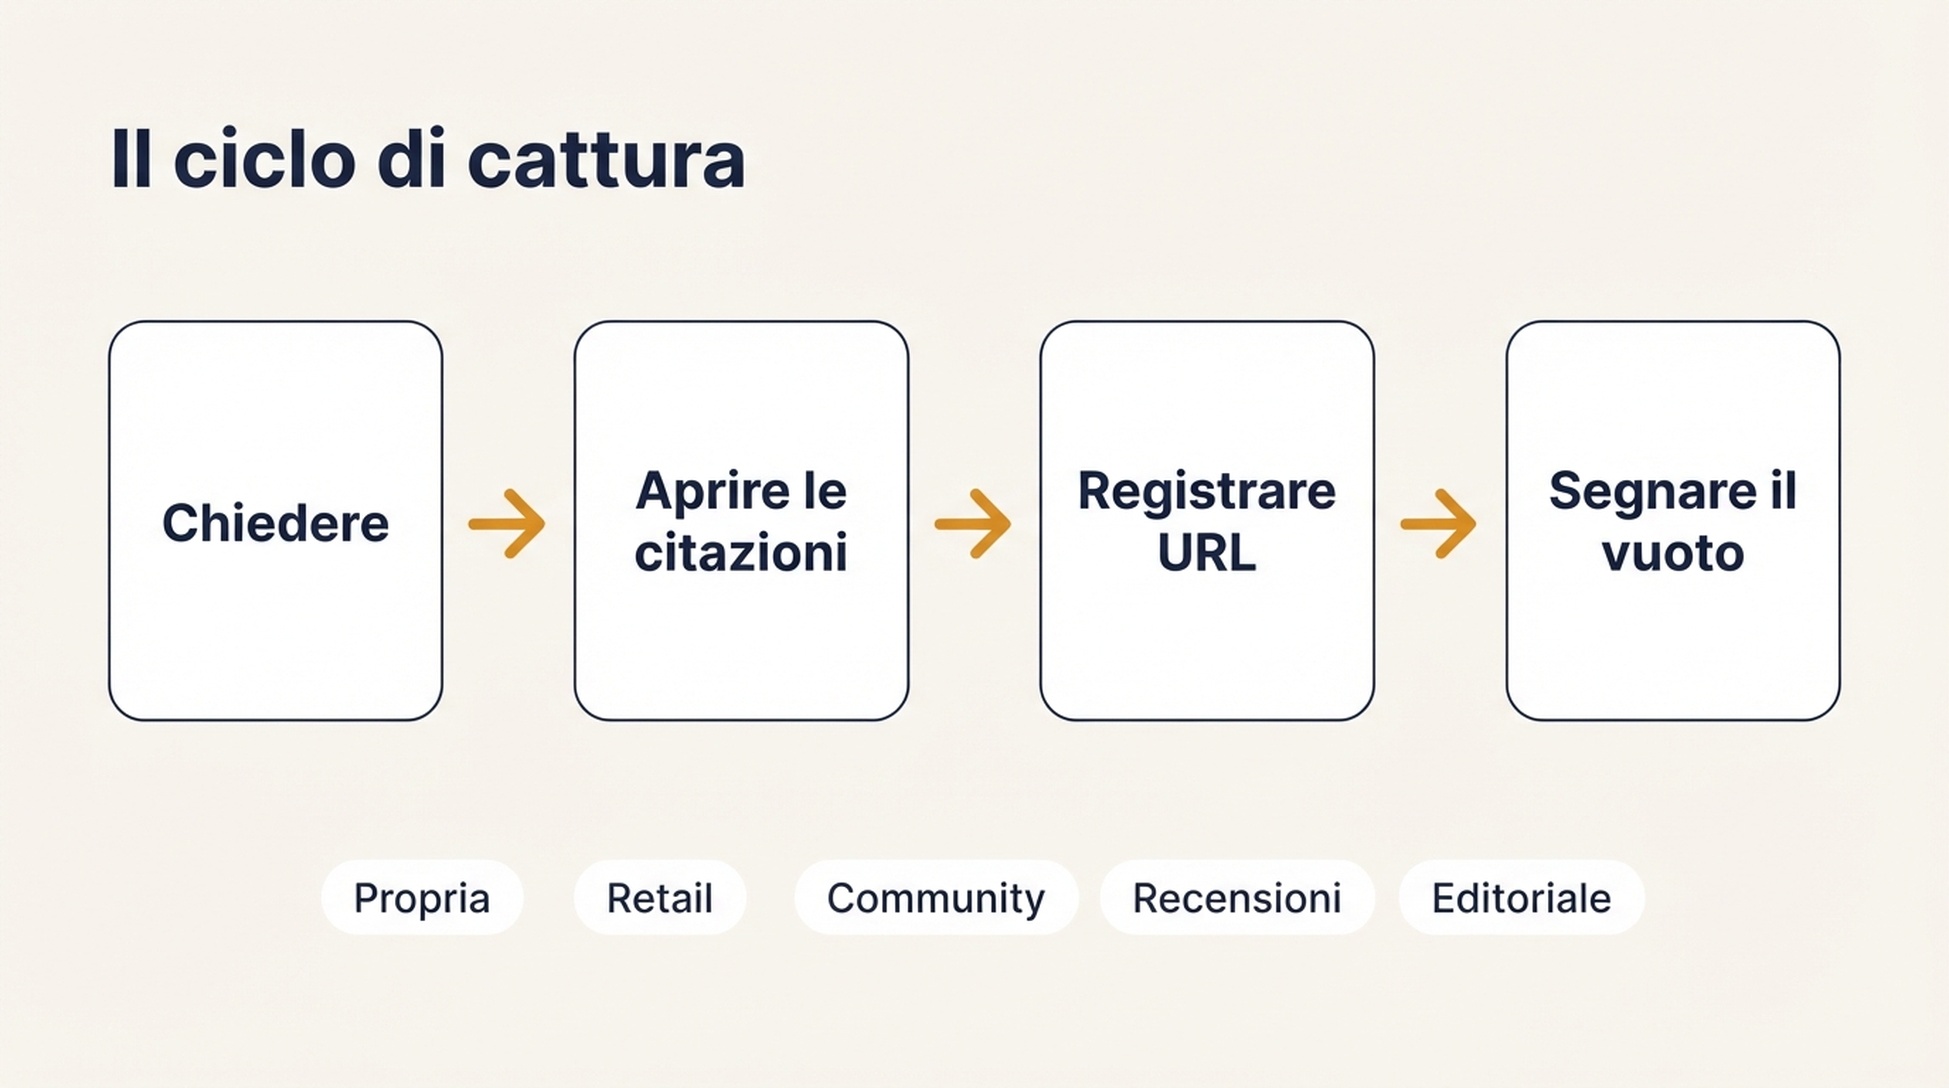
Il ciclo è semplice e noioso. Proprio questa combinazione lo rende un buon candidato per un agente.
Passo 3: ordinare le fonti per tipo
Ora comprimi la tabella lunga in un'immagine della tua categoria. Classifica ogni URL citato in uno di cinque secchi:
- Propria: il tuo sito, o quello di un concorrente
- Retail e marketplace: schede prodotto, pagine di confronto prezzi, app store
- Community e UGC: Reddit, YouTube, Quora, forum, thread Discord indicizzati
- Directory di recensioni e piattaforme B2B: G2, Capterra, Clutch, Trustpilot, directory di settore
- Editoriale indipendente e riferimento: stampa di settore, notizie, Wikipedia, analisi di analisti, blog indipendenti
Conta per secchio e per motore, e hai la tua mappa delle citazioni.
Quello che cerchi non è un numero singolo. È la forma. Alcune categorie sono sostenute quasi interamente da thread di community e stampa di settore, e il sito proprio del brand conta pochissimo. Altre sono dominate dalle schede prodotto, perché la scheda stessa contiene la risposta. Questo mix dipende da cosa chiedono gli acquirenti, non da quanto è fatto bene il sito di qualcuno. È difficile da accettare quando hai passato due anni sul sito.
Risultato atteso: una tabella piccola, una riga per tipo di fonte, una colonna per motore, con la quota delle fonti citate.
Controllo di qualità: se un secchio tiene più del 70% delle tue citazioni, controlla cinque URL al suo interno per confermare che siano davvero di quel tipo. Un aggregatore ad alto traffico può mascherarsi da fonte editoriale quando in realtà è una directory.
Percorso di recupero: se i conteggi sembrano casuali, probabilmente hai mescolato forme di domanda e questo ha nascosto il pattern. Dividi la tabella per forma di domanda e guarda di nuovo. Le domande sul prezzo e quelle sul rischio hanno spesso profili di fonte completamente diversi.
Passo 4: trovare i vuoti in cui un concorrente è citato e tu no
Filtra la tabella lunga sulle righe in cui compare un concorrente e il tuo brand no. Quella lista filtrata è la tua lista di lavoro. È molto più utile di un mandato generico tipo "ci servono più menzioni", perché ogni riga porta già un URL e una domanda del cliente. Passala a qualcuno lunedì e può iniziare.
Per ogni riga, apri la pagina citata e rispondi a tre domande:
- Il nostro prodotto appartiene davvero a questa pagina?
- Se sì, cosa manca: una scheda che non abbiamo mai reclamato, un confronto in cui siamo assenti, un thread in cui nessuno ci ha menzionati, una recensione che non abbiamo mai chiesto?
- Qual è la più piccola azione legittima che ci metterebbe lì?
La terza domanda è dove entra la disciplina. L'azione cambia da secchio a secchio. Sbagliare qui significa ritrovarsi con un SEO che manda email a freddo ai giornalisti a proposito di un thread su Reddit.
Tipo di fonte | Azione legittima | Cosa non fare |
|---|---|---|
Directory di recensioni | Reclamare e completare il profilo, chiedere recensioni ai clienti | Comprare recensioni o seminarne di false |
Thread di community | Rispondere con onestà come dipendente identificato, dichiarando il legame | Fare astroturfing o lasciare un link senza contributo |
Editoriale | Proporre un angolo davvero utile che il media non ha ancora trattato | Mandare lo stesso comunicato a 200 domini |
Marketplace o scheda retail | Correggere specifiche, immagini e descrizione perché i fatti siano recuperabili | Riempire la scheda di parole chiave |
Pagina propria | Ristrutturare perché il fatto specifico sia facile da trovare e citare | Aggiungere un blocco FAQ che non risponde a nulla |
Risultato atteso: una lista filtrata e prioritizzata. Ordina per la frequenza con cui la fonte compare nel tuo set di domande, non per quanto prestigioso suona il dominio. Un thread di forum citato in sei delle tue venti domande passa davanti a una pubblicazione di settore citata una volta, e per di più è molto più facile da affrontare.
Controllo di qualità: per ogni riga che tieni, conferma di saper enunciare la domanda del cliente a cui corrisponde. Se non ci riesci, scarta la riga. Le pagine citate per domande che nessuno nella tua pipeline fa distraggono soltanto.
Percorso di recupero: se la lista filtrata è ancora enorme, non hai filtrato abbastanza. Limita la prima passata a dieci righe, ordinate per frequenza di citazione, e lavorale prima di riaprire la lista completa.
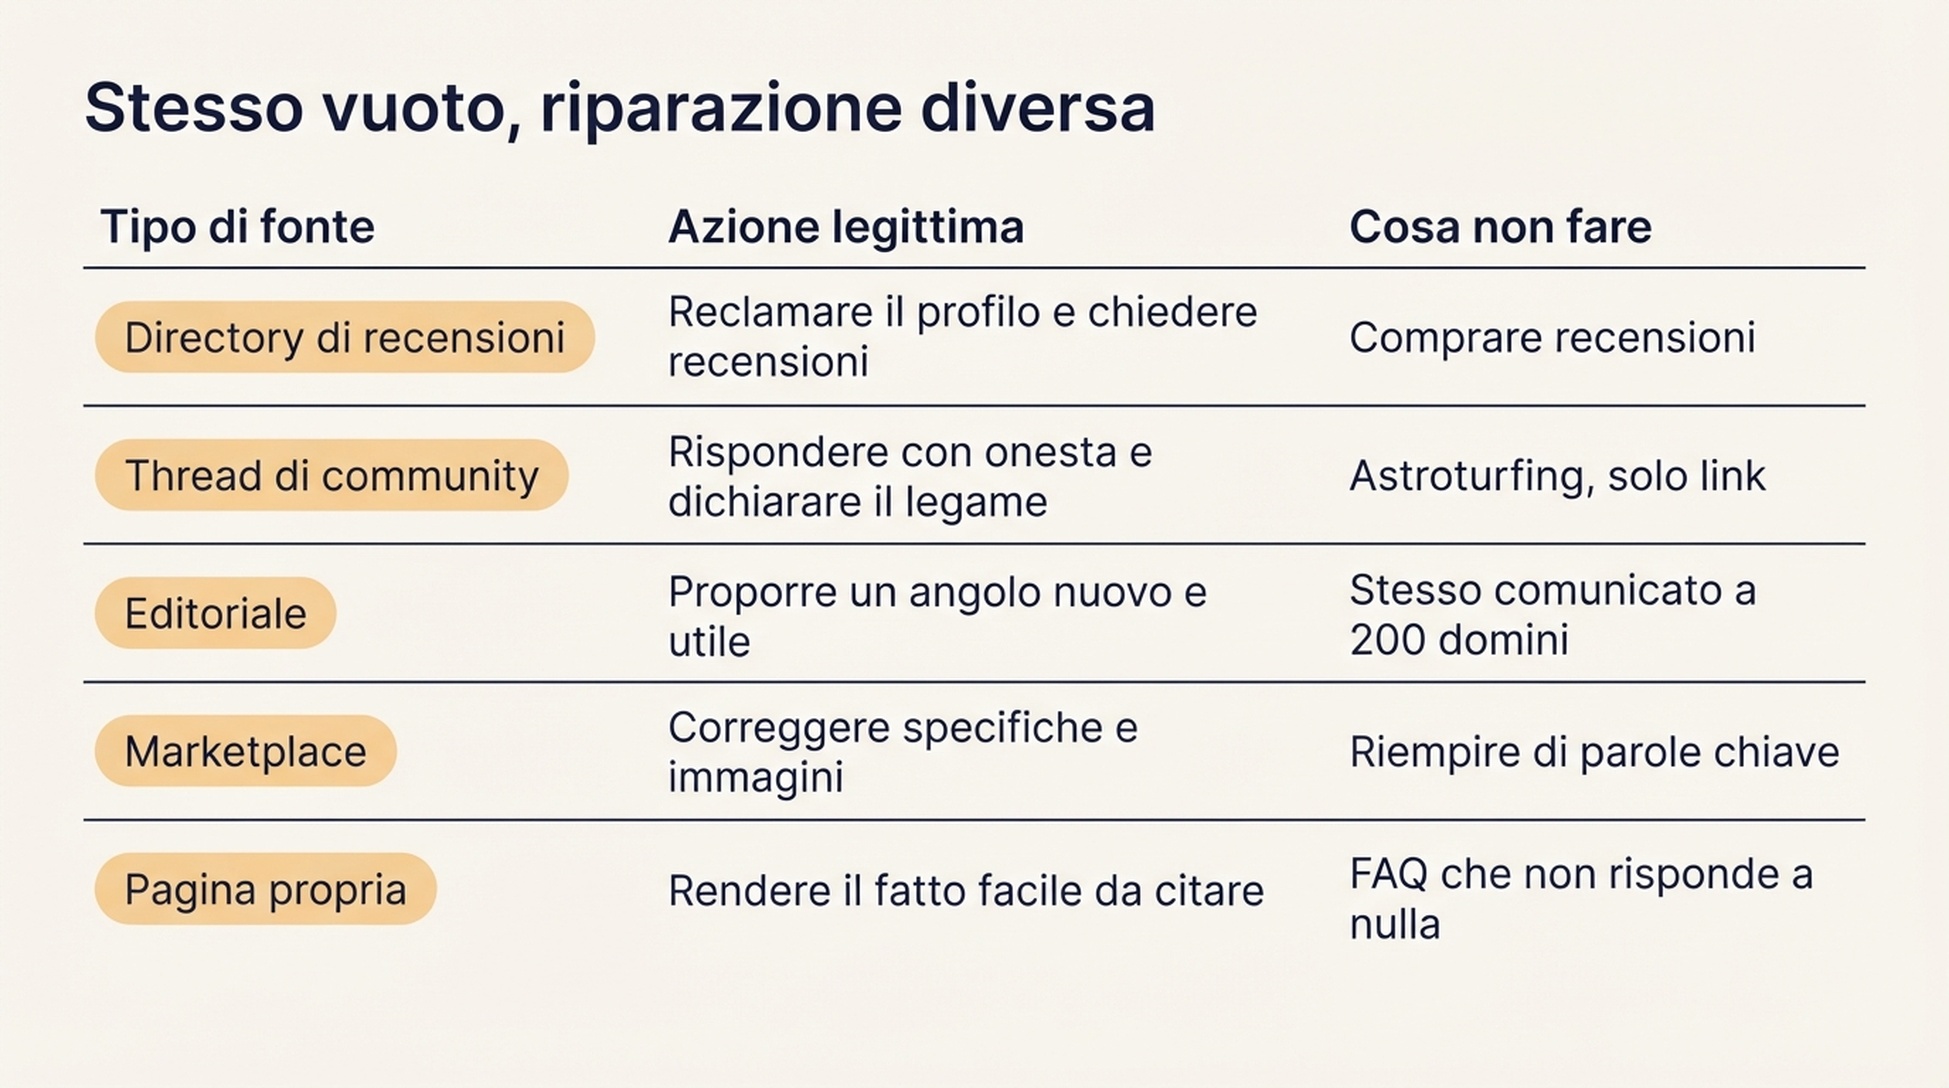
Stesso vuoto, riparazione diversa. Trattare ogni citazione mancante come un problema di outreach è come i team finiscono per vendere un thread di Reddit a un redattore.
Passo 5: affidare la metà meccanica a un agente
I passi 2 e 3 sono quelli che consumano più tempo e richiedono meno giudizio. È la definizione di lavoro che vale la pena delegare. Il set di domande e la prioritizzazione restano a una persona, perché sono i due punti in cui un errore di giudizio fa cadere tutto l'esercizio.
I quattro agenti qui sotto possono eseguire lo stesso metodo. Quello che cambia è dove vive il metodo e come torna il risultato. Scegli su questo, non su quale modello ha vinto un benchmark questo mese.
Codex
Ideale quando vuoi che la mappa viva in un repository e produca un artefatto rivisto a ogni esecuzione. Se il tuo sito è già su git, questa è la strada con meno attrito.
Prepara una cartella di progetto con una directory citation-map/, un questions.csv con il tuo set di domande e un SKILL.md che dichiari il metodo: quali motori controllare, quali campi registrare, come classificare una fonte e come deve apparire il file di output. Tieni un file per esecuzione, nominato per data, così accumuli storico invece di sovrascrivere.
Chiedi a Codex di eseguire le domande, aggiungere righe al file dell'esecuzione corrente e produrre una tabella riassuntiva della quota di fonti per motore. Poiché l'output è un file dentro un repository, ottieni un diff che puoi rivedere prima che qualcosa venga considerato definitivo. Quel passaggio di revisione è il punto: stai controllando le classificazioni, non rifacendo la cattura.
Una regola deve stare nel SKILL.md in ogni caso: l'agente registra ciò che ha osservato e non inferisce una citazione che non ha visto. Inventare fonti è la modalità di fallimento più dannosa di questo flusso. Una regola scritta più un controllo a campione su tre righe ferma la maggior parte dei casi, e le tre righe che controlli devono cambiare a ogni esecuzione.
Claude Code
Ideale quando il metodo deve essere letto contro una policy scritta esplicita, e quando vuoi rivedere le pagine catturate con un contesto lungo.
Metti il metodo in un CLAUDE.md o in uno skill di progetto, includendo le tue definizioni di tipo di fonte e lo schema di output esatto. Punta Claude Code alla cartella di esecuzione e chiedigli di classificare ogni URL citato, poi di segnalare ogni riga in cui il contenuto della pagina non sostiene davvero la citazione.
Il secondo lavoro è quello per cui vale la pena pagare. Leggere 200 pagine citate e giudicare se ciascuna risponde davvero alla domanda è penoso per una persona e ragionevole per un agente con uno standard scritto. Chiedi un indicatore di confidenza per riga e rivedi tu solo quelle a bassa confidenza.
ChatGPT
Ideale quando vuoi il costo di setup più basso e il lavoro è una singola sessione invece di un'esecuzione ricorrente.
Incolla il metodo come istruzione personalizzata o prompt di progetto salvato, allega la tua lista di domande e lavora a lotti per motore. Chiedi l'output come tabella con esattamente le colonne del passo 2, così si incolla direttamente nel foglio di calcolo.
Il problema è che ChatGPT è anche una delle superfici che stai misurando. Se stai mappando le citazioni di ChatGPT stesso, fallo in una sessione pulita senza il metodo caricato, altrimenti contamini l'osservazione. Usa una sessione per catturare e un'altra per organizzare.
Hermes Agent
Ideale quando vuoi che il metodo persista come skill e migliori tra un'esecuzione e l'altra senza doverlo rispiegare.
Installa il metodo della mappa delle citazioni come skill di Hermes con il set di domande e lo schema di output, poi eseguilo con una cadenza; il mensile di solito è quello giusto. Poiché lo skill e la sua memoria persistono, le correzioni fatte il primo mese passano al secondo. Se l'agente ha classificato male una directory come fonte editoriale, correggi la regola una volta.
Il prezzo è che la memoria persistente richiede revisione periodica. Ogni poche esecuzioni, leggi il file dello skill e controlla che le correzioni accumulate descrivano ancora il metodo che vuoi, e non un mucchio di eccezioni una tantum che nessuno sa spiegare.
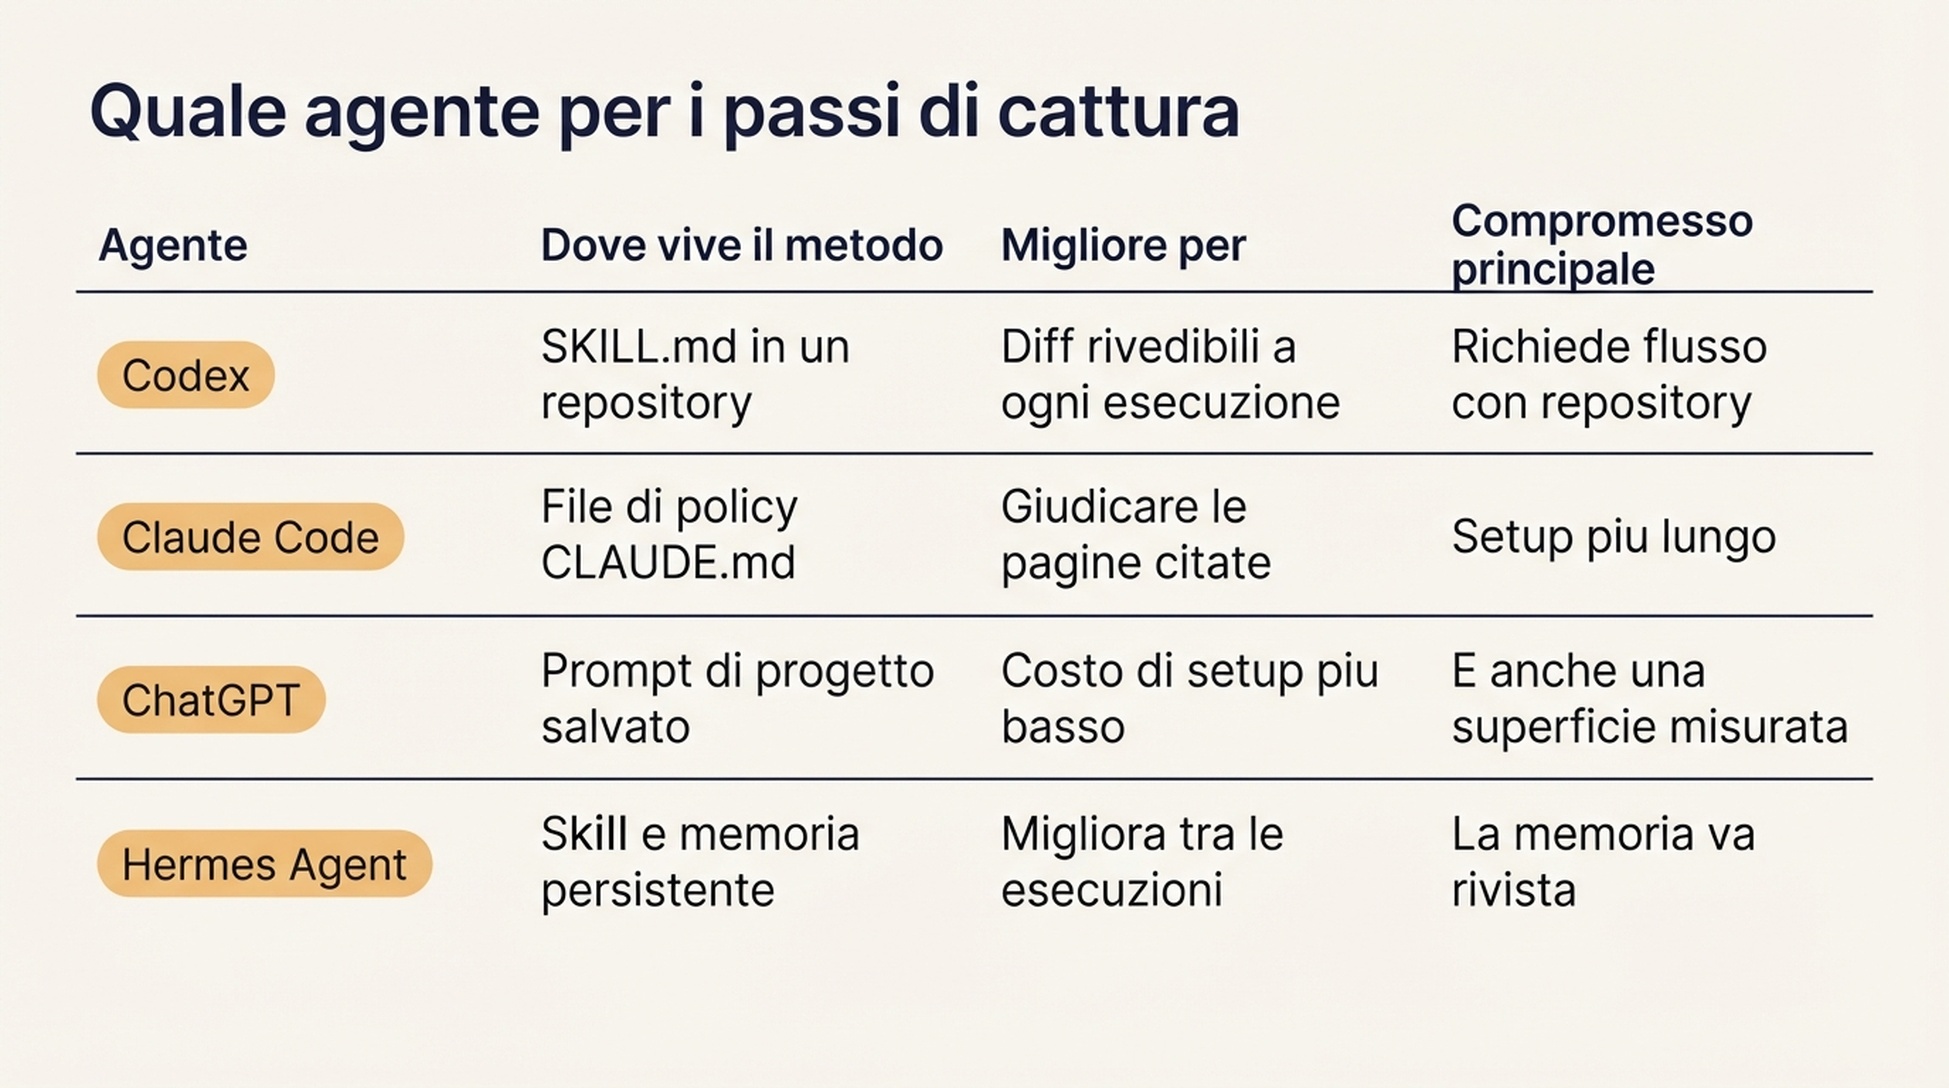
Tutti e quattro eseguono gli stessi cinque passi. Scegli in base a dove deve vivere il metodo, non in base a quale modello segna di più in un benchmark.
Passo 6: verificare la mappa prima di agire
Non assegnare lavoro partendo da una mappa non verificata. Esegui prima questo controllo. Cinque minuti qui risparmiano un trimestre di sforzi nella direzione sbagliata.
- Riesegui tre domande una settimana dopo. Se il mix di fonti cambia del tutto, il tuo set di domande è troppo volatile o il campione è troppo piccolo. Registra la variazione invece di trattare la prima passata come verità assoluta. Una certa variazione è normale; un ricambio totale è un avvertimento.
- Conferma il motore, non solo la risposta. Una fonte che compare in Perplexity può mancare in ChatGPT per la stessa domanda. Tieni le colonne per motore separate nel riepilogo; un totale aggregato nasconde esattamente il segnale che ti serve.
- Controlla anche le tue citazioni. Se il tuo brand è citato, apri la pagina. A volte il motore cita una pagina in cui sei menzionato in modo critico, o una che non controlli. È informazione utile, non una vittoria.
- Conferma la data su ogni riga. Una mappa delle citazioni senza date non si confronta con nulla in seguito.
- Controlla il conteggio delle fonti. Se una domanda ha restituito 40 fonti e le altre tre, verifica se hai catturato un pannello "correlati" invece delle citazioni reali.
Cosa significa finito: puoi consegnare a un collega la tabella riassuntiva e una lista di lavoro filtrata, e può agire senza chiederti cosa significa nessuna riga.
Mantenere la mappa
Esegui la passata completa ogni trimestre con lo stesso set di domande, e una passata leggera mensile sulle cinque domande con il valore commerciale più alto. Conserva le esecuzioni vecchie. Il segnale interessante raramente è l'istantanea. È la deriva: un tipo di fonte che cresce in silenzio, o un concorrente che inizia a comparire in un secchio dove prima non c'era.
Rivedi il set di domande due volte l'anno. Le domande d'acquisto cambiano con il tuo prodotto e il tuo mercato, e un set obsoleto produce la mappa di una categoria che non vendi più.
Una cosa a cui resistere: trasformare tutto questo in una dashboard. Il risultato è una lista di lavoro con responsabili e URL. Se alla fine nessuno ha un compito, la mappa non ha fatto il suo lavoro.
Domande frequenti
Serve uno strumento a pagamento di visibilità IA per farlo? No. La versione manuale funziona per una categoria e richiede mezza giornata. Gli strumenti si guadagnano il costo quando segui molte categorie o mercati, o quando vuoi linee di tendenza storiche senza mantenere tu il foglio di calcolo.
Quante domande bastano? Da 10 a 20 per categoria. Sotto le dieci non distingui un pattern da una coincidenza. Sopra le venti alla prima passata non finisci l'analisi, che è la parte che produce la lista di lavoro.
Devo includere domande in cui compariamo già? Sì. Sapere quali fonti ti sostengono è utile quanto sapere quali ti mancano, e ti dice cosa proteggere quando modifichi i contenuti.
E se il motore dà una risposta diversa ogni volta? È normale e vale la pena registrarlo. Esegui la stessa domanda tre volte e annota la variazione. Se il set di fonti è completamente diverso ogni volta, tratta quella domanda come a bassa confidenza e dagli meno peso nella prioritizzazione.
Posso usare la lista delle fonti del motore senza aprire le pagine? Per la cattura iniziale, sì. Per le righe su cui agirai, no. Devi leggere la pagina per giudicare se il tuo brand appartiene davvero lì e cosa sarebbe un contributo utile.
In cosa è diverso dal monitoraggio delle posizioni? Il monitoraggio delle posizioni ti dice dove compaiono le tue pagine in una lista di risultati. Una mappa delle citazioni ti dice da quali pagine è stata assemblata una risposta. Una pagina può essere prima e non essere mai citata, e una che non si posiziona da nessuna parte può essere la spina dorsale di una risposta. È questo scarto che rende sensato dedicarci mezza giornata.
Autore: Ethan Marlowe, responsabile della misurazione GEO in Auspia con oltre 500 prompt analizzati. Scrive di monitoraggio dei prompt, report delle citazioni, dashboard di visibilità e di come distinguere un vero cambiamento di visibilità IA dal rumore tra un'esecuzione e l'altra.