מה יהיה לך בסוף
מפת ציטוטים היא תיעוד של העמודים שמנוע AI באמת משך כשהשיב לשאלות של הקונים הפוטנציאליים שלך. לא אם המותג שלך הופיע בתשובה. אלא מאילו מקורות התשובה הזו הורכבה.
הרצתי את זה במספיק קטגוריות כדי לדעת שהתוצאה הראשונה בדרך כלל מביכה. צוותים מניחים שהאתר שלהם הוא שנושא את התשובות האלה. לרוב זה לא כך. בקטגוריית B2B אחת, העמודים של הספק עצמו היו חלק זעום, בעוד אתר ביקורות שאף אחד לא תבע עשה את רוב העבודה.
זו הסיבה לעשות את זה. אתה מפסיק לנחש ומתחיל להסתכל על העמודים האמיתיים.
בסוף המדריך הזה יהיו לך:
- 10 עד 20 שאלות רכישה אמיתיות לקטגוריית מוצר או שירות אחת, כתובות כפי שלקוח היה שואל
- כל שאלה הורצה במנועי ה-AI שהקונים שלך באמת משתמשים בהם, עם המקורות המצוטטים מתועדים ומתוארכים
- המקורות האלה מסודרים לפי סוג, כדי שתראה מאיפה מגיעות התשובות בקטגוריה שלך
- רשימה קצרה של עמודים שבהם מתחרה מצוטט ואתה לא, כל אחד עם צעד הבא לגיטימי
- אחראים ותאריך סקירה, כדי שהמפה לא תרקב בתיקייה משותפת
למי זה מיועד: אחראי SEO, GEO או תוכן פנימי, או אסטרטג בסוכנות שיכול להמליץ על עבודה גם כשמישהו אחר מבצע. אין צורך בכלי בתשלום, אם כי הוא עוזר בקנה מידה גדול.
דרישות מקדימות: דפדפן, גיליון אלקטרוני והרשאת קריאה לאתר שלך. לגרסאות עם סוכן, התקנה עובדת של הסוכן שתבחר, ותיקייה שתוכל להפנות אליה אותו.
זמן: כשעתיים למעבר הראשון בקטגוריה אחת. כ-45 דקות מהן הן הרצת פרומפטים והעתקת מקורות. בדיוק 45 הדקות האלה הן החלק ששווה למסור לסוכן, והשאר הוא החלק שדורש את השיפוט שלך.
מה המשמעות של סיום: אתה יכול לנקוב בשלושה או ארבעה סוגי מקורות שנושאים את התשובות בקטגוריה שלך, להצביע על עמודים ספציפיים שבהם אתה חסר ומתחרה נוכח, ולמסור למישהו משימה עם כתובת URL מצורפת. אם יש לך רק רשימת דומיינים ותחושה מעורפלת ש-Reddit חשוב, לא סיימת.
העמדה של Auspia: רוב הצוותים הולכים ישר ל"אנחנו צריכים יותר אזכורים של המותג" כי הם מעולם לא הסתכלו ממה התשובה באמת הורכבה. המפה היא מה שהופך את התחושה המעורפלת הזו לעמוד שאפשר לפעול לפיו.
לפני שמתחילים: שתי החלטות שקובעות הכל
שני בחירות קובעים מה שאר העבודה תייצר. את שניהם קל לעשות לא נכון, ואת שניהם לא נוח לבטל אחר כך.
בחר קטגוריה אחת, לא את כל העסק. לחברה שמוכרת תוכנה ומפעילה גם זרוע שירותים יש שתי מערכות אקולוגיות שונות של מקורות. מיפוי שתיהן יחד מייצר ממוצע שלא מתאר אף אחת מהן. בחר את הקטגוריה עם ההכנסה הגדולה ביותר והשאר את השאר לרבעון הבא.
בחר את המנועים במודע. Google AI Overview, ChatGPT, Perplexity ו-Gemini לא שואבים מאותה באר. מקור שאיבד ממשקלו במנוע אחד יכול עדיין להיספר באחר. הרץ לפחות שניים. אם אתה לא יודע אילו שניים, שאל את צוות המכירות איזה ממשק לקוחות מזכירים, או בדוק תעבורת הפניה מדומיינים של AI.
משוך קו עכשיו. זה תרגיל תצפית, לא תרגיל הוכחה. אתה מתעד מה מנוע החזיר ביום מסוים. תשובות משתנות בין הרצות, כך שתצפית בודדת היא נקודת נתונים, לא מגמה. תארך הכל, אחרת כל הקובץ יהיה חסר תועלת בעוד חודש.
שלב 1: לבנות את מערך השאלות
כתוב 10 עד 20 שאלות שלקוח ישאל בעת הבחירה. לא מילות מפתח. שאלות, במילים של הלקוח עצמו.
זה השלב שאנשים ממהרים לעבור עליו, והוא השלב שקובע אם שאר העבודה שווה את המאמץ. מערך שאלות שנבנה מייצוא מילות מפתח מייצר מפה של איך אנשים מחפשים. מערך שנבנה מהערות שיחות מכירה מייצר מפה של איך אנשים קונים. אלה לא אותה רשימה.
חומרים שאפשר להשתמש בהם:
- שאלות טרום-רכישה הנפוצות ביותר שצוות המכירות מקבל
- כרטיסי תמיכה מ-30 הימים הראשונים אחרי הרכישה
- בלוק "אנשים גם שואלים" בשאילתות המסחריות העיקריות שלך
- מחקר מילות המפתח שלך, שנכתב מחדש כשאלות
- חיפושי השוואה של מתחרים שהקונים שלך עורכים
ערבב צורות שאלות, כי כל אחת מושכת מקורות שונים.
צורת השאלה | דוגמה | אילו מקורות עולים בדרך כלל |
|---|---|---|
התאמה לקטגוריה | "למה צריכה לשים לב חברה לוגיסטית בינונית בבחירת כלי לתכנון מסלולים?" | רשימות עיתונאיות, אתרי ביקורות |
השוואה ישירה | "כלי A או כלי B לצוות של 20 איש?" | עמודי השוואה, שרשורי קהילה |
סיכון והתנגדות | "האם כלי A באמת בטוח מספיק לנתוני בריאות?" | פורומים, ניתוחי תאימות, תיעוד הספק |
מחיר וערך | "כמה כלי A באמת עולה למושב?" | עמודי מחירים, שרשורי קהילה, אתרי ביקורות |
הטמעה | "כמה זמן לוקח לעבור מכלי B?" | תיעוד, הסברים ב-YouTube, פורומים |
התוצר הצפוי: גיליון אלקטרוני עם שורה לכל שאלה, עמודה לצורת השאלה ועמודה למנוע שבו תריץ אותה.
בדיקת איכות: קרא שוב את הרשימה ושאל אם קונה אמיתי היה מקליד כל אחת מהן. אם שאלה מובנת רק למי שכבר מכיר את הטקסונומיה של המוצר שלך, כתוב אותה מחדש. עשר שאלות שקונה באמת שואל עדיפות על חמישים שנשמעות כמו ייצוא מילות מפתח.
מסלול התאוששות: אם אתה לא מגיע לעשר שאלות, זו בעיית מחקר, לא בעיית מיפוי. הוצא את 20 הערות שיחות המכירה האחרונות או 50 כרטיסי התמיכה האחרונים וחלץ מהן שאלות לפני שתמשיך.
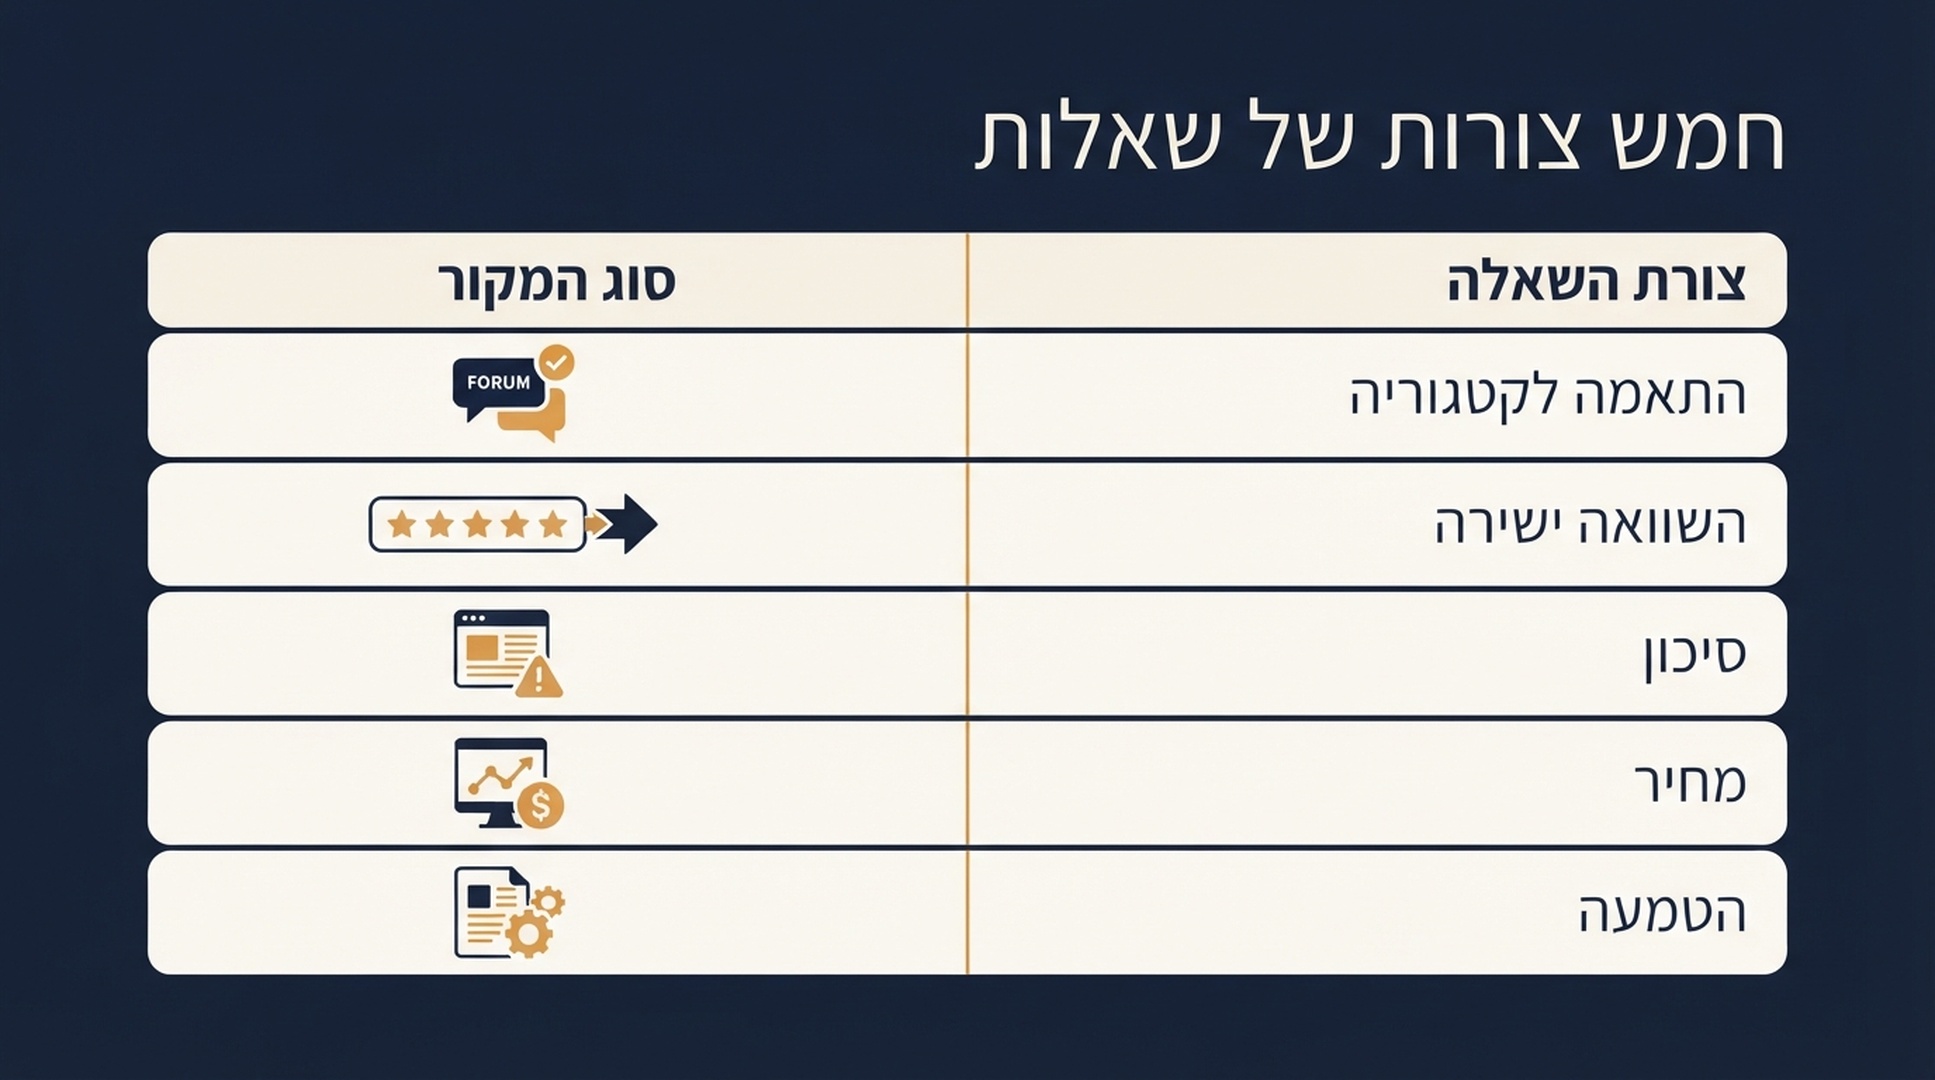
צורת השאלה היא המשתנה הנסתר. שאלת השוואה ישירה ושאלת סיכון על אותו מוצר לא מחזירות את אותם מקורות.
שלב 2: להריץ את השאלות ולתעד את המקורות
כאן הליבה המכנית, וכאן העבודה הידנית מתפרקת. עשה חמש שאלות ביד כדי להבין איך התוצר צריך להיראות. אחר כך אוטומט את השאר.
לכל שאלה, בכל מנוע:
- פתח שיחה חדשה. הקשר קודם משנה מה המנוע שולף.
- שאל את השאלה בדיוק כפי שכתבת אותה.
- פתח את פאנל הציטוטים או רשימת המקורות. ברוב המנועים זה אייקון קטן ליד התשובה, לא רשימה גלויה.
- תעד כל כתובת URL מצוטטת, וכן את הדומיין ואת סוג המקור.
- רשום את התאריך, המנוע, והאם התשובה ציטטה משהו בכלל.
תעד במבנה הזה:
שדה | למה זה חשוב |
|---|---|
מזהה שאלה | מקשר כל תצפית לשאלת הרכישה |
מנוע | מאפשר בהמשך להפריד דפוסים לפי מנוע |
תאריך ושעה | תשובות נסחפות; שורה בלי תאריך חסרת תועלת בעוד חודש |
כתובת URL מצוטטת | העמוד האמיתי, לא רק הדומיין |
דומיין | לקיבוץ ולספירת תדירות |
סוג מקור | עצמי, קמעונאות/מרקטפלייס, קהילה, מדריך ביקורות, עיתונאי |
נוכחות מתחרה | כן/לא, ואיזה |
נוכחות המותג שלנו | בתשובה, במקורות, בשניהם, או באף אחד |
השורה האחרונה ראויה לעצירה. מותג יכול להיות מוזכר בתשובה בלי שאף אחד מהעמודים שלו יצוטט. הוא יכול גם להיות מצוטט בלי להיות מוזכר באופן בולט. אלה שני אותות שונים, ואם אתה עוקב רק אחרי "האם הופענו", תקרא את שניהם לא נכון. ראיתי צוותים חוגגים אזכור שהגיע מעמוד שהתווכח איתם.
התוצר הצפוי: טבלה ארוכה, שורה אחת לכל מקור מצוטט, לכל שאלה ולכל מנוע.
בדיקת איכות: בלפחות שלוש שורות, היכנס ולאמת שהעמוד המצוטט באמת תומך בטענה שבגללה צוטט. מנועים לפעמים מצטטים עמוד שמזכיר את הנושא בלי לענות על השאלה. שורות כאלה הן רעש וצריך לסמן אותן.
מסלול התאוששות: אם מנוע לא מחזיר ציטוטים לשאלה, זה ממצא, לא כישלון. תעד כאפס מקורות והמשך. שאלות שנענות בלי שליפה הן שאלות שהתוכן שלך לא יכול להשפיע עליהן.
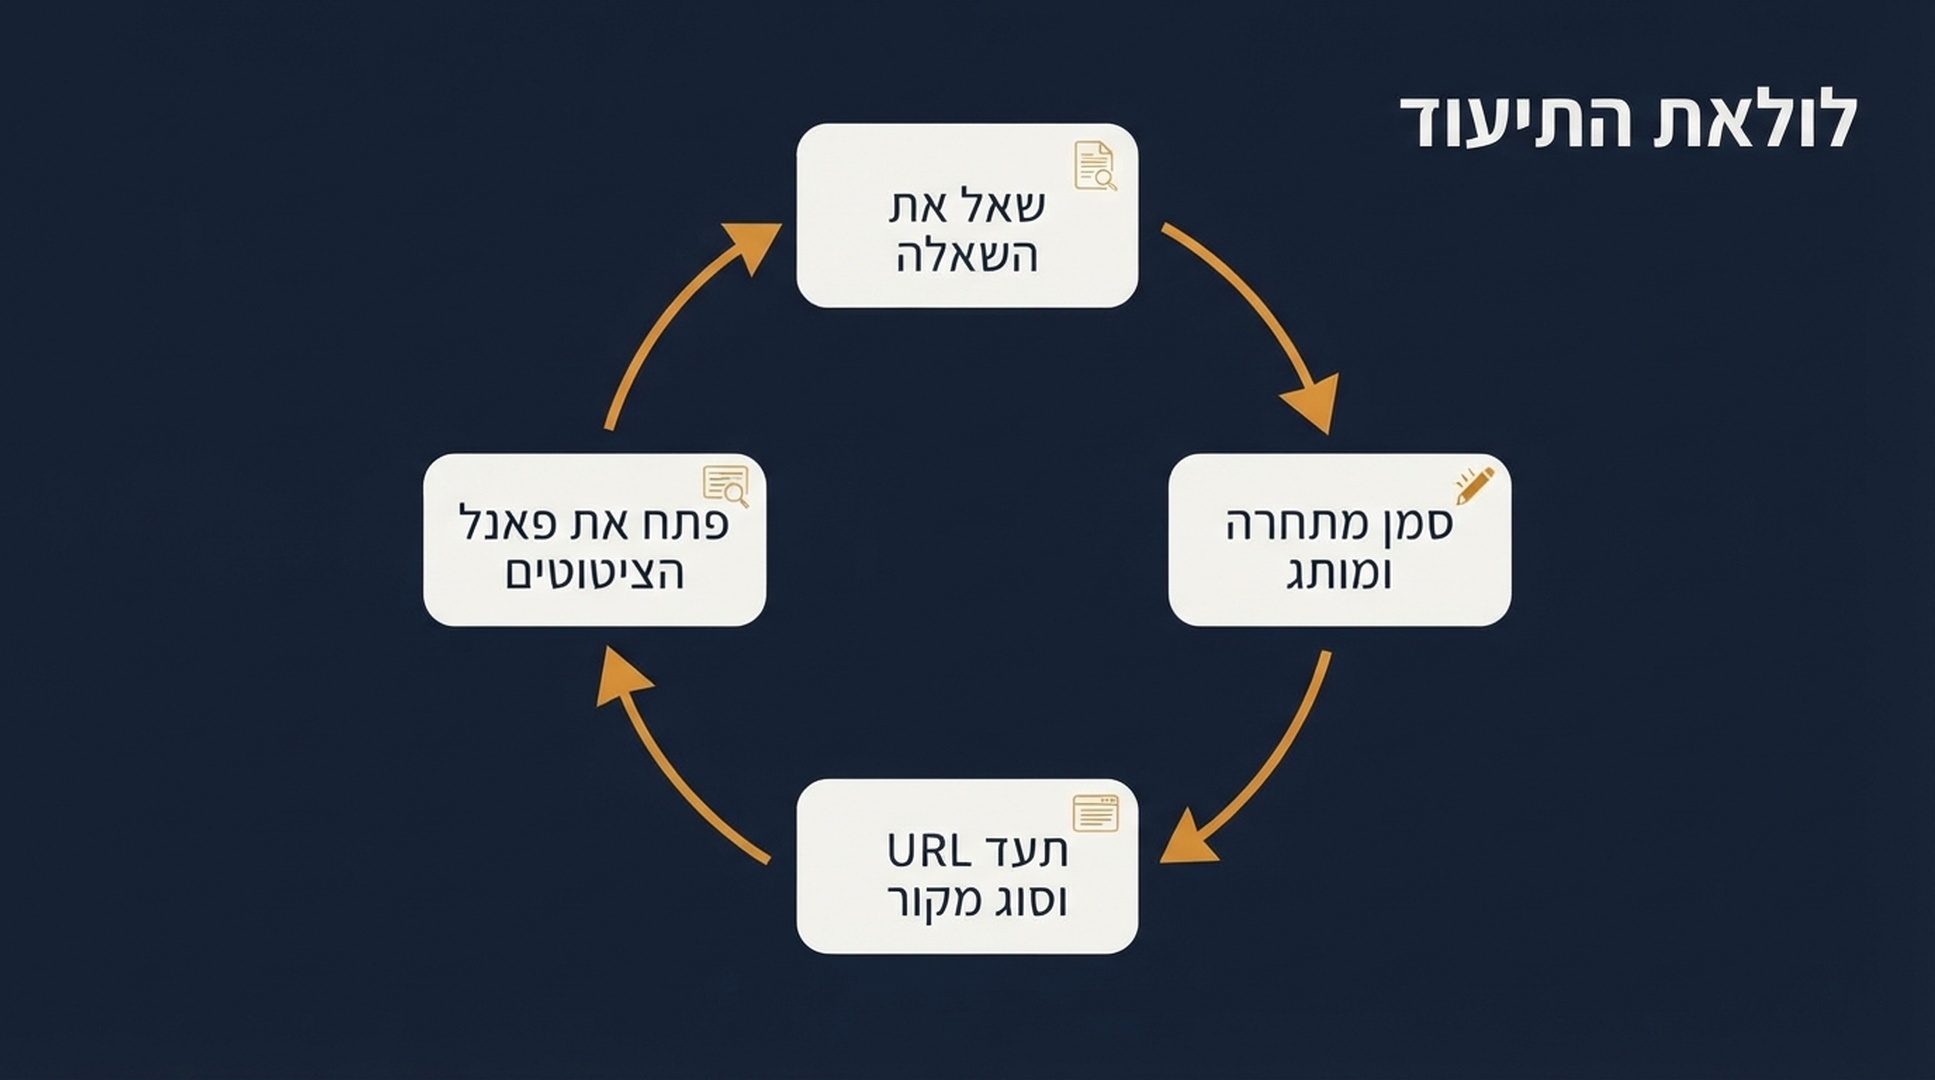
הלולאה פשוטה ומשעממת. בדיוק השילוב הזה הופך אותה למועמדת טובה למסירה לסוכן.
שלב 3: לסדר את המקורות לפי סוג
עכשיו דחוס את הטבלה הארוכה לתמונה של הקטגוריה שלך. סווג כל כתובת URL מצוטטת לאחת מחמש דליים:
- עצמי: האתר שלך, או של מתחרה
- קמעונאות ומרקטפלייס: רשימות מוצרים, עמודי השוואת מחירים, חנויות אפליקציות
- קהילה ותוכן משתמשים: Reddit, YouTube, Quora, פורומים, שרשורי Discord מאונדקסים
- מדריכי ביקורות ופלטפורמות B2B: G2, Capterra, Clutch, Trustpilot, מדריכים ענפיים
- עיתונאי עצמאי ומקורות עזר: עיתונות ענפית, חדשות, Wikipedia, ניתוחי אנליסטים, בלוגים עצמאיים
ספור לפי דלי ולפי מנוע, ויש לך מפת ציטוטים.
מה שאתה מחפש הוא לא מספר בודד. זה הצורה. קטגוריות מסוימות נשענות כמעט כולן על שרשורי קהילה ועיתונות ענפית, והאתר של המותג עצמו כמעט לא תורם. אחרות נשלטות על ידי רשימות מוצרים, כי הרשימה עצמה מכילה את התשובה. התערובת הזו תלויה במה שהקונים שואלים, לא בכמה טוב האתר של מישהו. קשה לקבל את זה כשהשקעת שנתיים באתר.
התוצר הצפוי: טבלה קטנה, שורה לכל סוג מקור, עמודה לכל מנוע, שמציגה את חלקם של המקורות המצוטטים.
בדיקת איכות: אם דלי אחד מחזיק יותר מכ-70% מהציטוטים שלך, בדוק חמש כתובות URL בתוכו כדי לאמת שהן באמת מהסוג הזה. אגרגטור עם תעבורה גבוהה יכול להתחזות למקור עיתונאי כשבפועל הוא מדריך.
מסלול התאוששות: אם המספרים נראים אקראיים, כנראה ערבבת צורות שאלה ובכך הסתרת את הדפוס. פצל את הטבלה לפי צורת שאלה והסתכל שוב. לשאלות מחיר ולשאלות סיכון יש לעתים קרובות פרופילי מקורות שונים לחלוטין.
שלב 4: למצוא את הפערים שבהם מתחרה מצוטט ואתה לא
סנן את הטבלה הארוכה לשורות שבהן מופיע מתחרה והמותג שלך לא. הרשימה המסוננת הזו היא רשימת העבודה שלך. היא שימושית הרבה יותר מצו כללי כמו "אנחנו צריכים יותר אזכורים", כי כל שורה כבר נושאת כתובת URL ושאלת לקוח. תן אותה למישהו ביום שני והוא יכול להתחיל מיד.
לכל שורה, פתח את העמוד המצוטט וענה על שלוש שאלות:
- האם המוצר שלנו באמת שייך לעמוד הזה?
- אם כן, מה חסר: רשומה שמעולם לא תבענו, השוואה שאנחנו נעדרים ממנה, שרשור שאף אחד לא הזכיר אותנו בו, ביקורת שמעולם לא ביקשנו?
- מה הצעד הלגיטימי הקטן ביותר שימקם אותנו שם?
השאלה השלישית היא מקום המשמעת. הפעולה שונה מדלי לדלי. טעות כאן נגמרת בכך שמומחה SEO שולח מיילים קרים לעיתונאים על שרשור ב-Reddit.
סוג מקור | פעולה לגיטימית | מה לא לעשות |
|---|---|---|
מדריך ביקורות | לתבוע ולהשלים את הפרופיל, לבקש ביקורות מלקוחות | לקנות ביקורות או לשתול מזויפות |
שרשור קהילה | לענות בכנות כעובד בשמו, ולחשוף את הזיקה | אסטרוטרפינג, או לזרוק קישור בלי תרומה |
עיתונאי | להציע זווית חדשה ושימושית שהמדיום לא סיקר | לשלוח את אותו הודעה לעיתונות ל-200 דומיינים |
מרקטפלייס או רשומת קמעונאות | לתקן מפרטים, תמונות ותיאור כדי שהעובדות יהיו נגישות | לדחוס מילות מפתח ברשומה |
עמוד עצמי | לבנות מחדש כך שהעובדה הספציפית תהיה קלה למציאה ולציטוט | להוסיף בלוק FAQ שלא עונה על כלום |
התוצר הצפוי: רשימה מסוננת ומתועדפת. סדר לפי תדירות הופעת המקור במערך השאלות שלך, לא לפי כמה יוקרתי הדומיין נשמע. שרשור פורום שמצוטט בשש מעשרים השאלות שלך עומד לפני פרסום ענפי שמצוטט פעם אחת, וגם קל בהרבה לטפל בו.
בדיקת איכות: לכל שורה שתשאיר, אמת שאתה יכול לנקוב בשאלת הלקוח המתאימה. אם לא, הסר את השורה. עמודים שמצוטטים לשאלות שאף אחד בצינור שלך לא שואל רק מסיחים את הדעת.
מסלול התאוששות: אם הרשימה המסוננת עדיין ענקית, לא סיננת חזק מספיק. הגבל את המעבר הראשון לעשר שורות, מסודרות לפי תדירות ציטוט, וסיים אותן לפני שתפתח מחדש את הרשימה המלאה.
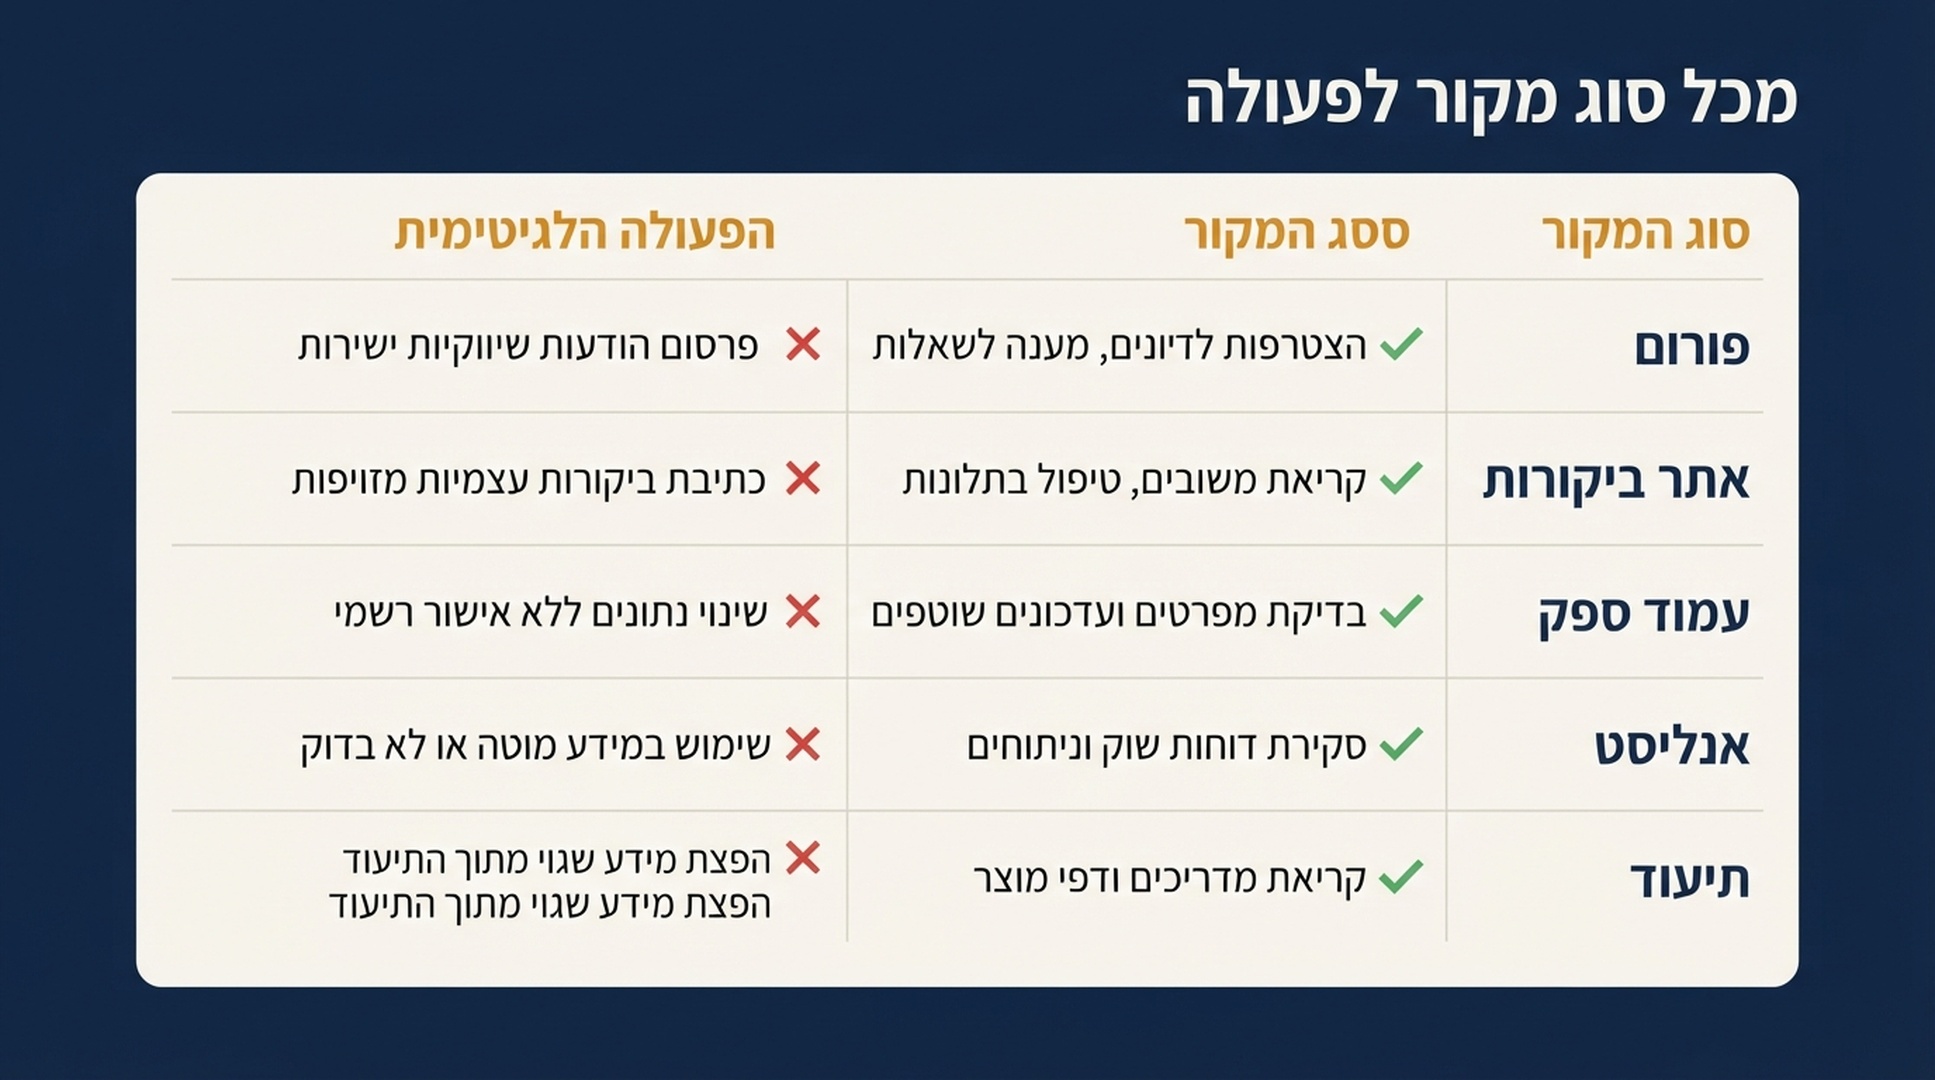
אותו פער, תיקון אחר. התייחסות לכל ציטוט חסר כבעיית פנייה החוצה היא הדרך שבה צוותים מגיעים להציע שרשור Reddit לעורך.
שלב 5: למסור את החצי המכני לסוכן
שלבים 2 ו-3 הם שצורכים את הזמן הרב ביותר ודורשים את השיפוט המועט ביותר. זו ההגדרה של עבודה ששווה להאציל. מערך השאלות והתיעדוף נשארים עם אדם, כי אלה שני המקומות שבהם שיפוט שגוי מפיל את כל התרגיל.
ארבעת הסוכנים למטה יכולים להריץ את אותה שיטה. מה שמשתנה הוא היכן השיטה חיה ואיך התוצר חוזר. בחר לפי זה, לא לפי איזה מודל ניצח במדד החודש.
Codex
אידיאלי כשאתה רוצה שהמפה תחיה במאגר קוד ותפיק בכל הרצה תוצר שנבדק. אם האתר שלך כבר ב-git, זה המסלול עם הפחות חיכוך.
הקם תיקיית פרויקט עם תיקיית citation-map/, קובץ questions.csv שמחזיק את מערך השאלות שלך, וקובץ SKILL.md שמצהיר על השיטה: אילו מנועים לבדוק, אילו שדות לתעד, איך לסווג מקור ואיך קובץ הפלט צריך להיראות. החזק קובץ אחד לכל הרצה, בשם לפי תאריך, כדי לצבור היסטוריה במקום לדרוס.
בקש מ-Codex להריץ את השאלות, להוסיף שורות לקובץ ההרצה הנוכחית, ולהפיק טבלת סיכום של חלק המקורות לפי מנוע. מכיוון שהפלט הוא קובץ במאגר, אתה מקבל diff שאתה יכול לסקור לפני שמשהו נחשב סופי. שלב הסקירה הזה הוא העיקר: אתה בודק את הסיווגים, לא עושה מחדש את התיעוד.
כלל אחד חייב להיות ב-SKILL.md בכל מקרה: הסוכן מתעד את מה שצפה בו ואינו מסיק ציטוט שלא ראה. המצאת מקורות היא מצב הכשל המזיק ביותר בתהליך הזה. כלל כתוב בתוספת בדיקת מדגם של שלוש שורות עוצר את רובו, ושלוש השורות שאתה בודק צריכות להשתנות בכל הרצה.
Claude Code
אידיאלי כשהשיטה צריכה להיקרא מול מדיניות כתובה מפורשת, וכשאתה רוצה לסקור את העמודים שתועדו בהקשר ארוך.
שים את השיטה ב-CLAUDE.md או ב-skill של הפרויקט, כולל הגדרות סוגי המקורות וסכמת הפלט המדויקת. הפנה את Claude Code לתיקיית ההרצה ובקש ממנו לסווג כל כתובת URL מצוטטת, ואז לסמן כל שורה שבה תוכן העמוד לא באמת תומך בציטוט.
העבודה השנייה היא זו ששווה לשלם עליה. לקרוא 200 עמודים מצוטטים ולשפוט אם כל אחד באמת עונה על השאלה זה מייגע לאדם וסביר לסוכן עם תקן כתוב. בקש דגל ביטחון לכל שורה וסקור בעצמך רק את בעלות הביטחון הנמוך.
ChatGPT
אידיאלי כשאתה רוצה את עלות ההקמה הנמוכה ביותר והעבודה היא מפגש אחד ולא הרצה חוזרת.
הדבק את השיטה כהוראה מותאמת אישית או כפרומפט פרויקט שמור, צרף את רשימת השאלות שלך, ועבד בקבוצות לפי מנוע. בקש את הפלט כטבלה עם בדיוק אותן עמודות כמו בשלב 2, כדי שתודבק ישר לגיליון.
המלכודת היא ש-ChatGPT הוא גם אחד המשטחים שאתה מודד. אם אתה ממפה את הציטוטים של ChatGPT עצמו, עשה זאת בשיחה נקייה בלי השיטה שלך טעונה, אחרת תזהם את התצפית. השתמש בשיחה אחת לתיעוד ובאחרת לארגון.
Hermes Agent
אידיאלי כשאתה רוצה שהשיטה תתמיד כ-skill ותשתפר בין הרצות בלי שתצטרך להסביר מחדש.
התקן את שיטת מפת הציטוטים כ-skill של Hermes עם מערך השאלות וסכמת הפלט, ואז הרץ בקצב; חודשי הוא בדרך כלל הנכון. מכיוון שה-skill והזיכרון שלו מתמידים, תיקונים שתעשה בחודש הראשון עוברים לשני. אם הסוכן סיווג מדריך בטעות כמקור עיתונאי, תקן את הכלל פעם אחת.
המחיר הוא שזיכרון מתמשך דורש סקירה תקופתית. כל כמה הרצות, קרא את קובץ ה-skill ובדוק שהתיקונים המצטברים עדיין מתארים את השיטה שאתה רוצה, ולא ערימה של חריגים חד-פעמיים שאיש לא יכול להסביר.
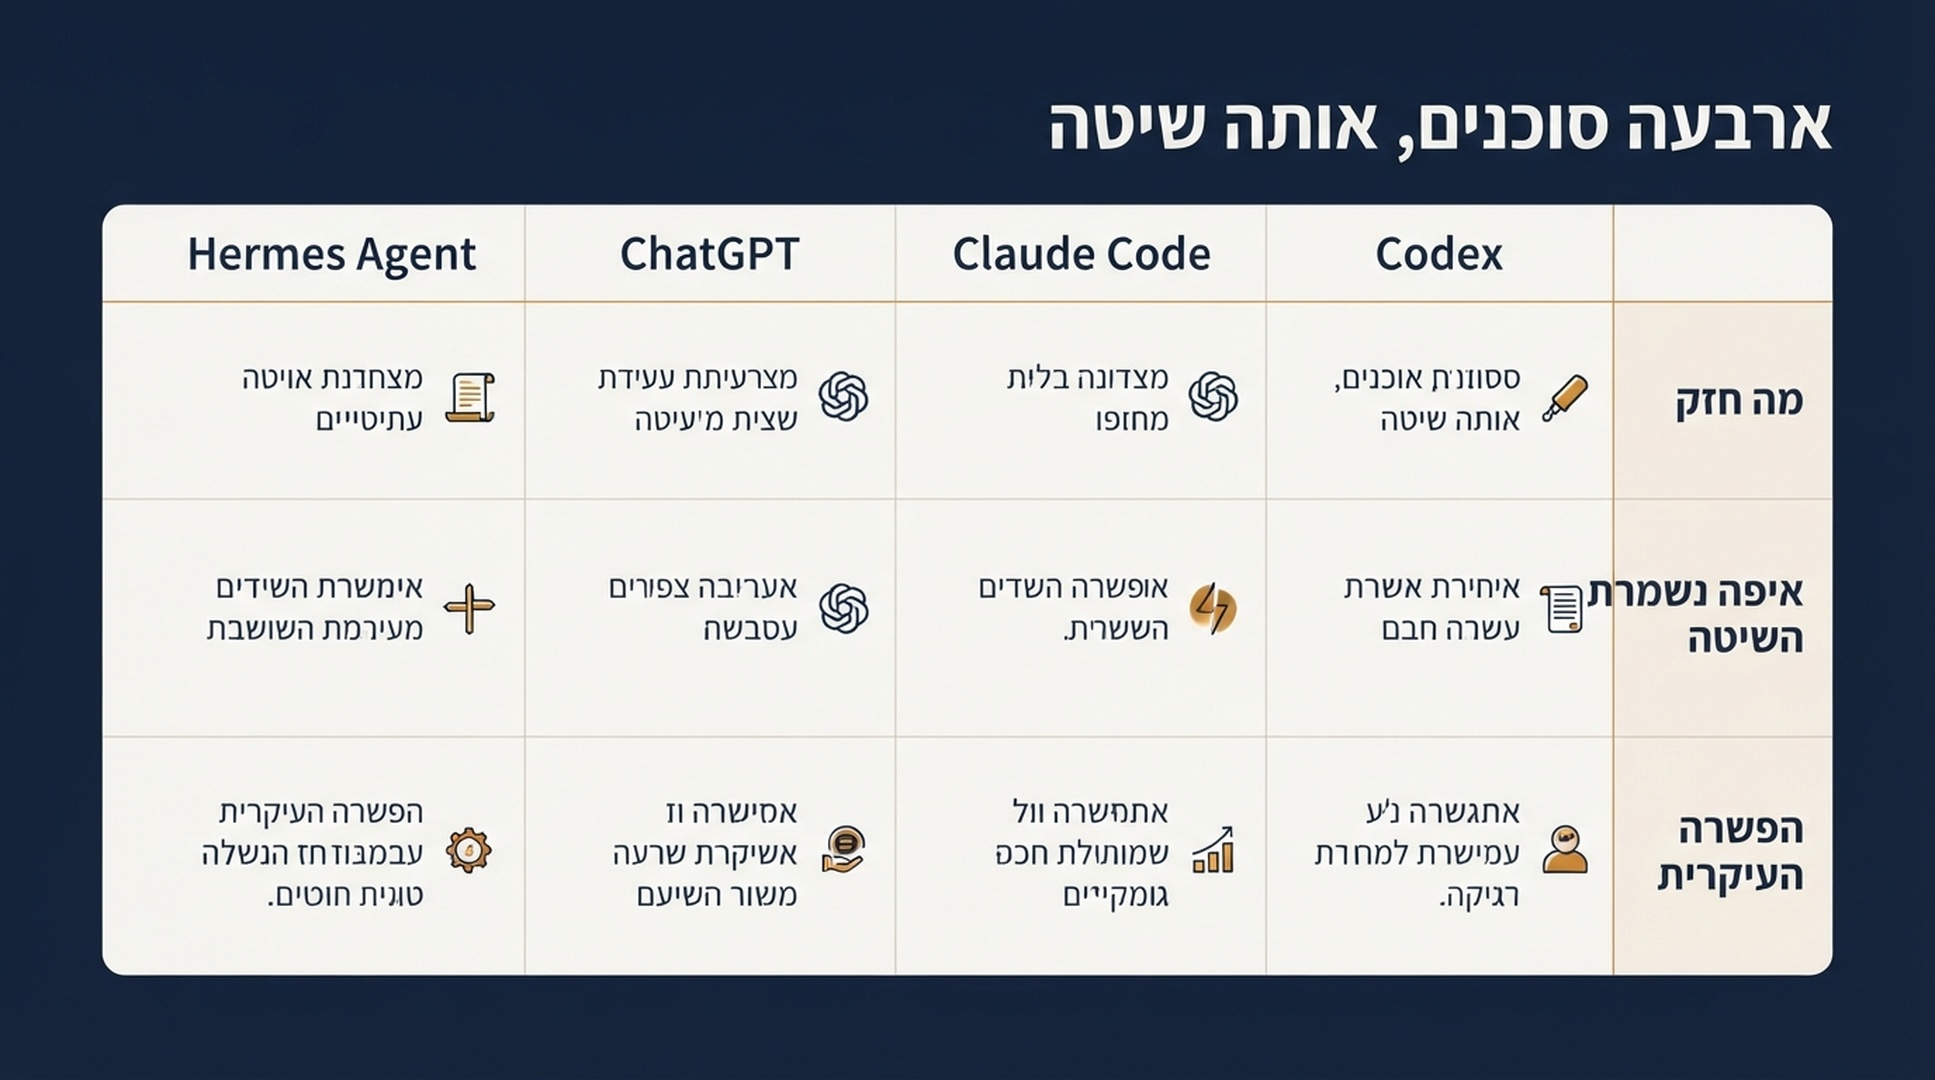
כל הארבעה מריצים את אותן חמש שלבים. בחר לפי היכן השיטה צריכה לחיות, לא לפי איזה מודל קיבל את הציון הגבוה ביותר במדד.
שלב 6: לאמת את המפה לפני שפועלים לפיה
אל תפיץ עבודה על בסיס מפה שלא אומתה. הרץ את הבדיקה הזו קודם. חמש דקות כאן חוסכות רבעון של מאמץ בכיוון הלא נכון.
- הרץ מחדש שלוש שאלות כעבור שבוע. אם תערובת המקורות משתנה לחלוטין, מערך השאלות שלך תנודתי מדי או שהמדגם קטן מדי. תעד את התנודה במקום להתייחס למעבר הראשון כאמת מוחלטת. תנודה מסוימת היא נורמלית; החלפה מלאה היא אזהרה.
- אמת את המנוע, לא רק את התשובה. מקור שמופיע ב-Perplexity יכול להיעדר ב-ChatGPT לאותה שאלה. השאר עמודות לפי מנוע נפרדות בסיכום; סכום מאוחד מסתיר בדיוק את האות שאתה צריך.
- בדוק גם את הציטוטים שלך. אם המותג שלך מצוטט, פתח את העמוד. לפעמים המנוע מצטט עמוד שבו אתה מוזכר בביקורתיות, או עמוד שאינך שולט בו. זה מידע שימושי, לא ניצחון.
- אמת את התאריך בכל שורה. מפת ציטוטים בלי תאריכים לא ניתנת להשוואה לשום דבר אחר כך.
- בדוק את מספר המקורות. אם שאלה אחת החזירה 40 מקורות והשאר שלושה, בדוק אם תפסת פאנל "קשורים" במקום את הציטוטים האמיתיים.
מה המשמעות של סיום: אתה יכול למסור לעמית את טבלת הסיכום ורשימת עבודה מסוננת אחת, והוא יכול לפעול בלי לשאול מה המשמעות של אף שורה.
תחזוקת המפה
הרץ את המעבר המלא כל רבעון על אותו מערך שאלות, ומעבר קל מדי חודש על חמש השאלות בעלות הערך המסחרי הגבוה ביותר. שמור את ההרצות הישנות. האות המעניין הוא לעתים רחוקות התצלום. הוא הסחיפה: סוג מקור שגדל בשקט, או מתחרה שהתחיל להופיע בדלי שבו לא היה.
סקור את מערך השאלות פעמיים בשנה. שאלות רכישה משתנות עם המוצר והשוק שלך, ומערך מיושן מייצר מפה של קטגוריה שאתה כבר לא מוכר בה.
דבר אחד שכדאי להתנגד לו: להפוך את זה ללוח מחוונים. התוצר הוא רשימת עבודה עם אחראים וכתובות URL. אם בסוף לאף אחד אין משימה, המפה לא עשתה את עבודתה.
שאלות נפוצות
האם אני צריך כלי בתשלום לנראות ב-AI כדי לעשות את זה? לא. הגרסה הידנית עובדת לקטגוריה אחת ולוקחת חצי יום. כלים מצדיקים את עלותם כשאתה עוקב אחר קטגוריות או שווקים רבים, או כשאתה רוצה קווי מגמה היסטוריים בלי לתחזק את הגיליון בעצמך.
כמה שאלות מספיקות? 10 עד 20 לקטגוריה. פחות מעשר ואתה לא מבחין בין דפוס למקרה. יותר מעשרים במעבר הראשון ולא תסיים את הניתוח, שהוא החלק שמייצר את רשימת העבודה.
האם לכלול שאלות שאנחנו כבר מופיעים בהן? כן. לדעת אילו מקורות נושאים אותך שימושי בדיוק כמו לדעת אילו מפספסים אותך, וזה אומר לך מה להגן עליו כשאתה משנה תוכן.
מה אם המנוע נותן תשובה שונה בכל פעם? זה נורמלי ושווה לתעד. הרץ את אותה שאלה שלוש פעמים ורשום את התנודה. אם מערך המקורות שונה לחלוטין בכל פעם, התייחס לשאלה כבעלת ביטחון נמוך ותן לה משקל קטן יותר בתיעדוף.
האם אני יכול להשתמש ברשימת המקורות של המנוע בלי לפתוח את העמודים? לתיעוד הראשוני, כן. לשורות שעליהן תפעל, לא. אתה צריך לקרוא את העמוד כדי לשפוט אם המותג שלך באמת שייך לשם ומה תהיה תרומה שימושית.
במה זה שונה ממעקב דירוגים? מעקב דירוגים אומר לך היכן העמודים שלך מופיעים ברשימת תוצאות. מפת ציטוטים אומרת לך מאילו עמודים הורכבה תשובה. עמוד יכול להיות ראשון ומעולם לא יצוטט, ועמוד שלא מדורג בשום מקום יכול להיות עמוד השדרה של תשובה. הפער הזה הוא מה שמצדיק חצי יום.
המחבר: Ethan Marlowe, מוביל מדידת GEO ב-Auspia, ניתח יותר מ-500 פרומפטים. הוא כותב על מעקב פרומפטים, דיווח ציטוטים, לוחות מחוונים לנראות, ואיך להבחין בין שינוי אמיתי בנראות AI לבין רעש בין הרצות.