Що ви отримаєте в результаті
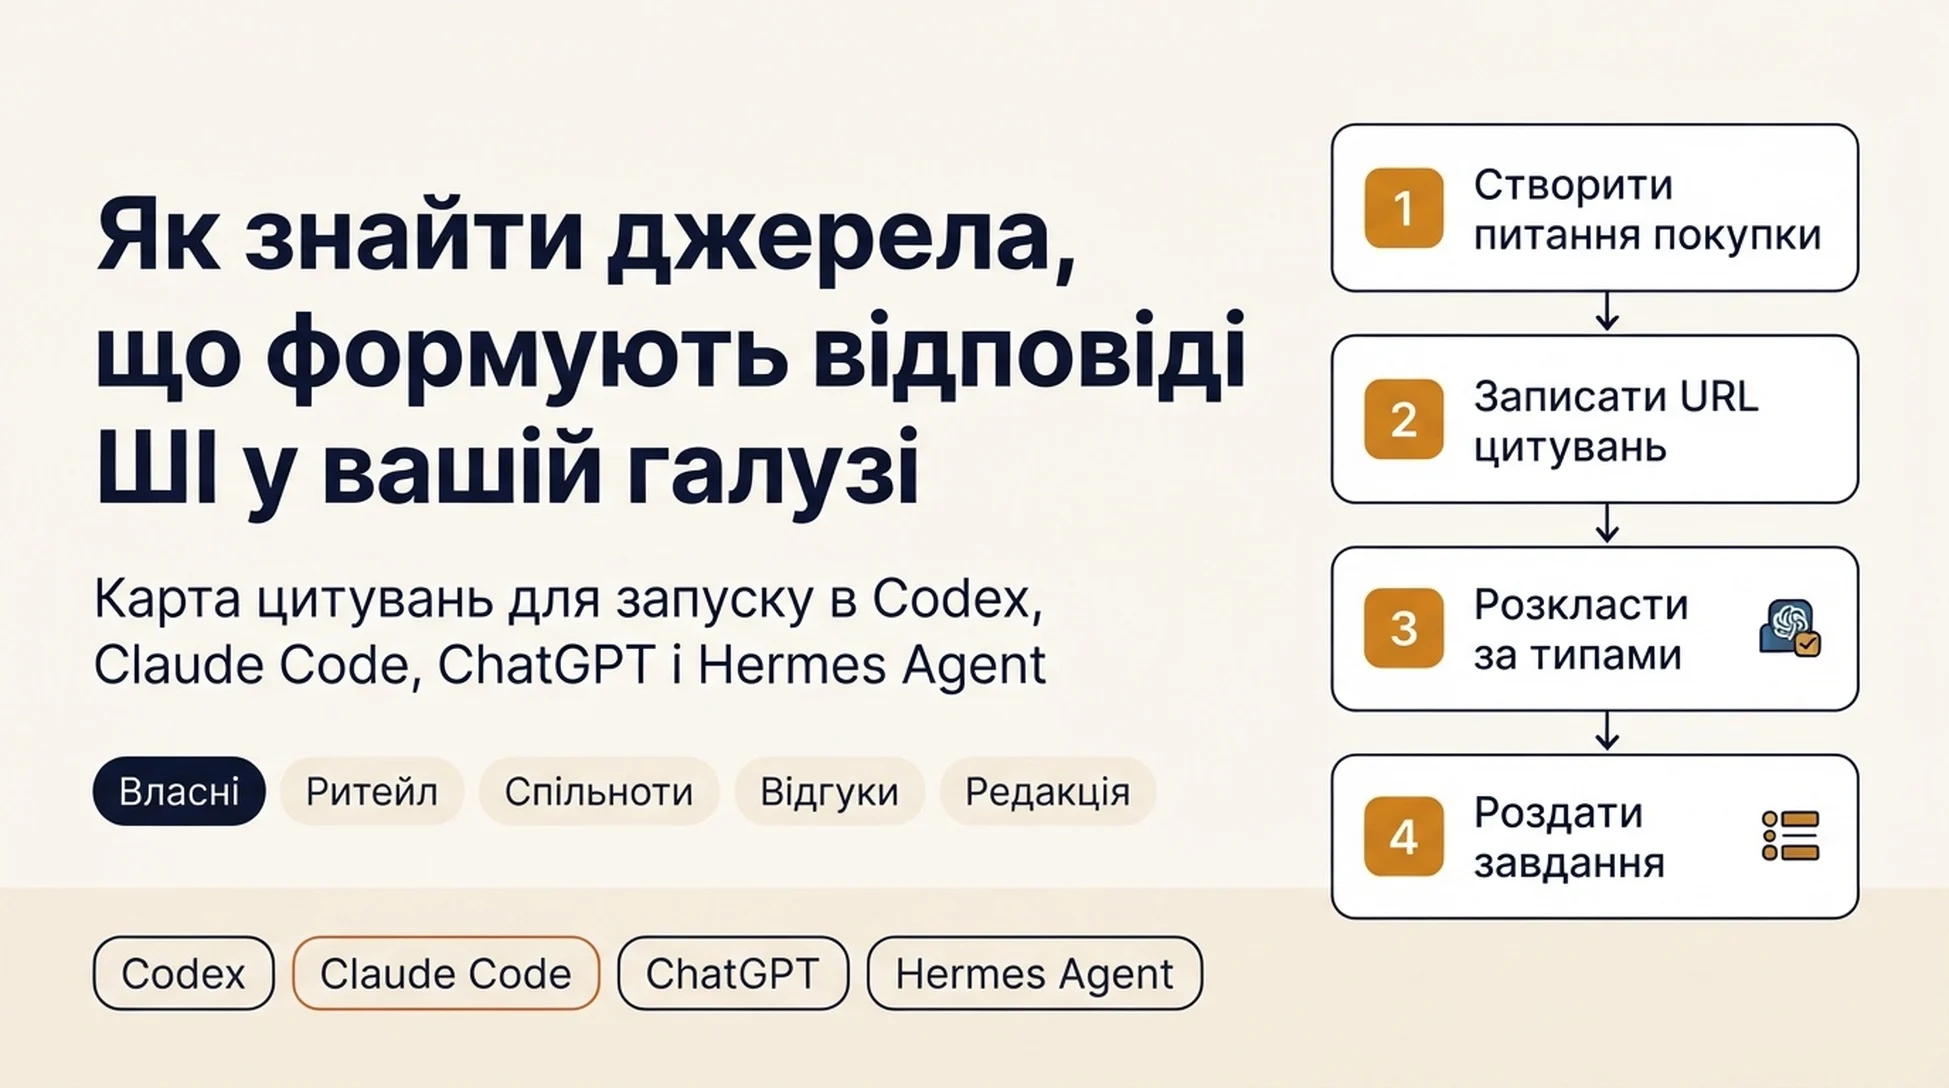
Карта цитувань — це запис того, які сторінки ШІ-рушій справді витягнув, коли відповідав на запитання ваших покупців. Не того, чи з'явився ваш бренд у відповіді. А того, з яких джерел цю відповідь було зібрано.
Я проганяв це в достатній кількості категорій, щоб знати: перший результат зазвичай тверезить. Команди припускають, що відповіді тримаються на їхньому власному сайті. Найчастіше це не так. В одній B2B-категорії сторінки самого вендора давали мізерну частку, а сайт відгуків, який ніхто не заявив, робив основну роботу.
У цьому й сенс вправи. Ви перестаєте вгадувати й починаєте дивитися на реальні сторінки.
Наприкінці цього розбору у вас буде:
- Від 10 до 20 справжніх запитань про покупку для однієї категорії товару чи послуги, сформульованих так, як їх поставив би клієнт
- Кожне запитання прогнане в тих ШІ-рушіях, якими реально користуються ваші покупці, з зафіксованими й датованими джерелами цитування
- Ці джерела розкладені за типами, щоб ви бачили, звідки беруться відповіді у вашій категорії
- Короткий список сторінок, де цитується конкурент, а вас немає, кожна із законним наступним кроком
- Відповідальні та дата перегляду, щоб карта не згнила у спільній теці
Для кого це: внутрішній відповідальний за SEO, GEO чи контент, або стратег агенції, який може пропонувати роботу, навіть якщо виконує її хтось інший. Платний інструмент не обов'язковий, хоча на масштабі допомагає.
Що потрібно заздалегідь: браузер, таблиця та доступ на читання до власного сайту. Для версій з агентом — робоча інсталяція обраного агента й тека, на яку його можна спрямувати.
Час: близько двох годин на перший прохід по одній категорії. Приблизно 45 хвилин із них — прогін запитів і копіювання джерел. Саме ці 45 хвилин варто віддати агенту, а решта — та частина, де потрібне ваше судження.
Що означає «готово»: ви можете назвати три-чотири типи джерел, на яких тримаються відповіді у вашій категорії, показати конкретні сторінки, де вас немає, а конкурент є, і передати комусь завдання з доданим посиланням. Якщо у вас лише список доменів і невиразне відчуття, що Reddit важливий, — ви не закінчили.
Позиція Auspia: більшість команд ідуть прямо до «нам потрібно більше згадок бренду», бо жодного разу не дивилися, з чого відповідь насправді зібрана. Карта перетворює це невиразне відчуття на сторінку, за якою можна діяти.
Перед початком: два рішення, що визначають усе
Два вибори визначають, що дасть решта роботи. Обидва легко зробити неправильно, і обидва незручно скасовувати потім.
Виберіть одну категорію, а не весь бізнес. У компанії, яка продає софт і водночас веде сервісний напрям, дві різні екосистеми джерел. Картувати обидві одразу — означає отримати середнє, яке не описує жодну з них. Візьміть категорію з найбільшим доходом і відкладіть решту на наступний квартал.
Обирайте рушії усвідомлено. Google AI Overview, ChatGPT, Perplexity і Gemini не черпають з однієї криниці. Джерело, що втратило вагу в одному рушії, може досі враховуватися в іншому. Запускайте щонайменше два. Якщо не знаєте які, запитайте відділ продажів, який інтерфейс згадують клієнти, або подивіться реферальний трафік з ШІ-доменів.
Проведіть межу одразу. Це вправа на спостереження, а не на доведення. Ви фіксуєте те, що рушій повернув у конкретний день. Відповіді змінюються від запуску до запуску, тож одне спостереження — це точка даних, а не тренд. Ставте дату на все, інакше весь файл стане непридатним за місяць.
Крок 1: зібрати набір запитань
Напишіть від 10 до 20 запитань, які клієнт поставив би під час вибору. Не ключові слова. Запитання, словами самого клієнта.
Це крок, який люди проскакують, і саме він вирішує, чи варта решта зусиль. Набір запитань з вивантаження ключових слів дає карту того, як люди шукають. Набір із нотаток про дзвінки з продажами дає карту того, як люди купують. Це не один і той самий список.
Матеріали, з яких можна брати запитання:
- Найчастіші передпокупкові запитання, які отримує відділ продажів
- Тікети підтримки за перші 30 днів після покупки
- Блок «інші запитують» за вашими основними комерційними запитами
- Ваше власне дослідження ключових слів, переписане у форму запитань
- Порівняльні запити конкурентів, які роблять ваші покупці
Змішуйте форми запитань, бо кожна тягне різні джерела.
Форма запитання | Приклад | Які джерела зазвичай виходять |
|---|---|---|
Відповідність категорії | «На що дивитися середній логістичній компанії при виборі інструменту маршрутизації?» | Редакційні добірки, сайти відгуків |
Пряме порівняння | «Інструмент A чи інструмент B для команди з 20 осіб?» | Сторінки порівнянь, гілки спільнот |
Ризик і заперечення | «Інструмент A справді достатньо безпечний для медичних даних?» | Форуми, розбори відповідності, документація вендора |
Ціна й цінність | «Скільки інструмент A реально коштує за місце?» | Сторінки цін, гілки спільнот, сайти відгуків |
Впровадження | «Скільки триває перехід з інструменту B?» | Документація, розбори на YouTube, форуми |
Очікуваний результат: таблиця, де на кожне запитання один рядок, один стовпець під форму запитання й один під рушій, у якому ви його прогнаєте.
Перевірка якості: перечитайте список і запитайте себе, чи набрав би реальний покупець кожне з них. Якщо запитання зрозуміле лише тому, хто вже знає таксономію вашого продукту, перепишіть його. Десять запитань, які покупець справді поставить, кращі за п'ятдесят, що звучать як вивантаження ключових слів.
Шлях відновлення: якщо не набирається десять запитань, це проблема дослідження, а не картування. Дістаньте останні 20 нотаток про дзвінки з продажами або останні 50 тікетів підтримки й витягніть запитання звідти, перш ніж продовжувати.
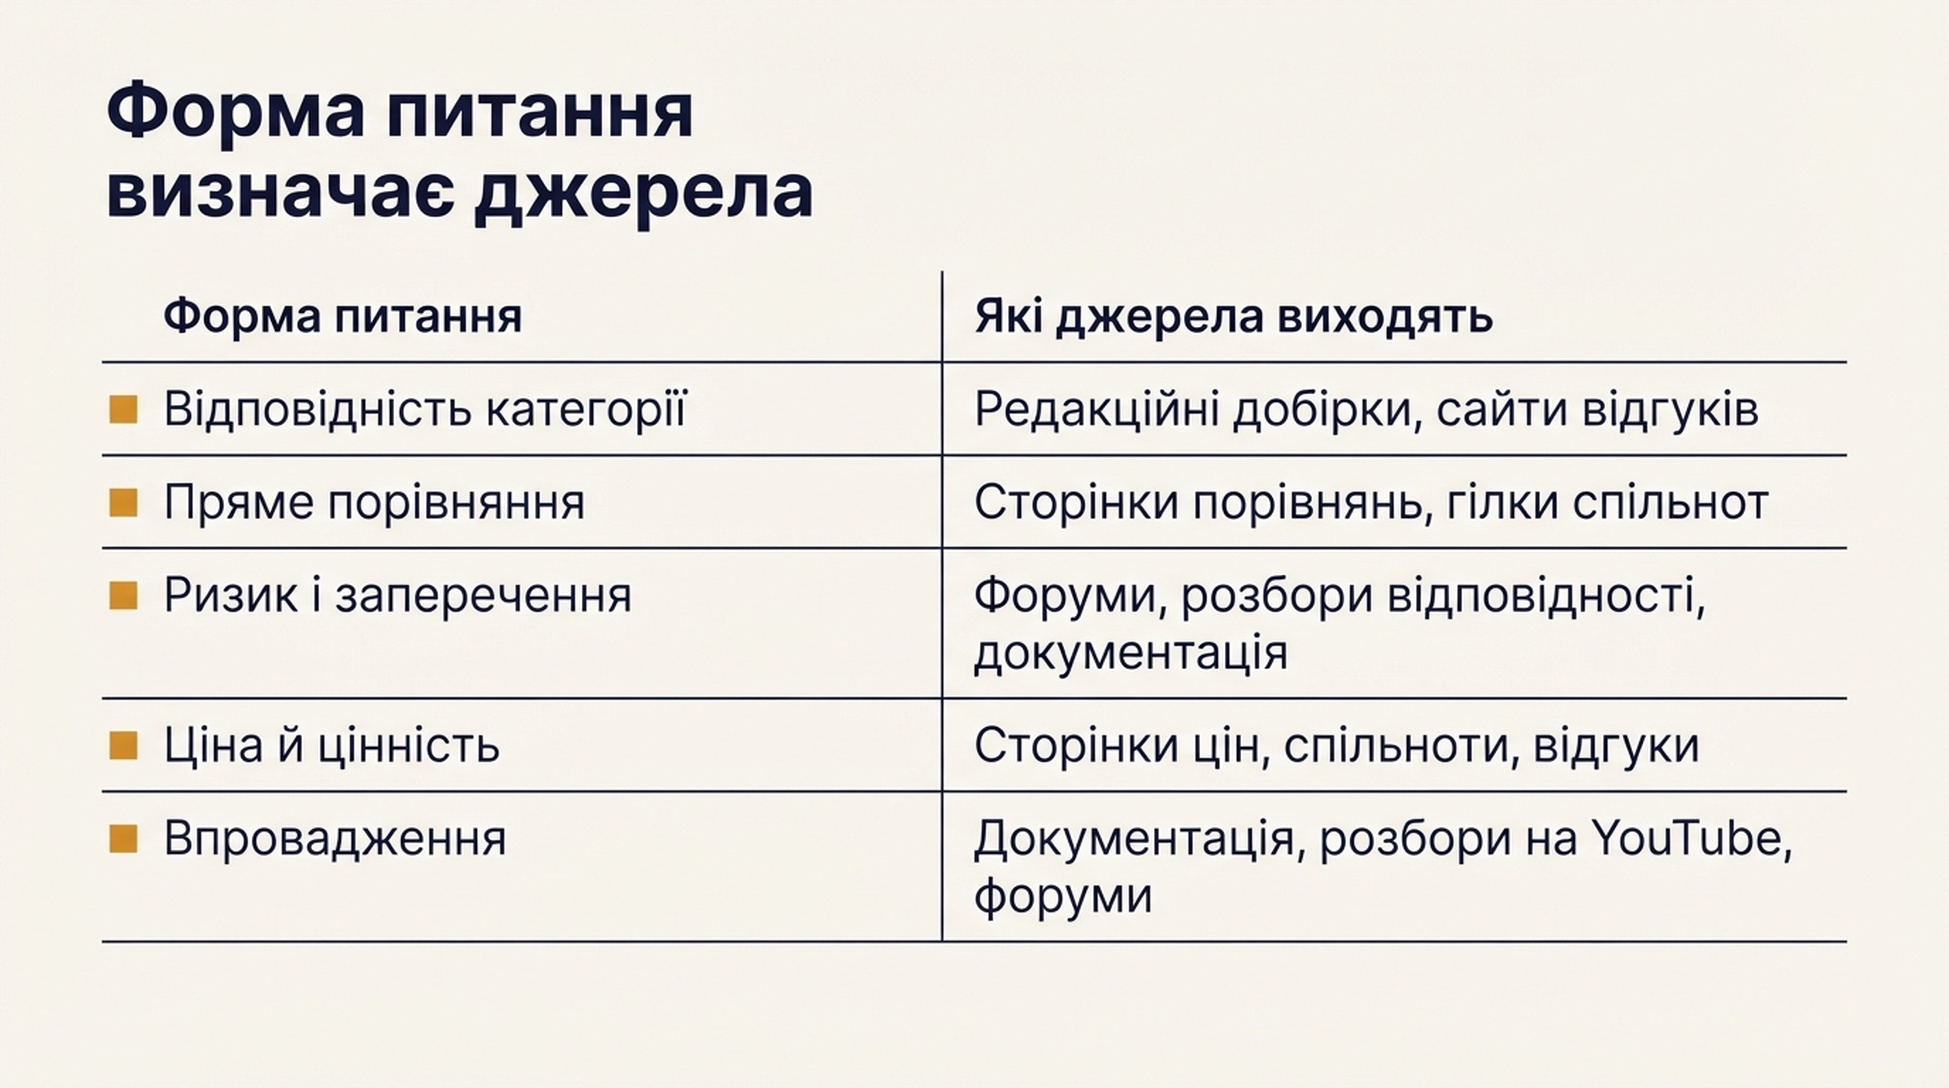
Форма запитання — прихована змінна. Запитання про пряме порівняння й запитання про ризик щодо одного й того самого продукту повертають різні джерела.
Крок 2: прогнати запитання й зафіксувати джерела
Тут механічне ядро, і тут ручна робота розвалюється. Зробіть п'ять запитань руками, щоб зрозуміти, як має виглядати результат. Далі автоматизуйте решту.
Для кожного запитання в кожному рушії:
- Відкрийте новий діалог. Попередній контекст змінює те, що рушій дістане.
- Поставте запитання рівно так, як записали.
- Відкрийте панель цитувань або список джерел. У більшості рушіїв це маленька іконка біля відповіді, а не видимий список.
- Зафіксуйте кожен процитований URL, а також домен і тип джерела.
- Позначте дату, рушій і те, чи були взагалі цитування.
Фіксуйте в такій структурі:
Поле | Чому важливо |
|---|---|
ID запитання | Пов'язує кожне спостереження із запитанням про покупку |
Рушій | Дозволяє згодом розділити закономірності за рушіями |
Дата й час | Відповіді дрейфують; рядок без дати непридатний за місяць |
Процитований URL | Реальна сторінка, а не лише домен |
Домен | Для групування й підрахунку частоти |
Тип джерела | власний, ритейл/маркетплейс, спільнота, каталог відгуків, редакційний |
Конкурент присутній | Так/ні та який саме |
Наш бренд присутній | У відповіді, у джерелах, в обох або ніде |
На останньому рядку варто затриматися. Бренд може бути названий у відповіді, при цьому жодна його сторінка не процитована. І навпаки, бренд може бути процитований, не будучи помітно названим. Це два різні сигнали, і якщо стежити лише за «ми з'явилися», ви прочитаєте обидва неправильно. Я бачив команди, які раділи згадці зі сторінки, що сперечалася з ними.
Очікуваний результат: довга таблиця, по одному рядку на кожне процитоване джерело, запитання й рушій.
Перевірка якості: щонайменше в трьох рядках перейдіть за посиланням і переконайтеся, що процитована сторінка справді підтверджує твердження, заради якого її процитували. Рушії іноді цитують сторінку, яка згадує тему, але не відповідає на запитання. Такі рядки — шум, їх треба позначати.
Шлях відновлення: якщо рушій не повернув цитувань за запитанням, це знахідка, а не провал. Запишіть нуль джерел і йдіть далі. Запитання, на які відповідають без вилучення, — це запитання, на які ваш контент вплинути не може.
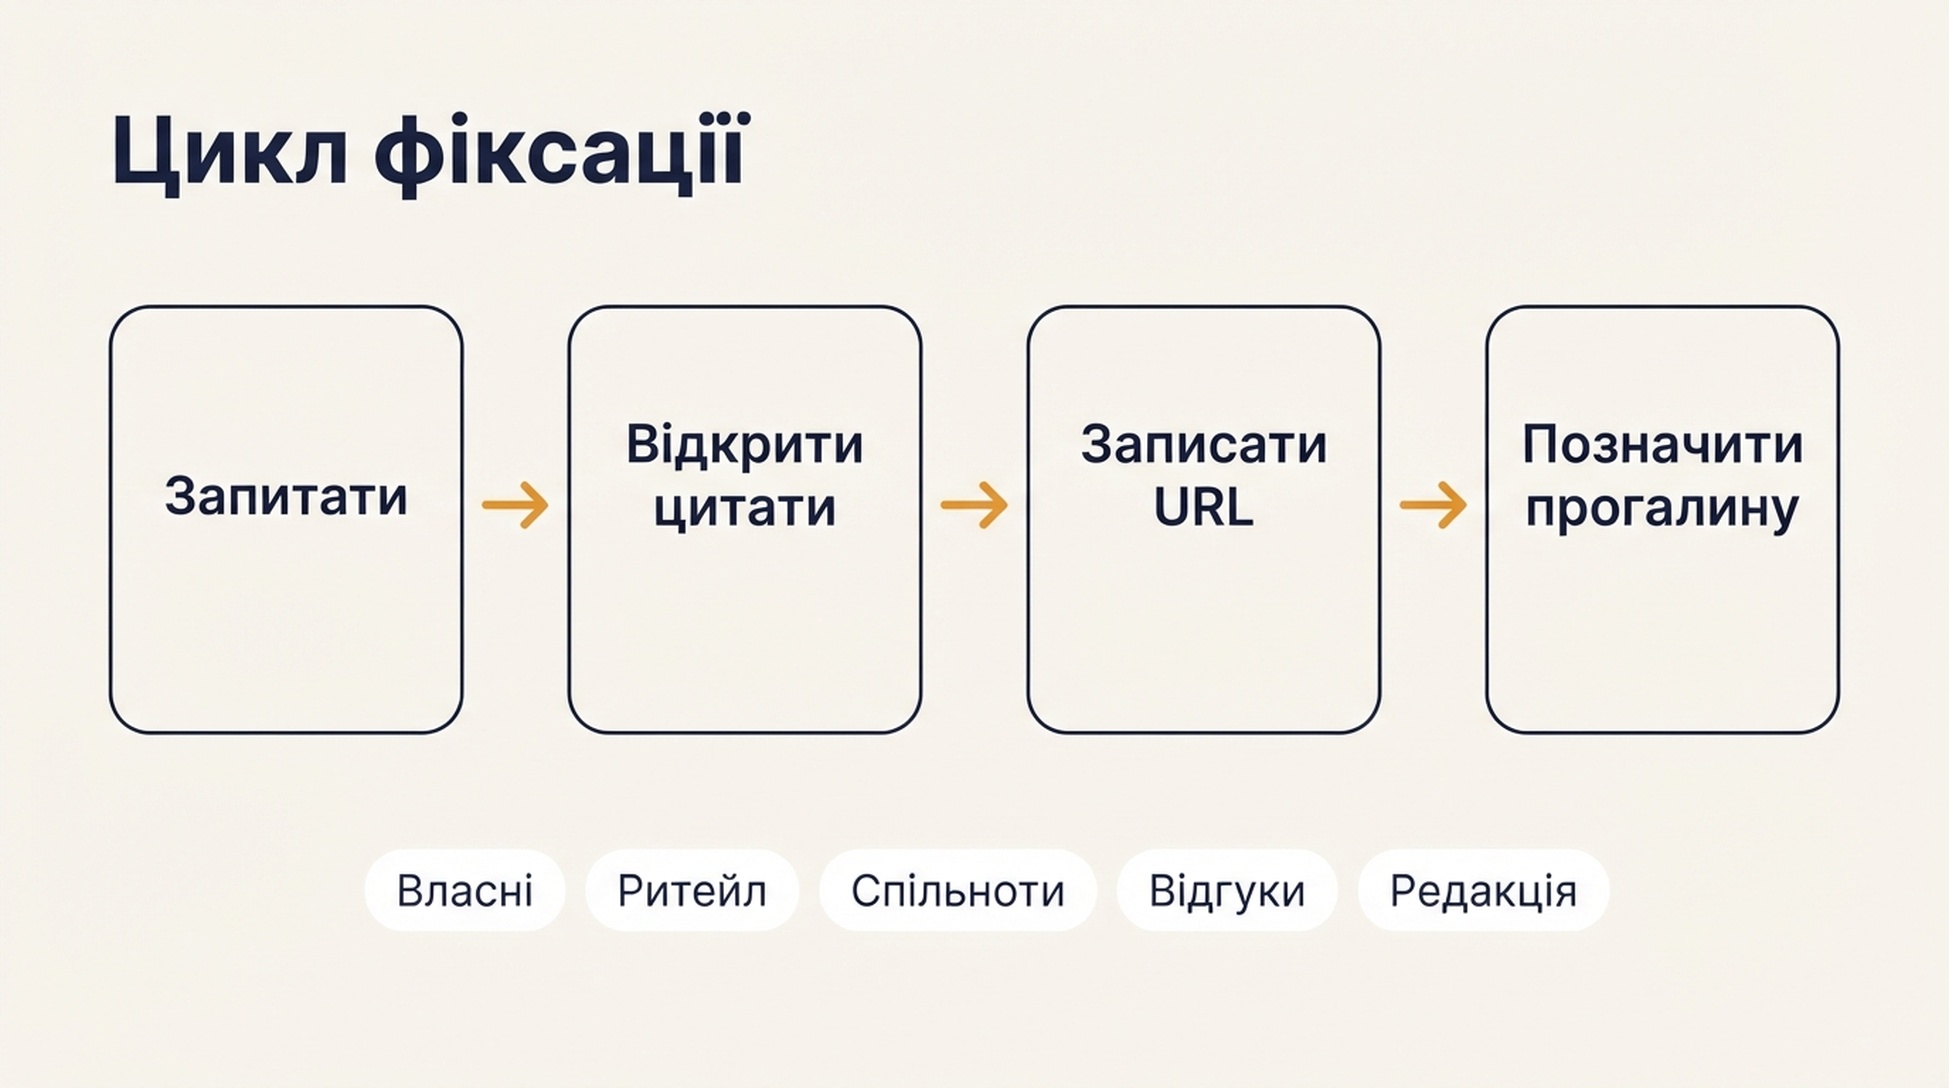
Цикл простий і нудний. Саме це поєднання робить його добрим кандидатом для передачі агенту.
Крок 3: розкласти джерела за типами
Тепер стисніть довгу таблицю в картину вашої категорії. Віднесіть кожен процитований URL до одного з п'яти кошиків:
- Власні: ваш сайт або сайт конкурента
- Ритейл і маркетплейси: картки товарів, сторінки порівняння цін, магазини застосунків
- Спільноти та UGC: Reddit, YouTube, Quora, форуми, проіндексовані гілки Discord
- Каталоги відгуків і B2B-платформи: G2, Capterra, Clutch, Trustpilot, галузеві каталоги
- Незалежні редакційні та довідкові: галузева преса, новини, Wikipedia, розбори аналітиків, незалежні блоги
Порахуйте за кошиками й за рушіями — і карта цитувань готова.
Ви шукаєте не окреме число. Ви шукаєте форму. Одні категорії тримаються майже цілком на гілках спільнот і галузевій пресі, а власний сайт бренду майже не бере участі. Інші підім'яті картками товарів, бо відповідь лежить у самій картці. Ця суміш залежить від того, що запитують покупці, а не від того, наскільки добрий чийсь сайт. Це важко прийняти, коли ви вклали в сайт два роки.
Очікуваний результат: невелика таблиця, по одному рядку на тип джерела, по одному стовпцю на рушій, із часткою процитованих джерел.
Перевірка якості: якщо один кошик тримає понад приблизно 70% ваших цитувань, перевірте п'ять URL усередині, чи справді вони цього типу. Один високотрафіковий агрегатор може маскуватися під редакційне джерело, будучи насправді каталогом.
Шлях відновлення: якщо цифри виглядають випадковими, ви, найімовірніше, змішали форми запитань і цим приховали закономірність. Розділіть таблицю за формою запитання й подивіться знову. Запитання про ціну та про ризик часто дають цілком різні профілі джерел.
Крок 4: знайти прогалини, де цитують конкурента, а вас ні
Відфільтруйте довгу таблицю до рядків, де з'являється конкурент, а ваш бренд — ні. Цей відфільтрований список і є вашим робочим списком. Він значно корисніший за загальний мандат «нам потрібно більше згадок», бо в кожному рядку вже є URL і клієнтське запитання. Віддайте його комусь у понеділок — людина одразу почне.
Для кожного рядка відкрийте процитовану сторінку й дайте відповідь на три запитання:
- Чи справді наш продукт доречний на цій сторінці?
- Якщо так, чого бракує: картки, яку ми ніколи не заявляли, порівняння, де нас немає, гілки, де нас ніхто не згадав, відгуку, який ми ніколи не просили?
- Яка мінімальна законна дія поставила б нас туди?
Третє запитання — там, де вмикається дисципліна. Дія залежить від кошика. Помилка тут — це коли SEO-фахівець починає розсилати журналістам холодні листи про гілку на Reddit.
Тип джерела | Законна дія | Чого робити не варто |
|---|---|---|
Каталог відгуків | Заявити й заповнити профіль, попросити клієнтів залишити відгуки | Купувати відгуки або підсівати фальшиві |
Гілка спільноти | Відповісти чесно як названий співробітник, розкривши свій зв'язок | Астротурфінг або посилання без внеску |
Редакційний | Запропонувати справді корисний кут, який видання ще не висвітлювало | Розіслати один і той самий пресреліз на 200 доменів |
Маркетплейс або картка ритейлу | Полагодити характеристики, зображення й опис, щоб факти вилучалися | Набити картку ключовими словами |
Власна сторінка | Перебудувати так, щоб конкретний факт було легко знайти й процитувати | Додати блок FAQ, який ні на що не відповідає |
Очікуваний результат: відфільтрований і пріоритезований список. Сортуйте за частотою появи джерела у вашому наборі запитань, а не за тим, наскільки престижно звучить домен. Гілка форуму, процитована в шести з двадцяти запитань, стоїть вище за галузеве видання, процитоване один раз, і до того ж із нею значно простіше працювати.
Перевірка якості: для кожного залишеного рядка переконайтеся, що можете назвати відповідне клієнтське запитання. Якщо не можете — приберіть рядок. Сторінки, процитовані за запитаннями, яких ніхто у вашій воронці не ставить, лише відволікають.
Шлях відновлення: якщо відфільтрований список усе ще величезний, ви фільтрували недостатньо жорстко. Обмежте перший прохід десятьма рядками, відсортованими за частотою цитування, і розберіться з ними, перш ніж знову відкривати повний список.
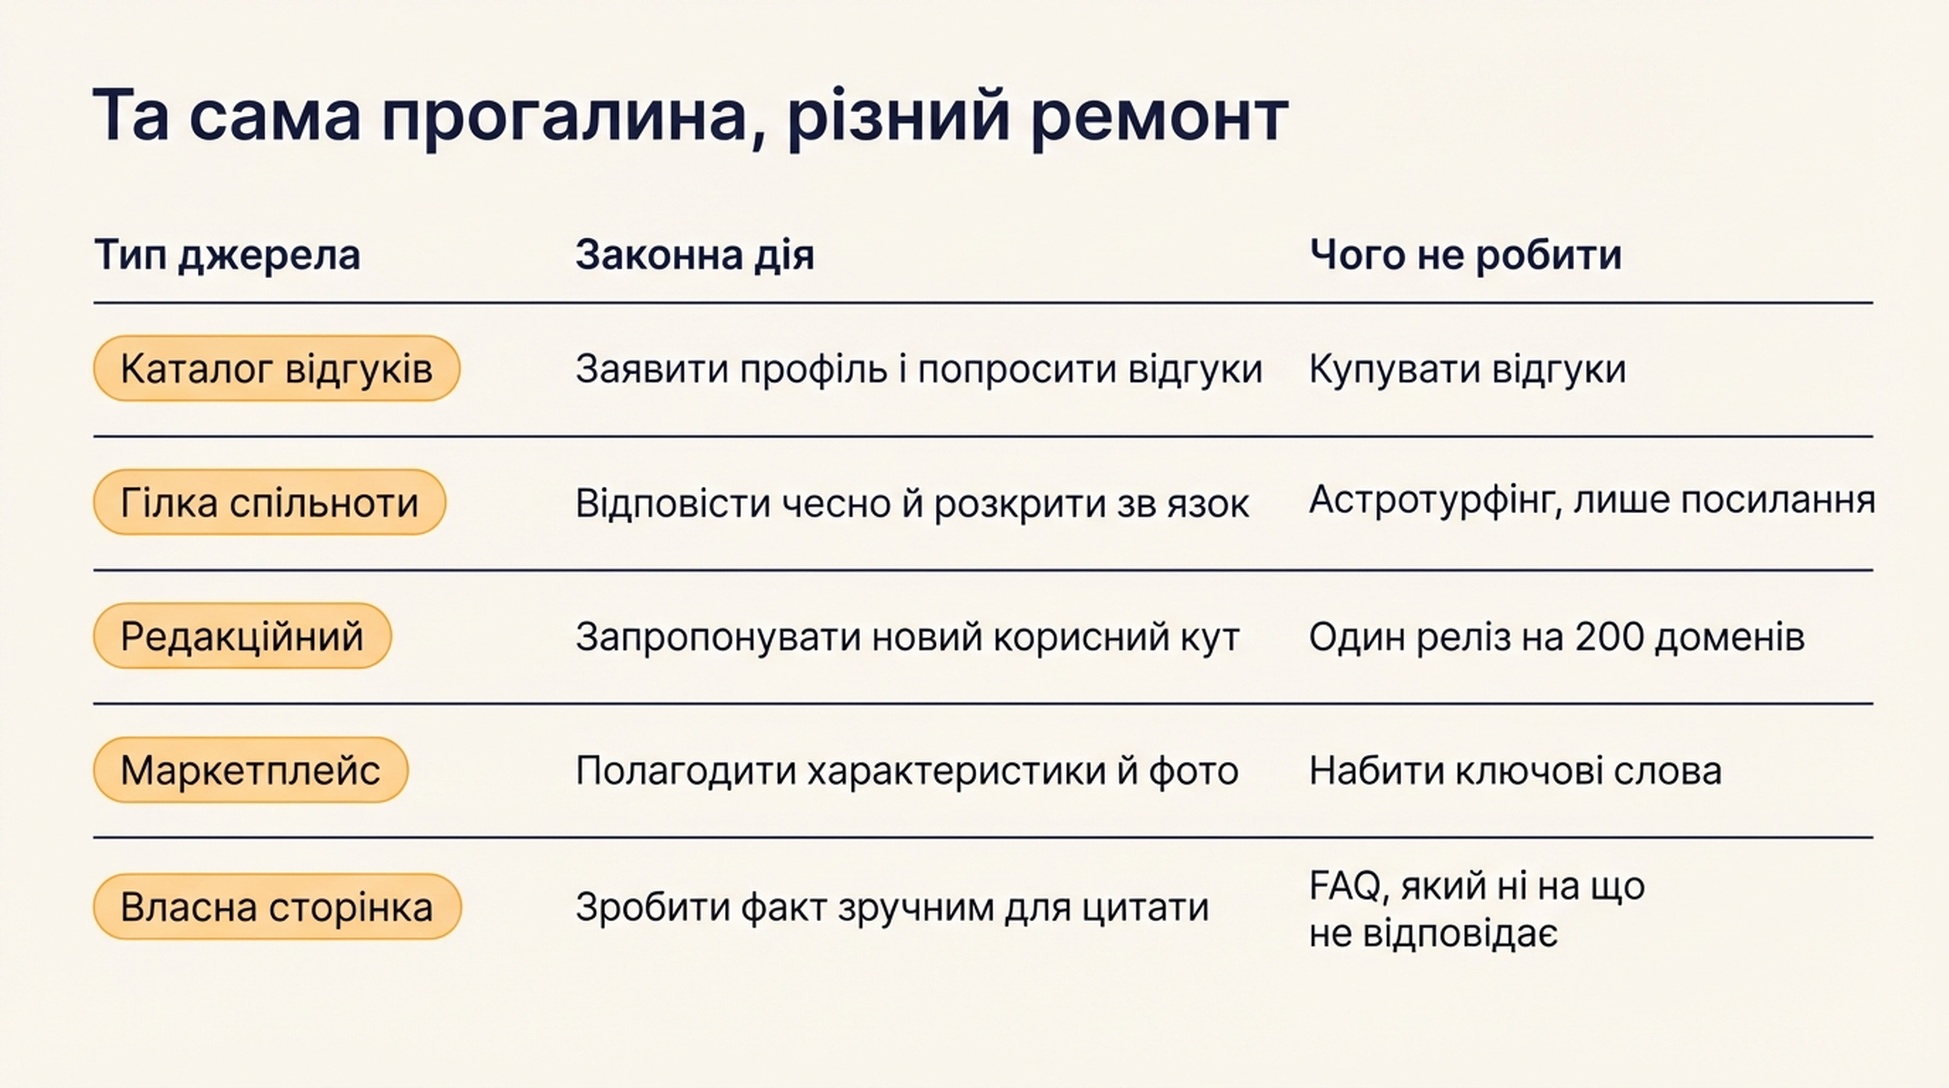
Та сама прогалина, але різний ремонт. Ставитися до кожного відсутнього цитування як до проблеми аутричу — так команди й доходять до того, що пропонують редактору гілку з Reddit.
Крок 5: віддати механічну половину агенту
Кроки 2 і 3 з'їдають найбільше часу й вимагають найменше судження. Це і є визначення роботи, яку варто делегувати. Набір запитань і пріоритезація залишаються за людиною, бо це дві точки, де помилка судження обнуляє всю вправу.
Чотири агенти нижче вміють виконувати той самий метод. Змінюється те, де живе метод і як повертається результат. Обирайте за цим, а не за тим, яка модель виграла бенчмарк цього місяця.
Codex
Ідеальний, коли ви хочете, щоб карта жила в репозиторії й на кожному запуску давала артефакт, який можна перевірити. Якщо ваш сайт уже в git, це шлях із найменшим тертям.
Зберіть теку проєкту з каталогом citation-map/, файлом questions.csv із вашим набором запитань і SKILL.md, у якому описано метод: які рушії перевіряти, які поля фіксувати, як класифікувати джерело й як має виглядати вихідний файл. Тримайте по одному файлу на запуск, названому за датою, щоб накопичувати історію, а не перезаписувати її.
Попросіть Codex прогнати запитання, дописати рядки у файл поточного запуску й видати зведену таблицю частки джерел за рушіями. Оскільки результат — файл у репозиторії, ви отримуєте diff, який можна перевірити, перш ніж щось стане остаточним. Цей етап перевірки і є суттю: ви контролюєте класифікації, а не переробляєте збір.
Одне правило має бути в SKILL.md у будь-якому разі: агент фіксує те, що спостерігав, і не виводить цитування, якого не бачив. Вигадані джерела — найшкідливіший режим відмови в цьому процесі. Письмове правило плюс вибіркова перевірка трьох рядків зупиняє більшість, і три рядки для перевірки мають змінюватися від запуску до запуску.
Claude Code
Ідеальний, коли метод треба читати проти явно написаної політики, і коли ви хочете переглядати зібрані сторінки в довгому контексті.
Покладіть метод у CLAUDE.md або в проєктний skill, включно з визначеннями типів джерел і точною схемою виводу. Спрямуйте Claude Code на теку запуску й попросіть класифікувати кожен процитований URL, а потім позначити рядки, де вміст сторінки насправді не підтверджує цитування.
Друге завдання — те, за яке варто платити. Прочитати 200 процитованих сторінок і оцінити, чи справді кожна відповідає на запитання, болісно для людини й розумно для агента з письмовим стандартом. Попросіть прапорець упевненості на кожен рядок і переглядайте самі лише рядки з низькою впевненістю.
ChatGPT
Ідеальний, коли потрібна мінімальна вартість налаштування, а робота — це одна сесія, а не повторюваний запуск.
Вставте метод як користувацьку інструкцію або збережений проєктний промпт, додайте список запитань і працюйте партіями за рушіями. Просіть вивід таблицею з точно тими самими стовпцями, що на кроці 2, щоб вона одразу вставлялася в таблицю.
Загвоздка в тому, що ChatGPT — теж одна з поверхонь, які ви вимірюєте. Якщо ви картуєте цитування самого ChatGPT, робіть це в чистій сесії без завантаженого методу, інакше забрудните спостереження. Використовуйте одну сесію для збору, іншу — для систематизації.
Hermes Agent
Ідеальний, коли ви хочете, щоб метод зберігався як skill і поліпшувався від запуску до запуску без повторних пояснень.
Встановіть метод карти цитувань як skill Hermes разом із набором запитань і схемою виводу, потім запускайте за ритмом; щомісяця зазвичай правильно. Оскільки skill і його пам'ять зберігаються, правки першого місяця переходять у другий. Якщо агент помилково класифікував каталог як редакційне джерело, ви правите правило один раз.
Ціна — постійна пам'ять потребує періодичного перегляду. Раз на кілька запусків читайте файл skill і перевіряйте, що накопичені правки все ще описують потрібний вам метод, а не купу разових винятків, які ніхто не може пояснити.
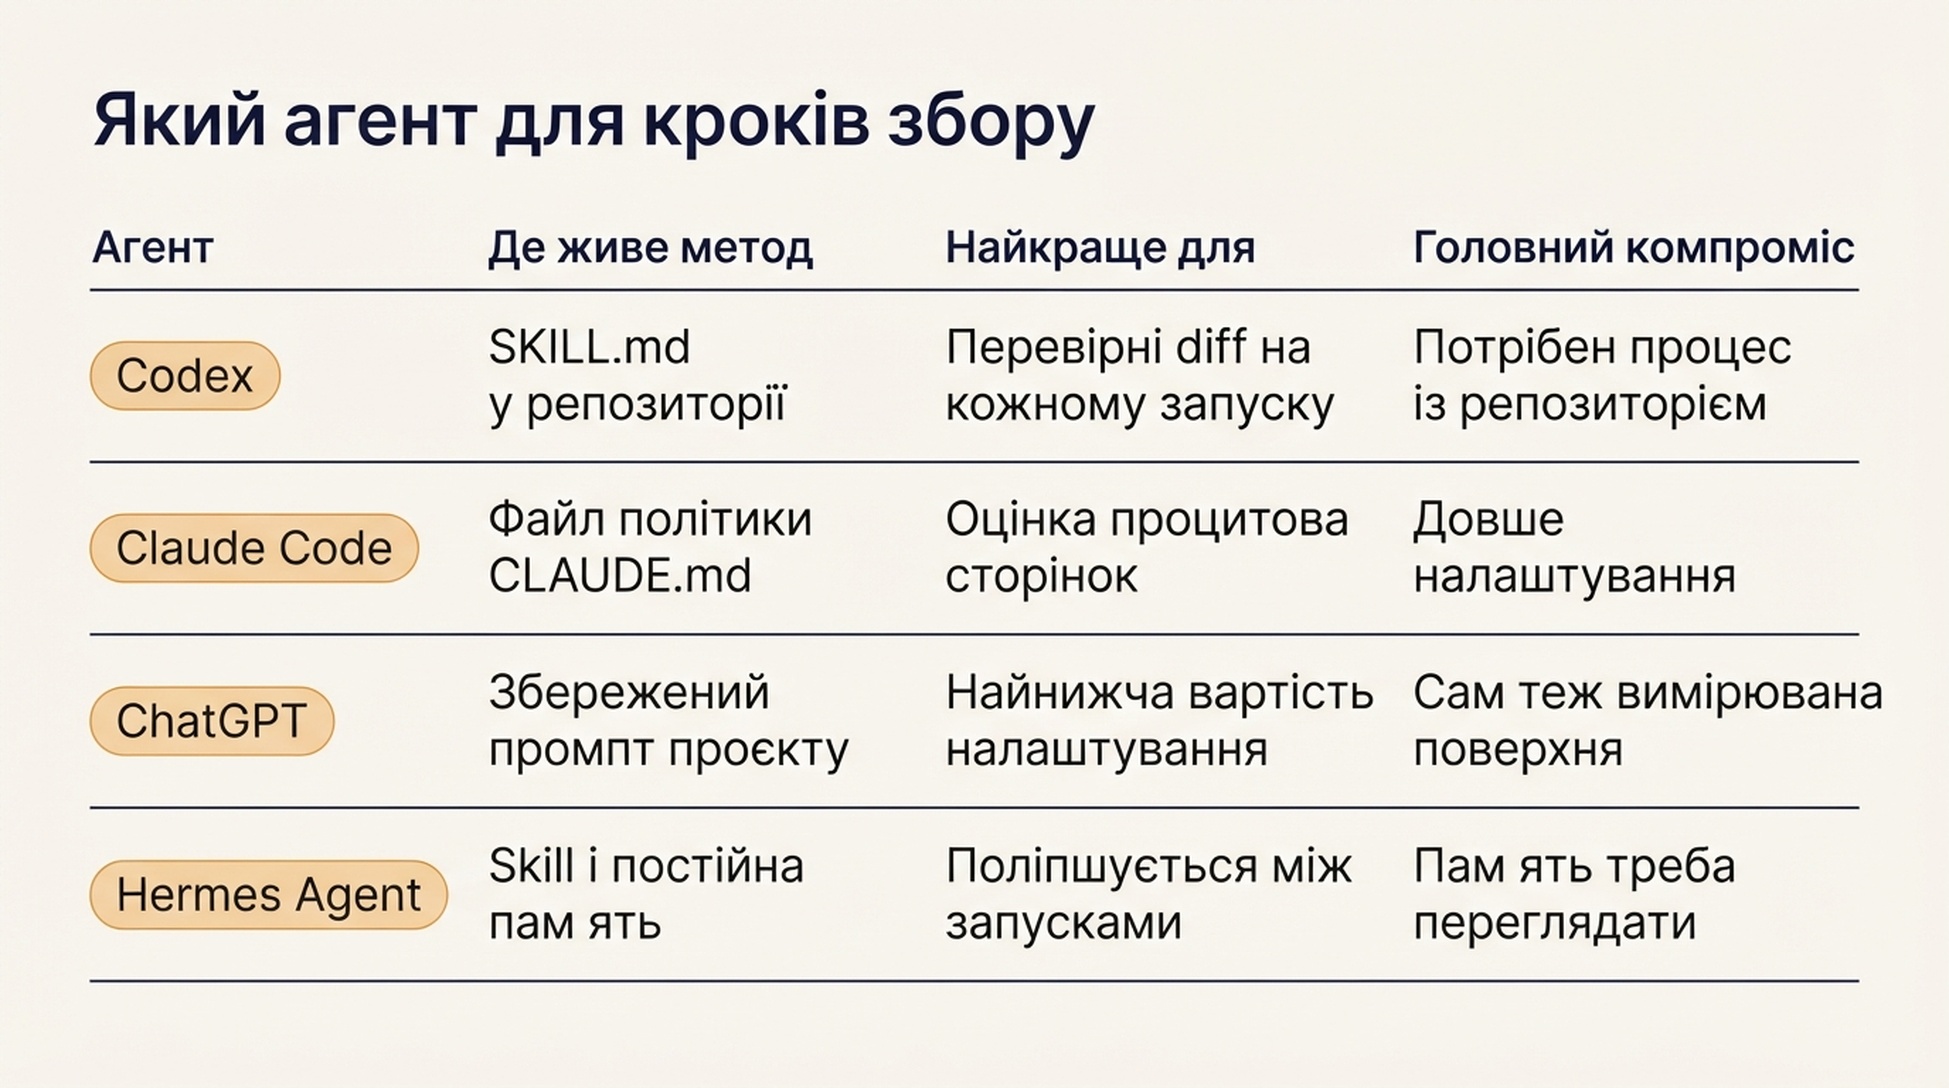
Усі чотири виконують ті самі п'ять кроків. Обирайте за тим, де має жити метод, а не за тим, яка модель набрала більше балів у бенчмарку.
Крок 6: перевірити карту, перш ніж діяти
Не розподіляйте роботу за неперевіреною картою. Спершу прогнайте цю перевірку. П'ять хвилин тут економлять квартал зусиль не в той бік.
- Прогоніть три запитання повторно через тиждень. Якщо суміш джерел змінюється повністю, ваш набір запитань занадто волатильний або вибірка занадто мала. Фіксуйте розкид, а не вважайте перший прохід істиною. Якийсь розкид нормальний; повна зміна — це попередження.
- Підтверджуйте рушій, а не лише відповідь. Джерело, що з'явилося в Perplexity, може бути відсутнім у ChatGPT за тим самим запитанням. Тримайте стовпці за рушіями окремо у зведенні; об'єднаний підсумок приховує саме той сигнал, який вам потрібен.
- Перевіряйте й власні цитування. Якщо ваш бренд процитовано, відкрийте сторінку. Іноді рушій цитує сторінку, де про вас відгукуються критично, або ту, яку ви не контролюєте. Це корисна інформація, а не перемога.
- Підтверджуйте дату в кожному рядку. Карта цитувань без дат потім ні з чим не порівнюється.
- Перевіряйте кількість джерел. Якщо одне запитання повернуло 40 джерел, а решта три, перевірте, чи не зібрали ви панель «схожі» замість реальних цитувань.
Що означає «готово»: ви можете віддати колезі зведену таблицю й один відфільтрований робочий список, і він зможе діяти, не питаючи, що означає будь-який із рядків.
Підтримання карти
Прогоньте повний прохід раз на квартал за тим самим набором запитань і легкий прохід щомісяця за п'ятьма запитаннями з найбільшою комерційною цінністю. Зберігайте минулі запуски. Цікавий сигнал рідко у знімку. Він у дрейфі: тип джерела, що тихо зростає, або конкурент, який почав з'являтися в кошику, де його раніше не було.
Переглядайте набір запитань двічі на рік. Запитання про покупку змінюються разом із вашим продуктом і ринком, а застарілий набір дає карту категорії, яку ви більше не продаєте.
Одне, чому варто опиратися: перетворювати це на дашборд. Результат — робочий список із відповідальними та URL. Якщо в кінці ні в кого немає завдання, карта не зробила свою роботу.
Часті запитання
Чи потрібен для цього платний інструмент видимості в ШІ? Ні. Ручна версія працює для однієї категорії й займає пів дня. Інструменти окупаються, коли ви відстежуєте багато категорій чи ринків, або коли хочете історичні лінії тренду, не підтримуючи таблицю самостійно.
Скільки запитань достатньо? Від 10 до 20 на категорію. Менше десяти — і ви не відрізните закономірність від збігу. Більше двадцяти на першому проході — і ви не закінчите аналіз, а саме аналіз породжує робочий список.
Чи включати запитання, де ми вже з'являємося? Так. Знати, які джерела вас тримають, так само корисно, як знати, які вас пропускають, і це підказує, що захищати при зміні контенту.
Що якщо рушій щоразу дає різну відповідь? Це нормально й варто фіксувати. Прогоніть одне й те саме запитання тричі й позначте розкид. Якщо набір джерел щоразу цілком різний, вважайте запитання низьконадійним і дайте йому меншу вагу під час пріоритезації.
Чи можна просто використати список джерел рушія, не відкриваючи сторінки? Для первинного збору — так. Для рядків, за якими ви будете діяти, — ні. Треба прочитати сторінку, щоб оцінити, чи справді ваш бренд там доречний і що було б корисним внеском.
Чим це відрізняється від відстеження позицій? Відстеження позицій каже, де ваші сторінки з'являються у списку результатів. Карта цитувань каже, з яких сторінок зібрано відповідь. Сторінка може бути першою й ніколи не цитуватися, а сторінка, яка ніде не ранжується, може бути хребтом відповіді. Саме цей розрив і виправдовує витрачені пів дня.
Автор: Ethan Marlowe, керівник вимірювань GEO в Auspia, проаналізував понад 500 промптів. Пише про відстеження промптів, звітність із цитувань, дашборди видимості та про те, як відрізнити реальну зміну видимості в ШІ від шуму між запусками.