Apa yang akan Anda hasilkan
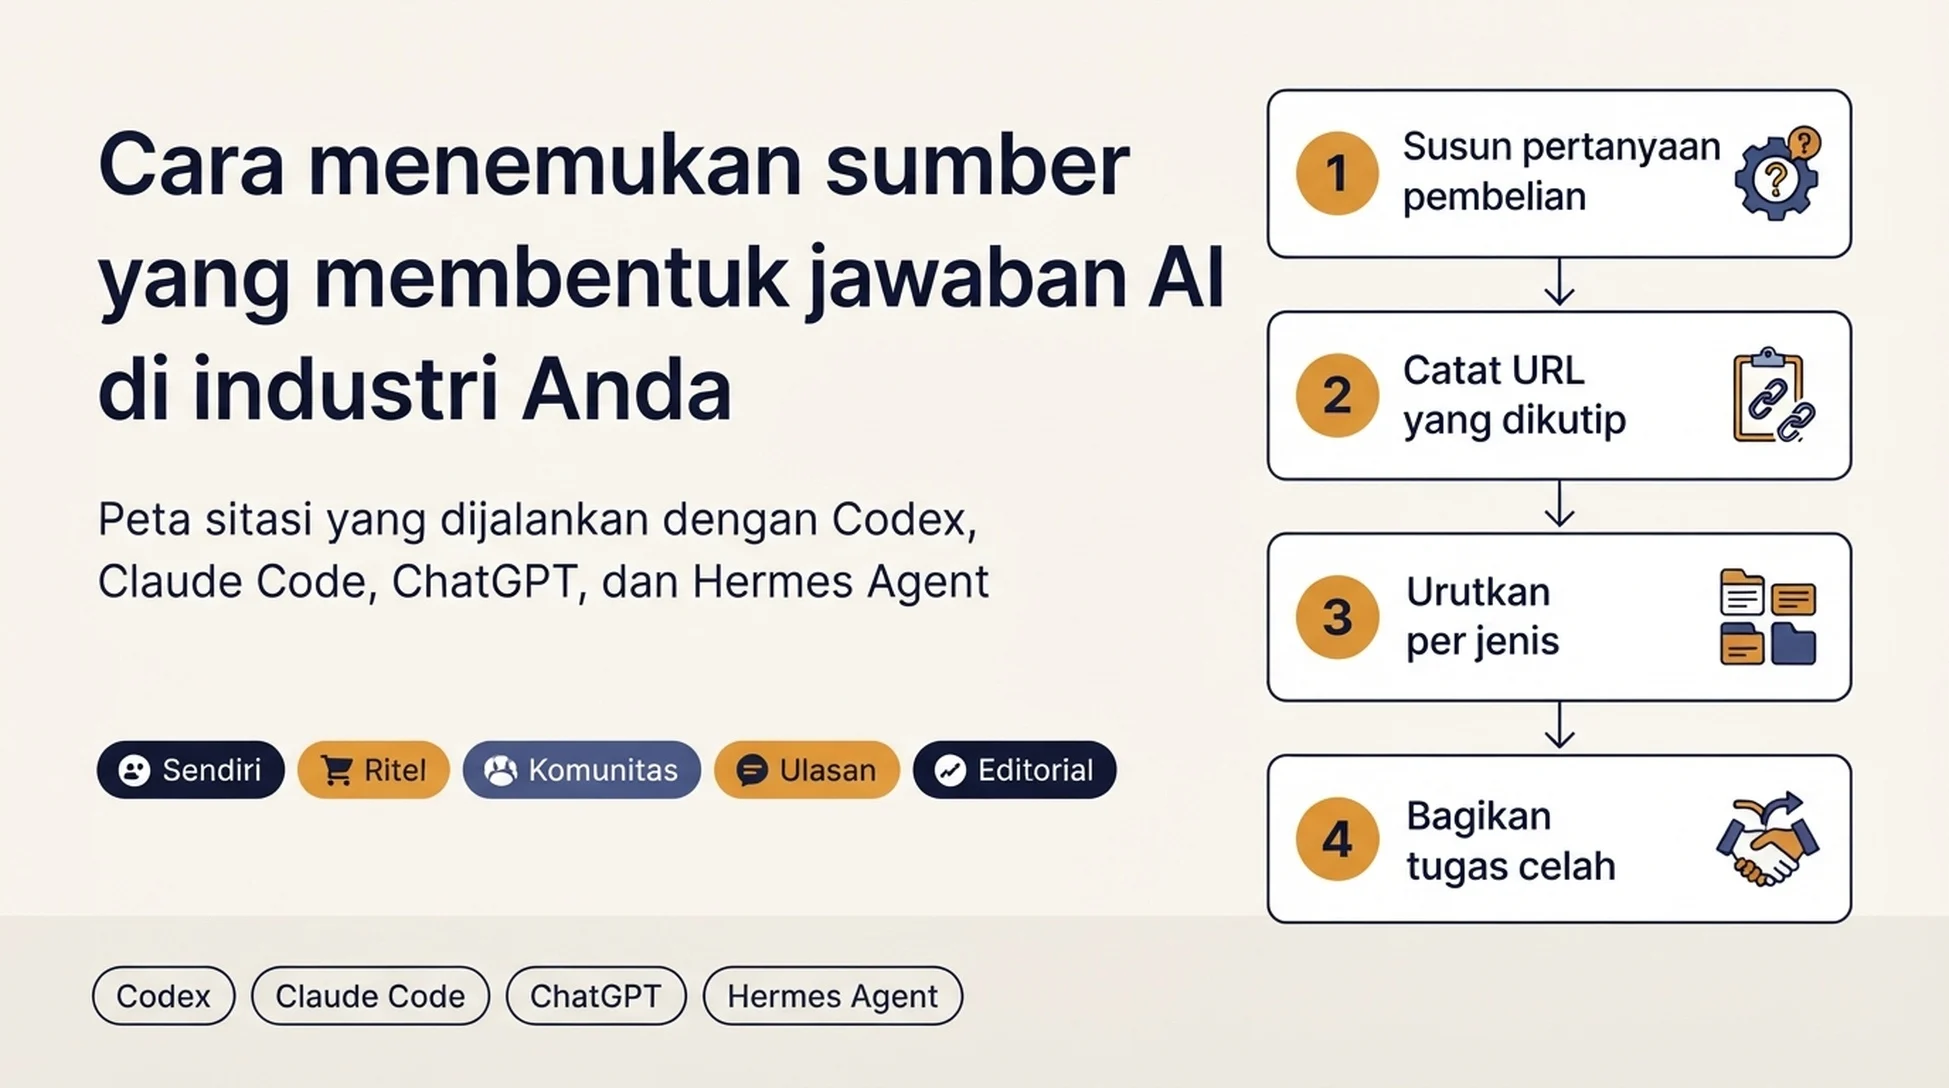
Peta sitasi adalah catatan tentang halaman mana yang benar-benar diambil mesin AI saat menjawab pertanyaan calon pembeli Anda. Bukan apakah merek Anda muncul di jawaban itu. Melainkan dari sumber mana jawaban tersebut disusun.
Saya sudah menjalankan ini di cukup banyak kategori untuk tahu bahwa hasil pertama biasanya memalukan. Tim mengasumsikan situs mereka sendiri yang menopang jawaban-jawaban itu. Sering kali bukan. Di satu kategori B2B, halaman milik vendor sendiri hanya menyumbang sebagian sangat kecil, sementara situs ulasan yang belum diklaim siapa pun mengerjakan sebagian besar bebannya.
Itulah alasan melakukannya. Anda berhenti menebak dan mulai melihat halaman yang sebenarnya.
Di akhir panduan ini Anda akan punya:
- 10 sampai 20 pertanyaan pembelian nyata untuk satu kategori produk atau layanan, ditulis seperti cara pelanggan bertanya
- Setiap pertanyaan dijalankan di mesin AI yang benar-benar dipakai pembeli Anda, dengan sumber yang dikutip dicatat dan diberi tanggal
- Sumber-sumber itu diurutkan berdasarkan jenis, sehingga Anda bisa melihat dari mana jawaban di kategori Anda berasal
- Daftar singkat halaman tempat kompetitor dikutip dan Anda tidak, masing-masing dengan langkah berikutnya yang sah
- Penanggung jawab dan tanggal tinjauan, supaya peta ini tidak membusuk di folder bersama
Untuk siapa: penanggung jawab SEO, GEO, atau konten di internal, atau strategi agensi yang bisa merekomendasikan pekerjaan meski yang mengeksekusi orang lain. Tidak ada alat berbayar yang wajib, meski akan membantu pada skala besar.
Prasyarat: peramban, spreadsheet, dan akses baca ke situs Anda sendiri. Untuk versi agen, instalasi agen pilihan Anda yang sudah berjalan, plus folder yang bisa Anda arahkan kepadanya.
Waktu: sekitar dua jam untuk putaran pertama di satu kategori. Sekitar 45 menit dari waktu itu untuk menjalankan prompt dan menyalin sumber. Empat puluh lima menit itulah bagian yang layak diserahkan ke agen, dan sisanya bagian yang butuh penilaian Anda.
Arti selesai: Anda bisa menyebut tiga atau empat jenis sumber yang menopang jawaban di kategori Anda, menunjuk halaman spesifik tempat Anda absen dan kompetitor hadir, dan menyerahkan tugas dengan URL terlampir ke orang lain. Kalau Anda hanya punya daftar domain dan perasaan samar bahwa Reddit itu penting, Anda belum selesai.
Pandangan Auspia: sebagian besar tim langsung menuju "kita butuh lebih banyak sebutan merek" karena mereka tidak pernah melihat dari apa jawaban itu sebenarnya disusun. Peta inilah yang mengubah insting samar itu menjadi halaman yang bisa ditindaklanjuti.
Sebelum mulai: dua keputusan yang menentukan segalanya
Dua pilihan menentukan apa yang dihasilkan bagian selanjutnya. Keduanya mudah salah dan keduanya merepotkan untuk dibatalkan nanti.
Pilih satu kategori, bukan seluruh bisnis. Perusahaan yang menjual perangkat lunak sekaligus menjalankan lini layanan punya dua ekosistem sumber yang berbeda. Memetakan keduanya sekaligus menghasilkan rata-rata yang tidak menggambarkan keduanya. Ambil kategori dengan pendapatan terbesar dan tunda sisanya ke kuartal berikutnya.
Pilih mesinnya dengan sadar. Google AI Overview, ChatGPT, Perplexity, dan Gemini tidak menimba dari sumur yang sama. Sumber yang kehilangan bobot di satu mesin bisa tetap berpengaruh di mesin lain. Jalankan minimal dua. Kalau tidak tahu mana dua, tanya tim penjualan antarmuka mana yang disebut pelanggan, atau periksa lalu lintas rujukan dari domain AI.
Tetapkan batas sekarang. Ini latihan pengamatan, bukan pembuktian. Anda mencatat apa yang dikembalikan mesin pada hari tertentu. Jawaban berubah antar eksekusi, jadi satu pengamatan adalah satu titik data, bukan tren. Beri tanggal pada semuanya, kalau tidak seluruh berkas jadi tidak berguna dalam sebulan.
Langkah 1: menyusun set pertanyaan
Tulis 10 sampai 20 pertanyaan yang akan diajukan pelanggan saat memilih. Bukan kata kunci. Pertanyaan, dalam kata-kata pelanggan sendiri.
Ini langkah yang orang buru-buru lewati, dan inilah langkah yang menentukan apakah sisanya layak dikerjakan. Set pertanyaan yang dibuat dari ekspor kata kunci menghasilkan peta tentang bagaimana orang mencari. Set yang dibuat dari catatan panggilan penjualan menghasilkan peta tentang bagaimana orang membeli. Keduanya bukan daftar yang sama.
Bahan yang bisa dipakai:
- Pertanyaan pra-pembelian yang paling sering diterima tim penjualan
- Tiket dukungan dari 30 hari pertama setelah pembelian
- Blok "orang juga bertanya" pada kueri komersial utama Anda
- Riset kata kunci Anda sendiri, ditulis ulang dalam bentuk pertanyaan
- Pencarian perbandingan kompetitor yang dilakukan pembeli Anda
Campur bentuk pertanyaannya, karena masing-masing menarik sumber yang berbeda.
Bentuk pertanyaan | Contoh | Sumber yang biasanya muncul |
|---|---|---|
Kesesuaian kategori | "Apa yang harus diperhatikan perusahaan logistik menengah saat memilih alat perutean?" | Daftar editorial, situs ulasan |
Perbandingan langsung | "Alat A atau alat B untuk tim 20 orang?" | Halaman perbandingan, utas komunitas |
Risiko dan keberatan | "Apakah alat A benar-benar cukup aman untuk data kesehatan?" | Forum, ulasan kepatuhan, dokumentasi vendor |
Harga dan nilai | "Berapa biaya alat A per kursi sebenarnya?" | Halaman harga, utas komunitas, situs ulasan |
Implementasi | "Berapa lama migrasi dari alat B?" | Dokumentasi, tutorial YouTube, forum |
Hasil yang diharapkan: spreadsheet dengan satu baris per pertanyaan, satu kolom untuk bentuk pertanyaan, dan satu kolom untuk mesin tempat Anda akan menjalankannya.
Pemeriksaan kualitas: baca ulang daftarnya dan tanyakan apakah pembeli nyata akan mengetik setiap pertanyaan. Kalau sebuah pertanyaan hanya masuk akal bagi orang yang sudah paham taksonomi produk Anda, tulis ulang. Sepuluh pertanyaan yang benar-benar diajukan pembeli mengalahkan lima puluh yang terdengar seperti ekspor kata kunci.
Jalur pemulihan: kalau Anda tidak sampai sepuluh pertanyaan, itu masalah riset, bukan pemetaan. Ambil 20 catatan panggilan penjualan terakhir atau 50 tiket dukungan terakhir dan tarik pertanyaan dari sana sebelum melanjutkan.
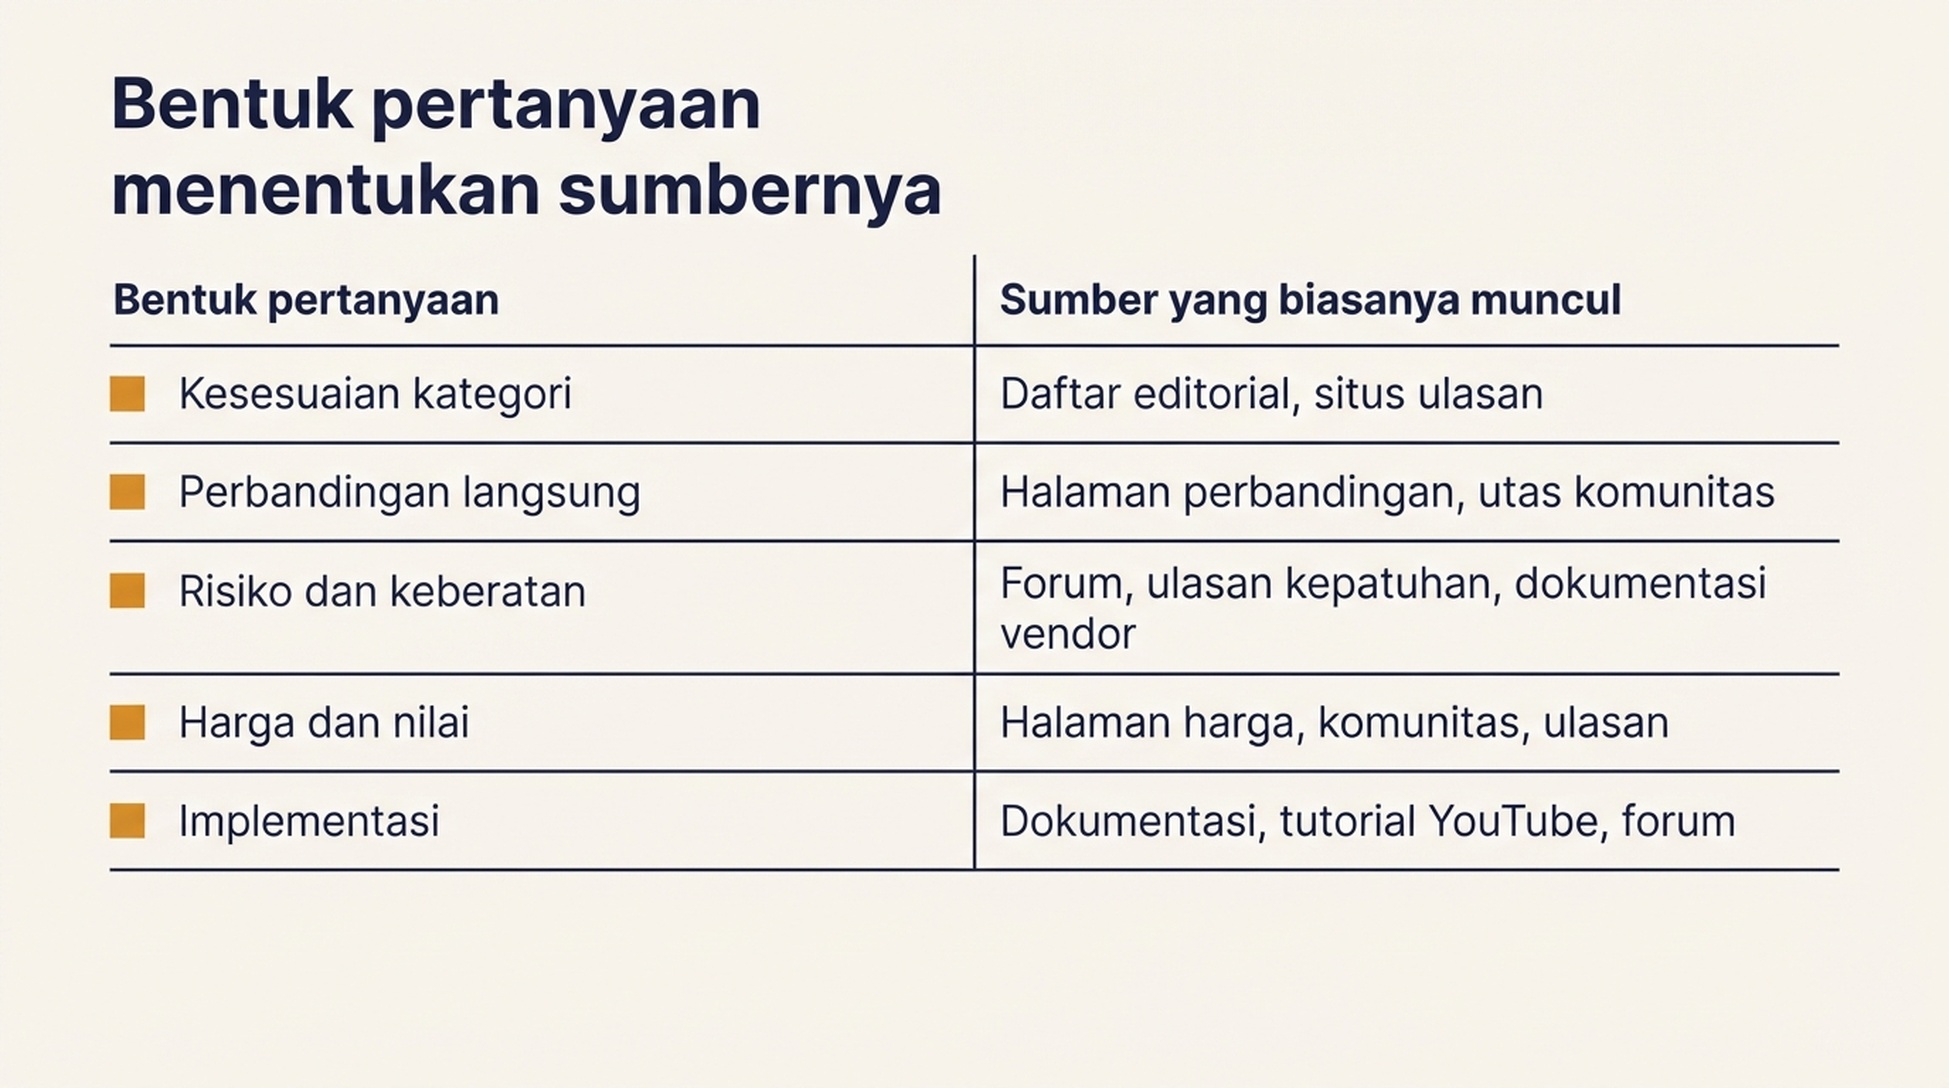
Bentuk pertanyaan adalah variabel tersembunyi. Pertanyaan perbandingan langsung dan pertanyaan risiko tentang produk yang sama tidak mengembalikan sumber yang sama.
Langkah 2: menjalankan pertanyaan dan mencatat sumbernya
Di sinilah inti mekanisnya, dan di sinilah kerja manual berantakan. Kerjakan lima pertanyaan dengan tangan supaya Anda paham bagaimana hasilnya seharusnya. Setelah itu otomatiskan sisanya.
Untuk setiap pertanyaan, di setiap mesin:
- Buka percakapan baru. Konteks sebelumnya mengubah apa yang diambil mesin.
- Ajukan pertanyaan persis seperti yang Anda tulis.
- Buka panel sitasi atau daftar sumber. Di sebagian besar mesin ini ikon kecil di dekat jawaban, bukan daftar yang terlihat.
- Catat setiap URL yang dikutip, plus domain dan jenis sumbernya.
- Catat tanggal, mesin, dan apakah jawaban itu mengutip apa pun.
Catat dengan struktur ini:
Kolom | Kenapa penting |
|---|---|
ID pertanyaan | Menyambungkan setiap pengamatan ke pertanyaan pembelian |
Mesin | Memungkinkan pemisahan pola per mesin nanti |
Tanggal dan waktu | Jawaban bergeser; baris tanpa tanggal tidak berguna dalam sebulan |
URL yang dikutip | Halaman sebenarnya, bukan hanya domain |
Domain | Untuk pengelompokan dan penghitungan frekuensi |
Jenis sumber | sendiri, ritel/marketplace, komunitas, direktori ulasan, editorial |
Kompetitor hadir | Ya/tidak, dan yang mana |
Merek kita hadir | Di jawaban, di sumber, di keduanya, atau di keduanya tidak |
Baris terakhir layak direnungkan. Merek bisa disebut dalam jawaban tanpa satu pun halamannya dikutip. Merek juga bisa dikutip tanpa disebut secara menonjol. Itu dua sinyal berbeda, dan kalau Anda hanya melacak "kita muncul atau tidak", keduanya akan salah dibaca. Saya pernah melihat tim merayakan sebutan yang datang dari halaman yang justru berargumen melawan mereka.
Hasil yang diharapkan: tabel panjang, satu baris per sumber yang dikutip, per pertanyaan, per mesin.
Pemeriksaan kualitas: pada minimal tiga baris, klik masuk dan pastikan halaman yang dikutip benar-benar menopang klaim yang jadi alasan pengutipannya. Mesin kadang mengutip halaman yang menyebut topiknya tanpa menjawab pertanyaannya. Baris seperti itu adalah derau dan harus ditandai.
Jalur pemulihan: kalau sebuah mesin tidak mengembalikan sitasi untuk suatu pertanyaan, itu temuan, bukan kegagalan. Catat sebagai nol sumber lalu lanjut. Pertanyaan yang dijawab tanpa pengambilan adalah pertanyaan yang tidak bisa dipengaruhi konten Anda sendiri.
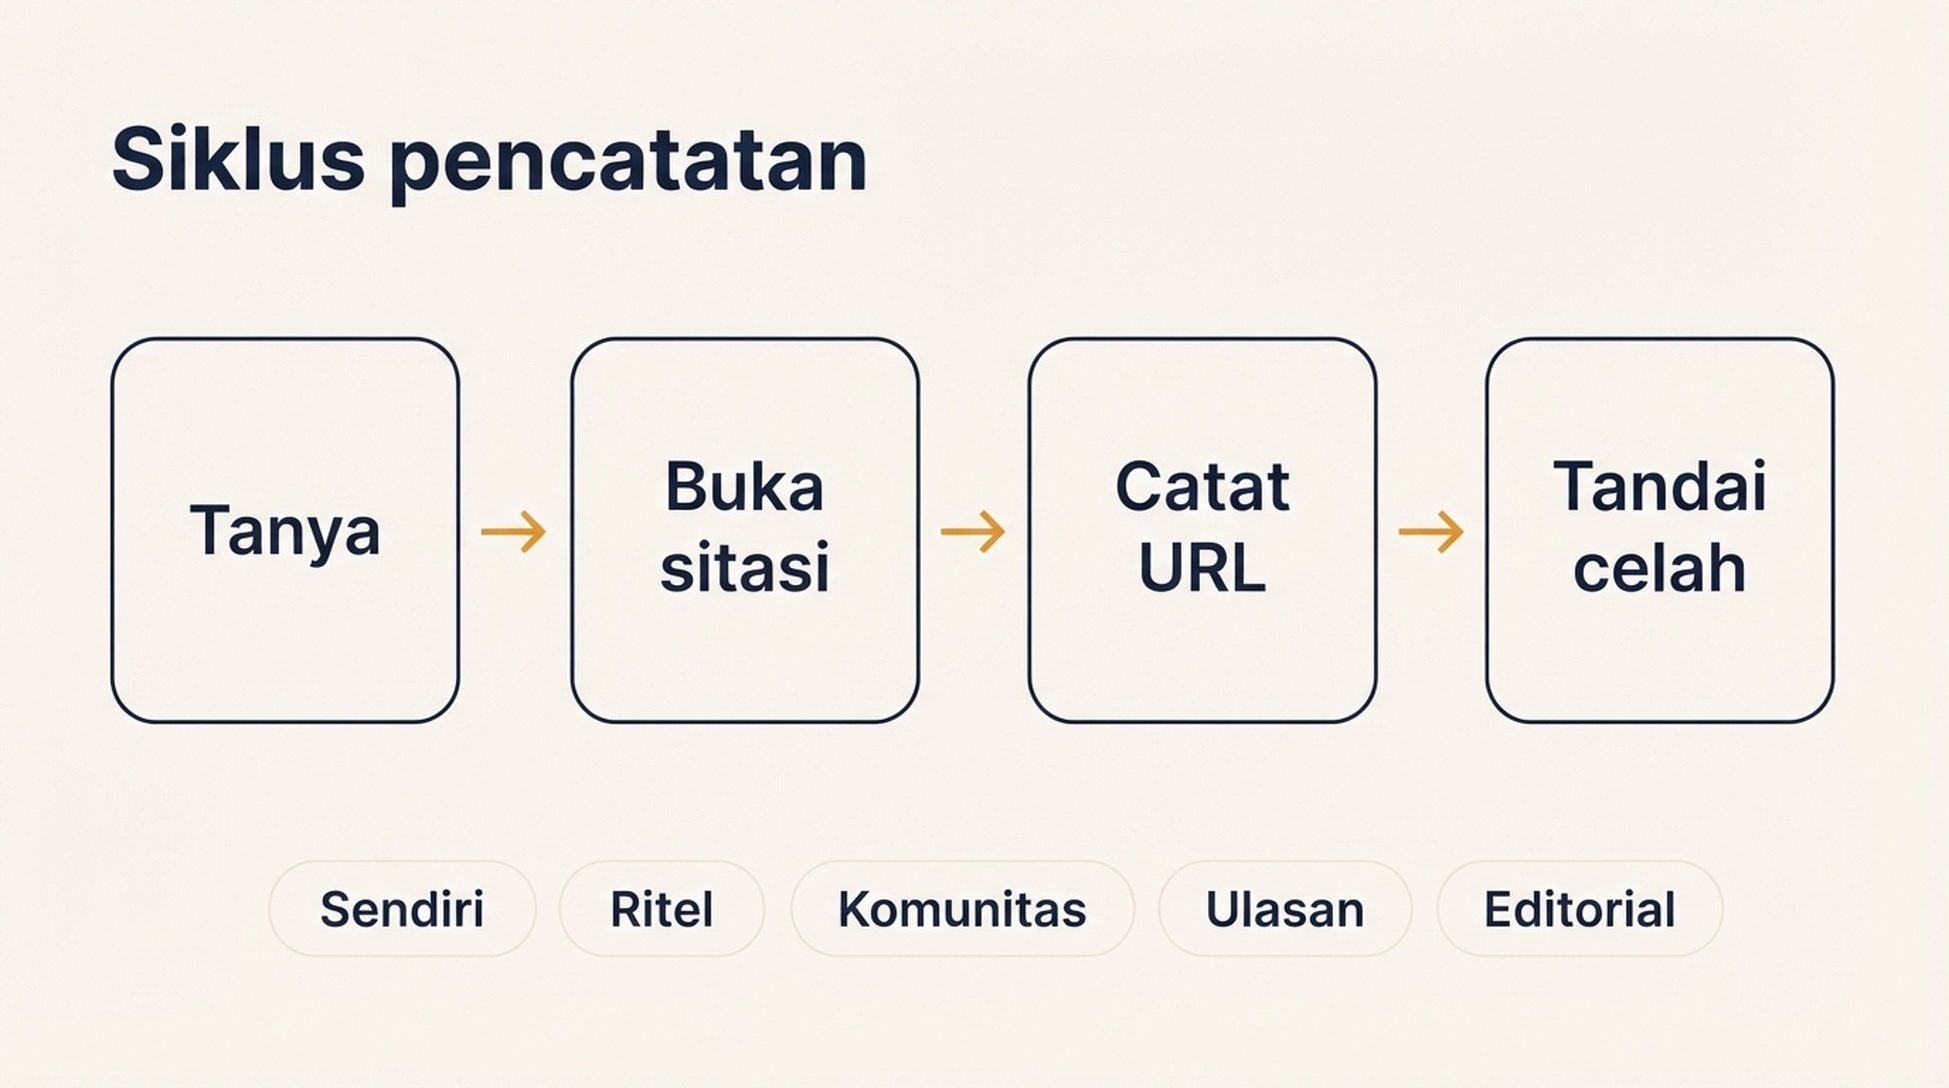
Siklusnya sederhana dan membosankan. Kombinasi itulah yang membuatnya cocok diserahkan ke agen.
Langkah 3: mengurutkan sumber berdasarkan jenis
Sekarang padatkan tabel panjang itu menjadi gambaran kategori Anda. Kelompokkan setiap URL yang dikutip ke salah satu dari lima ember:
- Sendiri: situs Anda, atau situs kompetitor
- Ritel dan marketplace: daftar produk, halaman perbandingan harga, toko aplikasi
- Komunitas dan UGC: Reddit, YouTube, Quora, forum, utas Discord yang terindeks
- Direktori ulasan dan platform B2B: G2, Capterra, Clutch, Trustpilot, direktori khusus industri
- Editorial independen dan referensi: pers industri, berita, Wikipedia, analisis analis, blog independen
Hitung per ember, per mesin, dan Anda sudah punya peta sitasinya.
Yang Anda cari bukan satu angka. Melainkan bentuknya. Sebagian kategori ditopang hampir seluruhnya oleh utas komunitas dan pers industri, sementara situs merek sendiri hampir tidak berpengaruh. Kategori lain didominasi daftar produk, karena daftarnya sendiri memuat jawabannya. Campuran ini mengikuti apa yang ditanyakan pembeli, bukan seberapa bagus situs siapa pun. Sulit diterima kalau Anda sudah menghabiskan dua tahun menggarap situsnya.
Hasil yang diharapkan: tabel kecil, satu baris per jenis sumber, satu kolom per mesin, menunjukkan porsi sumber yang dikutip.
Pemeriksaan kualitas: kalau satu ember menampung lebih dari sekitar 70% sitasi Anda, periksa lima URL di dalamnya untuk memastikan jenisnya benar. Satu agregator bertrafik tinggi bisa menyamar sebagai sumber editorial padahal sebenarnya direktori.
Jalur pemulihan: kalau angkanya tampak acak, kemungkinan Anda mencampur bentuk pertanyaan sehingga polanya tertutup. Pisahkan tabel berdasarkan bentuk pertanyaan lalu lihat lagi. Pertanyaan harga dan pertanyaan risiko sering punya profil sumber yang sama sekali berbeda.
Langkah 4: menemukan celah tempat kompetitor dikutip dan Anda tidak
Saring tabel panjang ke baris tempat kompetitor muncul dan merek Anda tidak. Daftar tersaring itulah daftar kerja Anda. Ini jauh lebih berguna daripada mandat umum "kita butuh lebih banyak sebutan", karena setiap baris sudah membawa URL dan pertanyaan pelanggan. Serahkan ke seseorang pada hari Senin, dia bisa langsung mulai.
Untuk setiap baris, buka halaman yang dikutip dan jawab tiga pertanyaan:
- Apakah produk kita benar-benar layak ada di halaman ini?
- Kalau layak, apa yang kurang: daftar yang belum pernah kita klaim, perbandingan yang kita tidak ada di dalamnya, utas tempat tidak ada yang menyebut kita, ulasan yang belum pernah kita minta?
- Apa tindakan sah terkecil yang akan menempatkan kita di sana?
Pertanyaan ketiga adalah tempat disiplin diuji. Tindakannya berbeda per ember. Salah di sini berujung pada SEO yang mengirim surel dingin ke jurnalis soal utas Reddit.
Jenis sumber | Tindakan sah | Yang jangan dilakukan |
|---|---|---|
Direktori ulasan | Klaim dan lengkapi profil, minta ulasan dari pelanggan | Membeli ulasan atau menanam ulasan palsu |
Utas komunitas | Menjawab jujur sebagai karyawan bernama jelas, mengungkap keterkaitan | Astroturfing, atau menaruh tautan tanpa kontribusi |
Editorial | Mengusulkan sudut yang benar-benar berguna dan belum dibahas media itu | Mengirim siaran pers yang sama ke 200 domain |
Marketplace atau daftar ritel | Perbaiki spesifikasi, gambar, dan deskripsi agar faktanya bisa diambil | Menjejalkan kata kunci ke daftar |
Halaman sendiri | Susun ulang agar fakta spesifiknya mudah ditemukan dan dikutip | Menambah blok FAQ yang tidak menjawab apa pun |
Hasil yang diharapkan: daftar tersaring dan berprioritas. Urutkan berdasarkan seberapa sering sumber itu muncul di set pertanyaan Anda, bukan seberapa bergengsi domainnya terdengar. Utas forum yang dikutip di enam dari dua puluh pertanyaan Anda ada di atas terbitan industri yang dikutip sekali, dan juga jauh lebih mudah ditangani.
Pemeriksaan kualitas: untuk setiap baris yang Anda pertahankan, pastikan Anda bisa menyebut pertanyaan pelanggan yang sesuai. Kalau tidak bisa, buang barisnya. Halaman yang dikutip untuk pertanyaan yang tidak ditanyakan siapa pun di pipeline Anda hanya mengalihkan perhatian.
Jalur pemulihan: kalau daftar tersaringnya masih sangat besar, Anda belum menyaring cukup keras. Batasi putaran pertama pada sepuluh baris, diurutkan berdasarkan frekuensi sitasi, dan kerjakan itu sebelum membuka lagi daftar lengkapnya.
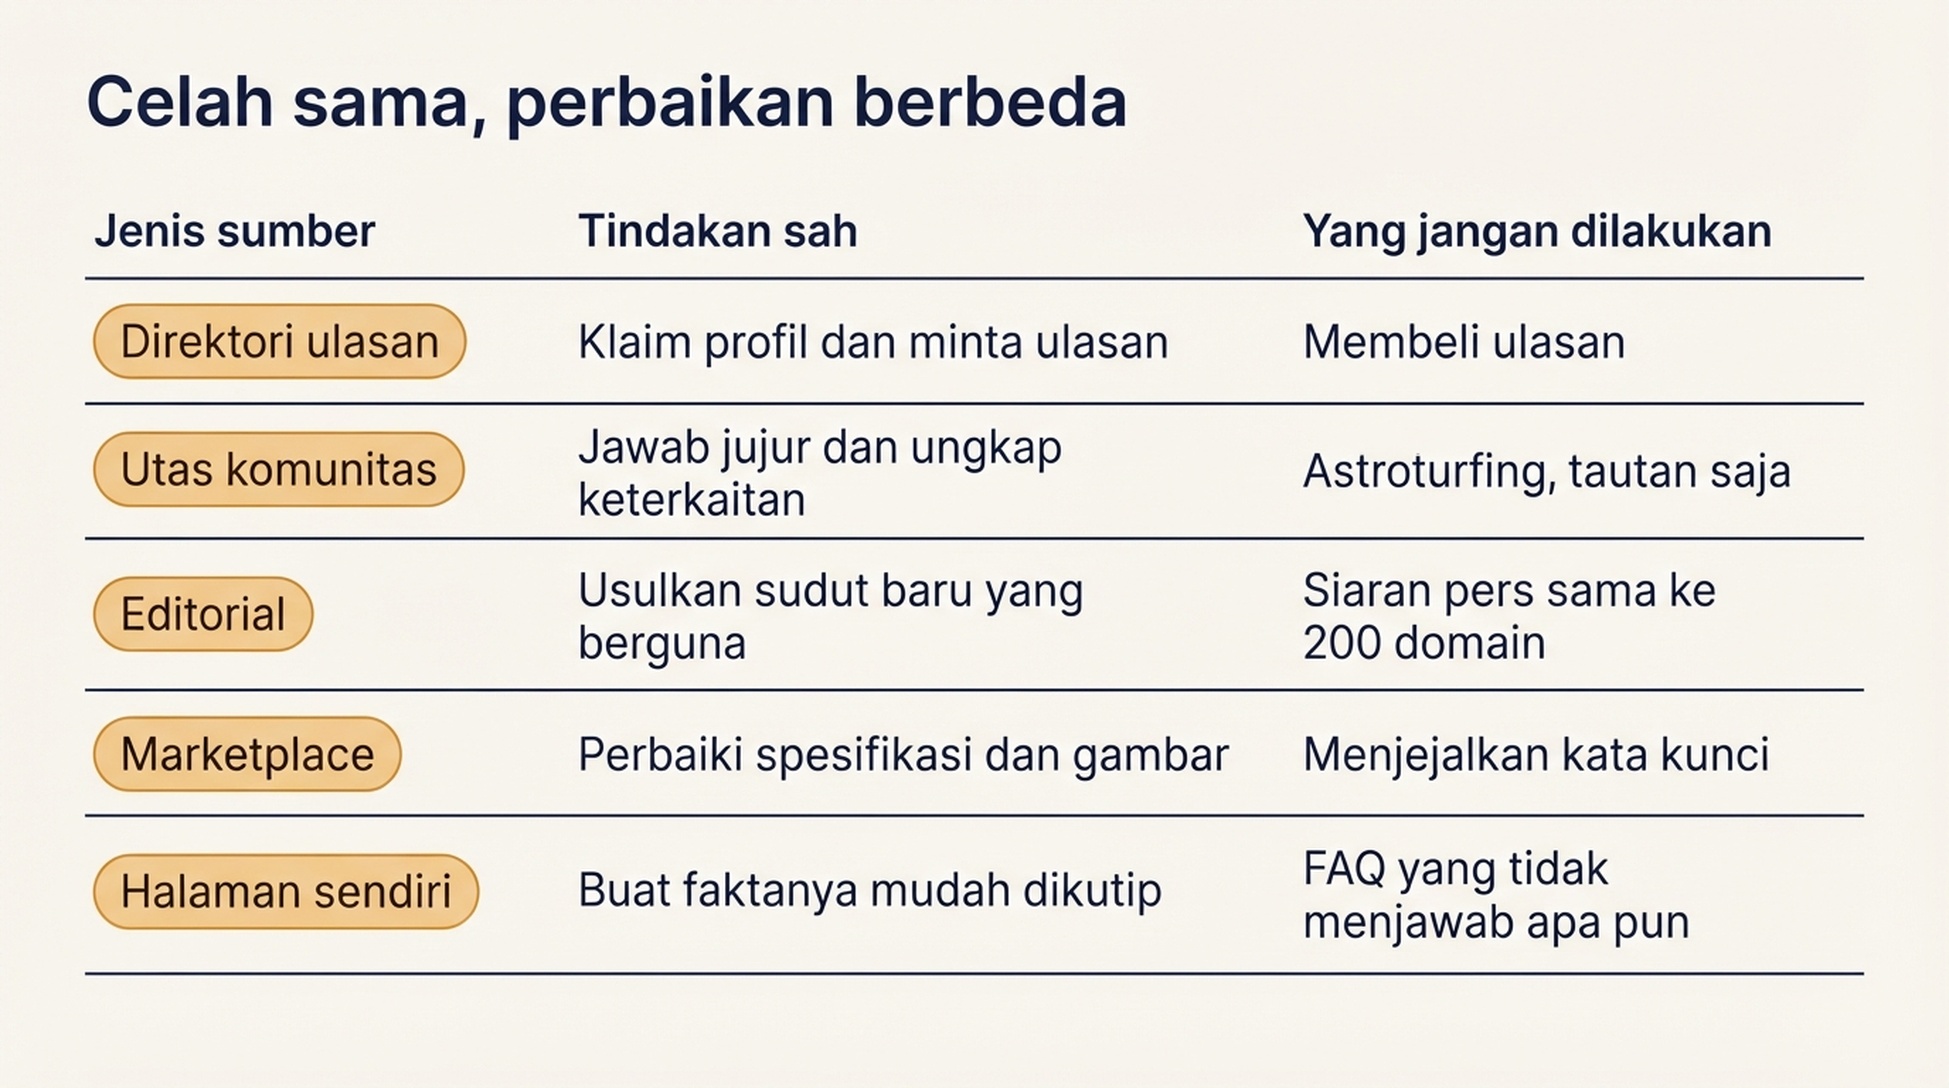
Celah yang sama, perbaikan yang berbeda. Memperlakukan setiap sitasi yang hilang sebagai masalah outreach adalah cara tim berakhir menawarkan utas Reddit ke editor.
Langkah 5: serahkan separuh mekanisnya ke agen
Langkah 2 dan 3 paling banyak menghabiskan waktu dan paling sedikit menuntut penilaian. Itulah definisi pekerjaan yang layak didelegasikan. Set pertanyaan dan penentuan prioritas tetap di tangan manusia, karena di dua titik itulah kesalahan penilaian membuat seluruh latihan sia-sia.
Empat agen di bawah ini bisa menjalankan metode yang sama. Yang berubah adalah di mana metodenya tinggal dan bagaimana hasilnya kembali. Pilih berdasarkan itu, bukan berdasarkan model mana yang menang benchmark bulan ini.
Codex
Ideal kalau Anda ingin petanya tinggal di repositori dan menghasilkan artefak yang ditinjau setiap eksekusi. Kalau situs Anda sudah ada di git, ini jalur dengan gesekan paling sedikit.
Siapkan folder proyek berisi direktori citation-map/, questions.csv berisi set pertanyaan Anda, dan SKILL.md yang menyatakan metodenya: mesin mana yang diperiksa, kolom apa yang dicatat, bagaimana sumber diklasifikasikan, dan bagaimana berkas keluarannya. Simpan satu berkas per eksekusi, dinamai berdasarkan tanggal, supaya Anda mengakumulasi riwayat alih-alih menimpanya.
Minta Codex menjalankan pertanyaannya, menambahkan baris ke berkas eksekusi saat ini, dan menghasilkan tabel ringkasan porsi sumber per mesin. Karena keluarannya berkas di dalam repositori, Anda mendapat diff yang bisa ditinjau sebelum apa pun dianggap final. Tahap tinjauan itulah intinya: Anda memeriksa klasifikasinya, bukan mengulang pencatatannya.
Satu aturan harus ada di SKILL.md apa pun yang terjadi: agen mencatat apa yang diamati dan tidak menyimpulkan sitasi yang tidak dilihatnya. Mengarang sumber adalah mode kegagalan paling merusak di alur ini. Satu aturan tertulis plus pemeriksaan sampel tiga baris menahan sebagian besarnya, dan tiga baris yang Anda periksa harus berganti setiap eksekusi.
Claude Code
Ideal kalau metodenya perlu dibaca terhadap kebijakan tertulis yang eksplisit, dan Anda ingin meninjau halaman yang tercatat dengan konteks panjang.
Taruh metodenya di CLAUDE.md atau skill proyek, termasuk definisi jenis sumber dan skema keluaran yang tepat. Arahkan Claude Code ke folder eksekusi dan minta ia mengklasifikasikan setiap URL yang dikutip, lalu menandai baris yang isi halamannya sebenarnya tidak menopang sitasi itu.
Pekerjaan kedua itulah yang layak dibayar. Membaca 200 halaman yang dikutip dan menilai apakah masing-masing benar-benar menjawab pertanyaannya menyiksa bagi manusia dan wajar bagi agen dengan standar tertulis. Minta penanda keyakinan per baris dan tinjau sendiri hanya yang berkeyakinan rendah.
ChatGPT
Ideal kalau Anda ingin biaya penyiapan paling rendah dan pekerjaannya sekali duduk, bukan eksekusi berulang.
Tempel metodenya sebagai instruksi khusus atau prompt proyek tersimpan, lampirkan daftar pertanyaan Anda, dan kerjakan per kelompok mesin. Minta keluarannya berupa tabel dengan kolom persis seperti langkah 2, supaya bisa langsung ditempel ke spreadsheet.
Jebakannya, ChatGPT juga salah satu permukaan yang Anda ukur. Kalau Anda memetakan sitasi ChatGPT sendiri, lakukan di sesi bersih tanpa metode Anda dimuat, atau pengamatannya terkontaminasi. Pakai satu sesi untuk mencatat dan sesi lain untuk merapikan.
Hermes Agent
Ideal kalau Anda ingin metodenya bertahan sebagai skill dan membaik antar eksekusi tanpa perlu dijelaskan ulang.
Pasang metode peta sitasi sebagai skill Hermes bersama set pertanyaan dan skema keluarannya, lalu jalankan dengan irama; bulanan biasanya tepat. Karena skill dan memorinya bertahan, koreksi yang Anda buat di bulan pertama terbawa ke bulan kedua. Kalau agen salah mengklasifikasikan direktori sebagai sumber editorial, perbaiki aturannya sekali.
Harganya, memori yang bertahan perlu ditinjau berkala. Setiap beberapa eksekusi, baca berkas skill-nya dan pastikan koreksi yang menumpuk masih menggambarkan metode yang Anda inginkan, bukan tumpukan pengecualian sekali pakai yang tidak bisa dijelaskan siapa pun.
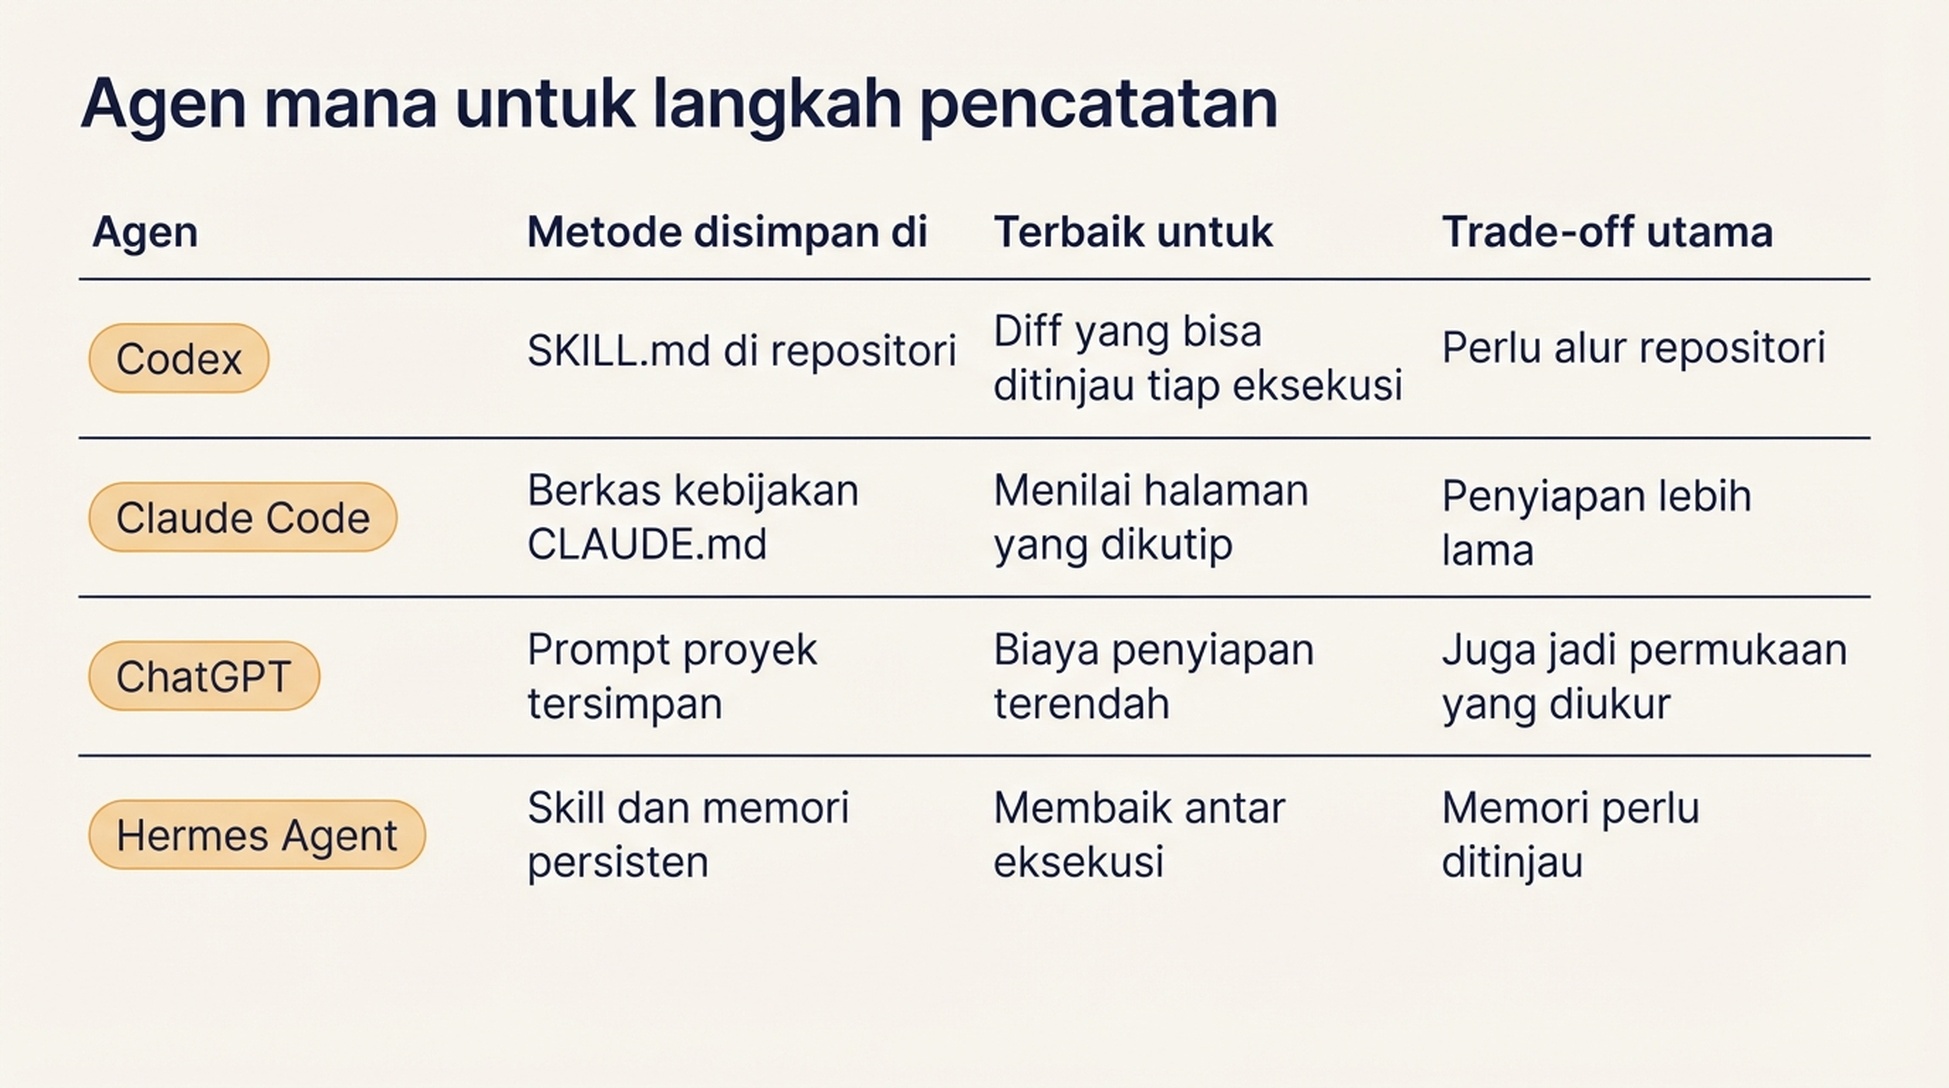
Keempatnya menjalankan lima langkah yang sama. Pilih berdasarkan di mana metodenya sebaiknya tinggal, bukan berdasarkan model mana yang skornya tertinggi di benchmark.
Langkah 6: memverifikasi peta sebelum bertindak
Jangan membagikan pekerjaan berdasarkan peta yang belum diverifikasi. Jalankan pemeriksaan ini dulu. Lima menit di sini menghemat satu kuartal usaha yang salah arah.
- Jalankan ulang tiga pertanyaan seminggu kemudian. Kalau campuran sumbernya berubah total, set pertanyaan Anda terlalu labil atau sampelnya terlalu kecil. Catat pergeserannya alih-alih memperlakukan putaran pertama sebagai kebenaran mutlak. Sebagian pergeseran itu normal; pergantian total adalah peringatan.
- Pastikan mesinnya, bukan hanya jawabannya. Sumber yang muncul di Perplexity bisa absen di ChatGPT untuk pertanyaan yang sama. Pisahkan kolom per mesin di ringkasan; total gabungan justru menyembunyikan sinyal yang Anda butuhkan.
- Periksa juga sitasi Anda sendiri. Kalau merek Anda dikutip, buka halamannya. Kadang mesin mengutip halaman yang membahas Anda secara kritis, atau halaman yang tidak Anda kendalikan. Itu informasi berguna, bukan kemenangan.
- Pastikan tanggal di setiap baris. Peta sitasi tanpa tanggal tidak bisa dibandingkan dengan apa pun nanti.
- Periksa jumlah sumbernya. Kalau satu pertanyaan mengembalikan 40 sumber dan sisanya tiga, periksa apakah Anda menangkap panel "terkait" alih-alih sitasi sebenarnya.
Arti selesai: Anda bisa menyerahkan tabel ringkasan dan satu daftar kerja tersaring ke kolega, dan dia bisa bertindak tanpa menanyakan arti baris mana pun.
Merawat peta
Jalankan putaran lengkap tiap kuartal dengan set pertanyaan yang sama, dan putaran ringan bulanan pada lima pertanyaan bernilai komersial tertinggi. Simpan eksekusi lama. Sinyal yang menarik jarang berupa cuplikan. Yang menarik adalah pergeserannya: jenis sumber yang diam-diam tumbuh, atau kompetitor yang mulai muncul di ember yang sebelumnya tidak ada.
Tinjau set pertanyaannya dua kali setahun. Pertanyaan pembelian berubah mengikuti produk dan pasar Anda, dan set yang basi menghasilkan peta kategori yang sudah tidak Anda jual.
Satu hal yang perlu ditahan: mengubah ini menjadi dasbor. Keluarannya adalah daftar kerja berisi penanggung jawab dan URL. Kalau pada akhirnya tidak ada yang memegang tugas, petanya belum menjalankan fungsinya.
Pertanyaan umum
Apakah saya perlu alat visibilitas AI berbayar untuk ini? Tidak. Versi manualnya berfungsi untuk satu kategori dan selesai dalam setengah hari. Alat berbayar sepadan ketika Anda melacak banyak kategori atau pasar, atau ketika Anda ingin garis tren historis tanpa merawat spreadsheet sendiri.
Berapa banyak pertanyaan yang cukup? 10 sampai 20 per kategori. Di bawah sepuluh, Anda tidak bisa membedakan pola dari kebetulan. Di atas dua puluh pada putaran pertama, analisisnya tidak akan selesai, padahal analisis itulah bagian yang menghasilkan daftar kerja.
Haruskah saya memasukkan pertanyaan yang sudah memunculkan kami? Ya. Mengetahui sumber mana yang menopang Anda sama bergunanya dengan mengetahui mana yang melewatkan Anda, dan itu memberi tahu apa yang harus dijaga saat Anda mengubah konten.
Bagaimana kalau mesin memberi jawaban berbeda setiap kali? Itu normal dan layak dicatat. Jalankan pertanyaan yang sama tiga kali dan catat variasinya. Kalau set sumbernya benar-benar berbeda setiap kali, anggap pertanyaan itu berkeyakinan rendah dan beri bobot lebih kecil saat memprioritaskan.
Bisakah saya langsung memakai daftar sumber dari mesinnya tanpa membuka halamannya? Untuk pencatatan awal, bisa. Untuk baris yang akan Anda tindak lanjuti, tidak. Anda perlu membaca halamannya untuk menilai apakah merek Anda benar-benar layak di sana dan apa yang bisa jadi kontribusi berguna.
Apa bedanya dengan pelacakan peringkat? Pelacakan peringkat memberi tahu di mana halaman Anda muncul di daftar hasil. Peta sitasi memberi tahu dari halaman mana sebuah jawaban disusun. Ada halaman yang peringkat satu tapi tidak pernah dikutip, dan ada halaman yang tidak berperingkat sama sekali justru jadi tulang punggung jawaban. Selisih itulah yang membuat setengah hari ini layak dihabiskan.
Penulis: Ethan Marlowe, pemimpin pengukuran GEO di Auspia dengan lebih dari 500 prompt yang dianalisis. Ia menulis tentang pelacakan prompt, pelaporan sitasi, dasbor visibilitas, dan cara membedakan perubahan visibilitas AI yang nyata dari derau antar eksekusi.