Что у вас будет на выходе
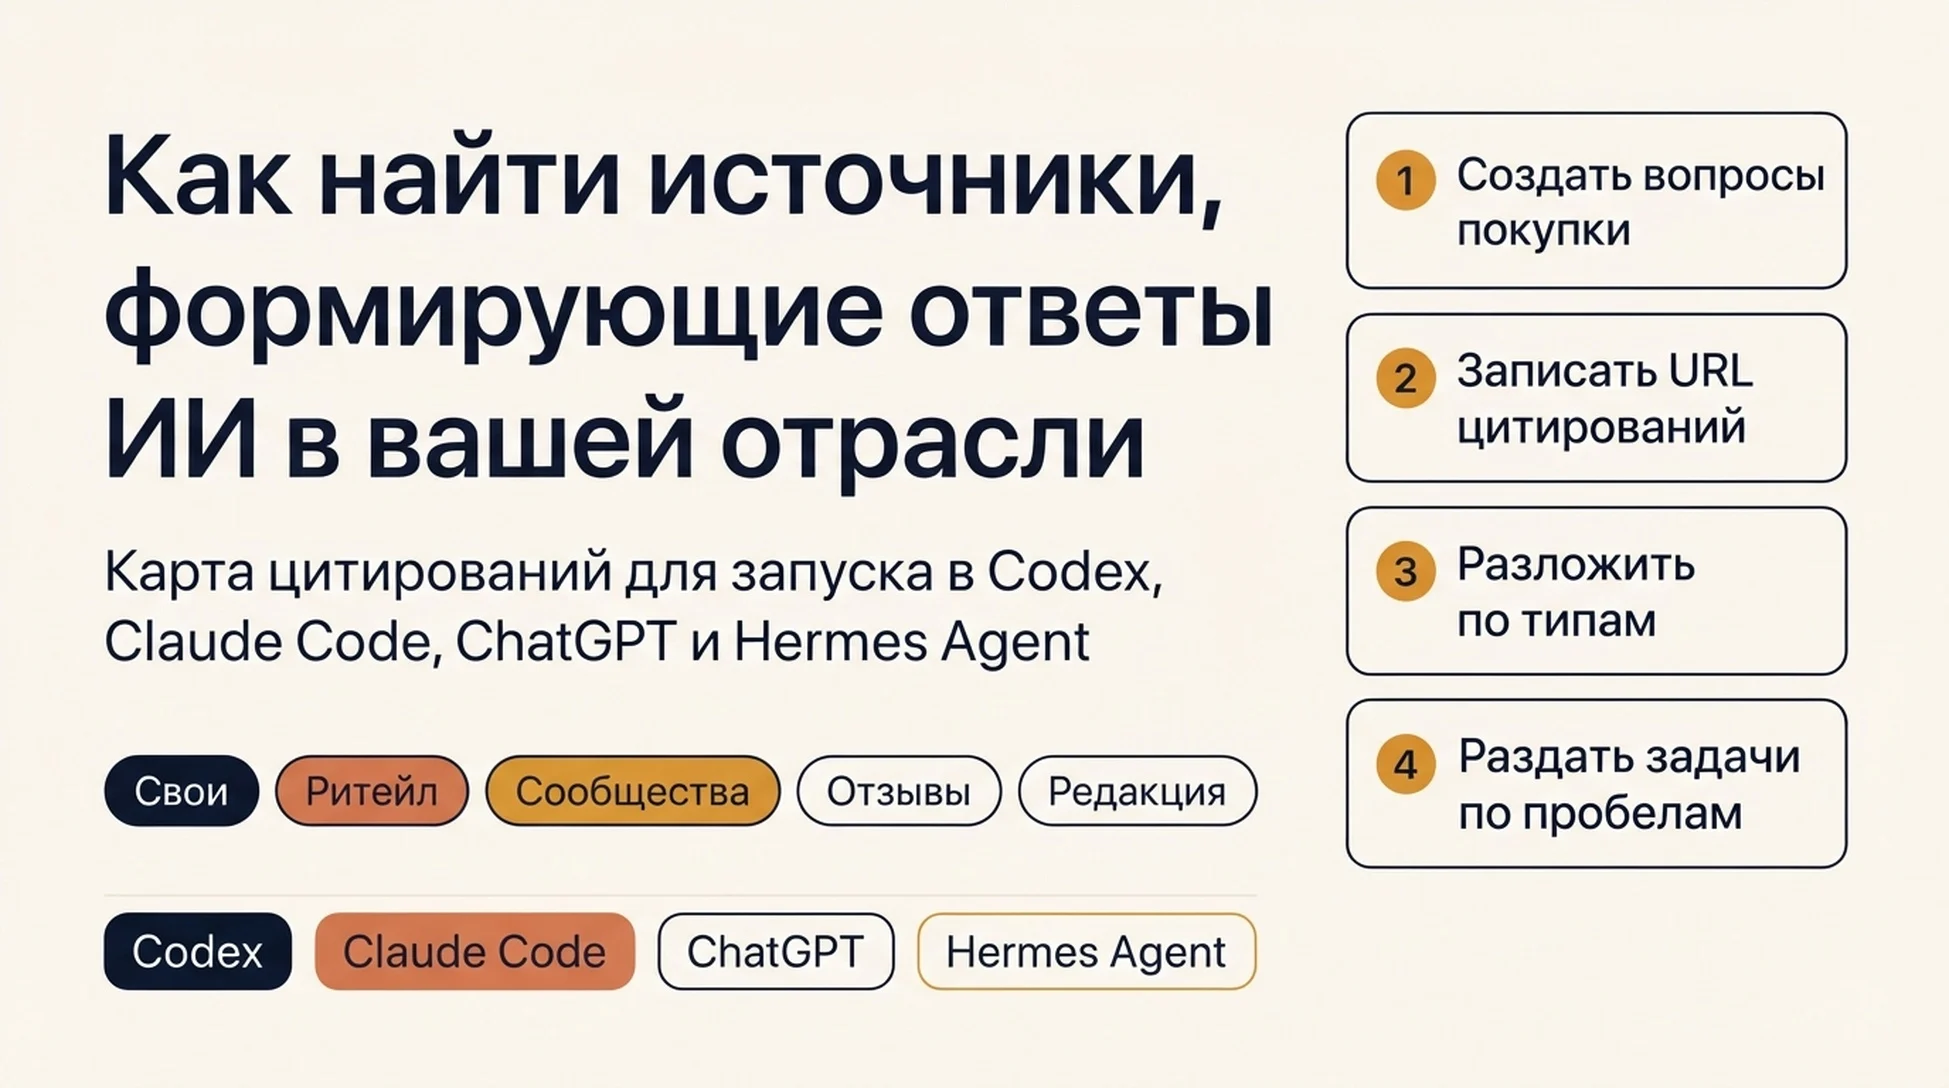
Карта цитирований — это запись того, какие страницы ИИ-движок действительно вытащил, когда отвечал на вопросы ваших покупателей. Не того, появился ли ваш бренд в ответе. А того, из каких источников этот ответ был собран.
Я прогонял это в достаточном числе категорий, чтобы знать: первый результат обычно отрезвляет. Команды исходят из того, что ответы держатся на их собственном сайте. Чаще всего это не так. В одной B2B-категории страницы самого вендора давали ничтожную долю, а сайт отзывов, который никто не заявил, делал основную работу.
В этом и смысл упражнения. Вы перестаёте гадать и начинаете смотреть на реальные страницы.
К концу этого разбора у вас будет:
- От 10 до 20 настоящих вопросов о покупке для одной категории товара или услуги, сформулированных так, как их задал бы клиент
- Каждый вопрос прогнан в тех ИИ-движках, которыми реально пользуются ваши покупатели, с зафиксированными и датированными источниками цитирования
- Эти источники разложены по типам, чтобы вы видели, откуда берутся ответы в вашей категории
- Короткий список страниц, где цитируется конкурент, а вас нет, каждая с законным следующим шагом
- Ответственные и дата пересмотра, чтобы карта не сгнила в общей папке
Для кого это: внутренний ответственный за SEO, GEO или контент, либо стратег агентства, который может предлагать работу, даже если исполняет её кто-то другой. Платный инструмент не обязателен, хотя на масштабе помогает.
Что нужно заранее: браузер, таблица и доступ на чтение к собственному сайту. Для версий с агентом — рабочая установка выбранного агента и папка, на которую его можно направить.
Время: около двух часов на первый проход по одной категории. Примерно 45 минут из них — прогон запросов и копирование источников. Именно эти 45 минут стоит отдать агенту, а остальное — та часть, где нужно ваше суждение.
Что значит «готово»: вы можете назвать три-четыре типа источников, на которых держатся ответы в вашей категории, показать конкретные страницы, где вас нет, а конкурент есть, и передать кому-то задачу с приложенной ссылкой. Если у вас только список доменов и смутное ощущение, что Reddit важен, — вы не закончили.
Позиция Auspia: большинство команд идут прямиком к «нам нужно больше упоминаний бренда», потому что ни разу не смотрели, из чего ответ реально собран. Карта превращает это смутное ощущение в страницу, по которой можно действовать.
Перед началом: два решения, которые определяют всё
Два выбора определяют, что даст остальная работа. Оба легко сделать неправильно, и оба неудобно отменять потом.
Выберите одну категорию, а не весь бизнес. У компании, которая продаёт софт и одновременно ведёт сервисное направление, две разные экосистемы источников. Картировать обе сразу — значит получить среднее, которое не описывает ни одну из них. Возьмите категорию с наибольшей выручкой и отложите остальное на следующий квартал.
Выбирайте движки осознанно. Google AI Overview, ChatGPT, Perplexity и Gemini не черпают из одного колодца. Источник, потерявший вес в одном движке, может по-прежнему учитываться в другом. Запускайте минимум два. Если не знаете какие, спросите отдел продаж, какой интерфейс упоминают клиенты, или посмотрите реферальный трафик с ИИ-доменов.
Проведите границу сразу. Это упражнение на наблюдение, а не на доказательство. Вы фиксируете то, что движок вернул в конкретный день. Ответы меняются от запуска к запуску, поэтому одно наблюдение — это точка данных, а не тренд. Ставьте дату на всё, иначе весь файл станет бесполезен через месяц.
Шаг 1: собрать набор вопросов
Напишите от 10 до 20 вопросов, которые клиент задал бы при выборе. Не ключевые слова. Вопросы, словами самого клиента.
Это шаг, который люди проскакивают, и именно он решает, стоит ли остальное усилий. Набор вопросов из выгрузки ключевых слов даёт карту того, как люди ищут. Набор из заметок о звонках с продажами даёт карту того, как люди покупают. Это не один и тот же список.
Материалы, из которых можно брать вопросы:
- Самые частые предпокупочные вопросы, которые получает отдел продаж
- Тикеты поддержки за первые 30 дней после покупки
- Блок «другие спрашивают» по вашим основным коммерческим запросам
- Ваше собственное исследование ключевых слов, переписанное в форму вопросов
- Сравнительные запросы конкурентов, которые делают ваши покупатели
Смешивайте формы вопросов, потому что каждая тянет разные источники.
Форма вопроса | Пример | Какие источники обычно выходят |
|---|---|---|
Соответствие категории | «На что смотреть средней логистической компании при выборе инструмента маршрутизации?» | Редакционные подборки, сайты отзывов |
Прямое сравнение | «Инструмент A или инструмент B для команды из 20 человек?» | Страницы сравнений, ветки сообществ |
Риск и возражение | «Инструмент A действительно достаточно безопасен для медицинских данных?» | Форумы, разборы соответствия, документация вендора |
Цена и ценность | «Сколько инструмент A реально стоит за место?» | Страницы с ценами, ветки сообществ, сайты отзывов |
Внедрение | «Сколько занимает переход с инструмента B?» | Документация, разборы на YouTube, форумы |
Ожидаемый результат: таблица, где на каждый вопрос одна строка, один столбец под форму вопроса и один под движок, в котором вы его прогоните.
Проверка качества: перечитайте список и спросите себя, набрал бы реальный покупатель каждый из них. Если вопрос понятен только тому, кто уже знает таксономию вашего продукта, перепишите его. Десять вопросов, которые покупатель действительно задаст, лучше пятидесяти, звучащих как выгрузка ключевых слов.
Путь восстановления: если не набирается десять вопросов, это проблема исследования, а не картирования. Достаньте последние 20 заметок о звонках с продажами или последние 50 тикетов поддержки и вытащите вопросы оттуда, прежде чем продолжать.
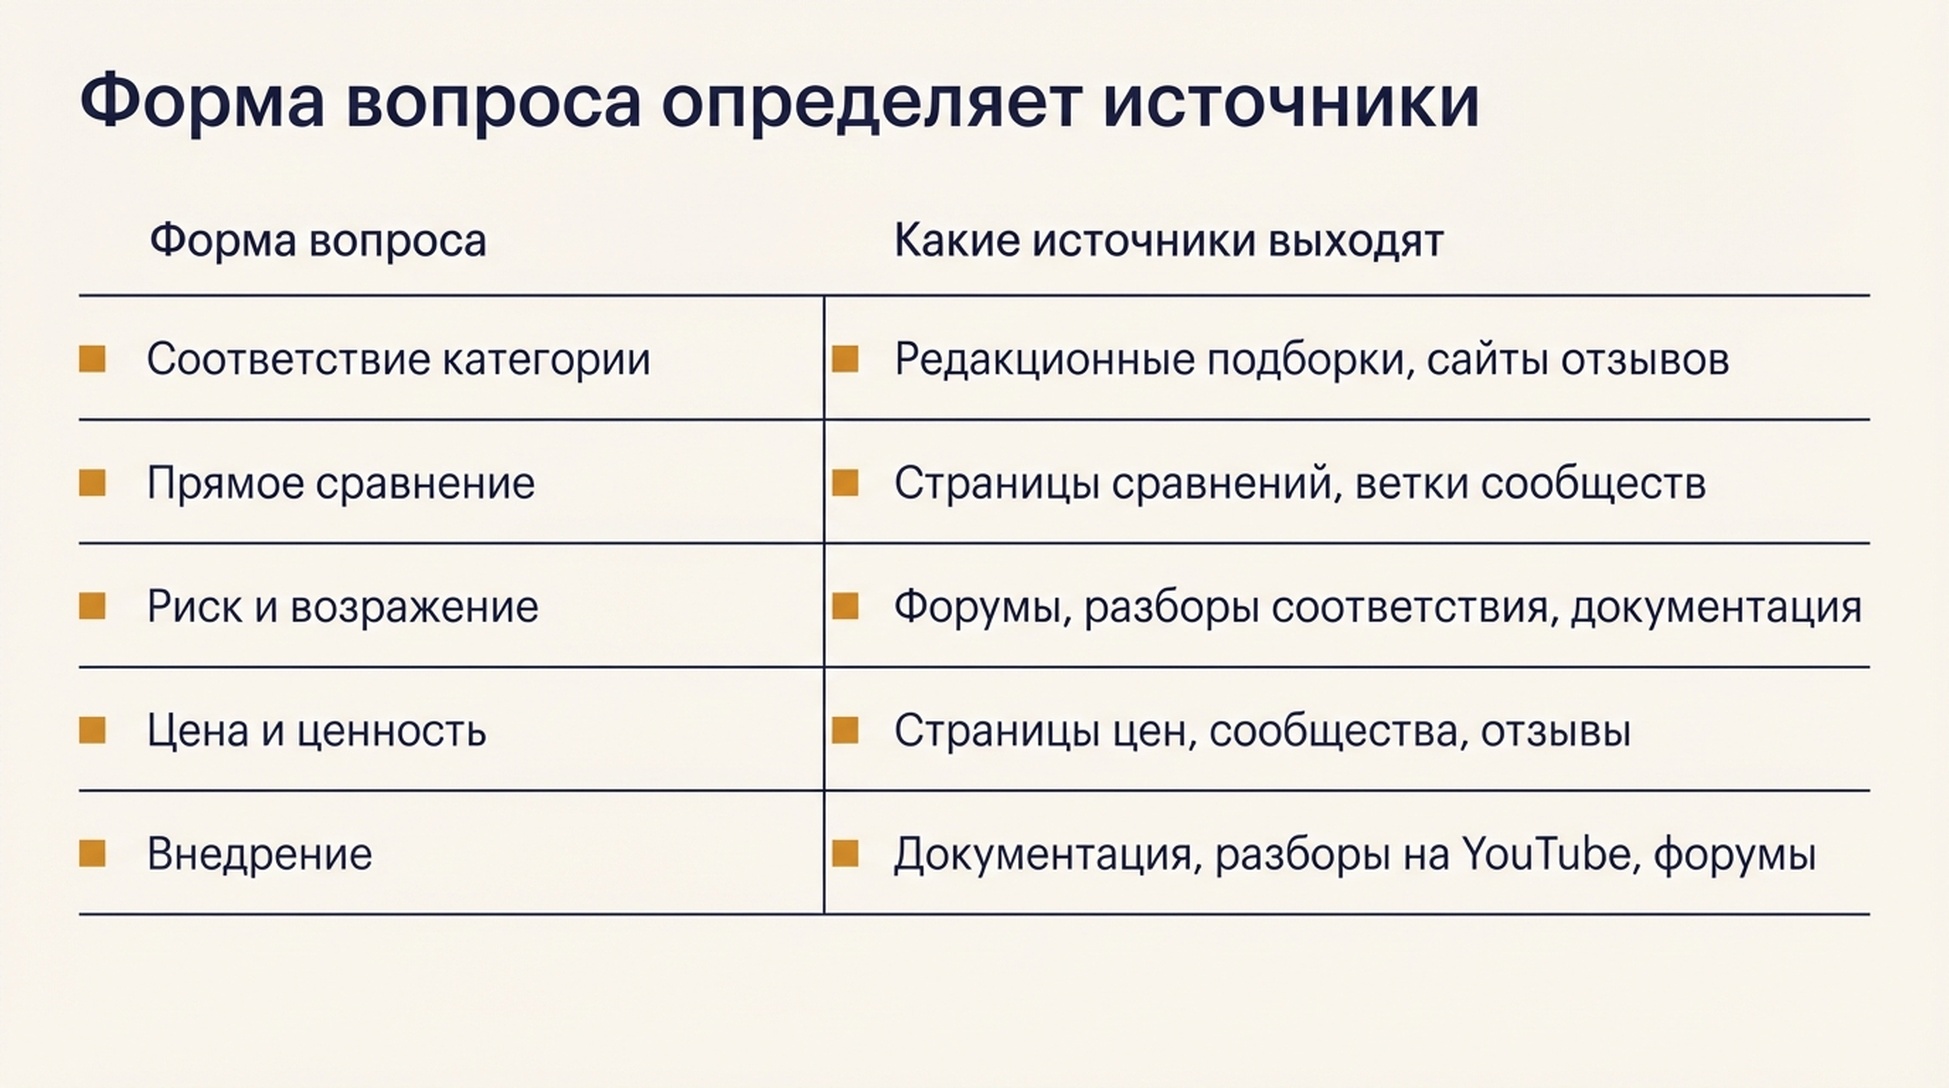
Форма вопроса — скрытая переменная. Вопрос о прямом сравнении и вопрос о риске по одному и тому же продукту возвращают разные источники.
Шаг 2: прогнать вопросы и зафиксировать источники
Здесь механическое ядро, и здесь ручная работа разваливается. Сделайте пять вопросов руками, чтобы понять, как должен выглядеть результат. Дальше автоматизируйте остальное.
Для каждого вопроса в каждом движке:
- Откройте новый диалог. Предыдущий контекст меняет то, что движок достанет.
- Задайте вопрос ровно так, как записали.
- Откройте панель цитирований или список источников. В большинстве движков это маленькая иконка рядом с ответом, а не видимый список.
- Зафиксируйте каждый процитированный URL, а также домен и тип источника.
- Отметьте дату, движок и то, были ли вообще цитирования.
Фиксируйте в такой структуре:
Поле | Почему важно |
|---|---|
ID вопроса | Связывает каждое наблюдение с вопросом о покупке |
Движок | Позволяет позже разделить закономерности по движкам |
Дата и время | Ответы дрейфуют; строка без даты бесполезна через месяц |
Процитированный URL | Реальная страница, а не только домен |
Домен | Для группировки и подсчёта частоты |
Тип источника | свой, ретейл/маркетплейс, сообщество, каталог отзывов, редакционный |
Конкурент присутствует | Да/нет и какой именно |
Наш бренд присутствует | В ответе, в источниках, в обоих или нигде |
На последней строке стоит задержаться. Бренд может быть назван в ответе, при этом ни одна его страница не процитирована. И наоборот, бренд может быть процитирован, не будучи заметно названным. Это два разных сигнала, и если следить только за «мы появились», вы прочитаете оба неверно. Я видел команды, которые радовались упоминанию со страницы, которая спорила с ними.
Ожидаемый результат: длинная таблица, по одной строке на каждый процитированный источник, вопрос и движок.
Проверка качества: минимум в трёх строках пройдите по ссылке и убедитесь, что процитированная страница действительно подтверждает утверждение, ради которого её процитировали. Движки иногда цитируют страницу, которая упоминает тему, но не отвечает на вопрос. Такие строки — шум, их нужно помечать.
Путь восстановления: если движок не вернул цитирований по вопросу, это находка, а не провал. Запишите ноль источников и идите дальше. Вопросы, на которые отвечают без извлечения, — это вопросы, на которые ваш контент повлиять не может.
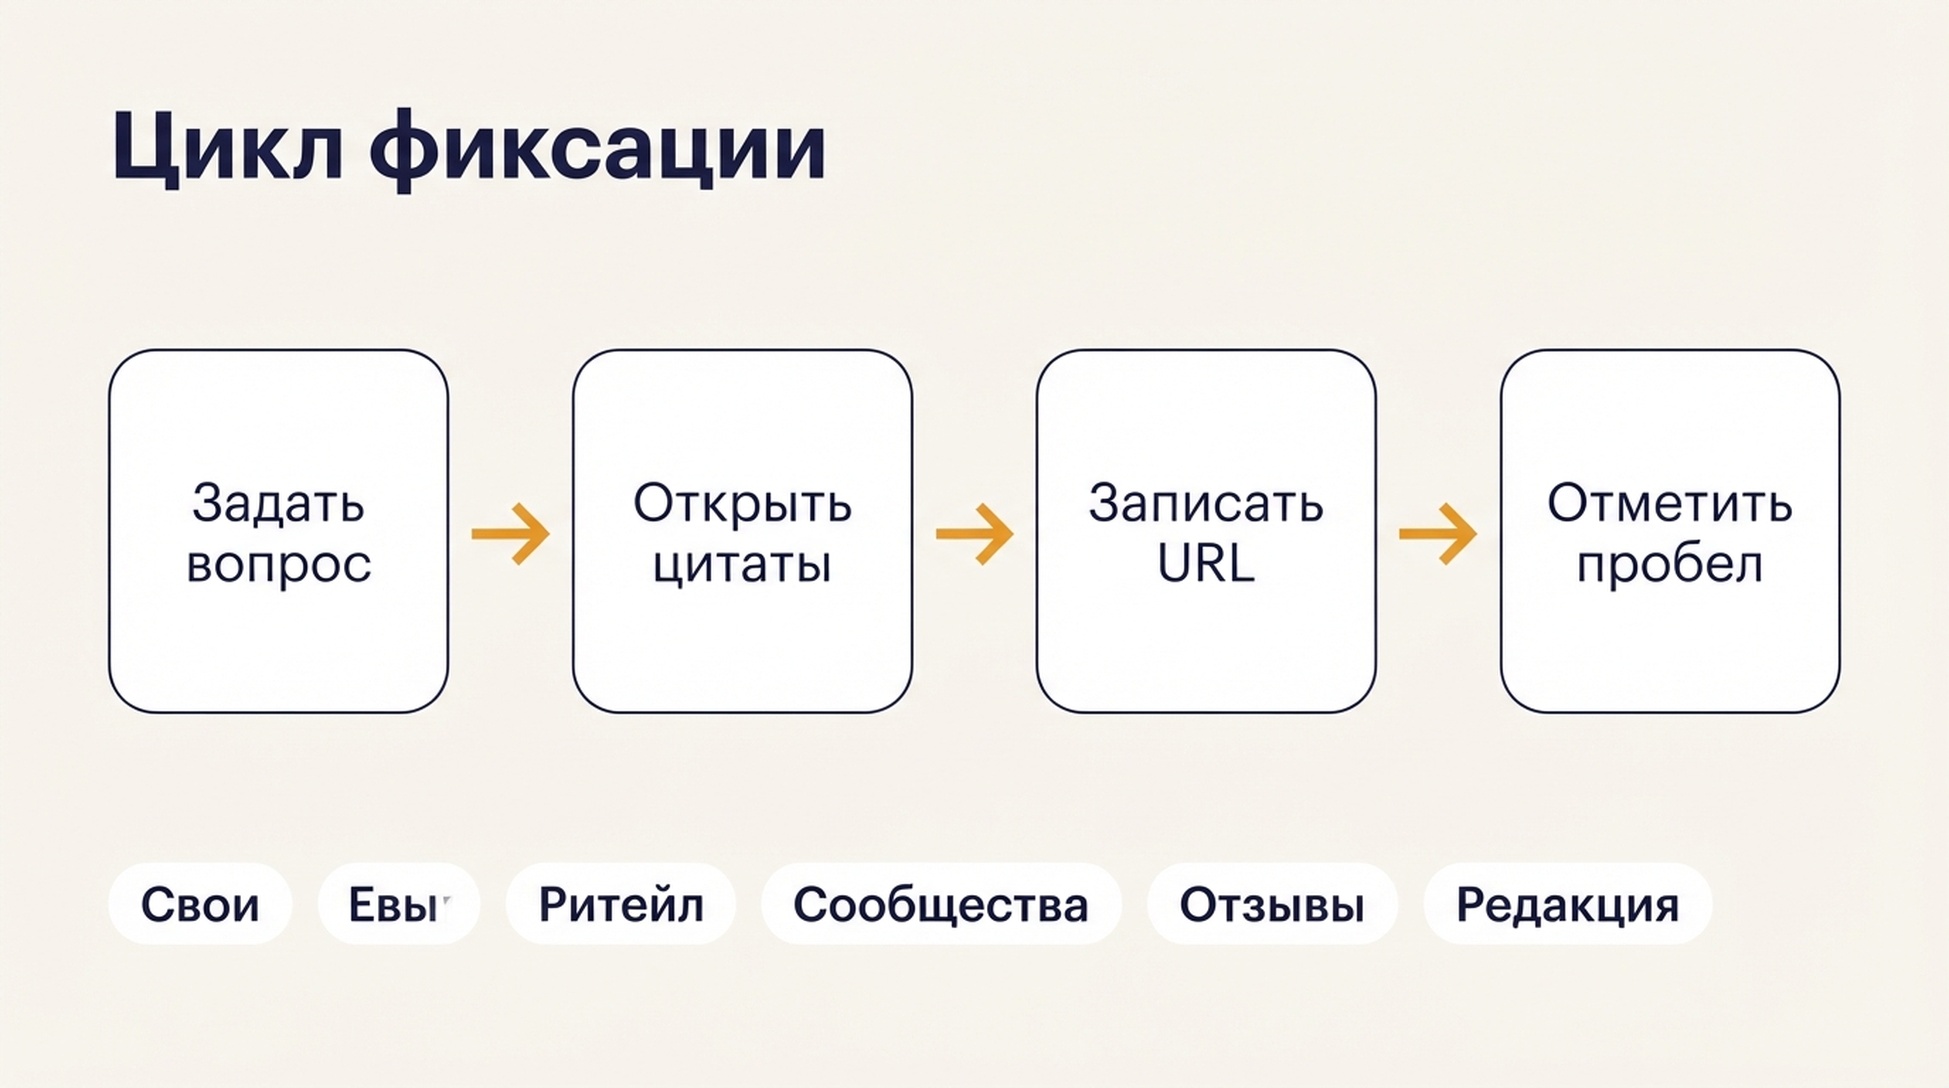
Цикл простой и нудный. Именно это сочетание делает его хорошим кандидатом для передачи агенту.
Шаг 3: разложить источники по типам
Теперь сожмите длинную таблицу в картину вашей категории. Отнесите каждый процитированный URL в одну из пяти корзин:
- Свои: ваш сайт или сайт конкурента
- Ретейл и маркетплейсы: карточки товаров, страницы сравнения цен, магазины приложений
- Сообщества и UGC: Reddit, YouTube, Quora, форумы, проиндексированные ветки Discord
- Каталоги отзывов и B2B-платформы: G2, Capterra, Clutch, Trustpilot, отраслевые каталоги
- Независимые редакционные и справочные: отраслевая пресса, новости, Wikipedia, разборы аналитиков, независимые блоги
Посчитайте по корзинам и по движкам — и карта цитирований готова.
Вы ищете не отдельное число. Вы ищете форму. Одни категории держатся почти целиком на ветках сообществ и отраслевой прессе, а собственный сайт бренда почти не участвует. Другие подмяты карточками товаров, потому что ответ лежит в самой карточке. Эта смесь зависит от того, что спрашивают покупатели, а не от того, насколько хорош чей-то сайт. Это трудно принять, когда вы вложили в сайт два года.
Ожидаемый результат: небольшая таблица, по одной строке на тип источника, по одному столбцу на движок, с долей процитированных источников.
Проверка качества: если одна корзина держит больше примерно 70% ваших цитирований, проверьте пять URL внутри, действительно ли они этого типа. Один высокотрафиковый агрегатор может маскироваться под редакционный источник, будучи на деле каталогом.
Путь восстановления: если цифры выглядят случайными, вы, скорее всего, смешали формы вопросов и этим скрыли закономерность. Разделите таблицу по форме вопроса и посмотрите снова. Вопросы о цене и о риске часто дают совершенно разные профили источников.
Шаг 4: найти пробелы, где цитируют конкурента, а вас нет
Отфильтруйте длинную таблицу до строк, где появляется конкурент, а ваш бренд — нет. Этот отфильтрованный список и есть ваш рабочий список. Он куда полезнее общего мандата «нам нужно больше упоминаний», потому что в каждой строке уже есть URL и клиентский вопрос. Отдайте его кому-то в понедельник — человек сразу начнёт.
Для каждой строки откройте процитированную страницу и ответьте на три вопроса:
- Действительно ли наш продукт уместен на этой странице?
- Если да, чего не хватает: карточки, которую мы никогда не заявляли, сравнения, где нас нет, ветки, где нас никто не упомянул, отзыва, который мы никогда не просили?
- Какое минимальное законное действие поставило бы нас туда?
Третий вопрос — там, где включается дисциплина. Действие зависит от корзины. Ошибка здесь — это когда SEO-специалист начинает рассылать журналистам холодные письма про ветку на Reddit.
Тип источника | Законное действие | Чего делать не стоит |
|---|---|---|
Каталог отзывов | Заявить и заполнить профиль, попросить клиентов оставить отзывы | Покупать отзывы или подсевать фальшивые |
Ветка сообщества | Ответить честно как названный сотрудник, раскрыв свою связь | Астротурфинг или ссылка без вклада |
Редакционный | Предложить действительно полезный угол, который издание ещё не освещало | Разослать один и тот же пресс-релиз по 200 доменам |
Маркетплейс или карточка ретейла | Починить характеристики, изображения и описание, чтобы факты извлекались | Набить карточку ключевыми словами |
Своя страница | Перестроить так, чтобы конкретный факт было легко найти и процитировать | Добавить блок FAQ, который ни на что не отвечает |
Ожидаемый результат: отфильтрованный и приоритизированный список. Сортируйте по частоте появления источника в вашем наборе вопросов, а не по тому, насколько престижно звучит домен. Ветка форума, процитированная в шести из двадцати вопросов, стоит выше отраслевого издания, процитированного один раз, и вдобавок с ней гораздо проще работать.
Проверка качества: для каждой оставленной строки убедитесь, что можете назвать соответствующий клиентский вопрос. Если не можете — уберите строку. Страницы, процитированные по вопросам, которых никто в вашей воронке не задаёт, только отвлекают.
Путь восстановления: если отфильтрованный список всё ещё огромен, вы фильтровали недостаточно жёстко. Ограничьте первый проход десятью строками, отсортированными по частоте цитирования, и разберитесь с ними, прежде чем снова открывать полный список.
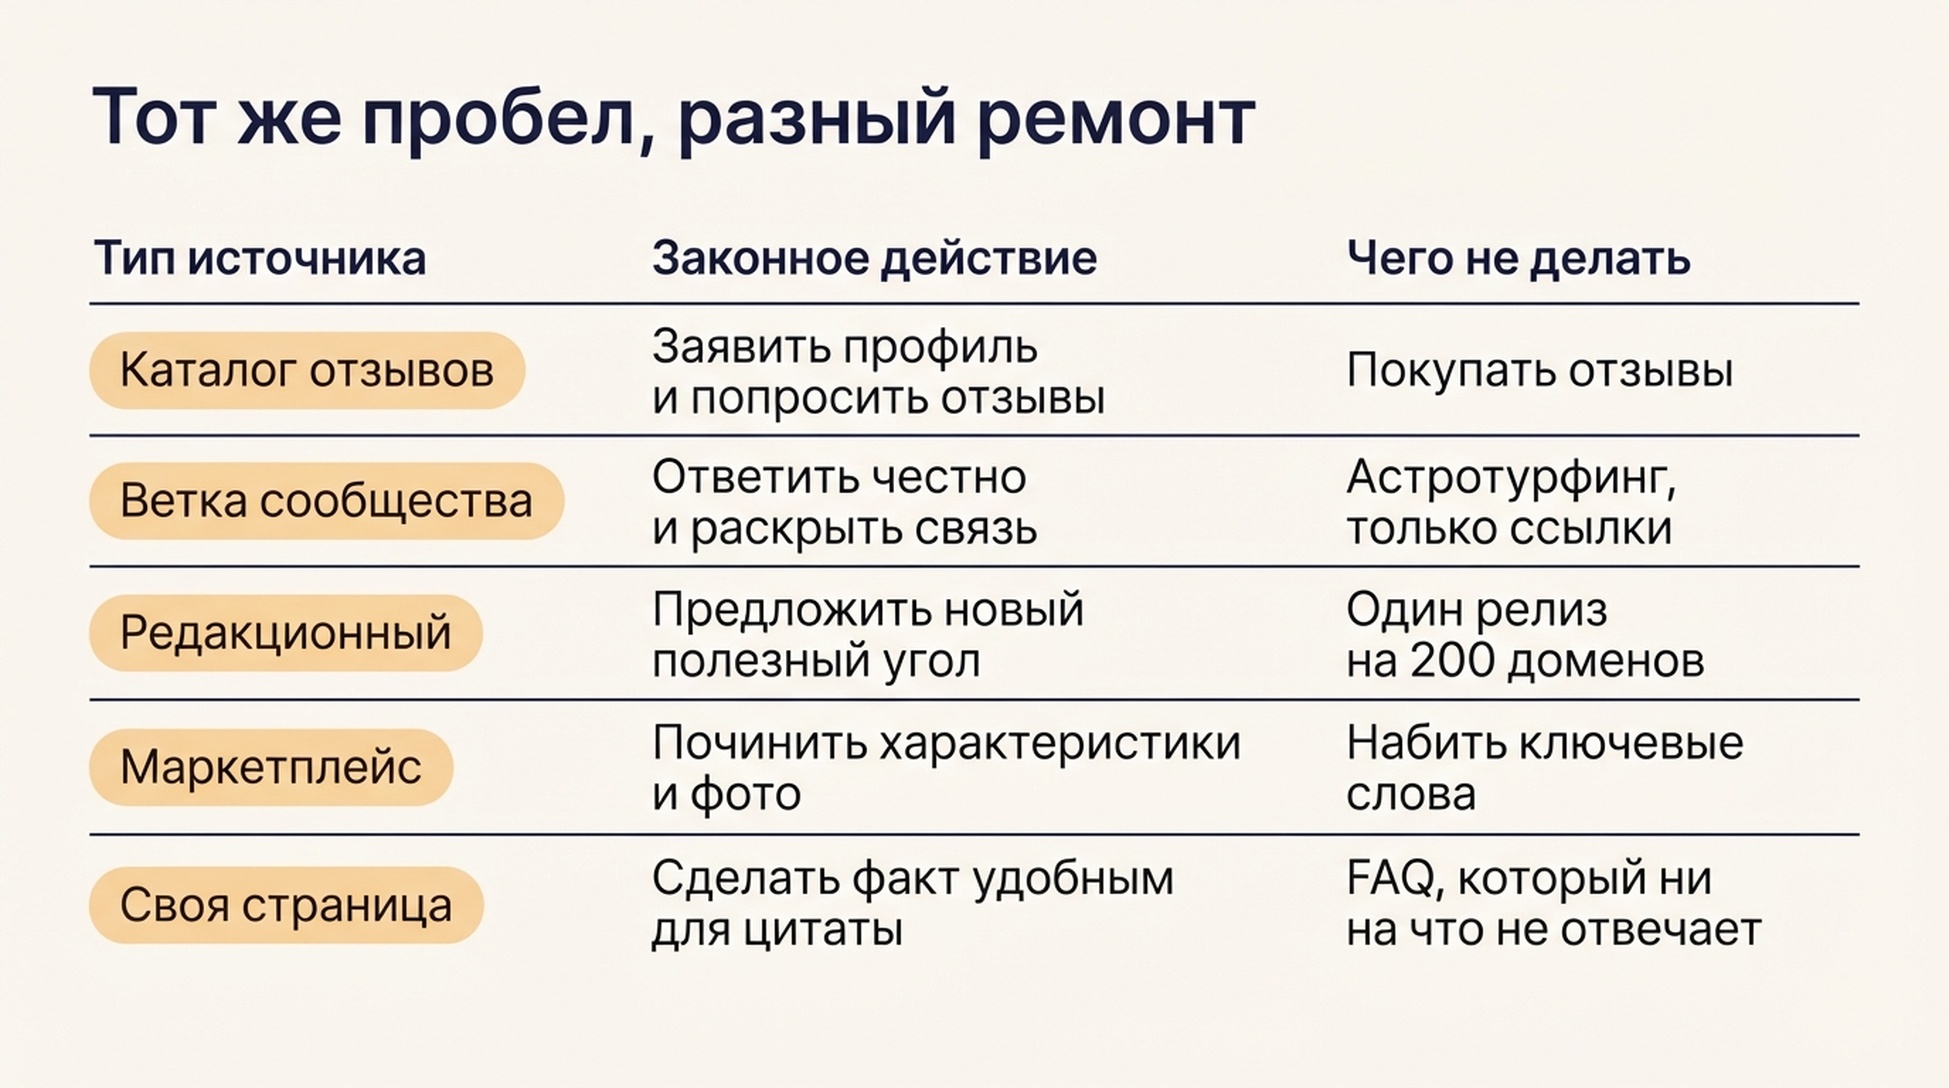
Тот же пробел, но разный ремонт. Относиться к каждому отсутствующему цитированию как к проблеме аутрича — так команды и доходят до того, что предлагают редактору ветку с Reddit.
Шаг 5: отдать механическую половину агенту
Шаги 2 и 3 съедают больше всего времени и требуют меньше всего суждения. Это и есть определение работы, которую стоит делегировать. Набор вопросов и приоритизация остаются за человеком, потому что это две точки, где ошибка суждения обнуляет всё упражнение.
Четыре агента ниже умеют выполнять один и тот же метод. Меняется то, где живёт метод и как возвращается результат. Выбирайте по этому, а не по тому, какая модель выиграла бенчмарк в этом месяце.
Codex
Идеален, когда вы хотите, чтобы карта жила в репозитории и на каждом запуске давала проверяемый артефакт. Если ваш сайт уже в git, это путь с наименьшим трением.
Соберите папку проекта с каталогом citation-map/, файлом questions.csv с вашим набором вопросов и SKILL.md, в котором описан метод: какие движки проверять, какие поля фиксировать, как классифицировать источник и как должен выглядеть выходной файл. Держите по одному файлу на запуск, названному по дате, чтобы накапливать историю, а не перезаписывать её.
Попросите Codex прогнать вопросы, дописать строки в файл текущего запуска и выдать сводную таблицу доли источников по движкам. Поскольку результат — файл в репозитории, вы получаете diff, который можно проверить, прежде чем что-то станет окончательным. Этот этап проверки и есть суть: вы контролируете классификации, а не переделываете сбор.
Одно правило должно быть в SKILL.md в любом случае: агент фиксирует то, что наблюдал, и не выводит цитирование, которого не видел. Выдуманные источники — самый вредный режим отказа в этом процессе. Письменное правило плюс выборочная проверка трёх строк останавливает большую часть, и три строки для проверки должны меняться от запуска к запуску.
Claude Code
Идеален, когда метод нужно читать против явно написанной политики, и когда вы хотите просматривать собранные страницы в длинном контексте.
Положите метод в CLAUDE.md или в проектный skill, включая определения типов источников и точную схему вывода. Направьте Claude Code на папку запуска и попросите классифицировать каждый процитированный URL, а затем пометить строки, где содержимое страницы на самом деле не подтверждает цитирование.
Вторая задача — та, за которую стоит платить. Прочитать 200 процитированных страниц и оценить, действительно ли каждая отвечает на вопрос, мучительно для человека и разумно для агента с письменным стандартом. Попросите флаг уверенности по каждой строке и просматривайте сами только строки с низкой уверенностью.
ChatGPT
Идеален, когда нужна минимальная стоимость настройки, а работа — это одна сессия, а не повторяющийся запуск.
Вставьте метод как пользовательскую инструкцию или сохранённый проектный промпт, приложите список вопросов и работайте партиями по движкам. Просите вывод таблицей с точно теми же столбцами, что на шаге 2, чтобы она сразу вставлялась в таблицу.
Загвоздка в том, что ChatGPT — тоже одна из поверхностей, которые вы измеряете. Если вы карти́руете цитирования самого ChatGPT, делайте это в чистой сессии без загруженного метода, иначе загрязните наблюдение. Используйте одну сессию для сбора, другую — для систематизации.
Hermes Agent
Идеален, когда вы хотите, чтобы метод сохранялся как skill и улучшался от запуска к запуску без повторных объяснений.
Установите метод карты цитирований как skill Hermes вместе с набором вопросов и схемой вывода, затем запускайте по ритму; ежемесячно обычно верно. Поскольку skill и его память сохраняются, правки первого месяца переходят во второй. Если агент ошибочно классифицировал каталог как редакционный источник, вы правите правило один раз.
Цена — постоянная память требует периодического пересмотра. Раз в несколько запусков читайте файл skill и проверяйте, что накопленные правки всё ещё описывают нужный вам метод, а не кучу разовых исключений, которые никто не может объяснить.
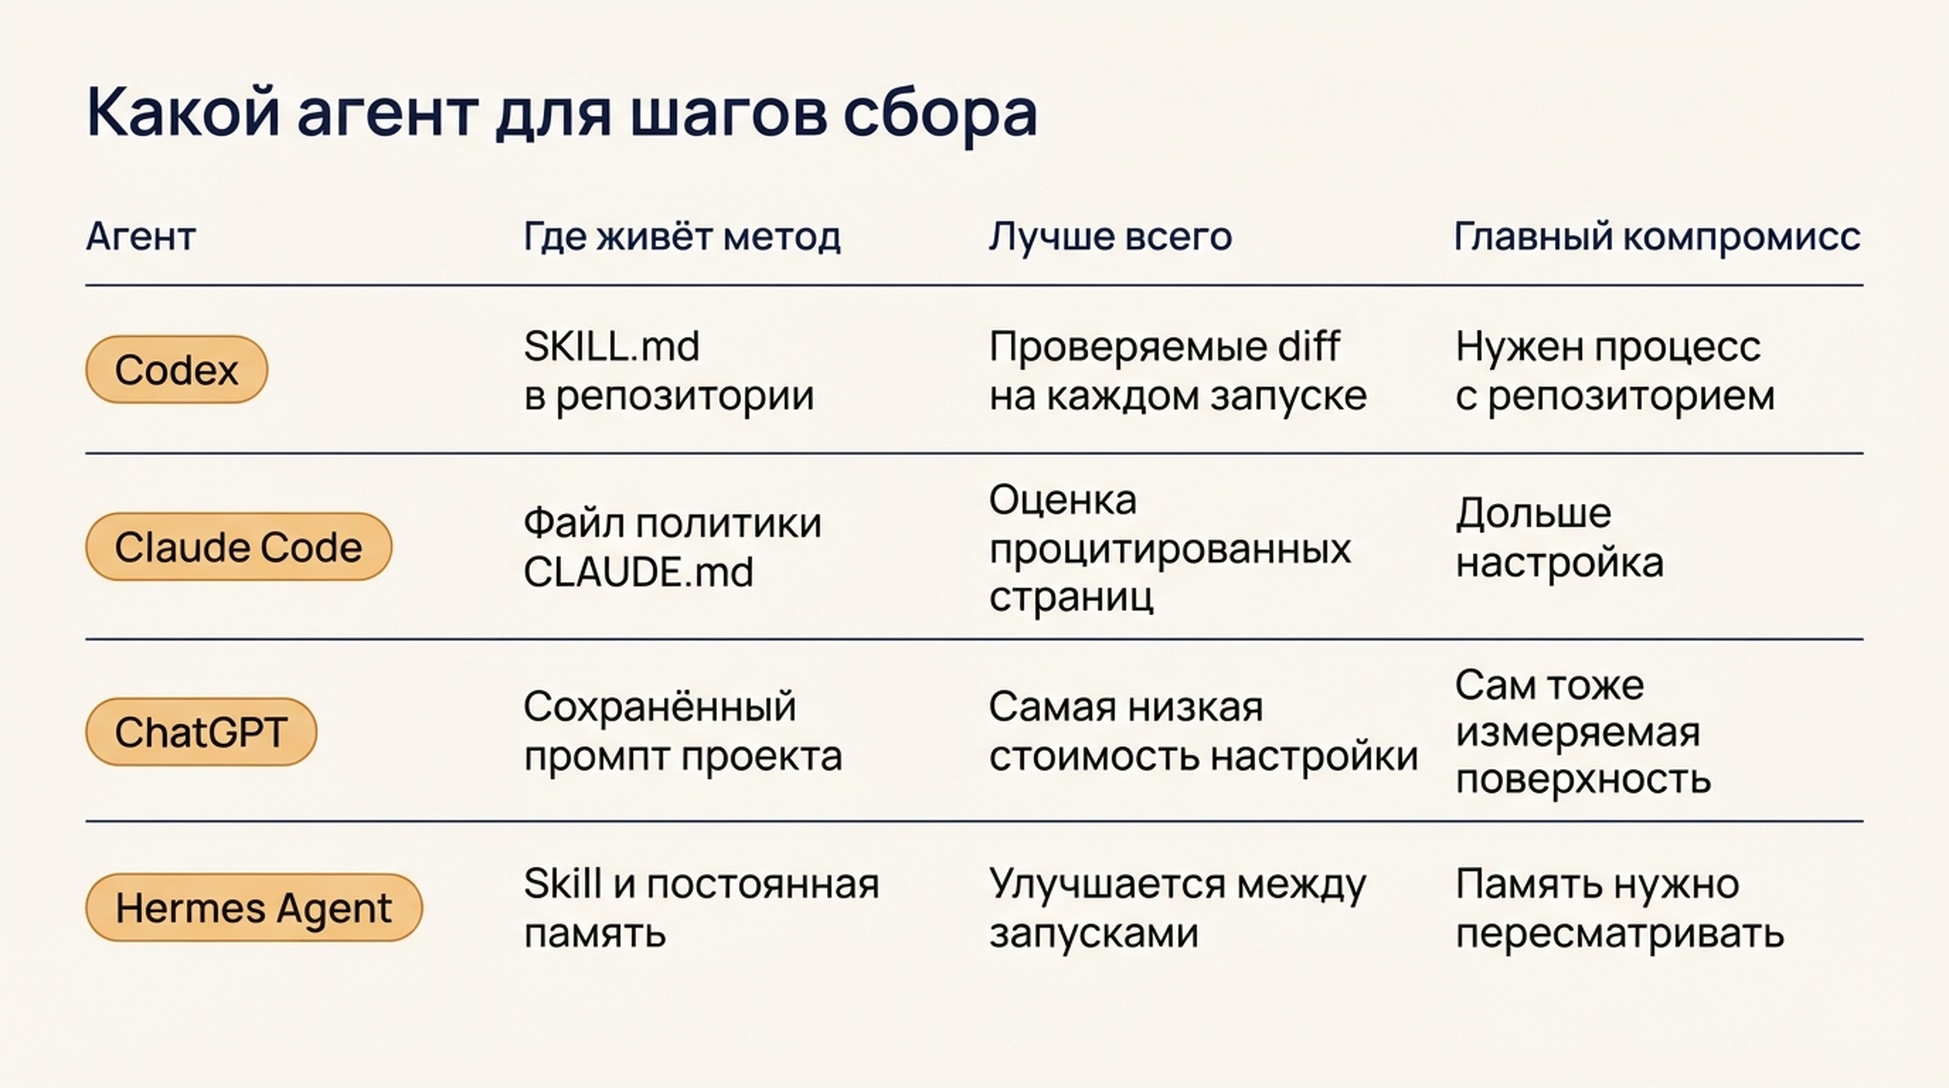
Все четыре выполняют одни и те же пять шагов. Выбирайте по тому, где должен жить метод, а не по тому, какая модель набрала больше баллов в бенчмарке.
Шаг 6: проверить карту, прежде чем действовать
Не распределяйте работу по непроверенной карте. Сначала прогоните эту проверку. Пять минут здесь экономят квартал усилий не в ту сторону.
- Прогоните три вопроса повторно через неделю. Если смесь источников меняется полностью, ваш набор вопросов слишком волатилен или выборка слишком мала. Фиксируйте разброс, а не считайте первый проход истиной. Какой-то разброс нормален; полная смена — это предупреждение.
- Подтверждайте движок, а не только ответ. Источник, появившийся в Perplexity, может отсутствовать в ChatGPT по тому же вопросу. Держите столбцы по движкам раздельно в сводке; объединённый итог скрывает именно тот сигнал, который вам нужен.
- Проверяйте и собственные цитирования. Если ваш бренд процитирован, откройте страницу. Иногда движок цитирует страницу, где о вас отзываются критически, или ту, которую вы не контролируете. Это полезная информация, а не победа.
- Подтверждайте дату в каждой строке. Карта цитирований без дат потом ни с чем не сравнивается.
- Проверяйте число источников. Если один вопрос вернул 40 источников, а остальные три, проверьте, не собрали ли вы панель «похожие» вместо реальных цитирований.
Что значит «готово»: вы можете отдать коллеге сводную таблицу и один отфильтрованный рабочий список, и он сможет действовать, не спрашивая, что означает любая из строк.
Поддержание карты
Прогоняйте полный проход раз в квартал по тому же набору вопросов и лёгкий проход ежемесячно по пяти вопросам с наибольшей коммерческой ценностью. Храните прошлые запуски. Интересный сигнал редко в снимке. Он в дрейфе: тип источника, который тихо растёт, или конкурент, начавший появляться в корзине, где его раньше не было.
Пересматривайте набор вопросов дважды в год. Вопросы о покупке меняются вместе с вашим продуктом и рынком, а устаревший набор даёт карту категории, которую вы больше не продаёте.
Одно, чему стоит сопротивляться: превращать это в дашборд. Результат — рабочий список с ответственными и URL. Если в конце ни у кого нет задачи, карта не сделала свою работу.
Частые вопросы
Нужен ли для этого платный инструмент видимости в ИИ? Нет. Ручная версия работает для одной категории и занимает полдня. Инструменты окупаются, когда вы отслеживаете много категорий или рынков, либо когда хотите исторические линии тренда, не поддерживая таблицу самостоятельно.
Сколько вопросов достаточно? От 10 до 20 на категорию. Меньше десяти — и вы не отличите закономерность от совпадения. Больше двадцати на первом проходе — и вы не закончите анализ, а именно анализ порождает рабочий список.
Включать ли вопросы, где мы уже появляемся? Да. Знать, какие источники вас держат, так же полезно, как знать, какие вас пропускают, и это подсказывает, что защищать при изменении контента.
Что если движок каждый раз даёт разный ответ? Это нормально и стоит фиксировать. Прогоните один и тот же вопрос трижды и отметьте разброс. Если набор источников каждый раз полностью разный, считайте вопрос низконадёжным и дайте ему меньший вес при приоритизации.
Можно ли просто использовать список источников движка, не открывая страницы? Для первичного сбора — да. Для строк, по которым вы будете действовать, — нет. Нужно прочитать страницу, чтобы оценить, действительно ли ваш бренд там уместен и что было бы полезным вкладом.
Чем это отличается от отслеживания позиций? Отслеживание позиций говорит, где ваши страницы появляются в списке результатов. Карта цитирований говорит, из каких страниц собран ответ. Страница может быть первой и никогда не цитироваться, а страница, которая нигде не ранжируется, может быть хребтом ответа. Именно этот разрыв и оправдывает потраченные полдня.
Автор: Ethan Marlowe, руководитель измерений GEO в Auspia, проанализировал более 500 промптов. Пишет об отслеживании промптов, отчётности по цитированиям, дашбордах видимости и о том, как отличить реальное изменение видимости в ИИ от шума между запусками.