इस लेख के अंत में आपके पास क्या होगा
साइटेशन मैप यह रिकॉर्ड है कि जब कोई AI इंजन आपके खरीदारों के सवालों का जवाब देता है, तो वह वाकई कौन-से पेज उठाता है। यह नहीं कि जवाब में आपका ब्रांड दिखा या नहीं। बल्कि यह कि वह जवाब किन स्रोतों से जोड़ा गया।
मैंने यह काम काफी श्रेणियों में चलाया है, इसलिए जानता हूँ कि पहला नतीजा आमतौर पर थोड़ा असहज करता है। टीमें मान लेती हैं कि उनकी अपनी वेबसाइट ही उन जवाबों को थामे हुए है। अक्सर ऐसा नहीं होता। एक B2B श्रेणी में खुद विक्रेता के पेज बहुत छोटा हिस्सा थे, जबकि एक समीक्षा साइट जिसे किसी ने दावा नहीं किया था, ज़्यादातर काम कर रही थी।
यही इस काम को करने की वजह है। आप अंदाज़ा लगाना बंद करते हैं और असली पेज देखने लगते हैं।
इस प्रक्रिया के अंत में आपके पास होगा:
- एक उत्पाद या सेवा श्रेणी के लिए 10 से 20 असली खरीद सवाल, ग्राहक के अपने शब्दों में लिखे हुए
- हर सवाल उन AI इंजनों में चलाया गया जो आपके खरीदार वाकई इस्तेमाल करते हैं, साइट किए गए स्रोतों के साथ तारीख दर्ज करके
- वे स्रोत प्रकार के हिसाब से लगाए हुए, ताकि आप देख सकें कि आपकी श्रेणी के जवाब कहाँ से आते हैं
- उन पेजों की छोटी सूची जहाँ प्रतिस्पर्धी साइट होता है और आप नहीं, हर एक के साथ एक जायज़ अगला कदम
- ज़िम्मेदार व्यक्ति और समीक्षा की तारीख, ताकि यह मैप किसी साझा फ़ोल्डर में सड़ न जाए
किसके लिए: अंदरूनी SEO, GEO या कंटेंट लीड, या ऐसा एजेंसी स्ट्रैटेजिस्ट जो सुझाव दे सकता है भले ही अमल कोई और करे। कोई पेड टूल ज़रूरी नहीं, हालाँकि बड़े पैमाने पर मदद करता है।
पहले से क्या चाहिए: एक ब्राउज़र, एक स्प्रेडशीट, और अपनी वेबसाइट पर पढ़ने की अनुमति। एजेंट वाले तरीकों के लिए, चुने हुए एजेंट की चलती हुई इंस्टॉल और एक फ़ोल्डर जिसकी ओर आप उसे इंगित कर सकें।
समय: एक श्रेणी में पहले दौर के लिए लगभग दो घंटे। इसमें से करीब 45 मिनट प्रॉम्प्ट चलाने और स्रोत कॉपी करने में जाते हैं। यही 45 मिनट वह हिस्सा है जिसे एजेंट को सौंपना बनता है, और बाकी वह हिस्सा है जिसमें आपका निर्णय चाहिए।
पूरा होने का मतलब: आप अपनी श्रेणी में जवाबों को थामने वाले तीन-चार स्रोत प्रकार बता सकते हैं, ऐसे ठोस पेज दिखा सकते हैं जहाँ आप नहीं हैं और प्रतिस्पर्धी है, और किसी को URL लगा हुआ काम सौंप सकते हैं। अगर आपके पास सिर्फ़ डोमेन की सूची और यह धुँधला अहसास है कि Reddit मायने रखता है, तो काम पूरा नहीं हुआ।
Auspia का नज़रिया: ज़्यादातर टीमें सीधे "हमें ब्रांड के और ज़िक्र चाहिए" पर पहुँच जाती हैं, क्योंकि उन्होंने कभी देखा ही नहीं कि जवाब असल में किससे बना है। मैप उस धुँधले अहसास को ऐसे पेज में बदल देता है जिस पर काम किया जा सके।
शुरू करने से पहले: दो फ़ैसले जो सब तय करते हैं
बाकी सब क्या पैदा करेगा, यह इन दो चुनावों से तय होता है। दोनों गलत करना आसान है और दोनों बाद में बदलना मुश्किल।
एक श्रेणी चुनें, पूरा कारोबार नहीं। जो कंपनी सॉफ़्टवेयर बेचती है और साथ में सेवाओं का हिस्सा भी चलाती है, उसके दो अलग स्रोत पारिस्थितिकी तंत्र हैं। दोनों को एक साथ मैप करने पर ऐसा औसत निकलता है जो किसी को भी नहीं दिखाता। जिस श्रेणी में सबसे ज़्यादा राजस्व दाँव पर है वह चुनें और बाकी अगली तिमाही के लिए छोड़ दें।
इंजन सोच-समझकर चुनें। Google AI Overview, ChatGPT, Perplexity और Gemini एक ही कुएँ से पानी नहीं खींचते। जो स्रोत एक इंजन में अपनी अहमियत खो चुका है, वह दूसरे में अब भी गिना जा सकता है। कम से कम दो चलाएँ। अगर पता नहीं कौन-से दो, तो सेल्स टीम से पूछें कि ग्राहक किस सतह का ज़िक्र करते हैं, या AI डोमेन से आने वाला रेफ़रल ट्रैफ़िक देखें।
अभी एक सीमा खींच लें। यह निरीक्षण का अभ्यास है, सबूत देने का नहीं। आप दर्ज कर रहे हैं कि किसी ख़ास दिन किसी इंजन ने क्या लौटाया। जवाब हर बार बदलते हैं, इसलिए एक अकेला निरीक्षण एक डेटा बिंदु है, कोई रुझान नहीं। हर चीज़ पर तारीख लगाएँ, वरना पूरी फ़ाइल एक महीने में बेकार हो जाएगी।
चरण 1: सवालों का सेट बनाएँ
ऐसे 10 से 20 सवाल लिखें जो ग्राहक चुनाव करते समय पूछेगा। कीवर्ड नहीं। सवाल, ग्राहक के अपने शब्दों में।
यही वह चरण है जिसे लोग जल्दबाज़ी में छोड़ देते हैं, और यही तय करता है कि बाकी काम करने लायक है या नहीं। कीवर्ड एक्सपोर्ट से बना सवालों का सेट यह नक्शा देता है कि लोग कैसे खोजते हैं। सेल्स कॉल नोट्स से बना सेट यह नक्शा देता है कि लोग कैसे ख़रीदते हैं। दोनों एक सूची नहीं हैं।
जिन चीज़ों से सवाल निकाल सकते हैं:
- सेल्स टीम को सबसे ज़्यादा मिलने वाले ख़रीद-पूर्व सवाल
- ख़रीद के बाद पहले 30 दिनों के सपोर्ट टिकट
- आपके मुख्य व्यावसायिक क्वेरी के "लोग यह भी पूछते हैं" ब्लॉक
- आपकी खुद की कीवर्ड रिसर्च, सवाल के रूप में दोबारा लिखी हुई
- आपके खरीदारों की प्रतिस्पर्धी तुलना वाली खोजें
सवालों के प्रकार मिलाएँ, क्योंकि हर प्रकार अलग स्रोत खींचता है।
सवाल का प्रकार | उदाहरण | आमतौर पर कौन-से स्रोत आते हैं |
|---|---|---|
श्रेणी की उपयुक्तता | "मँझोली लॉजिस्टिक्स कंपनी को रूटिंग टूल चुनते समय क्या देखना चाहिए?" | संपादकीय सूचियाँ, समीक्षा साइटें |
सीधी तुलना | "20 लोगों की टीम के लिए टूल A या टूल B?" | तुलना पेज, कम्युनिटी थ्रेड |
जोखिम और आपत्ति | "क्या टूल A स्वास्थ्य डेटा के लिए सचमुच पर्याप्त सुरक्षित है?" | फ़ोरम, अनुपालन विश्लेषण, विक्रेता दस्तावेज़ |
कीमत और मूल्य | "टूल A की असल में प्रति सीट कितनी कीमत है?" | कीमत पेज, कम्युनिटी थ्रेड, समीक्षा साइटें |
क्रियान्वयन | "टूल B से हटने में कितना समय लगता है?" | दस्तावेज़, YouTube वॉकथ्रू, फ़ोरम |
अपेक्षित नतीजा: एक स्प्रेडशीट जिसमें हर सवाल के लिए एक पंक्ति, सवाल के प्रकार का एक कॉलम, और उस इंजन का एक कॉलम जिसमें आप उसे चलाएँगे।
गुणवत्ता जाँच: सूची दोबारा पढ़ें और पूछें कि क्या कोई असली खरीदार इन्हें टाइप करेगा। अगर कोई सवाल सिर्फ़ उसी को समझ आता है जो आपके उत्पाद का वर्गीकरण पहले से जानता है, तो उसे दोबारा लिखें। खरीदार के वाकई पूछे जाने वाले दस सवाल कीवर्ड एक्सपोर्ट जैसे लगने वाले पचास सवालों से बेहतर हैं।
सुधार का रास्ता: अगर दस सवाल तक नहीं पहुँच पा रहे, तो यह रिसर्च की समस्या है, मैपिंग की नहीं। आगे बढ़ने से पहले पिछले 20 सेल्स कॉल नोट्स या पिछले 50 सपोर्ट टिकट निकालें और उनसे सवाल छाँटें।
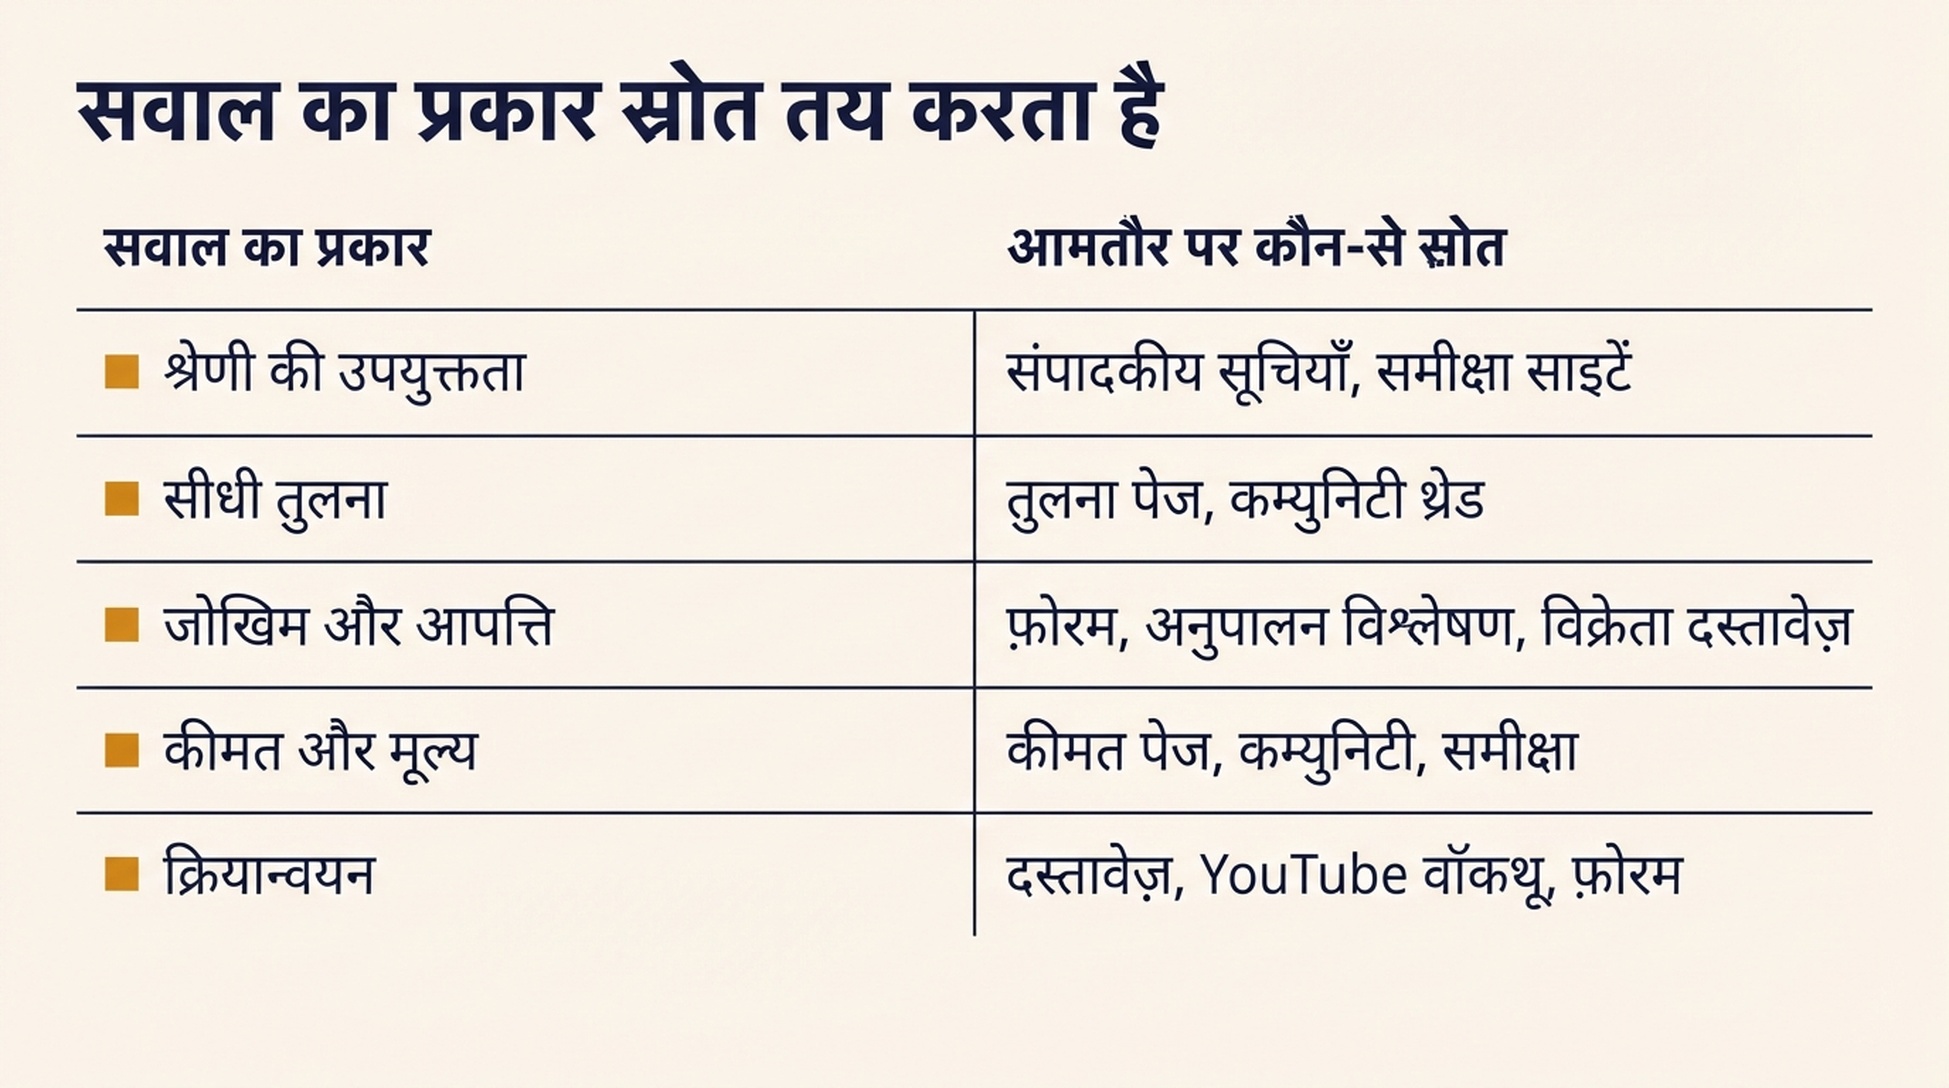
सवाल का प्रकार छिपा हुआ चर है। एक ही उत्पाद पर सीधी तुलना का सवाल और जोखिम का सवाल एक जैसे स्रोत नहीं लौटाते।
चरण 2: सवाल चलाएँ और स्रोत दर्ज करें
यही यांत्रिक कोर है, और यहीं हाथ से किया गया काम बिखरता है। पाँच सवाल हाथ से करें ताकि समझ आए कि नतीजा कैसा दिखना चाहिए। फिर बाकी अपने आप कराएँ।
हर सवाल के लिए, हर इंजन में:
- नई बातचीत शुरू करें। पिछला संदर्भ बदल देता है कि इंजन क्या निकालेगा।
- सवाल ठीक वैसे ही पूछें जैसे लिखा था।
- साइटेशन पैनल या स्रोत सूची खोलें। ज़्यादातर इंजनों में यह जवाब के पास एक छोटा आइकन है, दिखने वाली सूची नहीं।
- हर साइट किए गए URL को दर्ज करें, साथ में डोमेन और स्रोत प्रकार भी।
- तारीख, इंजन, और यह कि जवाब में कोई साइटेशन था या नहीं, नोट करें।
इस ढाँचे में दर्ज करें:
फ़ील्ड | क्यों ज़रूरी है |
|---|---|
सवाल ID | हर निरीक्षण को खरीद सवाल से जोड़ता है |
इंजन | बाद में इंजन-वार पैटर्न अलग करने देता है |
तारीख और समय | जवाब बदलते रहते हैं; बिना तारीख की पंक्ति एक महीने में बेकार |
साइट किया URL | असली पेज, सिर्फ़ डोमेन नहीं |
डोमेन | समूह बनाने और आवृत्ति गिनने के लिए |
स्रोत प्रकार | अपना, रिटेल/मार्केटप्लेस, कम्युनिटी, समीक्षा डायरेक्टरी, संपादकीय |
प्रतिस्पर्धी मौजूद | हाँ/नहीं, और कौन |
हमारा ब्रांड मौजूद | जवाब में, स्रोतों में, दोनों में, या किसी में नहीं |
आख़िरी पंक्ति पर ठहरना बनता है। कोई ब्रांड जवाब में नाम लिए बिना भी आ सकता है, जबकि उसका कोई पेज साइट न हुआ हो। और कोई ब्रांड बिना प्रमुखता से नाम लिए भी साइट हो सकता है। ये दो अलग संकेत हैं, और अगर आप सिर्फ़ "हम दिखे या नहीं" देखते हैं, तो दोनों को गलत पढ़ेंगे। मैंने ऐसी टीमें देखी हैं जो ऐसे पेज से आए ज़िक्र पर खुश हो रही थीं जो उनके ख़िलाफ़ दलील दे रहा था।
अपेक्षित नतीजा: एक लंबी तालिका, हर साइट किए स्रोत, हर सवाल और हर इंजन के लिए एक पंक्ति।
गुणवत्ता जाँच: कम से कम तीन पंक्तियों में क्लिक करके देखें कि साइट किया पेज वाकई उस दावे को थामता है जिसके लिए उसे साइट किया गया। इंजन कभी-कभी ऐसा पेज साइट करते हैं जो विषय का ज़िक्र करता है पर सवाल का जवाब नहीं देता। ऐसी पंक्तियाँ शोर हैं और उन्हें चिह्नित करना चाहिए।
सुधार का रास्ता: अगर कोई इंजन किसी सवाल पर कोई साइटेशन नहीं लौटाता, तो यह खोज है, नाकामी नहीं। उसे शून्य स्रोत के रूप में दर्ज करें और आगे बढ़ें। जिन सवालों का जवाब बिना रिट्रीवल के मिल जाता है, उन पर आपका कंटेंट असर नहीं डाल सकता।
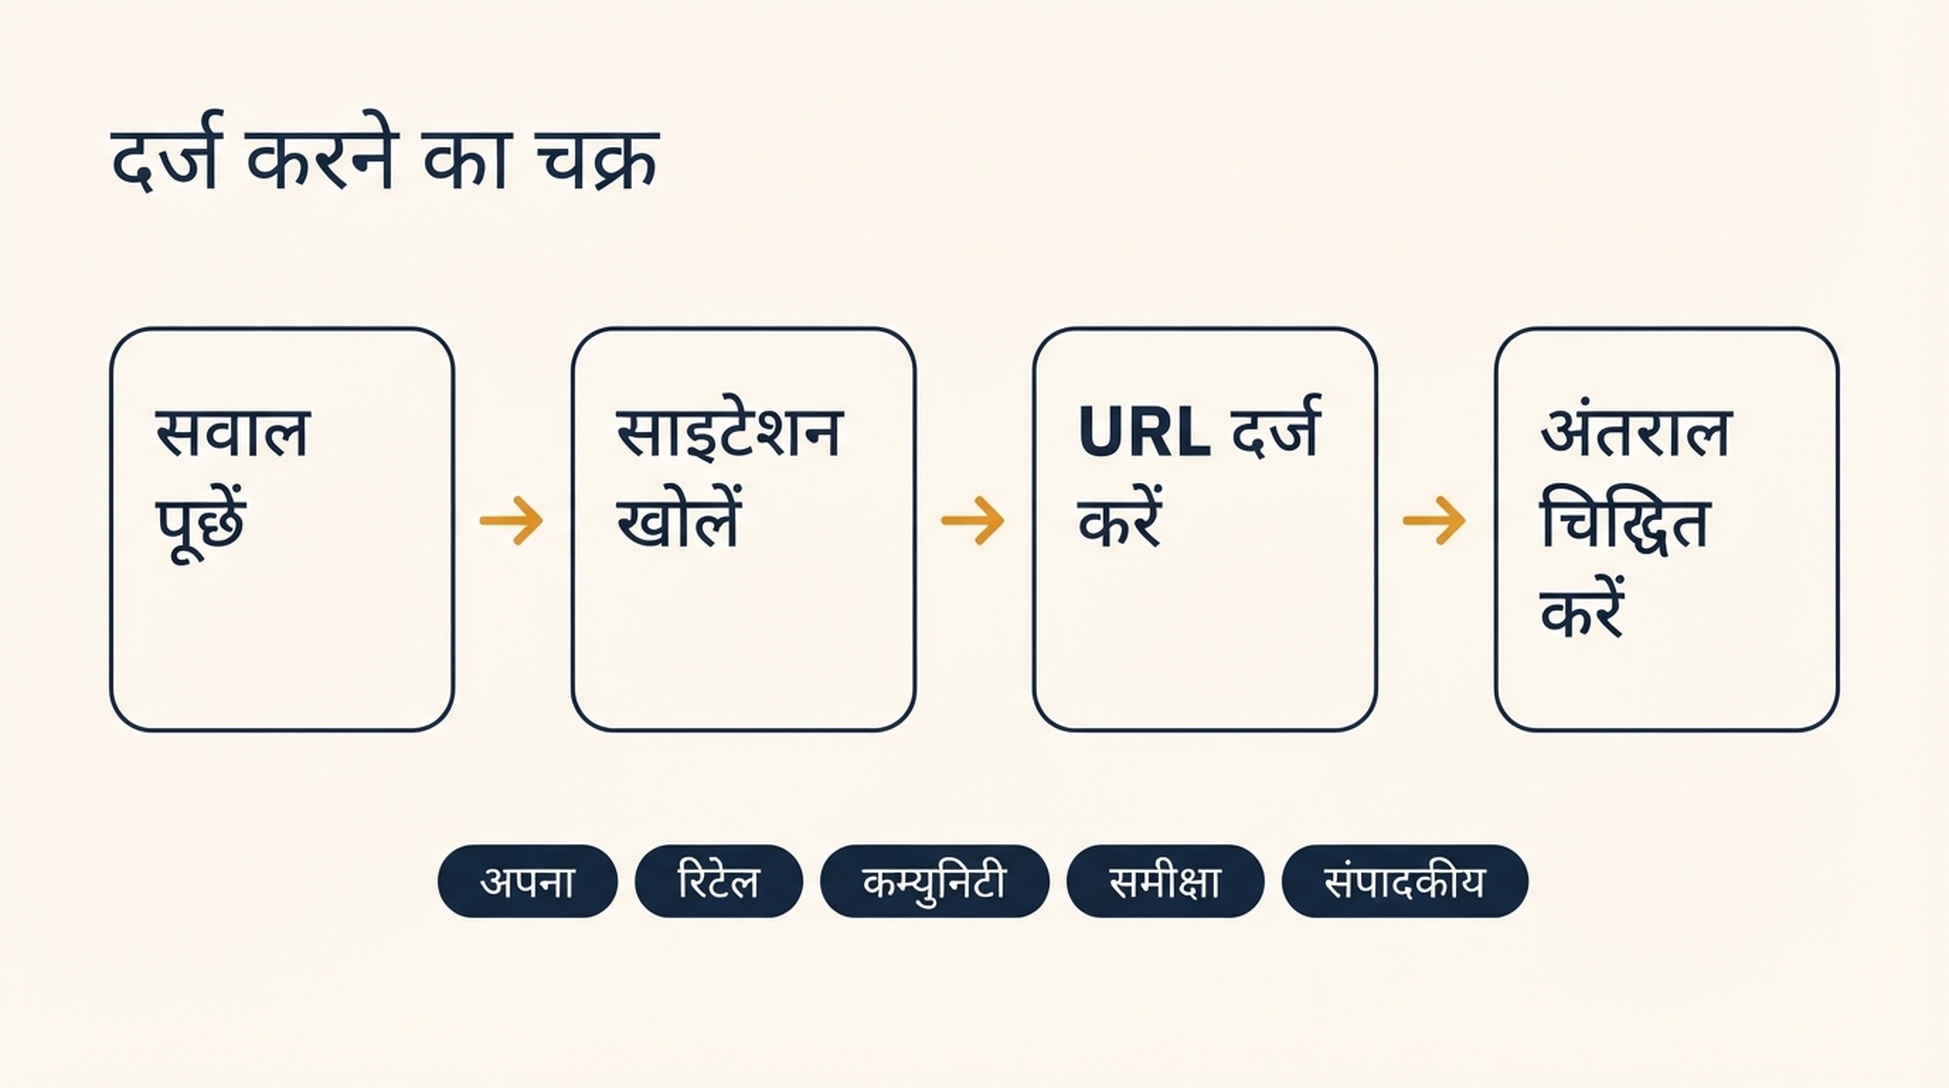
यह चक्र सीधा और ऊबाऊ है। यही मेल इसे एजेंट को सौंपने लायक बनाता है।
चरण 3: स्रोतों को प्रकार के हिसाब से लगाएँ
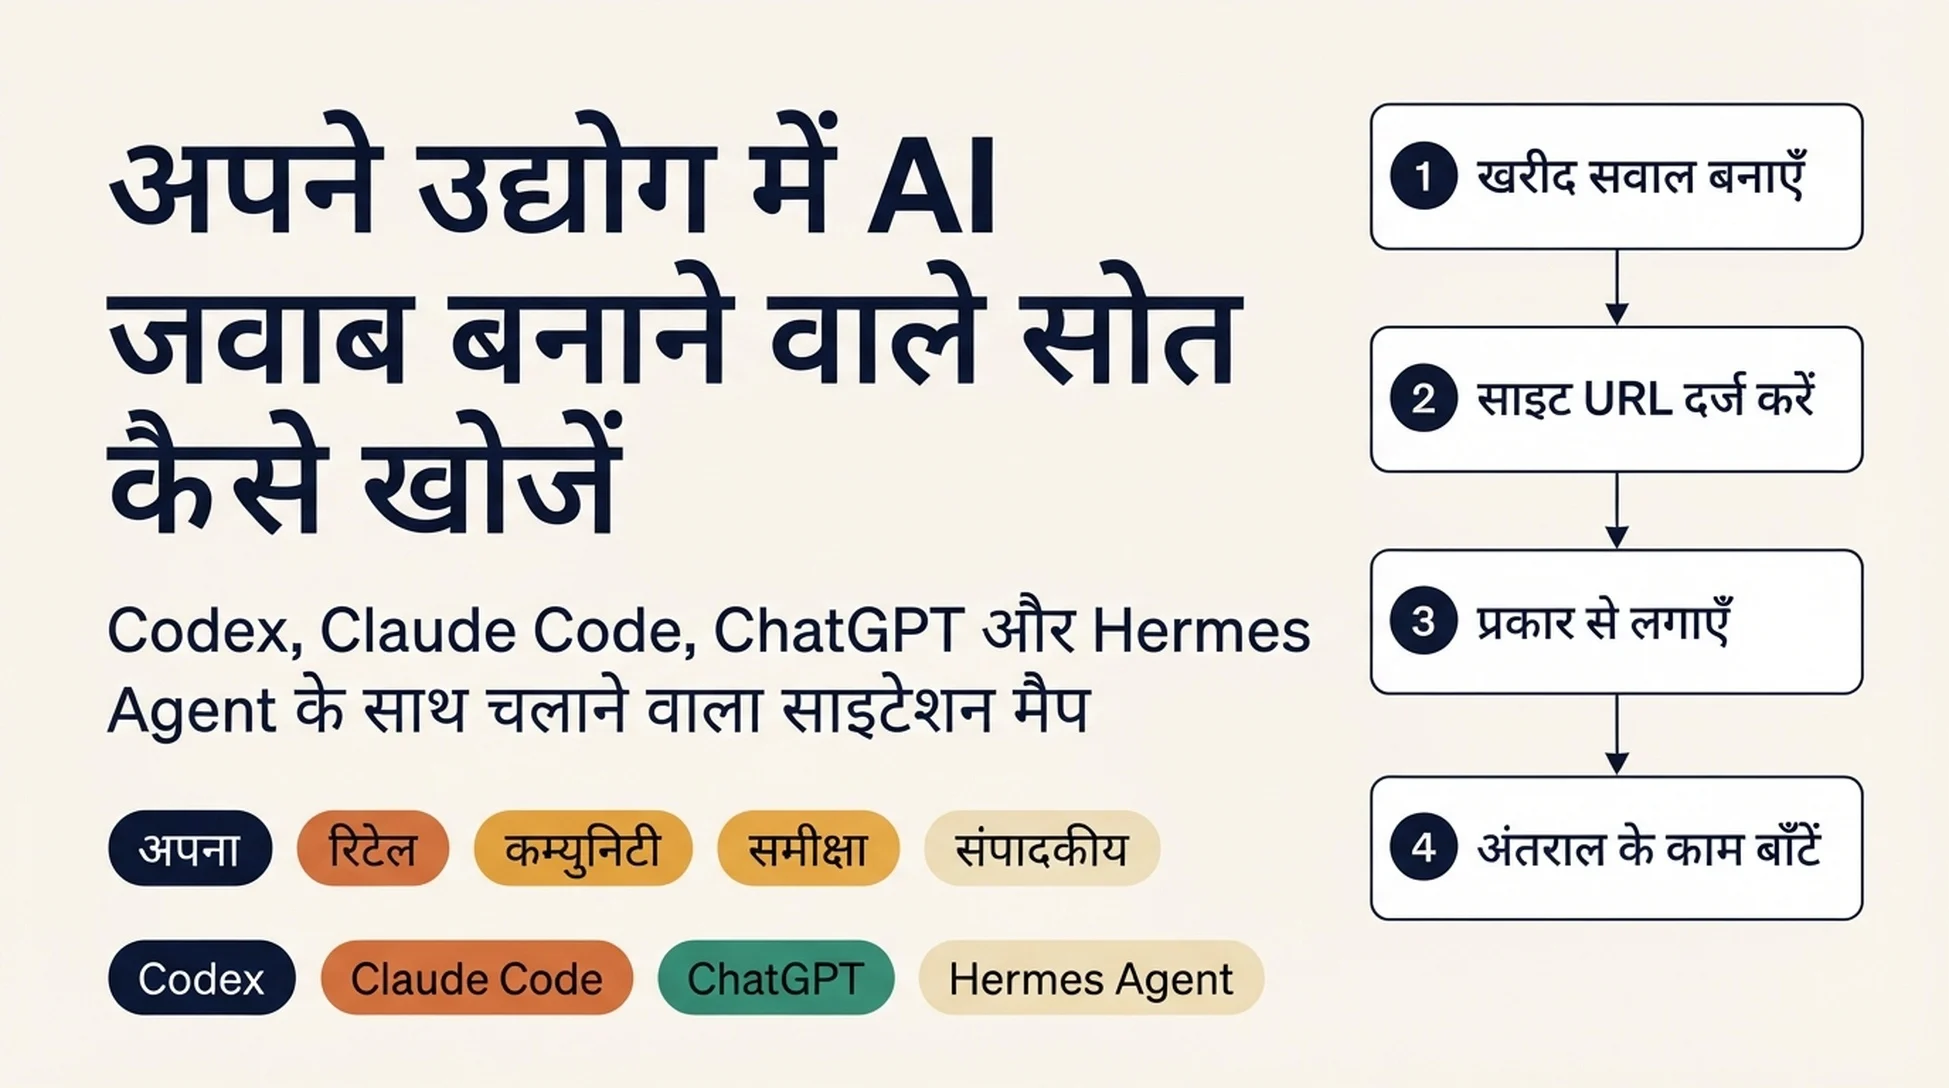
अब लंबी तालिका को अपनी श्रेणी की तस्वीर में दबा दें। हर साइट किए URL को पाँच में से एक बाल्टी में डालें:
- अपना: आपकी साइट, या किसी प्रतिस्पर्धी की
- रिटेल और मार्केटप्लेस: उत्पाद लिस्टिंग, कीमत तुलना पेज, ऐप स्टोर
- कम्युनिटी और UGC: Reddit, YouTube, Quora, फ़ोरम, इंडेक्स किए Discord थ्रेड
- समीक्षा डायरेक्टरी और B2B प्लेटफ़ॉर्म: G2, Capterra, Clutch, Trustpilot, उद्योग-विशेष डायरेक्टरी
- स्वतंत्र संपादकीय और संदर्भ: उद्योग मीडिया, समाचार, Wikipedia, विश्लेषक रिपोर्ट, स्वतंत्र ब्लॉग
बाल्टी-वार और इंजन-वार गिनें, और आपका साइटेशन मैप तैयार है।
आप जो ढूँढ रहे हैं वह कोई अकेला आँकड़ा नहीं है। वह आकार है। कुछ श्रेणियाँ लगभग पूरी तरह कम्युनिटी थ्रेड और उद्योग मीडिया पर टिकी हैं, और ब्रांड की अपनी साइट लगभग कुछ नहीं देती। दूसरी श्रेणियों पर उत्पाद लिस्टिंग हावी है, क्योंकि जवाब खुद लिस्टिंग में है। यह मेल इस पर निर्भर है कि खरीदार क्या पूछते हैं, इस पर नहीं कि किसकी साइट कितनी अच्छी है। यह स्वीकार करना मुश्किल है जब आपने साइट पर दो साल लगाए हों।
अपेक्षित नतीजा: एक छोटी तालिका, हर स्रोत प्रकार के लिए एक पंक्ति, हर इंजन के लिए एक कॉलम, जिसमें साइट किए स्रोतों का हिस्सा दिखे।
गुणवत्ता जाँच: अगर एक बाल्टी में आपके साइटेशन का करीब 70% से ज़्यादा है, तो उसके अंदर पाँच URL जाँचें कि वे सचमुच उसी प्रकार के हैं। कोई हाई-ट्रैफ़िक एग्रीगेटर संपादकीय स्रोत का रूप धर सकता है जबकि असल में वह डायरेक्टरी हो।
सुधार का रास्ता: अगर आँकड़े बेतरतीब लगें, तो शायद आपने सवालों के प्रकार मिला दिए और इससे पैटर्न छिप गया। तालिका को सवाल के प्रकार से बाँटें और दोबारा देखें। कीमत और जोखिम के सवालों के स्रोत प्रोफ़ाइल अक्सर पूरी तरह अलग होते हैं।
चरण 4: वे अंतराल खोजें जहाँ प्रतिस्पर्धी साइट हो और आप नहीं
लंबी तालिका को उन पंक्तियों तक छानें जहाँ प्रतिस्पर्धी दिखता है और आपका ब्रांड नहीं। यही छनी हुई सूची आपकी काम की सूची है। यह "हमें और ज़िक्र चाहिए" जैसे ढीले आदेश से कहीं ज़्यादा उपयोगी है, क्योंकि हर पंक्ति में पहले से एक URL और एक ग्राहक सवाल जुड़ा है। सोमवार को किसी को दे दें, वह तुरंत शुरू कर सकता है।
हर पंक्ति के लिए साइट किया पेज खोलें और तीन सवालों के जवाब दें:
- क्या हमारा उत्पाद वाकई इस पेज पर होना चाहिए?
- अगर हाँ, तो क्या कम है: ऐसी लिस्टिंग जिसे हमने कभी दावा नहीं किया, ऐसी तुलना जिसमें हम नहीं हैं, ऐसा थ्रेड जिसमें किसी ने हमें नहीं बताया, ऐसी समीक्षा जो हमने कभी माँगी नहीं?
- वह सबसे छोटा जायज़ कदम क्या है जो हमें वहाँ पहुँचा दे?
तीसरा सवाल वह जगह है जहाँ अनुशासन आता है। कदम हर बाल्टी में अलग है। यहाँ गलती का मतलब है कि कोई SEO विशेषज्ञ Reddit थ्रेड के बारे में पत्रकारों को कोल्ड ईमेल भेजने लगे।
स्रोत प्रकार | जायज़ कदम | क्या न करें |
|---|---|---|
समीक्षा डायरेक्टरी | प्रोफ़ाइल दावा करें और पूरी करें, ग्राहकों से समीक्षा माँगें | समीक्षा ख़रीदना या नकली डालना |
कम्युनिटी थ्रेड | नाम बताते हुए कर्मचारी के रूप में ईमानदारी से जवाब दें, जुड़ाव बताएँ | एस्ट्रोटर्फ़िंग, या बिना योगदान लिंक छोड़ना |
संपादकीय | ऐसा नया उपयोगी कोण सुझाएँ जो मीडिया ने नहीं उठाया | वही प्रेस रिलीज़ 200 डोमेन पर भेजना |
मार्केटप्लेस या रिटेल लिस्टिंग | स्पेक, तस्वीरें और विवरण ठीक करें ताकि तथ्य निकाले जा सकें | लिस्टिंग में कीवर्ड ठूँसना |
अपना पेज | दोबारा ढाँचा बनाएँ ताकि ठोस तथ्य मिलना और साइट होना आसान हो | ऐसा FAQ जोड़ना जो कुछ जवाब न दे |
अपेक्षित नतीजा: एक छनी हुई और प्राथमिकता वाली सूची। डोमेन कितना नामी लगता है इससे नहीं, बल्कि यह कि स्रोत आपके सवालों के सेट में कितनी बार आता है, उससे क्रम लगाएँ। बीस में से छह सवालों पर साइट होने वाला फ़ोरम थ्रेड एक बार साइट होने वाले उद्योग प्रकाशन से ऊपर है, और उस पर काम करना भी कहीं आसान है।
गुणवत्ता जाँच: हर रखी गई पंक्ति के लिए पक्का करें कि आप उससे जुड़ा ग्राहक सवाल बता सकते हैं। अगर नहीं, तो पंक्ति हटा दें। जिन सवालों को आपकी पाइपलाइन में कोई नहीं पूछता, उन पर साइट होने वाले पेज सिर्फ़ ध्यान भटकाते हैं।
सुधार का रास्ता: अगर छनी हुई सूची अब भी बहुत बड़ी है, तो आपने काफ़ी सख़्ती से नहीं छाना। पहला दौर दस पंक्तियों तक सीमित करें, साइटेशन आवृत्ति के क्रम में, और पूरी सूची दोबारा खोलने से पहले उन्हें निपटाएँ।
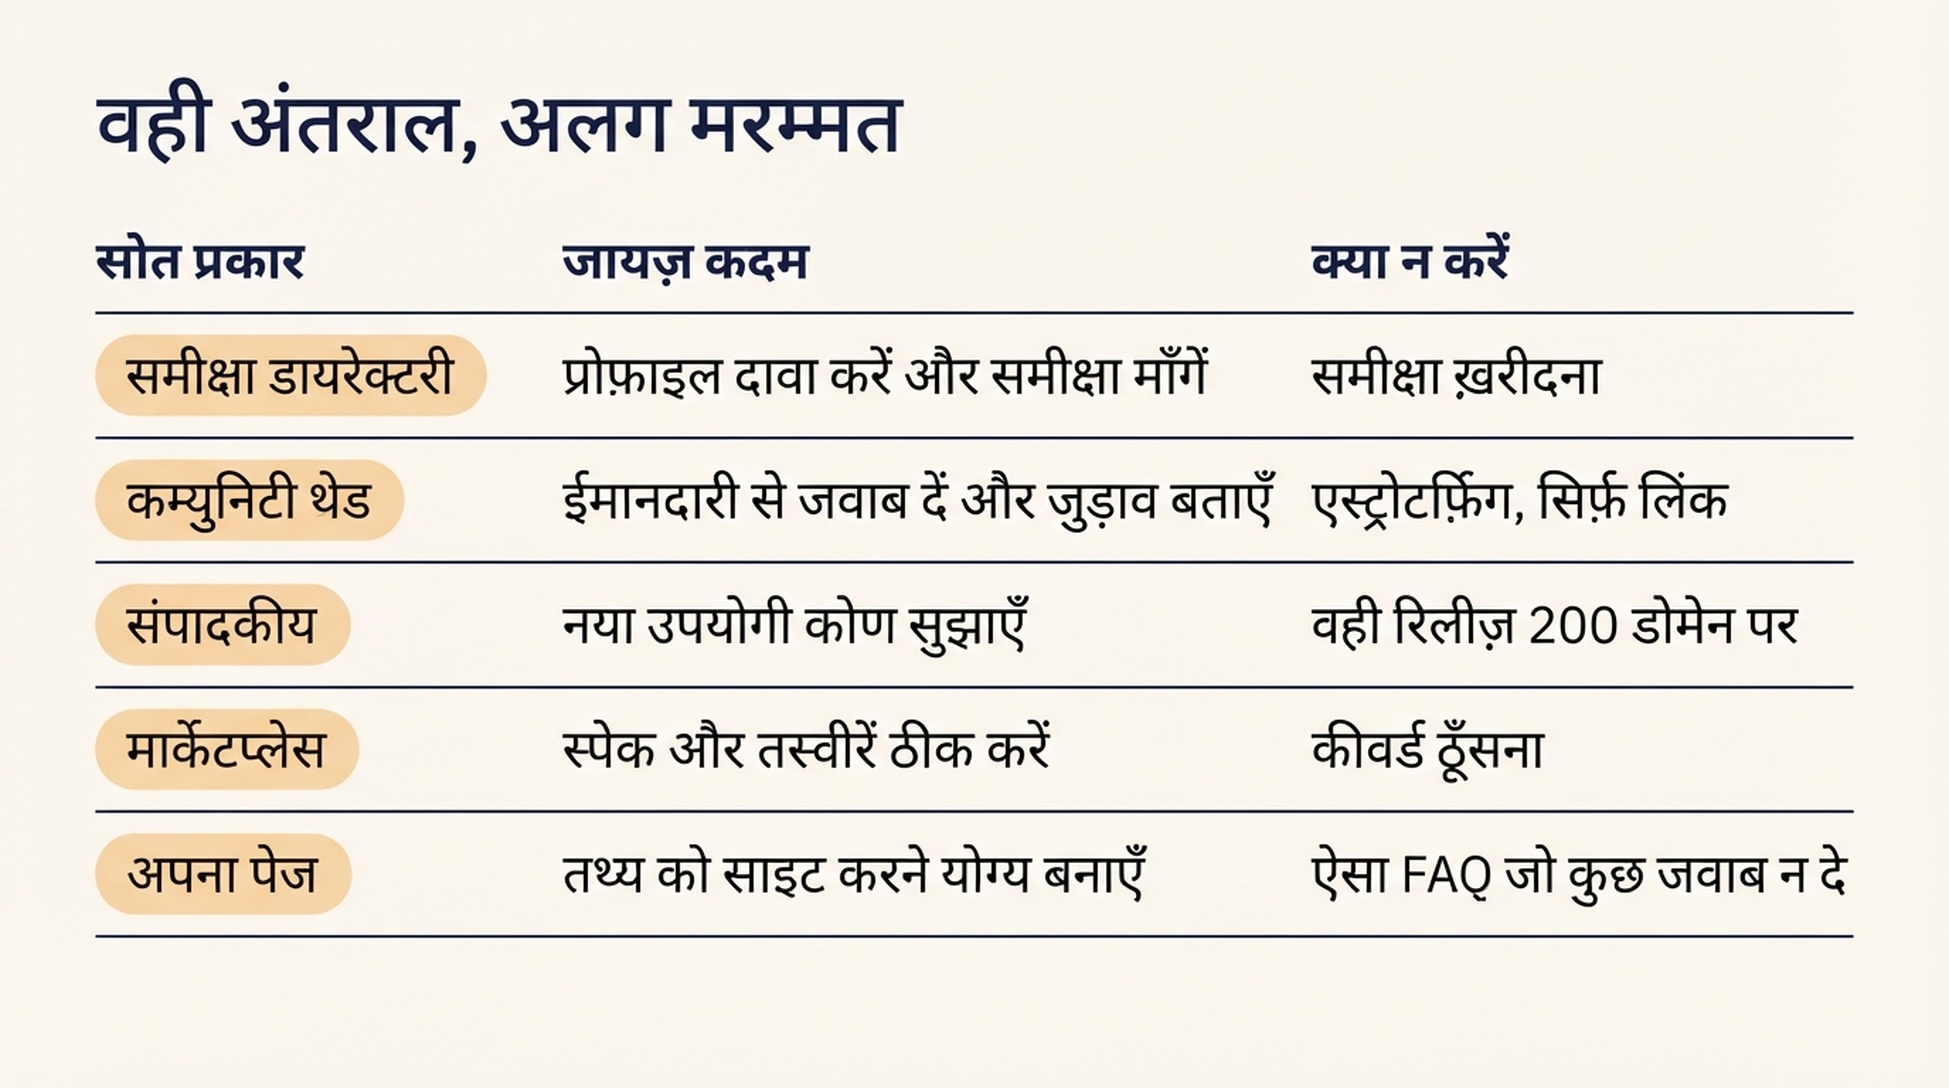
वही अंतराल, अलग मरम्मत। हर छूटे साइटेशन को आउटरीच की समस्या मानना वह रास्ता है जिस पर टीमें संपादक को Reddit थ्रेड बेचने पहुँच जाती हैं।
चरण 5: यांत्रिक आधा हिस्सा एजेंट को सौंपें
चरण 2 और 3 सबसे ज़्यादा समय लेते हैं और सबसे कम निर्णय माँगते हैं। यही उस काम की परिभाषा है जिसे सौंपना बनता है। सवालों का सेट और प्राथमिकता इंसान के पास रहती है, क्योंकि यही दो जगहें हैं जहाँ गलत निर्णय पूरा अभ्यास बेकार कर देता है।
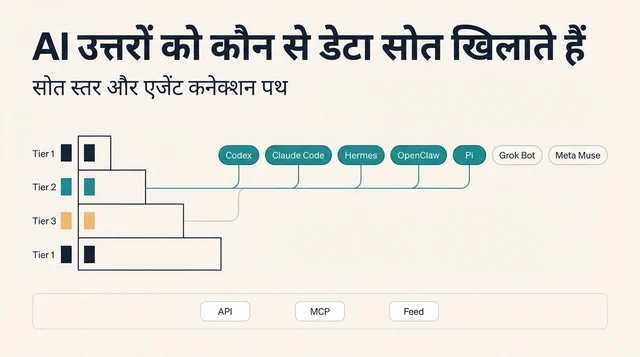
नीचे दिए चारों एजेंट यही तरीका चला सकते हैं। बदलता यह है कि तरीका कहाँ रहता है और नतीजा कैसे लौटता है। इसी आधार पर चुनें, इस पर नहीं कि इस महीने कौन-सा मॉडल बेंचमार्क जीतता है।
Codex
तब बेहतर जब आप चाहते हैं कि मैप किसी रिपॉज़िटरी में रहे और हर बार चलने पर समीक्षित आर्टिफ़ैक्ट दे। अगर आपकी साइट पहले से git में है, तो यह सबसे कम रगड़ वाला रास्ता है।
एक प्रोजेक्ट फ़ोल्डर बनाएँ जिसमें citation-map/ डायरेक्टरी, सवालों का सेट रखने वाली questions.csv, और तरीका बताने वाली SKILL.md हो: कौन-से इंजन जाँचने हैं, कौन-से फ़ील्ड दर्ज करने हैं, स्रोत को कैसे वर्गीकृत करना है, और आउटपुट फ़ाइल कैसी दिखनी चाहिए। हर बार चलाने पर एक फ़ाइल रखें, तारीख से नाम दें, ताकि ऊपर लिखने के बजाय इतिहास जमा हो।
Codex से कहें कि सवाल चलाए, मौजूदा रन फ़ाइल में पंक्तियाँ जोड़े, और इंजन-वार स्रोत हिस्से की सारांश तालिका बनाए। चूँकि आउटपुट रिपॉज़िटरी में एक फ़ाइल है, आपको ऐसा diff मिलता है जिसे कुछ भी अंतिम मानने से पहले देख सकें। यही समीक्षा चरण असली बात है: आप वर्गीकरण जाँच रहे हैं, दर्ज करना दोबारा नहीं कर रहे।
एक नियम हर हाल में SKILL.md में होना चाहिए: एजेंट वही दर्ज करता है जो उसने देखा, और ऐसा साइटेशन नहीं निकालता जो उसने नहीं देखा। स्रोत गढ़ना इस प्रक्रिया का सबसे नुकसानदेह फ़ेल्योर मोड है। लिखा हुआ नियम और तीन पंक्तियों की नमूना जाँच ज़्यादातर रोक देती है, और जिन तीन पंक्तियों को आप जाँचें वे हर बार बदलनी चाहिए।
Claude Code
तब बेहतर जब तरीके को किसी स्पष्ट लिखी नीति के सामने पढ़ना हो, और जब आप दर्ज किए पेजों को लंबे संदर्भ में देखना चाहें।
तरीका CLAUDE.md या किसी प्रोजेक्ट skill में रखें, जिसमें स्रोत प्रकारों की परिभाषाएँ और सटीक आउटपुट स्कीमा हों। Claude Code को रन फ़ोल्डर की ओर इंगित करें और कहें कि हर साइट किए URL को वर्गीकृत करे, फिर उन पंक्तियों को चिह्नित करे जहाँ पेज का कंटेंट वाकई साइटेशन को नहीं थामता।
दूसरा काम वह है जिसके लिए पैसा देना बनता है। 200 साइट किए पेज पढ़कर यह तय करना कि हर एक सचमुच सवाल का जवाब देता है या नहीं, इंसान के लिए पीड़ादायक है और लिखे हुए मानक वाले एजेंट के लिए उचित है। हर पंक्ति पर भरोसे का झंडा माँगें और सिर्फ़ कम भरोसे वाली पंक्तियाँ खुद देखें।
ChatGPT
तब बेहतर जब आप सबसे कम सेटअप लागत चाहते हैं और काम एक ही बैठक का है, बार-बार चलने वाला नहीं।
तरीका कस्टम इंस्ट्रक्शन या सहेजे गए प्रोजेक्ट प्रॉम्प्ट के रूप में चिपकाएँ, सवालों की सूची लगाएँ, और इंजन-वार बैच में काम करें। आउटपुट ऐसी तालिका में माँगें जिसके कॉलम ठीक चरण 2 जैसे हों, ताकि वह सीधे स्प्रेडशीट में चिपक जाए।
पेच यह है कि ChatGPT भी उन सतहों में से एक है जिन्हें आप माप रहे हैं। अगर आप ChatGPT के खुद के साइटेशन मैप कर रहे हैं, तो यह काम ऐसी साफ़ बातचीत में करें जिसमें आपका तरीका लोड न हो, वरना निरीक्षण दूषित हो जाएगा। दर्ज करने के लिए एक बातचीत और व्यवस्थित करने के लिए दूसरी रखें।
Hermes Agent
तब बेहतर जब आप चाहते हैं कि तरीका skill के रूप में बना रहे और बिना दोबारा समझाए हर बार चलने पर सुधरता जाए।
साइटेशन मैप का तरीका सवालों के सेट और आउटपुट स्कीमा के साथ Hermes skill के रूप में इंस्टॉल करें, फिर एक लय पर चलाएँ; महीने-महीने आमतौर पर ठीक रहता है। चूँकि skill और उसकी मेमोरी बनी रहती है, पहले महीने के सुधार दूसरे महीने में चले जाते हैं। अगर एजेंट ने किसी डायरेक्टरी को गलती से संपादकीय स्रोत मान लिया, तो नियम एक बार ठीक करें।
कीमत यह है कि स्थायी मेमोरी को समय-समय पर देखना पड़ता है। हर कुछ बार चलाने पर skill फ़ाइल पढ़ें और जाँचें कि जमा हुए सुधार अब भी वही तरीका बताते हैं जो आप चाहते हैं, न कि ऐसे एकबारगी अपवादों का ढेर जिसे कोई समझा न सके।
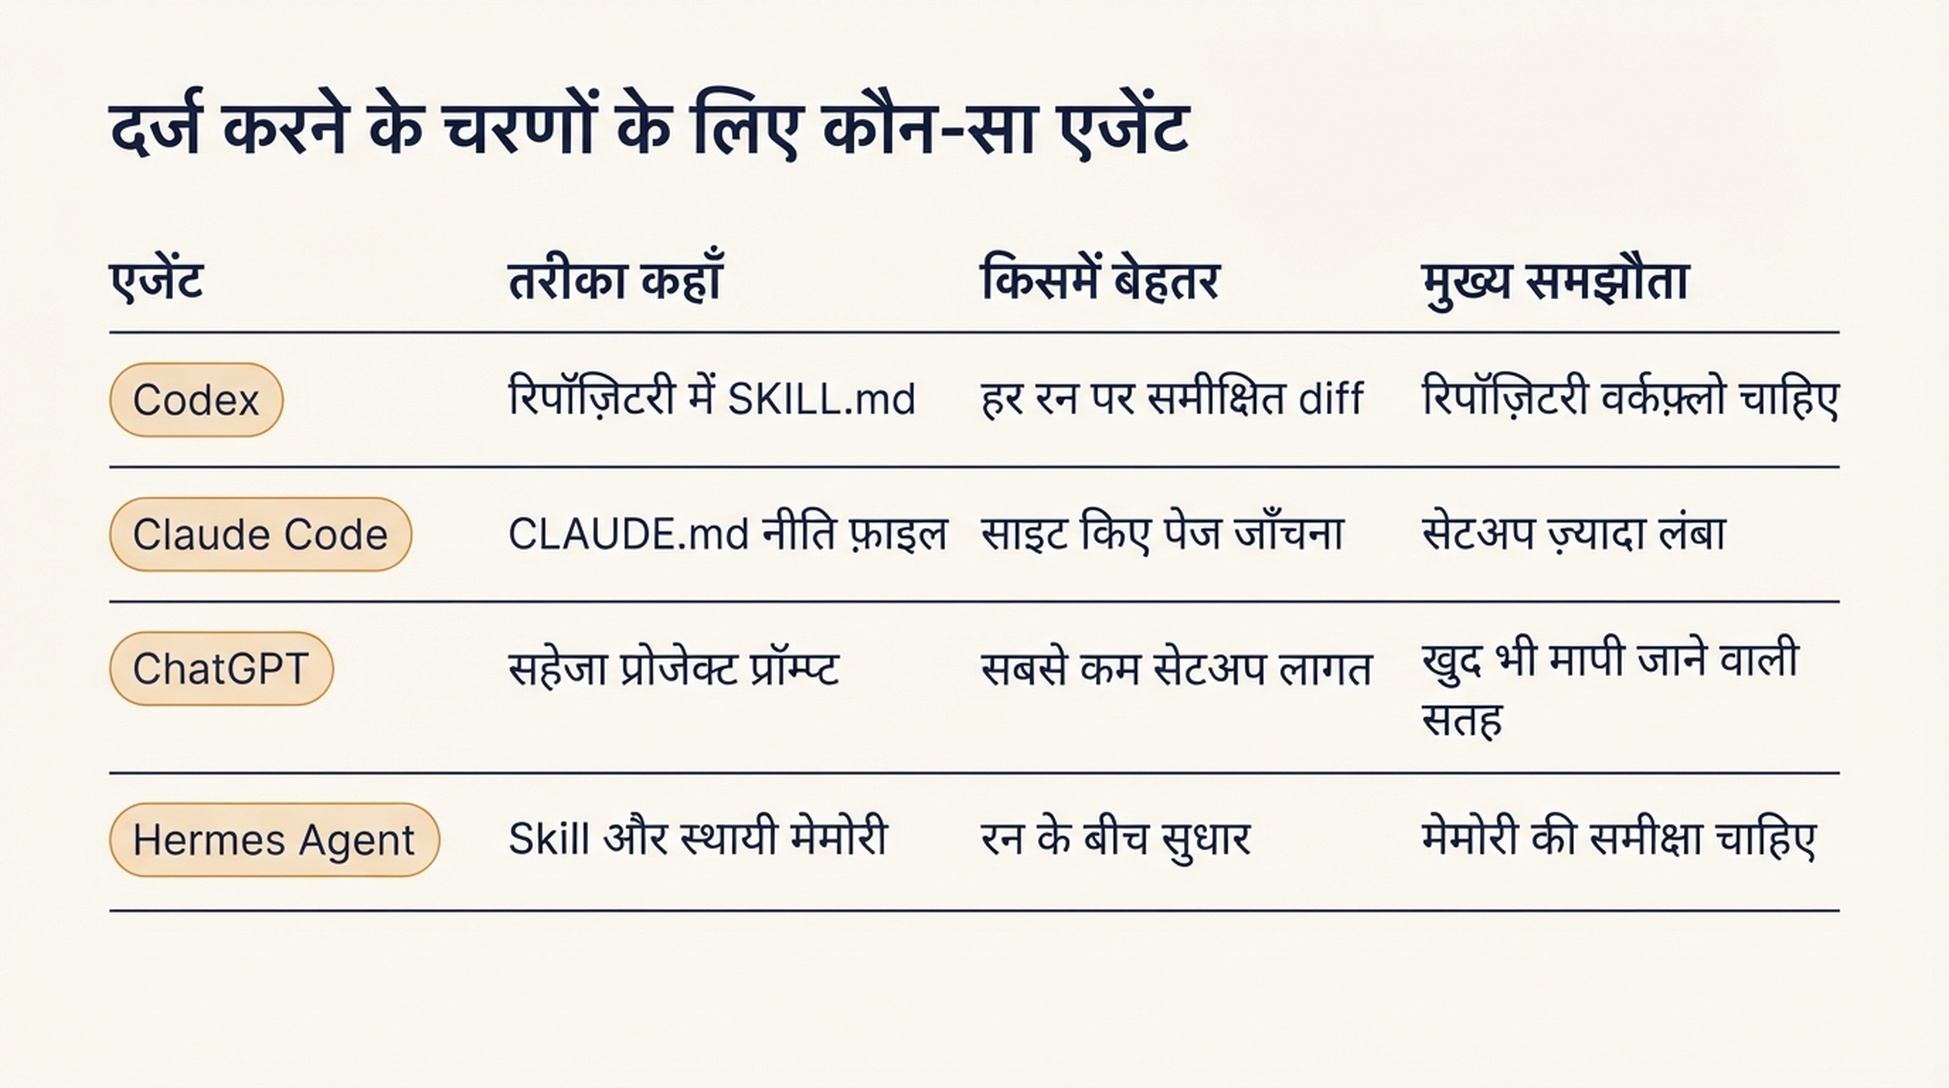
चारों एक ही पाँच चरण चलाते हैं। इस आधार पर चुनें कि तरीका कहाँ रहना चाहिए, इस पर नहीं कि बेंचमार्क में कौन-सा मॉडल सबसे आगे है।
चरण 6: काम करने से पहले मैप जाँचें
बिना जाँचे मैप पर काम बाँटें नहीं। पहले यह जाँच चलाएँ। यहाँ के पाँच मिनट एक तिमाही की गलत दिशा बचा देते हैं।
- एक हफ़्ते बाद तीन सवाल दोबारा चलाएँ। अगर स्रोतों का मेल पूरी तरह बदल जाए, तो आपका सवाल सेट बहुत अस्थिर है या नमूना बहुत छोटा। बदलाव दर्ज करें, पहले दौर को अंतिम सत्य न मानें। कुछ बदलाव सामान्य है; पूरी अदला-बदली चेतावनी है।
- जवाब ही नहीं, इंजन भी पक्का करें। Perplexity में दिखने वाला स्रोत उसी सवाल पर ChatGPT में न हो सकता है। सारांश में इंजन के कॉलम अलग रखें; मिला हुआ कुल ठीक वही संकेत छिपा देता है जो आपको चाहिए।
- अपने साइटेशन भी जाँचें। अगर आपका ब्रांड साइट है, तो पेज खोलें। कभी-कभी इंजन ऐसा पेज साइट करता है जहाँ आपकी आलोचना है, या जो आपके नियंत्रण में नहीं है। यह उपयोगी जानकारी है, जीत नहीं।
- हर पंक्ति पर तारीख पक्की करें। बिना तारीख का साइटेशन मैप बाद में किसी से तुलना नहीं कर सकता।
- स्रोतों की गिनती जाँचें। अगर एक सवाल 40 स्रोत लौटाए और बाकी तीन, तो देखें कि आपने असली साइटेशन के बजाय "संबंधित" पैनल दर्ज न कर लिया हो।
पूरा होने का मतलब: आप किसी सहकर्मी को सारांश तालिका और एक छनी हुई काम की सूची दे सकते हैं, और वह बिना किसी पंक्ति का मतलब पूछे काम कर सकता है।
मैप बनाए रखना
हर तिमाही उसी सवाल सेट पर पूरा दौर चलाएँ, और सबसे ज़्यादा व्यावसायिक मूल्य वाले पाँच सवालों पर महीने-महीने हल्का दौर। पुराने रन रखें। दिलचस्प संकेत अक्सर तस्वीर नहीं होता। वह बहाव होता है: कोई स्रोत प्रकार जो चुपचाप बढ़ रहा है, या कोई प्रतिस्पर्धी जो ऐसी बाल्टी में दिखने लगा जहाँ पहले नहीं था।
सवाल सेट साल में दो बार देखें। खरीद सवाल आपके उत्पाद और बाज़ार के साथ बदलते हैं, और पुराना सेट ऐसी श्रेणी का नक्शा बनाता है जिसे आप अब नहीं बेचते।
एक चीज़ का विरोध करें: इसे डैशबोर्ड बनाना। नतीजा ज़िम्मेदार व्यक्तियों और URL वाली काम की सूची है। अगर अंत में किसी के पास कोई काम नहीं है, तो मैप ने अपना काम नहीं किया।
अक्सर पूछे जाने वाले सवाल
क्या इसके लिए कोई पेड AI विज़िबिलिटी टूल चाहिए? नहीं। हाथ से करने वाला तरीका एक श्रेणी के लिए चलता है और आधे दिन में हो जाता है। टूल तब कीमत वसूल करते हैं जब आप कई श्रेणियाँ या बाज़ार ट्रैक करते हैं, या जब आप खुद स्प्रेडशीट बनाए रखे बिना ऐतिहासिक रुझान रेखाएँ चाहते हैं।
कितने सवाल काफ़ी हैं? हर श्रेणी में 10 से 20। दस से कम पर आप पैटर्न और संयोग में फ़र्क़ नहीं कर पाएँगे। पहले दौर में बीस से ज़्यादा पर विश्लेषण पूरा नहीं होगा, और काम की सूची विश्लेषण से ही निकलती है।
क्या वे सवाल भी शामिल करें जिनमें हम पहले से दिखते हैं? हाँ। कौन-से स्रोत आपको थामे हुए हैं, यह जानना उतना ही उपयोगी है जितना यह जानना कि कौन-से आपको छोड़ देते हैं, और यह बताता है कि कंटेंट बदलते समय क्या बचाना है।
अगर इंजन हर बार अलग जवाब दे? यह सामान्य है और दर्ज करने लायक है। वही सवाल तीन बार चलाएँ और बदलाव नोट करें। अगर स्रोतों का सेट हर बार पूरी तरह अलग हो, तो उस सवाल को कम भरोसे वाला मानें और प्राथमिकता देते समय उसका वज़न कम रखें।
क्या पेज खोले बिना इंजन की स्रोत सूची सीधे इस्तेमाल कर सकते हैं? पहले दौर के दर्ज करने के लिए हाँ। जिन पंक्तियों पर आप काम करेंगे, उनके लिए नहीं। यह तय करने के लिए कि आपका ब्रांड वहाँ वाकई बनता है और उपयोगी योगदान क्या होगा, पेज पढ़ना ज़रूरी है।
यह रैंक ट्रैकिंग से कैसे अलग है? रैंक ट्रैकिंग बताती है कि नतीजों की सूची में आपके पेज कहाँ दिखते हैं। साइटेशन मैप बताता है कि कोई जवाब किन पेजों से जोड़ा गया। कोई पेज पहले नंबर पर हो सकता है और कभी साइट न हो। कोई पेज कहीं रैंक न करे और जवाब की रीढ़ बन जाए। यही अंतर आधा दिन लगाने लायक बनाता है।
लेखक: Ethan Marlowe, Auspia में GEO मापन लीड, 500 से ज़्यादा प्रॉम्प्ट का विश्लेषण किया है। ये प्रॉम्प्ट ट्रैकिंग, साइटेशन रिपोर्टिंग, विज़िबिलिटी डैशबोर्ड, और असली AI विज़िबिलिटी बदलाव को रन-दर-रन शोर से अलग पहचानने के बारे में लिखते हैं।