สิ่งที่คุณจะได้เมื่อทำเสร็จ
แผนที่การอ้างอิง (citation map) คือบันทึกว่าหน้าส่วนไหนที่เครื่องมือ AI ดึงมาใช้จริงตอนตอบคำถามของกลุ่มผู้ซื้อของคุณ ไม่ใช่เรื่องว่าชื่อแบรนด์ของคุณโผล่ในคำตอบหรือไม่ แต่เป็นเรื่องว่าคำตอบนั้นประกอบขึ้นจากแหล่งข้อมูลใด
ผมรันวิธีนี้มาแล้วหลายหมวดหมู่พอที่จะรู้ว่าผลลัพธ์ครั้งแรกมักทำให้หน้าแบน ทีมต่างๆ มักคิดว่าเว็บไซต์ของตัวเองเป็นคนแบกคำตอบเหล่านั้น แต่บ่อยครั้งไม่ใช่เลย ในหมวด B2B หมวดหนึ่ง หน้าที่เป็นของผู้ขายเองคิดเป็นสัดส่วนน้อยจนแทบเป็นเศษเสี้ยว ขณะที่เว็บไดเรกทอรีรีวิวที่ไม่มีใครเข้าไปจองกลับทำงานเกือบทั้งหมด
นั่นแหละคือเหตุผลที่ต้องทำสิ่งนี้ คุณจะเลิกเดาแล้วเริ่มดูหน้าที่เป็นจริง
เมื่อจบคู่มือนี้ คุณจะมี:
- คำถามการซื้อจริง 10 ถึง 20 ข้อสำหรับสินค้าหรือบริการหนึ่งหมวด เขียนแบบที่ลูกค้าจะถามจริง
- คำถามแต่ละข้อถูกรันผ่านเครื่องมือ AI ที่ผู้ซื้อของคุณใช้จริง พร้อมบันทึกแหล่งที่ถูกอ้างอิงและวันที่
- แหล่งข้อมูลเหล่านั้นถูกจัดเรียงตามประเภท เพื่อให้เห็นว่าคำตอบในหมวดของคุณมาจากไหน
- รายการสั้นๆ ของหน้าที่คู่แข่งถูกอ้างอิงแต่คุณไม่ถูกอ้างอิง พร้อมก้าวถัดไปที่ถูกต้องสำหรับแต่ละรายการ
- ผู้รับผิดชอบและวันทบทวน เพื่อให้แผนที่ไม่เน่าในไดรฟ์ที่แชร์กัน
เหมาะกับใคร: หัวหน้าฝ่าย SEO, GEO หรือคอนเทนต์ในองค์กร หรือนักกลยุทธ์ในเอเจนซีที่แนะนำงานได้แม้คนอื่นจะเป็นคนลงมือทำ ไม่จำเป็นต้องใช้เครื่องมือแบบเสียเงิน แม้ว่าจะช่วยได้เมื่อทำในสเกลใหญ่
สิ่งที่ต้องมีก่อนเริ่ม: เบราว์เซอร์ หนึ่งสเปรดชีต และสิทธิ์อ่านเว็บไซต์ของคุณเอง สำหรับเวอร์ชันที่ใช้เอเจนต์ ต้องมีเอเจนต์ที่คุณเลือกติดตั้งใช้งานได้จริง บวกกับโฟลเดอร์ที่คุณชี้ให้มันทำงานได้
เวลา: ประมาณสองชั่วโมงสำหรับรอบแรกในหนึ่งหมวด ประมาณ 45 นาทีในนั้นคือการรันพรอมป์ต์และคัดลอกแหล่งข้อมูล 45 นาทีนั้นคือส่วนที่คุ้มค่าจะมอบให้เอเจนต์ ส่วนที่เหลือคือส่วนที่ต้องใช้วิจารณญาณของคุณ
คำว่าเสร็จหมายถึง: คุณสามารถระบุชื่อแหล่งข้อมูลสามหรือสี่ประเภทที่แบกคำตอบในหมวดของคุณ ชี้ไปที่หน้าเฉพาะที่คุณหายไปแต่คู่แข่งอยู่ตรงนั้น และมอบหมายงานให้ใครสักคนพร้อมแนบ URL ได้ ถ้าคุณมีแค่รายชื่อโดเมนกับความรู้สึกคลุมเครือว่า Reddit สำคัญ แสดงว่าคุณยังไม่เสร็จ
มุมมองของ Auspia: ทีมส่วนใหญ่ข้ามไปที่ "เราต้องมีคนพูดถึงแบรนด์มากขึ้น" ทันที เพราะไม่เคยดูว่าคำตอบนั้นสร้างมาจากอะไรจริงๆ แผนที่คือสิ่งที่เปลี่ยนสัญชาตญาณคลุมเครือนั้นให้กลายเป็นหน้าที่ลงมือทำได้
ก่อนเริ่ม: สองการตัดสินใจที่กำหนดทุกอย่าง
สองทางเลือกนี้กำหนดว่าส่วนที่เหลือจะออกมาเป็นอะไร ทั้งคู่ทำผิดได้ง่าย และทั้งคู่แก้ทีหลังได้น่ารำคาญ
เลือกหนึ่งหมวด ไม่ใช่ทั้งธุรกิจ บริษัทที่ขายซอฟต์แวร์และมีสายงานบริการด้วยมีระบบนิเวศของแหล่งข้อมูลสองแบบที่ต่างกัน ถ้าทำพร้อมกันคุณจะได้ค่าเฉลี่ยที่ไม่ได้อธิบายทั้งสองแบบ เลือกหมวดที่มีรายได้เสี่ยงมากที่สุด แล้วเก็บที่เหลือไว้ไตรมาสหน้า
เลือกเครื่องมือ AI อย่างตั้งใจ Google AI Overviews, ChatGPT, Perplexity และ Gemini ไม่ได้ดึงจากแหล่งเดียวกัน และแหล่งที่จางไปในเครื่องหนึ่งอาจยังมีน้ำหนักในอีกเครื่องหนึ่ง รันอย่างน้อยสองเครื่อง ถ้าไม่รู้ว่าจะเลือกสองตัวไหน ถามทีมขายว่าลูกค้าพูดถึงพื้นผิวไหน หรือดูทราฟฟิกอ้างอิงของคุณที่มีโดเมน AI
มีเส้นแบ่งหนึ่งข้อที่ต้องตั้งไว้ตั้งแต่ตอนนี้ นี่คือแบบฝึกหัดการสังเกต ไม่ใช่การพิสูจน์ คุณกำลังบันทึกว่าเครื่องมือคืนอะไรในวันหนึ่งๆ คำตอบเปลี่ยนไปมาระหว่างการรัน ดังนั้นการสังเกตครั้งเดียวคือจุดข้อมูลหนึ่งจุด ไม่ใช่แนวโน้ม ใส่วันที่ทุกอย่าง ไม่งั้นทั้งไฟล์จะใช้ไม่ได้ภายในหนึ่งเดือน
ขั้นที่ 1: สร้างชุดคำถาม
เขียนคำถาม 10 ถึง 20 ข้อที่ลูกค้าจะถามตอนเลือกซื้อ ไม่ใช่คีย์เวิร์ด แต่เป็นคำถามในคำพูดของลูกค้าเอง
นี่คือขั้นที่คนมักรีบข้าม และเป็นขั้นที่ตัดสินว่าส่วนที่เหลือคุ้มค่าจะทำหรือไม่ ชุดคำถามที่สร้างจากไฟล์ส่งออกคีย์เวิร์ดจะได้แผนที่ว่าคนค้นหาอย่างไร ชุดคำถามที่สร้างจากสายการขายจะได้แผนที่ว่าคนซื้ออย่างไร สองอย่างนี้ไม่ใช่รายการเดียวกัน
แหล่งที่ดีสำหรับรายการนี้:
- คำถามก่อนซื้อที่ทีมขายของคุณเจอบ่อยที่สุด
- ตั๋วซัพพอร์ตจาก 30 วันแรกหลังซื้อ
- บล็อก "ผู้คนยังถาม" (people also ask) บนคำค้นเชิงพาณิชย์หลักของคุณ
- งานวิจัยคีย์เวิร์ดของคุณเอง เขียนใหม่ให้อยู่ในรูปคำถาม
- การค้นหาเปรียบเทียบคู่แข่งที่ผู้ซื้อของคุณรัน
ใส่รูปแบบคำถามให้ผสมกัน เพราะแต่ละแบบดึงแหล่งข้อมูลต่างกัน:
รูปแบบคำถาม | ตัวอย่าง | มักเผยให้เห็นอะไร |
|---|---|---|
ความเหมาะสมกับหมวด | "บริษัทโลจิสติกส์ขนาดกลางควรดูอะไรบ้างในเครื่องมือจัดเส้นทาง" | บทความรวบรวม ไซต์รีวิว |
เทียบตรงตัว | "เครื่องมือ A กับเครื่องมือ B สำหรับทีม 20 คน" | หน้าเปรียบเทียบ กระทู้คอมมูนิตี้ |
ความเสี่ยงและข้อโต้แย้ง | "เครื่องมือ A ปลอดภัยพอสำหรับข้อมูลสุขภาพจริงหรือ" | ฟอรัม บทความด้านคอมพลายแอนซ์ เอกสารผู้ขาย |
ราคาและความคุ้มค่า | "เครื่องมือ A คิดราคาต่อที่นั่งจริงเท่าไหร่" | หน้าราคา กระทู้คอมมูนิตี้ ไซต์รีวิว |
การนำไปใช้ | "ใช้เวลานานแค่ไหนกว่าจะย้ายออกจากเครื่องมือ B ได้" | เอกสาร วิดีโอสอนบน YouTube ฟอรัม |
ผลลัพธ์ที่คาดหวัง: สเปรดชีตที่มีหนึ่งแถวต่อหนึ่งคำถาม มีคอลัมน์สำหรับรูปแบบคำถาม และคอลัมน์สำหรับเครื่องมือ AI ที่คุณจะรัน
การตรวจคุณภาพ: อ่านรายการกลับแล้วถามว่าผู้ซื้อจริงจะพิมพ์คำถามนี้ไหม ถ้าคำถามนั้นสมเหตุสมผลเฉพาะกับคนที่รู้จักอนุกรมสินค้าของคุณอยู่แล้ว ให้เขียนใหม่ คำถามสิบข้อที่ผู้ซื้อจะถามจริงชนะคำถามห้าสิบข้อที่ฟังเหมือนไฟล์ส่งออกคีย์เวิร์ด
เส้นทางกู้: ถ้าคุณไปไม่ถึงสิบคำถาม นั่นคือปัญหางานวิจัย ไม่ใช่ปัญหาแผนที่ ดึงบันทึกสายการขาย 20 ครั้งหลังสุดหรือตั๋วซัพพอร์ต 50 ใบหลังสุด แล้วสกัดคำถามออกมาก่อนจะทำต่อ
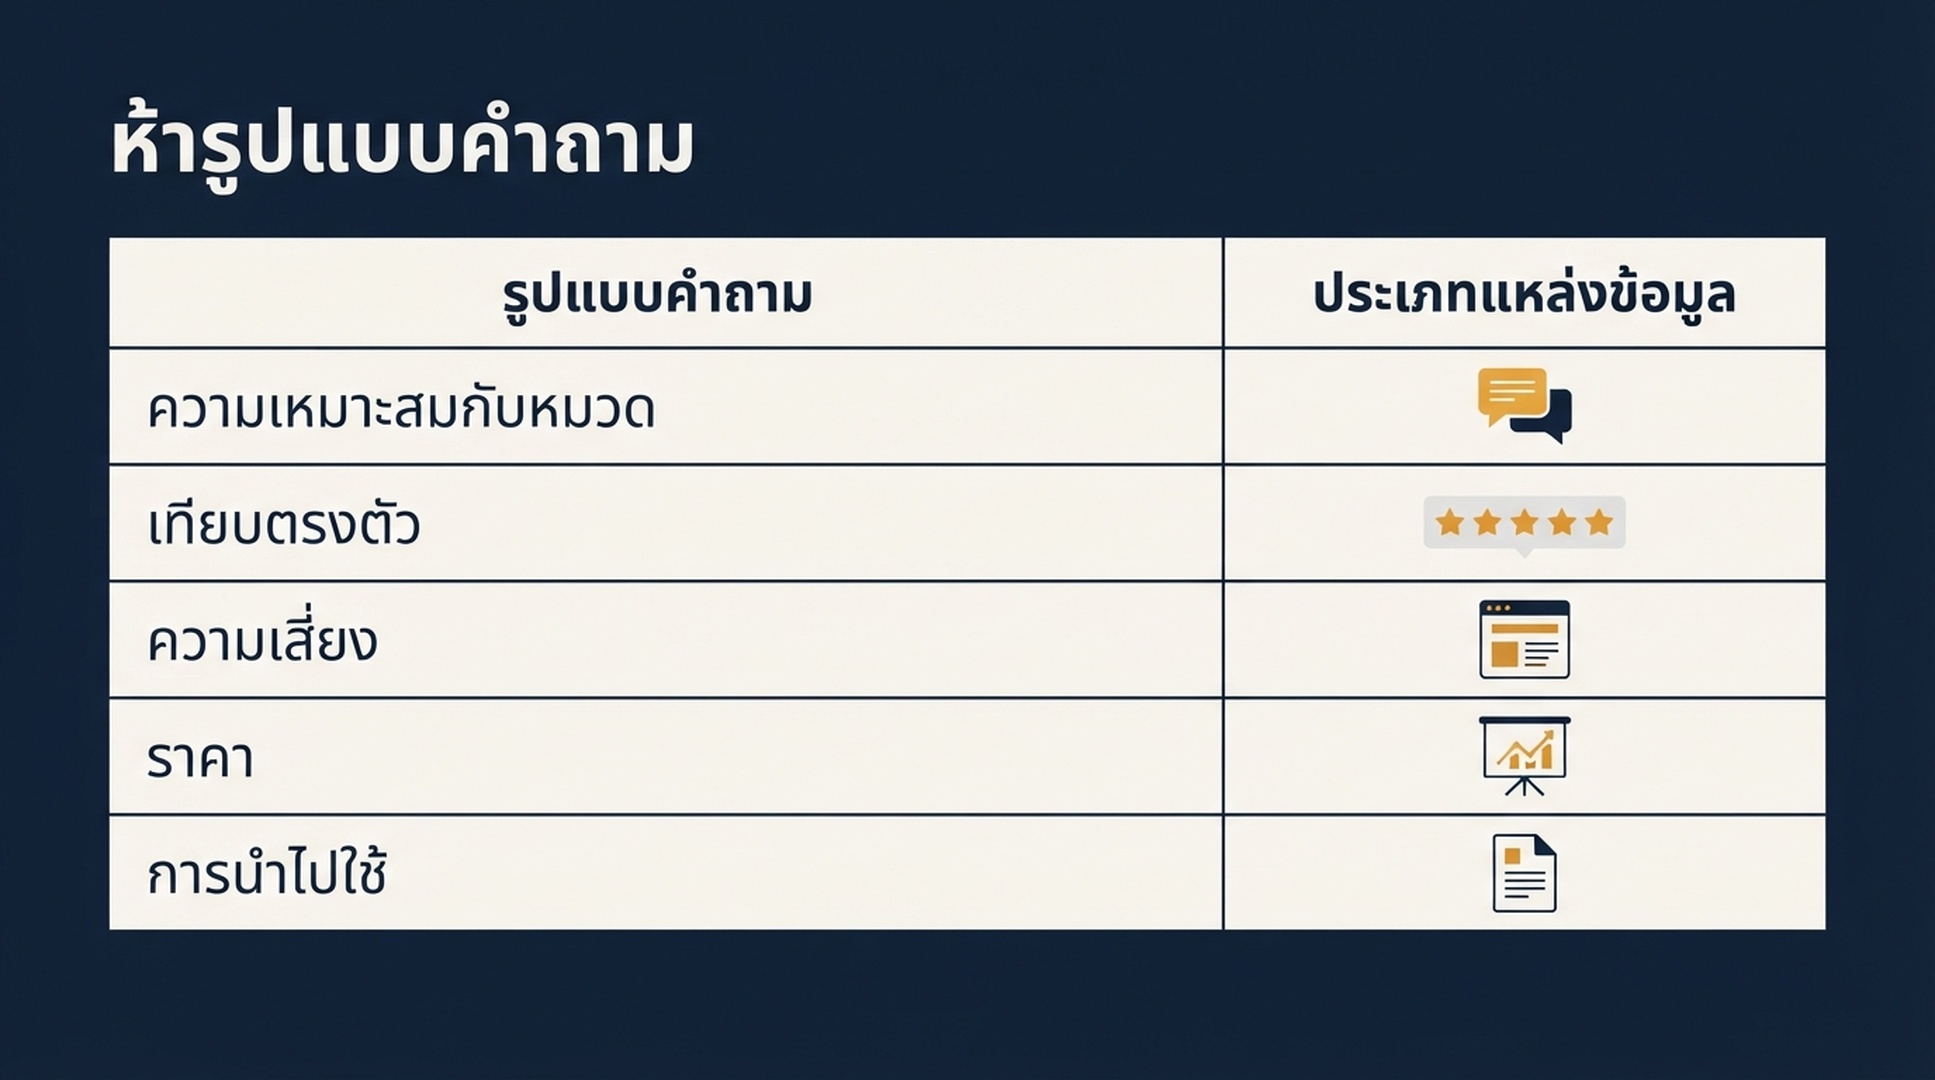
รูปแบบคำถามคือตัวแปรที่ซ่อนอยู่ คำถามเทียบตรงตัวกับคำถามเรื่องความเสี่ยงของสินค้าเดียวกันจะไม่คืนแหล่งข้อมูลชุดเดียวกัน
ขั้นที่ 2: รันคำถามและบันทึกแหล่งข้อมูล
นี่คือแกนกลไก และเป็นจุดที่การทำมือพังทลาย ลองทำห้าข้อด้วยมือเพื่อให้เข้าใจว่าผลลัพธ์ควรหน้าตาเป็นอย่างไร จากนั้นจึงทำให้ส่วนที่เหลือเป็นอัตโนมัติ
สำหรับคำถามแต่ละข้อ ในแต่ละเครื่องมือ:
- เริ่มบทสนทนาใหม่ บริบทก่อนหน้าจะเปลี่ยนสิ่งที่เครื่องมือดึงมา
- ถามคำถามตามที่เขียนไว้เป๊ะๆ
- เปิดแผงการอ้างอิงหรือรายการแหล่งข้อมูล ในเครื่องมือส่วนใหญ่จะเป็นไอคอนเล็กๆ ใกล้คำตอบ ไม่ใช่รายการที่มองเห็นได้
- บันทึกทุก URL ที่ถูกอ้างอิง บวกกับโดเมนและประเภทของแหล่งข้อมูล
- จดวันที่ เครื่องมือ และว่าคำตอบนั้นอ้างอิงอะไรไหมเลย
บันทึกในรูปแบบนี้:
ฟิลด์ | ทำไมจึงสำคัญ |
|---|---|
รหัสคำถาม | เชื่อมทุกการสังเกตกลับไปที่คำถามการซื้อ |
เครื่องมือ | ทำให้แยกรูปแบบระดับเครื่องมือได้ทีหลัง |
วันที่และเวลา | คำตอบเปลี่ยนไป แถวที่ไม่มีวันที่ใช้ไม่ได้ในหนึ่งเดือน |
URL ที่ถูกอ้างอิง | หน้าที่เป็นจริง ไม่ใช่แค่โดเมน |
โดเมน | สำหรับจัดกลุ่มและนับความถี่ |
ประเภทแหล่งข้อมูล | เป็นเจ้าของเอง, ค้าปลีก/มาร์เก็ตเพลส, คอมมูนิตี้, ไดเรกทอรีรีวิว, บทบรรณาธิการ |
คู่แข่งปรากฏ | ใช่/ไม่ และคู่แข่งรายไหน |
แบรนด์ของเราปรากฏ | ในคำตอบ, ในแหล่งข้อมูล, ทั้งคู่, หรือไม่ปรากฏเลย |
แถวสุดท้ายนี้คุ้มค่าที่จะคิดให้ลึก แบรนด์หนึ่งอาจถูกเอ่ยชื่อในคำตอบโดยที่ไม่มีหน้าไหนของมันถูกอ้างอิงเลย มันอาจถูกอ้างอิงโดยไม่ถูกเอ่ยชื่อเด่นชัดก็ได้ สองอย่างนี้เป็นสัญญาณที่ต่างกัน และถ้าคุณติดตามแค่ "เราโผล่ไหม" คุณจะตีความทั้งสองผิด ผมเคยเห็นทีมฉลองการถูกเอ่ยชื่อที่มาจากหน้าที่โต้แย้งพวกเขา
ผลลัพธ์ที่คาดหวัง: ตารางยาว หนึ่งแถวต่อหนึ่งแหล่งที่ถูกอ้างอิง ต่อหนึ่งคำถาม ต่อหนึ่งเครื่องมือ
การตรวจคุณภาพ: อย่างน้อยสามแถว ให้คลิกเข้าไปยืนยันว่าหน้าที่ถูกอ้างอิงนั้นสนับสนุนข้อกล่าวอ้างที่มันถูกอ้างอิงมาจริง เครื่องมือบางครั้งอ้างอิงหน้าที่พูดถึงหัวข้อแต่ไม่ได้ตอบคำถาม แถวพวกนั้นคือสัญญาณรบกวนและควรถูกทำเครื่องหมาย
เส้นทางกู้: ถ้าเครื่องมือไม่คืนการอ้างอิงเลยสำหรับคำถามหนึ่ง นั่นคือข้อค้นพบ ไม่ใช่ความล้มเหลว บันทึกเป็นศูนย์แหล่งข้อมูลแล้วไปต่อ คำถามที่ถูกตอบโดยไม่มีการดึงข้อมูลเลย คือคำถามที่คอนเทนต์ของคุณเองไม่มีทางมีอิทธิพล
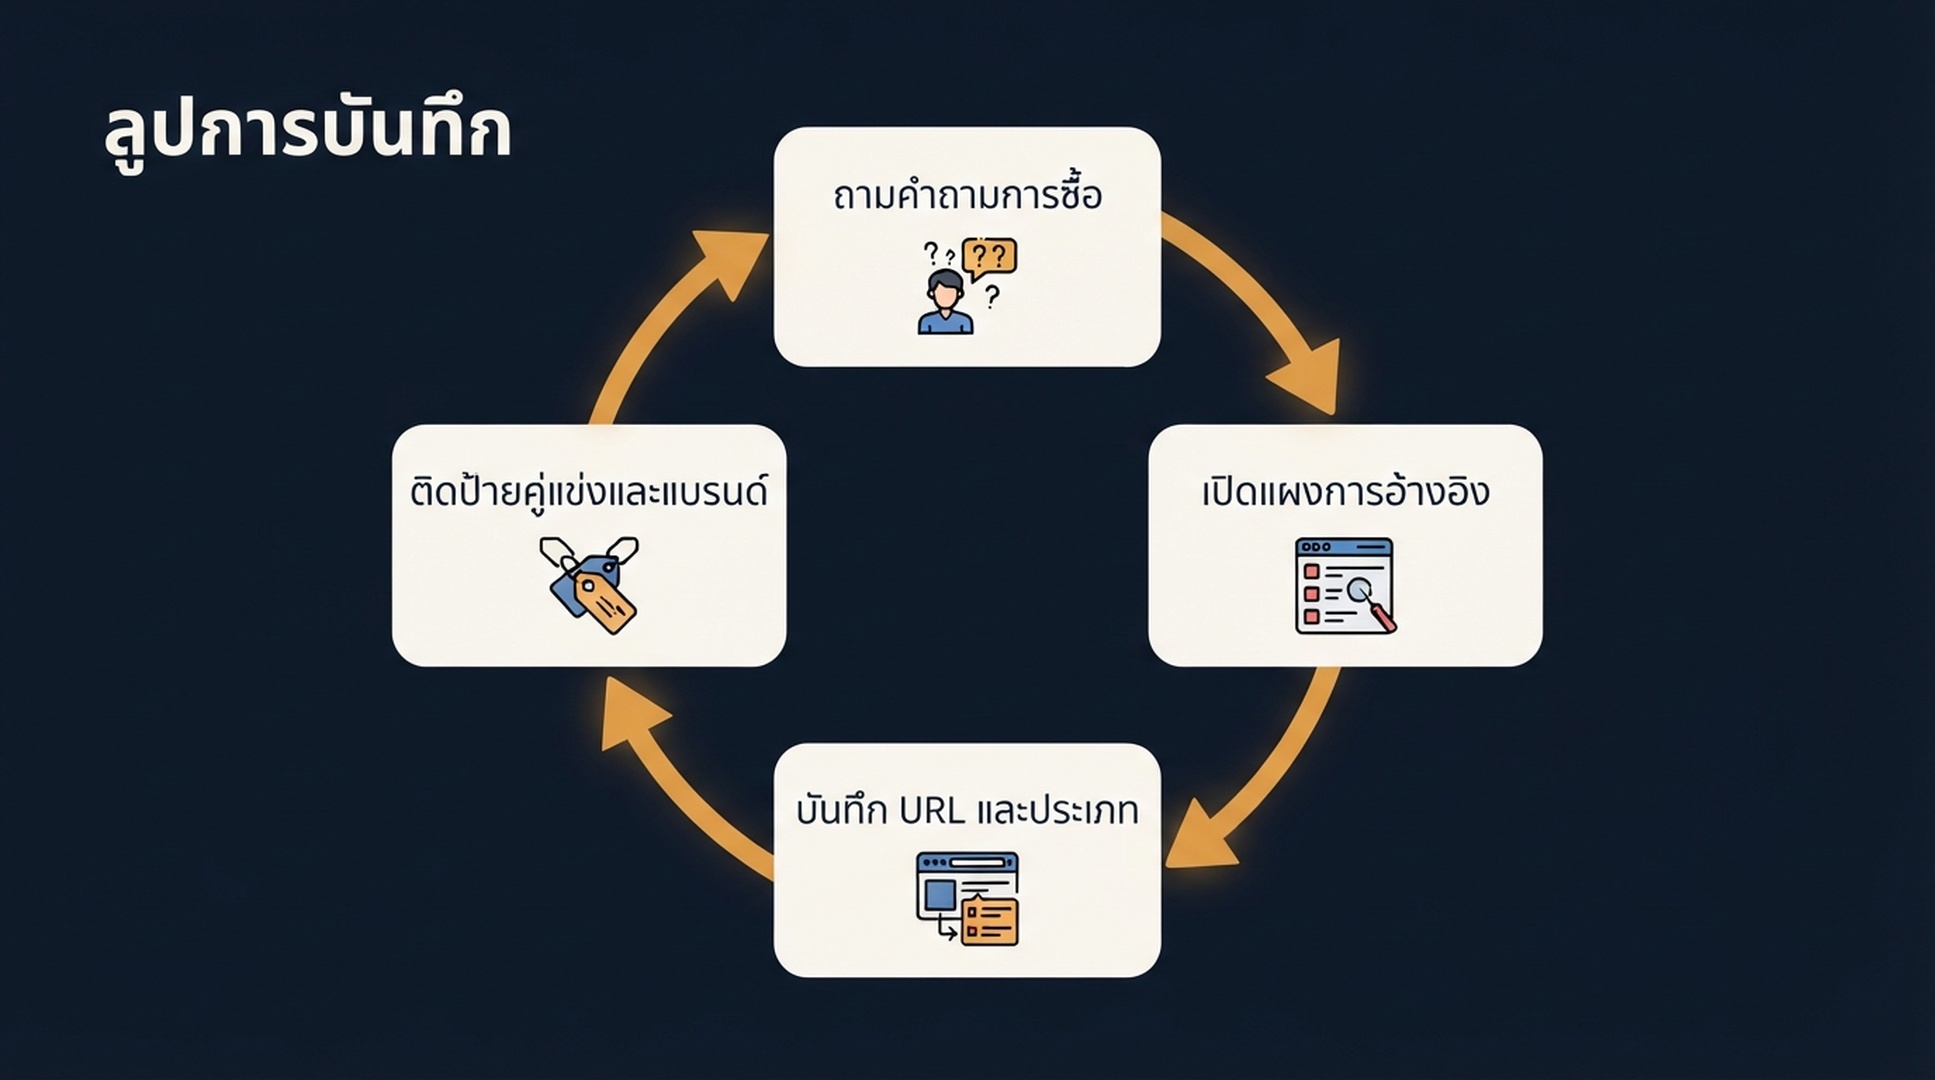
ลูปนี้ง่ายและน่าเบื่อ การผสมกันแบบนี้แหละที่ทำให้มันเป็นตัวเลือกที่ดีสำหรับเอเจนต์
ขั้นที่ 3: จัดเรียงแหล่งข้อมูลตามประเภท
ตอนนี้ย่อตารางยาวให้กลายเป็นภาพของหมวดหมู่คุณ จัดทุก URL ที่ถูกอ้างอิงเข้าในห้าถัง:
- เป็นเจ้าของเอง: ไซต์ของคุณ หรือไซต์ของคู่แข่ง
- ค้าปลีกและมาร์เก็ตเพลส: รายการสินค้า หน้าเปรียบเทียบราคา แอปสโตร์
- คอมมูนิตี้และ UGC: Reddit, YouTube, Quora, ฟอรัม, เธรด Discord ที่ถูกจัดทำดัชนี
- ไดเรกทอรีรีวิวและแพลตฟอร์ม B2B: G2, Capterra, Clutch, Trustpilot, ไดเรกทอรีเฉพาะอุตสาหกรรม
- บทบรรณาธิการและเอกสารอ้างอิงอิสระ: สื่อสายอาชีพ ข่าว Wikipedia บทวิเคราะห์ของนักวิเคราะห์ บล็อกอิสระ
นับต่อถัง ต่อเครื่องมือ และคุณจะได้แผนที่การอ้างอิงของคุณ
สิ่งที่คุณมองหาไม่ใช่ตัวเลขเดียว แต่คือรูปร่าง บางหมวดถูกแบกด้วยกระทู้คอมมูนิตี้และสื่อสายอาชีพเกือบทั้งหมด โดยไซต์ของแบรนด์เองแทบไม่ปรากฏ บางหมวดถูกครอบงำด้วยรายการสินค้า เพราะตัวรายการเองมีคำตอบอยู่ในนั้น ส่วนผสมเป็นไปตามสิ่งที่ผู้ซื้อถาม ไม่ใช่ว่าเว็บไซต์ใครดีแค่ไหน นั่นเป็นเรื่องยากที่จะยอมรับเมื่อคุณใช้เวลาสองปีกับเว็บไซต์นั้น
ผลลัพธ์ที่คาดหวัง: ตารางเล็ก หนึ่งแถวต่อหนึ่งประเภทแหล่งข้อมูล หนึ่งคอลัมน์ต่อหนึ่งเครื่องมือ แสดงสัดส่วนของแหล่งที่ถูกอ้างอิง
การตรวจคุณภาพ: ถ้าถังหนึ่งมีมากกว่าประมาณ 70% ของการอ้างอิงทั้งหมด ให้สุ่มตรวจห้า URL ในถังนั้นเพื่อยืนยันว่าเป็นประเภทนั้นจริง ตัวรวบรวมที่มีทราฟฟิกสูงตัวเดียวอาจปลอมตัวเป็นแหล่งบรรณาธิการได้ทั้งที่จริงๆ เป็นไดเรกทอรี
เส้นทางกู้: ถ้าตัวเลขดูสุ่ม แสดงว่าคุณคงผสมรูปแบบคำถามในทางที่ซ่อนรูปแบบไว้ แยกตารางตามรูปแบบคำถามแล้วดูใหม่ คำถามเรื่องราคากับคำถามเรื่องความเสี่ยงมักมีโปรไฟล์แหล่งข้อมูลที่ต่างกันโดยสิ้นเชิง
ขั้นที่ 4: หาช่องว่างที่คู่แข่งถูกอ้างอิงแต่คุณไม่ถูก
กรองตารางยาวให้เหลือแถวที่คู่แข่งปรากฏและแบรนด์ของคุณไม่ปรากฏ รายการที่กรองแล้วนั่นคือรายการงานของคุณ มันชนะคำสั่งกว้างๆ อย่าง "เราต้องมีคนพูดถึงมากขึ้น" เพราะทุกแถวมี URL และคำถามของลูกค้าติดอยู่แล้ว คุณมอบให้ใครสักคนวันจันทร์แล้วเขาเริ่มได้เลย
สำหรับแต่ละแถว เปิดหน้าที่ถูกอ้างอิงแล้วตอบสามคำถาม:
- สินค้าของเราอยู่บนหน้านี้อย่างสมเหตุสมผลจริงไหม
- ถ้าใช่ อะไรขาดไป — รายการที่เราไม่เคยจอง การเปรียบเทียบที่เราหายไป กระทู้ที่ไม่มีใครพูดถึงเรา รีวิวที่เราไม่เคยขอ
- การกระทำที่เล็กที่สุดและถูกต้องที่สุดที่จะทำให้เราอยู่ตรงนั้นคืออะไร
คำถามข้อสามคือจุดที่วินัยสำคัญ เพราะการกระทำต่างกันในแต่ละถัง การทำผิดตรงนี้คือทางที่นัก SEO ลงเอยด้วยการยิงอีเมลหานักข่าวเรื่องกระทู้ Reddit
ประเภทแหล่งข้อมูล | การกระทำที่ถูกต้อง | สิ่งที่ไม่ควรทำ |
|---|---|---|
ไดเรกทอรีรีวิว | จองและทำโปรไฟล์ให้ครบ ขอรีวิวจากลูกค้า | ซื้อรีวิวหรือปั่นรีวิวปลอม |
กระทู้คอมมูนิตี้ | ตอบคำถามจริงอย่างซื่อสัตย์ในนามพนักงานที่เปิดเผยตัว เปิดเผยความเกี่ยวข้อง | แฝงตัว หรือทิ้งลิงก์โดยไม่มีส่วนร่วม |
บทบรรณาธิการ | เสนอมุมที่มีประโยชน์จริงๆซึ่งสื่อนั้นยังไม่เคยทำ | ยิงข่าวประชาสัมพันธ์เดียวกันไป 200 โดเมน |
รายการมาร์เก็ตเพลสหรือค้าปลีก | แก้สเปก รูป และคำอธิบายให้ข้อเท็จจริงถูกดึงได้ | ยัดคีย์เวิร์ดในรายการ |
หน้าเป็นเจ้าของเอง | ปรับโครงสร้างให้ข้อเท็จจริงเฉพาะนั้นหาและอ้างได้ง่าย | ใส่บล็อก FAQ ที่ไม่ตอบอะไรเลย |
ผลลัพธ์ที่คาดหวัง: รายการที่กรองและจัดลำดับความสำคัญแล้ว จัดอันดับตามความถี่ที่แหล่งนั้นปรากฏในชุดคำถามของคุณ ไม่ใช่ตามความหรูของชื่อโดเมน กระทู้ฟอรัมที่ถูกอ้างในหกจากยี่สิบคำถามของคุณมีอันดับเหนือกว่าสื่อสายอาชีพที่ถูกอ้างครั้งเดียว และมันก็จัดการได้ง่ายกว่ามากด้วย
การตรวจคุณภาพ: สำหรับแต่ละแถวที่คุณเก็บไว้ ยืนยันว่าคุณระบุคำถามของลูกค้าที่มันแมปได้ ถ้าระบุไม่ได้ ให้ตัดแถวนั้นทิ้ง หน้าที่ถูกอ้างสำหรับคำถามที่ไม่มีใครในไปป์ไลน์ของคุณถาม คือสิ่งรบกวนสมาธิ
เส้นทางกู้: ถ้ารายการที่กรองแล้วยังมหึมา แสดงว่าคุณกรองไม่แรงพอ จำกัดรอบแรกไว้สิบแถว เรียงตามความถี่การอ้างอิง แล้วทำสิบแถวนั้นก่อนจะเปิดรายการเต็มอีกครั้ง
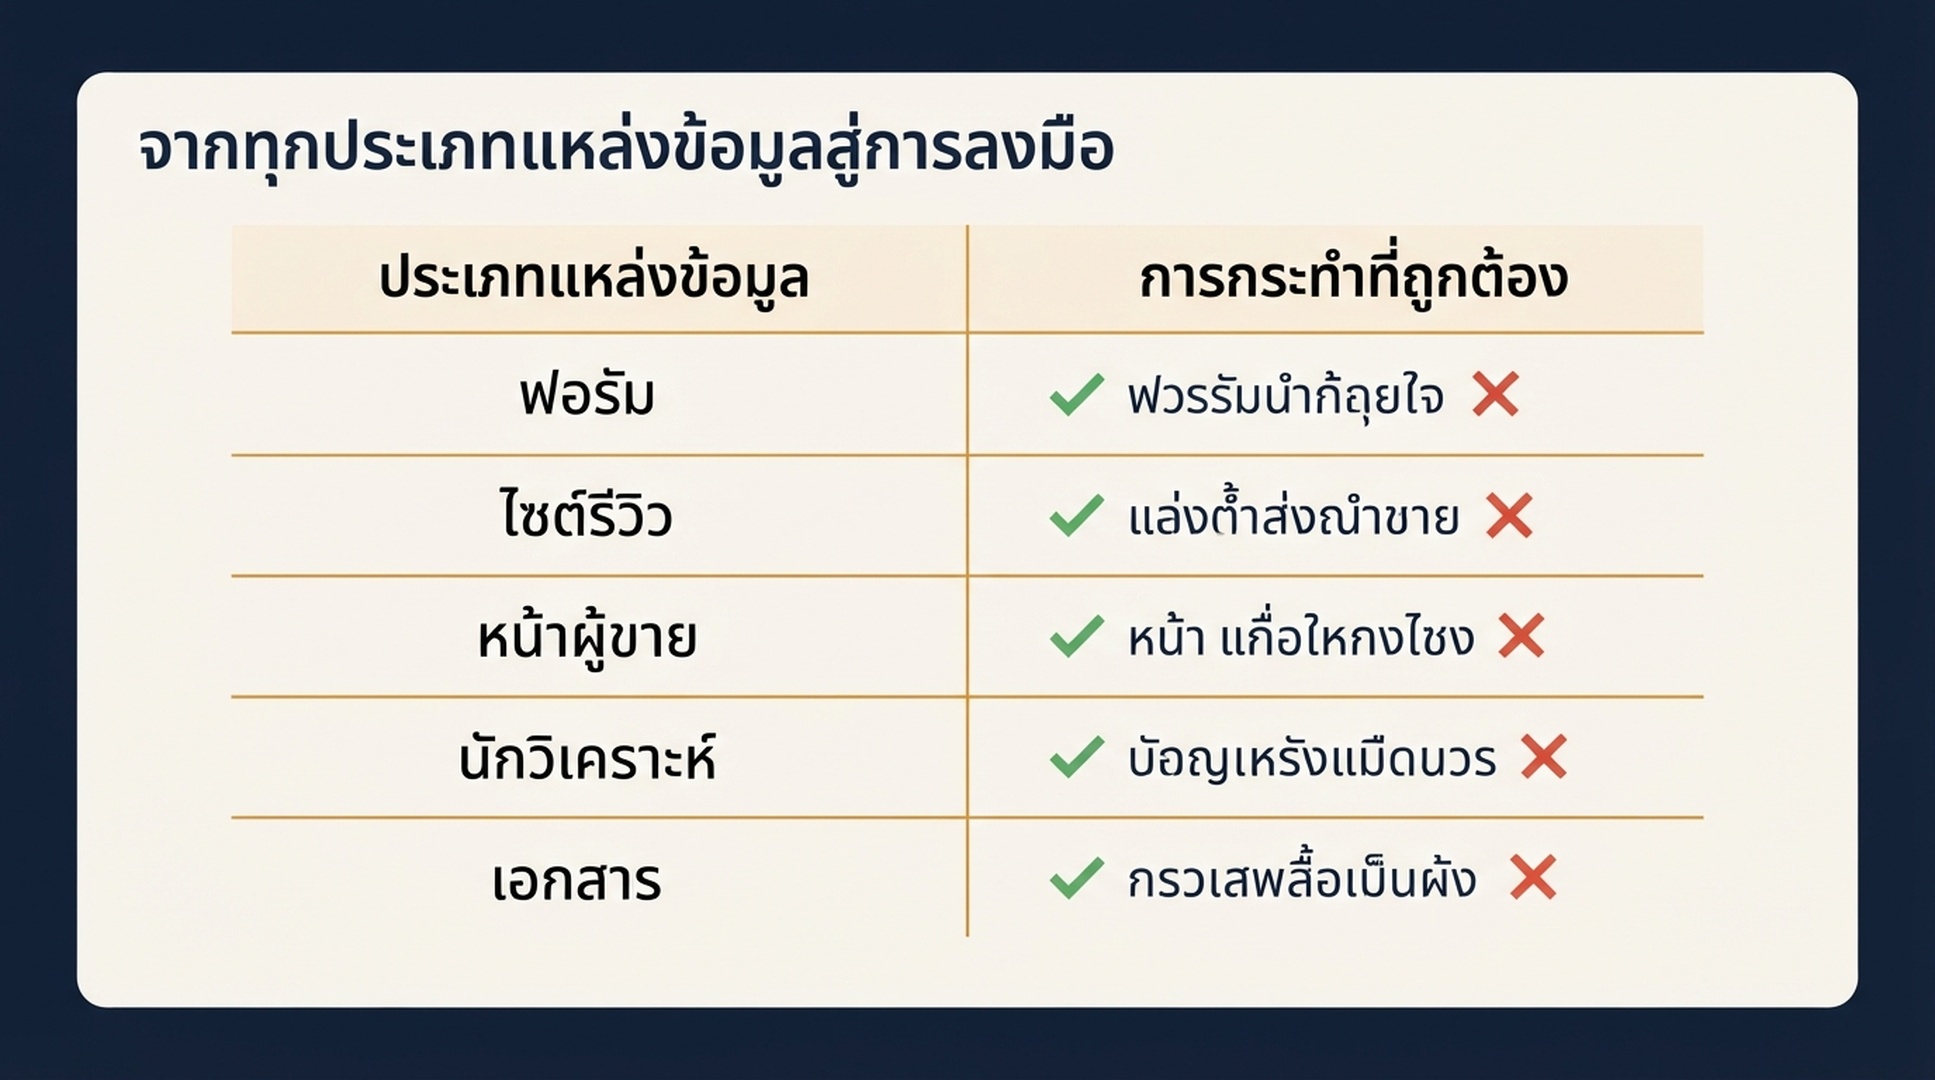
ช่องว่างเดียวกัน ซ่อมต่างกัน การมองการอ้างอิงที่ขาดทุกอันเป็นปัญหาการติดต่อเชิงรุก คือทางที่ทีมลงเอยด้วยการยิงหาบรรณาธิการเรื่องกระทู้ Reddit
ขั้นที่ 5: มอบครึ่งที่เป็นงานกลไกให้เอเจนต์
ขั้นที่ 2 และ 3 เผาเวลามากที่สุดและต้องการวิจารณญาณน้อยที่สุด นั่นคือคำนิยามของงานที่คุ้มค่าจะมอบหมาย ชุดคำถามและการจัดลำดับความสำคัญยังอยู่กับคน เพราะสองจุดนั้นคือที่ที่การตัดสินใจผิดทำให้ทั้งแบบฝึกหัดเสียเปล่า
เอเจนต์ทั้งสี่ตัวด้านล่างรันวิธีเดียวกันได้ สิ่งที่เปลี่ยนคือวิธีอยู่ที่ไหนและผลลัพธ์กลับมาถึงคุณอย่างไร เลือกจากตรงนั้น ไม่ใช่จากว่าโมเดลไหนชนะเบนช์มาร์กเดือนนี้
Codex
ดีที่สุดเมื่อคุณต้องการให้แผนที่อยู่ในรีโพซิทอรีและสร้างอาร์ติแฟกต์ที่ผ่านการรีวิวทุกรอบ ถ้าไซต์ของคุณอยู่ใน git อยู่แล้ว นี่คือทางที่เสียดทานน้อยที่สุด
ตั้งโฟลเดอร์โปรเจกต์ที่มีไดเรกทอรี citation-map/, ไฟล์ questions.csv เก็บชุดคำถามของคุณ และไฟล์ SKILL.md ที่ระบุวิธี: จะเช็กเครื่องมือไหน จะบันทึกฟิลด์อะไร จะจัดประเภทแหล่งข้อมูลอย่างไร และไฟล์ผลลัพธ์ควรหน้าตาเป็นอย่างไร เก็บหนึ่งไฟล์ต่อหนึ่งรอบ ตั้งชื่อตามวันที่ เพื่อสะสมประวัติแทนที่จะเขียนทับ
สั่ง Codex ให้รันคำถาม ต่อท้ายแถวในไฟล์รอบปัจจุบัน และสร้างตารางสรุปสัดส่วนแหล่งข้อมูลต่อเครื่องมือ เพราะผลลัพธ์เป็นไฟล์ในรีโพ คุณจะได้ diff ที่รีวิวได้ก่อนจะถือว่าอะไรเป็นข้อยุติ ขั้นรีวิวคือประเด็น: คุณกำลังตรวจการจัดประเภท ไม่ใช่ทำการบันทึกใหม่
มีกฎข้อหนึ่งที่ต้องอยู่ในไฟล์สกิลไม่ว่าจะยังไง: เอเจนต์บันทึกสิ่งที่มันสังเกตและไม่อนุมานการอ้างอิงที่มันไม่เห็น แหล่งข้อมูลที่กุขึ้นคือโหมดความล้มเหลวที่ทำลายมากที่สุดในเวิร์กโฟลว์นี้ กฎที่เขียนไว้บวกการสุ่มตรวจสามแถวจับได้เกือบทั้งหมด และสามแถวที่คุณตรวจควรเปลี่ยนทุกรอบ
Claude Code
ดีที่สุดเมื่อวิธีต้องถูกอ่านเทียบกับนโยบายที่เป็นลายลักษณ์อักษรชัดเจน และเมื่อคุณต้องการการรีวิวบริบทยาวของหน้าที่บันทึกมา
ใส่วิธีลงใน CLAUDE.md หรือสกิลโปรเจกต์ รวมนิยามประเภทแหล่งข้อมูลของคุณและสคีมาผลลัพธ์ที่แน่นอน ชี้ Claude Code ไปที่โฟลเดอร์รอบรัน แล้วสั่งให้จัดประเภททุก URL ที่ถูกอ้างอิง จากนั้นติดธงทุกแถวที่เนื้อหาหน้าไม่สนับสนุนการอ้างอิงนั้นจริง
งานที่สองคือสิ่งที่คุ้มค่าจ่าย การอ่านหน้าที่ถูกอ้าง 200 หน้าและตัดสินว่าแต่ละหน้าตอบคำถามจริงไหมเป็นเรื่องทรมานสำหรับคน และสมเหตุสมผลสำหรับเอเจนต์ที่มีมาตรฐานเป็นลายลักษณ์อักษร ขอธงความมั่นใจในทุกแถว แล้วรีวิวเฉพาะแถวที่ความมั่นใจต่ำด้วยตัวเอง
ChatGPT
ดีที่สุดเมื่อคุณต้องการต้นทุนการตั้งค่าต่ำสุดและงานเป็นครั้งเดียวจบ ไม่ใช่รอบที่เกิดซ้ำ
วางวิธีเป็นคำสั่งกำหนดเองหรือพรอมป์ต์โปรเจกต์ที่บันทึกไว้ แนบรายการคำถามของคุณ แล้วไล่ทีละเครื่องมือเป็นชุดๆ ขอผลลัพธ์เป็นตารางที่มีคอลัมน์ตรงกับขั้นที่ 2 เป๊ะๆ เพื่อให้วางลงสเปรดชีตได้เลย
ข้อควรระวังคือ ChatGPT ก็เป็นหนึ่งในพื้นผิวที่คุณกำลังวัด ถ้าคุณกำลังทำแผนที่การอ้างอิงของ ChatGPT เอง ให้ทำในเซสชันสะอาดที่ยังไม่โหลดวิธีของคุณ ไม่งั้นคุณจะปนเปื้อนการสังเกต ใช้เซสชันหนึ่งเพื่อบันทึกและอีกเซสชันเพื่อจัดระเบียบ
Hermes Agent
ดีที่สุดเมื่อคุณต้องการให้วิธีคงอยู่เป็นสกิลและพัฒนาขึ้นข้ามรอบโดยที่คุณไม่ต้องอธิบายซ้ำ
ติดตั้งวิธีแผนที่การอ้างอิงเป็นสกิล Hermes พร้อมชุดคำถามและสคีมาผลลัพธ์ แล้วรันเป็นจังหวะ — เดือนละครั้งมักเหมาะสม เพราะสกิลและความจำของมันคงอยู่ การแก้ไขที่คุณทำในเดือนแรกจะส่งต่อไปเดือนที่สอง ถ้าเอเจนต์จัดประเภทไดเรกทอรีผิดเป็นบทบรรณาธิการ แก้กฎครั้งเดียว
ข้อแลกเปลี่ยนคือความจำที่คงอยู่ต้องได้รับการทบทวนเป็นระยะ ทุกระยะไม่กี่รอบ ให้อ่านไฟล์สกิลและเช็กว่าการแก้ไขที่สะสมมายังอธิบายวิธีที่คุณต้องการอยู่ ถ้าปล่อยไว้ มันจะกลายเป็นกองข้อยกเว้นเฉพาะกิจที่ไม่มีใครอธิบายได้
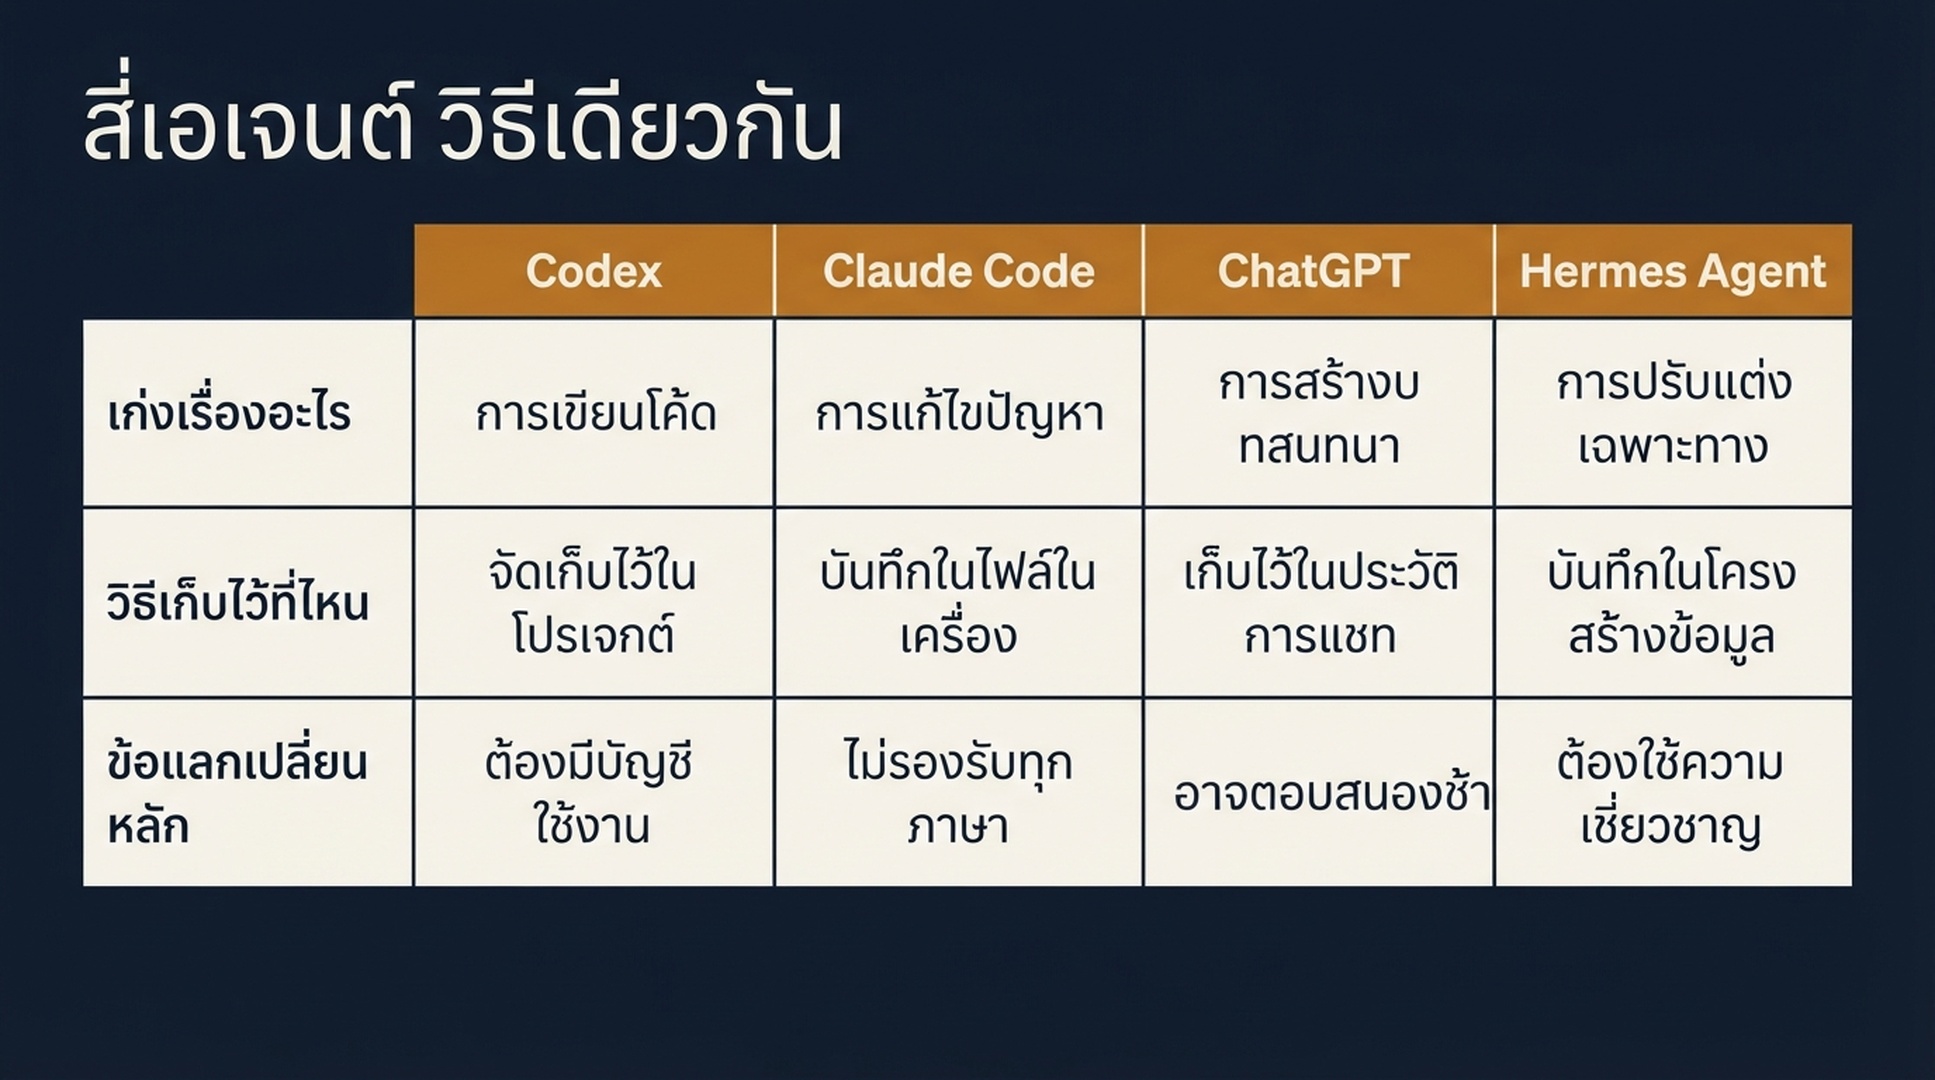
ทั้งสี่ตัวรันห้าขั้นตอนเดียวกัน เลือกจากว่าวิธีของคุณควรอยู่ที่ไหน ไม่ใช่จากว่าโมเดลไหนได้คะแนนเบนช์มาร์กสูงสุด
ขั้นที่ 6: ยืนยันแผนที่ก่อนลงมือทำตาม
อย่ามอบหมายงานจากแผนที่ที่ยังไม่ยืนยัน ห้านาทีตรงนี้ประหยัดเวลาไตรมาสที่ใช้ผิดทาง
- รันคำถามสามข้อซ้ำอีกหนึ่งสัปดาห์ถัดไป ถ้าส่วนผสมแหล่งข้อมูลเปลี่ยนไปทั้งหมด แสดงว่าชุดคำถามของคุณผันผวนเกินไปหรือตัวอย่างเล็กเกินไป บันทึกการเปลี่ยนแปลงไว้แทนที่จะถือรอบแรกเป็นความจริงสูงสุด การเปลี่ยนแปลงบางส่วนเป็นเรื่องปกติ การพลิกทั้งหมดคือสัญญาณเตือน
- ยืนยันเครื่องมือ ไม่ใช่แค่คำตอบ แหล่งที่ปรากฏใน Perplexity อาจหายไปใน ChatGPT สำหรับคำถามเดียวกัน แยกคอลัมน์เครื่องมือไว้ในสรุปของคุณ ยอดรวมที่ผสมกันจะซ่อนสัญญาณที่คุณต้องการพอดี
- ตรวจการอ้างอิงของคุณเองด้วย ถ้าแบรนด์ของคุณถูกอ้างอิง ให้เปิดหน้านั้น บางครั้งเครื่องมืออ้างอิงหน้าที่พูดถึงคุณในเชิงวิพากษ์ หรือหน้าที่คุณไม่ได้ควบคุมเลย นั่นคือข้อมูลที่มีประโยชน์ และไม่ใช่ชัยชนะ
- ยืนยันวันที่ในทุกแถว แผนที่การอ้างอิงที่ไม่มีวันที่เทียบกับอะไรทีหลังไม่ได้
- ตรวจจำนวนแหล่งข้อมูลอย่างมีสติ ถ้าคำถามหนึ่งคืน 40 แหล่งและที่เหลือคืนสามแหล่ง ให้เช็กว่าคุณจับแผง "ที่เกี่ยวข้อง" แทนการอ้างอิงจริงหรือเปล่า
คำว่าเสร็จหมายถึง: คุณมอบตารางสรุปและรายการงานที่กรองแล้วหนึ่งชุดให้เพื่อนร่วมงานได้ และเขาลงมือได้โดยไม่ต้องถามคุณว่าแถวไหนหมายถึงอะไร
การดูแลแผนที่
รันรอบเต็มทุกไตรมาสบนชุดคำถามเดิม และรันรอบเบาเดือนละครั้งบนห้าคำถามที่มีมูลค่าเชิงพาณิชย์สูงสุด เก็บรอบเก่าไว้ สัญญาณที่น่าสนใจไม่ค่อยอยู่ที่ภาพรวมชั่วขณะ แต่อยู่ที่การเลื่อนไถล: ประเภทแหล่งข้อมูลที่ค่อยๆ โตขึ้น หรือคู่แข่งที่เริ่มโผล่ในถังที่เคยหายไป
ทบทวนชุดคำถามปีละสองครั้ง คำถามการซื้อเปลี่ยนไปตามสินค้าและตลาดของคุณ และชุดคำถามที่เก่าคร่ำจะสร้างแผนที่ของหมวดที่คุณเลิกขายไปแล้ว
สิ่งหนึ่งที่ต้องต้านไว้: การเปลี่ยนมันเป็นแดชบอร์ด ผลลัพธ์คือรายการงานที่มีผู้รับผิดชอบและ URL ถ้าไม่มีใครมีงานตอนจบ แผนที่ยังทำหน้าที่ไม่สำเร็จ
คำถามที่พบบ่อย
ต้องใช้เครื่องมือ AI visibility แบบเสียเงินไหม ไม่ต้อง เวอร์ชันทำมือใช้ได้กับหนึ่งหมวดและใช้เวลาครึ่งวัน เครื่องมือจะคุ้มค่าก็ต่อเมื่อคุณติดตามหลายหมวดหรือหลายตลาด หรือเมื่อคุณต้องการเส้นแนวโน้มย้อนหลังโดยไม่ต้องดูแลสเปรดชีตเอง
กี่คำถามถึงจะพอ สิบถึงยี่สิบข้อต่อหมวด น้อยกว่าสิบคุณแยกแยะรูปแบบจากความบังเอิญไม่ได้ มากกว่ายี่สิบในรอบแรกคุณจะวิเคราะห์ไม่จบ ซึ่งเป็นส่วนที่สร้างรายการงาน
ควรรวมคำถามที่เราโผล่อยู่แล้วไหม ควร การรู้ว่าแหล่งไหนแบกคุณอยู่มีประโยชน์พอๆ กับการรู้ว่าแหล่งไหนพลาดคุณ มันยังบอกด้วยว่าต้องปกป้องอะไรตอนคุณเขียนหน้าใหม่
ถ้าเครื่องมือให้คำตอบต่างกันทุกครั้งที่ถามล่ะ นั่นเป็นเรื่องปกติ และคุ้มค่าจะบันทึก รันคำถามเดิมสามครั้งแล้วจดความแปรผัน ถ้าชุดแหล่งข้อมูลต่างกันโดยสิ้นเชิงทุกครั้ง ให้ถือคำถามนั้นว่ามีความมั่นใจต่ำและให้น้ำหนักน้อยลงตอนจัดลำดับความสำคัญ
ใช้รายการแหล่งข้อมูลของเครื่องมือเองโดยไม่เปิดหน้าได้ไหม สำหรับการบันทึกครั้งแรก ได้ สำหรับแถวที่คุณวางแผนจะลงมือทำ ไม่ได้ คุณต้องอ่านหน้าเพื่อตัดสินว่าแบรนด์ของคุณควรอยู่ตรงนั้นไหมและการมีส่วนร่วมที่มีประโยชน์ควรเป็นอย่างไร
ต่างจากการติดตามอันดับ (rank tracking) ยังไง Rank tracking บอกว่าหน้าของคุณโผล่ตรงไหนในรายการผลลัพธ์ แผนที่การอ้างอิงบอกว่าคำตอบถูกประกอบขึ้นจากหน้าอะไร หน้าหนึ่งอาจอยู่อันดับหนึ่งและไม่เคยถูกอ้างอิงเลย หน้าที่ไม่ติดอันดับเลยอาจเป็นกระดูกสันหลังของคำตอบ นี่คือช่องว่างที่ทำให้แบบฝึกหัดนี้คุ้มค่ากับครึ่งวันของคุณ
ผู้เขียน: Ethan Marlowe, GEO Measurement Lead Across 500+ Prompts at Auspia. Ethan เขียนเกี่ยวกับ prompt tracking, citation reporting, visibility dashboards และวิธีแยกความเปลี่ยนแปลงของ AI visibility จริงออกจากสัญญาณรบกวนระหว่างรอบ