Co otrzymasz na końcu
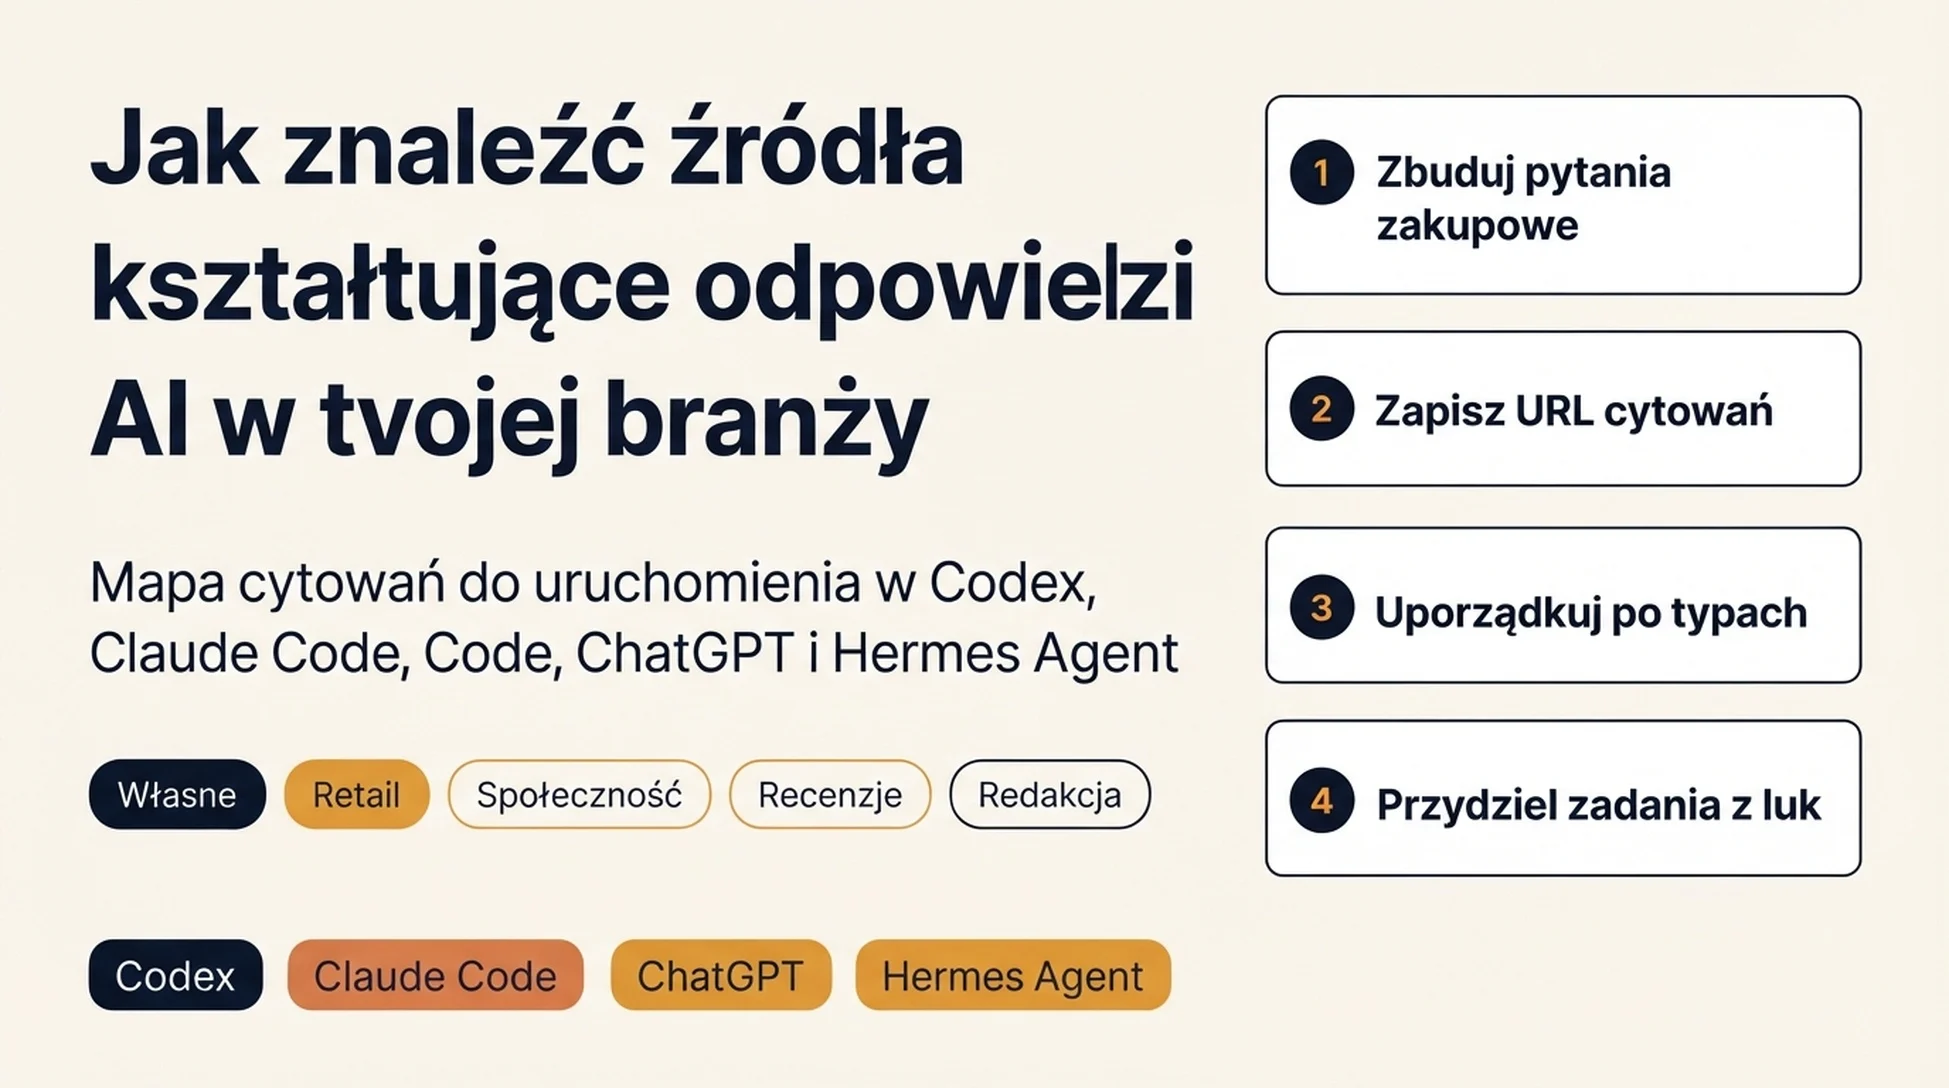
Mapa cytowań to zapis tego, które strony silnik AI faktycznie wyciągnął, odpowiadając na pytania twoich kupujących. Nie tego, czy twoja marka pojawiła się w odpowiedzi. Tylko tego, z jakich źródeł ta odpowiedź została złożona.
Przeprowadzałem to w wystarczającej liczbie kategorii, żeby wiedzieć, że pierwszy wynik zwykle otrzeźwia. Zespoły zakładają, że odpowiedzi trzymają się na ich własnej stronie. Najczęściej tak nie jest. W jednej kategorii B2B strony samego dostawcy dawały znikomy udział, a serwis z recenzjami, którego nikt nie zgłosił, wykonywał większość pracy.
W tym jest sens tego ćwiczenia. Przestajesz zgadywać i zaczynasz patrzeć na prawdziwe strony.
Po przejściu tego przewodnika będziesz mieć:
- Od 10 do 20 prawdziwych pytań zakupowych dla jednej kategorii produktu lub usługi, napisanych tak, jak zadałby je klient
- Każde pytanie uruchomione w tych silnikach AI, z których naprawdę korzystają twoi kupujący, z zarejestrowanymi i opatrzonymi datą źródłami cytowań
- Te źródła uporządkowane według typu, żebyś widział, skąd pochodzą odpowiedzi w twojej kategorii
- Krótką listę stron, na których cytowany jest konkurent, a ciebie nie ma, każda z uzasadnionym następnym krokiem
- Osoby odpowiedzialne i datę przeglądu, żeby mapa nie zgniła we wspólnym folderze
Dla kogo: wewnętrzny specjalista od SEO, GEO lub treści albo strateg agencji, który może rekomendować pracę, nawet gdy wykonuje ją ktoś inny. Płatne narzędzie nie jest konieczne, choć przy skali pomaga.
Wymagania wstępne: przeglądarka, arkusz kalkulacyjny i dostęp do odczytu własnej strony. W wersjach z agentem działająca instalacja wybranego agenta i folder, na który możesz go wskazać.
Czas: około dwóch godzin na pierwsze przejście w jednej kategorii. Około 45 minut z tego to uruchamianie promptów i kopiowanie źródeł. Właśnie te 45 minut warto oddać agentowi, a reszta to część wymagająca twojego osądu.
Co znaczy „gotowe”: potrafisz wymienić trzy lub cztery typy źródeł, na których trzymają się odpowiedzi w twojej kategorii, wskazać konkretne strony, na których ciebie nie ma, a konkurent jest, i przekazać komuś zadanie z załączonym adresem URL. Jeśli masz tylko listę domen i mgliste poczucie, że Reddit jest ważny, to jeszcze nie koniec.
Stanowisko Auspii: większość zespołów idzie prosto do „potrzebujemy więcej wzmianek o marce”, bo nigdy nie spojrzała, z czego odpowiedź jest naprawdę złożona. Mapa zamienia to mgliste przeczucie w stronę, na której można działać.
Zanim zaczniesz: dwie decyzje, które determinują wszystko
Dwa wybory decydują o tym, co da reszta pracy. Oba łatwo podjąć błędnie i oba trudno potem odwrócić.
Wybierz jedną kategorię, nie cały biznes. Firma, która sprzedaje oprogramowanie i prowadzi też dział usług, ma dwa różne ekosystemy źródeł. Mapowanie obu naraz daje średnią, która nie opisuje żadnego z nich. Weź kategorię z największym przychodem i odłóż resztę na następny kwartał.
Wybieraj silniki świadomie. Google AI Overview, ChatGPT, Perplexity i Gemini nie czerpią ze tej samej studni. Źródło, które straciło wagę w jednym silniku, może nadal liczyć się w innym. Uruchom co najmniej dwa. Jeśli nie wiesz które, zapytaj dział sprzedaży, jaki interfejs wspominają klienci, albo sprawdź ruch polecający z domen AI.
Wyznacz granicę od razu. To ćwiczenie obserwacyjne, nie dowodowe. Rejestrujesz to, co silnik zwrócił w danym dniu. Odpowiedzi zmieniają się między uruchomieniami, więc pojedyncza obserwacja to punkt danych, a nie trend. Opatruj datą wszystko, inaczej cały plik stanie się bezużyteczny po miesiącu.
Krok 1: zbudować zestaw pytań
Napisz od 10 do 20 pytań, które klient zadałby przy wyborze. Nie słowa kluczowe. Pytania, słowami samego klienta.
To krok, który ludzie pomijają w pośpiechu, i to on decyduje, czy reszta jest warta zachodu. Zestaw pytań z eksportu słów kluczowych daje mapę tego, jak ludzie szukają. Zestaw z notatek ze rozmów sprzedażowych daje mapę tego, jak ludzie kupują. To nie ta sama lista.
Materiały, z których możesz korzystać:
- Najczęstsze pytania przedzakupowe, które dostaje dział sprzedaży
- Zgłoszenia do wsparcia z pierwszych 30 dni po zakupie
- Blok „inne pytania” przy twoich głównych zapytaniach komercyjnych
- Twoje własne badanie słów kluczowych przepisane na pytania
- Porównawcze wyszukiwania konkurentów, które robią twoi kupujący
Mieszaj formy pytań, bo każda przyciąga inne źródła.
Forma pytania | Przykład | Jakie źródła zwykle wychodzą |
|---|---|---|
Dopasowanie do kategorii | „Na co powinna patrzeć średnia firma logistyczna, wybierając narzędzie do planowania tras?” | Zestawienia redakcyjne, serwisy z recenzjami |
Bezpośrednie porównanie | „Narzędzie A czy narzędzie B dla zespołu 20 osób?” | Strony porównawcze, wątki społeczności |
Ryzyko i obiekcja | „Czy narzędzie A jest naprawdę wystarczająco bezpieczne dla danych medycznych?” | Fora, analizy zgodności, dokumentacja dostawcy |
Cena i wartość | „Ile narzędzie A naprawdę kosztuje za stanowisko?” | Strony z cenami, wątki społeczności, serwisy z recenzjami |
Wdrożenie | „Ile trwa migracja z narzędzia B?” | Dokumentacja, omówienia na YouTube, fora |
Oczekiwany wynik: arkusz z jednym wierszem na pytanie, kolumną na formę pytania i kolumną na silnik, w którym je uruchomisz.
Kontrola jakości: przeczytaj listę i zapytaj, czy prawdziwy kupujący wpisałby każde z nich. Jeśli pytanie ma sens tylko dla kogoś, kto zna już taksonomię twojego produktu, przepisz je. Dziesięć pytań, które kupujący naprawdę zada, bije pięćdziesiąt brzmiących jak eksport słów kluczowych.
Ścieżka odzyskiwania: jeśli nie dobijasz do dziesięciu pytań, to problem badawczy, nie mapowania. Wyciągnij ostatnie 20 notatek ze rozmów sprzedażowych albo ostatnie 50 zgłoszeń do wsparcia i wydobądź z nich pytania, zanim pójdziesz dalej.
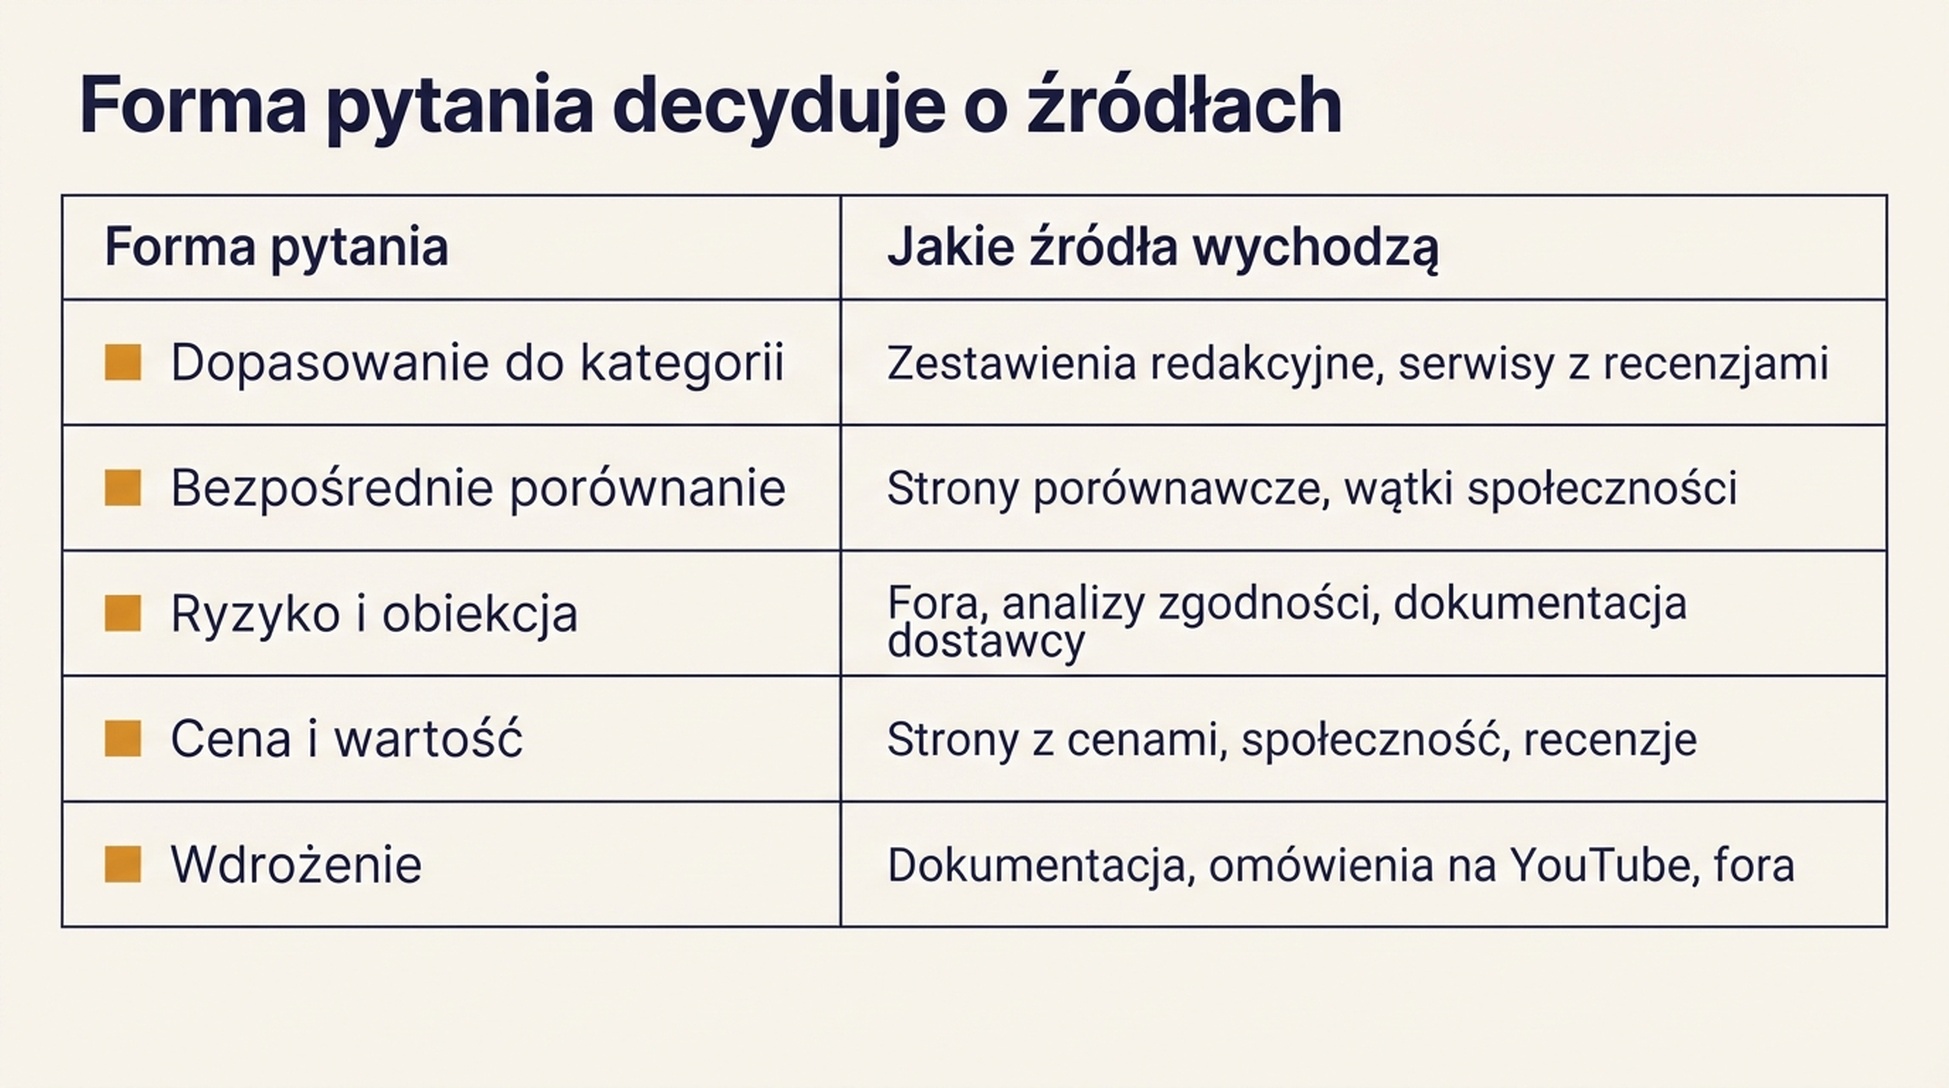
Forma pytania to ukryta zmienna. Pytanie o bezpośrednie porównanie i pytanie o ryzyko dotyczące tego samego produktu nie zwracają tych samych źródeł.
Krok 2: uruchomić pytania i zarejestrować źródła
Tu jest rdzeń mechaniczny i tu praca ręczna się rozpada. Zrób pięć pytań ręcznie, żeby zrozumieć, jak powinien wyglądać wynik. Potem zautomatyzuj resztę.
Dla każdego pytania, w każdym silniku:
- Otwórz nową rozmowę. Poprzedni kontekst zmienia to, co silnik pobierze.
- Zadaj pytanie dokładnie tak, jak je zapisałeś.
- Otwórz panel cytowań albo listę źródeł. W większości silników to mała ikona obok odpowiedzi, a nie widoczna lista.
- Zapisz każdy cytowany adres URL, a także domenę i typ źródła.
- Zanotuj datę, silnik i to, czy odpowiedź w ogóle coś cytowała.
Rejestruj w takiej strukturze:
Pole | Dlaczego ważne |
|---|---|
ID pytania | Wiąże każdą obserwację z pytaniem zakupowym |
Silnik | Pozwala później rozdzielić wzorce według silników |
Data i godzina | Odpowiedzi dryfują; wiersz bez daty jest bezużyteczny po miesiącu |
Cytowany URL | Prawdziwa strona, nie tylko domena |
Domena | Do grupowania i zliczania częstotliwości |
Typ źródła | własne, retail/marketplace, społeczność, katalog recenzji, redakcyjne |
Konkurent obecny | Tak/nie i który |
Nasza marka obecna | W odpowiedzi, w źródłach, w obu albo nigdzie |
Ostatni wiersz wart jest chwili. Marka może być wymieniona w odpowiedzi, choć żadna jej strona nie została zacytowana. Może też być cytowana bez wyraźnego wymienienia. To dwa różne sygnały, a jeśli śledzisz tylko „czy się pojawiliśmy”, oba odczytasz błędnie. Widziałem zespoły świętujące wzmiankę ze strony, która argumentowała przeciwko nim.
Oczekiwany wynik: długa tabela, po jednym wierszu na każde cytowane źródło, pytanie i silnik.
Kontrola jakości: w co najmniej trzech wierszach kliknij i potwierdź, że cytowana strona naprawdę podtrzymuje twierdzenie, dla którego ją zacytowano. Silniki czasem cytują stronę, która wspomina temat, ale nie odpowiada na pytanie. Takie wiersze to szum i trzeba je oznaczyć.
Ścieżka odzyskiwania: jeśli silnik nie zwrócił cytowań dla pytania, to odkrycie, a nie porażka. Zapisz zero źródeł i idź dalej. Pytania, na które odpowiada się bez pobierania, to pytania, na które twoja treść nie ma wpływu.
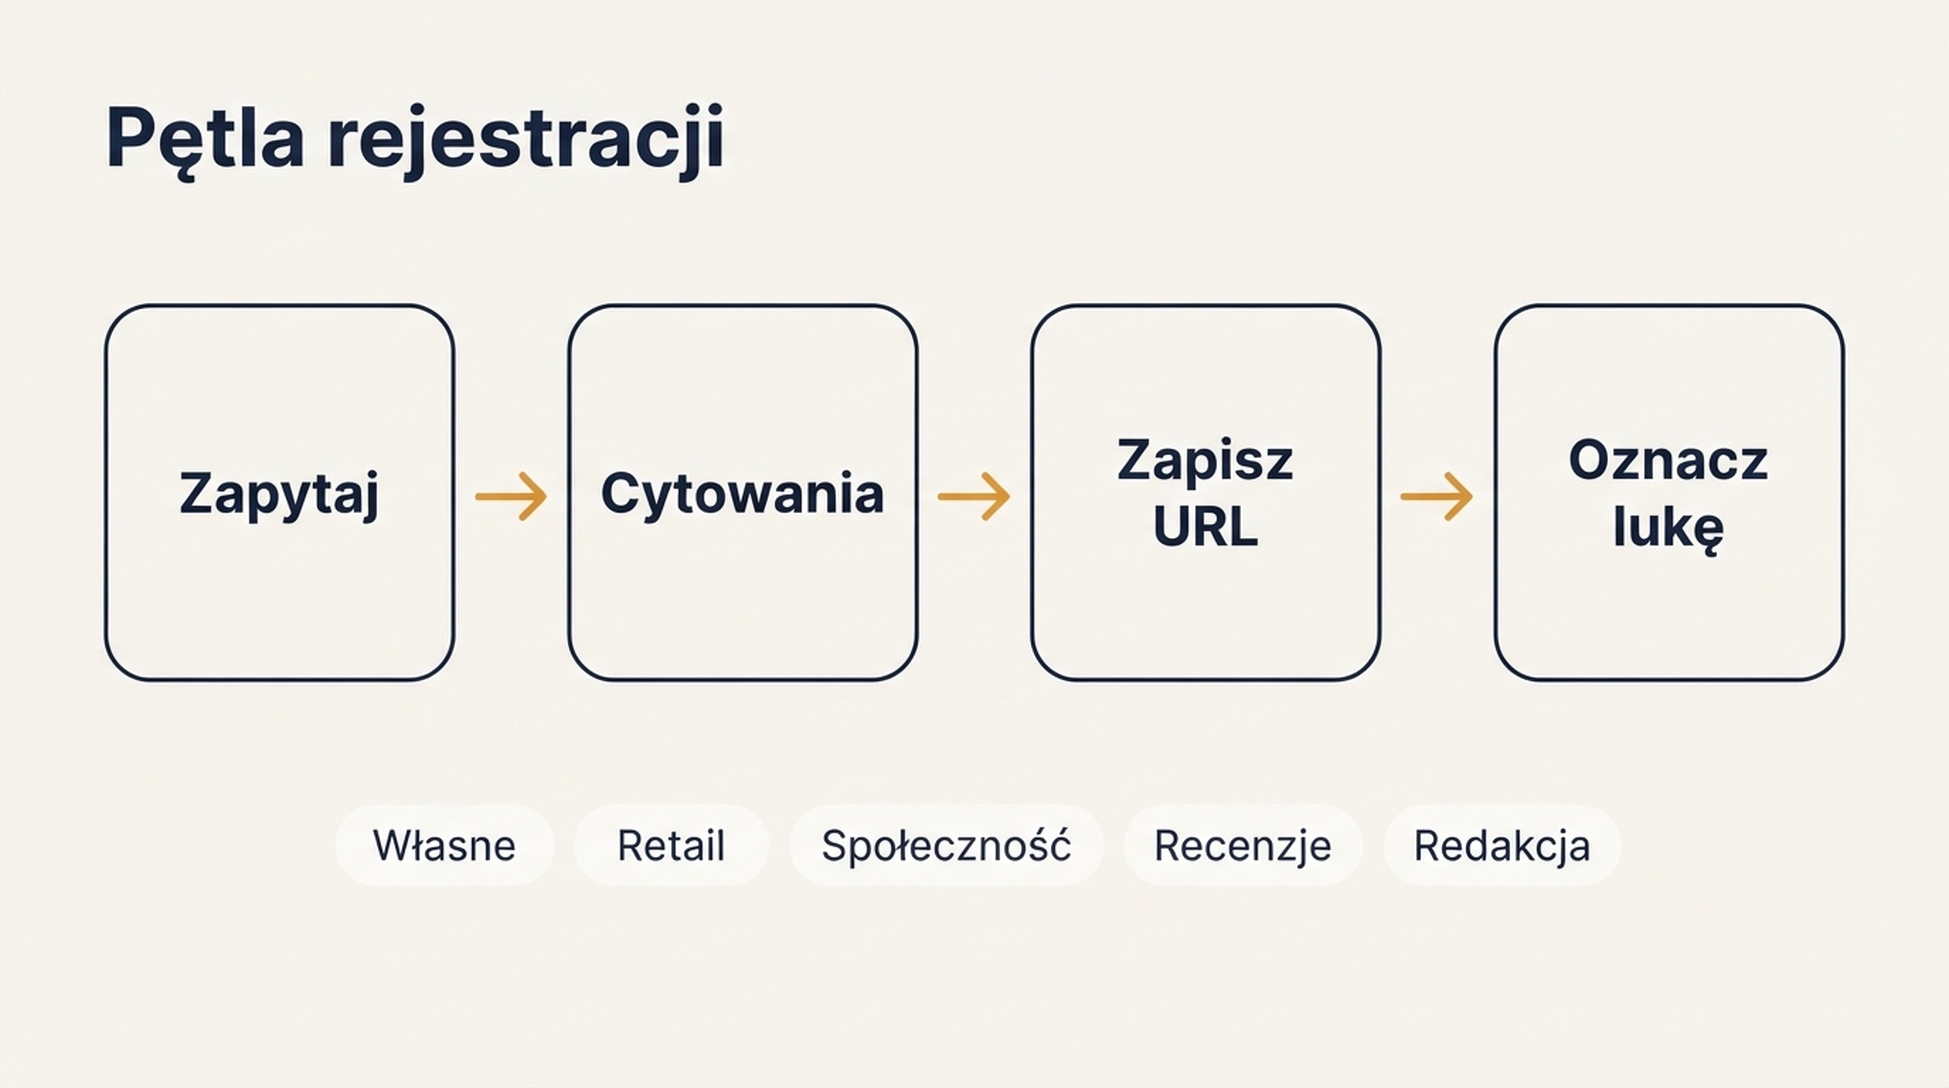
Pętla jest prosta i nużąca. Właśnie to połączenie czyni ją dobrym kandydatem do przekazania agentowi.
Krok 3: uporządkować źródła według typu
Teraz ściśnij długą tabelę w obraz swojej kategorii. Przypisz każdy cytowany URL do jednego z pięciu koszyków:
- Własne: twoja strona albo strona konkurenta
- Retail i marketplace: karty produktów, strony porównania cen, sklepy z aplikacjami
- Społeczność i UGC: Reddit, YouTube, Quora, fora, zaindeksowane wątki Discord
- Katalogi recenzji i platformy B2B: G2, Capterra, Clutch, Trustpilot, katalogi branżowe
- Niezależne redakcyjne i referencyjne: prasa branżowa, wiadomości, Wikipedia, analizy analityków, niezależne blogi
Policz według koszyków i silników — i mapa cytowań gotowa.
Szukasz nie pojedynczej liczby. Szukasz kształtu. Jedne kategorie trzymają się niemal w całości na wątkach społeczności i prasie branżowej, a własna strona marki prawie nie uczestniczy. Inne są zdominowane przez karty produktów, bo odpowiedź leży w samej karcie. Ta mieszanka zależy od tego, o co pytają kupujący, a nie od tego, jak dobra jest czyjaś strona. Trudno to przyjąć, gdy włożyłeś w stronę dwa lata.
Oczekiwany wynik: mała tabela, po jednym wierszu na typ źródła, po jednej kolumnie na silnik, z udziałem cytowanych źródeł.
Kontrola jakości: jeśli jeden koszyk trzyma ponad około 70% twoich cytowań, sprawdź pięć adresów URL w środku, czy naprawdę są tego typu. Jeden agregator o wysokim ruchu może udawać źródło redakcyjne, będąc w rzeczywistości katalogiem.
Ścieżka odzyskiwania: jeśli liczby wyglądają losowo, prawdopodobnie pomieszałeś formy pytań i tym samym ukryłeś wzorzec. Podziel tabelę według formy pytania i spójrz ponownie. Pytania o cenę i o ryzyko często mają zupełnie różne profile źródeł.
Krok 4: znaleźć luki, w których cytowany jest konkurent, a ciebie nie ma
Przefiltruj długą tabelę do wierszy, w których pojawia się konkurent, a twojej marki nie ma. Ta przefiltrowana lista to twoja lista pracy. Jest znacznie użyteczniejsza niż ogólny mandat „potrzebujemy więcej wzmianek”, bo każdy wiersz ma już adres URL i pytanie klienta. Daj ją komuś w poniedziałek — od razu zacznie.
Dla każdego wiersza otwórz cytowaną stronę i odpowiedz na trzy pytania:
- Czy nasz produkt naprawdę należy na tę stronę?
- Jeśli tak, czego brakuje: karty, której nigdy nie zgłosiliśmy, porównania, w którym nas nie ma, wątku, w którym nikt nas nie wspomniał, recenzji, o którą nigdy nie poprosiliśmy?
- Jaka najmniejsza uzasadniona czynność umieściłaby nas tam?
Trzecie pytanie to miejsce, w którym włącza się dyscyplina. Czynność zależy od koszyka. Pomyłka tutaj kończy się tym, że specjalista SEO wysyła dziennikarzom zimne maile o wątku na Reddicie.
Typ źródła | Uzasadniona czynność | Czego nie robić |
|---|---|---|
Katalog recenzji | Zgłosić i uzupełnić profil, poprosić klientów o recenzje | Kupować recenzje albo podrzucać fałszywe |
Wątek społeczności | Odpowiedzieć uczciwie jako nazwany pracownik, ujawniając powiązanie | Astroturfing albo wrzucenie linku bez wkładu |
Redakcyjne | Zaproponować naprawdę użyteczny kąt, którego medium jeszcze nie poruszyło | Rozesłać ten sam komunikat do 200 domen |
Marketplace lub karta retail | Naprawić specyfikacje, zdjęcia i opis, żeby fakty dały się pobrać | Wpychać słowa kluczowe w kartę |
Własna strona | Przebudować tak, żeby konkretny fakt był łatwy do znalezienia i zacytowania | Dodać blok FAQ, który na nic nie odpowiada |
Oczekiwany wynik: przefiltrowana i uprioritetyzowana lista. Sortuj według częstotliwości pojawiania się źródła w twoim zestawie pytań, a nie według tego, jak prestiżowo brzmi domena. Wątek forum cytowany w sześciu z dwudziestu pytań stoi wyżej niż branżowa publikacja cytowana raz, a do tego jest znacznie łatwiejszy do ruszenia.
Kontrola jakości: dla każdego zachowanego wiersza potwierdź, że potrafisz podać odpowiadające mu pytanie klienta. Jeśli nie potrafisz, usuń wiersz. Strony cytowane przy pytaniach, których nikt w twoim lejku nie zadaje, tylko rozpraszają.
Ścieżka odzyskiwania: jeśli przefiltrowana lista jest wciąż ogromna, nie filtrowałeś wystarczająco mocno. Ogranicz pierwsze przejście do dziesięciu wierszy, uporządkowanych według częstotliwości cytowań, i zajmij się nimi, zanim otworzysz pełną listę.
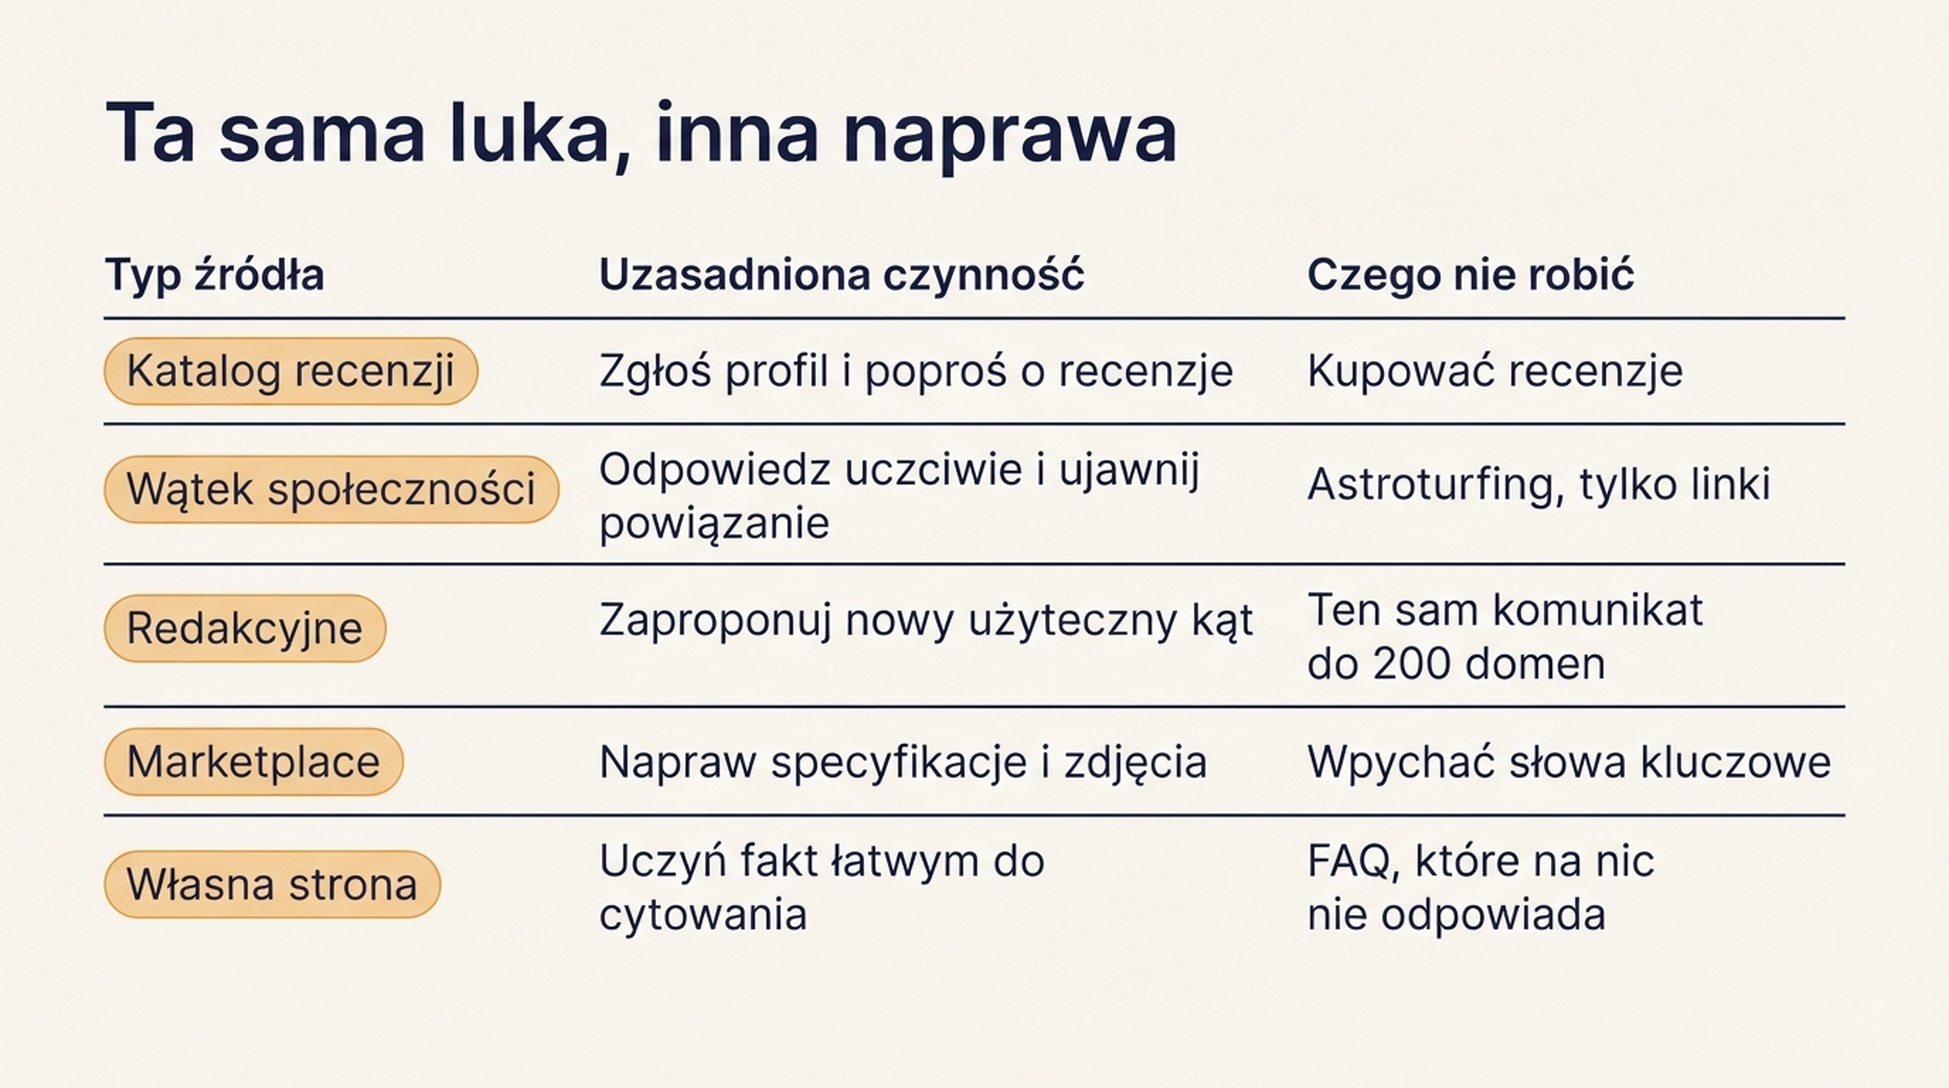
Ta sama luka, inna naprawa. Traktowanie każdego brakującego cytowania jako problemu outreachu to droga, na której zespoły kończą, sprzedając redaktorowi wątek z Reddita.
Krok 5: oddać mechaniczną połowę agentowi
Kroki 2 i 3 pochłaniają najwięcej czasu i wymagają najmniej osądu. To właśnie definicja pracy warta delegowania. Zestaw pytań i priorytetyzacja zostają przy człowieku, bo to dwa miejsca, w których błąd osądu unieważnia całe ćwiczenie.
Cztery agenty poniżej potrafią wykonać tę samą metodę. Zmienia się to, gdzie mieszka metoda i jak wraca wynik. Wybieraj według tego, a nie według tego, który model wygrał benchmark w tym miesiącu.
Codex
Idealny, gdy chcesz, żeby mapa mieszkała w repozytorium i przy każdym uruchomieniu dawała artefakt do przejrzenia. Jeśli twoja strona jest już w gicie, to ścieżka z najmniejszym tarciem.
Przygotuj folder projektu z katalogiem citation-map/, plikiem questions.csv z twoim zestawem pytań i SKILL.md, który opisuje metodę: które silniki sprawdzać, jakie pola rejestrować, jak klasyfikować źródło i jak ma wyglądać plik wyjściowy. Trzymaj jeden plik na uruchomienie, nazwany datą, żeby gromadzić historię, a nie nadpisywać.
Poproś Codexa, żeby uruchomił pytania, dopisał wiersze do pliku bieżącego uruchomienia i wygenerował tabelę podsumowującą udział źródeł według silników. Ponieważ wynik jest plikiem w repozytorium, dostajesz diff, który możesz przejrzeć, zanim cokolwiek stanie się ostateczne. Ten etap przeglądu jest sednem: sprawdzasz klasyfikacje, a nie powtarzasz zbieranie.
Jedna zasada musi znaleźć się w SKILL.md niezależnie od wszystkiego: agent rejestruje to, co zaobserwował, i nie wnioskuje o cytowaniu, którego nie widział. Wymyślanie źródeł to najbardziej szkodliwy tryb awarii w tym procesie. Zapisana zasada plus wyrywkowa kontrola trzech wierszy zatrzymuje większość, a trzy sprawdzane wiersze powinny zmieniać się przy każdym uruchomieniu.
Claude Code
Idealny, gdy metodę trzeba czytać wobec wyraźnie zapisanej polityki i gdy chcesz przeglądać zebrane strony w długim kontekście.
Umieść metodę w CLAUDE.md albo w skillu projektu, wraz z definicjami typów źródeł i dokładnym schematem wyjścia. Wskaż Claude Code folder uruchomienia i poproś, żeby sklasyfikował każdy cytowany URL, a następnie oznaczył wiersze, w których treść strony naprawdę nie podtrzymuje cytowania.
Drugie zadanie to to, za które warto płacić. Przeczytanie 200 cytowanych stron i ocena, czy każda naprawdę odpowiada na pytanie, jest męczące dla człowieka i rozsądne dla agenta z zapisanym standardem. Poproś o flagę pewności przy każdym wierszu i sam przeglądaj tylko te o niskiej pewności.
ChatGPT
Idealny, gdy chcesz najniższy koszt konfiguracji, a praca to jedna sesja, a nie powtarzalne uruchomienie.
Wklej metodę jako instrukcję niestandardową albo zapisany prompt projektu, załącz listę pytań i pracuj partiami według silników. Poproś o wynik jako tabelę z dokładnie tymi samymi kolumnami co w kroku 2, żeby wklejała się prosto do arkusza.
Haczyk jest taki, że ChatGPT to także jedna z powierzchni, które mierzysz. Jeśli mapujesz cytowania samego ChatGPT, rób to w czystej sesji bez wczytanej metody, inaczej zanieczyszczasz obserwację. Użyj jednej sesji do zbierania, a innej do porządkowania.
Hermes Agent
Idealny, gdy chcesz, żeby metoda przetrwała jako skill i poprawiała się między uruchomieniami bez ponownego tłumaczenia.
Zainstaluj metodę mapy cytowań jako skill Hermesa wraz z zestawem pytań i schematem wyjścia, a potem uruchamiaj w rytmie; miesięczny zwykle jest właściwy. Ponieważ skill i jego pamięć przetrwają, poprawki z pierwszego miesiąca przechodzą do drugiego. Jeśli agent błędnie sklasyfikował katalog jako źródło redakcyjne, poprawiasz regułę raz.
Cena jest taka, że trwała pamięć wymaga okresowego przeglądu. Co kilka uruchomień przeczytaj plik skilla i sprawdź, czy nagromadzone poprawki nadal opisują metodę, której chcesz, a nie stertę jednorazowych wyjątków, których nikt nie potrafi wyjaśnić.
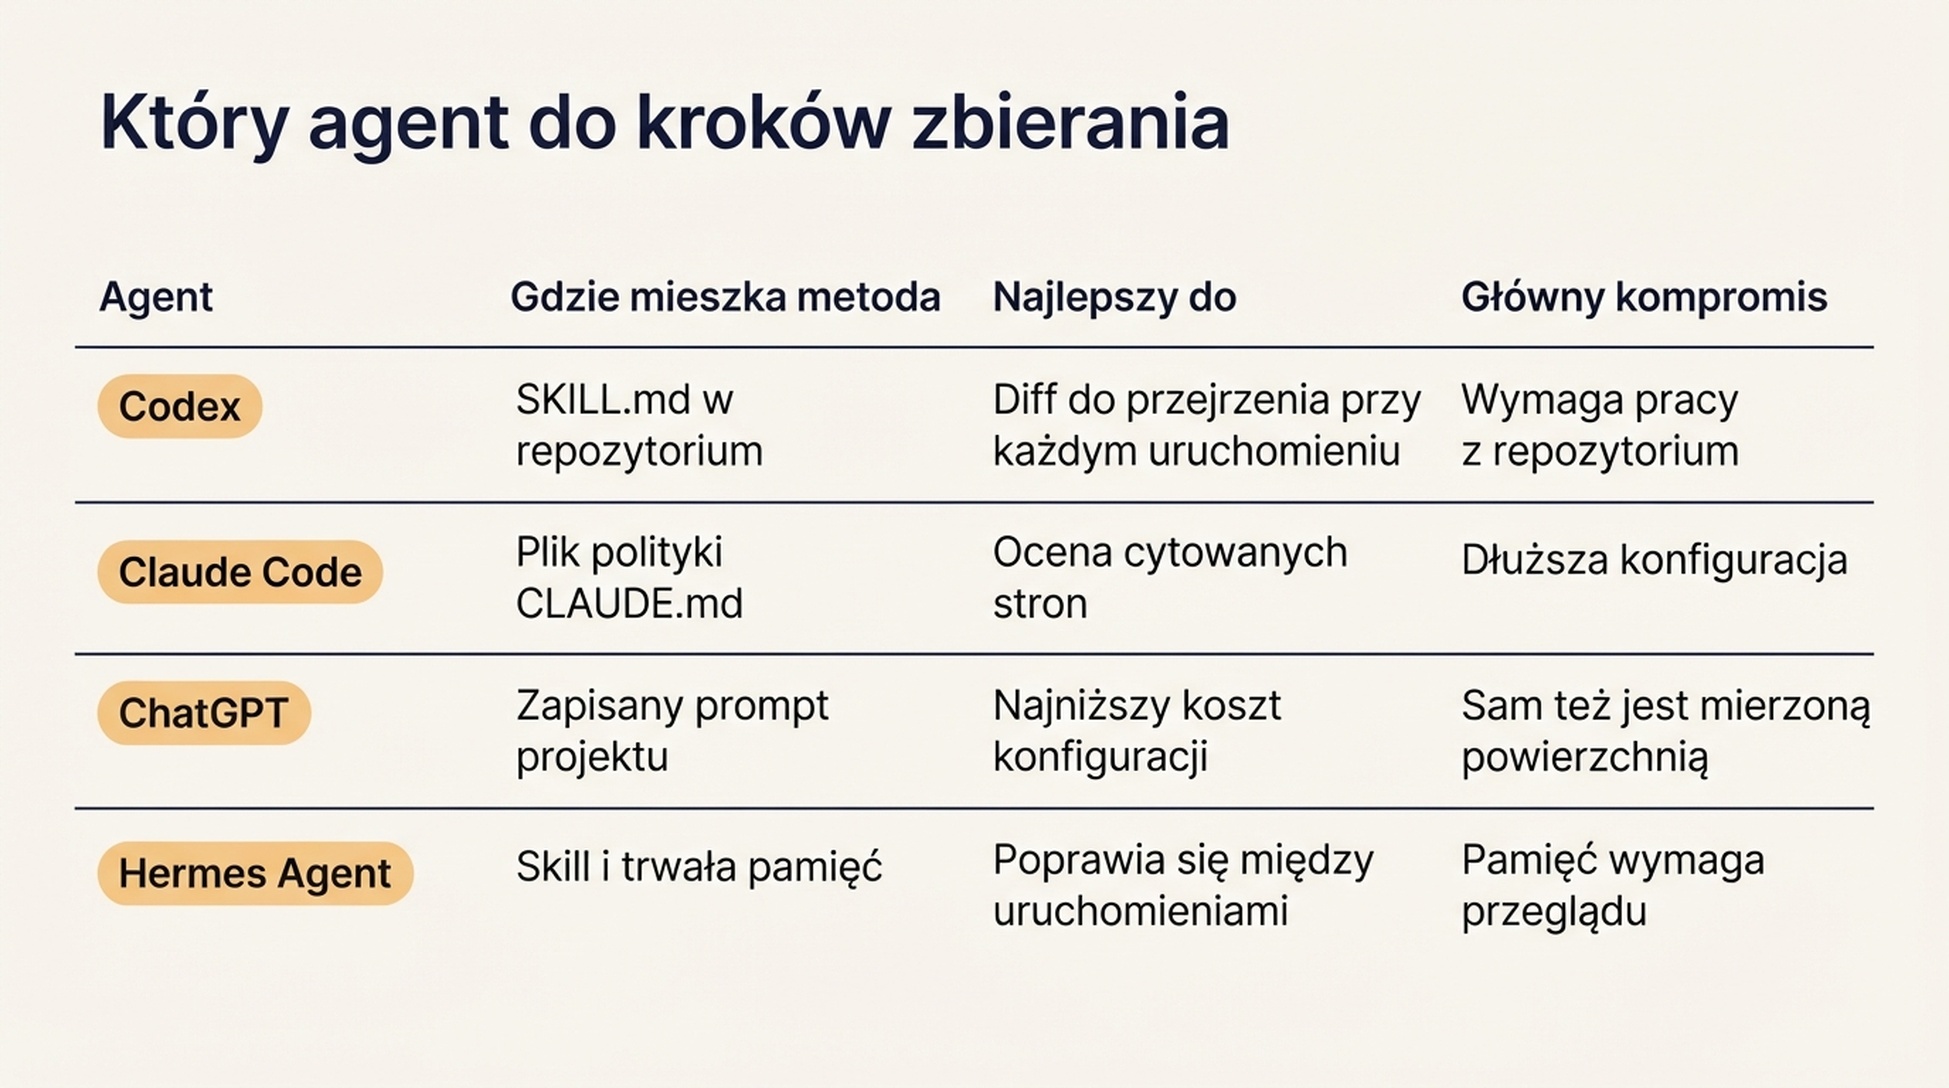
Wszystkie cztery wykonują te same pięć kroków. Wybieraj według tego, gdzie ma mieszkać metoda, a nie według tego, który model zdobył najwyższy wynik w benchmarku.
Krok 6: zweryfikować mapę, zanim zaczniesz działać
Nie przydzielaj pracy na podstawie niezweryfikowanej mapy. Najpierw uruchom tę kontrolę. Pięć minut tutaj oszczędza kwartał wysiłku w złym kierunku.
- Uruchom ponownie trzy pytania tydzień później. Jeśli mieszanka źródeł zmienia się całkowicie, twój zestaw pytań jest zbyt zmienny albo próba zbyt mała. Rejestruj rozrzut, zamiast traktować pierwsze przejście jako prawdę. Pewien rozrzut jest normalny; całkowita wymiana to ostrzeżenie.
- Potwierdź silnik, nie tylko odpowiedź. Źródło, które pojawia się w Perplexity, może nie występować w ChatGPT przy tym samym pytaniu. Trzymaj kolumny według silników osobno w podsumowaniu; zbiorczy wynik ukrywa dokładnie ten sygnał, którego potrzebujesz.
- Sprawdź też własne cytowania. Jeśli twoja marka jest cytowana, otwórz stronę. Czasem silnik cytuje stronę, na której mówi się o tobie krytycznie, albo taką, której nie kontrolujesz. To użyteczna informacja, nie zwycięstwo.
- Potwierdź datę w każdym wierszu. Mapa cytowań bez dat nie porównuje się potem z niczym.
- Sprawdź liczbę źródeł. Jeśli jedno pytanie zwróciło 40 źródeł, a reszta trzy, sprawdź, czy nie zebrałeś panelu „podobne” zamiast rzeczywistych cytowań.
Co znaczy „gotowe”: możesz przekazać koledze tabelę podsumowującą i jedną przefiltrowaną listę pracy, a on może działać, nie pytając, co znaczy którykolwiek wiersz.
Utrzymanie mapy
Uruchamiaj pełne przejście raz na kwartał na tym samym zestawie pytań, a lekkie przejście co miesiąc na pięciu pytaniach o największej wartości komercyjnej. Zachowuj stare uruchomienia. Ciekawy sygnał rzadko jest migawką. To dryf: typ źródła, który cicho rośnie, albo konkurent, który zaczyna pojawiać się w koszyku, w którym go wcześniej nie było.
Przeglądaj zestaw pytań dwa razy w roku. Pytania zakupowe zmieniają się wraz z twoim produktem i rynkiem, a nieaktualny zestaw daje mapę kategorii, której już nie sprzedajesz.
Jedna rzecz, której warto się opierać: zamienianie tego w dashboard. Wynik to lista pracy z osobami odpowiedzialnymi i adresami URL. Jeśli na końcu nikt nie ma zadania, mapa nie wykonała swojej pracy.
Najczęstsze pytania
Czy potrzebuję płatnego narzędzia do widoczności w AI, żeby to zrobić? Nie. Wersja ręczna działa dla jednej kategorii i zajmuje pół dnia. Narzędzia zarabiają na siebie, gdy śledzisz wiele kategorii lub rynków, albo gdy chcesz historyczne linie trendu bez samodzielnego utrzymywania arkusza.
Ile pytań wystarczy? Od 10 do 20 na kategorię. Poniżej dziesięciu nie odróżnisz wzorca od przypadku. Powyżej dwudziestu w pierwszym przejściu nie skończysz analizy, a to właśnie analiza tworzy listę pracy.
Czy uwzględniać pytania, w których już się pojawiamy? Tak. Wiedza, które źródła cię trzymają, jest tak samo użyteczna jak wiedza, które cię pomijają, i podpowiada, co chronić przy zmianie treści.
Co jeśli silnik za każdym razem daje inną odpowiedź? To normalne i warto to rejestrować. Uruchom to samo pytanie trzy razy i zanotuj rozrzut. Jeśli zestaw źródeł jest za każdym razem zupełnie inny, potraktuj to pytanie jako o niskiej pewności i daj mu mniejszą wagę przy priorytetyzacji.
Czy mogę po prostu użyć listy źródeł silnika bez otwierania stron? Do pierwszego zbierania tak. Do wierszy, na których będziesz działać, nie. Musisz przeczytać stronę, żeby ocenić, czy twoja marka naprawdę tam należy i co byłoby użytecznym wkładem.
Czym to się różni od śledzenia pozycji? Śledzenie pozycji mówi, gdzie twoje strony pojawiają się na liście wyników. Mapa cytowań mówi, z których stron złożono odpowiedź. Strona może być pierwsza i nigdy nie być cytowana, a strona, która nigdzie się nie pozycjonuje, może być kręgosłupem odpowiedzi. Właśnie ta różnica sprawia, że warto poświęcić pół dnia.
Autor: Ethan Marlowe, lider pomiaru GEO w Auspii, przeanalizował ponad 500 promptów. Pisze o śledzeniu promptów, raportowaniu cytowań, dashboardach widoczności i o tym, jak odróżnić prawdziwą zmianę widoczności w AI od szumu między uruchomieniami.