ทีมส่วนใหญ่ที่ติดตามการปรากฏตัวของแบรนด์ในคำตอบ AI ยังทำงานจากภาพหน้าจออยู่ พวกเขาถาม ChatGPT หนึ่งคำถาม คัดลอกการอ้างอิง แล้ววางลงในเอกสาร สิ่งนั้นบอกได้แค่ว่าโมเดลหนึ่งพูดอะไรในบ่ายวันหนึ่ง ไม่ได้บอกว่ามีแหล่งข้อมูลใดที่เครื่องยนต์ตอบคำถามเข้าถึงได้จริง และไม่ได้ให้อะไรกับเอเจนต์ของคุณเพื่อให้มันไปดึงข้อมูลเอง
รูปแบบที่มีประโยชน์กว่าของงานนี้คือแผนที่แหล่งข้อมูลบวกเส้นทางเชื่อมต่อ คุณตัดสินใจว่าแหล่งข้อมูลใดสำคัญกับหมวดหมู่ของคุณ แล้วเชื่อมสิ่งที่เข้าถึงได้เข้ากับเอเจนต์ที่รันการติดตามโดยตรง สิ่งที่เหลือคือรายการสั้น ๆ ของแหล่งข้อมูลที่คุณทำได้เพียงสร้างอิทธิพลทางอ้อม และรายการนั้นมักสั้นกว่าที่คุณคิด
บทความนี้ทำสามอย่าง จัดชั้นแหล่งข้อมูลที่อยู่เบื้องหลังคำตอบ AI ตามความหนักแน่นของหลักฐานและความสดใหม่ ให้เส้นทาง API หรือ MCP ที่ชัดเจนสำหรับแหล่งที่มีเส้นทาง และอธิบายวิธีเชื่อมต่อสำหรับ Codex, Claude Code, Hermes Agent, OpenClaw, Pi Agent, Grok Bot และ Meta Muse รวมถึงกรณีที่ไม่มีคอนเนกเตอร์สำเร็จรูปและคุณต้องสร้างสะพานเอง
คำตอบสั้น
แหล่งข้อมูลที่หนุนคำตอบ AI แบ่งเป็นสี่หมวด และการเข้าถึงไม่เท่ากัน
แหล่งเว็บและการค้นพบผ่านการค้นหาเข้าถึงได้ผ่าน API แบบ grounding และผ่านหน้าที่คุณทำให้ถูกครอวล์ได้ ฟีดพาณิชย์แบบมีโครงสร้างเข้าถึงได้ผ่านสเปกฟีดที่มีเอกสาร แต่การเข้าถึงถูกจำกัดด้วยการอนุมัติ คลังความรู้และชุมชนเข้าถึงได้บางส่วนผ่าน API ที่มีลิขสิทธิ์ และบางส่วนถูกล็อกไว้หลังการเก็บข้อมูลตอนฝึกที่คุณสร้างอิทธิพลไม่ได้ ส่วนพื้นผิวการกระทำของเอเจนต์เข้าถึงได้ผ่านสเปกโปรโตคอลที่ยังคงเข้าที่
เมื่อแปลงเป็นเวิร์กโฟลว์การติดตามที่เอเจนต์ขับเคลื่อน มันกลายเป็นกฎที่ใช้ได้จริง เชื่อมสิ่งที่ม API หรือเซิร์ฟเวอร์ MCP ที่มีเอกสารแล้ว มองสิ่งที่มสเปกฟีดเป็นโปรเจกต์คุณภาพข้อมูล และมองสิ่งที่ไม่มีทั้งสองอย่างเป็นโปรเจกต์เนื้อหาและเอนทิตี ไม่ใช่โปรเจกต์ข้อมูล
วิธีอ่านตารางชั้น
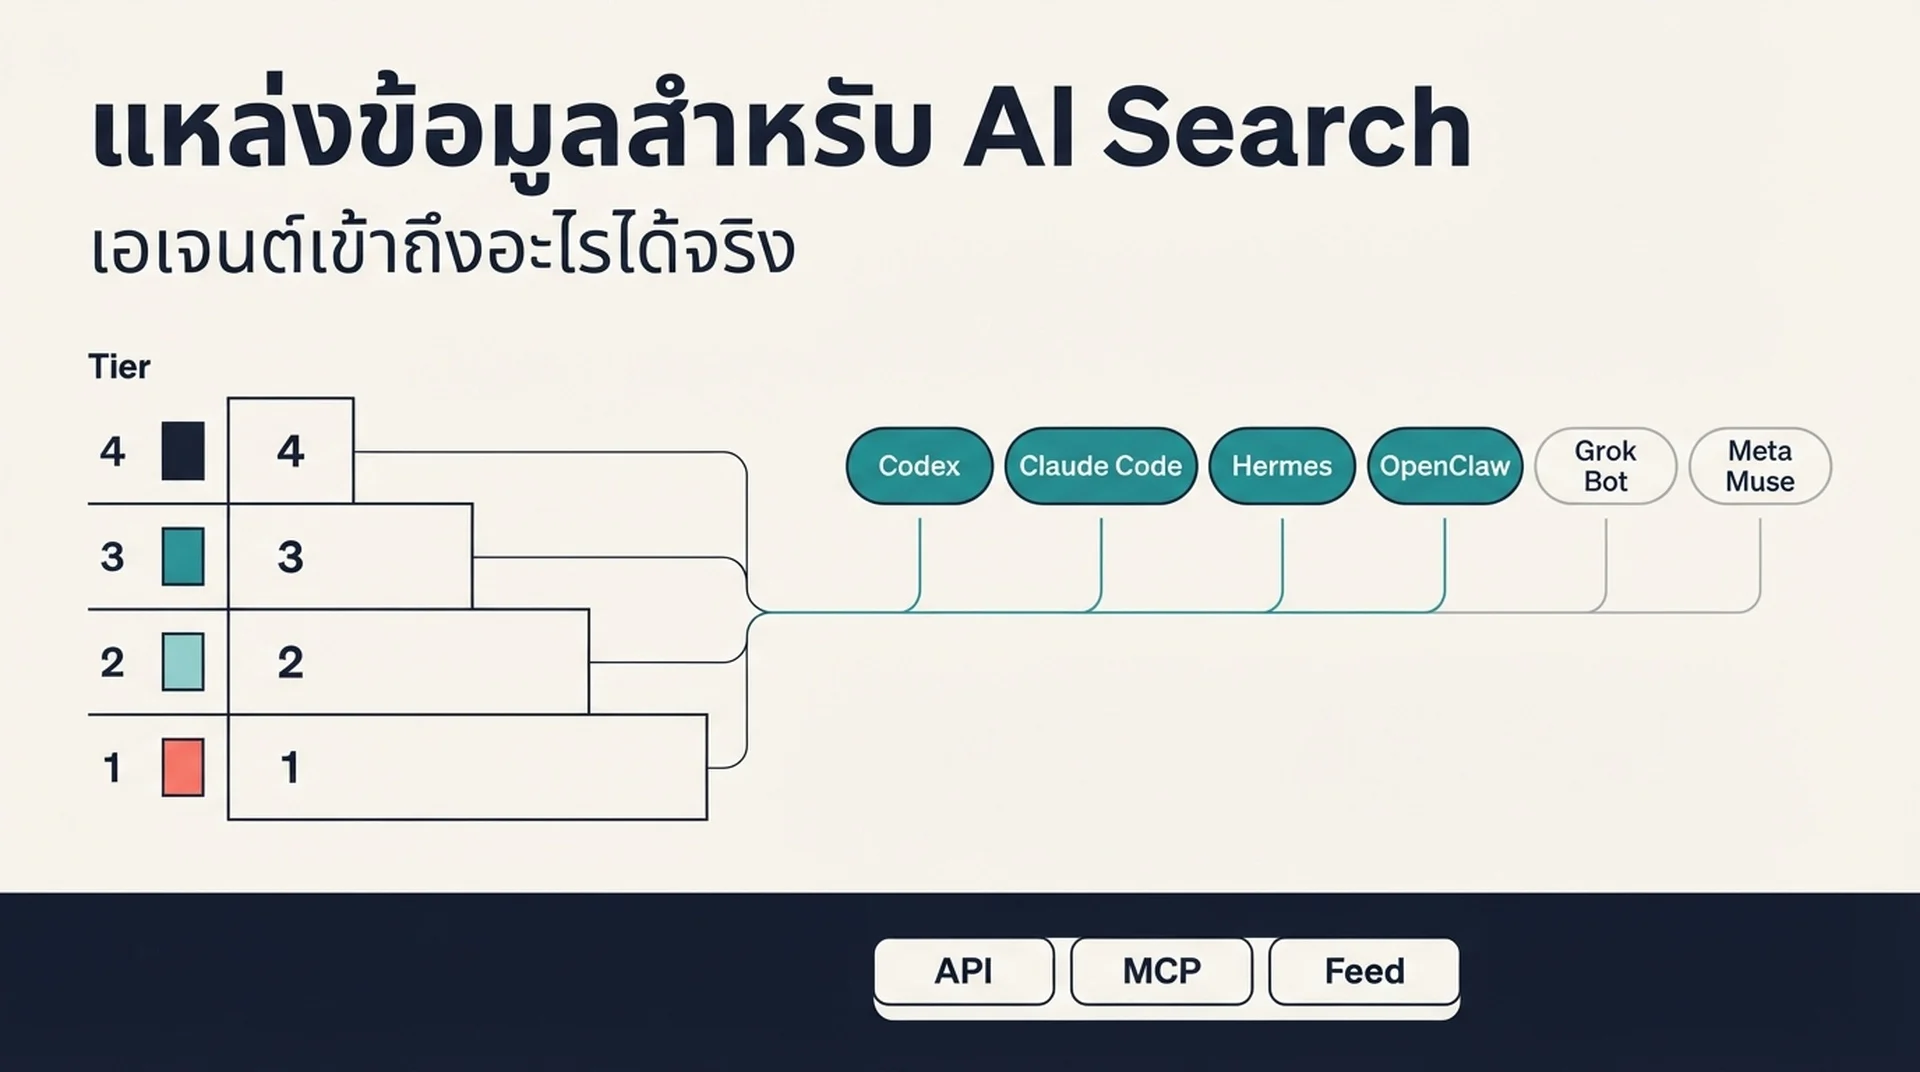
ชั้นด้านล่างจัดหมวดแหล่งข้อมูลตามความหนักแน่นของหลักฐานว่ามันหนุนคำตอบ AI อยู่จริงในตอนนี้ และตามว่าการเชื่อมต่อนั้นยังมีชีวิตหรือเป็นอดีต นี่คือจุดที่รายการแหล่งข้อมูลส่วนใหญ่ผิดพลาด แหล่งที่หล่อหลอมโมเดลในปี 2022 กับแหล่งที่โมเดลค้นหาวันนี้เป็นคนละเรื่อง และการหลอมรวมสองอย่างเข้าด้วยกันทำให้กลยุทธ์ผิดพลาด
ชั้น | ความหมาย | ความหมายต่อเวิร์กโฟลว์ของคุณ |
|---|---|---|
1 | ยืนยันแล้วและยังใช้อยู่ | grounding การดึงข้อมูล หรือการกระทำแบบสด เชื่อม ติดตาม และปรับให้เหมาะกับมัน |
2 | ยืนยันแล้วและยังใช้อยู่ | การฝึกหรือลิขสิทธิ์ คุณสร้างอิทธิพลได้ผ่านเนื้อหาและความร่วมมือ ไม่ใช่ผ่าน API |
3 | ยืนยันแล้วในเชิงประวัติศาสตร์ | การฝึกก่อนเท่านั้น ไม่มีคานงัดแบบสด อย่าสร้างเวิร์กโฟลว์การติดตามรอบมัน |
4 | หลักฐานหนักแน่นแต่ยังไม่ยืนยัน | การอนุมานเชิงหมวดหมู่ ควรจับตา แต่ยังไม่ควรตั้งงบ |
ข้อควรระวังก่อนดูตาราง หมวดนี้เปลี่ยนทุกเดือน ทั้งเอกสารผู้ให้บริการ ดีลลิขสิทธิ์ และสเปกฟีดล้วนเคลื่อนไหว มองการจัดชั้นเป็นจุดเริ่มต้นที่คุณตรวจซ้ำกับเอกสารของผู้ให้บริการเองก่อนจะผูกทีมเข้ากับเวิร์กโฟลว์
ชั้น 1: แหล่งสดที่เอเจนต์เข้าถึงได้จริง
นี่คือแหล่งที่มีการเชื่อมต่อที่มีเอกสารรองรับในวันนี้ ถ้าเอเจนต์ของคุณจะดึงข้อมูลการปรากฏตัวใน AI ด้วยตัวเอง ก็เริ่มที่นี่
เว็บและการค้นพบผ่านการค้นหา
grounding กับ Google Search API ของ Gemini มีเครื่องมือ google_search ที่เชื่อมโมเดลกับเนื้อหาเว็บแบบเรียลไทม์และคืนการอ้างอิงไปยัง URL ต้นทาง นี่มีเอกสาร ยังใช้อยู่ และเป็นตัวอย่างที่ชัดที่สุดของ grounding แบบสดในตลาด และยังหมายความว่าคานงัดคือความสามารถในการถูกครอวล์และโครงสร้างหน้าของคุณ ไม่ใช่ฟีด
Bing Search Microsoft ระบุในเอกสารว่าผลลัพธ์ Bing ถูกใช้เสริมคำตอบของ Copilot นัยในทางปฏิบัติเหมือนกับ Google ถ้าอยากปรากฏ หน้าต้องเข้าถึงได้และดึงข้อมูลได้
หน้าเว็บของสำนักพิมพ์แบบสด เข้าถึงตอนอนุมานผ่าน grounding ในการค้นหา ไม่ใช่ผ่านการฝึกก่อน การเลือกผลลัพธ์และความสามารถในการถูกครอวล์กำหนดการถูกรวม จึงเป็นเหตุให้งาน SEO เชิงเทคนิคยังปรากฏในผลลัพธ์การมองเห็นใน AI
สินค้าและการช้อปปิ้ง
Google Merchant Center ข้อมูลฟีดผู้ขายเป็นฐานของพื้นผิวการช้อปปิ้งของ Google ถ้าคุณขายสินค้าจับต้องได้และไม่ได้อยู่ใน Merchant Center คุณก็หายไปจากพื้นผิวที่กำลังถูกเชื่อมเข้าคำตอบ AI อย่างจริงจัง
ฟีดผู้ขายและค้าปลีกของ OpenAI ผู้ขายแชร์ฟีดสินค้าแบบมีโครงสร้าง และเอกสาร Agentic Commerce Protocol อธิบายสกีมา เส้นทางผสานรวมทั้งการอัปโหลดไฟล์และ API และรอบการรีเฟรชที่รับอัปเดตได้ตลอดวัน การเข้าถึงตอนนี้จำกัดเฉพาะพาร์ตเนอร์ที่อนุมัติแล้ว จึงเป็นโปรเจกต์ที่มีเวลารอ ไม่ใช่สวิตช์ที่กดได้ทันที
ท้องถิ่นและสถานที่
grounding กับ Google Maps มีเอกสารรองรับเป็นเครื่องมือคู่กับ grounding ในการค้นหา ให้บริบทเชิงภูมิศาสตร์แก่โมเดล นี่คือเหตุที่ธุรกิจท้องถิ่นที่มีโปรไฟล์ถูกต้องครบถ้วนปรากฏในคำตอบ AI เกี่ยวกับตัวเลือกใกล้เคียง
Google Business Profile ข้อมูลโปรไฟล์ธุรกิจเป็นฐานของพื้นผิวท้องถิ่นของ Google สำหรับธุรกิจท้องถิ่น นี่คือหนึ่งในแหล่งที่ให้คานงัดสูงและใช้แรงน้อยที่สุดในรายการ
Yelp ให้ลิขสิทธิ์รีวิว รูปภาพ และข้อมูลธุรกิจเพื่อการแนะนำท้องถิ่นแบบเรียลไทม์ และความสัมพันธ์นี้เลยจาก grounding ไปสู่การกระทำ นี่คือหนึ่งในไม่กี่แหล่งที่แพลตฟอร์มรีวิวเป็นทั้งแหล่งอ้างอิงและพื้นผิวธุรกรรม
ความรู้และการอ้างอิง
Wikipedia และ Wikimedia ปรากฏในส่วนผสมการฝึกก่อนที่เปิดเผย และถูกใช้อย่างกว้างขวางเป็นคลังอ้างอิงแบบสด ลิขสิทธิ์ชัดเจนผิดปกติ ทำให้เป็นเป้าหมายที่ชอบด้วยเหตุผลสำหรับงานเอนทิตี
ชุมชน ถามตอบ และโซเชียล
Reddit เป็นแหล่ง grounding แบบสดผ่านข้อตกลงลิขสิทธิ์ข้อมูล โดยด้านการฝึกถูกรายงานแยกต่างหาก มองสถานะการต่อสัญญาว่าไม่มั่นคง และอย่าสร้างเวิร์กโฟลว์ที่สมมติว่ามีการเข้าถึงถาวร
ชั้น 2 และ 3: แหล่งที่คุณสร้างอิทธิพลได้แต่ค้นหาไม่ได้
สิ่งเหล่านี้สำคัญ แต่ไม่ใช่ผ่าน API ที่เอเจนต์เรียกได้
เนื้อหาสำนักพิมพ์ที่มีลิขสิทธิ์ มีความร่วมมือด้านลิขสิทธิ์ที่ชัดเจนหลายรายกับสำนักพิมพ์รายใหญ่ โดยเงื่อนไขต่างกันตามคู่สัญญาในเรื่องการฝึก grounding และการระบุที่มา คุณซื้อที่ในรายการนี้ไม่ได้ในฐานะเว็บเล็ก แต่คุณเป็นแหล่งประเภทที่ถูกอ้างอิงได้เมื่อคลังที่มีลิขสิทธิ์บางเบาในหัวข้อของคุณ
แหล่งสำหรับนักพัฒนาและเทคนิค คลังโค้ดสาธารณะและคลังเอกสารเทคนิคเป็นแหล่งที่ยืนยันแล้วและยังใช้อยู่ สำหรับบริษัทเครื่องมือสำหรับนักพัฒนา นี่คือชั้นที่มีค่าสูงสุดในรายการ และเข้าถึงได้ผ่านคุณภาพเอกสาร ไม่ใช่ผ่านฟีด
คลังเว็บเชิงประวัติศาสตร์ เวอร์ชันดัดแปลงที่ทำความสะอาดจากข้อมูลครอวล์ทั่วไปและคลังเก็บที่คล้ายกัน ยืนยันแล้วในเชิงประวัติศาสตร์ ไม่มีคานงัดแบบสด มีประโยชน์เป็นบริบทเพื่อเข้าใจว่าทำไมโมเดลจึงมีสมมติฐานหนึ่ง แต่ไม่เหมาะกับเวิร์กโฟลว์การติดตาม
ชั้นการเชื่อมต่อ: แต่ละเอเจนต์เข้าถึงอะไรได้
ตรงนี้คือจุดที่บทความนี้คุ้มค่า ตารางด้านล่างจับคู่เอเจนต์แต่ละตัวกับกลไกการเชื่อมต่อที่รองรับจริง และกับสถานะที่ตรงไปตรงมาของคอนเนกเตอร์สำเร็จรูปสำหรับแหล่งข้างต้น
เอเจนต์ | กลไกการเชื่อมต่อ | คอนเนกเตอร์สำเร็จรูป | สิ่งที่คุณสร้าง |
|---|---|---|---|
Codex | MCP ผ่าน stdio และ streamable HTTP ตั้งค่าใน | ทะเบียนเซิร์ฟเวอร์ MCP จากชุมชนที่เติบโต | เซิร์ฟเวอร์ MCP บาง ๆ สำหรับแหล่งที่มี HTTP API |
Claude Code | MCP ผ่าน HTTP, SSE, stdio และ WebSocket | ไดเรกทอรีคอนเนกเตอร์ของ Anthropic และเซิร์ฟเวอร์จากชุมชน | เซิร์ฟเวอร์เดิม เพิ่มด้วย |
Hermes Agent | MCP พร้อมการกรองเครื่องมือรายเซิร์ฟเวอร์ บวกสกิลแบบเนทีฟ | แค็ตตาล็อก MCP คัดสรรที่ติดตั้งได้ในคลิกเดียว | สกิลที่ห่อ API เมื่อไม่มี MCP |
OpenClaw | ไคลเอนต์และเซิร์ฟเวอร์ MCP บวก A2A JSON-RPC | ทะเบียน MCP ของ OpenClaw และคำจำกัดความเซิร์ฟเวอร์ที่บันทึกไว้ | คำจำกัดความ MCP ที่บันทึกไว้ หรือสะพาน A2A |
Pi Agent | ส่วนขยาย TypeScript และสกิล ไม่มีไคลเอนต์ MCP แบบเนทีฟ | ไม่มีโดยค่าเริ่มต้น | ส่วนขยายเล็ก ๆ ที่เรียก API เป็นเครื่องมือ |
Grok Bot | เครื่องมือ MCP ระยะไกลที่ประกาศในคำขอ API | เซิร์ฟเวอร์ MCP ระยะไกลใดก็ได้ที่คุณชี้ไป | เซิร์ฟเวอร์ MCP ระยะไกล เพราะ Grok จัดการการเชื่อมต่อ |
Meta Muse | คอนเนกเตอร์ ไม่มีพื้นผิว MCP หรือ API สาธารณะ | คอนเนกเตอร์ที่ผู้ให้บริการจัดการเท่านั้น | งานทางอ้อมเท่านั้น: ฟีด ข้อมูลเอนทิตี และหน้าที่ถูกครอวล์ได้ |
รูปแบบที่น่าสังเกตคือ ห้าในเจ็ดเอเจนต์พูด MCP และสองตัวที่ไม่พูดอยู่คนละสุดของสเปกตรัม Pi Agent เรียบง่ายโดยเจตนาและคาดหวังให้คุณเขียนส่วนขยาย ส่วน Meta Muse เป็นผลิตภัณฑ์สำหรับผู้บริโภคที่ไม่มีพื้นผิวสำหรับนักพัฒนาเลย
นั่นหมายความว่าการเคลื่อนไหวที่มีประสิทธิภาพคือสร้างเซิร์ฟเวอร์ MCP หนึ่งตัวสำหรับแหล่งที่มีค่าสูงสุดของคุณ แล้วนำกลับมาใช้ซ้ำใน Codex, Claude Code, Hermes Agent, OpenClaw และ Grok Bot คุณเขียนครั้งเดียว
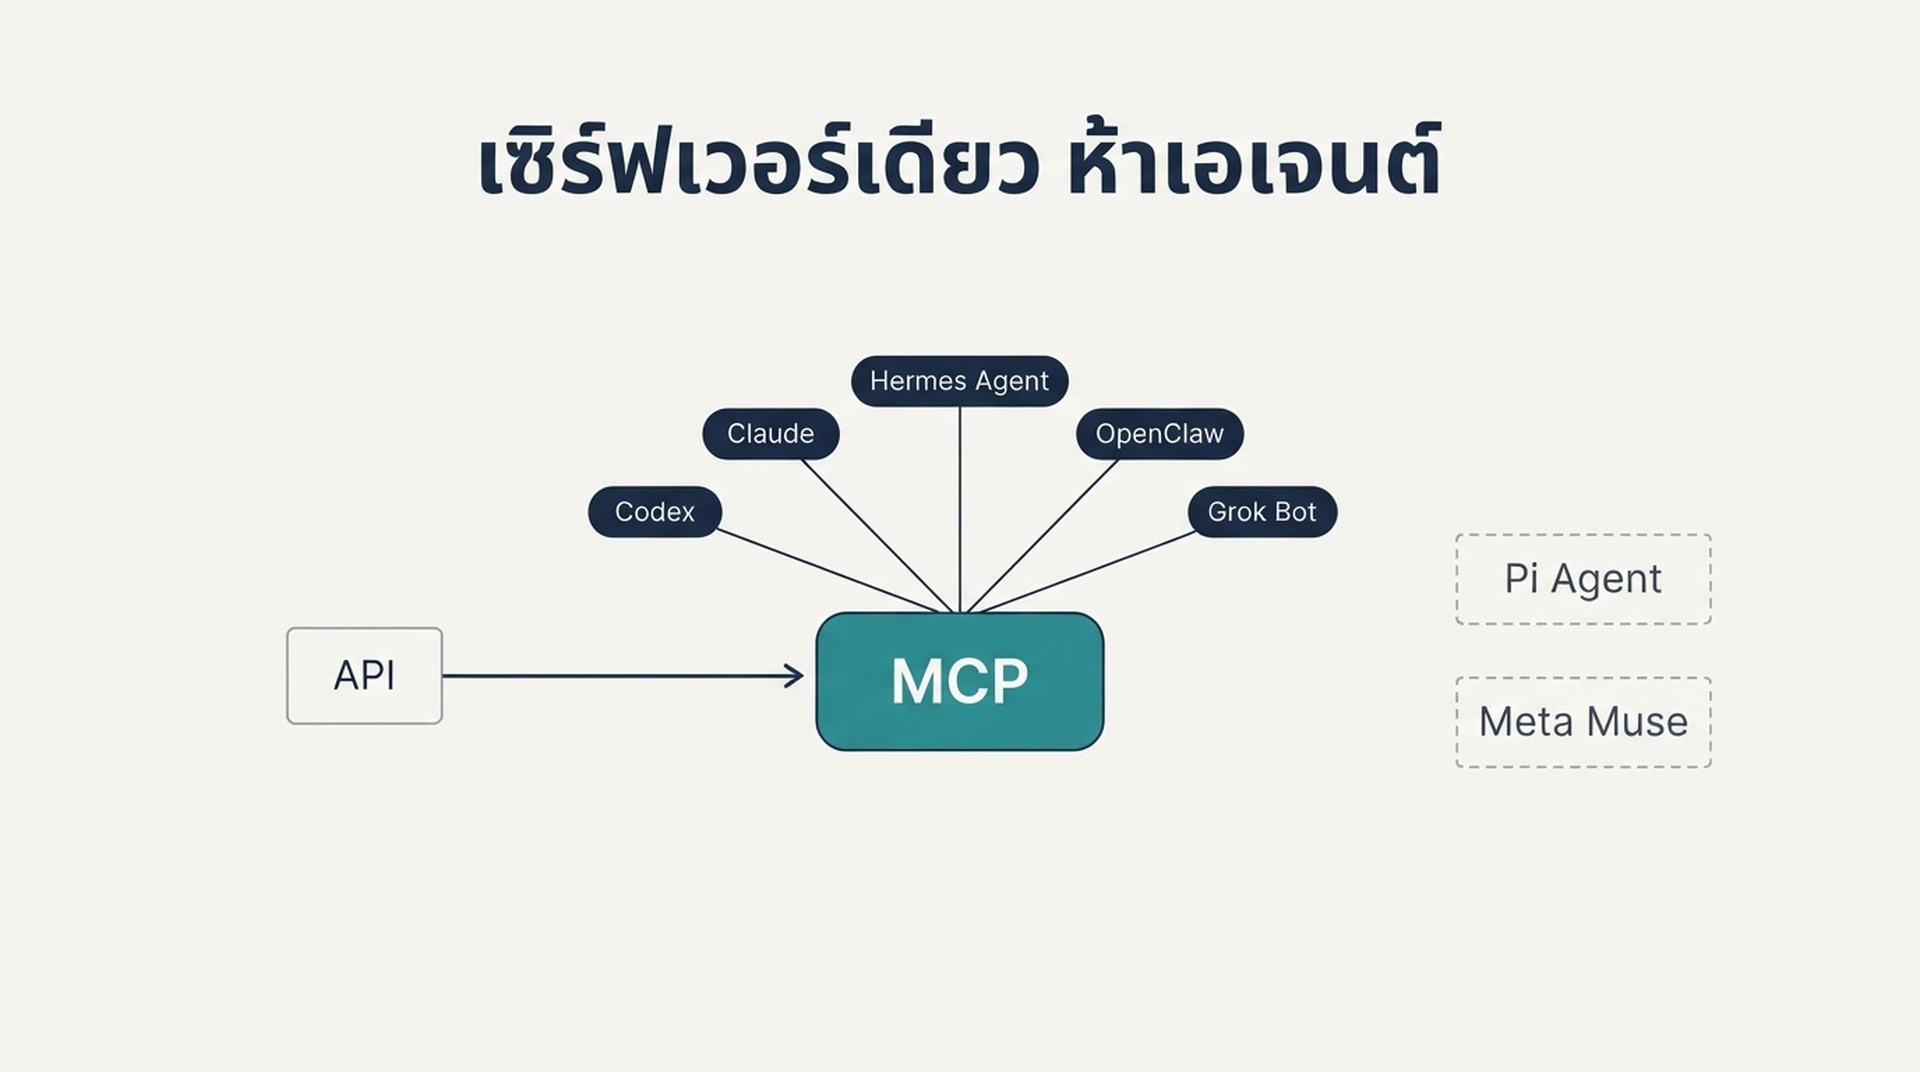
เซิร์ฟเวอร์เดียวครอบคลุมห้าในเจ็ดเอเจนต์ ส่วน Pi Agent และ Meta Muse ต้องใช้เส้นทางอื่น
วิธีเชื่อมต่อแต่ละเอเจนต์
ขั้นตอนด้านล่างสมมติว่าคุณมีคีย์ API หรือโทเคนสำหรับแหล่งที่กำลังเชื่อมต่ออยู่แล้ว อย่าใส่ข้อมูลรับรองในไฟล์ตั้งค่าที่จะถูกคอมมิต
Codex
Codex เก็บการตั้งค่า MCP ไว้ใน config.toml ไม่ที่ ~/.codex/config.toml ก็ระดับโปรเจกต์ที่ .codex/config.toml แอปเดสก์ท็อป ChatGPT, Codex CLI และส่วนขยาย IDE ใช้การตั้งค่านี้ร่วมกัน จึงตั้งครั้งเดียว
สำหรับเซิร์ฟเวอร์ stdio:
codex mcp add my-source --env API_KEY=your-key -- npx -y @your-org/my-source-mcpสำหรับเซิร์ฟเวอร์ streamable HTTP ให้เพิ่มตารางใน config.toml:
[mcp_servers.my-source]
url = "https://mcp.example.com/mcp"
bearer_token_env_var = "MY_SOURCE_TOKEN"
Codex อ่านฟิลด์ instructions ที่ MCP คืนมาตอนเริ่มต้นและใช้เป็นแนวทางระดับเซิร์ฟเวอร์ ถ้าคุณสร้างเซิร์ฟเวอร์ ให้ทำให้ 512 ตัวอักษรแรกสมบูรณ์ในตัวเอง เพื่อให้ข้อจำกัดที่สำคัญที่สุดพร้อมใช้เมื่อเอเจนต์ตัดสินใจว่าจะเรียกหรือไม่
รัน codex mcp list เพื่อยืนยันว่าเซิร์ฟเวอร์ถูกลงทะเบียน และ /mcp ใน TUI เพื่อดูเซิร์ฟเวอร์ที่ใช้งานอยู่
Claude Code
Claude Code รองรับการรับส่ง HTTP ระยะไกล, SSE ระยะไกล, stdio ท้องถิ่น และ WebSocket ระยะไกล HTTP เป็นตัวเลือกที่แนะนำสำหรับเซิร์ฟเวอร์ระยะไกล
claude mcp add --transport http my-source https://mcp.example.com/mcp \
  --header "Authorization: Bearer your-token"
สำหรับเซิร์ฟเวอร์ท้องถิ่น:
claude mcp add my-source -- npx -y @your-org/my-source-mcpมีสองจุดที่คนมักพลาด จุดแรก รายการในการตั้งค่า JSON ที่มี url แต่ไม่มี type จะถูกมองเป็นเซิร์ฟเวอร์ stdio และถูกข้ามไปเงียบ ๆ จึงต้องระบุ "type": "http" ให้ชัดเจน จุดที่สอง Claude Code ตั้งค่า CLAUDE_PROJECT_DIR ในสภาพแวดล้อมของเซิร์ฟเวอร์ที่มันเริ่ม ทำให้เซิร์ฟเวอร์ท้องถิ่นแก้เส้นทางสัมพัทธ์กับโปรเจกต์ได้โดยไม่ต้องพึ่งไดเรกทอรีทำงาน
Hermes Agent
Hermes Agent มาพร้อมการรองรับ MCP ในการติดตั้งมาตรฐาน การตั้งค่าอยู่ที่ ~/.hermes/config.yaml:
mcp_servers:
  my-source:
    command: "npx"
    args: ["-y", "@your-org/my-source-mcp"]
Hermes ยังรองรับเซิร์ฟเวอร์ MCP ระยะไกลผ่าน HTTP ในการตั้งค่าเดียวกัน และรองรับการกรองรายเซิร์ฟเวอร์เพื่อให้คุณเปิดเผยเฉพาะเครื่องมือที่ต้องการให้เอเจนต์เห็น การกรองนี้สำคัญที่นี่มากกว่าเอเจนต์อื่น เพราะ Hermes รันแบบไม่มีคนดูแลตามตารางเวลา
ถ้าคุณย้ายจาก Claude Code คำสั่ง hermes import-agent claude-code จะแมปบล็อก mcpServers จาก ~/.claude.json ไปยัง mcp_servers ในการตั้งค่า Hermes และนำสกิลกับคำแนะนำมาด้วยพร้อมกัน
เมื่อไม่มีเซิร์ฟเวอร์ MCP สำหรับแหล่งใด ระบบสกิลคือทางเลือกสำรอง สกิลคือไดเรกทอรีที่มี SKILL.md บอกเอเจนต์ว่าควรใช้เมื่อไรและทำอะไร ห่อการเรียก API ไว้ในสคริปต์ที่แนบมาแล้วอ้างอิงจากสกิล เอเจนต์ก็ได้ความสามารถโดยไม่ต้องมีเซิร์ฟเวอร์โปรโตคอล
OpenClaw
OpenClaw ทำงานเป็นทั้งไคลเอนต์ MCP และเซิร์ฟเวอร์ MCP ในฐานะไคลเอนต์ คุณจัดการคำจำกัดความเซิร์ฟเวอร์ที่บันทึกไว้ผ่านคำสั่งย่อย mcp registry และแก้ไขหรือตรวจสอบเซิร์ฟเวอร์ได้จากหน้าตั้งค่า Control UI ในเบราว์เซอร์
openclaw mcp registry add my-source --transport streamable-http --url https://mcp.example.com/mcp
openclaw mcp status
OpenClaw ยังเปิดเผยบทสนทนาในช่องทางของตัวเองผ่าน MCP ซึ่งเป็นทิศทางกลับกันและมีประโยชน์ถ้าคุณอยากให้เอเจนต์อื่นอ่านว่า OpenClaw ของคุณทำอะไรไปบ้าง สำหรับเอเจนต์ภายนอกที่ไม่ใช่ไคลเอนต์ MCP OpenClaw พูด A2A บน JSON-RPC
เหตุผลที่เลือก OpenClaw สำหรับงานนี้คือโมเดลสิทธิ์ มันมีนโยบายเครื่องมือรายแชตและเส้นทางอนุมัติการรันที่ชัดเจน ซึ่งเป็นสิ่งที่คุณต้องการเมื่อเอเจนต์อ่านแหล่งข้อมูลแบบเสียเงินและคุณต้องจำกัดว่าใช้จ่ายได้แค่ไหน
Pi Agent
Pi Agent ไม่มีไคลเอนต์ MCP แบบเนทีฟ และนั่นเป็นทางเลือกการออกแบบ ไม่ใช่ช่องโหว่ จุดขยายของมันคือโมดูล TypeScript ที่รันในโปรเซส Pi และลงทะเบียนเครื่องมือ
สร้างส่วนขยายที่ ~/.pi/agent/extensions/my-source.ts:
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.registerTool({
    name: "my_source_lookup",
    description: "Look up a record in My Source by query.",
    parameters: { type: "object", properties: { query: { type: "string" } }, required: ["query"] },
    handler: async ({ query }) => {
      const res = await fetch(`https://api.example.com/search?q=${encodeURIComponent(query)}`, {
        headers: { Authorization: `Bearer ${process.env.MY_SOURCE_TOKEN}` },
      });
      return await res.json();
    },
  });
}
โหลดโดยตรงตอนพัฒนาได้ด้วย pi --extension ./my-source.ts แล้วย้ายไปยังไดเรกทอรีส่วนขยายหรือแพ็กด้วย pi install เมื่อมันเสถียร
ข้อแลกเปลี่ยนเป็นเรื่องจริงและควรพูดตรง ๆ ส่วนขยายรันด้วยสิทธิ์ระบบปฏิบัติการเดียวกับโปรเซส Pi และตรวจสอบพรอมป์ต การเรียกเครื่องมือ ไฟล์ และข้อมูลรับรองได้ โหลดส่วนขยายจากแหล่งที่คุณเชื่อถือเท่านั้น และอ่านซอร์สก่อนติดตั้ง
Grok Bot
API ของ Grok รองรับเครื่องมือ MCP ระยะไกล และ xAI จัดการการเชื่อมต่อเซิร์ฟเวอร์ให้คุณ คุณประกาศเซิร์ฟเวอร์ในอาร์เรย์ tools ของคำขอ:
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import mcp

client = Client(api_key=os.getenv("XAI_API_KEY"))
chat = client.chat.create(
    model="grok-4.7",
    tools=[mcp(server_url="https://mcp.example.com/mcp", server_label="my-source")],
)
เครื่องมือ MCP ระยะไกลรองรับเฉพาะการรับส่ง streaming HTTP และ SSE คุณจำกัดเครื่องมือที่จะเปิดเผยได้ด้วย allowed_tools และส่งโทเคนอนุญาตที่ xAI ตั้งในหัวข้อ Authorization เมื่อเรียกไปยังเซิร์ฟเวอร์ของคุณ
ข้อดีคือคุณไม่ต้องรันหรือดูแลการเชื่อมต่อฝั่งไคลเอนต์ ข้อเสียคือเซิร์ฟเวอร์ MCP ต้องเข้าถึงได้จากสาธารณะ สิ่งที่อยู่หลัง VPN จึงต้องใช้วิธีอื่น
Meta Muse
Muse เชื่อมต่อแอปและบริการของบุคคลที่สามผ่านคอนเนกเตอร์ และตัวเอเจนต์เองไม่มีพื้นผิว MCP หรือ API สำหรับนักพัฒนาแบบสาธารณะ นี่คือคำตอบที่ตรงไปตรงมา และมันเปลี่ยนสิ่งที่คุณทำได้
คุณเชื่อม Muse เข้ากับเวิร์กโฟลว์การติดตามเหมือนเอเจนต์อีกหกตัวไม่ได้ สิ่งที่ทำได้คือทำให้แหล่งที่ Muse อ่านดีขึ้น นั่นหมายถึงข้อมูลสินค้าและแค็ตตาล็อกที่ถูกต้องถ้าคุณขายสินค้า ข้อมูลธุรกิจที่ครบถ้วนและสอดคล้องถ้าคุณเป็นธุรกิจท้องถิ่น และหน้าที่ถูกครอวล์ได้พร้อมสัญญาณเอนทิตีชัดเจนถ้าคุณเป็นสำนักพิมพ์ Muse เป็นเป้าหมายของงานเตรียมความพร้อม ไม่ใช่แหล่งข้อมูลที่คุณค้นหา
ถ้า Meta เปิดพื้นผิวสำหรับนักพัฒนาสำหรับ Muse ส่วนนี้จะเปลี่ยน จนถึงตอนนั้น มองมันเป็นกลุ่มเป้าหมายที่ต้องเตรียมตัว ไม่ใช่ระบบที่ต้องผสานรวม
สร้างเซิร์ฟเวอร์หนึ่งตัว ใช้ซ้ำห้าครั้ง
ถ้าคุณจะสร้างอะไรสักอย่าง ให้สร้างเซิร์ฟเวอร์ MCP สำหรับแหล่งที่มีค่าสูงสุดของคุณแล้วใช้ซ้ำ เอเจนต์ห้าตัวที่รองรับ MCP ข้างต้นรับเซิร์ฟเวอร์ streamable HTTP ทั้งหมด การดีพลอยครั้งเดียวจึงครอบคลุมทั้งหมด
เซิร์ฟเวอร์ขั้นต่ำต้องการสี่อย่าง เครื่องมือที่รับคำค้นและคืนข้อมูลแบบมีโครงสร้าง การตรวจสอบโทเคน bearer ฝั่งเซิร์ฟเวอร์ การจำกัดอัตราเพื่อไม่ให้เอเจนต์ที่หลุดควบคุมเผาผลาญโควตา API ของคุณ และฟิลด์ instructions ที่ระบุข้อจำกัดใน 512 ตัวอักษรแรก
สองกฎที่กันความเจ็บปวดส่วนใหญ่ได้ คืนข้อมูลแบบมีโครงสร้างไม่ใช่ร้อยแก้ว เพื่อให้เอเจนต์ใช้เหตุผลกับฟิลด์แทนที่จะแยกวิเคราะห์ข้อความใหม่ และทำให้ทุกเครื่องมืออ่านได้อย่างเดียวจนกว่าคุณจะเห็นเอเจนต์ใช้ครบหนึ่งรอบ เซิร์ฟเวอร์ที่อ่านได้อย่างเดียวทำอะไรเสียหายไม่ได้ และคุณขยายมันได้หลังจากเห็นรูปแบบการเรียกจริง
ตรวจสอบการเชื่อมต่อก่อนเชื่อ
อย่าสมมติว่าเซิร์ฟเวอร์ที่ตั้งค่าไว้คือเซิร์ฟเวอร์ที่ทำงานได้ รันการตรวจสอบสี่ข้อนี้
ตรวจว่าเซิร์ฟเวอร์ถูกลงทะเบียน codex mcp list, claude mcp list หรือ openclaw mcp status ควรแสดงมัน เซิร์ฟเวอร์ที่แยกวิเคราะห์ไม่ผ่านจะถูกข้ามไปเงียบ ๆ ในไคลเอนต์บางตัว
ตรวจรายการเครื่องมือ ขอให้เอเจนต์ระบุเครื่องมือที่เซิร์ฟเวอร์เปิดเผย ถ้าคุณคาดหกแต่เห็นหนึ่ง แปลว่าเซิร์ฟเวอร์ลงทะเบียนแล้วแต่เครื่องมือยังไม่
ตรวจด้วยคำค้นจริง ขอระเบียนเฉพาะที่คุณตรวจสอบด้วยมือได้ คำถามกว้าง ๆ อย่าง "คุณดึงข้อมูลอะไรได้บ้าง" พิสูจน์อะไรไม่ได้
ตรวจเส้นทางล้มเหลว เพิกถอนโทเคนแล้วรันคำค้นอีกครั้ง สิ่งที่ต้องการคือข้อผิดพลาดการยืนยันตัวตนที่ชัดเจน ไม่ใช่ผลลัพธ์ว่างเปล่าแบบเงียบ ๆ เอเจนต์ที่มองการเรียกที่ล้มเหลวเป็น "ไม่มีข้อมูล" จะรายงานผลลัพธ์สะอาดสำหรับการเชื่อมต่อที่ขาด และนั่นคือโหมดล้มเหลวที่แพงที่สุดในเวิร์กโฟลว์ทั้งหมดนี้
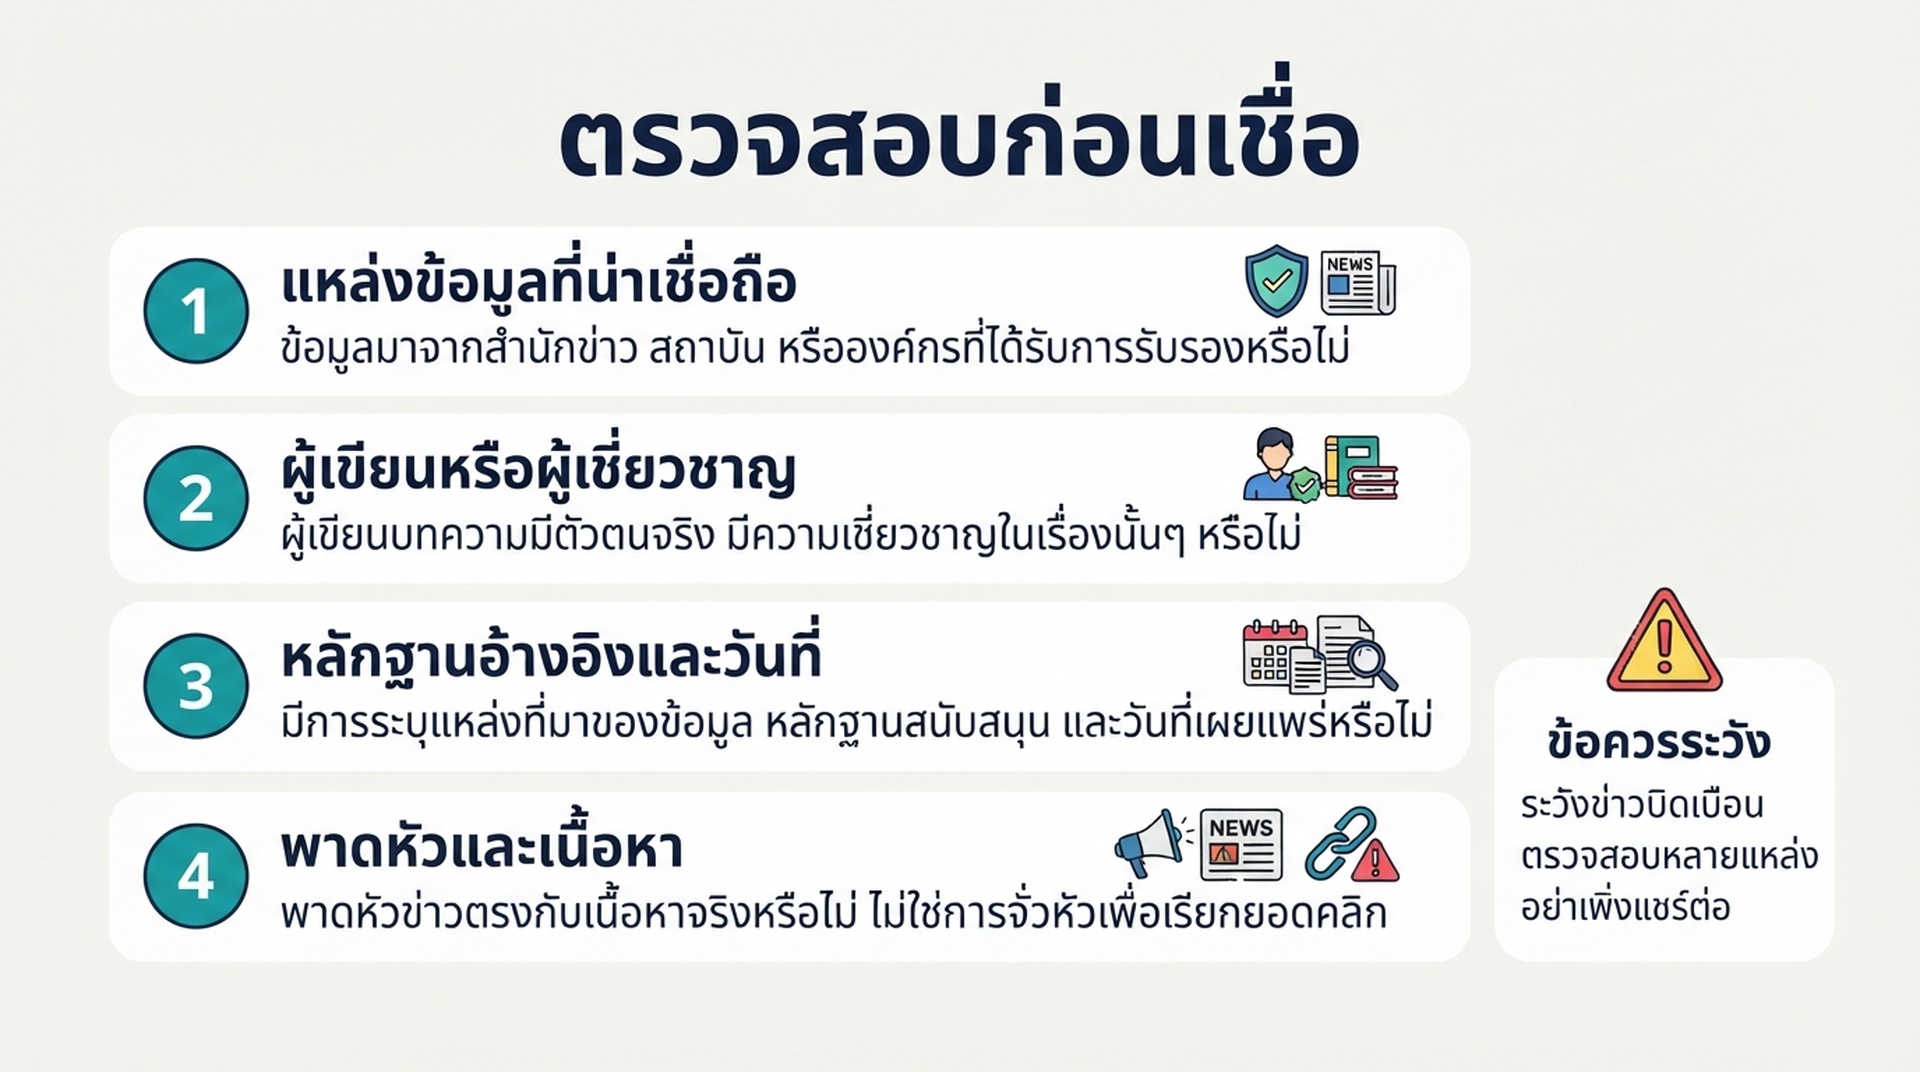
สี่การตรวจสอบ ข้อสุดท้ายจับความล้มเหลวที่ดูเหมือนเป็นข้อค้นพบ
สิ่งนี้เปลี่ยนลำดับความสำคัญของคุณอย่างไร
ตารางชั้นและตารางการเชื่อมต่อชี้ไปทางเดียวกัน แหล่งที่คุณเชื่อมกับเอเจนต์ได้คือแหล่งที่คุณวัดได้ และแหล่งที่คุณวัดได้คือแหล่งที่คุณปรับปรุงเทียบกับเส้นฐานได้
นั่นหมายความว่าลำดับงานไม่ใช่ลำดับที่ทีมส่วนใหญ่ใช้ เริ่มจากแหล่งที่มีทั้งการเชื่อมต่อที่มีเอกสารและผลกระทบทางธุรกิจจริงต่อคุณ สำหรับธุรกิจท้องถิ่นนั่นคือ Google Business Profile และ grounding กับ Maps สำหรับบริษัทสินค้าคือ Merchant Center หรือฟีดสินค้า สำหรับบริษัทเครื่องมือสำหรับนักพัฒนาคือคุณภาพเอกสาร สำหรับสำนักพิมพ์คือความสามารถในการถูกครอวล์และดึงข้อมูลของหน้าสด
จากนั้นสร้างเซิร์ฟเวอร์ MCP ตัวเดียวที่นำแหล่งนั้นเข้าเอเจนต์ของคุณ และใช้ซ้ำในเอเจนต์ห้าตัวที่พูดโปรโตคอลนี้ ปล่อยแหล่งที่ไม่มีเส้นทางเชื่อมต่อไว้เป็นงานเนื้อหาและเอนทิตี และยอมรับอย่างตรงไปตรงมาว่าคุณวัดมันแบบเดียวกันไม่ได้
ทีมที่ได้เปรียบตรงนี้ไม่ใช่ทีมที่มีรายการแหล่งข้อมูลยาวที่สุด แต่เป็นทีมที่เชื่อมแหล่งสำคัญสองสามแหล่งและสร้างวงจรการติดตามรอบมัน
คำถามที่พบบ่อย
ต้องใช้ MCP เพื่อให้เอเจนต์เข้าถึงแหล่งข้อมูลไหม ไม่ MCP เป็นมาตรฐานที่เอเจนต์ส่วนใหญ่รองรับตอนนี้ ทำให้เป็นตัวเลือกที่นำกลับมาใช้ซ้ำได้มากที่สุด แต่สกิลที่มีสคริปต์ API แนบมาก็ใช้ได้ดีพอ ๆ กันกับเอเจนต์ตัวเดียว ถ้าคุณเชื่อมแหล่งหนึ่งกับเอเจนต์หนึ่ง สกิลใช้แรงน้อยกว่า ถ้าเชื่อมแหล่งหนึ่งกับห้าเอเจนต์ MCP คืนทุนทันที
ควรเริ่มจากเอเจนต์ตัวไหน เริ่มจากตัวที่ตรงกับที่ที่งานของคุณอยู่แล้ว ถ้าเว็บไซต์อยู่ในรีโพ git เลือก Codex หรือ Claude Code ถ้าต้องการรันตามตารางพร้อมหน่วยความจำถาวร เลือก Hermes Agent ถ้าต้องการขอบเขตสิทธิ์ที่เข้มงวดกับแหล่งข้อมูลแบบเสียเงิน เลือก OpenClaw ถ้าต้องการพื้นผิวเล็กที่สุดที่ตรวจสอบได้ในนั่งเดียว เลือก Pi Agent
เชื่อมแหล่งที่ไม่มีเซิร์ฟเวอร์ MCP ได้ไหม ได้ สามวิธี เขียนเซิร์ฟเวอร์ MCP บาง ๆ ถ้าแหล่งมี HTTP API และคุณอยากใช้ซ้ำในหลายเอเจนต์ เขียนสกิลที่มีสคริปต์แนบมาถ้าต้องการแค่เอเจนต์เดียว หรือใช้เอเจนต์ที่รองรับเครื่องมือ MCP ระยะไกลแล้วชี้ไปยังเซิร์ฟเวอร์ที่คนอื่นโฮสต์
ทำไมเชื่อม Meta Muse ไม่ได้ Meta ยังไม่เปิด API สำหรับนักพัฒนาหรือพื้นผิว MCP สำหรับ Muse คอนเนกเตอร์ถูกจัดการโดยผู้ให้บริการ จนกว่าจะเปลี่ยน Muse เป็นพื้นผิวที่ต้องเตรียมเนื้อหาและข้อมูลให้ ไม่ใช่ระบบที่คุณค้นหา
การจัดชั้นเป็นเรื่องถาวรไหม ไม่ หมวดนี้เปลี่ยนทุกเดือน ตรวจเอกสารผู้ให้บริการซ้ำก่อนผูกทีมเข้ากับเวิร์กโฟลว์ และมองการจัดชั้นที่เก่ากว่าหนึ่งไตรมาสเป็นยังไม่ยืนยัน
ข้อผิดพลาดที่พบบ่อยที่สุดในงานนี้คืออะไร การมองการเรียก API ที่ล้มเหลวเป็นศูนย์จริง ถ้าเอเจนต์รายงานว่าแบรนด์ไม่มีการปรากฏใน AI และสาเหตุรากคือโทเคนหมดอายุ คุณกำลังเจอความล้มเหลวในการวัดที่ปลอมเป็นข้อค้นพบ ทดสอบเส้นทางล้มเหลวเสมอก่อนเชื่อเส้นทางสำเร็จ
Author: Julian Mercer ผู้ปฏิบัติงาน SEO เชิงเทคนิคประสบการณ์ 14 ปีที่ Auspia เขียนเกี่ยวกับความสามารถในการถูกครอวล์ สกีมา การเรนเดอร์ และพื้นฐานทางเทคนิคที่ทำให้เนื้อหาอ่านได้ทั้งโดยเครื่องมือค้นหาและเอเจนต์ AI