Większość zespołów śledzących widoczność w AI nadal pracuje na zrzucie ekranu. Zadają ChatGPT pytanie, kopiują cytowania i wklejają je do dokumentu. To mówi, co jeden model powiedział pewnego popołudnia. Nie mówi, do jakich źródeł silnik odpowiedzi faktycznie dociera, i nie daje Twojemu agentowi niczego, o co mógłby zapytać samodzielnie.
Użyteczniejsza wersja tej pracy to mapa źródeł plus ścieżka połączenia. Decydujesz, które źródła danych mają znaczenie w Twojej kategorii, a potem podłączasz te, do których możesz dotrzeć, bezpośrednio do agenta, który prowadzi monitoring. Zostaje krótka lista źródeł, na które możesz wpływać tylko pośrednio, i ta lista jest zwykle krótsza, niż się wydaje.
Ten artykuł robi trzy rzeczy. Porządkuje źródła danych stojące za odpowiedziami AI w poziomy według tego, jak potwierdzone i jak aktualne są dowody. Podaje konkretną ścieżkę API lub MCP dla tych, które ją mają. I przechodzi przez sposób połączenia dla Codex, Claude Code, Hermes Agent, OpenClaw, Pi Agent, Grok Bot i Meta Muse, w tym przez przypadki, w których nie ma gotowego konektora i most trzeba zbudować samemu.
Krótka odpowiedź
Cztery kategorie źródeł zasilają odpowiedzi AI i nie są równie dostępne.
Źródła webowe i wyszukiwawcze są dostępne przez API ugruntowania (grounding) oraz przez Twoje własne indeksowalne strony. Strukturyzowane komercyjne feedy są dostępne przez udokumentowane specyfikacje feedów, ale dostęp jest ograniczony zatwierdzeniem. Korpusy wiedzy i społeczności są częściowo dostępne przez licencjonowane API, a częściowo zamknięte za wchłanianiem w czasie treningu, na które nie masz wpływu. Powierzchnie działań agentów są dostępne przez specyfikacje protokołów, które wciąż się krystalizują.
W praktyce monitoringu prowadzonego przez agenta przekłada się to na prostą zasadę. Podłączaj to, co ma udokumentowane API lub serwer MCP. To, co ma specyfikację feedu, traktuj jako projekt jakości danych. To, co nie ma ani jednego, ani drugiego, traktuj jako projekt treści i encji, a nie projekt danych.
Jak czytać tabelę poziomów
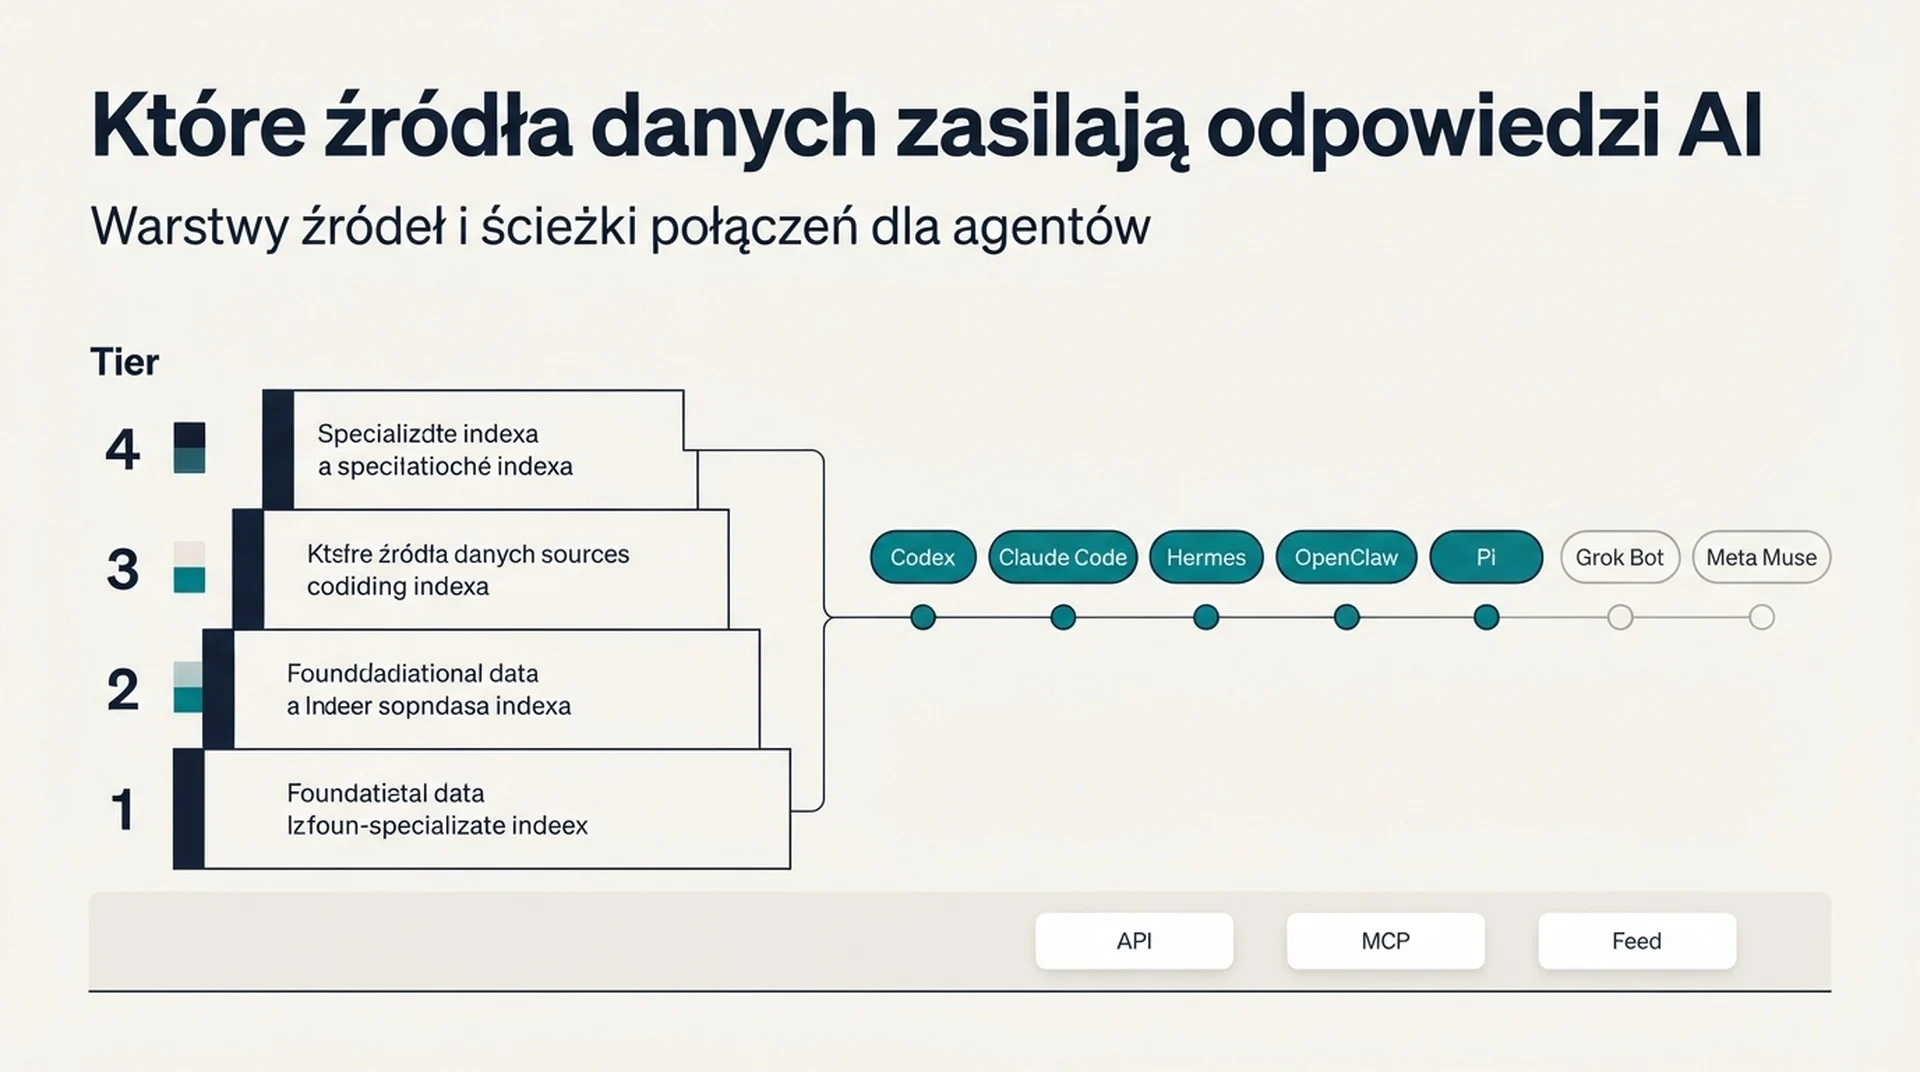
Poniższe poziomy porządkują źródła według tego, jak mocne są dowody, że obecnie zasilają odpowiedzi AI, oraz według tego, czy to połączenie jest żywe, czy historyczne. To jest właśnie miejsce, w którym większość list źródeł się myli. Źródło, które ukształtowało model w 2022 roku, i źródło, o które model pyta dziś, to dwie różne rzeczy, a ich mieszanie daje złą strategię.
Poziom | Znaczenie | Co to oznacza dla Twojego procesu |
|---|---|---|
1 | Potwierdzone i aktualne | Żywe ugruntowanie, wyszukiwanie lub działania. Podłącz, monitoruj, optymalizuj pod to. |
2 | Potwierdzone i aktualne | Trening lub licencjonowanie. Możesz wpływać przez treści i partnerstwa, nie przez API. |
3 | Potwierdzone historycznie | Wyłącznie pretrening. Brak żywej dźwigni. Nie buduj wokół tego procesu monitoringu. |
4 | Mocne dowody, niepotwierdzone | Wnioskowanie kategorii. Warto obserwować, nie warto jeszcze planować budżetu. |
Jedno zastrzeżenie przed tabelą. Ta kategoria zmienia się co miesiąc. Dokumentacja dostawców, umowy licencyjne i specyfikacje feedów ciągle się zmieniają. Traktuj przypisania poziomów jako punkt wyjścia, który weryfikujesz ponownie w dokumentacji dostawcy, zanim zobowiążesz zespół do procesu.
Poziom 1: żywe źródła, do których Twój agent naprawdę dociera
To źródła, w których udokumentowane połączenie istnieje dziś. Jeśli Twój agent ma samodzielnie pobierać dane o widoczności w AI, to tutaj zaczyna.
Web i wyszukiwanie
Ugruntowanie Google Search. API Gemini udostępnia narzędzie google_search, które łączy model z treścią webową w czasie rzeczywistym i zwraca cytowania do źródłowych adresów URL. Jest to udokumentowane, aktualne i najczystszy przykład żywego ugruntowania na rynku. Oznacza to też, że dźwignią jest Twoja indeksowalność i struktura strony, a nie feed.
Bing Search. Microsoft dokumentuje, że wyniki Bing są używane do wzbogacania odpowiedzi Copilota. Praktyczna konsekwencja jest taka sama jak w Google: jeśli chcesz się pojawić, strona musi być osiągalna i możliwa do wyodrębnienia treści.
Żywe strony wydawców. Osiągane w czasie wnioskowania przez ugruntowanie wyszukiwania, a nie przez pretrening. O wyborze do pobrania decyduje selekcja i indeksowalność, dlatego techniczne SEO nadal przekłada się na wyniki widoczności w AI.
Produkty i zakupy
Google Merchant Center. Dane z feedu Merchant zasilają powierzchnie zakupowe Google. Jeśli sprzedajesz produkty fizyczne i nie ma Cię w Merchant Center, jesteś nieobecny na powierzchni, która jest aktywnie podłączana do odpowiedzi AI.
Feedy handlowe i detaliczne OpenAI. Sprzedawcy udostępniają strukturyzowany feed produktowy, a dokumentacja Agentic Commerce Protocol opisuje schemat, ścieżki integracji przez upload pliku i API oraz cykl odświeżania, który przyjmuje aktualizacje przez cały dzień. Dostęp jest obecnie ograniczony do zatwierdzonych partnerów, więc to projekt z czasem oczekiwania, a nie przełącznik, który się przestawia.
Lokalne i miejsca
Ugruntowanie Google Maps. Udokumentowane jako narzędzie obok ugruntowania Search, dające modelom kontekst geoprzestrzenny. Dlatego lokalne firmy z dokładnymi, kompletnymi profilami pojawiają się w odpowiedziach AI o opcjach w pobliżu.
Google Business Profile. Dane profilu firmy zasilają lokalne powierzchnie Google. Dla lokalnych firm to jedno z najbardziej dźwigniowych i najmniej pracochłonnych źródeł na liście.
Yelp. Yelp licencjonuje opinie, zdjęcia i informacje o firmach na potrzeby rekomendacji lokalnych w czasie rzeczywistym, a relacja wykracza poza ugruntowanie w stronę działań. To jedno z niewielu źródeł, w których platforma z opiniami jest jednocześnie źródłem cytowań i powierzchnią transakcyjną.
Wiedza i źródła referencyjne
Wikipedia i Wikimedia. Obecne w ujawnionych mieszankach pretreningowych i szeroko używane jako żywy korpus referencyjny. Licencjonowanie jest wyjątkowo jasne, co czyni je uzasadnionym celem pracy nad encjami.
Społeczność, pytania i odpowiedzi oraz media społecznościowe
Reddit. Żywe źródło ugruntowania na podstawie umowy licencyjnej na dane, przy czym strona treningowa jest raportowana osobno. Traktuj status odnowienia jako niestabilny i nie buduj procesu, który zakłada stały dostęp.
Poziomy 2 i 3: źródła, na które wpływasz, a o które nie pytasz
Mają znaczenie, ale nie przez API, które możesz wywołać z agenta.
Licencjonowane treści wydawców. Istnieje wiele wyraźnych partnerstw licencyjnych z dużymi wydawcami, a warunki różnią się między partnerami w zakresie treningu, ugruntowania i atrybucji. Jako mały serwis nie możesz kupić sobie miejsca na tej liście, ale możesz być tym rodzajem źródła, które jest cytowane, gdy licencjonowany korpus jest ubogi w Twoim temacie.
Źródła deweloperskie i techniczne. Publiczne repozytoria kodu i korpusy dokumentacji technicznej to potwierdzone aktualne źródła. Dla firm tworzących narzędzia deweloperskie to poziom o najwyższej wartości na liście, osiągalny przez jakość dokumentacji, a nie przez feed.
Historyczne korpusy webowe. Oczyszczone pochodne danych Common Crawl i podobnych archiwów. Potwierdzone historycznie, bez żywej dźwigni. Przydatny kontekst do zrozumienia, dlaczego model ma jakiś prior, ale nieprzydatny w procesie monitoringu.
Warstwa połączeń: do czego dociera każdy agent
Tutaj artykuł zarabia na siebie. Poniższa tabela mapuje każdego agenta na mechanizm połączenia, który faktycznie obsługuje, oraz na uczciwy stan gotowych konektorów do powyższych źródeł.
Agent | Mechanizm połączenia | Gotowe konektory źródeł | Co budujesz |
|---|---|---|---|
Codex | MCP przez stdio i streamable HTTP, konfigurowane w | Rosnące repozytorium społecznościowych serwerów MCP | Cienki serwer MCP dla każdego źródła z HTTP API |
Claude Code | MCP przez HTTP, SSE, stdio i WebSocket | Katalog konektorów Anthropic plus serwery społecznościowe | Ten sam serwer, dodany przez |
Hermes Agent | MCP z filtrowaniem narzędzi na poziomie serwera plus natywne umiejętności | Wyselekcjonowany katalog MCP z instalacją jednym kliknięciem | Umiejętność opakowująca API, gdy nie ma MCP |
OpenClaw | Klient i serwer MCP plus A2A JSON-RPC | Rejestr MCP OpenClaw i zapisane definicje serwerów | Zapisana definicja MCP lub most A2A |
Pi Agent | Rozszerzenia i umiejętności w TypeScript, bez natywnego klienta MCP | Domyślnie brak | Niewielkie rozszerzenie wywołujące API jako narzędzie |
Grok Bot | Zdalne narzędzia MCP deklarowane w żądaniu API | Dowolny zdalny serwer MCP, na który go wskażesz | Zdalny serwer MCP, ponieważ Grok zarządza połączeniem |
Meta Muse | Konektory, bez publicznego MCP lub API | Wyłącznie konektory zarządzane przez dostawcę | Tylko praca pośrednia: feedy, dane encji i indeksowalne strony |
Wzorzec, który warto zauważyć: pięć z siedmiu agentów mówi po MCP, a te dwa, które nie mówią, są na przeciwnych końcach spektrum. Pi Agent jest celowo minimalistyczny i oczekuje, że napiszesz rozszerzenie. Meta Muse to produkt konsumencki bez żadnej powierzchni deweloperskiej.
Oznacza to, że efektywnym ruchem jest zbudowanie jednego serwera MCP dla źródła o najwyższej wartości i ponowne użycie go w Codex, Claude Code, Hermes Agent, OpenClaw i Grok Bot. Piszesz go raz.
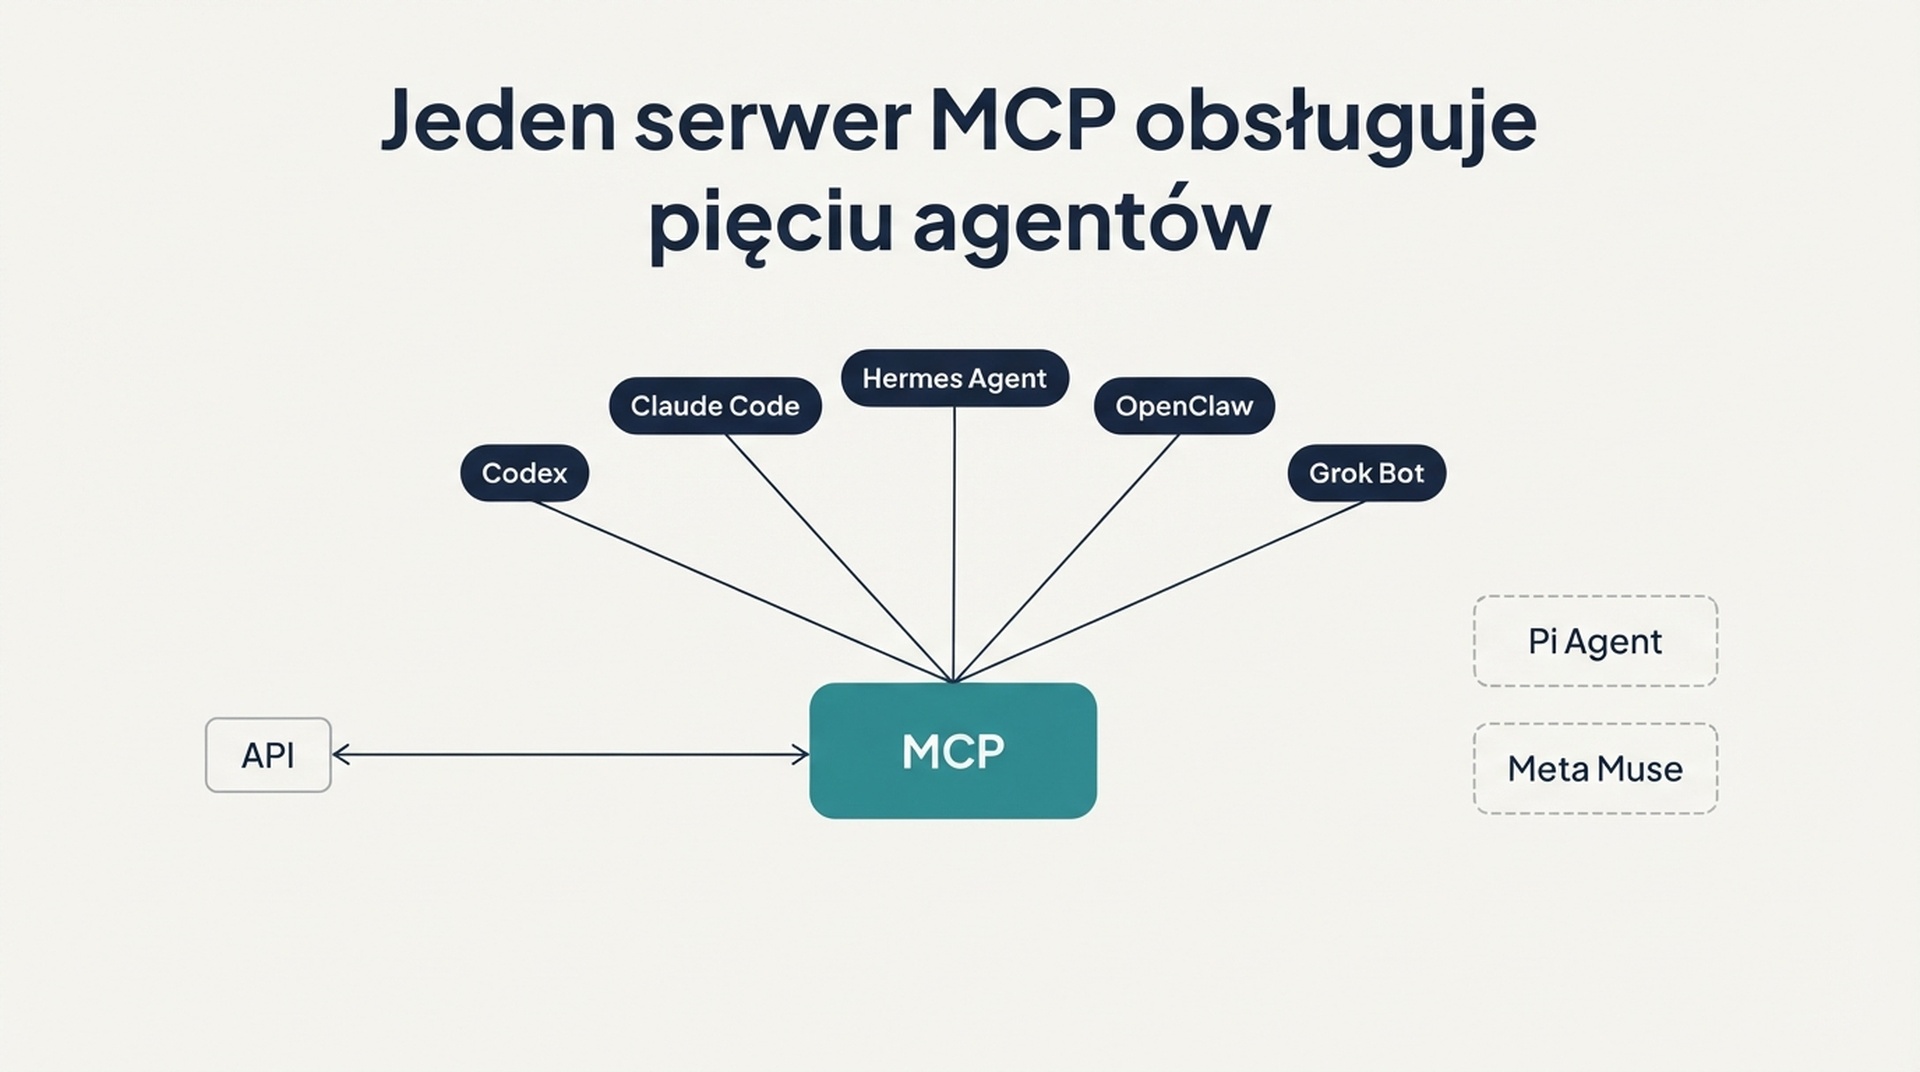
Jeden serwer obsługuje pięciu z siedmiu agentów. Pi Agent i Meta Muse potrzebują innych ścieżek.
Jak podłączyć każdego agenta
Poniższe kroki zakładają, że masz już klucz API lub token do źródła, które podłączasz. Nigdy nie umieszczaj danych uwierzytelniających w pliku konfiguracyjnym, który trafia do repozytorium.
Codex
Codex przechowuje konfigurację MCP w config.toml, albo w ~/.codex/config.toml, albo w zakresie projektu w .codex/config.toml. Aplikacja desktopowa ChatGPT, CLI Codex i rozszerzenie do IDE współdzielą tę konfigurację, więc konfigurujesz ją raz.
Dla serwera stdio:
codex mcp add my-source --env API_KEY=your-key -- npx -y @your-org/my-source-mcpDla serwera streamable HTTP dodaj tabelę do config.toml:
[mcp_servers.my-source]
url = "https://mcp.example.com/mcp"
bearer_token_env_var = "MY_SOURCE_TOKEN"
Codex czyta pole instructions MCP zwracane przy inicjalizacji i używa go jako wskazówek dla całego serwera. Jeśli budujesz serwer, zadbaj, by pierwsze 512 znaków było samowystarczalne, żeby najważniejsze ograniczenia były dostępne, gdy agent decyduje, czy go wywołać.
Uruchom codex mcp list, aby potwierdzić, że serwer się zarejestrował, oraz /mcp w TUI, aby zobaczyć aktywne serwery.
Claude Code
Claude Code obsługuje zdalne HTTP, zdalne SSE, lokalne stdio i zdalne WebSocket. HTTP to zalecana opcja dla zdalnych serwerów.
claude mcp add --transport http my-source https://mcp.example.com/mcp \
  --header "Authorization: Bearer your-token"
Dla serwera lokalnego:
claude mcp add my-source -- npx -y @your-org/my-source-mcpDwa szczegóły, na których ludzie się potykają. Po pierwsze, w konfiguracji JSON wpis z url, ale bez type, jest traktowany jako serwer stdio i po cichu pomijany, więc zawsze ustawiaj "type": "http" jawnie. Po drugie, Claude Code ustawia CLAUDE_PROJECT_DIR w środowisku uruchamianego serwera, więc lokalny serwer może rozwiązywać ścieżki względne wobec projektu bez zależności od katalogu roboczego.
Hermes Agent
Hermes Agent jest dostarczany ze wsparciem MCP w standardowej instalacji. Konfiguracja znajduje się w ~/.hermes/config.yaml:
mcp_servers:
  my-source:
    command: "npx"
    args: ["-y", "@your-org/my-source-mcp"]
Hermes obsługuje też zdalne serwery MCP po HTTP w tej samej konfiguracji oraz filtrowanie na poziomie serwera, dzięki czemu wystawiasz tylko te narzędzia, które faktycznie chcesz pokazać agentowi. To filtrowanie ma tu większe znaczenie niż u innych agentów, bo Hermes działa bez nadzoru, według harmonogramu.
Jeśli migrujesz z Claude Code, hermes import-agent claude-code mapuje blok mcpServers z ~/.claude.json na mcp_servers w konfiguracji Hermesa i przenosi jednocześnie umiejętności oraz instrukcje.
Gdy dla danego źródła nie istnieje serwer MCP, system umiejętności jest rozwiązaniem zapasowym. Umiejętność to katalog z plikiem SKILL.md, który mówi agentowi, kiedy jej użyć i co ma zrobić. Opakuj wywołanie API w dołączony skrypt i odwołaj się do niego z umiejętności, a agent zyska możliwość bez serwera protokołu.
OpenClaw
OpenClaw działa zarówno jako klient MCP, jak i serwer MCP. Jako klient zarządzasz zapisanymi definicjami serwerów przez podpolecenia mcp registry, a serwery możesz edytować i przeglądać na stronie ustawień Control UI w przeglądarce.
openclaw mcp registry add my-source --transport streamable-http --url https://mcp.example.com/mcp
openclaw mcp status
OpenClaw wystawia też własne rozmowy kanałowe przez MCP, co jest kierunkiem odwrotnym i przydaje się, gdy chcesz, by inny agent przeczytał, co robiła Twoja instancja OpenClaw. Dla zewnętrznych agentów, które nie są klientami MCP, OpenClaw mówi po A2A przez JSON-RPC.
Model uprawnień to powód, by wybrać OpenClaw do tej pracy. Ma politykę narzędzi na czat i wyraźną ścieżkę zatwierdzania wykonania, czego chcesz, gdy agent czyta płatne źródło danych i musisz ograniczyć, ile może wydać.
Pi Agent
Pi Agent nie ma natywnego klienta MCP i jest to wybór projektowy, a nie luka. Jego punktem rozszerzenia są moduły TypeScript, które działają wewnątrz procesu Pi i rejestrują narzędzia.
Utwórz rozszerzenie w ~/.pi/agent/extensions/my-source.ts:
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.registerTool({
    name: "my_source_lookup",
    description: "Look up a record in My Source by query.",
    parameters: { type: "object", properties: { query: { type: "string" } }, required: ["query"] },
    handler: async ({ query }) => {
      const res = await fetch(`https://api.example.com/search?q=${encodeURIComponent(query)}`, {
        headers: { Authorization: `Bearer ${process.env.MY_SOURCE_TOKEN}` },
      });
      return await res.json();
    },
  });
}
Ładuj je bezpośrednio w czasie tworzenia przez pi --extension ./my-source.ts, a potem przenieś do katalogu rozszerzeń albo spakuj przez pi install, gdy będzie stabilne.
Kompromis jest realny i warto go powiedzieć wprost. Rozszerzenie działa z tymi samymi uprawnieniami systemowymi co proces Pi i może odczytywać prompty, wywołania narzędzi, pliki i dane uwierzytelniające. Ładuj rozszerzenia tylko ze źródeł, którym ufasz, i przeczytaj kod źródłowy, zanim je zainstalujesz.
Grok Bot
API Groka obsługuje zdalne narzędzia MCP, a xAI zarządza połączeniem z serwerem w Twoim imieniu. Deklarujesz serwer w tablicy tools żądania:
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import mcp

client = Client(api_key=os.getenv("XAI_API_KEY"))
chat = client.chat.create(
    model="grok-4.7",
    tools=[mcp(server_url="https://mcp.example.com/mcp", server_label="my-source")],
)
Dla zdalnych narzędzi MCP obsługiwane są tylko transporty streaming HTTP i SSE. Możesz ograniczyć, które narzędzia są wystawiane, przez allowed_tools, i przekazać token autoryzacyjny, który xAI ustawia w nagłówku Authorization w żądaniach do Twojego serwera.
Zaletą jest to, że nie uruchamiasz ani nie utrzymujesz połączenia po stronie klienta. Wadą jest to, że serwer MCP musi być publicznie osiągalny, więc wszystko za Twoim VPN wymaga innego podejścia.
Meta Muse
Muse łączy się z aplikacjami i usługami zewnętrznymi przez Konektory, a dla samego agenta nie ma publicznego MCP ani powierzchni API dla deweloperów. To jest uczciwa odpowiedź i zmienia to, co możesz zrobić.
Nie możesz podłączyć Muse do procesu monitoringu tak, jak pozostałych sześciu agentów. Możesz natomiast poprawić źródła, które Muse czyta. To znaczy: dokładne dane produktowe i katalogowe, jeśli sprzedajesz; kompletne i spójne informacje o firmie, jeśli działasz lokalnie; oraz indeksowalne strony z jasnymi sygnałami encji, jeśli jesteś wydawcą. Muse to cel pracy nad gotowością, a nie źródło danych, o które pytasz.
Jeśli Meta udostępni powierzchnię deweloperską dla Muse, ta sekcja się zmieni. Do tego czasu traktuj ją jako publiczność, na którą się przygotowujesz, a nie system, z którym się integrujesz.
Zbuduj jeden serwer, użyj go pięć razy
Jeśli masz cokolwiek budować, zbuduj serwer MCP dla swojego jednego źródła o najwyższej wartości i używaj go ponownie. Pięciu agentów obsługujących MCP powyżej akceptuje serwer streamable HTTP, więc jedna instalacja obsługuje ich wszystkich.
Minimalny działający serwer potrzebuje czterech rzeczy: narzędzia, które przyjmuje zapytanie i zwraca dane strukturyzowane; sprawdzania tokenu bearer po stronie serwera; limitu szybkości, żeby wymykający się agent nie wypalił Twojego limitu API; oraz pola instructions, które podaje ograniczenia w pierwszych 512 znakach.
Dwie zasady, które zapobiegają większości problemów. Zwracaj dane strukturyzowane, a nie prozę, żeby agent mógł wnioskować po polach, a nie ponownie parsować tekst. I uczyń każde narzędzie tylko do odczytu, dopóki nie obserwujesz agenta używającego go przez pełny cykl. Serwer tylko do odczytu nie może niczego zepsuć, a możesz go rozszerzyć, gdy zobaczysz rzeczywiste wzorce wywołań.
Zweryfikuj połączenie, zanim mu zaufasz
Nie zakładaj, że skonfigurowany serwer to działający serwer. Wykonaj te cztery sprawdzenia.
Sprawdź, czy serwer jest zarejestrowany. codex mcp list, claude mcp list lub openclaw mcp status powinny go pokazać. Serwer, który nie przeszedł parsowania, jest po cichu pomijany u niektórych klientów.
Sprawdź inwentarz narzędzi. Poproś agenta o wypisanie narzędzi, które serwer wystawia. Jeśli oczekujesz sześciu narzędzi, a widzisz jedno, serwer się zarejestrował, ale narzędzia nie.
Sprawdź prawdziwe zapytanie. Poproś o konkretny rekord, który możesz zweryfikować ręcznie. Ogólne pytanie „jakie dane możesz pobrać” niczego nie dowodzi.
Sprawdź ścieżkę awarii. Unieważnij token i uruchom zapytanie ponownie. Chcesz wyraźnego błędu uwierzytelniania, a nie cichego pustego wyniku. Agent, który traktuje nieudane wywołanie jako „brak danych”, zgłosi czysty wynik dla zepsutego połączenia, a to najdroższy tryb awarii w całym tym procesie.
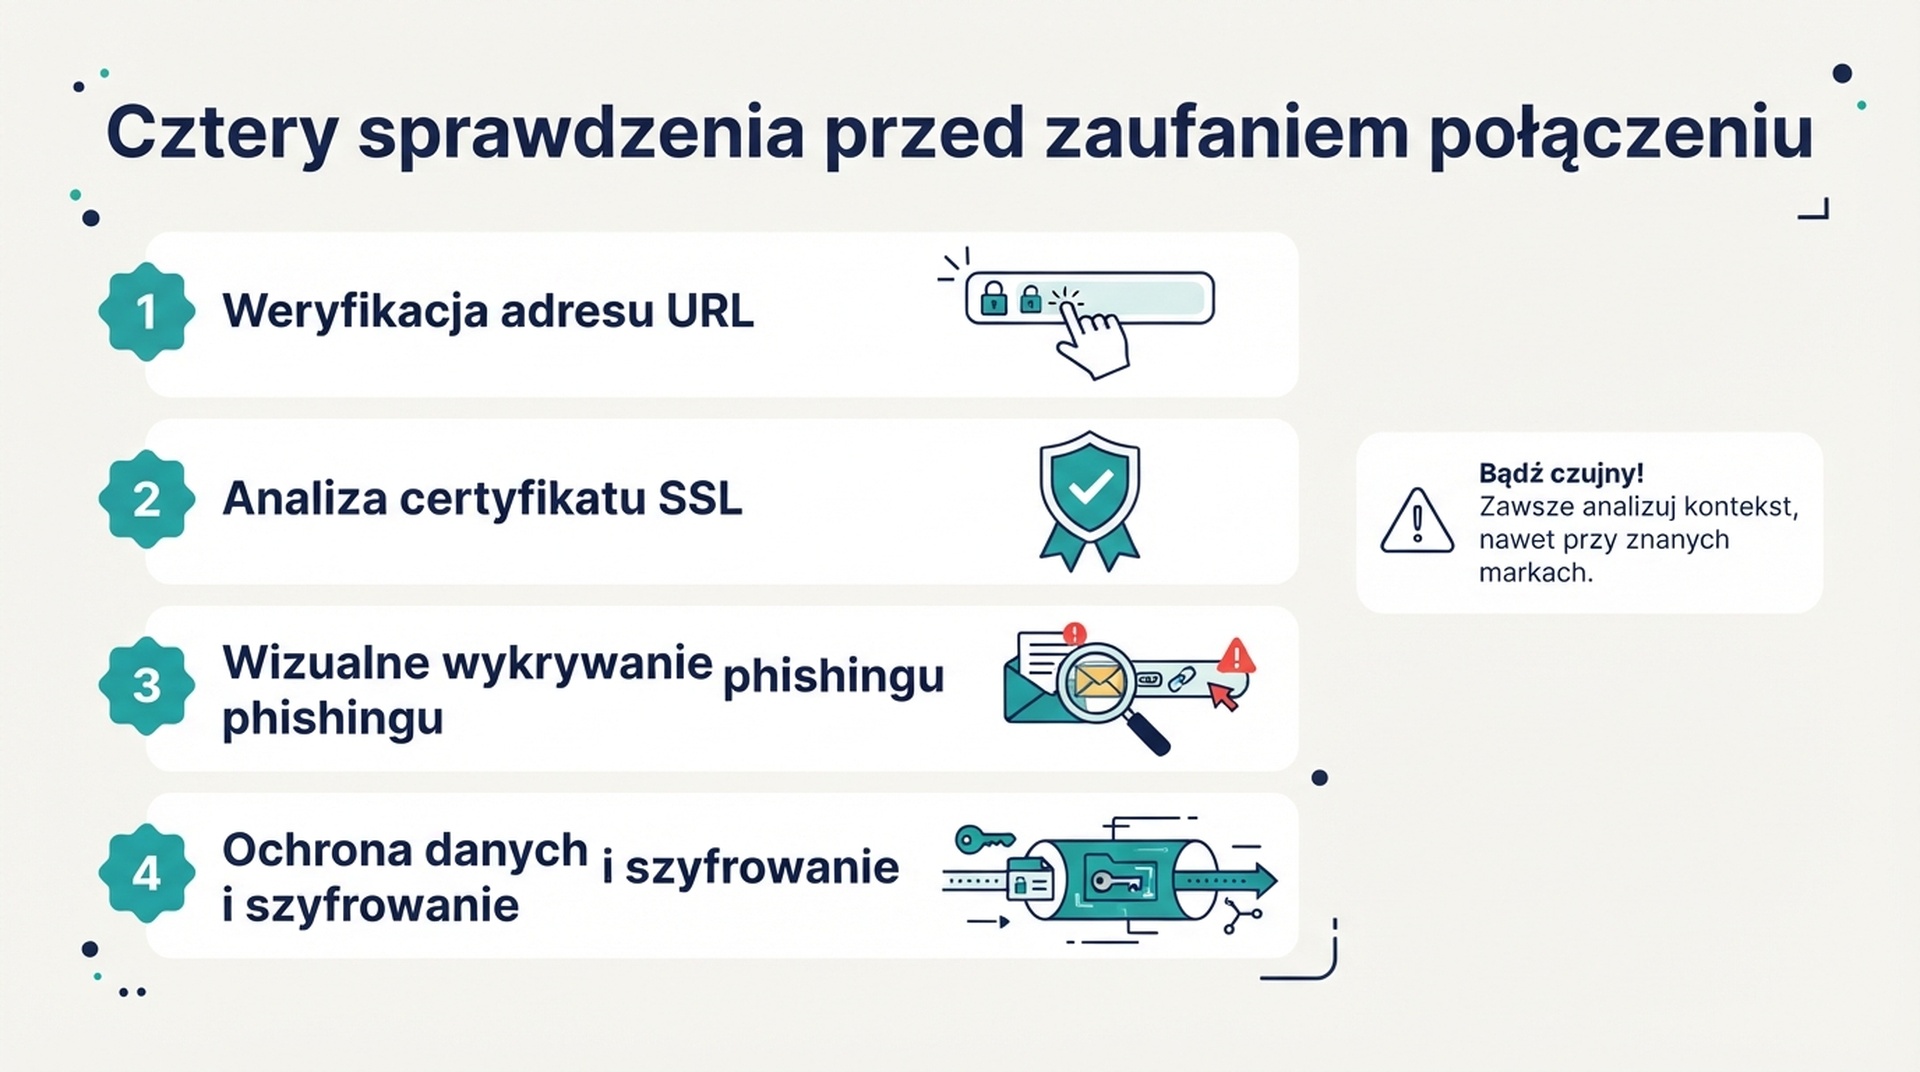
Cztery sprawdzenia. Ostatnie wyłapuje awarię, która wygląda jak ustalenie.
Co to zmienia w Twoich priorytetach
Tabela poziomów i tabela połączeń wskazują w tym samym kierunku. Źródła, które możesz podłączyć do agenta, to źródła, które możesz mierzyć, a źródła, które możesz mierzyć, to te, które możesz poprawiać względem punktu odniesienia.
Oznacza to, że kolejność pracy nie jest kolejnością, której używa większość zespołów. Zacznij od źródła, które ma jednocześnie udokumentowane połączenie i realny wpływ biznesowy dla Ciebie. Dla lokalnej firmy to Google Business Profile i ugruntowanie Maps. Dla firmy produktowej to Merchant Center lub feed produktowy. Dla firmy tworzącej narzędzia deweloperskie to jakość dokumentacji. Dla wydawcy to indeksowalność i wyodrębnialność żywych stron.
Potem zbuduj ten jeden serwer MCP, który wprowadza to źródło do Twojego agenta, i używaj go ponownie w pięciu agentach mówiących tym protokołem. Źródła bez ścieżki połączenia zostaw jako pracę nad treścią i encjami i bądź szczery, że nie możesz ich mierzyć w ten sam sposób.
Zespoły, które wychodzą tu na prowadzenie, to nie te z najdłuższą listą źródeł. To te, które podłączyły dwa lub trzy źródła mające znaczenie i zbudowały wokół nich pętlę monitoringu.
FAQ
Czy potrzebuję MCP, żeby dać agentowi dostęp do źródła danych? Nie. MCP to standard, który obsługuje teraz większość agentów, co czyni go najbardziej wielokrotnego użytku opcją, ale umiejętność z dołączonym skryptem API działa równie dobrze dla jednego agenta. Jeśli podłączasz jedno źródło do jednego agenta, umiejętność to mniej pracy. Jeśli podłączasz jedno źródło do pięciu agentów, MCP zwraca się natychmiast.
Od którego agenta zacząć? Zacznij od tego, który pasuje do miejsca, gdzie już żyje Twoja praca. Jeśli Twoja strona jest w repozytorium git — Codex albo Claude Code. Jeśli chcesz uruchomień według harmonogramu z trwałą pamięcią — Hermes Agent. Jeśli potrzebujesz twardej granicy uprawnień na płatnym źródle danych — OpenClaw. Jeśli chcesz najmniejszej powierzchni, którą przeaudytujesz za jednym posiedzeniem — Pi Agent.
Czy mogę podłączyć źródło, które nie ma serwera MCP? Tak, na trzy sposoby. Napisz cienki serwer MCP, jeśli źródło ma HTTP API i chcesz używać go w wielu agentach. Napisz umiejętność z dołączonym skryptem, jeśli potrzebujesz tylko jednego agenta. Albo użyj agenta obsługującego zdalne narzędzia MCP i wskaż mu serwer hostowany przez kogoś innego.
Dlaczego nie mogę podłączyć Meta Muse? Meta nie opublikowała API dla deweloperów ani powierzchni MCP dla Muse. Konektory są zarządzane przez dostawcę. Dopóki się to nie zmieni, Muse to powierzchnia, na którą przygotowujesz treści i dane, a nie system, o który możesz pytać.
Czy przypisania poziomów są trwałe? Nie. Ta kategoria zmienia się co miesiąc. Zweryfikuj ponownie dokumentację dostawcy, zanim zobowiążesz zespół do procesu, i traktuj każde przypisanie poziomu starsze niż kwartał jako niezweryfikowane.
Jaki jest najczęstszy błąd w tej pracy? Traktowanie nieudanego wywołania API jako prawdziwego zera. Jeśli Twój agent zgłasza, że marka nie ma widoczności w AI, a przyczyną źródłową jest wygasły token, masz awarię pomiaru przebraną za ustalenie. Zawsze testuj ścieżkę awarii, zanim zaufasz ścieżce sukcesu.
Autor: Julian Mercer, praktyk technicznego SEO z 14-letnim doświadczeniem w Auspia. Pisze o indeksowalności, schematach, renderowaniu i technicznych podstawach, które czynią treść czytelną zarówno dla wyszukiwarek, jak i dla agentów AI.