Hầu hết các đội ngũ theo dõi mức độ hiển thị trên AI vẫn đang làm việc dựa trên ảnh chụp màn hình. Họ hỏi ChatGPT một câu, sao chép các trích dẫn rồi dán vào một tài liệu. Cách đó cho biết một mô hình đã nói gì vào một buổi chiều. Nó không cho biết công cụ trả lời thực sự có thể chạm tới những nguồn nào, và nó không cho agent của bạn thứ gì để tự truy vấn.
Phiên bản hữu ích hơn của công việc này là một bản đồ nguồn dữ liệu kèm đường kết nối. Bạn quyết định nguồn dữ liệu nào quan trọng với ngành của mình, rồi đấu nối những nguồn bạn chạm tới được trực tiếp vào agent đang chạy việc giám sát. Phần còn lại là một danh sách ngắn những nguồn bạn chỉ có thể tác động gián tiếp, và danh sách đó thường ngắn hơn người ta tưởng.
Bài viết này làm ba việc. Nó phân loại các nguồn dữ liệu đứng sau câu trả lời AI thành các tầng theo mức độ bằng chứng được xác nhận và mức độ hiện thời. Nó đưa ra đường API hoặc MCP cụ thể cho những nguồn có sẵn. Và nó đi qua cách kết nối cho Codex, Claude Code, Hermes Agent, OpenClaw, Pi Agent, Grok Bot và Meta Muse, kể cả những trường hợp không có connector dựng sẵn và bạn phải tự xây cầu nối.
Câu trả lời ngắn
Bốn nhóm nguồn nuôi dưỡng câu trả lời AI, và chúng không dễ tiếp cận như nhau.
Nguồn web và khám phá tìm kiếm có thể tiếp cận qua API grounding và qua chính những trang có thể thu thập của bạn. Các feed thương mại có cấu trúc có thể tiếp cận qua đặc tả feed đã được tài liệu hóa, nhưng quyền truy cập bị chặn sau bước phê duyệt. Kho tri thức và kho cộng đồng thì một phần tiếp cận được qua API có giấy phép, một phần bị khóa sau quá trình nạp dữ liệu lúc huấn luyện mà bạn không thể tác động. Các bề mặt hành động của agent tiếp cận được qua những đặc tả giao thức vẫn đang định hình.
Với một quy trình giám sát do agent vận hành, điều đó trở thành một nguyên tắc thực dụng. Hãy kết nối những gì có API hoặc máy chủ MCP đã được tài liệu hóa. Coi những gì có đặc tả feed là một dự án chất lượng dữ liệu. Coi những gì không có cả hai là dự án nội dung và thực thể, chứ không phải dự án dữ liệu.
Cách đọc bảng phân tầng
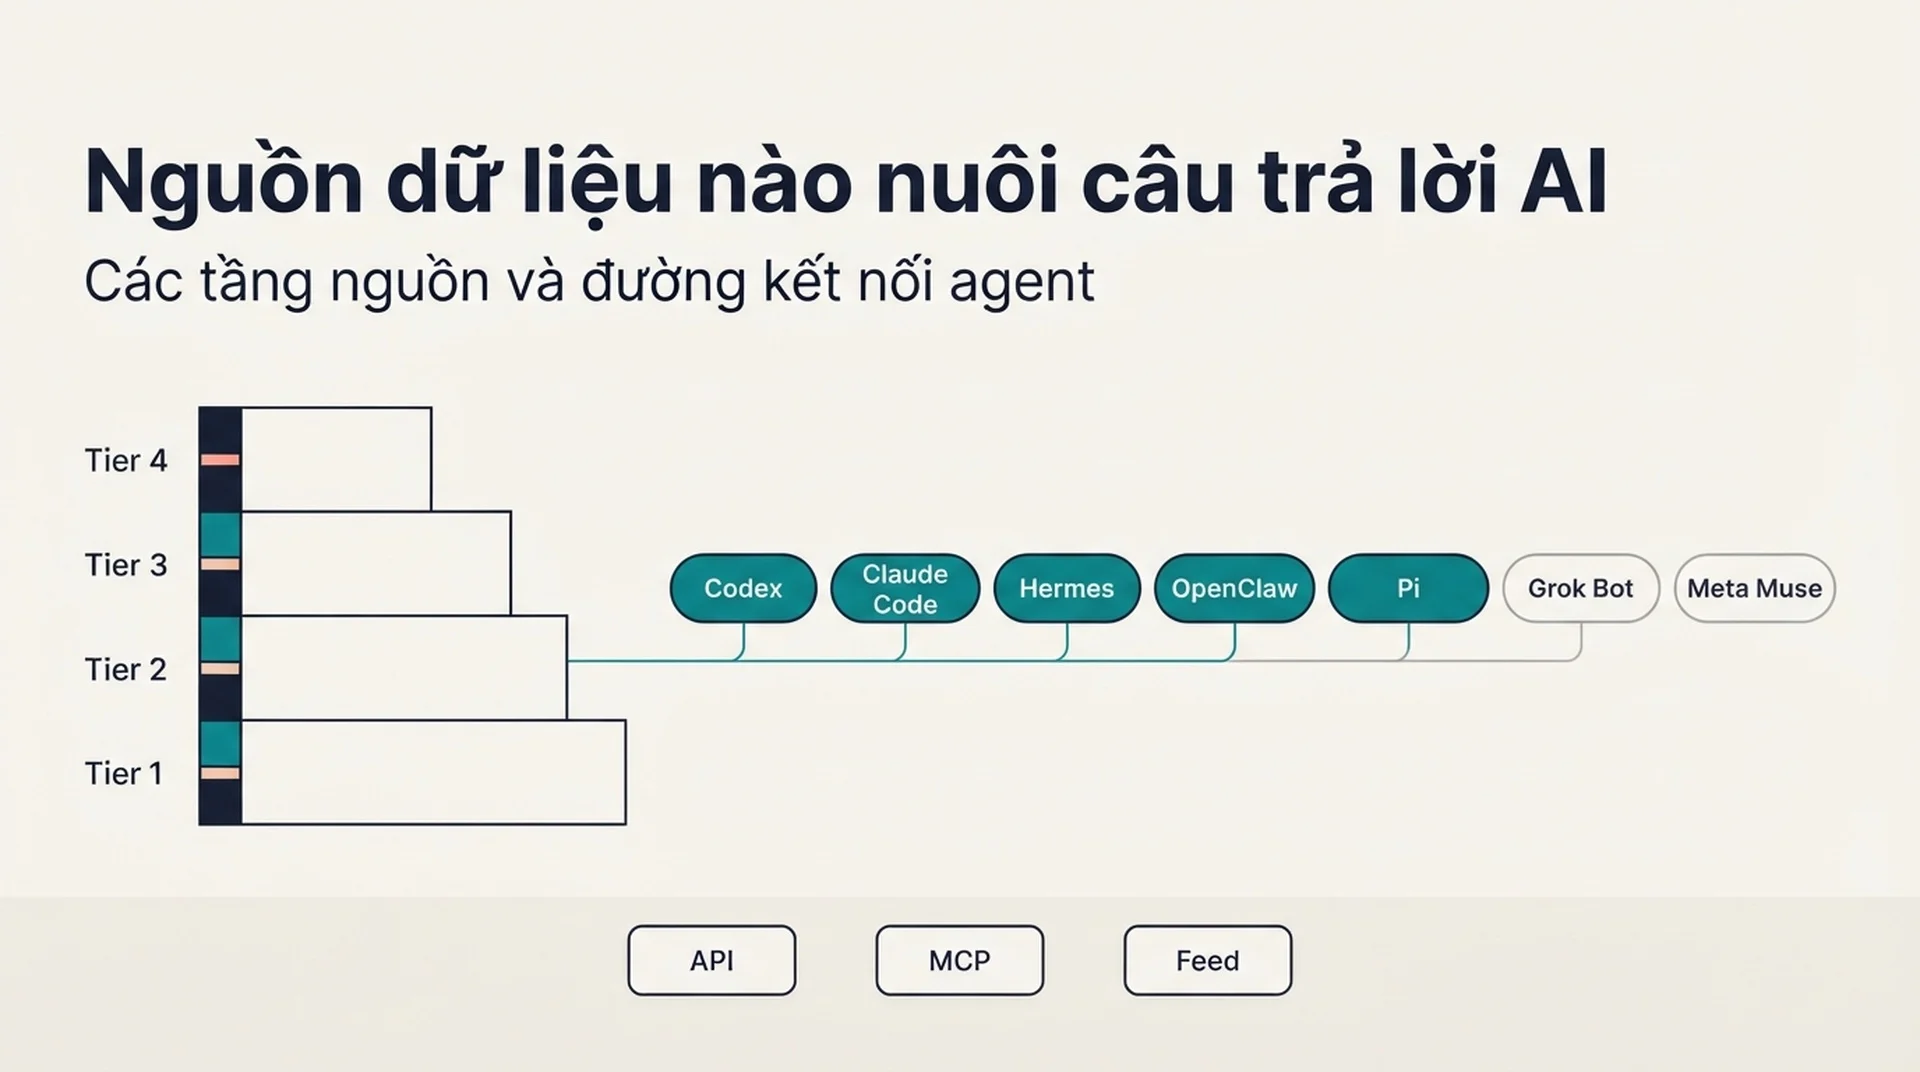
Các tầng dưới đây sắp xếp nguồn theo mức độ mạnh của bằng chứng rằng chúng đang nuôi dưỡng câu trả lời AI hiện nay, và theo việc kết nối đó đang sống hay chỉ còn tính lịch sử. Đây chính là chỗ mà hầu hết danh sách nguồn làm sai. Một nguồn đã định hình nên mô hình năm 2022 và một nguồn mà mô hình truy vấn hôm nay là hai thứ khác nhau, và gộp chúng lại sẽ tạo ra chiến lược tồi.
Tầng | Ý nghĩa | Điều đó nghĩa là gì với quy trình của bạn |
|---|---|---|
1 | Đã xác nhận và hiện thời | Grounding, truy xuất hoặc hành động đang sống. Hãy kết nối, giám sát, tối ưu cho nó. |
2 | Đã xác nhận và hiện thời | Huấn luyện hoặc cấp phép. Bạn tác động được qua nội dung và quan hệ đối tác, không qua API. |
3 | Đã xác nhận mang tính lịch sử | Chỉ có tiền huấn luyện. Không có đòn bẩy sống. Đừng xây quy trình giám sát quanh nó. |
4 | Bằng chứng mạnh, chưa xác nhận | Suy luận theo ngành. Đáng theo dõi, chưa đáng để lập ngân sách. |
Một lưu ý trước bảng. Ngành này thay đổi hằng tháng. Tài liệu nhà cung cấp, thỏa thuận cấp phép và đặc tả feed đều dịch chuyển. Hãy coi việc xếp tầng là điểm khởi đầu mà bạn kiểm tra lại với tài liệu của chính nhà cung cấp trước khi cam kết cả đội ngũ vào một quy trình.
Tầng 1: những nguồn sống mà agent của bạn thực sự chạm tới được
Đây là những nguồn có kết nối đã được tài liệu hóa ngay hôm nay. Nếu agent của bạn sẽ tự kéo dữ liệu hiển thị trên AI, thì nó bắt đầu từ đây.
Web và khám phá tìm kiếm
Grounding Google Search. API Gemini cung cấp công cụ google_search kết nối mô hình với nội dung web theo thời gian thực và trả về trích dẫn tới URL nguồn. Đây là ví dụ rõ ràng nhất, đã được tài liệu hóa và còn hiện hành, về grounding sống trên thị trường. Nó cũng có nghĩa đòn bẩy là khả năng thu thập và cấu trúc trang của bạn, không phải feed của bạn.
Bing Search. Microsoft ghi nhận rằng kết quả Bing được dùng để tăng cường câu trả lời Copilot. Hàm ý thực tế giống Google: nếu bạn muốn xuất hiện, trang phải tiếp cận được và trích xuất được.
Trang của nhà xuất bản đang sống. Được chạm tới ở thời điểm suy luận qua grounding tìm kiếm chứ không qua tiền huấn luyện. Việc chọn lựa để truy xuất và khả năng thu thập quyết định việc được đưa vào, đó là lý do công việc SEO kỹ thuật vẫn thể hiện trong kết quả hiển thị trên AI.
Sản phẩm và mua sắm
Google Merchant Center. Dữ liệu feed Merchant là nền tảng cho các bề mặt mua sắm của Google. Nếu bạn bán sản phẩm vật lý mà không có mặt trên Merchant Center, bạn vắng mặt khỏi một bề mặt đang được đấu nối tích cực vào câu trả lời AI.
Feed thương nhân và bán lẻ của OpenAI. Người bán chia sẻ một feed sản phẩm có cấu trúc, và tài liệu Agentic Commerce Protocol mô tả lược đồ, các đường tích hợp qua tải tệp và API, cùng nhịp làm mới chấp nhận cập nhật suốt cả ngày. Quyền truy cập hiện giới hạn ở đối tác đã được phê duyệt, nên đây là dự án có thời gian chờ, không phải một công tắc bật là xong.
Địa phương và địa điểm
Grounding Google Maps. Được tài liệu hóa như một công cụ bên cạnh grounding Search, mang lại ngữ cảnh không gian địa lý cho mô hình. Đó là lý do doanh nghiệp địa phương có hồ sơ chính xác, đầy đủ xuất hiện trong câu trả lời AI về các lựa chọn gần đó.
Google Business Profile. Dữ liệu hồ sơ doanh nghiệp nuôi các bề mặt địa phương của Google. Với doanh nghiệp địa phương, đây là một trong những nguồn đòn bẩy cao nhất và tốn ít công nhất trong danh sách.
Yelp. Yelp cấp phép đánh giá, ảnh và thông tin doanh nghiệp cho các gợi ý địa phương theo thời gian thực, và mối quan hệ này vượt ra ngoài grounding để đi vào hành động. Đây là một trong số ít nguồn mà nền tảng đánh giá vừa là nguồn trích dẫn vừa là bề mặt giao dịch.
Tri thức và tham chiếu
Wikipedia và Wikimedia. Có mặt trong các hỗn hợp tiền huấn luyện đã công bố và được dùng rộng rãi như một kho tham chiếu sống. Việc cấp phép rõ ràng một cách bất thường, khiến nó trở thành mục tiêu chính đáng cho công việc về thực thể.
Cộng đồng, hỏi đáp và mạng xã hội
Reddit. Một nguồn grounding sống thông qua thỏa thuận cấp phép dữ liệu, với phần huấn luyện được báo cáo riêng. Hãy coi tình trạng gia hạn là bất ổn và đừng xây quy trình giả định quyền truy cập vĩnh viễn.
Tầng 2 và 3: những nguồn bạn tác động, chứ không truy vấn
Chúng quan trọng, nhưng không phải qua một API mà bạn gọi được từ agent.
Nội dung nhà xuất bản được cấp phép. Tồn tại nhiều quan hệ cấp phép rõ ràng với các nhà xuất bản lớn, với điều khoản khác nhau theo từng đối tác về huấn luyện, grounding và ghi nguồn. Bạn không thể mua suất vào danh sách này khi là một site nhỏ, nhưng bạn có thể trở thành kiểu nguồn được trích dẫn khi kho được cấp phép mỏng về chủ đề của bạn.
Nguồn dành cho lập trình viên và nguồn kỹ thuật. Các kho mã công khai và kho tài liệu kỹ thuật là những nguồn hiện thời đã được xác nhận. Với công ty làm công cụ cho lập trình viên, đây là tầng giá trị cao nhất trong danh sách, và nó tiếp cận được qua chất lượng tài liệu chứ không qua feed.
Kho web mang tính lịch sử. Các dẫn xuất đã làm sạch từ dữ liệu Common Crawl và những kho tương tự. Đã xác nhận mang tính lịch sử, không có đòn bẩy sống. Hữu ích để hiểu vì sao một mô hình có định kiến tiên nghiệm nào đó, không hữu ích cho quy trình giám sát.
Lớp kết nối: mỗi agent chạm tới được gì
Đây là chỗ bài viết đáng giá. Bảng dưới đây ánh xạ từng agent với cơ chế kết nối mà nó thực sự hỗ trợ, cùng tình trạng trung thực của connector dựng sẵn cho các nguồn ở trên.
Agent | Cơ chế kết nối | Connector nguồn dựng sẵn | Bạn xây gì |
|---|---|---|---|
Codex | MCP qua stdio và streamable HTTP, cấu hình trong | Kho máy chủ MCP cộng đồng đang lớn lên | Một máy chủ MCP mỏng cho bất kỳ nguồn nào có HTTP API |
Claude Code | MCP qua HTTP, SSE, stdio và WebSocket | Danh mục connector của Anthropic cùng máy chủ cộng đồng | Cùng máy chủ đó, thêm bằng |
Hermes Agent | MCP có lọc công cụ theo từng máy chủ, cùng skill gốc | Danh mục MCP tuyển chọn, cài bằng một cú nhấp | Một skill bọc API khi chưa có MCP |
OpenClaw | Vừa là client vừa là server MCP, cùng A2A JSON-RPC | Sổ đăng ký MCP của OpenClaw và định nghĩa máy chủ đã lưu | Một định nghĩa MCP đã lưu hoặc một cầu A2A |
Pi Agent | Tiện ích mở rộng và skill TypeScript, không có client MCP gốc | Mặc định không có | Một tiện ích nhỏ gọi API như một công cụ |
Grok Bot | Công cụ MCP từ xa khai báo trong yêu cầu API | Bất kỳ máy chủ MCP từ xa nào bạn trỏ tới | Một máy chủ MCP từ xa, vì Grok quản lý kết nối |
Meta Muse | Connector, không có bề mặt MCP hay API công khai | Chỉ connector do nhà cung cấp quản lý | Chỉ công việc gián tiếp: feed, dữ liệu thực thể và trang thu thập được |
Một mẫu đáng chú ý: năm trong bảy agent nói MCP, và hai agent không nói nằm ở hai đầu đối lập của phổ. Pi Agent được thiết kế tối giản có chủ đích và chờ bạn viết tiện ích mở rộng. Meta Muse là sản phẩm tiêu dùng không có bề mặt dành cho lập trình viên.
Điều đó nghĩa là nước đi hiệu quả là xây một máy chủ MCP cho nguồn giá trị nhất của bạn rồi tái sử dụng nó trên Codex, Claude Code, Hermes Agent, OpenClaw và Grok Bot. Bạn viết một lần.
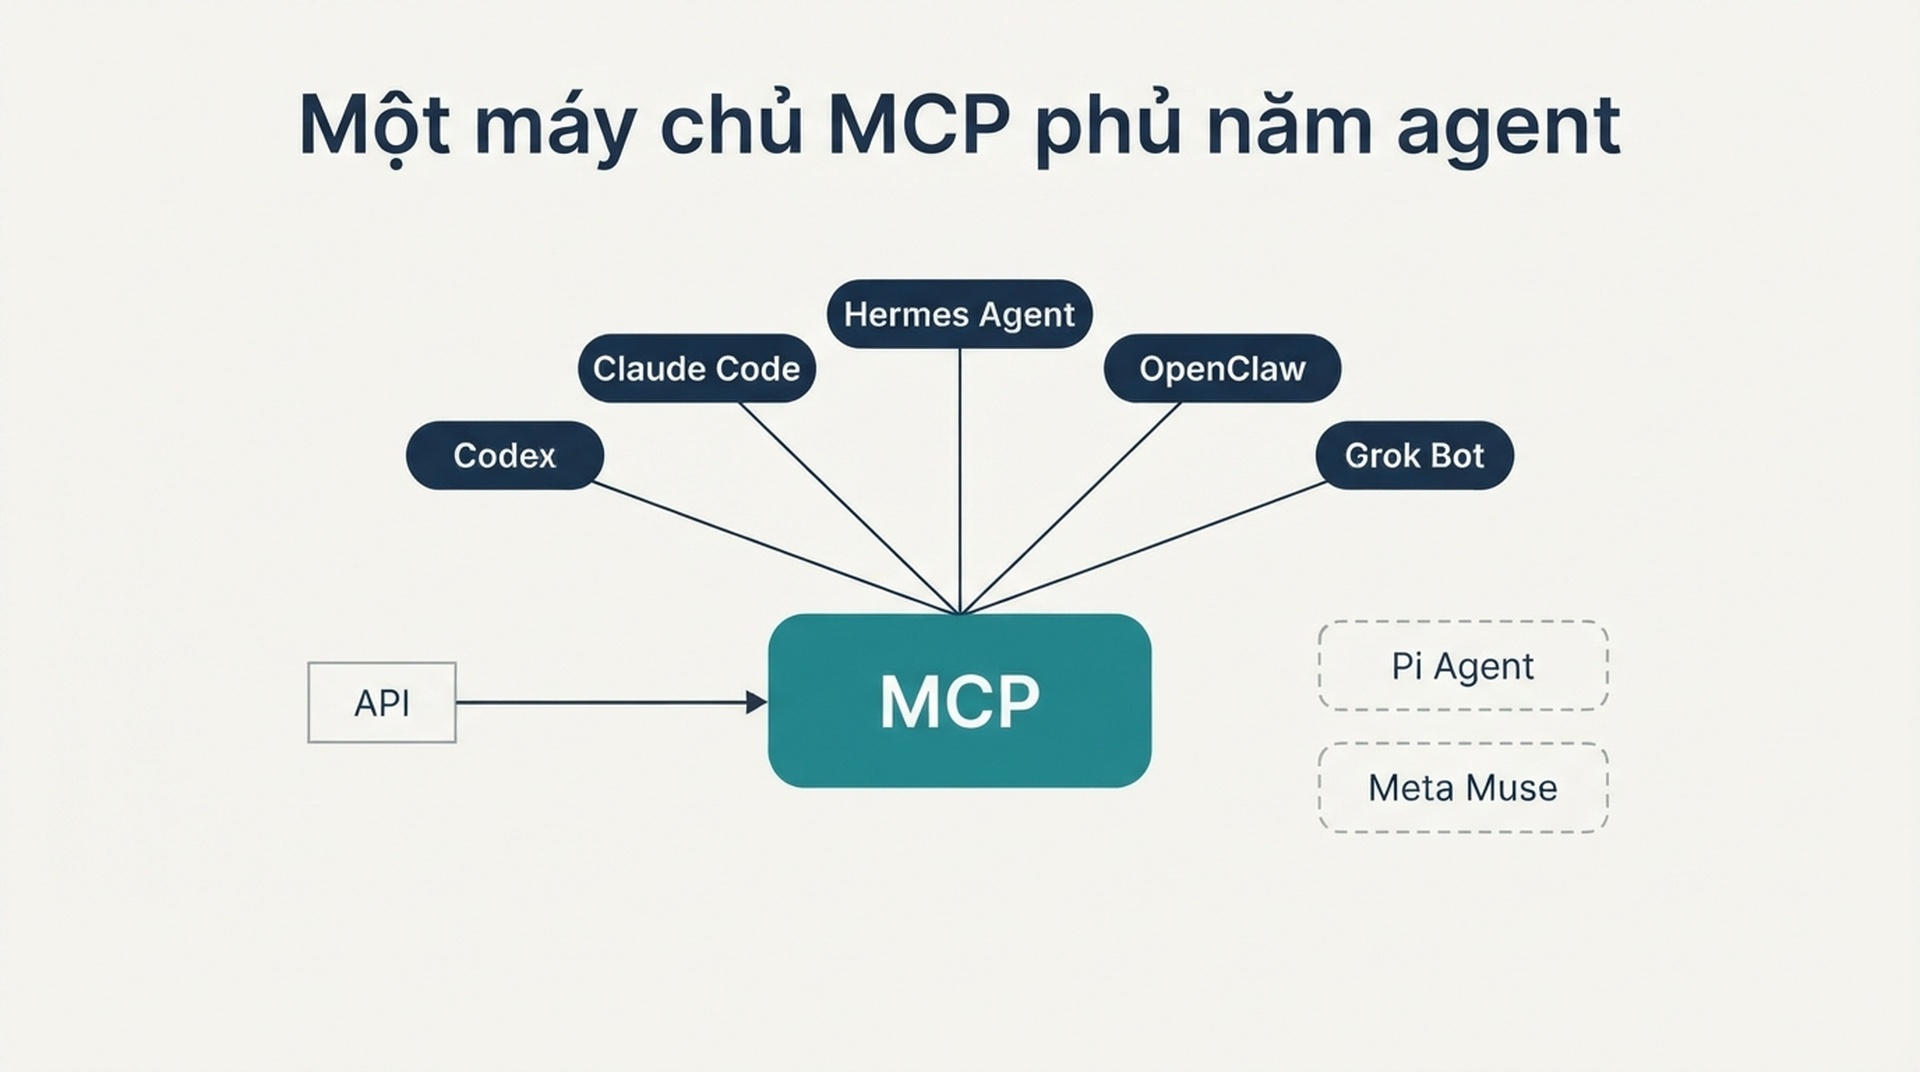
Một máy chủ phủ năm trong bảy agent. Pi Agent và Meta Muse cần đường đi khác.
Cách kết nối từng agent
Các bước dưới đây giả định bạn đã có khóa API hoặc token cho nguồn đang kết nối. Tuyệt đối không đặt thông tin xác thực vào tệp cấu hình bị commit.
Codex
Codex lưu cấu hình MCP trong config.toml, hoặc ở ~/.codex/config.toml, hoặc theo phạm vi dự án ở .codex/config.toml. Ứng dụng ChatGPT trên máy tính, Codex CLI và tiện ích IDE dùng chung cấu hình này, nên bạn cấu hình một lần.
Với máy chủ stdio:
codex mcp add my-source --env API_KEY=your-key -- npx -y @your-org/my-source-mcpVới máy chủ streamable HTTP, thêm một bảng vào config.toml:
[mcp_servers.my-source]
url = "https://mcp.example.com/mcp"
bearer_token_env_var = "MY_SOURCE_TOKEN"
Codex đọc trường instructions của MCP được trả về lúc khởi tạo và dùng nó như hướng dẫn cho toàn bộ máy chủ. Nếu bạn đang xây máy chủ, hãy giữ 512 ký tự đầu tự chứa đủ thông tin để những ràng buộc quan trọng nhất có mặt khi agent quyết định có gọi nó hay không.
Chạy codex mcp list để xác nhận máy chủ đã đăng ký, và /mcp trong TUI để xem các máy chủ đang hoạt động.
Claude Code
Claude Code hỗ trợ HTTP từ xa, SSE từ xa, stdio cục bộ và WebSocket từ xa. HTTP là lựa chọn được khuyến nghị cho máy chủ từ xa.
claude mcp add --transport http my-source https://mcp.example.com/mcp \
  --header "Authorization: Bearer your-token"
Với máy chủ cục bộ:
claude mcp add my-source -- npx -y @your-org/my-source-mcpHai chi tiết khiến người ta vấp. Thứ nhất, trong cấu hình JSON, một mục có url nhưng không có type bị coi là máy chủ stdio và bị bỏ qua một cách im lặng, nên hãy luôn đặt "type": "http" một cách tường minh. Thứ hai, Claude Code đặt CLAUDE_PROJECT_DIR trong môi trường của máy chủ được khởi tạo, nên máy chủ cục bộ có thể phân giải đường dẫn tương đối theo dự án mà không phụ thuộc vào thư mục làm việc.
Hermes Agent
Hermes Agent được phát hành kèm hỗ trợ MCP trong bản cài tiêu chuẩn. Cấu hình nằm ở ~/.hermes/config.yaml:
mcp_servers:
  my-source:
    command: "npx"
    args: ["-y", "@your-org/my-source-mcp"]
Hermes cũng hỗ trợ máy chủ MCP HTTP từ xa trong cùng tệp cấu hình, và hỗ trợ lọc theo từng máy chủ để bạn chỉ để lộ những công cụ thực sự muốn agent thấy. Việc lọc này quan trọng ở đây hơn ở các agent khác, vì Hermes chạy không người trông theo lịch.
Nếu bạn đang chuyển từ Claude Code, hermes import-agent claude-code ánh xạ khối mcpServers từ ~/.claude.json sang mcp_servers trong cấu hình Hermes và mang theo cả skill lẫn hướng dẫn cùng lúc.
Khi không có máy chủ MCP cho một nguồn, hệ thống skill là phương án dự phòng. Một skill là thư mục có tệp SKILL.md cho agent biết khi nào dùng và phải làm gì. Hãy bọc lời gọi API trong một script đi kèm và tham chiếu nó từ skill, thế là agent có được năng lực đó mà không cần máy chủ giao thức.
OpenClaw
OpenClaw hoạt động vừa như client MCP vừa như server MCP. Ở vai client, bạn quản lý các định nghĩa máy chủ đã lưu qua những lệnh con mcp registry, và có thể sửa cũng như xem máy chủ từ trang cài đặt Control UI trên trình duyệt.
openclaw mcp registry add my-source --transport streamable-http --url https://mcp.example.com/mcp
openclaw mcp status
OpenClaw cũng để lộ các cuộc hội thoại kênh của chính nó qua MCP, tức chiều ngược lại, hữu ích khi bạn muốn một agent khác đọc xem instance OpenClaw của bạn đang làm gì. Với agent bên ngoài không phải client MCP, OpenClaw nói A2A qua JSON-RPC.
Mô hình quyền là lý do nên chọn OpenClaw cho công việc này. Nó có chính sách công cụ theo từng cuộc trò chuyện và đường phê duyệt tường minh cho việc thực thi, đúng thứ bạn cần khi agent đang đọc một nguồn dữ liệu trả phí và bạn phải giới hạn mức chi.
Pi Agent
Pi Agent không có client MCP gốc, và đó là lựa chọn thiết kế chứ không phải lỗ hổng. Điểm mở rộng của nó là các mô-đun TypeScript chạy bên trong tiến trình Pi và đăng ký công cụ.
Tạo một tiện ích mở rộng tại ~/.pi/agent/extensions/my-source.ts:
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.registerTool({
    name: "my_source_lookup",
    description: "Look up a record in My Source by query.",
    parameters: { type: "object", properties: { query: { type: "string" } }, required: ["query"] },
    handler: async ({ query }) => {
      const res = await fetch(`https://api.example.com/search?q=${encodeURIComponent(query)}`, {
        headers: { Authorization: `Bearer ${process.env.MY_SOURCE_TOKEN}` },
      });
      return await res.json();
    },
  });
}
Nạp trực tiếp trong lúc phát triển bằng pi --extension ./my-source.ts, rồi chuyển nó vào thư mục extensions hoặc đóng gói bằng pi install khi đã ổn định.
Sự đánh đổi là thật và đáng nói thẳng. Một tiện ích mở rộng chạy với cùng quyền hệ điều hành như tiến trình Pi và có thể xem prompt, lời gọi công cụ, tệp và thông tin xác thực. Chỉ nạp tiện ích từ nguồn bạn tin, và đọc mã nguồn trước khi cài.
Grok Bot
API của Grok hỗ trợ công cụ MCP từ xa, và xAI quản lý kết nối máy chủ thay bạn. Bạn khai báo máy chủ trong mảng tools của yêu cầu:
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import mcp

client = Client(api_key=os.getenv("XAI_API_KEY"))
chat = client.chat.create(
    model="grok-4.7",
    tools=[mcp(server_url="https://mcp.example.com/mcp", server_label="my-source")],
)
Với công cụ MCP từ xa, chỉ có transport streaming HTTP và SSE được hỗ trợ. Bạn có thể giới hạn công cụ nào được để lộ bằng allowed_tools, và truyền một token ủy quyền mà xAI đặt vào header Authorization trong các yêu cầu gửi tới máy chủ của bạn.
Lợi thế ở đây là bạn không phải chạy hay duy trì kết nối phía client. Bất lợi là máy chủ MCP phải tiếp cận được công khai, nên bất cứ thứ gì sau VPN của bạn cần cách tiếp cận khác.
Meta Muse
Muse kết nối với ứng dụng và dịch vụ bên thứ ba qua Connector, và không có bề mặt MCP hay API lập trình viên công khai cho chính agent này. Đó là câu trả lời trung thực, và nó thay đổi những gì bạn làm được.
Bạn không thể đấu nối Muse vào quy trình giám sát như với sáu agent còn lại. Điều bạn làm được là khiến những nguồn Muse đọc trở nên tốt hơn. Nghĩa là dữ liệu sản phẩm và danh mục chính xác nếu bạn bán hàng, thông tin doanh nghiệp đầy đủ và nhất quán nếu bạn là doanh nghiệp địa phương, và những trang thu thập được với tín hiệu thực thể rõ ràng nếu bạn là nhà xuất bản. Muse là mục tiêu cho công việc chuẩn bị, không phải nguồn dữ liệu bạn truy vấn.
Nếu Meta phát hành một bề mặt lập trình viên cho Muse, phần này sẽ thay đổi. Tới lúc đó, hãy coi nó là một đối tượng cần chuẩn bị hơn là một hệ thống cần tích hợp.
Xây một máy chủ, dùng lại năm lần
Nếu bạn định xây bất cứ thứ gì, hãy xây máy chủ MCP cho nguồn giá trị cao nhất duy nhất của bạn rồi dùng lại. Năm agent hỗ trợ MCP ở trên đều chấp nhận máy chủ streamable HTTP, nên một lần triển khai phủ tất cả.
Một máy chủ tối thiểu khả dụng cần bốn thứ: một công cụ nhận truy vấn và trả về dữ liệu có cấu trúc, một bước kiểm tra token bearer phía máy chủ, một giới hạn tần suất để agent chạy loạn không đốt hết hạn mức API của bạn, và một trường instructions nêu các ràng buộc trong 512 ký tự đầu.
Hai nguyên tắc ngăn phần lớn đau đầu. Hãy trả về dữ liệu có cấu trúc thay vì văn xuôi, để agent suy luận trên các trường thay vì phân tích lại văn bản. Và để mọi công cụ chỉ đọc cho tới khi bạn đã quan sát agent dùng nó trọn một chu kỳ. Máy chủ chỉ đọc không thể làm hỏng thứ gì, và bạn có thể mở rộng sau khi đã thấy các mẫu gọi thực tế.
Xác minh kết nối trước khi tin nó
Đừng cho rằng một máy chủ đã cấu hình là một máy chủ đang chạy. Hãy chạy bốn bước kiểm tra sau.
Kiểm tra máy chủ đã đăng ký. codex mcp list, claude mcp list hoặc openclaw mcp status phải hiển thị nó. Một máy chủ phân tích cú pháp thất bại sẽ bị bỏ qua im lặng ở một số client.
Kiểm tra danh mục công cụ. Yêu cầu agent liệt kê các công cụ máy chủ để lộ. Nếu bạn mong sáu công cụ mà chỉ thấy một, máy chủ đã đăng ký nhưng công cụ thì chưa.
Kiểm tra một truy vấn thật. Yêu cầu một bản ghi cụ thể mà bạn tự kiểm chứng được. Một câu hỏi chung chung kiểu "bạn lấy được dữ liệu gì" không chứng minh điều gì.
Kiểm tra đường thất bại. Thu hồi token rồi chạy lại truy vấn. Bạn muốn một lỗi xác thực rõ ràng, không phải một kết quả rỗng im lặng. Một agent coi lời gọi thất bại là "không có dữ liệu" sẽ báo cáo kết quả sạch cho một kết nối hỏng, và đó là kiểu thất bại tốn kém nhất trong toàn bộ quy trình này.
Bốn bước kiểm tra. Bước cuối bắt được thất bại trông như một phát hiện.
Điều này thay đổi gì trong ưu tiên của bạn
Bảng phân tầng và bảng kết nối chỉ về cùng một hướng. Những nguồn bạn đấu nối được vào agent là những nguồn bạn đo được, và những nguồn bạn đo được là những nguồn bạn cải thiện được so với một mốc chuẩn.
Điều đó nghĩa là thứ tự công việc không phải thứ tự mà hầu hết đội ngũ dùng. Hãy bắt đầu từ nguồn vừa có kết nối đã được tài liệu hóa vừa có tác động kinh doanh thật với bạn. Với doanh nghiệp địa phương, đó là Google Business Profile và grounding Maps. Với công ty sản phẩm, đó là Merchant Center hoặc một feed sản phẩm. Với công ty làm công cụ cho lập trình viên, đó là chất lượng tài liệu. Với nhà xuất bản, đó là khả năng thu thập và trích xuất của những trang đang sống.
Rồi xây một máy chủ MCP đưa nguồn đó vào agent của bạn, và dùng lại nó trên năm agent nói giao thức này. Để những nguồn không có đường kết nối lại thành công việc nội dung và thực thể, và hãy trung thực rằng bạn không thể đo chúng theo cùng cách.
Những đội ngũ vượt lên ở đây không phải những đội có danh sách nguồn dài nhất. Họ là những người đã kết nối hai hoặc ba nguồn quan trọng và xây một vòng giám sát quanh chúng.
Câu hỏi thường gặp
Tôi có cần MCP để cho agent truy cập một nguồn dữ liệu không? Không. MCP là chuẩn mà hầu hết agent hiện hỗ trợ, khiến nó thành lựa chọn tái sử dụng tốt nhất, nhưng một skill kèm script API cũng hiệu quả tương đương cho một agent duy nhất. Nếu bạn nối một nguồn với một agent, skill tốn ít công hơn. Nếu bạn nối một nguồn với năm agent, MCP hoàn vốn ngay lập tức.
Tôi nên bắt đầu với agent nào? Hãy bắt đầu với cái khớp nơi công việc của bạn đang nằm. Nếu site của bạn ở trong kho git — Codex hoặc Claude Code. Nếu bạn muốn chạy theo lịch với bộ nhớ bền — Hermes Agent. Nếu bạn cần ranh giới quyền cứng trên một nguồn dữ liệu trả phí — OpenClaw. Nếu bạn muốn bề mặt nhỏ nhất có thể kiểm toán trong một lần ngồi — Pi Agent.
Tôi có thể kết nối một nguồn không có máy chủ MCP không? Được, theo ba cách. Viết một máy chủ MCP mỏng nếu nguồn có HTTP API và bạn muốn dùng lại trên nhiều agent. Viết một skill kèm script nếu bạn chỉ cần một agent. Hoặc dùng một agent hỗ trợ công cụ MCP từ xa và trỏ nó tới máy chủ do người khác vận hành.
Vì sao tôi không kết nối được Meta Muse? Meta chưa công bố API lập trình viên hay bề mặt MCP cho Muse. Connector do nhà cung cấp quản lý. Tới khi điều đó thay đổi, Muse là bề mặt để bạn chuẩn bị nội dung và dữ liệu, không phải hệ thống bạn truy vấn.
Việc xếp tầng có vĩnh viễn không? Không. Ngành này dịch chuyển hằng tháng. Hãy kiểm tra lại tài liệu nhà cung cấp trước khi cam kết đội ngũ vào một quy trình, và coi bất kỳ việc xếp tầng nào cũ hơn một quý là chưa được xác minh.
Lỗi phổ biến nhất trong công việc này là gì? Coi một lời gọi API thất bại là số không thật. Nếu agent của bạn báo rằng một thương hiệu không có hiển thị trên AI mà nguyên nhân gốc là token hết hạn, thì bạn có một thất bại đo lường được ngụy trang thành một phát hiện. Luôn kiểm tra đường thất bại trước khi tin đường thành công.
Tác giả: Julian Mercer, chuyên gia SEO kỹ thuật với 14 năm kinh nghiệm tại Auspia. Julian viết về khả năng thu thập, schema, kết xuất và những nền tảng kỹ thuật giúp nội dung dễ đọc với cả công cụ tìm kiếm lẫn agent AI.