大多数追踪 AI 可见度的团队,到现在还是靠截图。他们向 ChatGPT 丢一个问题,复制引用,再粘进文档里。这样只能知道某个下午、某一个模型说了什么。你无从得知答案引擎实际能触达哪些来源,也无法让代理自己去查询。
这项工作更有用的形式,是来源地图加上连接路径。你先决定哪些数据来源对你的品类重要,再把触达得到的来源直接接进负责监控的代理。剩下的,是一份你只能间接影响的来源短名单,而那份名单通常比你想的还短。
这篇文章处理三件事。它依照证据有多确定、有多即时,把支撑 AI 答案的数据来源分成层级。它为有连接路径的来源,给出具体的 API 或 MCP 路径。它也逐一说明 Codex、Claude Code、Hermes Agent、OpenClaw、Pi Agent、Grok Bot、Meta Muse 的连接方式,包括没有现成连接器、必须自己搭桥的情况。
简短答案
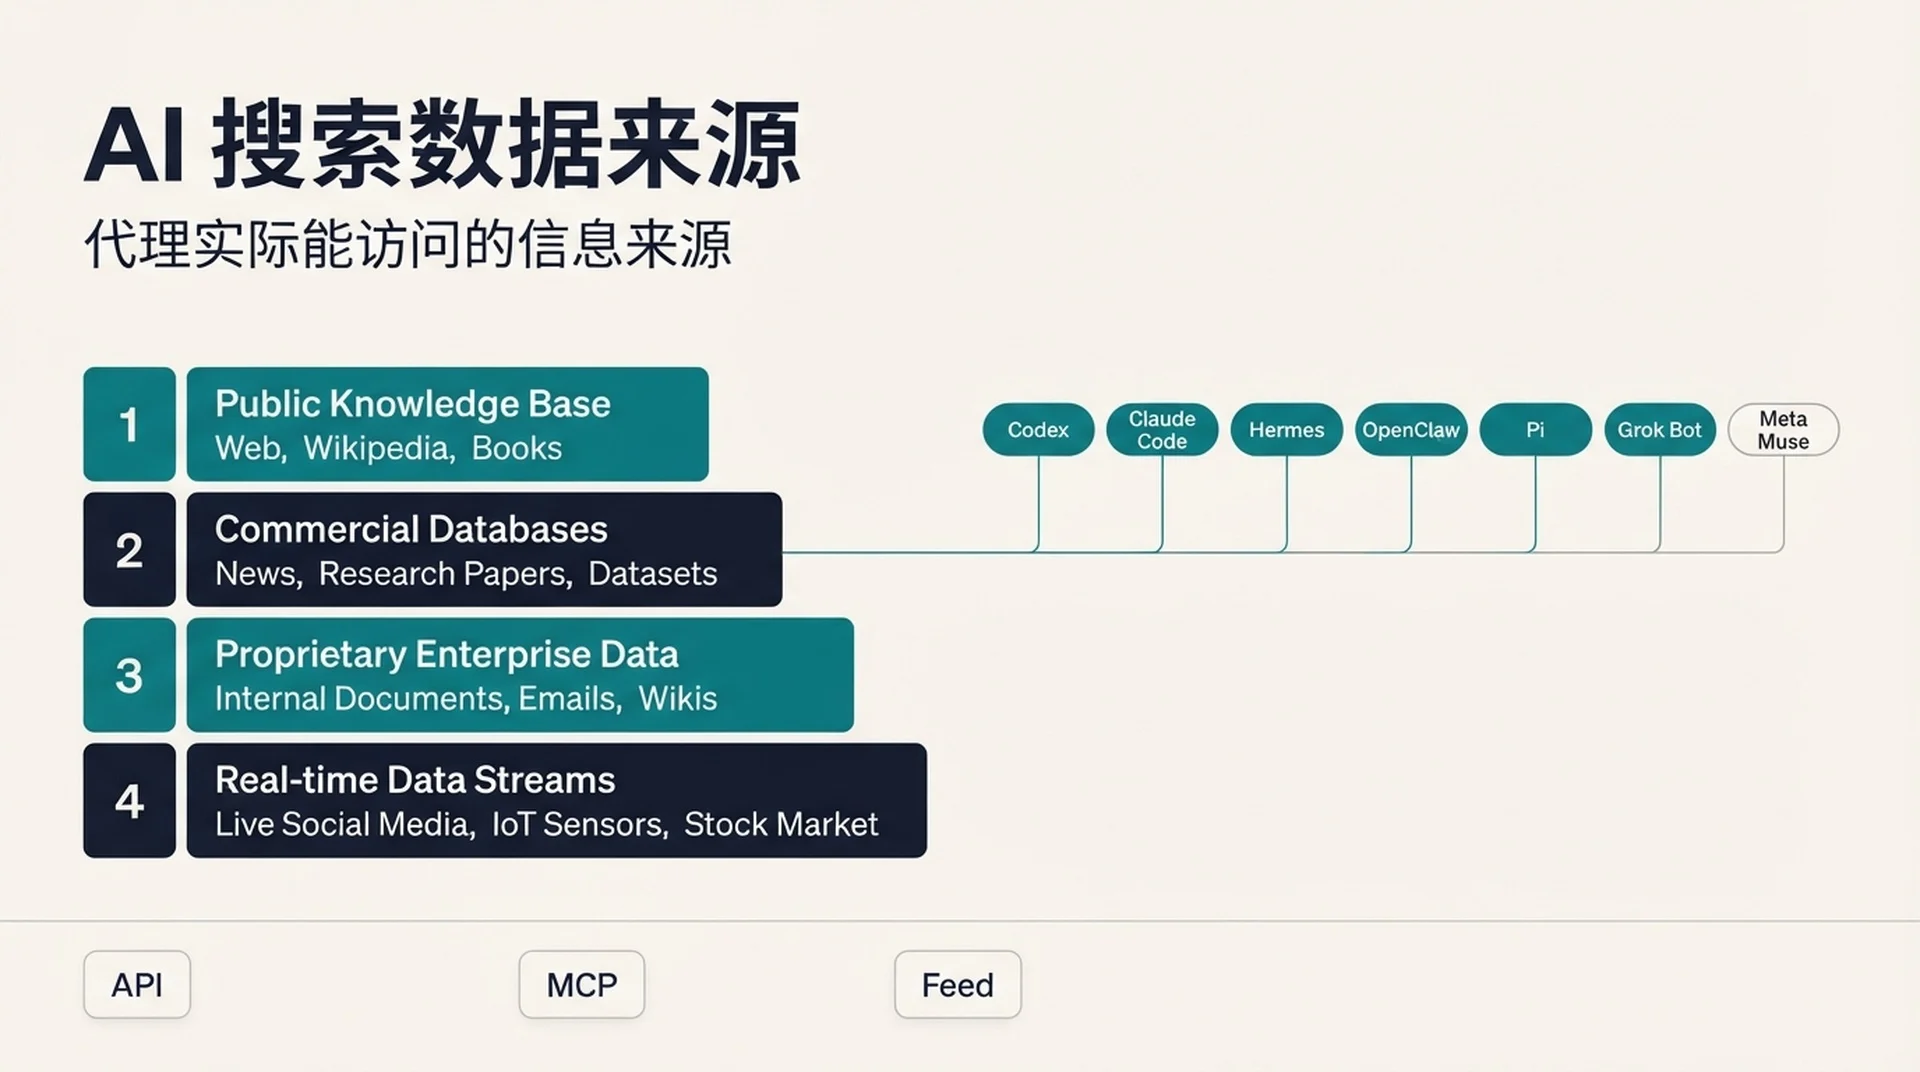
支撑 AI 答案的来源分成四类,触达难度并不一样。
网页与搜索发现类的来源,可通过 grounding API 以及你自己可被检索的页面触达。结构化的商务 feed 可通过已文档化的 feed 规范触达,但访问受到审核限制。知识与社区语料库,一部分可通过授权 API 触达,一部分锁在你无法影响的训练期收录背后。代理动作界面则可通过仍在成形的协议规范触达。
换成代理驱动的监控工作流,就成了实用规则。有已文档化 API 或 MCP 服务器的,就接上。有 feed 规范的,当成数据质量项目处理。两者都没有的,就当成内容与实体项目,而不是数据项目。
怎么读这张层级表
以下层级依两件事分类:这个来源目前支撑 AI 答案的证据有多强,以及那条连接是现行的还是历史性的。这正是大多数来源清单出错的地方。2022 年塑造过某个模型的来源,和今天某个模型会去查询的来源,是两回事,混为一谈就会做出错误策略。
层级 | 含义 | 对工作流的意义 |
|---|---|---|
1 | 已确认且现行 | 实时 grounding、检索或动作。接上它、监控它、为它优化。 |
2 | 已确认且现行 | 训练或授权。你能通过内容与合作影响它,而不是通过 API。 |
3 | 已确认的历史数据 | 仅限预训练。没有实时杠杆。不要围绕它建立监控流程。 |
4 | 证据强但未确认 | 品类推论。值得观察,还不值得编列预算。 |
看表之前先提醒一点。这个品类每个月都在变。厂商文档、授权合同、feed 规范全都在动。把层级归类当成起点,在让团队投入某个流程之前,先回到厂商自己的文档重新确认。
层级 1:代理真的触达得到的实时来源
这里是目前有已文档化连接的来源。如果你的代理要自己抓取 AI 可见度数据,就从这里开始。
网页与搜索发现
Google Search grounding。Gemini API 提供 google_search 工具,把模型连上实时网页内容,并返回指向来源网址的引用。这是有文档、现行有效,也是市场上最清楚的实时 grounding 范例。也就是说,杠杆是你的可检索性与页面结构,而不是 feed。
Bing Search。Microsoft 的文档说明 Bing 结果被用来强化 Copilot 的响应。实务上的意义和 Google 一样:想被看见,页面就得能被触达、能被抽取。
实时发布者页面。是在推理时通过搜索 grounding 触达,而不是预训练。检索结果的选择与可检索性决定是否被收录,这也是为什么技术 SEO 的工作会反映在 AI 可见度结果上。
产品与购物
Google Merchant Center。商家 feed 数据支撑 Google 的购物界面。如果你卖实体商品却不在 Merchant Center 里,你就缺席了一个正被积极接进 AI 答案的界面。
OpenAI 商家与零售 feed。商家分享结构化的商品 feed,Agentic Commerce Protocol 文档说明了结构定义、文件上传与 API 两种集成路径,以及一天之内可接受更新的刷新频率。访问目前限于已批准的合作伙伴,所以这是有前置时间的项目,不是打开开关就好。
本地与地点
Google Maps grounding。与 Search grounding 并列为已文档化的工具,为模型提供地理上下文。这就是为什么拥有正确、完整档案信息的本地商家,会出现在关于附近选项的 AI 答案里。
Google Business Profile。商家档案数据支撑 Google 的本地界面。对本地商家来说,这是清单上杠杆最高、投入最低的来源之一。
Yelp。Yelp 授权评论、照片与商家信息用于实时本地推荐,而这层关系不只 grounding,还延伸到动作。这是少数同时是引用来源、也是交易界面的评论平台。
知识与参考
Wikipedia 与 Wikimedia。出现在已披露的预训练混合数据中,也被广泛当作实时参考语料库使用。授权条件异常清楚,让它成为实体工作的正当目标。
社区、问答与社交
Reddit。通过数据授权协议成为实时 grounding 来源,训练那一侧则另有报道。把续约状态当成不稳定因素,不要建立假设能永久访问的流程。
层级 2 与 3:你能影响、但不能查询的来源
这些很重要,但不是通过代理能调用的 API。
授权的发布者内容。与主要出版社之间存在多项明确的授权合作,条件依合作对象而异,涵盖训练、grounding 与标注。小网站无法花钱挤进这份名单,但你可以成为那种在授权语料库对你的主题着墨不足时被引用的来源。
开发者与技术来源。公开代码仓库与技术文档语料库是已确认的现行来源。对开发者工具公司来说,这是清单上价值最高的层级,而它是通过文档质量触达,不是通过 feed。
历史网页语料库。常见爬取数据的清理衍生版本与类似归档。已确认的历史数据,没有实时杠杆。用来理解模型为何带有某种先验很有用,但不适合监控流程。
连接层:每个代理能触达什么
这里是这篇文章的重点。下表把每个代理实际支持的连接机制,对上上述来源的现成连接器实况。
代理 | 连接机制 | 现成来源连接器 | 你要自己建的东西 |
|---|---|---|---|
Codex | 在 | 持续增长的社区 MCP 服务器注册表 | 为任何有 HTTP API 的来源写一个精简 MCP 服务器 |
Claude Code | HTTP、SSE、stdio、WebSocket MCP | Anthropic 连接器目录与社区服务器 | 同一个服务器,用 |
Hermes Agent | 具备单服务器工具过滤的 MCP,加上原生技能 | 可一键安装的精选 MCP 目录 | 没有 MCP 时,用技能包住 API |
OpenClaw | MCP 客户端与服务器,加上 A2A JSON-RPC | OpenClaw MCP 注册表与已保存的服务器定义 | 已保存的 MCP 定义,或 A2A 桥接 |
Pi Agent | TypeScript 扩展与技能,没有原生 MCP 客户端 | 默认没有 | 一个把 API 当工具调用的小型扩展 |
Grok Bot | 在 API 请求中声明的远程 MCP 工具 | 你指定的任何远程 MCP 服务器 | 远程 MCP 服务器,连接由 Grok 管理 |
Meta Muse | 连接器,没有公开的 MCP 或 API 界面 | 仅限厂商管理的连接器 | 只能间接处理:feed、实体数据、可检索页面 |
值得注意的模式是这样。七个代理里有五个会说 MCP,而不会说的两个正好在光谱两端。Pi Agent 刻意保持精简,预期你自己写扩展。Meta Muse 则是完全没有开发者界面的消费级产品。
也就是说,最有效率的做法是为你的最高价值来源建一个 MCP 服务器,然后在 Codex、Claude Code、Hermes Agent、OpenClaw、Grok Bot 之间重复使用。你只需要写一次。
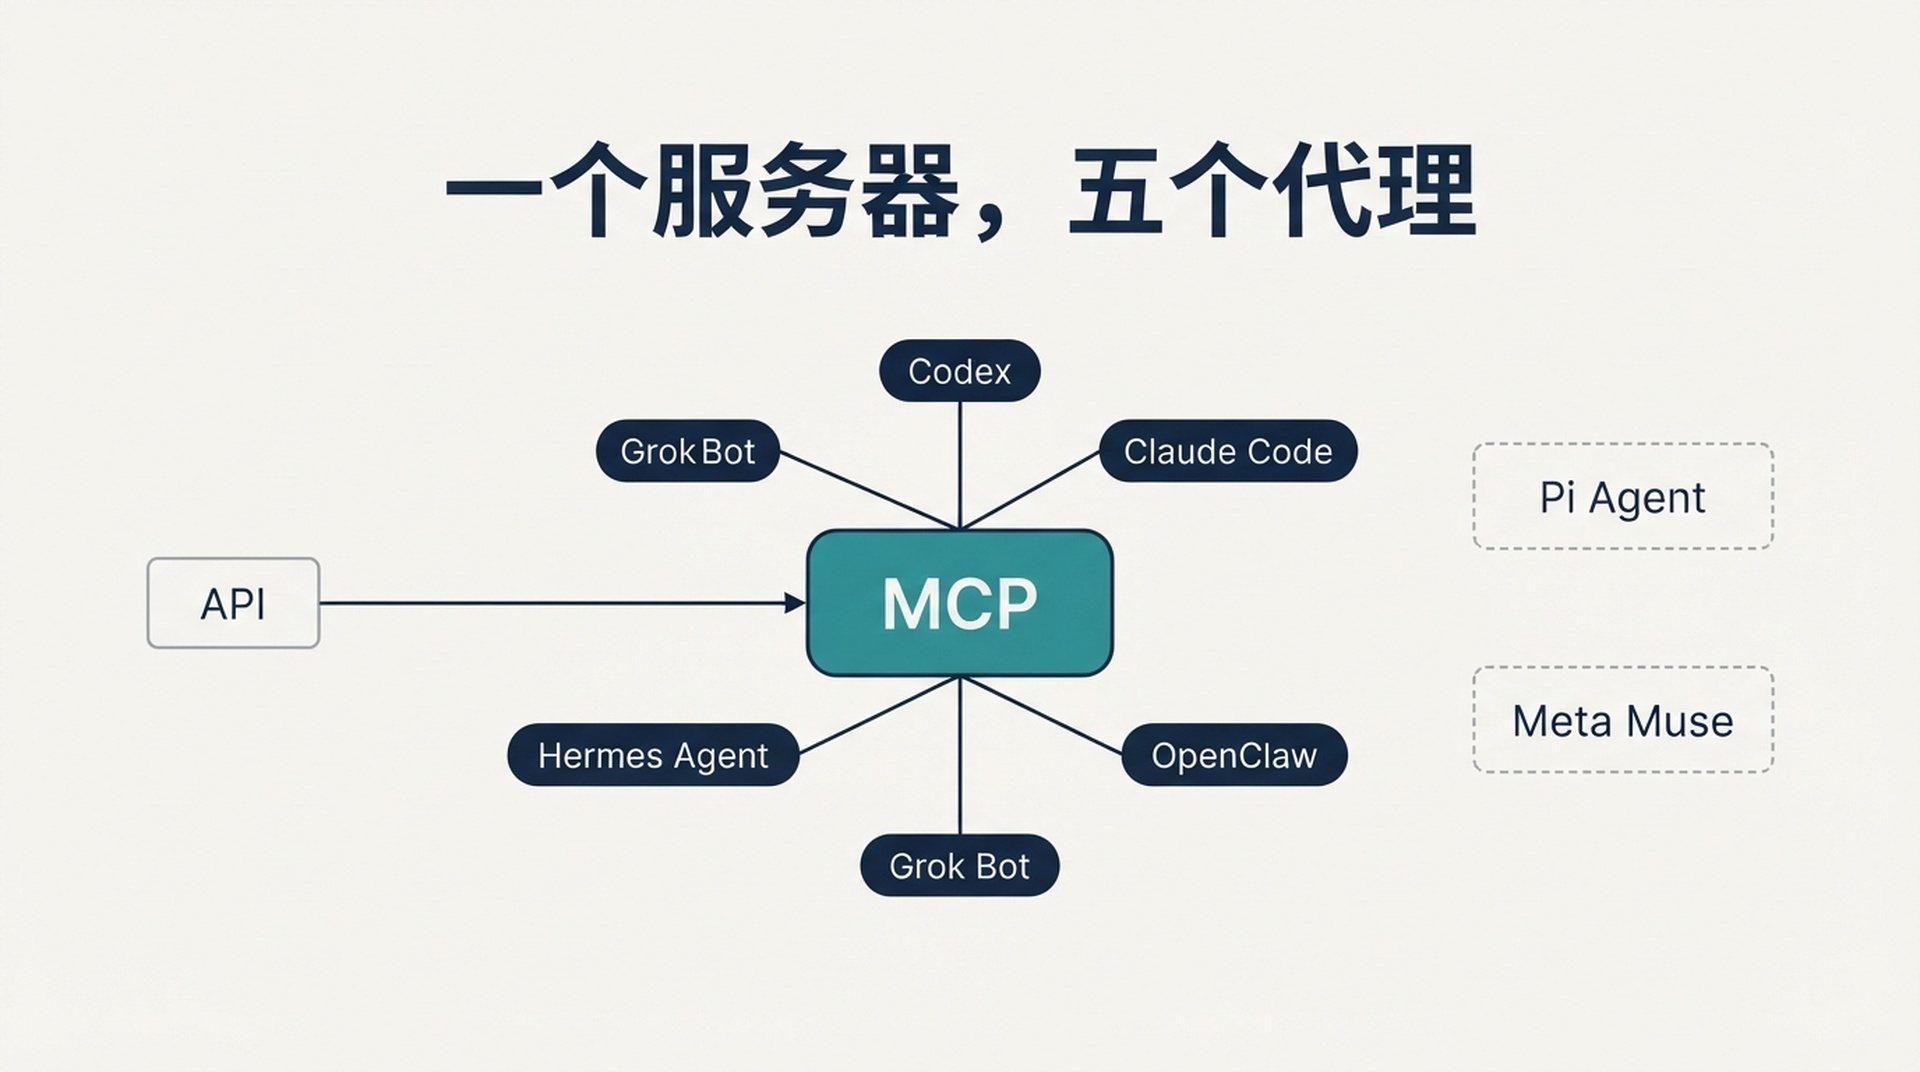
一个服务器就能覆盖七个代理里的五个。Pi Agent 与 Meta Muse 需要不同的路径。
各代理的连接方式
以下步骤假设你已经有要连接的来源的 API 密钥或令牌。不要把凭据放进会被提交的配置文件。
Codex
Codex 把 MCP 配置存在 config.toml,位置是 ~/.codex/config.toml,或项目层级的 .codex/config.toml。ChatGPT 桌面应用、Codex CLI 与 IDE 扩展共用这份配置,所以配置一次就好。
stdio 服务器:
codex mcp add my-source --env API_KEY=your-key -- npx -y @your-org/my-source-mcpstreamable HTTP 服务器,则在 config.toml 加入一个区块:
[mcp_servers.my-source]
url = "https://mcp.example.com/mcp"
bearer_token_env_var = "MY_SOURCE_TOKEN"
Codex 会读取初始化时返回的 MCP instructions 字段,并当成整个服务器的指引。如果你在写服务器,把前 512 个字符写成能自我完备的内容,这样代理在决定是否调用时,最重要的限制就在手边。
用 codex mcp list 确认服务器已注册,并在 TUI 内用 /mcp 查看生效中的服务器。
Claude Code
Claude Code 支持远程 HTTP、远程 SSE、本地 stdio 与远程 WebSocket 传输。远程服务器建议用 HTTP。
claude mcp add --transport http my-source https://mcp.example.com/mcp \
  --header "Authorization: Bearer your-token"
本地服务器:
claude mcp add my-source -- npx -y @your-org/my-source-mcp有两个容易踩到的细节。第一,JSON 配置里有 url 但没有 type 的条目会被当成 stdio 服务器,然后被默默跳过,所以一定要明确写 "type": "http"。第二,Claude Code 会在启动的服务器环境中设置 CLAUDE_PROJECT_DIR,让本地服务器不必依赖工作目录就能解析项目相对路径。
Hermes Agent
Hermes Agent 的标准安装就附带 MCP 支持。配置放在 ~/.hermes/config.yaml:
mcp_servers:
  my-source:
    command: "npx"
    args: ["-y", "@your-org/my-source-mcp"]
Hermes 也在同一份配置中支持远程 HTTP MCP 服务器,并支持单服务器层级的工具过滤,让你只暴露真正想让代理看到的工具。这里的过滤比其他代理更重要,因为 Hermes 会按计划无人执行。
如果你要从 Claude Code 迁移,hermes import-agent claude-code 会把 ~/.claude.json 的 mcpServers 区块映射到 Hermes 配置里的 mcp_servers,同时带过技能与指示。
当某个来源没有对应的 MCP 服务器时,技能系统就是备选方案。技能是一个含有 SKILL.md 的目录,告诉代理何时使用、要做什么。把 API 调用包进随附的脚本,再从技能引用它,代理就得到这项能力,不需要协议服务器。
OpenClaw
OpenClaw 同时是 MCP 客户端与 MCP 服务器。作为客户端,你用 mcp registry 子命令管理已保存的服务器定义,也可以从浏览器 Control UI 设置页面编辑与查看服务器。
openclaw mcp registry add my-source --transport streamable-http --url https://mcp.example.com/mcp
openclaw mcp status
OpenClaw 也能把自己的频道对话通过 MCP 暴露出来,这是反方向,当你想让另一个代理读取 OpenClaw 实例做过什么时很有用。对于不是 MCP 客户端的外部代理,OpenClaw 会说基于 JSON-RPC 的 A2A。
选择 OpenClaw 做这件事的理由是权限模型。它有逐聊天室的工具策略,以及明确的执行审批路径,这正是代理要读取付费数据来源、而你需要限制它能花多少钱时所需要的。
Pi Agent
Pi Agent 没有原生 MCP 客户端,这是设计选择,不是缺口。它的扩展点是在 Pi 进程内运行并注册工具的 TypeScript 模块。
在 ~/.pi/agent/extensions/my-source.ts 创建扩展:
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.registerTool({
    name: "my_source_lookup",
    description: "Look up a record in My Source by query.",
    parameters: { type: "object", properties: { query: { type: "string" } }, required: ["query"] },
    handler: async ({ query }) => {
      const res = await fetch(`https://api.example.com/search?q=${encodeURIComponent(query)}`, {
        headers: { Authorization: `Bearer ${process.env.MY_SOURCE_TOKEN}` },
      });
      return await res.json();
    },
  });
}
开发时用 pi --extension ./my-source.ts 直接加载,稳定后再移到扩展目录,或用 pi install 打包。
取舍很真实,也值得直说。扩展以与 Pi 进程相同的操作系统权限运行,能查看提示、工具调用、文件与凭据。只加载你信任来源的扩展,并在安装前读过源码。
Grok Bot
Grok 的 API 支持远程 MCP 工具,服务器连接由 xAI 代为管理。你在请求的 tools 数组中声明服务器:
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import mcp

client = Client(api_key=os.getenv("XAI_API_KEY"))
chat = client.chat.create(
    model="grok-4.7",
    tools=[mcp(server_url="https://mcp.example.com/mcp", server_label="my-source")],
)
远程 MCP 工具只支持 streaming HTTP 与 SSE 传输。你可以用 allowed_tools 限制暴露哪些工具,并传入授权令牌,由 xAI 设置在发往你服务器的 Authorization 标头。
好处是你不需要自己运行或维护客户端连接。缺点是 MCP 服务器必须公开可触达,所以任何在 VPN 后面的东西都得换一种做法。
Meta Muse
Muse 通过连接器连接第三方应用与服务,而代理本身没有公开的 MCP 或开发者 API 界面。这是诚实的答案,也改变了你能做的事。
你无法像其他六个代理那样,把 Muse 接进监控流程。你能做的是让 Muse 读取的来源更好。如果你卖商品,就是正确的商品与目录数据;如果你是本地商家,就是完整且一致的商家信息;如果你是发布者,就是具备清楚实体信号的可检索页面。Muse 是准备工作的对象,不是你能查询的数据来源。
如果 Meta 为 Muse 推出开发者界面,这一节就会改变。在那之前,把它当成要预先准备的受众,而不是要集成的系统。
建一个服务器,重复使用五次
如果你要动手做,就为价值最高的那一个来源建 MCP 服务器,然后重复使用。上面五个支持 MCP 的代理都接受 streamable HTTP 服务器,所以一次部署就能全部覆盖。
最小可行的服务器需要四件事:一个接受查询并返回结构化数据的工具、服务器端的 bearer token 检查、一道速率限制让暴走的代理烧不掉你的 API 配额,以及一个在前 512 个字符内说明限制的 instructions 字段。
两条能避免大部分痛苦的规则。返回结构化数据而不是散文,让代理能对字段推理,而不是重新解析文字。还有,在你看过代理跑完一个完整周期之前,把每个工具都设成只读。只读服务器什么都弄不坏,等你看过实际调用模式再放宽。
信任之前先验证连接
不要假设配置好的服务器就是能用的服务器。跑这四项检查。
确认服务器已注册。codex mcp list、claude mcp list 或 openclaw mcp status 应该要显示它。解析失败的服务器在某些客户端会被默默跳过。
确认工具清单。请代理列出服务器暴露的工具。如果你预期六个却只看到一个,代表服务器注册了但工具没有。
用真实查询确认。要一条你能手动核对的记录。问“你能获取什么数据”这种泛泛问题,什么都证明不了。
确认失败路径。撤销令牌再跑一次查询。你要的是清楚的验证错误,而不是无声的空结果。把失败调用当成“没有数据”的代理,会对断掉的连接回报干净的结果,而那是整套流程里最贵的失败模式。
四项检查。最后一项抓到的,是看起来像发现的失败。
这对优先级带来什么改变
层级表和连接表指向同一个方向。你能接进代理的来源,就是你能衡量的来源;而你能衡量的来源,就是你能对照基准改善的来源。
也就是说,工作顺序和多数团队用的顺序不同。从同时具备已文档化连接、又对你的业务有实际影响的来源开始。本地商家是 Google Business Profile 与 Maps grounding。商品公司是 Merchant Center 或商品 feed。开发者工具公司是文档质量。发布者是实时页面的可检索性与可抽取性。
接着建一个把该来源送进代理的 MCP 服务器,并在五个会说该协议的代理之间重复使用。把没有连接路径的来源留给内容与实体工作,并诚实承认你无法用同样的方式衡量它们。
在这里领先的团队,不是来源清单最长的那个。而是接上了真正重要的两、三个来源,并围绕它们建立监控循环的那个。
常见问题
要让代理获取数据来源,一定需要 MCP 吗?不用。MCP 是多数代理现在支持的标准,也是最容易重复使用的选项,但一个附带 API 脚本的技能,对单一代理同样可行。如果你是把一个来源接到一个代理,用技能比较省事。如果你是把一个来源接到五个代理,MCP 马上就回本。
我该从哪个代理开始?从最贴近你工作现状的那个开始。网站放在 git 仓库,就选 Codex 或 Claude Code。想要有持久记忆的定时执行,就选 Hermes Agent。需要对付费数据来源设下严格权限边界,就选 OpenClaw。想要一个能一次读完、可审计的最小界面,就选 Pi Agent。
我可以连接没有 MCP 服务器的来源吗?可以,有三种做法。如果来源有 HTTP API,而你想在多个代理之间重复使用,就写一个精简的 MCP 服务器。如果只需要一个代理,就写一个附带脚本的技能。或者用支持远程 MCP 工具的代理,指向别人托管的服务器。
为什么我无法连接 Meta Muse? Meta 尚未为 Muse 发布开发者 API 或 MCP 界面。连接器由厂商管理。在那之前,Muse 是要为它准备内容与数据的界面,不是你能查询的系统。
层级归类是永久的吗?不是。这个品类每个月都在变。在让团队投入某个流程之前,先重新确认厂商文档,并把超过一季的层级归类当成未验证。
这项工作最常见的错误是什么?把失败的 API 调用当成真正的零。如果代理回报某个品牌没有 AI 可见度,而根本原因是令牌过期,那就是一场看起来像发现的衡量失败。永远在信任成功路径之前,先测试失败路径。
Author: Julian Mercer,Auspia 的 14 年经验技术 SEO 实务工作者。他撰写关于可检索性、结构定义、渲染,以及让内容同时被搜索引擎与 AI 代理读懂的技术基础。