大多數追蹤 AI 能見度的團隊,到現在還是靠截圖。他們向 ChatGPT 丟出一個問題,複製引用,再貼進文件裡。這樣只能知道某個下午、某一個模型說了些什麼。你無從得知答案引擎實際上能觸及哪些來源,也無法讓代理自己去查詢。
這項工作更有用的形式,是來源地圖加上連接路徑。你先決定哪些資料來源對你的類別重要,再把觸及得到的來源直接接進負責監控的代理。剩下的,是一份你只能間接影響的來源短名單,而那份名單通常比你想的還短。
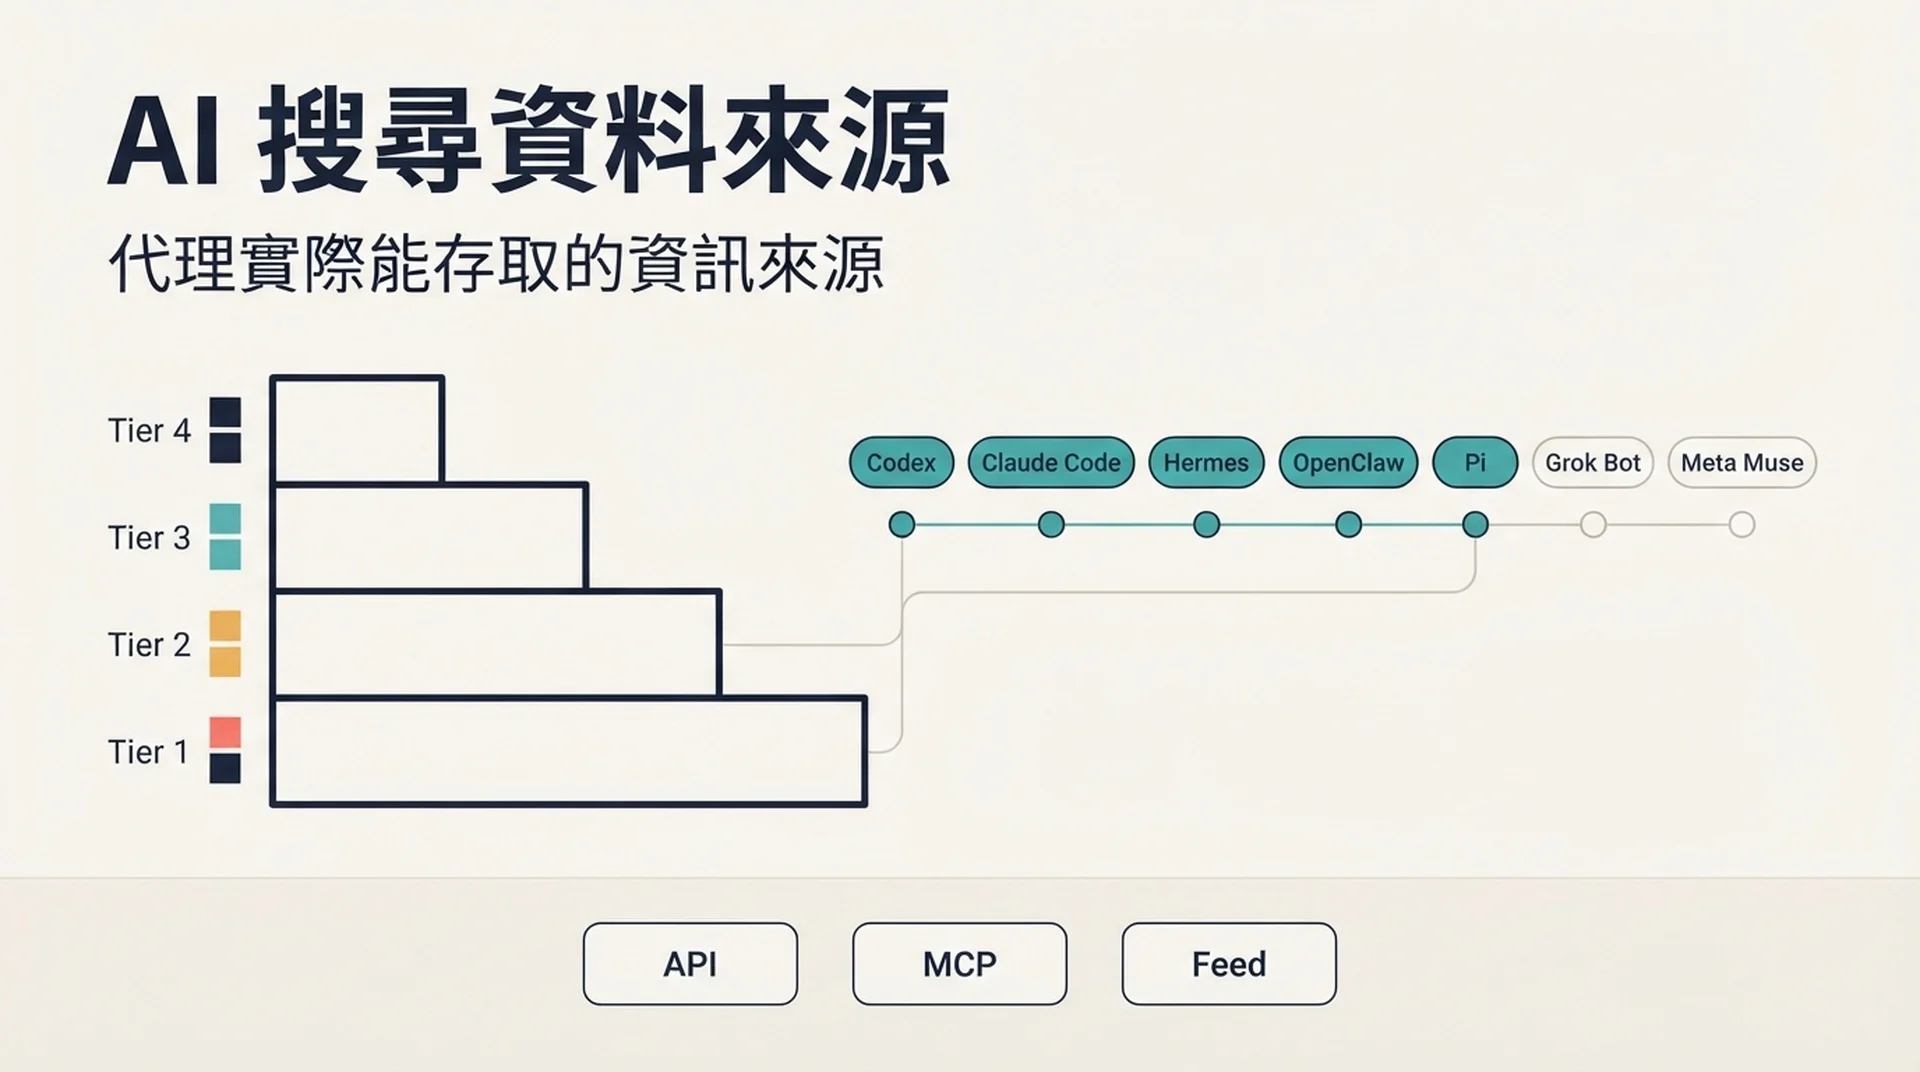
這篇文章處理三件事。它依照證據有多確定、有多即時,把支撐 AI 答案的資料來源分成層級。它為有連接路徑的來源,給出具體的 API 或 MCP 路徑。它也逐一說明 Codex、Claude Code、Hermes Agent、OpenClaw、Pi Agent、Grok Bot、Meta Muse 的連接方式,包括沒有現成連接器、必須自己搭橋的情況。
簡短答案
支撐 AI 答案的來源分成四類,觸及難度並不一樣。
網頁與搜尋探索類的來源,可透過 grounding API 以及你自己可被檢索的頁面觸及。結構化的商務饋送可透過已文件化的饋送規格觸及,但存取受到審核限制。知識與社群語料庫,一部分可透過授權 API 觸及,一部分鎖在你無法影響的訓練期收錄背後。代理動作介面則可透過仍在成形的協定規格觸及。
換成代理驅動的監控工作流程,就成了實用規則。有已文件化 API 或 MCP 伺服器的,就接上。有饋送規格的,當成資料品質專案處理。兩者都沒有的,就當成內容與實體專案,而不是資料專案。
怎麼讀這張層級表
以下層級依兩件事分類:這個來源目前支撐 AI 答案的證據有多強,以及那條連接是現行的還是歷史性的。這正是大多數來源清單出錯的地方。2022 年形塑過某個模型的來源,和今天某個模型會去查詢的來源,是兩回事,混為一談就會做出錯誤策略。
層級 | 意義 | 對工作流程的意義 |
|---|---|---|
1 | 已確認且現行 | 即時 grounding、檢索或動作。接上它、監控它、為它最佳化。 |
2 | 已確認且現行 | 訓練或授權。你能透過內容與合作影響它,而不是透過 API。 |
3 | 已確認的歷史資料 | 僅限預訓練。沒有即時槓桿。不要圍繞它建立監控流程。 |
4 | 證據強但未確認 | 類別推論。值得觀察,還不值得編列預算。 |
看表之前先提醒一點。這個類別每個月都在變。廠商文件、授權合約、饋送規格全都在動。把層級歸類當成起點,在讓團隊投入某個流程之前,先回到廠商自己的文件重新確認。
層級 1:代理真的觸及得到的即時來源
這裡是目前有已文件化連接的來源。如果你的代理要自己抓取 AI 能見度資料,就從這裡開始。
網頁與搜尋探索
Google Search grounding。Gemini API 提供 google_search 工具,把模型連上即時網頁內容,並回傳指向來源網址的引用。這是有文件、現行有效,也是市場上最清楚的即時 grounding 範例。也就是說,槓桿是你的可檢索性與頁面結構,而不是饋送。
Bing Search。Microsoft 的文件說明 Bing 結果被用來強化 Copilot 的回應。實務上的意義和 Google 一樣:想被看見,頁面就得能被觸及、能被擷取。
即時發佈者頁面。是在推論時透過搜尋 grounding 觸及,而不是預訓練。檢索結果的選擇與可檢索性決定是否被收錄,這也是為什麼技術 SEO 的工作會反映在 AI 能見度結果上。
產品與購物
Google Merchant Center。商家饋送資料支撐 Google 的購物介面。如果你賣實體商品卻不在 Merchant Center 裡,你就缺席了一個正被積極接進 AI 答案的介面。
OpenAI 商家與零售饋送。商家分享結構化的商品饋送,Agentic Commerce Protocol 文件說明了結構定義、檔案上傳與 API 兩種整合路徑,以及一天之內可接受更新的更新頻率。存取目前限於已核准的合作夥伴,所以這是有前置時間的專案,不是打開開關就好。
在地與地點
Google Maps grounding。與 Search grounding 並列為已文件化的工具,為模型提供地理脈絡。這就是為什麼擁有正確、完整檔案資訊的在地商家,會出現在關於附近選項的 AI 答案裡。
Google Business Profile。商家檔案資料支撐 Google 的在地介面。對在地商家來說,這是清單上槓桿最高、投入最低的來源之一。
Yelp。Yelp 授權評論、照片與商家資訊用於即時在地推薦,而這層關係不只 grounding,還延伸到動作。這是少數同時是引用來源、也是交易介面的評論平台。
知識與參考
Wikipedia 與 Wikimedia。出現在已揭露的預訓練混合資料中,也被廣泛當作即時參考語料庫使用。授權條件異常清楚,讓它成為實體工作的正當目標。
社群、問答與社交
Reddit。透過資料授權協議成為即時 grounding 來源,訓練那一側則另有報導。把續約狀態當成不穩定因素,不要建立假設能永久存取的流程。
層級 2 與 3:你能影響、但不能查詢的來源
這些很重要,但不是透過代理能呼叫的 API。
授權的發佈者內容。與主要出版社之間存在多項明確的授權合作,條件依合作對象而異,涵蓋訓練、grounding 與標註。小網站無法花錢擠進這份名單,但你可以成為那種在授權語料庫對你的主題著墨不足時被引用的來源。
開發者與技術來源。公開程式碼儲存庫與技術文件語料庫是已確認的現行來源。對開發者工具公司來說,這是清單上價值最高的層級,而它是透過文件品質觸及,不是透過饋送。
歷史網頁語料庫。常見爬取資料的清理衍生版本與類似封存。已確認的歷史資料,沒有即時槓桿。用來理解模型為何帶有某種先驗很有用,但不適合監控流程。
連接層:每個代理能觸及什麼
這裡是這篇文章的重點。下表把每個代理實際支援的連接機制,對上上述來源的現成連接器實況。
代理 | 連接機制 | 現成來源連接器 | 你要自己建的東西 |
|---|---|---|---|
Codex | 於 | 持續成長的社群 MCP 伺服器登錄庫 | 為任何有 HTTP API 的來源寫一個精簡 MCP 伺服器 |
Claude Code | HTTP、SSE、stdio、WebSocket MCP | Anthropic 連接器目錄與社群伺服器 | 同一個伺服器,用 |
Hermes Agent | 具備單一伺服器工具篩選的 MCP,加上原生技能 | 可一鍵安裝的精選 MCP 目錄 | 沒有 MCP 時,用技能包住 API |
OpenClaw | MCP 客戶端與伺服器,加上 A2A JSON-RPC | OpenClaw MCP 登錄庫與已儲存的伺服器定義 | 已儲存的 MCP 定義,或 A2A 橋接 |
Pi Agent | TypeScript 擴充與技能,沒有原生 MCP 客戶端 | 預設沒有 | 一個把 API 當工具呼叫的小型擴充 |
Grok Bot | 在 API 請求中宣告的遠端 MCP 工具 | 你指定的任何遠端 MCP 伺服器 | 遠端 MCP 伺服器,連線由 Grok 管理 |
Meta Muse | 連接器,沒有公開的 MCP 或 API 介面 | 僅限廠商管理的連接器 | 只能間接處理:饋送、實體資料、可檢索頁面 |
值得注意的模式是這樣。七個代理裡有五個會說 MCP,而不會說的兩個正好在光譜兩端。Pi Agent 刻意保持精簡,預期你自己寫擴充。Meta Muse 則是完全沒有開發者介面的消費級產品。
也就是說,最有效率的做法是為你價值最高的來源建一個 MCP 伺服器,然後在 Codex、Claude Code、Hermes Agent、OpenClaw、Grok Bot 之間重複使用。你只需要寫一次。
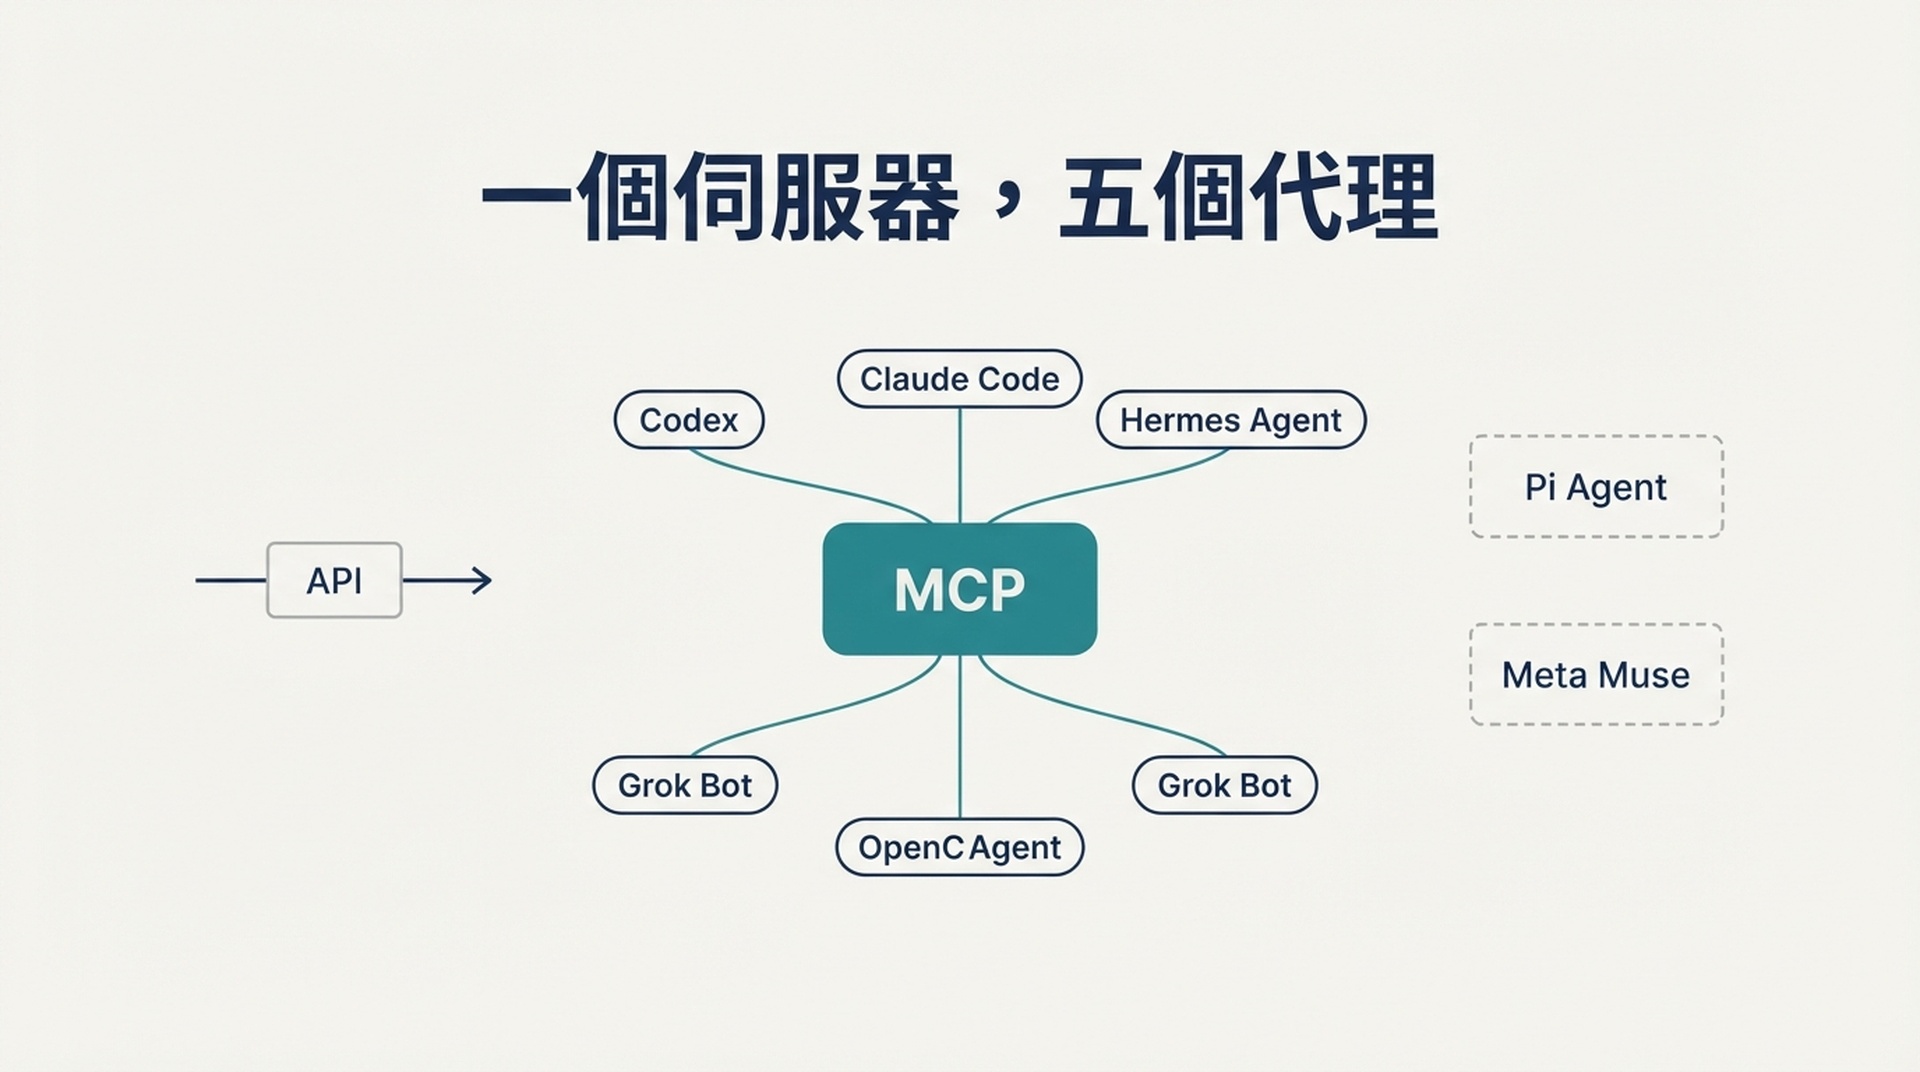
一個伺服器就能涵蓋七個代理裡的五個。Pi Agent 與 Meta Muse 需要不同的路徑。
各代理的連接方式
以下步驟假設你已經有要連接的來源的 API 金鑰或權杖。不要把憑證放進會被提交的設定檔。
Codex
Codex 把 MCP 設定存在 config.toml,位置是 ~/.codex/config.toml,或專案層級的 .codex/config.toml。ChatGPT 桌面應用程式、Codex CLI 與 IDE 擴充共用這份設定,所以設定一次就好。
stdio 伺服器:
codex mcp add my-source --env API_KEY=your-key -- npx -y @your-org/my-source-mcpstreamable HTTP 伺服器,則在 config.toml 加入一個區塊:
[mcp_servers.my-source]
url = "https://mcp.example.com/mcp"
bearer_token_env_var = "MY_SOURCE_TOKEN"
Codex 會讀取初始化時回傳的 MCP instructions 欄位,並當成整個伺服器的指引。如果你在寫伺服器,把前 512 個字元寫成能自我完備的內容,這樣代理在決定是否呼叫時,最重要的限制就在手邊。
用 codex mcp list 確認伺服器已註冊,並在 TUI 內用 /mcp 查看作用中的伺服器。
Claude Code
Claude Code 支援遠端 HTTP、遠端 SSE、本機 stdio 與遠端 WebSocket 傳輸。遠端伺服器建議用 HTTP。
claude mcp add --transport http my-source https://mcp.example.com/mcp \
  --header "Authorization: Bearer your-token"
本機伺服器:
claude mcp add my-source -- npx -y @your-org/my-source-mcp有兩個容易踩到的細節。第一,JSON 設定裡有 url 但沒有 type 的項目會被當成 stdio 伺服器,然後被默默跳過,所以一定要明確寫 "type": "http"。第二,Claude Code 會在啟動的伺服器環境中設定 CLAUDE_PROJECT_DIR,讓本機伺服器不必依賴工作目錄就能解析專案相對路徑。
Hermes Agent
Hermes Agent 的標準安裝就附帶 MCP 支援。設定放在 ~/.hermes/config.yaml:
mcp_servers:
  my-source:
    command: "npx"
    args: ["-y", "@your-org/my-source-mcp"]
Hermes 也在同一份設定中支援遠端 HTTP MCP 伺服器,並支援單一伺服器層級的工具篩選,讓你只暴露真正想讓代理看到的工具。這裡的篩選比其他代理更重要,因為 Hermes 會依排程無人執行。
如果你要從 Claude Code 移轉,hermes import-agent claude-code 會把 ~/.claude.json 的 mcpServers 區塊對應到 Hermes 設定裡的 mcp_servers,同時帶過技能與指示。
當某個來源沒有對應的 MCP 伺服器時,技能系統就是備案。技能是一個含有 SKILL.md 的目錄,告訴代理何時使用、要做什麼。把 API 呼叫包進隨附的腳本,再從技能引用它,代理就得到這項能力,不需要協定伺服器。
OpenClaw
OpenClaw 同時是 MCP 客戶端與 MCP 伺服器。作為客戶端,你用 mcp registry 子指令管理已儲存的伺服器定義,也可以從瀏覽器 Control UI 設定頁面編輯與檢視伺服器。
openclaw mcp registry add my-source --transport streamable-http --url https://mcp.example.com/mcp
openclaw mcp status
OpenClaw 也能把自己的頻道對話透過 MCP 暴露出來,這是反方向,當你想讓另一個代理讀取 OpenClaw 實例做過什麼時很有用。對於不是 MCP 客戶端的外部代理,OpenClaw 會說基於 JSON-RPC 的 A2A。
選擇 OpenClaw 做這件事的理由是權限模型。它有逐聊天室的工具政策,以及明確的執行核准路徑,這正是代理要讀取付費資料來源、而你需要限制它能花多少錢時所需要的。
Pi Agent
Pi Agent 沒有原生 MCP 客戶端,這是設計選擇,不是缺口。它的擴充點是在 Pi 行程內執行並註冊工具的 TypeScript 模組。
在 ~/.pi/agent/extensions/my-source.ts 建立擴充:
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.registerTool({
    name: "my_source_lookup",
    description: "Look up a record in My Source by query.",
    parameters: { type: "object", properties: { query: { type: "string" } }, required: ["query"] },
    handler: async ({ query }) => {
      const res = await fetch(`https://api.example.com/search?q=${encodeURIComponent(query)}`, {
        headers: { Authorization: `Bearer ${process.env.MY_SOURCE_TOKEN}` },
      });
      return await res.json();
    },
  });
}
開發時用 pi --extension ./my-source.ts 直接載入,穩定後再移到擴充目錄,或用 pi install 打包。
取捨很真實,也值得直說。擴充以與 Pi 行程相同的作業系統權限執行,能檢視提示、工具呼叫、檔案與憑證。只載入你信任來源的擴充,並在安裝前讀過原始碼。
Grok Bot
Grok 的 API 支援遠端 MCP 工具,伺服器連線由 xAI 代為管理。你在請求的 tools 陣列中宣告伺服器:
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import mcp

client = Client(api_key=os.getenv("XAI_API_KEY"))
chat = client.chat.create(
    model="grok-4.7",
    tools=[mcp(server_url="https://mcp.example.com/mcp", server_label="my-source")],
)
遠端 MCP 工具只支援 streaming HTTP 與 SSE 傳輸。你可以用 allowed_tools 限制暴露哪些工具,並傳入授權權杖,由 xAI 設定在送往你伺服器的 Authorization 標頭。
好處是你不需要自己執行或維護客戶端連線。缺點是 MCP 伺服器必須公開可觸及,所以任何在 VPN 後面的東西都得換一種做法。
Meta Muse
Muse 透過連接器連接第三方應用程式與服務,而代理本身沒有公開的 MCP 或開發者 API 介面。這是誠實的答案,也改變了你能做的事。
你無法像其他六個代理那樣,把 Muse 接進監控流程。你能做的是讓 Muse 讀取的來源更好。如果你賣商品,就是正確的商品與目錄資料;如果你是在地商家,就是完整且一致的商家資訊;如果你是發佈者,就是具備清楚實體訊號的可檢索頁面。Muse 是準備工作的對象,不是你能查詢的資料來源。
如果 Meta 為 Muse 推出開發者介面,這一節就會改變。在那之前,把它當成要預先準備的受眾,而不是要整合的系統。
建一個伺服器,重複使用五次
如果你要動手做,就為價值最高的那一個來源建 MCP 伺服器,然後重複使用。上面五個支援 MCP 的代理都接受 streamable HTTP 伺服器,所以一次部署就能全部涵蓋。
最小可行的伺服器需要四件事:一個接受查詢並回傳結構化資料的工具、伺服器端的 bearer token 檢查、一道速率限制讓暴走的代理燒不掉你的 API 額度,以及一個在前 512 個字元內說明限制的 instructions 欄位。
兩條能避免大部分痛苦的規則。回傳結構化資料而不是散文,讓代理能對欄位推理,而不是重新解析文字。還有,在你看過代理跑完一個完整週期之前,把每個工具都設成唯讀。唯讀伺服器什麼都弄不壞,等你看過實際呼叫模式再放寬。
信任之前先驗證連線
不要假設設定好的伺服器就是能用的伺服器。跑這四項檢查。
確認伺服器已註冊。codex mcp list、claude mcp list 或 openclaw mcp status 應該要顯示它。解析失敗的伺服器在某些客戶端會被默默跳過。
確認工具清單。請代理列出伺服器暴露的工具。如果你預期六個卻只看到一個,代表伺服器註冊了但工具沒有。
用真實查詢確認。要一筆你能手動核對的具體紀錄。問「你能取得什麼資料」這種泛泛問題,什麼都證明不了。
確認失敗路徑。撤銷權杖再跑一次查詢。你要的是清楚的驗證錯誤,而不是無聲的空結果。把失敗呼叫當成「沒有資料」的代理,會對斷掉的連線回報乾淨的結果,而那是整套流程裡最貴的失敗模式。
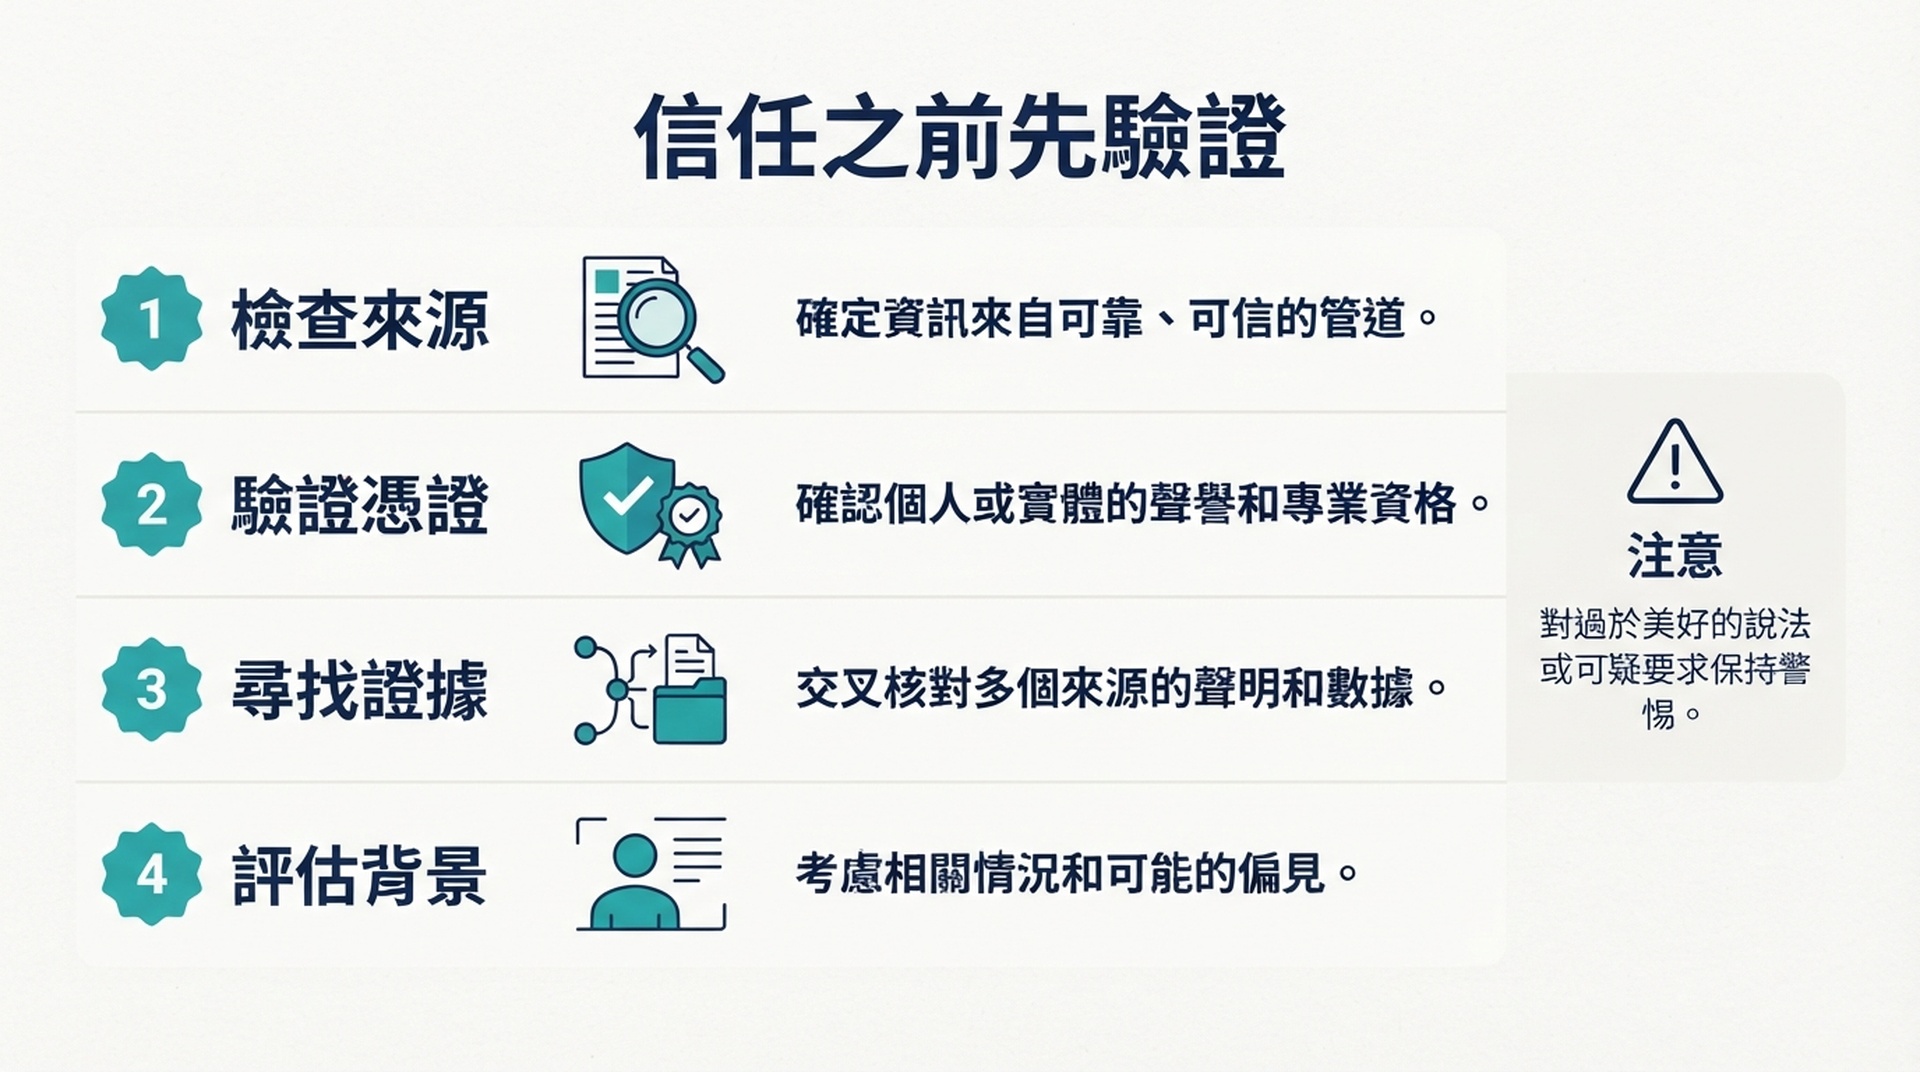
四項檢查。最後一項抓到的,是看起來像發現的失敗。
這對優先順序帶來什麼改變
層級表和連接表指向同一個方向。你能接進代理的來源,就是你能衡量的來源;而你能衡量的來源,就是你能對照基準改善的來源。
也就是說,工作順序和多數團隊用的順序不同。從同時具備已文件化連接、又對你的業務有實際影響的來源開始。在地商家是 Google Business Profile 與 Maps grounding。商品公司是 Merchant Center 或商品饋送。開發者工具公司是文件品質。發佈者是即時頁面的可檢索性與可擷取性。
接著建一個把該來源送進代理的 MCP 伺服器,並在五個會說該協定的代理之間重複使用。把沒有連接路徑的來源留給內容與實體工作,並誠實承認你無法用同樣的方式衡量它們。
在這裡領先的團隊,不是來源清單最長的那個。而是接上了真正重要的兩、三個來源,並圍繞它們建立監控迴圈的那個。
常見問題
要讓代理取得資料來源,一定需要 MCP 嗎?不用。MCP 是多數代理現在支援的標準,也是最容易重複使用的選項,但一個附帶 API 腳本的技能,對單一代理同樣可行。如果你是把一個來源接到一個代理,用技能比較省事。如果你是把一個來源接到五個代理,MCP 馬上就回本。
我該從哪個代理開始?從最貼近你工作現況的那個開始。網站放在 git 儲存庫,就選 Codex 或 Claude Code。想要有持久記憶的排程執行,就選 Hermes Agent。需要對付費資料來源設下嚴格權限邊界,就選 OpenClaw。想要一個能一次讀完、可稽核的最小介面,就選 Pi Agent。
我可以連接沒有 MCP 伺服器的來源嗎?可以,有三種做法。如果來源有 HTTP API,而你想在多個代理之間重複使用,就寫一個精簡的 MCP 伺服器。如果只需要一個代理,就寫一個附帶腳本的技能。或者用支援遠端 MCP 工具的代理,指向別人代管的伺服器。
為什麼我無法連接 Meta Muse? Meta 尚未為 Muse 發布開發者 API 或 MCP 介面。連接器由廠商管理。在那之前,Muse 是要為它準備內容與資料的介面,不是你能查詢的系統。
層級歸類是永久的嗎?不是。這個類別每個月都在變。在讓團隊投入某個流程之前,先重新確認廠商文件,並把超過一季的層級歸類當成未驗證。
這項工作最常見的錯誤是什麼?把失敗的 API 呼叫當成真正的零。如果代理回報某個品牌沒有 AI 能見度,而根本原因是權杖過期,那就是一場看起來像發現的衡量失敗。永遠在信任成功路徑之前,先測試失敗路徑。
Author: Julian Mercer,Auspia 的 14 年經驗技術 SEO 實務工作者。他撰寫關於可檢索性、結構定義、算繪,以及讓內容同時被搜尋引擎與 AI 代理讀懂的技術基礎。