AI दृश्यता ट्रैक करने वाली ज़्यादातर टीमें आज भी स्क्रीनशॉट पर काम कर रही हैं। वे ChatGPT से एक सवाल पूछती हैं, साइटेशन कॉपी करती हैं और उन्हें एक डॉक्यूमेंट में पेस्ट कर देती हैं। इससे पता चलता है कि एक मॉडल ने एक दोपहर में क्या कहा। इससे यह नहीं पता चलता कि आंसर इंजन वास्तव में किन स्रोतों तक पहुँच सकता है, और इससे आपके एजेंट को अपने आप क्वेरी करने के लिए कुछ नहीं मिलता।
इस काम का ज़्यादा उपयोगी रूप है स्रोत-मानचित्र के साथ कनेक्शन पथ। आप तय करते हैं कि आपकी श्रेणी के लिए कौन-से डेटा स्रोत मायने रखते हैं, और फिर जिन तक आप पहुँच सकते हैं उन्हें सीधे उस एजेंट से जोड़ देते हैं जो आपकी मॉनिटरिंग चलाता है। जो बचता है वह उन स्रोतों की छोटी सूची है जिन्हें आप केवल अप्रत्यक्ष रूप से प्रभावित कर सकते हैं, और वह सूची आमतौर पर लोगों की अपेक्षा से छोटी होती है।
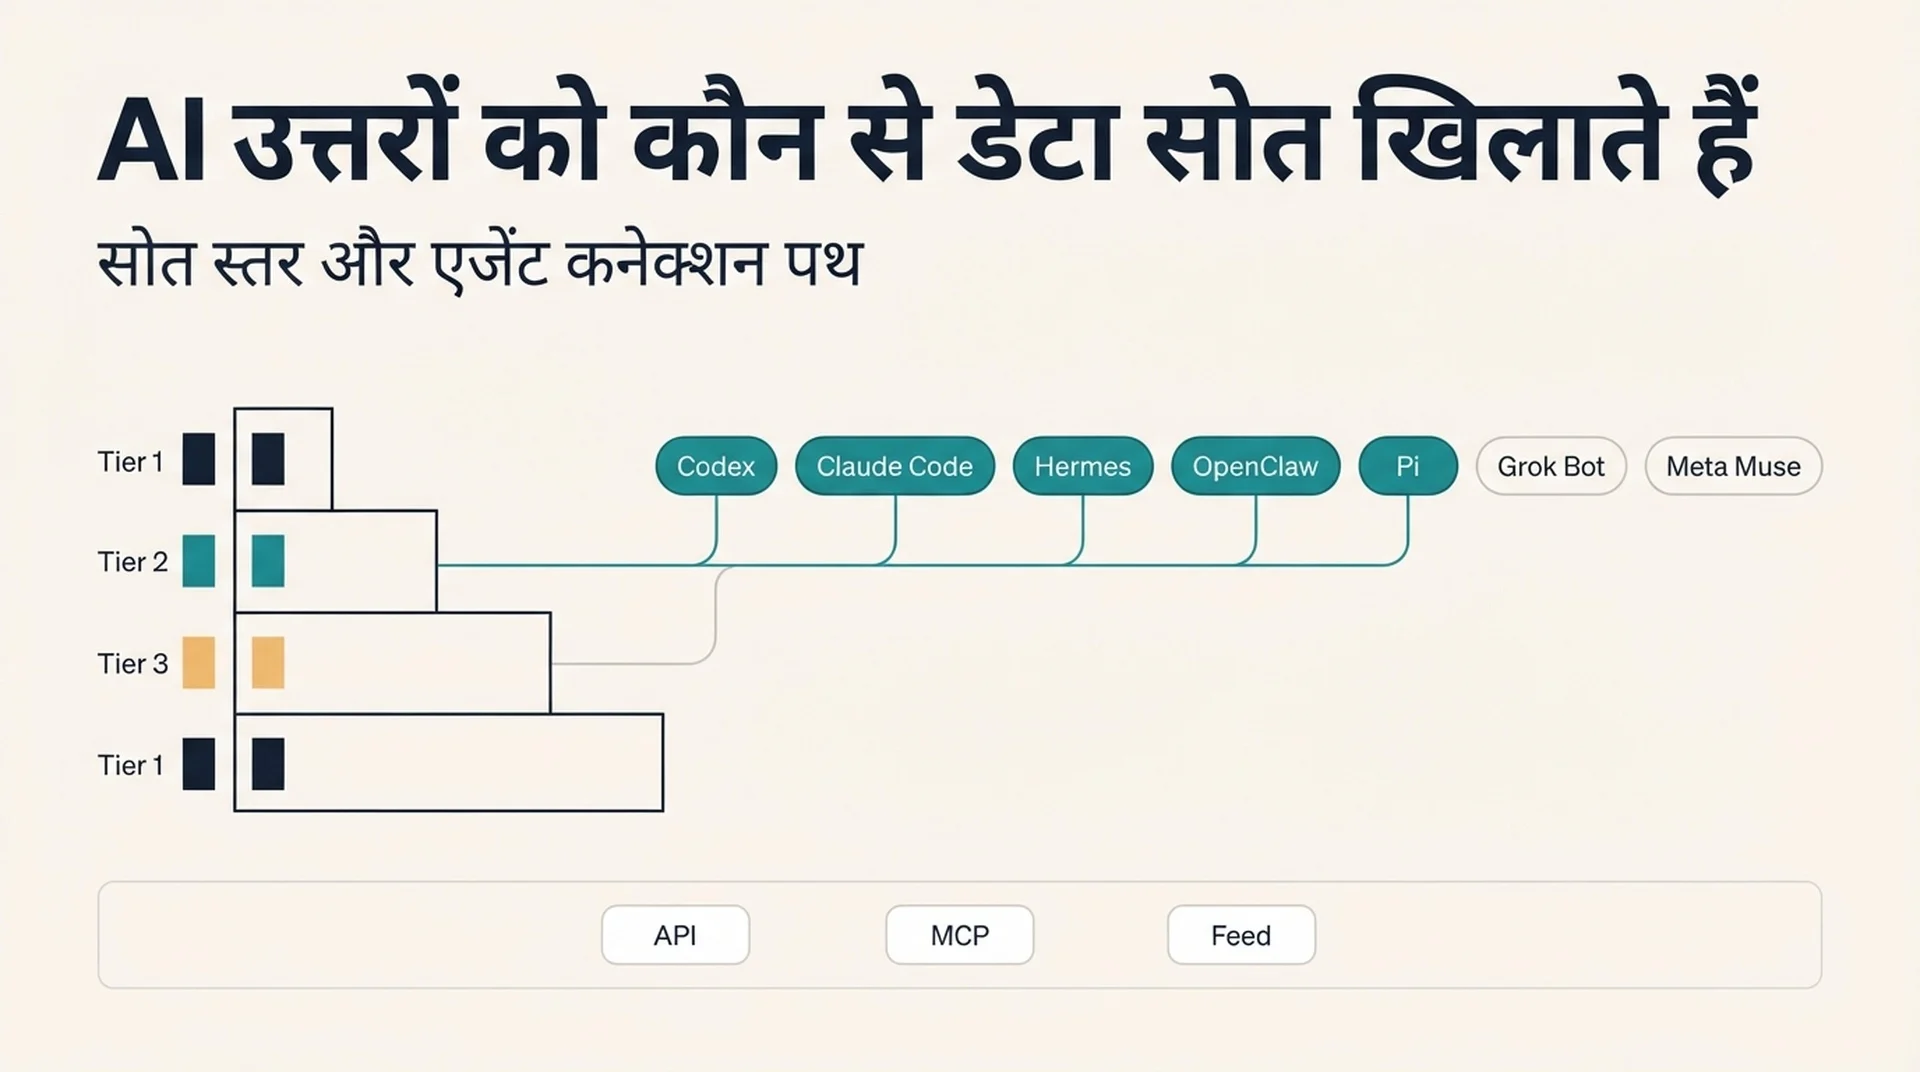
यह लेख तीन काम करता है। यह AI उत्तरों के पीछे के डेटा स्रोतों को इस आधार पर स्तरों में बाँटता है कि सबूत कितने पुष्ट और कितने ताज़ा हैं। यह उन स्रोतों के लिए ठोस API या MCP पथ देता है जिनके पास वह है। और यह Codex, Claude Code, Hermes Agent, OpenClaw, Pi Agent, Grok Bot और Meta Muse के लिए कनेक्शन का तरीका समझाता है, उन मामलों सहित जहाँ कोई तैयार कनेक्टर नहीं है और पुल खुद बनाना पड़ता है।
छोटा जवाब
AI उत्तरों को चार श्रेणियों के स्रोत खिलाते हैं, और उन तक पहुँच बराबर नहीं है।
वेब और सर्च डिस्कवरी स्रोत ग्राउंडिंग API के ज़रिए और आपके अपने क्रॉल-योग्य पेजों के ज़रिए पहुँच में हैं। संरचित व्यावसायिक फ़ीड्स डॉक्यूमेंटेड फ़ीड स्पेक्स के ज़रिए पहुँच में हैं, लेकिन पहुँच मंज़ूरी से बँधी है। ज्ञान और समुदाय के कॉर्पस आंशिक रूप से लाइसेंस प्राप्त API के ज़रिए पहुँच में हैं और आंशिक रूप से ट्रेनिंग-समय के अंतर्ग्रहण के पीछे बंद हैं, जिस पर आपका कोई नियंत्रण नहीं है। एजेंट एक्शन सरफ़ेस उन प्रोटोकॉल स्पेक्स के ज़रिए पहुँच में हैं जो अभी स्थिर हो रहे हैं।
एजेंट-संचालित मॉनिटरिंग वर्कफ़्लो में यह एक व्यावहारिक नियम बन जाता है। जिसके पास डॉक्यूमेंटेड API या MCP सर्वर है उसे जोड़ें। जिसके पास फ़ीड स्पेक है उसे डेटा-गुणवत्ता प्रोजेक्ट मानें। जिसके पास दोनों में से कुछ नहीं है उसे डेटा प्रोजेक्ट नहीं, बल्कि कंटेंट और एंटिटी प्रोजेक्ट मानें।
स्तर तालिका कैसे पढ़ें
नीचे दिए स्तर स्रोतों को इस आधार पर क्रमबद्ध करते हैं कि वे आज AI उत्तरों को खिलाते हैं इसके सबूत कितने मज़बूत हैं, और यह कनेक्शन जीवित है या ऐतिहासिक। यही वह हिस्सा है जहाँ ज़्यादातर स्रोत-सूचियाँ ग़लती करती हैं। जिस स्रोत ने 2022 में किसी मॉडल को आकार दिया और जिस स्रोत से मॉडल आज क्वेरी करता है, वे अलग चीज़ें हैं, और इन्हें मिला देना ख़राब रणनीति बनाता है।
स्तर | अर्थ | आपके वर्कफ़्लो के लिए इसका मतलब |
|---|---|---|
1 | पुष्ट और मौजूदा | जीवित ग्राउंडिंग, रिट्रीवल या एक्शन। इसे जोड़ें, मॉनिटर करें, इसके लिए ऑप्टिमाइज़ करें। |
2 | पुष्ट और मौजूदा | ट्रेनिंग या लाइसेंसिंग। आप कंटेंट और साझेदारी के ज़रिए प्रभाव डाल सकते हैं, API के ज़रिए नहीं। |
3 | पुष्ट ऐतिहासिक | केवल प्रीट्रेनिंग। कोई जीवित लीवर नहीं। इसके इर्द-गिर्द मॉनिटरिंग वर्कफ़्लो न बनाएँ। |
4 | मज़बूत सबूत, अपुष्ट | श्रेणी का अनुमान। नज़र रखने लायक, अभी बजट तय करने लायक नहीं। |
तालिका से पहले एक चेतावनी। यह श्रेणी हर महीने बदलती है। विक्रेता डॉक्स, लाइसेंसिंग सौदे और फ़ीड स्पेक्स सब चलते रहते हैं। स्तर के आवंटन को एक शुरुआती बिंदु मानें जिसे किसी टीम को वर्कफ़्लो सौंपने से पहले विक्रेता के अपने डॉक्स से दोबारा जाँचा जाए।
स्तर 1: जीवित स्रोत जिन तक आपका एजेंट वाकई पहुँच सकता है
ये वे स्रोत हैं जहाँ आज डॉक्यूमेंटेड कनेक्शन मौजूद है। अगर आपका एजेंट खुद AI-दृश्यता डेटा खींचने वाला है, तो वह यहीं से शुरू करता है।
वेब और सर्च डिस्कवरी
Google Search ग्राउंडिंग। Gemini API एक google_search टूल देता है जो मॉडल को रीयल-टाइम वेब कंटेंट से जोड़ता है और स्रोत URL के साइटेशन लौटाता है। यह डॉक्यूमेंटेड, मौजूदा और बाज़ार में जीवित ग्राउंडिंग का सबसे साफ़ उदाहरण है। इसका यह भी मतलब है कि लीवर आपकी क्रॉल-योग्यता और पेज संरचना है, आपकी फ़ीड नहीं।
Bing Search। Microsoft दर्ज करता है कि Bing नतीजे Copilot उत्तरों को बेहतर बनाने में इस्तेमाल होते हैं। व्यावहारिक निष्कर्ष Google जैसा ही है: अगर आप दिखना चाहते हैं, तो पेज पहुँच-योग्य और निकालने-योग्य होना चाहिए।
जीवित प्रकाशक पेज। ये प्रीट्रेनिंग के बजाय सर्च ग्राउंडिंग के ज़रिए इन्फ़रेंस समय पर पहुँचे जाते हैं। शामिल होने को रिट्रीवल चयन और क्रॉल-योग्यता तय करते हैं, इसीलिए तकनीकी SEO काम अब भी AI दृश्यता नतीजों में दिखता है।
उत्पाद और खरीदारी
Google Merchant Center। Merchant फ़ीड डेटा Google की शॉपिंग सरफ़ेस को आधार देता है। अगर आप भौतिक उत्पाद बेचते हैं और Merchant Center में नहीं हैं, तो आप उस सरफ़ेस से ग़ायब हैं जिसे सक्रिय रूप से AI उत्तरों से जोड़ा जा रहा है।
OpenAI मर्चेंट और रिटेल फ़ीड्स। व्यापारी एक संरचित उत्पाद फ़ीड साझा करते हैं, और Agentic Commerce Protocol डॉक्यूमेंटेशन स्कीमा, फ़ाइल-अपलोड और API एकीकरण पथ, और ऐसा रिफ़्रेश कैडेंस बताता है जो दिन भर अपडेट स्वीकार करता है। पहुँच फ़िलहाल मंज़ूर किए गए पार्टनर तक सीमित है, इसलिए यह लीड टाइम वाला प्रोजेक्ट है, कोई ऐसा स्विच नहीं जिसे आप झट से दबा दें।
स्थानीय और जगहें
Google Maps ग्राउंडिंग। Search ग्राउंडिंग के साथ एक टूल के रूप में डॉक्यूमेंटेड, जो मॉडल को भू-स्थानिक संदर्भ देता है। इसीलिए सटीक, पूर्ण प्रोफ़ाइल वाले स्थानीय कारोबार आस-पास के विकल्पों के बारे में AI उत्तरों में दिखते हैं।
Google Business Profile। बिज़नेस प्रोफ़ाइल डेटा Google की स्थानीय सरफ़ेस को खिलाता है। स्थानीय कारोबारों के लिए यह सूची के सबसे ज़्यादा असर और सबसे कम मेहनत वाले स्रोतों में से एक है।
Yelp। Yelp रीयल-टाइम स्थानीय सिफ़ारिशों के लिए समीक्षाएँ, फ़ोटो और बिज़नेस जानकारी लाइसेंस करता है, और यह रिश्ता ग्राउंडिंग से आगे एक्शन तक जाता है। यह उन गिने-चुने स्रोतों में से है जहाँ समीक्षा प्लेटफ़ॉर्म एक ही समय में साइटेशन स्रोत और लेन-देन की सरफ़ेस दोनों है।
ज्ञान और संदर्भ
Wikipedia और Wikimedia। प्रकट प्रीट्रेनिंग मिश्रणों में मौजूद और जीवित संदर्भ कॉर्पस के रूप में व्यापक रूप से इस्तेमाल। लाइसेंसिंग असामान्य रूप से साफ़ है, जो इसे एंटिटी काम के लिए वैध लक्ष्य बनाती है।
समुदाय, प्रश्नोत्तर और सोशल
Reddit। डेटा-लाइसेंसिंग व्यवस्था के ज़रिए एक जीवित ग्राउंडिंग स्रोत, जिसका ट्रेनिंग पक्ष अलग से रिपोर्ट किया जाता है। नवीनीकरण की स्थिति को अस्थिर मानें और ऐसा वर्कफ़्लो न बनाएँ जो स्थायी पहुँच मान ले।
स्तर 2 और 3: जिन स्रोतों पर आप प्रभाव डालते हैं, क्वेरी नहीं करते
ये मायने रखते हैं, लेकिन किसी ऐसे API के ज़रिए नहीं जिसे आप एजेंट से कॉल कर सकें।
लाइसेंस प्राप्त प्रकाशक कंटेंट। बड़े प्रकाशकों के साथ कई स्पष्ट लाइसेंसिंग साझेदारियाँ मौजूद हैं, जिनकी शर्तें ट्रेनिंग, ग्राउंडिंग और एट्रिब्यूशन पर पार्टनर-दर-पार्टनर अलग हैं। एक छोटी साइट के रूप में आप पैसे देकर इस सूची में नहीं आ सकते, लेकिन आप ऐसा स्रोत बन सकते हैं जिसे तब साइट किया जाता है जब लाइसेंस प्राप्त कॉर्पस आपके विषय पर पतला हो।
डेवलपर और तकनीकी स्रोत। सार्वजनिक कोड रिपॉज़िटरी और तकनीकी डॉक्यूमेंटेशन कॉर्पस पुष्ट मौजूदा स्रोत हैं। डेवलपर-टूल कंपनियों के लिए यह सूची का सबसे मूल्यवान स्तर है, और यह फ़ीड के बजाय डॉक्यूमेंटेशन गुणवत्ता से पहुँच में आता है।
ऐतिहासिक वेब कॉर्पस। Common Crawl डेटा और ऐसे ही अभिलेखागार के साफ़ किए गए व्युत्पन्न। पुष्ट ऐतिहासिक, कोई जीवित लीवर नहीं। यह समझने के लिए उपयोगी संदर्भ कि किसी मॉडल का कोई प्रायर क्यों है, मॉनिटरिंग वर्कफ़्लो के लिए उपयोगी नहीं।
कनेक्शन परत: हर एजेंट किस तक पहुँच सकता है
यहीं यह लेख अपनी कीमत वसूल करता है। नीचे की तालिका हर एजेंट को उस कनेक्शन तंत्र से जोड़ती है जिसे वह वाकई सपोर्ट करता है, और ऊपर के स्रोतों के लिए तैयार कनेक्टरों की ईमानदार स्थिति बताती है।
एजेंट | कनेक्शन तंत्र | तैयार स्रोत कनेक्टर | आप क्या बनाते हैं |
|---|---|---|---|
Codex | stdio और streamable HTTP पर MCP, | समुदायिक MCP सर्वरों का बढ़ता रजिस्ट्री | किसी भी HTTP API वाले स्रोत के लिए पतला MCP सर्वर |
Claude Code | HTTP, SSE, stdio और WebSocket पर MCP | Anthropic कनेक्टर डायरेक्टरी और समुदायिक सर्वर | वही सर्वर, |
Hermes Agent | प्रति-सर्वर टूल फ़िल्टरिंग वाला MCP, साथ में नेटिव स्किल्स | एक-क्लिक इंस्टॉल वाला चुना हुआ MCP कैटलॉग | ऐसी स्किल जो MCP न होने पर API को रैप करती है |
OpenClaw | MCP क्लाइंट और सर्वर, साथ में A2A JSON-RPC | OpenClaw MCP रजिस्ट्री और सहेजी गई सर्वर परिभाषाएँ | सहेजी गई MCP परिभाषा या A2A पुल |
Pi Agent | TypeScript एक्सटेंशन और स्किल्स, कोई नेटिव MCP क्लाइंट नहीं | डिफ़ॉल्ट रूप से कोई नहीं | छोटा एक्सटेंशन जो API को टूल के रूप में कॉल करता है |
Grok Bot | API अनुरोध में घोषित रिमोट MCP टूल्स | कोई भी रिमोट MCP सर्वर जिसकी ओर आप इसे इंगित करें | रिमोट MCP सर्वर, क्योंकि कनेक्शन Grok संभालता है |
Meta Muse | कनेक्टर, कोई सार्वजनिक MCP या API सरफ़ेस नहीं | केवल विक्रेता-प्रबंधित कनेक्टर | केवल अप्रत्यक्ष काम: फ़ीड्स, एंटिटी डेटा और क्रॉल-योग्य पेज |
ध्यान देने लायक पैटर्न: सात में से पाँच एजेंट MCP बोलते हैं, और जो दो नहीं बोलते वे स्पेक्ट्रम के दो विपरीत छोरों पर हैं। Pi Agent जान-बूझकर न्यूनतम है और अपेक्षा करता है कि आप एक्सटेंशन लिखें। Meta Muse एक उपभोक्ता उत्पाद है जिसके पास कोई डेवलपर सरफ़ेस ही नहीं है।
इसका मतलब है कि कुशल कदम यह है कि अपने सबसे मूल्यवान स्रोत के लिए एक MCP सर्वर बनाएँ और उसे Codex, Claude Code, Hermes Agent, OpenClaw और Grok Bot में दोबारा इस्तेमाल करें। आप उसे एक बार लिखते हैं।
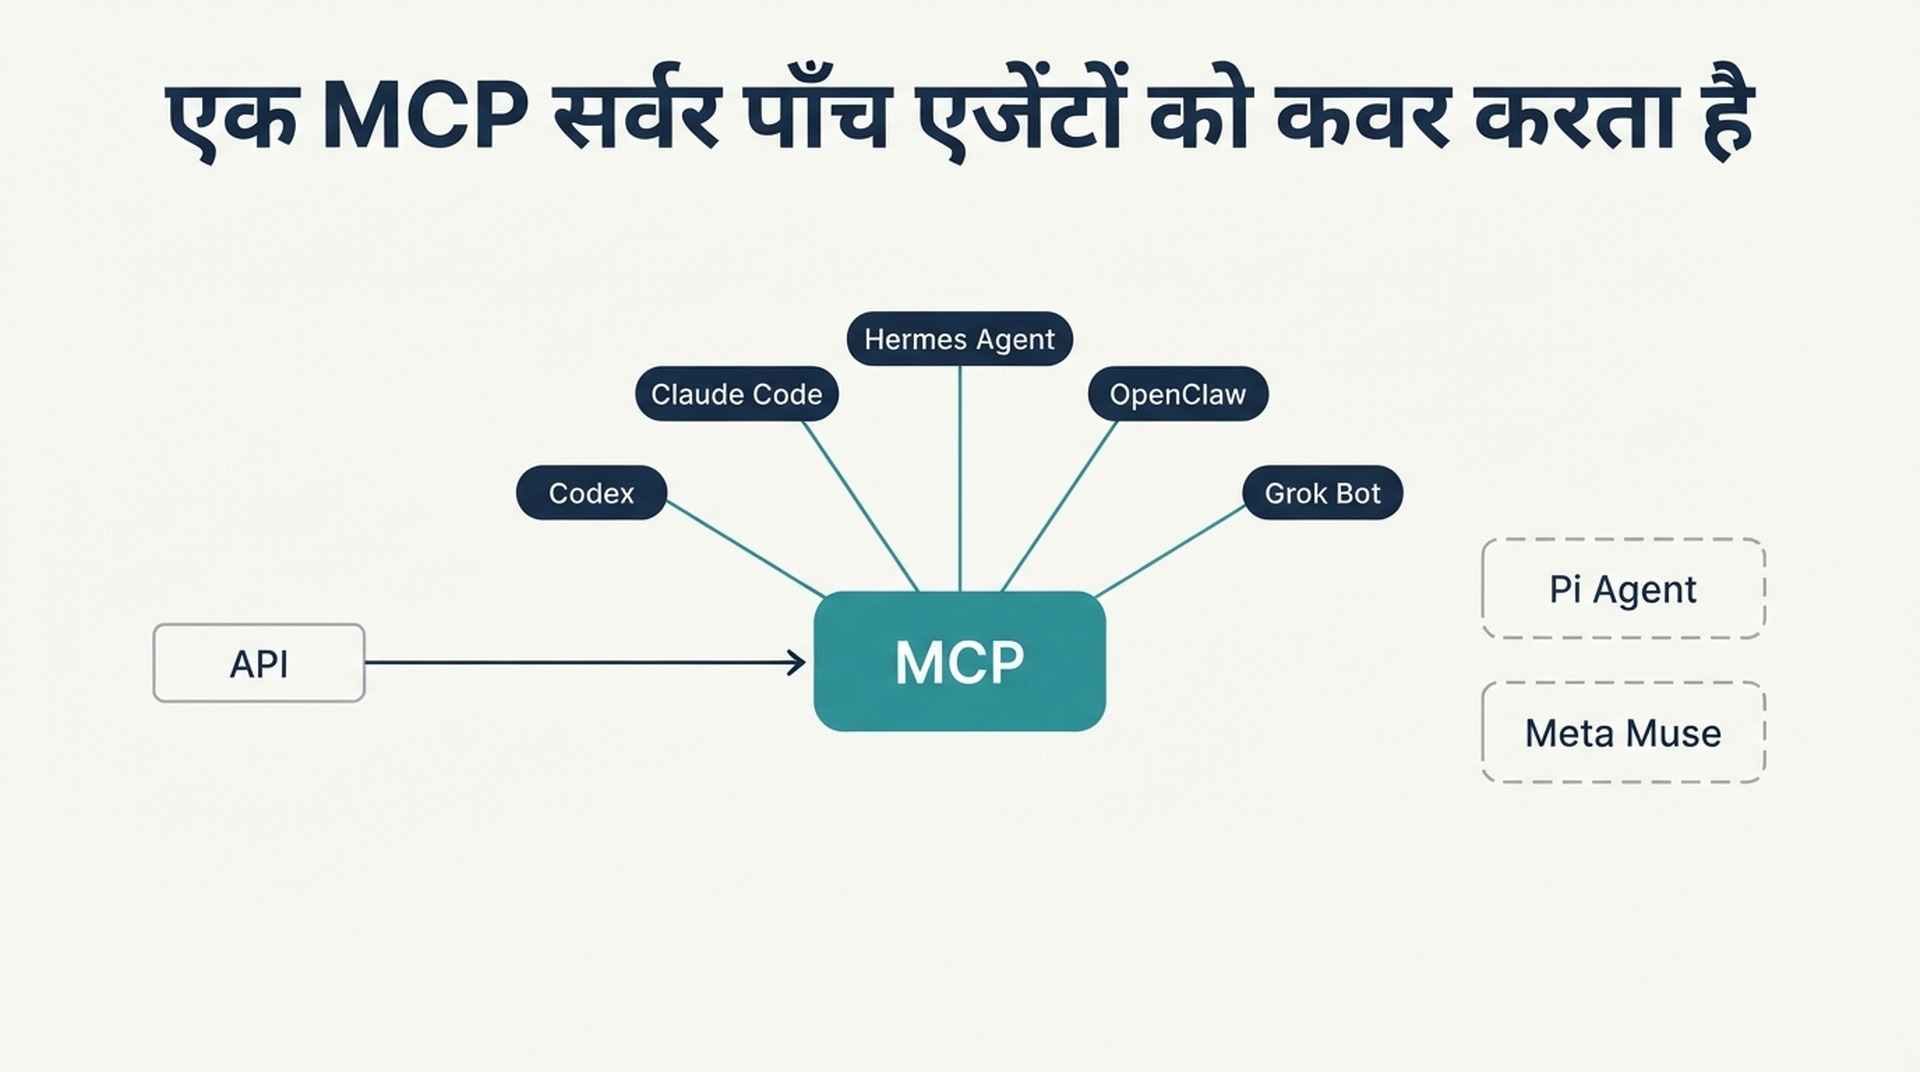
एक सर्वर सात में से पाँच एजेंटों को कवर करता है। Pi Agent और Meta Muse को अलग रास्ते चाहिए।
हर एजेंट को कैसे जोड़ें
नीचे दिए कदम मानते हैं कि आपके पास जिस स्रोत को जोड़ रहे हैं उसका API कुंजी या टोकन पहले से है। कभी भी क्रेडेंशियल ऐसी कॉन्फ़िग फ़ाइल में न रखें जो कमिट हो जाए।
Codex
Codex MCP कॉन्फ़िगरेशन config.toml में रखता है, या तो ~/.codex/config.toml पर या प्रोजेक्ट-स्कोप में .codex/config.toml पर। ChatGPT डेस्कटॉप ऐप, Codex CLI और IDE एक्सटेंशन यही कॉन्फ़िगरेशन साझा करते हैं, इसलिए आप इसे एक बार सेट करते हैं।
stdio सर्वर के लिए:
codex mcp add my-source --env API_KEY=your-key -- npx -y @your-org/my-source-mcpstreamable HTTP सर्वर के लिए config.toml में एक टेबल जोड़ें:
[mcp_servers.my-source]
url = "https://mcp.example.com/mcp"
bearer_token_env_var = "MY_SOURCE_TOKEN"
Codex इनिशियलाइज़ेशन पर लौटाए गए MCP instructions फ़ील्ड को पढ़ता है और उसे पूरे सर्वर के लिए मार्गदर्शन की तरह इस्तेमाल करता है। अगर आप सर्वर बना रहे हैं, तो पहले 512 अक्षरों को आत्मनिर्भर रखें ताकि एजेंट के यह तय करते समय कि इसे कॉल करना है या नहीं, सबसे ज़रूरी शर्तें उपलब्ध हों।
सर्वर रजिस्टर हुआ या नहीं यह पक्का करने के लिए codex mcp list चलाएँ, और सक्रिय सर्वर देखने के लिए TUI के भीतर /mcp।
Claude Code
Claude Code रिमोट HTTP, रिमोट SSE, लोकल stdio और रिमोट WebSocket सपोर्ट करता है। रिमोट सर्वरों के लिए HTTP सुझाया गया विकल्प है।
claude mcp add --transport http my-source https://mcp.example.com/mcp \
  --header "Authorization: Bearer your-token"
लोकल सर्वर के लिए:
claude mcp add my-source -- npx -y @your-org/my-source-mcpदो बातें जिन पर लोग फँसते हैं। पहली, JSON कॉन्फ़िग में url वाला लेकिन type रहित एंट्री stdio सर्वर मानी जाती है और चुपचाप छोड़ दी जाती है, इसलिए हमेशा "type": "http" स्पष्ट रूप से सेट करें। दूसरी, Claude Code स्पॉन किए गए सर्वर के एनवायरनमेंट में CLAUDE_PROJECT_DIR सेट करता है, इसलिए लोकल सर्वर वर्किंग डायरेक्टरी पर निर्भर हुए बिना प्रोजेक्ट-सापेक्ष पथ हल कर सकता है।
Hermes Agent
Hermes Agent स्टैंडर्ड इंस्टॉल में MCP सपोर्ट के साथ आता है। कॉन्फ़िगरेशन ~/.hermes/config.yaml में रहता है:
mcp_servers:
  my-source:
    command: "npx"
    args: ["-y", "@your-org/my-source-mcp"]
Hermes उसी कॉन्फ़िग में रिमोट HTTP MCP सर्वर भी सपोर्ट करता है, और प्रति-सर्वर फ़िल्टरिंग भी, जिससे आप केवल वही टूल्स उजागर करते हैं जो वाकई एजेंट को दिखाने हैं। यह फ़िल्टरिंग यहाँ दूसरे एजेंटों से ज़्यादा मायने रखती है, क्योंकि Hermes शेड्यूल पर बिना निगरानी चलता है।
अगर आप Claude Code से माइग्रेट कर रहे हैं, तो hermes import-agent claude-code ~/.claude.json के mcpServers ब्लॉक को Hermes कॉन्फ़िग के mcp_servers पर मैप करता है और साथ ही स्किल्स और निर्देश भी ले आता है।
जब किसी स्रोत के लिए कोई MCP सर्वर मौजूद न हो, तो स्किल्स सिस्टम विकल्प है। स्किल एक ऐसी डायरेक्टरी है जिसमें SKILL.md होता है जो एजेंट को बताता है कि इसे कब इस्तेमाल करना है और क्या करना है। API कॉल को एक साथ रखे स्क्रिप्ट में रैप करें और स्किल से उसका संदर्भ दें, और एजेंट को प्रोटोकॉल सर्वर के बिना यह क्षमता मिल जाती है।
OpenClaw
OpenClaw MCP क्लाइंट और MCP सर्वर दोनों की तरह काम करता है। क्लाइंट के रूप में आप mcp registry सबकमांड्स से सहेजी गई सर्वर परिभाषाएँ प्रबंधित करते हैं, और ब्राउज़र Control UI सेटिंग्स पेज से सर्वरों को संपादित और निरीक्षण कर सकते हैं।
openclaw mcp registry add my-source --transport streamable-http --url https://mcp.example.com/mcp
openclaw mcp status
OpenClaw अपनी चैनल बातचीत भी MCP पर उजागर करता है, जो उल्टी दिशा है और तब काम आती है जब आप चाहते हैं कि कोई दूसरा एजेंट पढ़े कि आपकी OpenClaw इंस्टेंस क्या कर रही थी। जो बाहरी एजेंट MCP क्लाइंट नहीं हैं, उनके लिए OpenClaw JSON-RPC पर A2A बोलता है।
अनुमति मॉडल ही इस काम के लिए OpenClaw चुनने की वजह है। इसमें प्रति-चैट टूल नीति और निष्पादन के लिए स्पष्ट अनुमोदन पथ है, जो तब चाहिए जब एजेंट किसी सशुल्क डेटा स्रोत को पढ़ रहा हो और आपको उसका खर्च सीमित करना हो।
Pi Agent
Pi Agent में नेटिव MCP क्लाइंट नहीं है, और यह कमी नहीं बल्कि डिज़ाइन का चुनाव है। इसका एक्सटेंशन बिंदु TypeScript मॉड्यूल हैं जो Pi प्रोसेस के भीतर चलते हैं और टूल्स रजिस्टर करते हैं।
~/.pi/agent/extensions/my-source.ts पर एक एक्सटेंशन बनाएँ:
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.registerTool({
    name: "my_source_lookup",
    description: "Look up a record in My Source by query.",
    parameters: { type: "object", properties: { query: { type: "string" } }, required: ["query"] },
    handler: async ({ query }) => {
      const res = await fetch(`https://api.example.com/search?q=${encodeURIComponent(query)}`, {
        headers: { Authorization: `Bearer ${process.env.MY_SOURCE_TOKEN}` },
      });
      return await res.json();
    },
  });
}
विकास के दौरान इसे सीधे pi --extension ./my-source.ts से लोड करें, फिर स्थिर होने पर इसे extensions डायरेक्टरी में ले जाएँ या pi install से पैकेज करें।
इसका सौदा असली है और सीधे बताने लायक है। एक्सटेंशन Pi प्रोसेस के समान ऑपरेटिंग-सिस्टम अनुमतियों के साथ चलता है और प्रॉम्प्ट, टूल कॉल, फ़ाइलें और क्रेडेंशियल देख सकता है। एक्सटेंशन केवल भरोसेमंद स्रोतों से लोड करें, और इंस्टॉल करने से पहले सोर्स पढ़ें।
Grok Bot
Grok का API रिमोट MCP टूल्स सपोर्ट करता है, और xAI आपकी ओर से सर्वर कनेक्शन संभालता है। आप सर्वर को अनुरोध की tools सरणी में घोषित करते हैं:
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import mcp

client = Client(api_key=os.getenv("XAI_API_KEY"))
chat = client.chat.create(
    model="grok-4.7",
    tools=[mcp(server_url="https://mcp.example.com/mcp", server_label="my-source")],
)
रिमोट MCP टूल्स के लिए केवल streaming HTTP और SSE ट्रांसपोर्ट सपोर्टेड हैं। आप allowed_tools से सीमित कर सकते हैं कि कौन-से टूल्स उजागर हों, और ऐसा प्राधिकरण टोकन भेज सकते हैं जिसे xAI आपके सर्वर पर अनुरोधों में Authorization हेडर में सेट करता है।
यहाँ फ़ायदा यह है कि आप क्लाइंट-साइड कनेक्शन चलाते या बनाए नहीं रखते। नुकसान यह है कि MCP सर्वर सार्वजनिक रूप से पहुँच-योग्य होना चाहिए, इसलिए आपके VPN के पीछे की हर चीज़ के लिए अलग तरीका चाहिए।
Meta Muse
Muse कनेक्टरों के ज़रिए तीसरे पक्ष के ऐप्स और सेवाओं से जुड़ता है, और एजेंट के लिए कोई सार्वजनिक MCP या डेवलपर API सरफ़ेस नहीं है। यही ईमानदार जवाब है, और यह बदल देता है कि आप क्या कर सकते हैं।
आप Muse को बाक़ी छह एजेंटों की तरह मॉनिटरिंग वर्कफ़्लो में नहीं जोड़ सकते। आप यह कर सकते हैं कि जिन स्रोतों को Muse पढ़ता है उन्हें बेहतर बनाएँ। यानी अगर आप बेचते हैं तो सटीक उत्पाद और कैटलॉग डेटा, अगर स्थानीय हैं तो पूर्ण और सुसंगत बिज़नेस जानकारी, और अगर प्रकाशक हैं तो स्पष्ट एंटिटी संकेतों वाले क्रॉल-योग्य पेज। Muse तैयारी के काम का लक्ष्य है, ऐसा डेटा स्रोत नहीं जिसे आप क्वेरी करें।
अगर Meta Muse के लिए कोई डेवलपर सरफ़ेस जारी करता है, तो यह हिस्सा बदल जाएगा। तब तक इसे उस दर्शक-वर्ग की तरह देखें जिसके लिए तैयारी करनी है, न कि ऐसे सिस्टम की तरह जिससे इंटीग्रेट करना है।
एक सर्वर बनाएँ, पाँच बार इस्तेमाल करें
अगर आपको कुछ भी बनाना है, तो अपने एक सबसे मूल्यवान स्रोत के लिए MCP सर्वर बनाएँ और उसे दोबारा इस्तेमाल करें। ऊपर के पाँच MCP-सक्षम एजेंट सभी streamable HTTP सर्वर स्वीकार करते हैं, इसलिए एक तैनाती उन सबको कवर करती है।
न्यूनतम व्यवहार्य सर्वर को चार चीज़ें चाहिए: एक टूल जो क्वेरी ले और संरचित डेटा लौटाए, सर्वर पक्ष पर बियरर टोकन जाँच, एक दर सीमा ताकि भागता हुआ एजेंट आपका API कोटा न जला दे, और एक instructions फ़ील्ड जो पहले 512 अक्षरों में शर्तें बताए।
दो नियम जो ज़्यादातर दर्द रोकते हैं। गद्य के बजाय संरचित डेटा लौटाएँ, ताकि एजेंट टेक्स्ट दोबारा पार्स करने के बजाय फ़ील्ड्स पर सोच सके। और हर टूल को तब तक केवल-पठन रखें जब तक आप एजेंट को एक पूरा चक्र उसका इस्तेमाल करते हुए न देख लें। केवल-पठन सर्वर कुछ बिगाड़ नहीं सकता, और असली कॉल पैटर्न देखने के बाद आप उसे चौड़ा कर सकते हैं।
भरोसा करने से पहले कनेक्शन जाँचें
यह न मानें कि कॉन्फ़िगर किया गया सर्वर चल रहा सर्वर है। ये चार जाँचें चलाएँ।
जाँचें कि सर्वर रजिस्टर है। codex mcp list, claude mcp list या openclaw mcp status को इसे दिखाना चाहिए। जो सर्वर पार्स होने में विफल रहा, वह कुछ क्लाइंट्स पर चुपचाप छोड़ दिया जाता है।
टूल इन्वेंटरी जाँचें। एजेंट से कहें कि सर्वर जो टूल्स उजागर करता है उन्हें सूचीबद्ध करे। अगर आप छह टूल्स की अपेक्षा करते हैं और एक दिखता है, तो सर्वर रजिस्टर हुआ लेकिन टूल्स नहीं।
असली क्वेरी जाँचें। ऐसा विशिष्ट रिकॉर्ड माँगें जिसे आप हाथ से सत्यापित कर सकें। सामान्य सवाल "आप कौन-सा डेटा ला सकते हैं" कुछ साबित नहीं करता।
विफलता पथ जाँचें। टोकन रद्द करें और क्वेरी दोबारा चलाएँ। आपको साफ़ प्रमाणीकरण त्रुटि चाहिए, चुपचाप खाली नतीजा नहीं। जो एजेंट विफल कॉल को "डेटा नहीं" मानता है, वह टूटे कनेक्शन के लिए साफ़ नतीजा रिपोर्ट करेगा, और यह इस पूरे वर्कफ़्लो का सबसे महँगा विफलता मोड है।
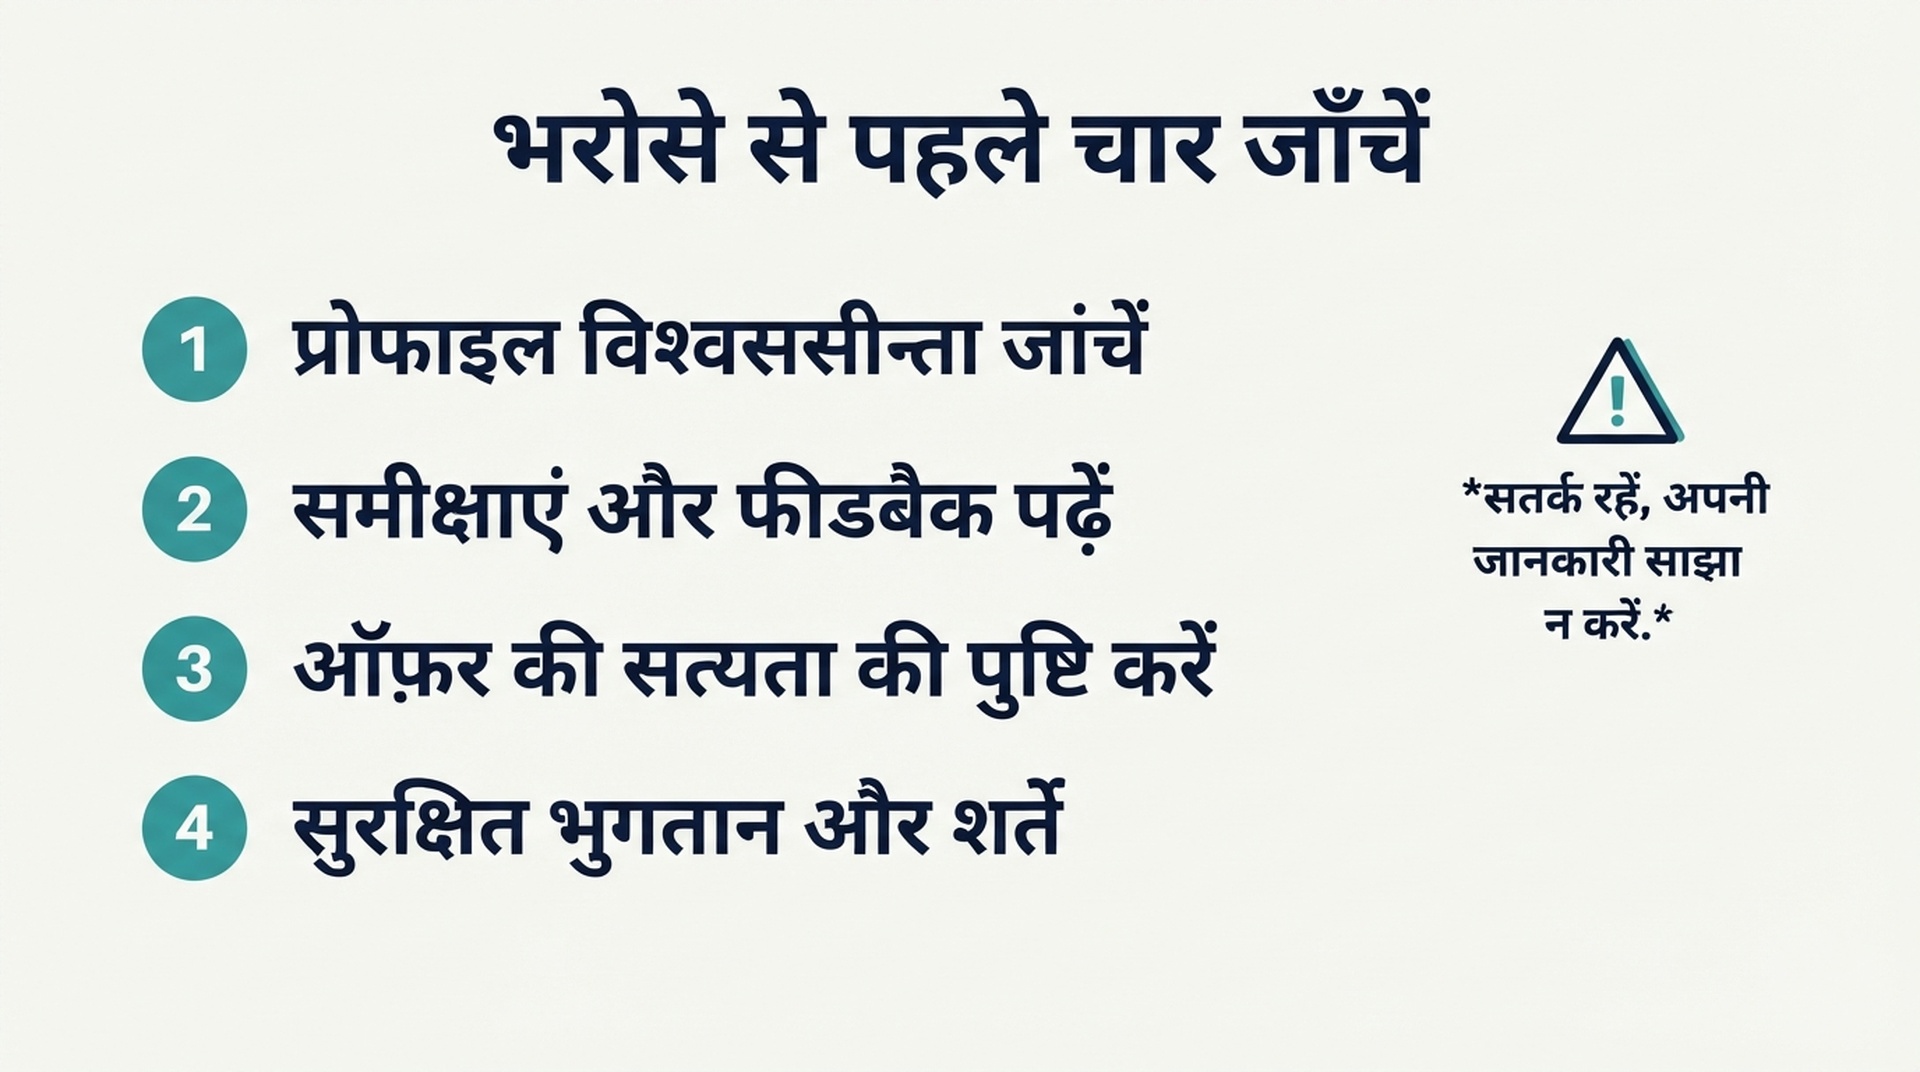
चार जाँचें। आख़िरी वाली उस विफलता को पकड़ती है जो निष्कर्ष जैसी दिखती है।
इससे आपकी प्राथमिकताओं में क्या बदलता है
स्तर तालिका और कनेक्शन तालिका एक ही दिशा में इशारा करती हैं। जिन स्रोतों को आप एजेंट से जोड़ सकते हैं वही स्रोत हैं जिन्हें आप माप सकते हैं, और जिन्हें आप माप सकते हैं वही हैं जिन्हें आप किसी आधार-रेखा के सापेक्ष सुधार सकते हैं।
इसका मतलब है कि काम का क्रम वह नहीं है जो ज़्यादातर टीमें इस्तेमाल करती हैं। उस स्रोत से शुरू करें जिसके पास डॉक्यूमेंटेड कनेक्शन और आपके लिए असली कारोबारी असर दोनों हों। स्थानीय कारोबार के लिए वह Google Business Profile और Maps ग्राउंडिंग है। उत्पाद कंपनी के लिए वह Merchant Center या उत्पाद फ़ीड है। डेवलपर-टूल कंपनी के लिए वह डॉक्यूमेंटेशन गुणवत्ता है। प्रकाशक के लिए वह जीवित पेजों की क्रॉल-योग्यता और निकालने-योग्यता है।
फिर वह एक MCP सर्वर बनाएँ जो उस स्रोत को आपके एजेंट तक लाता है, और उसे उन पाँच एजेंटों में दोबारा इस्तेमाल करें जो यह प्रोटोकॉल बोलते हैं। जिन स्रोतों का कोई कनेक्शन पथ नहीं है उन्हें कंटेंट और एंटिटी काम के रूप में छोड़ें, और ईमानदार रहें कि आप उन्हें उसी तरह नहीं माप सकते।
यहाँ आगे निकलने वाली टीमें सबसे लंबी स्रोत-सूची वाली नहीं होतीं। वे होती हैं जिन्होंने उन दो-तीन स्रोतों को जोड़ा जो मायने रखते हैं और उनके इर्द-गिर्द मॉनिटरिंग लूप बनाया।
अक्सर पूछे जाने वाले सवाल
क्या एजेंट को डेटा स्रोत तक पहुँच देने के लिए मुझे MCP चाहिए? नहीं। MCP वह मानक है जिसे अब ज़्यादातर एजेंट सपोर्ट करते हैं, जो इसे सबसे ज़्यादा दोबारा इस्तेमाल होने वाला विकल्प बनाता है, लेकिन साथ रखी API स्क्रिप्ट वाली स्किल एक ही एजेंट के लिए उतनी ही अच्छी तरह काम करती है। अगर आप एक स्रोत को एक एजेंट से जोड़ रहे हैं, तो स्किल कम मेहनत है। अगर आप एक स्रोत को पाँच एजेंटों से जोड़ रहे हैं, तो MCP तुरंत भरपाई कर लेता है।
किस एजेंट से शुरू करूँ? उससे शुरू करें जो वहाँ फिट बैठता है जहाँ आपका काम पहले से है। अगर आपकी साइट git रिपॉज़िटरी में है — Codex या Claude Code। अगर आपको स्थायी मेमोरी के साथ शेड्यूल पर रन चाहिए — Hermes Agent। अगर किसी सशुल्क डेटा स्रोत पर सख़्त अनुमति सीमा चाहिए — OpenClaw। अगर आपको सबसे छोटा सरफ़ेस चाहिए जिसे एक बैठक में ऑडिट कर सकें — Pi Agent।
क्या मैं ऐसा स्रोत जोड़ सकता हूँ जिसका कोई MCP सर्वर नहीं है? हाँ, तीन तरीक़ों से। अगर स्रोत का HTTP API है और आप उसे कई एजेंटों में दोबारा इस्तेमाल करना चाहते हैं तो पतला MCP सर्वर लिखें। अगर आपको केवल एक एजेंट चाहिए तो साथ रखी स्क्रिप्ट वाली स्किल लिखें। या ऐसा एजेंट इस्तेमाल करें जो रिमोट MCP टूल्स सपोर्ट करता है और उसे किसी और के होस्ट किए सर्वर की ओर इंगित करें।
मैं Meta Muse क्यों नहीं जोड़ सकता? Meta ने Muse के लिए कोई डेवलपर API या MCP सरफ़ेस प्रकाशित नहीं किया है। कनेक्टर विक्रेता द्वारा प्रबंधित होते हैं। जब तक यह नहीं बदलता, Muse वह सरफ़ेस है जिसके लिए आप कंटेंट और डेटा तैयार करते हैं, ऐसा सिस्टम नहीं जिसे आप क्वेरी करें।
क्या स्तर के आवंटन स्थायी हैं? नहीं। यह श्रेणी हर महीने बदलती है। किसी टीम को वर्कफ़्लो सौंपने से पहले विक्रेता डॉक्यूमेंटेशन दोबारा जाँचें, और एक तिमाही से पुराने किसी भी स्तर आवंटन को अपुष्ट मानें।
इस काम में सबसे आम ग़लती क्या है? विफल API कॉल को असली शून्य मान लेना। अगर आपका एजेंट बताता है कि किसी ब्रांड की AI दृश्यता नहीं है और असली वजह एक समाप्त टोकन है, तो आपके पास निष्कर्ष के भेस में मापन विफलता है। सफलता पथ पर भरोसा करने से पहले हमेशा विफलता पथ जाँचें।
लेखक: Julian Mercer, Auspia में 14 वर्षों के अनुभव वाले तकनीकी SEO प्रैक्टिशनर। Julian क्रॉल-योग्यता, स्कीमा, रेंडरिंग और उन तकनीकी बुनियादों पर लिखते हैं जो कंटेंट को सर्च इंजन और AI एजेंट दोनों के लिए पठनीय बनाती हैं।