AI可視性を追っているチームの多くは、いまもスクリーンショット頼みです。ChatGPTに質問を投げ、引用をコピーして、ドキュメントに貼り付ける。それで分かるのは、ある日の午後に1つのモデルが何を答えたかだけです。どの情報源に回答エンジンが実際に到達できるのかは分かりませんし、エージェントが自分で問い合わせるための材料にもなりません。
この作業のもっと役に立つ形は、情報源マップと接続経路の組み合わせです。自分のカテゴリで重要なデータソースを決め、到達できるものは監視を回しているエージェントに直接つなぎます。残るのは間接的にしか働きかけられない情報源の短いリストで、そのリストはたいてい思っているより短いものです。
この記事では3つのことを扱います。AIの回答を支えるデータソースを、証拠がどれだけ確かで、どれだけ現在のものかに応じて階層に分けます。接続経路があるものについては、具体的なAPIまたはMCPの経路を示します。そしてCodex、Claude Code、Hermes Agent、OpenClaw、Pi Agent、Grok Bot、Meta Museそれぞれの接続方法を、既成のコネクタが存在せず自分でブリッジを組む必要があるケースも含めて解説します。
短い答え
AIの回答を支える情報源は4つのカテゴリに分かれ、到達しやすさは同じではありません。
ウェブと検索の発見に関する情報源は、グラウンディングAPIと、自分自身のクロール可能なページを通じて到達できます。構造化されたコマースフィードは、文書化されたフィード仕様を通じて到達できますが、アクセスは承認によって制限されます。知識とコミュニティのコーパスは、一部はライセンスされたAPIで到達でき、一部は働きかけようのない学習時の取り込みの裏側に閉じています。エージェントのアクション面は、まだ固まりつつあるプロトコル仕様を通じて到達できます。
エージェント主導の監視ワークフローに置き換えると、実用的なルールになります。文書化されたAPIかMCPサーバーがあるものは接続する。フィード仕様があるものはデータ品質のプロジェクトとして扱う。どちらもないものは、データのプロジェクトではなくコンテンツとエンティティのプロジェクトとして扱う。
階層表の読み方
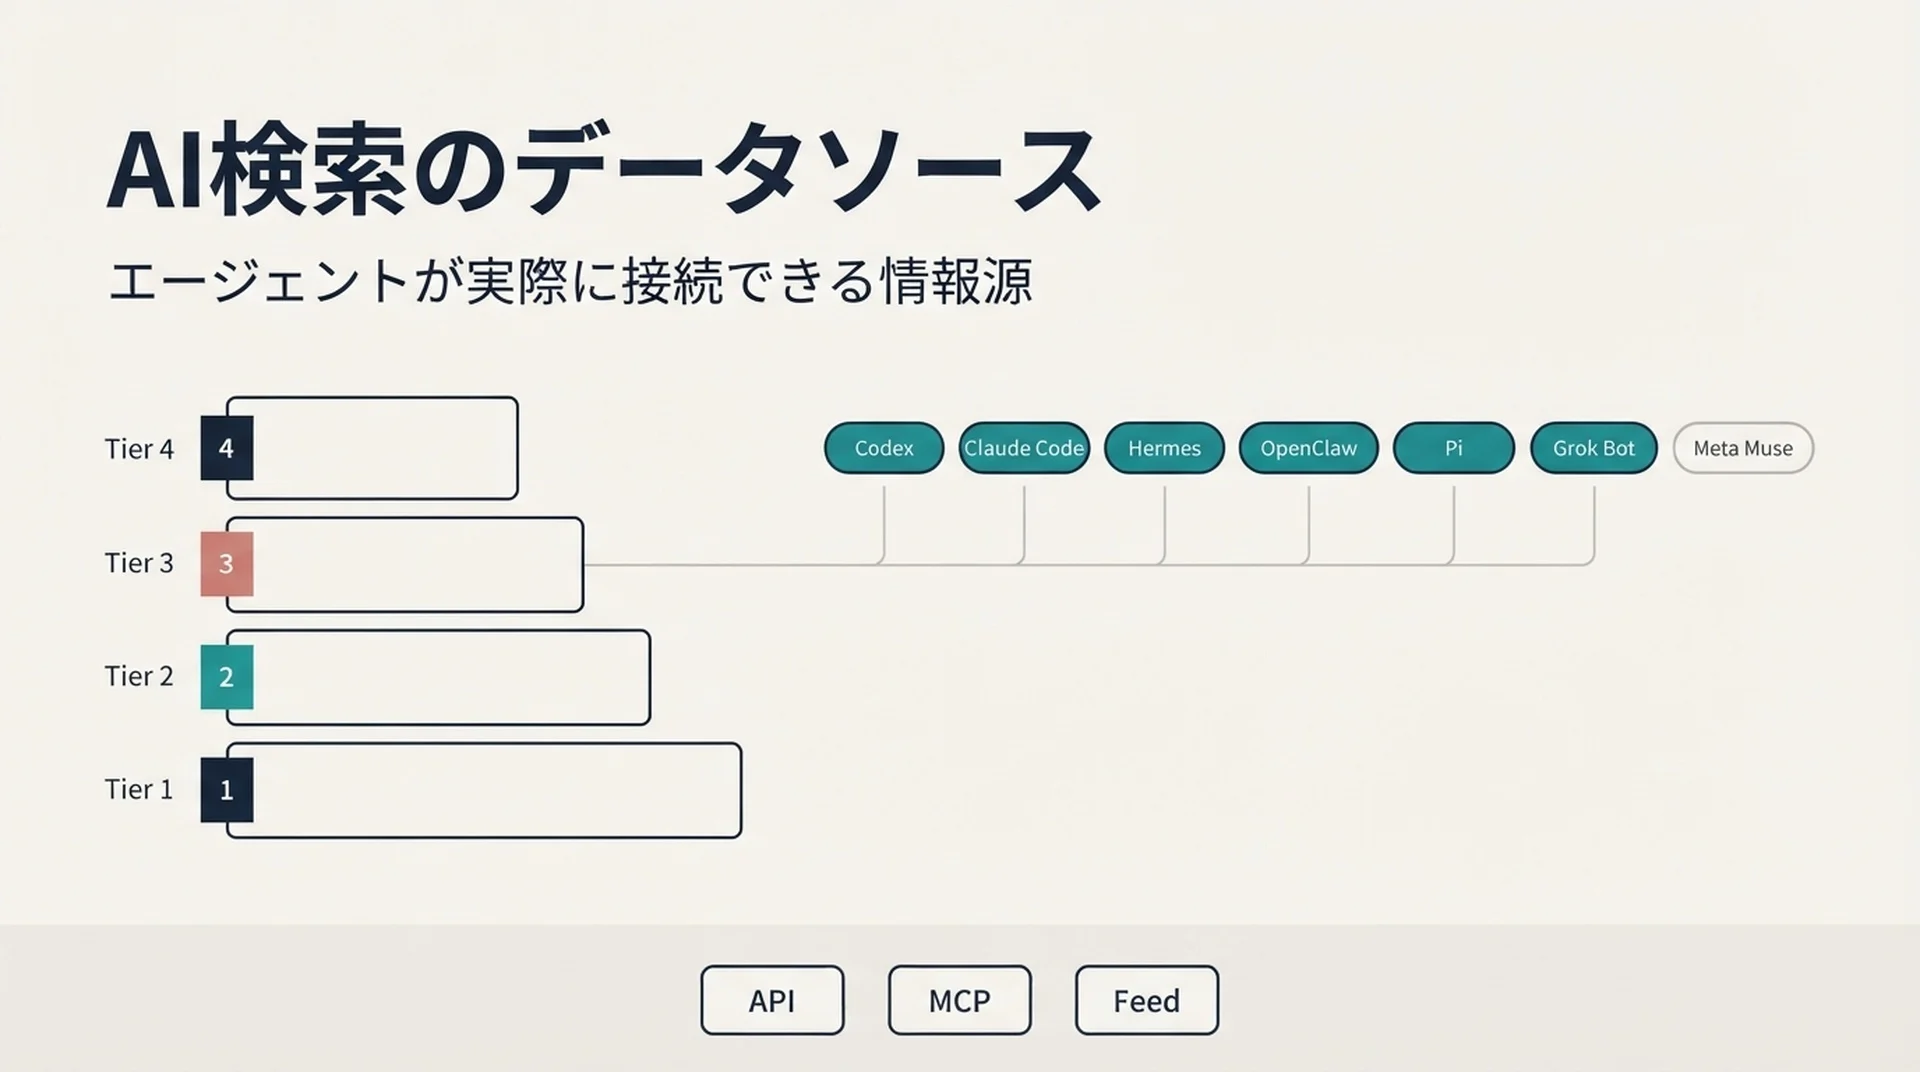
以下の階層は、その情報源が現在AIの回答を支えているという証拠の強さと、その接続が現在のものか歴史的なものかで分類しています。ここが多くの情報源リストが間違える部分です。2022年にモデルを形作った情報源と、今日モデルが問い合わせる情報源は別物であり、混同すると戦略を誤ります。
階層 | 意味 | ワークフローにとっての意味 |
|---|---|---|
1 | 確認済みかつ現在 | ライブのグラウンディング、検索、アクション。接続し、監視し、最適化する。 |
2 | 確認済みかつ現在 | 学習またはライセンス。APIではなくコンテンツと提携を通じて働きかける。 |
3 | 確認済みの歴史的データ | 事前学習のみ。ライブのてこはない。監視ワークフローの対象にしない。 |
4 | 強い証拠はあるが未確認 | カテゴリからの推測。注視する価値はあるが、予算を割り当てる段階ではない。 |
表の前に1つ注意点があります。このカテゴリは毎月変わります。ベンダーのドキュメント、ライセンス契約、フィード仕様はどれも動きます。階層の割り当ては出発点として扱い、チームをワークフローにコミットさせる前にベンダー自身のドキュメントで再確認してください。
階層1:エージェントが実際に到達できるライブ情報源
ここは今日、文書化された接続が存在する情報源です。エージェントがAI可視性のデータを自分で取得するなら、ここが出発点になります。
ウェブと検索の発見
Google Searchグラウンディング。Gemini APIはgoogle_searchツールを公開しており、モデルをリアルタイムのウェブコンテンツにつなぎ、情報源のURLへの引用を返します。これは文書化され、現在も有効で、市場で最も明確なライブグラウンディングの例です。つまり、てこになるのはフィードではなく、クロール可能性とページ構造です。
Bing Search。MicrosoftはBingの結果がCopilotの回答を強化するために使われていると文書化しています。実務上の意味はGoogleと同じです。掲載されたいなら、ページが到達可能で抽出可能でなければなりません。
ライブのパブリッシャーページ。事前学習ではなく、推論時に検索グラウンディングを通じて到達されます。検索結果の選択とクロール可能性が掲載を左右するため、テクニカルSEOの作業がAI可視性の結果にも表れます。
製品とショッピング
Google Merchant Center。マーチャントフィードのデータがGoogleのショッピング面を支えています。物販をしていてMerchant Centerにいないなら、AIの回答に積極的に組み込まれつつある面から不在になっています。
OpenAIのマーチャント/リテールフィード。マーチャントは構造化された商品フィードを共有し、Agentic Commerce Protocolのドキュメントにはスキーマ、ファイルアップロードとAPIの統合経路、1日を通じて更新を受け付けるリフレッシュ頻度が記載されています。アクセスは現在承認済みパートナーに限られるため、これはスイッチを入れる話ではなく、リードタイムのあるプロジェクトです。
ローカルと場所
Google Mapsグラウンディング。Searchグラウンディングと並ぶツールとして文書化されており、モデルに地理的な文脈を与えます。近くの選択肢についてのAIの回答に、正確で完全なプロフィールを持つローカルビジネスが現れるのはこのためです。
Google Business Profile。ビジネスプロフィールのデータがGoogleのローカル面を支えています。ローカルビジネスにとって、このリストで最もてこの効く、最も手間の少ない情報源の1つです。
Yelp。Yelpはリアルタイムのローカル推薦のためにレビュー、写真、ビジネス情報をライセンス供与しており、その関係はグラウンディングを超えてアクションにまで及びます。レビュープラットフォームが引用元と取引面の両方になる、数少ない情報源の1つです。
知識と参照
WikipediaとWikimedia。開示された事前学習の混合に含まれており、ライブの参照コーパスとしても広く使われています。ライセンスが異例なほど明確で、エンティティ作業の正当な対象になります。
コミュニティ、Q&A、ソーシャル
Reddit。データライセンス契約を通じたライブのグラウンディング情報源で、学習側は別途報告されています。更新の状況は不安定なものとして扱い、恒久的なアクセスを前提にしたワークフローを組まないでください。
階層2と3:問い合わせるのではなく働きかける情報源
これらは重要ですが、エージェントから呼び出せるAPIを通じてではありません。
ライセンスされたパブリッシャーコンテンツ。主要な出版社との明示的なライセンス提携が複数存在し、条件は提携先ごとに学習、グラウンディング、帰属の扱いが異なります。小さなサイトがこのリストに入るために金を払うことはできませんが、ライセンスされたコーパスが自分のトピックについて薄いときに引用される種類の情報源になることはできます。
開発者向け・技術系の情報源。公開コードリポジトリと技術ドキュメントのコーパスは、確認済みの現在の情報源です。開発者ツールの企業にとって、これはリストの中で最も価値の高い階層であり、フィードではなくドキュメントの品質を通じて到達できます。
歴史的なウェブコーパス。コモンクロールデータのクリーニング済み派生版や類似のアーカイブです。確認済みの歴史的データで、ライブのてこはありません。モデルがなぜある前提を持つのかを理解する文脈としては有用ですが、監視ワークフローには向きません。
接続レイヤー:各エージェントが到達できるもの
ここがこの記事の本題です。以下の表は、各エージェントが実際にサポートする接続方式と、上記の情報源に対する既成コネクタの正直な状況を対応させています。
エージェント | 接続方式 | 既成の情報源コネクタ | 自分で作るもの |
|---|---|---|---|
Codex |
| コミュニティ製MCPサーバーの成長中のレジストリ | HTTP APIを持つ情報源向けの薄いMCPサーバー |
Claude Code | HTTP、SSE、stdio、WebSocket経由のMCP | Anthropicのコネクタディレクトリとコミュニティ製サーバー | 同じサーバーを |
Hermes Agent | サーバー単位のツールフィルタリングを備えたMCPと、ネイティブのスキル | ワンクリックでインストールできる厳選MCPカタログ | MCPが存在しない場合にAPIを包むスキル |
OpenClaw | MCPクライアント兼サーバー、およびA2A JSON-RPC | OpenClawのMCPレジストリと保存済みサーバー定義 | 保存したMCP定義、またはA2Aブリッジ |
Pi Agent | TypeScript拡張とスキル。ネイティブのMCPクライアントはなし | 既定ではなし | APIをツールとして呼び出す小さな拡張 |
Grok Bot | APIリクエストで宣言するリモートMCPツール | 自分で指定した任意のリモートMCPサーバー | リモートMCPサーバー(接続はGrokが管理) |
Meta Muse | コネクタ。公開されたMCPやAPIの面はなし | ベンダー管理のコネクタのみ | 間接的な作業のみ:フィード、エンティティデータ、クロール可能なページ |
注目すべきパターンはこうです。7つのエージェントのうち5つがMCPを話し、話さない2つはスペクトルの両端にあります。Pi Agentは意図的に最小限で、拡張を書くことを前提にしています。Meta Museは開発者向けの面を一切持たないコンシューマー製品です。
つまり効率的な動きは、最も価値の高い情報源のためにMCPサーバーを1つ作り、Codex、Claude Code、Hermes Agent、OpenClaw、Grok Botで使い回すことです。書くのは1回で済みます。
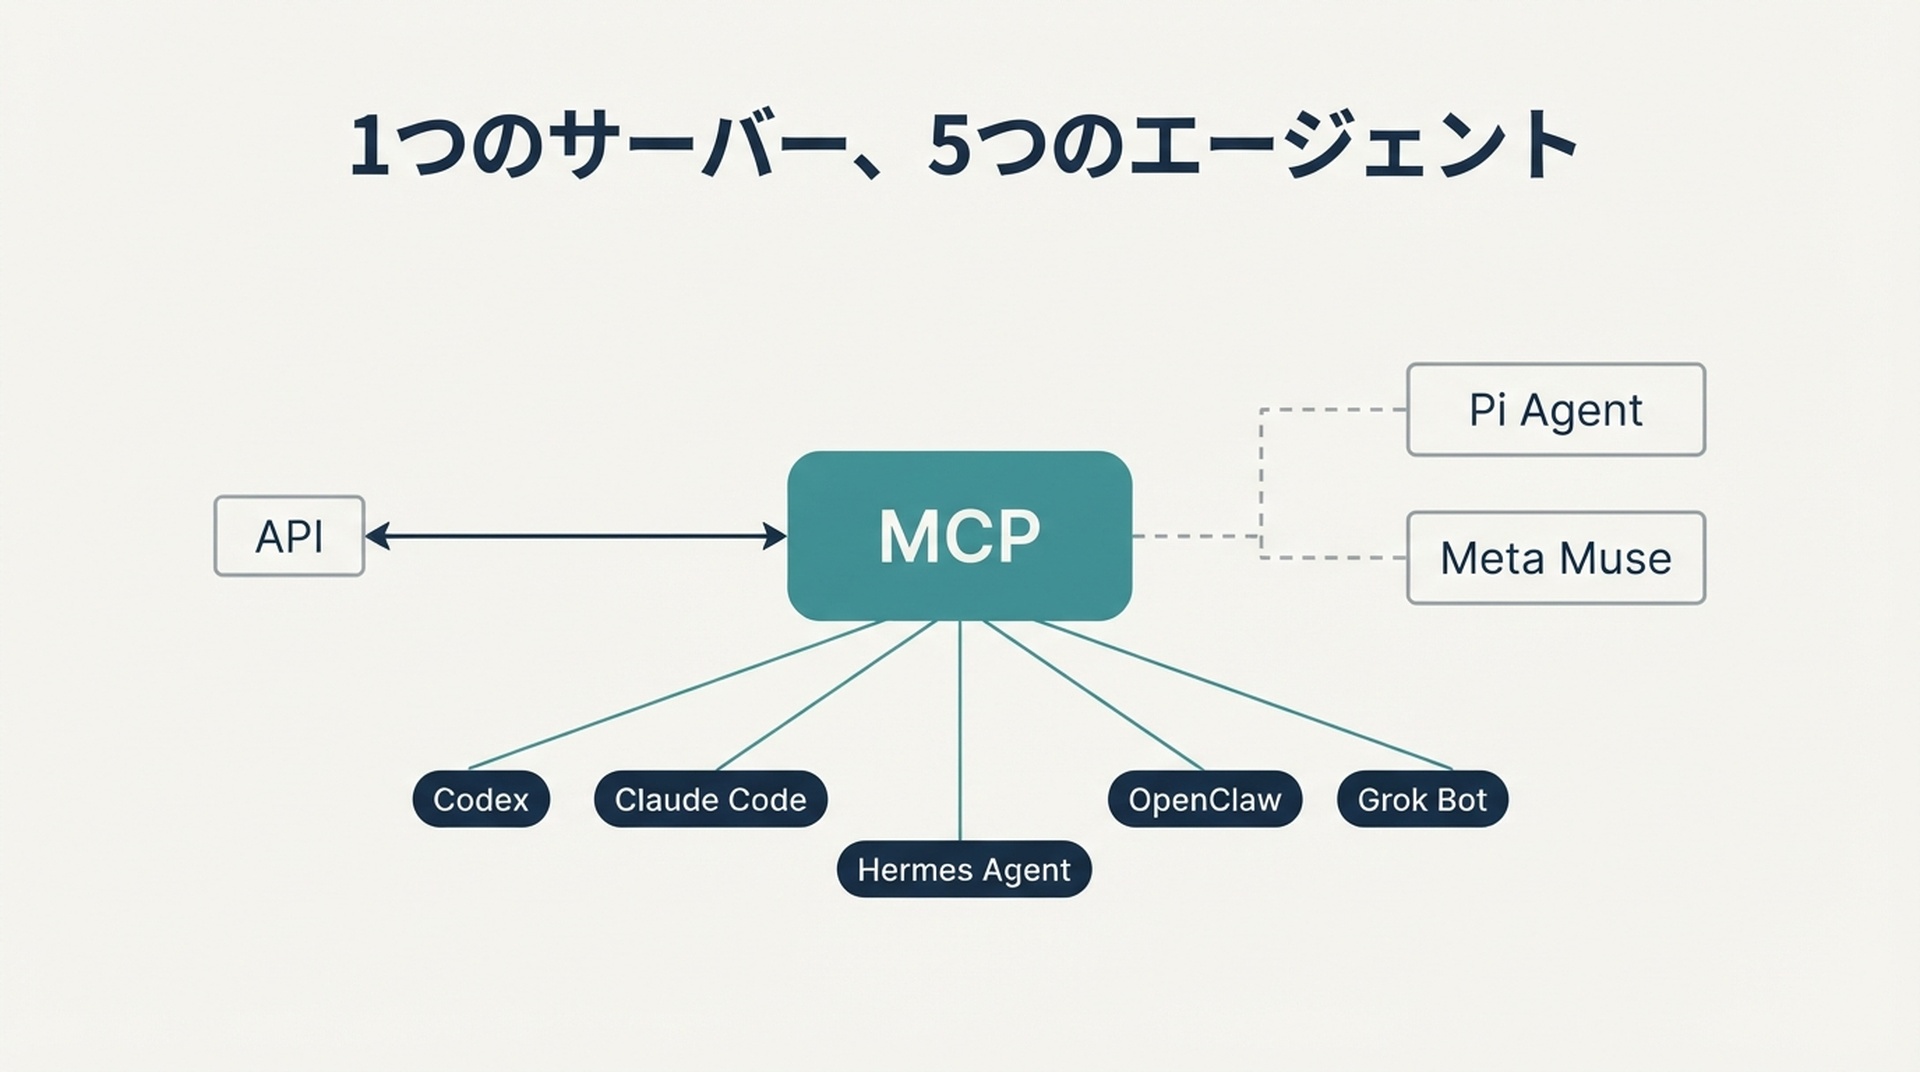
1つのサーバーで7つのエージェントのうち5つをカバーできます。Pi AgentとMeta Museには別の経路が必要です。
各エージェントの接続方法
以下の手順は、接続する情報源のAPIキーまたはトークンをすでに持っていることを前提としています。認証情報をコミットされる設定ファイルに置かないでください。
Codex
CodexはMCP設定をconfig.tomlに保存します。~/.codex/config.tomlか、プロジェクト単位の.codex/config.tomlです。ChatGPTデスクトップアプリ、Codex CLI、IDE拡張はこの設定を共有するので、一度設定すれば済みます。
stdioサーバーの場合:
codex mcp add my-source --env API_KEY=your-key -- npx -y @your-org/my-source-mcpstreamable HTTPサーバーの場合は、config.tomlにテーブルを追加します。
[mcp_servers.my-source]
url = "https://mcp.example.com/mcp"
bearer_token_env_var = "MY_SOURCE_TOKEN"Codexは初期化時に返されるMCPのinstructionsフィールドを読み、サーバー全体の指針として使います。サーバーを作る側なら、最初の512文字を自己完結させておくと、エージェントが呼び出すかどうかを判断するときに最重要の制約が参照できます。
codex mcp listでサーバーが登録されたことを確認し、TUI内の/mcpで有効なサーバーを確認します。
Claude Code
Claude CodeはリモートHTTP、リモートSSE、ローカルstdio、リモートWebSocketのトランスポートをサポートします。リモートサーバーにはHTTPが推奨です。
claude mcp add --transport http my-source https://mcp.example.com/mcp \
  --header "Authorization: Bearer your-token"
ローカルサーバーの場合:
claude mcp add my-source -- npx -y @your-org/my-source-mcpつまずきやすい点が2つあります。1つ目は、JSON設定でurlはあるがtypeがないエントリはstdioサーバーとして扱われ、黙ってスキップされることです。必ず"type": "http"を明示してください。2つ目は、Claude Codeが起動したサーバーの環境にCLAUDE_PROJECT_DIRを設定することです。これにより、ローカルサーバーは作業ディレクトリに依存せずプロジェクト相対のパスを解決できます。
Hermes Agent
Hermes Agentは標準インストールでMCPサポートが付属します。設定は~/.hermes/config.yamlに置きます。
mcp_servers:
  my-source:
    command: "npx"
    args: ["-y", "@your-org/my-source-mcp"]
Hermesは同じ設定でリモートHTTP MCPサーバーもサポートし、サーバー単位のフィルタリングでエージェントに見せたいツールだけを公開できます。このフィルタリングは他のエージェントより重要です。Hermesはスケジュールで無人実行されるためです。
Claude Codeから移行する場合、hermes import-agent claude-codeが~/.claude.jsonのmcpServersブロックをHermes設定のmcp_serversにマッピングし、スキルと指示も同時に引き継ぎます。
情報源に対応するMCPサーバーが存在しない場合、スキルシステムが代替になります。スキルはSKILL.mdを含むディレクトリで、いつ使うか、何をするかをエージェントに伝えます。API呼び出しを同梱のスクリプトに包み、スキルから参照すれば、プロトコルサーバーなしでエージェントに能力を与えられます。
OpenClaw
OpenClawはMCPクライアントとしてもMCPサーバーとしても動作します。クライアントとしては、mcp registryサブコマンドで保存済みサーバー定義を管理し、ブラウザのControl UI設定ページからサーバーを編集・確認できます。
openclaw mcp registry add my-source --transport streamable-http --url https://mcp.example.com/mcp
openclaw mcp status
OpenClawは自身のチャネル会話をMCP経由で公開することもでき、これは逆方向で、別のエージェントにOpenClawインスタンスが何をしてきたかを読ませたいときに便利です。MCPクライアントでない外部エージェント向けには、OpenClawはJSON-RPC上のA2Aを話します。
この作業でOpenClawを選ぶ理由は権限モデルです。チャット単位のツールポリシーと実行の明示的な承認経路があり、エージェントが有料のデータソースを読み、支出を制限したいときに求められるものです。
Pi Agent
Pi AgentにはネイティブのMCPクライアントがなく、これは欠落ではなく設計上の選択です。拡張点はPiプロセス内で動作しツールを登録するTypeScriptモジュールです。
~/.pi/agent/extensions/my-source.tsに拡張を作成します。
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.registerTool({
    name: "my_source_lookup",
    description: "Look up a record in My Source by query.",
    parameters: { type: "object", properties: { query: { type: "string" } }, required: ["query"] },
    handler: async ({ query }) => {
      const res = await fetch(`https://api.example.com/search?q=${encodeURIComponent(query)}`, {
        headers: { Authorization: `Bearer ${process.env.MY_SOURCE_TOKEN}` },
      });
      return await res.json();
    },
  });
}開発中はpi --extension ./my-source.tsで直接読み込み、安定したら拡張ディレクトリに移すかpi installでパッケージ化します。
トレードオフは現実的で、率直に述べる価値があります。拡張はPiプロセスと同じOS権限で動作し、プロンプト、ツール呼び出し、ファイル、認証情報を検査できます。信頼できる提供元の拡張だけを読み込み、インストール前にソースを読んでください。
Grok Bot
GrokのAPIはリモートMCPツールをサポートし、サーバー接続はxAIが代わりに管理します。サーバーはリクエストのtools配列で宣言します。
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import mcp

client = Client(api_key=os.getenv("XAI_API_KEY"))
chat = client.chat.create(
    model="grok-4.7",
    tools=[mcp(server_url="https://mcp.example.com/mcp", server_label="my-source")],
)
リモートMCPツールではstreaming HTTPとSSEのトランスポートのみがサポートされます。公開するツールはallowed_toolsで制限でき、xAIがサーバーへのリクエストのAuthorizationヘッダーに設定する認可トークンを渡せます。
利点は、クライアント側の接続を自分で実行・維持しなくてよいことです。欠点は、MCPサーバーが公開到達可能でなければならず、VPNの内側にあるものは別のアプローチが必要になることです。
Meta Muse
Museはコネクタを通じてサードパーティのアプリやサービスに接続し、エージェント自体に公開されたMCPや開発者APIの面はありません。これが正直な答えであり、できることが変わります。
他の6つのエージェントのようにMuseを監視ワークフローに組み込むことはできません。できるのは、Museが読む情報源をより良くすることです。物販なら正確な商品とカタログのデータ、ローカルなら完全で一貫したビジネス情報、パブリッシャーなら明確なエンティティシグナルを持つクロール可能なページです。Museは問い合わせるデータソースではなく、準備作業の対象です。
MetaがMuseの開発者向けの面を出せば、このセクションは変わります。それまでは、統合するシステムではなく、備えるべきオーディエンスとして扱ってください。
サーバーを1つ作り、5回使い回す
何かを作るなら、最も価値の高い情報源のためのMCPサーバーを1つ作り、使い回してください。上記のMCP対応エージェント5つはすべてstreamable HTTPサーバーを受け入れるので、1回のデプロイで全部をカバーできます。
最小限のサーバーに必要なのは4つです。クエリを受け取り構造化データを返すツール、サーバー側のベアラートークン検証、暴走したエージェントがAPIクォータを焼き尽くさないためのレート制限、そして制約を最初の512文字で述べるinstructionsフィールドです。
手間のほとんどを防ぐ2つのルールがあります。エージェントがテキストを再解析するのではなくフィールドを推論できるよう、散文ではなく構造化データを返すこと。そして、エージェントが1サイクル使うのを見るまでは、すべてのツールを読み取り専用にすることです。読み取り専用のサーバーは何も壊せず、実際の呼び出しパターンを見てから広げられます。
信頼する前に接続を検証する
設定されたサーバーが動くサーバーだと決めつけないでください。次の4つの確認を実行します。
サーバーが登録されているか確認する。codex mcp list、claude mcp list、openclaw mcp statusに表示されるはずです。パースに失敗したサーバーは一部のクライアントで黙ってスキップされます。
ツールの一覧を確認する。サーバーが公開するツールをエージェントに列挙させます。6個を期待して1個しか出ないなら、サーバーは登録されたがツールが登録されていません。
実際のクエリで確認する。手作業で検証できる特定のレコードを求めます。「どんなデータが取れるか」という一般的な質問では何も証明できません。
失敗経路を確認する。トークンを無効化して、もう一度クエリを実行します。欲しいのは明確な認証エラーで、黙った空の結果ではありません。失敗した呼び出しを「データなし」と扱うエージェントは、壊れた接続に対してきれいな結果を報告します。これがこのワークフロー全体で最も高くつく失敗モードです。
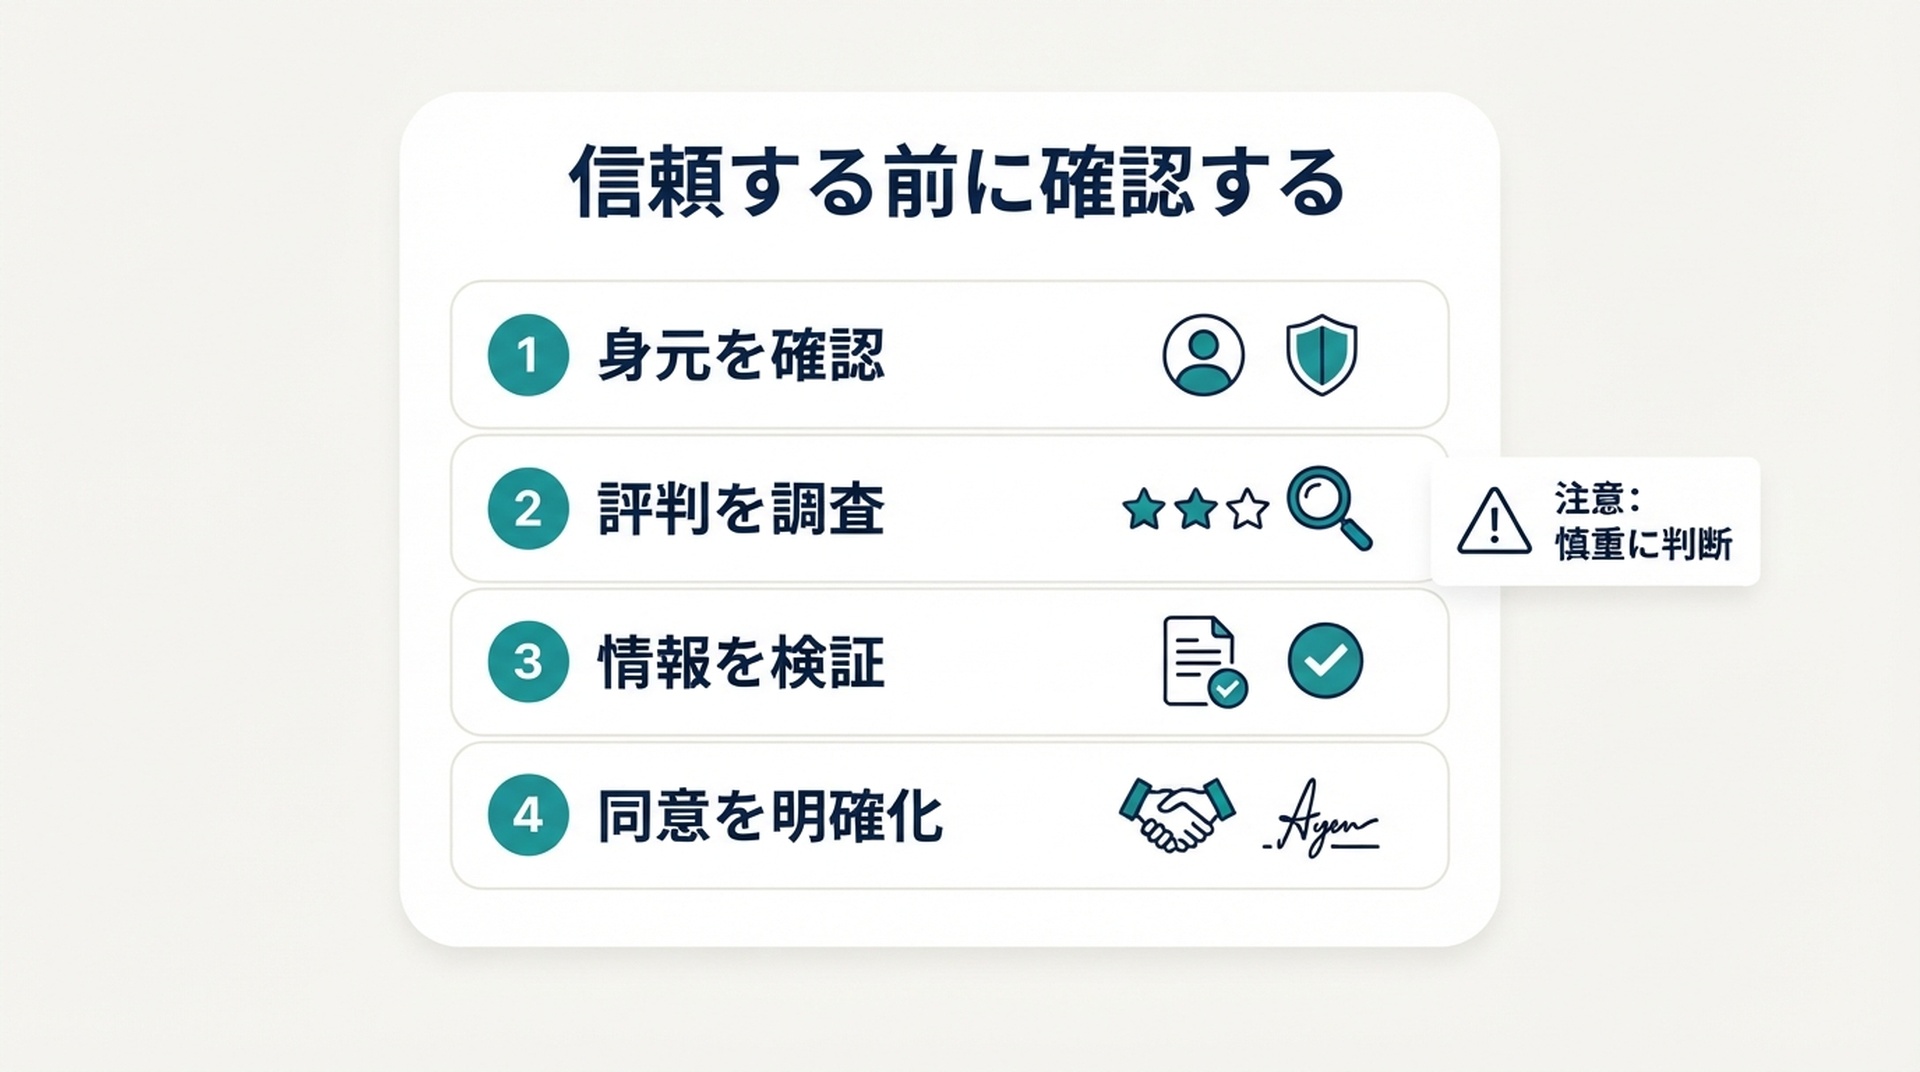
4つの確認。最後の1つが、発見に見える失敗を捕まえます。
これが優先順位に与える変化
階層表と接続表は同じ方向を指しています。エージェントに組み込める情報源は測定できる情報源であり、測定できる情報源はベースラインに対して改善できる情報源です。
つまり作業の順序は、多くのチームが使う順序とは違います。文書化された接続と自分のビジネスへの実際のインパクトの両方がある情報源から始めてください。ローカルビジネスならGoogle Business ProfileとMapsグラウンディングです。物販企業ならMerchant Centerか商品フィードです。開発者ツール企業ならドキュメントの品質です。パブリッシャーならライブページのクロール可能性と抽出可能性です。
そして、その情報源をエージェントに取り込むMCPサーバーを1つ作り、プロトコルを話す5つのエージェントで使い回します。接続経路のない情報源はコンテンツとエンティティの作業として残し、同じようには測定できないことを正直に認めてください。
ここで先を行くチームは、最も長い情報源リストを持つチームではありません。重要な2つか3つの情報源をつなぎ、その周りに監視ループを築いたチームです。
FAQ
データソースへのアクセスをエージェントに与えるのにMCPは必要ですか?いいえ。MCPはほとんどのエージェントが対応する標準であり、最も再利用しやすい選択肢ですが、APIスクリプトを同梱したスキルでも1つのエージェントには十分機能します。1つの情報源を1つのエージェントにつなぐならスキルのほうが手間が少なく、1つの情報源を5つのエージェントにつなぐならMCPはすぐに元が取れます。
どのエージェントから始めるべきですか?作業がすでに存在する場所に合うものから始めてください。サイトがgitリポジトリにあるならCodexかClaude Code。永続メモリを伴うスケジュール実行が欲しいならHermes Agent。有料データソースに厳格な権限境界が必要ならOpenClaw。一息で監査できる最小の面が欲しいならPi Agentです。
MCPサーバーがない情報源を接続できますか?はい、3つの方法があります。情報源にHTTP APIがあり複数のエージェントで使い回したいなら薄いMCPサーバーを書く。1つのエージェントだけが必要ならスクリプトを同梱したスキルを書く。あるいはリモートMCPツールをサポートするエージェントを使い、誰かがホストするサーバーを指定します。
なぜMeta Museに接続できないのですか? MetaはMuseの開発者APIやMCPの面を公開していません。コネクタはベンダー管理です。それが変わるまでは、Museはコンテンツとデータを準備する対象であり、問い合わせるシステムではありません。
階層の割り当ては恒久的ですか?いいえ。このカテゴリは毎月変わります。チームをワークフローにコミットさせる前にベンダーのドキュメントを再確認し、四半期より古い階層の割り当ては未検証として扱ってください。
この作業で最もよくある間違いは何ですか?失敗したAPI呼び出しを実際のゼロとして扱うことです。エージェントがブランドにAI可視性がないと報告し、その根本原因が期限切れのトークンなら、発見に見える測定の失敗です。成功経路を信頼する前に、必ず失敗経路をテストしてください。
Author: Julian Mercer, Auspiaの14年の経験を持つテクニカルSEO実務家。クロール可能性、スキーマ、レンダリング、そしてコンテンツを検索エンジンとAIエージェントの両方にとって読みやすくする技術的基盤について執筆しています。