AI 가시성을 추적하는 대부분의 팀은 여전히 스크린샷에 의존합니다. ChatGPT에 질문을 던지고, 인용을 복사해서 문서에 붙여 넣습니다. 그것으로 알 수 있는 것은 어느 날 오후에 한 모델이 무엇을 답했는지뿐입니다. 답변 엔진이 실제로 어떤 정보원에 접근할 수 있는지는 알 수 없고, 에이전트가 스스로 조회할 수 있는 재료도 되지 않습니다.
이 작업의 더 쓸모 있는 형태는 정보원 지도와 연결 경로의 조합입니다. 자기 카테고리에서 중요한 데이터 소스를 정하고, 접근할 수 있는 것은 모니터링을 돌리는 에이전트에 직접 연결합니다. 남는 것은 간접적으로만 영향을 줄 수 있는 정보원의 짧은 목록이고, 그 목록은 대개 생각보다 짧습니다.
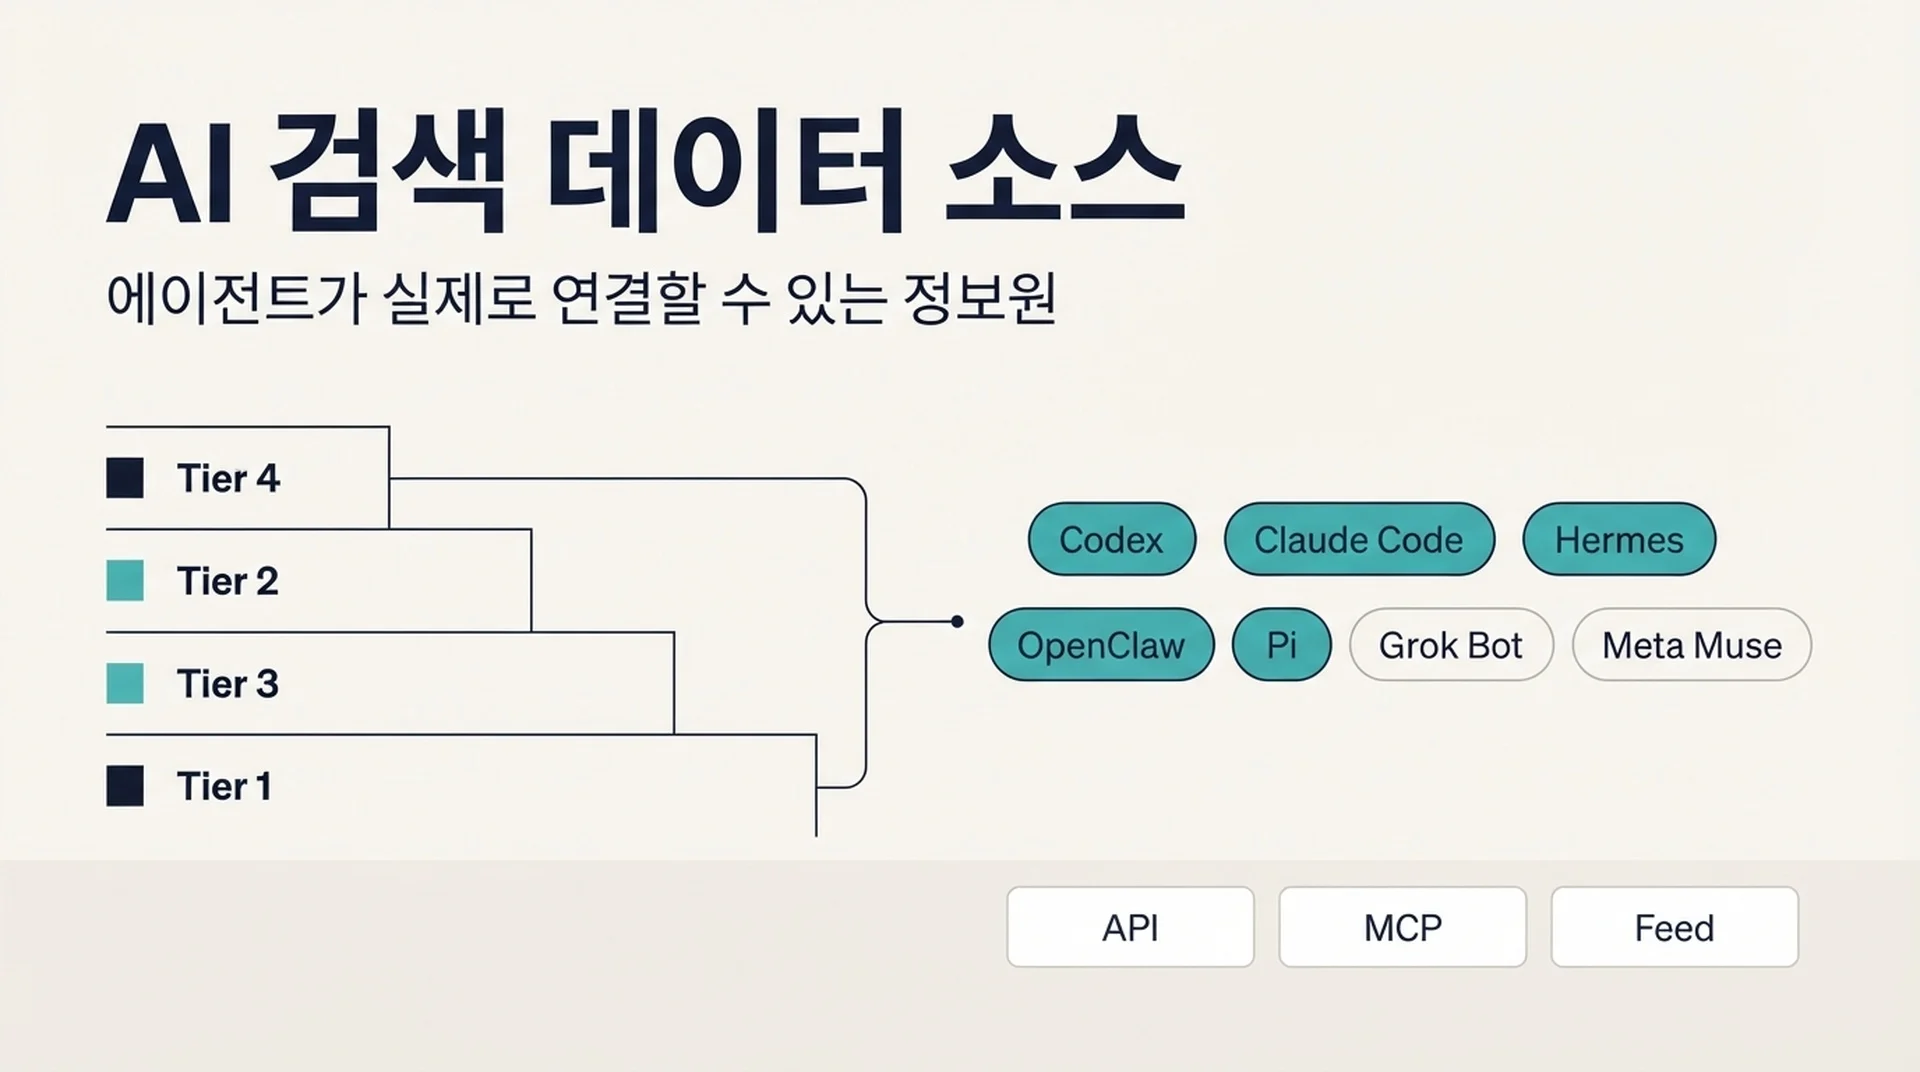
이 글에서는 세 가지를 다룹니다. AI 답변을 뒷받침하는 데이터 소스를 증거가 얼마나 확실하고 얼마나 현재적인지에 따라 계층으로 나눕니다. 연결 경로가 있는 것에는 구체적인 API 또는 MCP 경로를 제시합니다. 그리고 Codex, Claude Code, Hermes Agent, OpenClaw, Pi Agent, Grok Bot, Meta Muse 각각의 연결 방법을, 기성 커넥터가 없어 직접 브리지를 만들어야 하는 경우까지 포함해 설명합니다.
짧은 답변
AI 답변을 뒷받침하는 정보원은 네 가지 범주로 나뉘며, 접근 가능성은 같지 않습니다.
웹과 검색 발견 정보원은 그라운딩 API와 자체 크롤링 가능한 페이지를 통해 접근할 수 있습니다. 구조화된 커머스 피드는 문서화된 피드 사양을 통해 접근할 수 있지만, 접근은 승인으로 제한됩니다. 지식과 커뮤니티 코퍼스는 일부는 라이선스된 API로 접근할 수 있고, 일부는 영향을 줄 수 없는 학습 시점의 수집 뒤에 잠겨 있습니다. 에이전트 액션 표면은 아직 정리 중인 프로토콜 사양을 통해 접근할 수 있습니다.
에이전트 주도 모니터링 워크플로로 바꾸면 실용적인 규칙이 됩니다. 문서화된 API나 MCP 서버가 있는 것은 연결합니다. 피드 사양이 있는 것은 데이터 품질 프로젝트로 다룹니다. 둘 다 없는 것은 데이터 프로젝트가 아니라 콘텐츠와 엔티티 프로젝트로 다룹니다.
계층 표를 읽는 방법
아래 계층은 해당 정보원이 현재 AI 답변을 뒷받침한다는 증거의 강도와, 그 연결이 현재의 것인지 역사적인 것인지로 분류합니다. 여기서 대부분의 정보원 목록이 틀립니다. 2022년에 모델을 형성한 정보원과 오늘 모델이 조회하는 정보원은 다른 것이며, 이를 혼동하면 전략을 그르칩니다.
계층 | 의미 | 워크플로에 대한 의미 |
|---|---|---|
1 | 확인됨 + 현재 | 실시간 그라운딩, 검색, 액션. 연결하고 모니터링하고 최적화한다. |
2 | 확인됨 + 현재 | 학습 또는 라이선스. API가 아니라 콘텐츠와 제휴를 통해 영향을 준다. |
3 | 확인된 역사적 데이터 | 사전 학습 전용. 실시간 지렛대가 없다. 모니터링 워크플로의 대상으로 삼지 않는다. |
4 | 강한 증거, 미확인 | 범주 추론. 주시할 가치는 있지만 예산을 배정할 단계는 아니다. |
표에 앞서 한 가지 주의점이 있습니다. 이 범주는 매달 바뀝니다. 벤더 문서, 라이선스 계약, 피드 사양이 모두 움직입니다. 계층 배정은 출발점으로 삼고, 팀을 워크플로에 투입하기 전에 벤더 자체 문서로 다시 확인하십시오.
계층 1: 에이전트가 실제로 접근할 수 있는 실시간 정보원
여기는 오늘 문서화된 연결이 존재하는 정보원입니다. 에이전트가 AI 가시성 데이터를 스스로 가져올 것이라면 여기서 시작합니다.
웹과 검색 발견
Google Search 그라운딩. Gemini API는 google_search 도구를 제공하며, 모델을 실시간 웹 콘텐츠에 연결하고 정보원 URL에 대한 인용을 반환합니다. 문서화되어 있고 현재 유효하며, 시장에서 가장 명확한 실시간 그라운딩 사례입니다. 즉 지렛대가 되는 것은 피드가 아니라 크롤링 가능성과 페이지 구조입니다.
Bing Search. Microsoft는 Bing 결과가 Copilot 응답을 강화하는 데 사용된다고 문서화합니다. 실무적 의미는 Google과 같습니다. 노출되고 싶다면 페이지가 접근 가능하고 추출 가능해야 합니다.
실시간 퍼블리셔 페이지. 사전 학습이 아니라 추론 시점에 검색 그라운딩을 통해 접근됩니다. 검색 결과 선택과 크롤링 가능성이 포함 여부를 좌우하므로, 테크니컬 SEO 작업이 AI 가시성 결과에도 나타납니다.
제품과 쇼핑
Google Merchant Center. 머천트 피드 데이터가 Google의 쇼핑 표면을 뒷받침합니다. 실물 상품을 팔면서 Merchant Center에 없다면, AI 답변에 적극적으로 연결되고 있는 표면에서 부재한 것입니다.
OpenAI 머천트/리테일 피드. 머천트는 구조화된 상품 피드를 공유하며, Agentic Commerce Protocol 문서에는 스키마, 파일 업로드와 API 통합 경로, 하루 동안 업데이트를 받아들이는 갱신 주기가 설명되어 있습니다. 접근은 현재 승인된 파트너로 제한되므로, 스위치를 켜는 일이 아니라 리드 타임이 있는 프로젝트입니다.
로컬과 장소
Google Maps 그라운딩. Search 그라운딩과 나란한 도구로 문서화되어 있으며, 모델에 지리적 맥락을 제공합니다. 주변 선택지에 대한 AI 답변에 정확하고 완전한 프로필을 가진 로컬 비즈니스가 등장하는 이유입니다.
Google Business Profile. 비즈니스 프로필 데이터가 Google의 로컬 표면을 뒷받침합니다. 로컬 비즈니스에게 이 목록에서 지렛대 효과가 가장 크고 수고가 가장 적은 정보원 중 하나입니다.
Yelp. Yelp는 실시간 로컬 추천을 위해 리뷰, 사진, 비즈니스 정보를 라이선스하며, 그 관계는 그라운딩을 넘어 액션까지 확장됩니다. 리뷰 플랫폼이 인용 출처와 거래 표면을 동시에 하는 드문 정보원 중 하나입니다.
지식과 참조
Wikipedia와 Wikimedia. 공개된 사전 학습 혼합에 포함되어 있고 실시간 참조 코퍼스로도 널리 쓰입니다. 라이선스가 유난히 명확해서 엔티티 작업의 정당한 대상이 됩니다.
커뮤니티, Q&A, 소셜
Reddit. 데이터 라이선스 계약을 통한 실시간 그라운딩 정보원이며, 학습 측은 별도로 보고됩니다. 갱신 상태는 불안정한 것으로 다루고, 영구적 접근을 전제로 한 워크플로를 만들지 마십시오.
계층 2와 3: 조회하는 것이 아니라 영향을 주는 정보원
이들은 중요하지만, 에이전트가 호출할 수 있는 API를 통해서가 아닙니다.
라이선스된 퍼블리셔 콘텐츠. 주요 출판사와 명시적 라이선스 제휴가 여럿 존재하며, 조건은 제휴처마다 학습, 그라운딩, 귀속의 처리가 다릅니다. 작은 사이트가 이 목록에 들어가기 위해 돈을 낼 수는 없지만, 라이선스된 코퍼스가 자기 주제에 대해 얇을 때 인용되는 종류의 정보원이 될 수는 있습니다.
개발자 및 기술 정보원. 공개 코드 저장소와 기술 문서 코퍼스는 확인된 현재 정보원입니다. 개발자 도구 기업에게 이 목록에서 가장 가치 높은 계층이며, 피드가 아니라 문서 품질을 통해 접근할 수 있습니다.
역사적 웹 코퍼스. 커먼 크롤 데이터의 정제된 파생본과 유사 아카이브입니다. 확인된 역사적 데이터이고 실시간 지렛대는 없습니다. 모델이 왜 특정 사전 가정을 가지는지 이해하는 맥락으로는 유용하지만 모니터링 워크플로에는 맞지 않습니다.
연결 계층: 각 에이전트가 접근할 수 있는 것
여기가 이 글의 핵심입니다. 아래 표는 각 에이전트가 실제로 지원하는 연결 방식과, 위 정보원에 대한 기성 커넥터의 솔직한 상황을 대응시킵니다.
에이전트 | 연결 방식 | 기성 정보원 커넥터 | 직접 만드는 것 |
|---|---|---|---|
Codex |
| 커뮤니티 MCP 서버의 성장 중인 레지스트리 | HTTP API가 있는 정보원용 얇은 MCP 서버 |
Claude Code | HTTP, SSE, stdio, WebSocket 기반 MCP | Anthropic 커넥터 디렉터리와 커뮤니티 서버 | 같은 서버를 |
Hermes Agent | 서버별 도구 필터링을 갖춘 MCP와 네이티브 스킬 | 원클릭 설치가 가능한 엄선 MCP 카탈로그 | MCP가 없을 때 API를 감싸는 스킬 |
OpenClaw | MCP 클라이언트 겸 서버, 그리고 A2A JSON-RPC | OpenClaw MCP 레지스트리와 저장된 서버 정의 | 저장한 MCP 정의 또는 A2A 브리지 |
Pi Agent | TypeScript 확장과 스킬. 네이티브 MCP 클라이언트 없음 | 기본적으로 없음 | API를 도구로 호출하는 작은 확장 |
Grok Bot | API 요청에서 선언하는 원격 MCP 도구 | 직접 지정한 임의의 원격 MCP 서버 | 원격 MCP 서버 (연결은 Grok이 관리) |
Meta Muse | 커넥터. 공개된 MCP나 API 표면 없음 | 벤더 관리 커넥터만 | 간접 작업만: 피드, 엔티티 데이터, 크롤링 가능한 페이지 |
주목할 패턴은 이렇습니다. 일곱 에이전트 중 다섯이 MCP를 말하고, 말하지 않는 둘은 스펙트럼의 양 끝에 있습니다. Pi Agent는 의도적으로 최소이며 확장을 작성하는 것을 전제로 합니다. Meta Muse는 개발자 표면이 전혀 없는 소비자 제품입니다.
즉 효율적인 움직임은 가장 가치 높은 정보원을 위한 MCP 서버를 하나 만들고 Codex, Claude Code, Hermes Agent, OpenClaw, Grok Bot에서 재사용하는 것입니다. 작성은 한 번이면 됩니다.
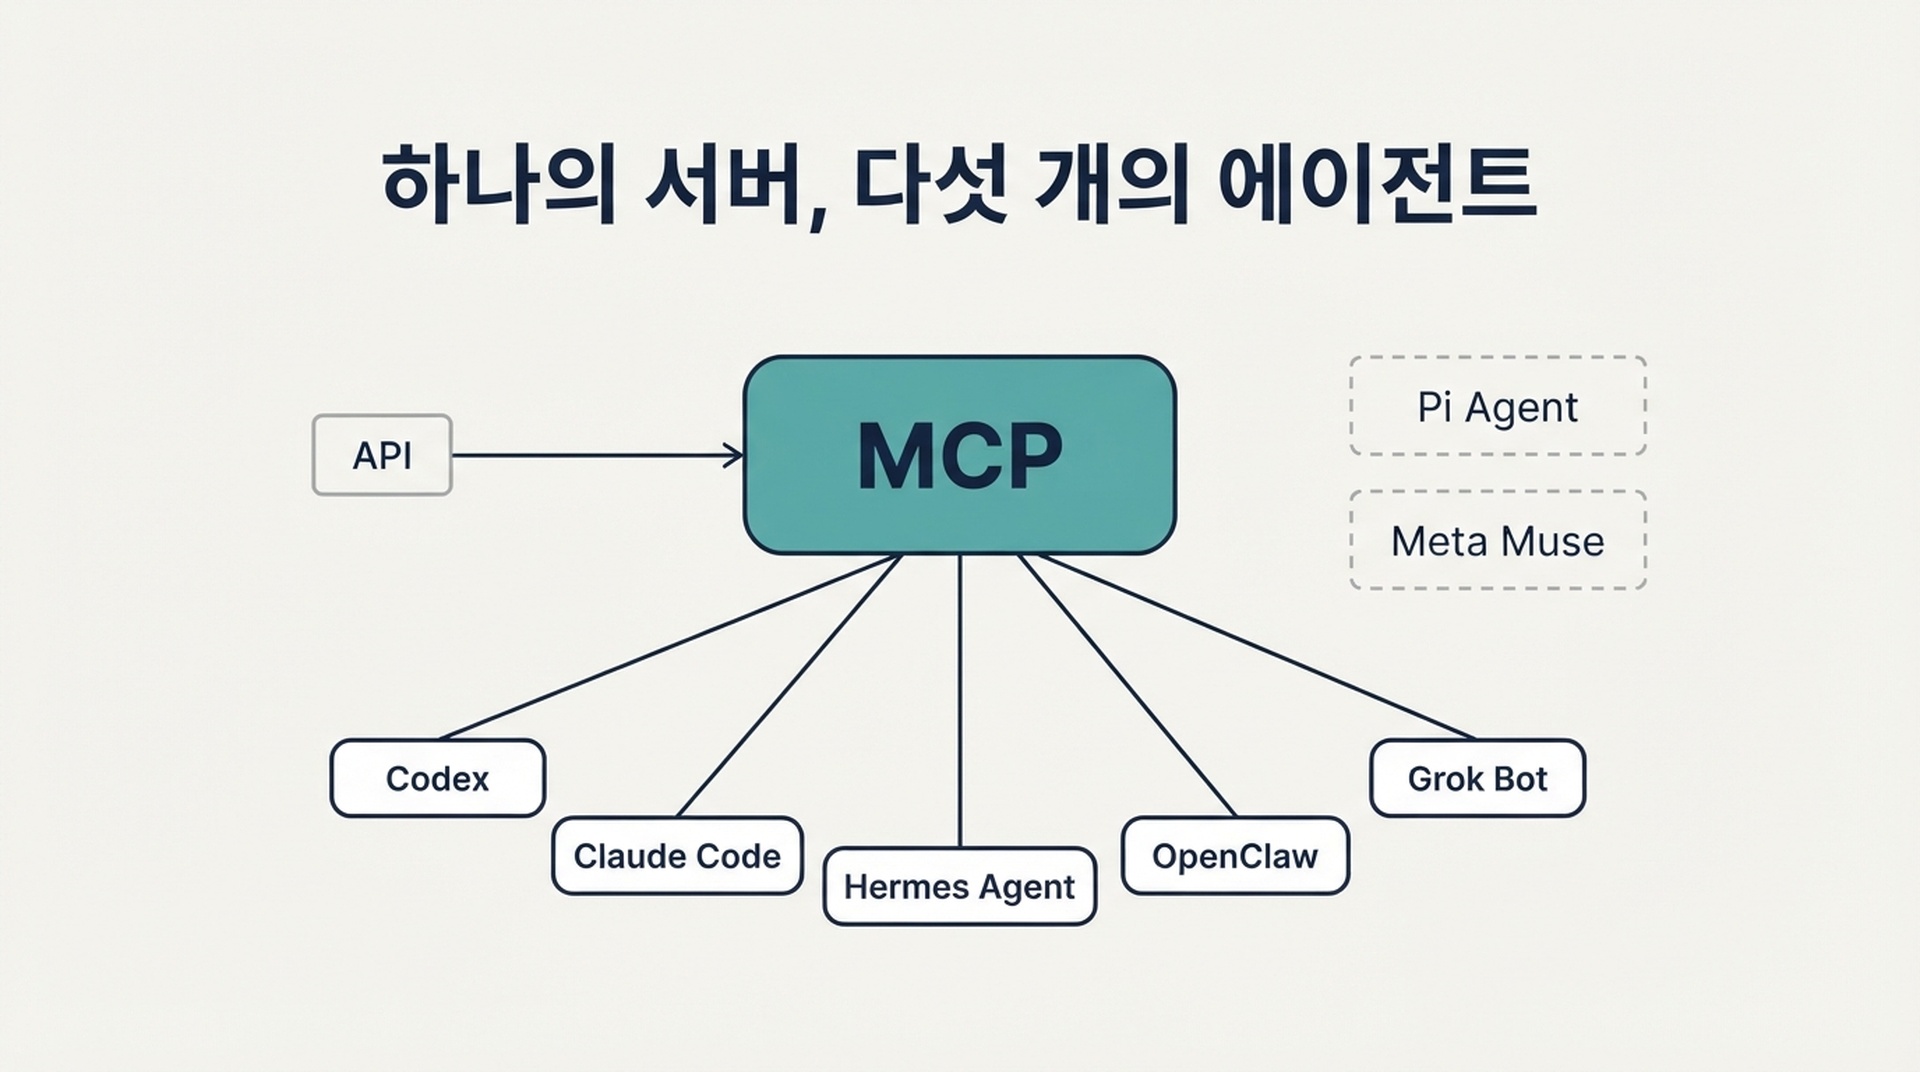
서버 하나로 일곱 에이전트 중 다섯을 커버합니다. Pi Agent와 Meta Muse에는 다른 경로가 필요합니다.
각 에이전트 연결 방법
아래 단계는 연결하려는 정보원의 API 키나 토큰을 이미 보유했다고 가정합니다. 자격 증명을 커밋되는 설정 파일에 두지 마십시오.
Codex
Codex는 MCP 설정을 config.toml에 저장합니다. ~/.codex/config.toml 또는 프로젝트 단위의 .codex/config.toml입니다. ChatGPT 데스크톱 앱, Codex CLI, IDE 확장이 이 설정을 공유하므로 한 번만 설정하면 됩니다.
stdio 서버의 경우:
codex mcp add my-source --env API_KEY=your-key -- npx -y @your-org/my-source-mcpstreamable HTTP 서버의 경우 config.toml에 테이블을 추가합니다.
[mcp_servers.my-source]
url = "https://mcp.example.com/mcp"
bearer_token_env_var = "MY_SOURCE_TOKEN"
Codex는 초기화 시 반환되는 MCP instructions 필드를 읽어 서버 전체 지침으로 사용합니다. 서버를 만드는 쪽이라면 처음 512자를 자기완결적으로 유지하십시오. 에이전트가 호출 여부를 판단할 때 가장 중요한 제약이 참조됩니다.
codex mcp list로 서버 등록을 확인하고, TUI 안의 /mcp로 활성 서버를 확인합니다.
Claude Code
Claude Code는 원격 HTTP, 원격 SSE, 로컬 stdio, 원격 WebSocket 전송을 지원합니다. 원격 서버에는 HTTP가 권장됩니다.
claude mcp add --transport http my-source https://mcp.example.com/mcp \
  --header "Authorization: Bearer your-token"
로컬 서버의 경우:
claude mcp add my-source -- npx -y @your-org/my-source-mcp사람들이 자주 걸리는 점이 두 가지 있습니다. 첫째, JSON 설정에서 url은 있지만 type이 없는 항목은 stdio 서버로 취급되어 조용히 건너뜁니다. 반드시 "type": "http"를 명시하십시오. 둘째, Claude Code는 실행한 서버 환경에 CLAUDE_PROJECT_DIR을 설정합니다. 덕분에 로컬 서버는 작업 디렉터리에 의존하지 않고 프로젝트 상대 경로를 해석할 수 있습니다.
Hermes Agent
Hermes Agent는 표준 설치에 MCP 지원이 포함됩니다. 설정은 ~/.hermes/config.yaml에 둡니다.
mcp_servers:
  my-source:
    command: "npx"
    args: ["-y", "@your-org/my-source-mcp"]
Hermes는 같은 설정에서 원격 HTTP MCP 서버도 지원하며, 서버별 필터링으로 에이전트에 보여줄 도구만 노출할 수 있습니다. 이 필터링은 다른 에이전트보다 더 중요합니다. Hermes는 일정에 따라 무인 실행되기 때문입니다.
Claude Code에서 이전하는 경우 hermes import-agent claude-code가 ~/.claude.json의 mcpServers 블록을 Hermes 설정의 mcp_servers로 매핑하고 스킬과 지침도 함께 가져옵니다.
정보원에 대응하는 MCP 서버가 없으면 스킬 시스템이 대안이 됩니다. 스킬은 SKILL.md를 포함한 디렉터리로, 언제 쓸지 무엇을 할지 에이전트에 알려 줍니다. API 호출을 동봉 스크립트로 감싸고 스킬에서 참조하면 프로토콜 서버 없이 에이전트에 능력을 부여할 수 있습니다.
OpenClaw
OpenClaw는 MCP 클라이언트이자 MCP 서버로 동작합니다. 클라이언트로서 mcp registry 하위 명령으로 저장된 서버 정의를 관리하고, 브라우저 Control UI 설정 페이지에서 서버를 편집하고 점검할 수 있습니다.
openclaw mcp registry add my-source --transport streamable-http --url https://mcp.example.com/mcp
openclaw mcp status
OpenClaw는 자체 채널 대화를 MCP로 노출할 수도 있는데, 이는 반대 방향이며 다른 에이전트가 OpenClaw 인스턴스가 무엇을 해 왔는지 읽게 하고 싶을 때 유용합니다. MCP 클라이언트가 아닌 외부 에이전트에게는 OpenClaw가 JSON-RPC 기반 A2A를 말합니다.
이 작업에서 OpenClaw를 고르는 이유는 권한 모델입니다. 채팅별 도구 정책과 실행에 대한 명시적 승인 경로가 있어, 에이전트가 유료 데이터 소스를 읽고 지출을 제한해야 할 때 필요한 것입니다.
Pi Agent
Pi Agent에는 네이티브 MCP 클라이언트가 없으며, 이는 누락이 아니라 설계상의 선택입니다. 확장 지점은 Pi 프로세스 안에서 동작하고 도구를 등록하는 TypeScript 모듈입니다.
~/.pi/agent/extensions/my-source.ts에 확장을 만듭니다.
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.registerTool({
    name: "my_source_lookup",
    description: "Look up a record in My Source by query.",
    parameters: { type: "object", properties: { query: { type: "string" } }, required: ["query"] },
    handler: async ({ query }) => {
      const res = await fetch(`https://api.example.com/search?q=${encodeURIComponent(query)}`, {
        headers: { Authorization: `Bearer ${process.env.MY_SOURCE_TOKEN}` },
      });
      return await res.json();
    },
  });
}
개발 중에는 pi --extension ./my-source.ts로 직접 로드하고, 안정되면 확장 디렉터리로 옮기거나 pi install로 패키징합니다.
트레이드오프는 현실적이고 솔직히 말할 가치가 있습니다. 확장은 Pi 프로세스와 같은 OS 권한으로 실행되며 프롬프트, 도구 호출, 파일, 자격 증명을 검사할 수 있습니다. 신뢰할 수 있는 출처의 확장만 로드하고 설치 전에 소스를 읽으십시오.
Grok Bot
Grok API는 원격 MCP 도구를 지원하며, 서버 연결은 xAI가 대신 관리합니다. 서버는 요청의 tools 배열에서 선언합니다.
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import mcp

client = Client(api_key=os.getenv("XAI_API_KEY"))
chat = client.chat.create(
    model="grok-4.7",
    tools=[mcp(server_url="https://mcp.example.com/mcp", server_label="my-source")],
)
원격 MCP 도구에서는 streaming HTTP와 SSE 전송만 지원됩니다. 노출할 도구는 allowed_tools로 제한할 수 있고, xAI가 서버 요청의 Authorization 헤더에 설정할 인가 토큰을 전달할 수 있습니다.
장점은 클라이언트 측 연결을 직접 실행하고 유지하지 않아도 된다는 것입니다. 단점은 MCP 서버가 공개적으로 접근 가능해야 하므로 VPN 내부에 있는 것은 다른 접근이 필요하다는 점입니다.
Meta Muse
Muse는 커넥터를 통해 서드파티 앱과 서비스에 연결하며, 에이전트 자체에 공개된 MCP나 개발자 API 표면이 없습니다. 이것이 솔직한 답이며 할 수 있는 일이 달라집니다.
다른 여섯 에이전트처럼 Muse를 모니터링 워크플로에 연결할 수는 없습니다. 할 수 있는 것은 Muse가 읽는 정보원을 더 좋게 만드는 것입니다. 상품을 판다면 정확한 상품과 카탈로그 데이터, 로컬이라면 완전하고 일관된 비즈니스 정보, 퍼블리셔라면 명확한 엔티티 신호를 가진 크롤링 가능한 페이지입니다. Muse는 조회하는 데이터 소스가 아니라 준비 작업의 대상입니다.
Meta가 Muse의 개발자 표면을 내놓으면 이 섹션은 바뀝니다. 그때까지는 통합할 시스템이 아니라 대비해야 할 오디언스로 다루십시오.
서버 하나를 만들고 다섯 번 재사용하기
무언가를 만든다면 가장 가치 높은 정보원을 위한 MCP 서버를 하나 만들고 재사용하십시오. 위의 MCP 지원 에이전트 다섯은 모두 streamable HTTP 서버를 받아들이므로 배포 한 번으로 전부 커버됩니다.
최소한의 서버에 필요한 것은 네 가지입니다. 쿼리를 받아 구조화된 데이터를 반환하는 도구, 서버 측 베어러 토큰 검증, 폭주하는 에이전트가 API 할당량을 태우지 못하게 하는 속도 제한, 그리고 제약을 처음 512자에 명시하는 instructions 필드입니다.
수고를 대부분 막아 주는 규칙 두 가지가 있습니다. 에이전트가 텍스트를 다시 파싱하는 대신 필드를 추론할 수 있도록 산문이 아니라 구조화된 데이터를 반환하십시오. 그리고 에이전트가 한 주기 사용하는 것을 지켜볼 때까지 모든 도구를 읽기 전용으로 두십시오. 읽기 전용 서버는 아무것도 망가뜨릴 수 없고, 실제 호출 패턴을 본 뒤에 넓힐 수 있습니다.
신뢰하기 전에 연결을 검증하십시오
설정된 서버가 동작하는 서버라고 가정하지 마십시오. 다음 네 가지 확인을 실행합니다.
서버가 등록되었는지 확인합니다. codex mcp list, claude mcp list, openclaw mcp status에 나타나야 합니다. 파싱에 실패한 서버는 일부 클라이언트에서 조용히 건너뜁니다.
도구 목록을 확인합니다. 서버가 노출하는 도구를 에이전트에게 나열하게 합니다. 여섯 개를 기대했는데 하나만 나온다면 서버는 등록되었지만 도구는 등록되지 않은 것입니다.
실제 쿼리로 확인합니다. 손으로 검증할 수 있는 특정 레코드를 요청합니다. "어떤 데이터를 얻을 수 있나"라는 일반적인 질문은 아무것도 증명하지 못합니다.
실패 경로를 확인합니다. 토큰을 무효화하고 쿼리를 다시 실행합니다. 원하는 것은 명확한 인증 오류이지 조용한 빈 결과가 아닙니다. 실패한 호출을 "데이터 없음"으로 처리하는 에이전트는 끊긴 연결에 대해 깨끗한 결과를 보고합니다. 이것이 이 워크플로 전체에서 가장 비용이 큰 실패 모드입니다.
네 가지 확인. 마지막 하나가 발견처럼 보이는 실패를 잡아냅니다.
이것이 우선순위에 주는 변화
계층 표와 연결 표는 같은 방향을 가리킵니다. 에이전트에 연결할 수 있는 정보원은 측정할 수 있는 정보원이고, 측정할 수 있는 정보원은 기준선 대비 개선할 수 있는 정보원입니다.
즉 작업 순서는 대부분의 팀이 쓰는 순서와 다릅니다. 문서화된 연결과 자기 비즈니스에 대한 실제 영향이 모두 있는 정보원부터 시작하십시오. 로컬 비즈니스라면 Google Business Profile과 Maps 그라운딩입니다. 상품 기업이라면 Merchant Center나 상품 피드입니다. 개발자 도구 기업이라면 문서 품질입니다. 퍼블리셔라면 실시간 페이지의 크롤링 가능성과 추출 가능성입니다.
그다음 그 정보원을 에이전트에 넣는 MCP 서버를 하나 만들고, 프로토콜을 말하는 다섯 에이전트에서 재사용합니다. 연결 경로가 없는 정보원은 콘텐츠와 엔티티 작업으로 남기고, 같은 방식으로 측정할 수 없다는 점을 솔직히 인정하십시오.
여기서 앞서 나가는 팀은 가장 긴 정보원 목록을 가진 팀이 아닙니다. 중요한 두세 개의 정보원을 연결하고 그 주위에 모니터링 루프를 세운 팀입니다.
FAQ
데이터 소스에 대한 접근을 에이전트에 주려면 MCP가 필요한가요? 아니요. MCP는 대부분의 에이전트가 지원하는 표준이며 가장 재사용하기 쉬운 선택이지만, API 스크립트를 동봉한 스킬도 에이전트 하나에는 충분히 작동합니다. 정보원 하나를 에이전트 하나에 연결한다면 스킬이 수고가 적고, 정보원 하나를 에이전트 다섯에 연결한다면 MCP는 곧바로 본전을 뽑습니다.
어떤 에이전트부터 시작해야 하나요? 작업이 이미 있는 곳에 맞는 것으로 시작하십시오. 사이트가 git 저장소에 있다면 Codex나 Claude Code. 영구 메모리를 동반한 예약 실행을 원한다면 Hermes Agent. 유료 데이터 소스에 엄격한 권한 경계가 필요하다면 OpenClaw. 한 번에 감사할 수 있는 최소한의 표면을 원한다면 Pi Agent입니다.
MCP 서버가 없는 정보원을 연결할 수 있나요? 네, 세 가지 방법이 있습니다. 정보원에 HTTP API가 있고 여러 에이전트에서 재사용하고 싶다면 얇은 MCP 서버를 작성합니다. 에이전트 하나만 필요하다면 스크립트를 동봉한 스킬을 작성합니다. 또는 원격 MCP 도구를 지원하는 에이전트를 사용해 누군가 호스팅하는 서버를 지정합니다.
왜 Meta Muse에는 연결할 수 없나요? Meta는 Muse의 개발자 API나 MCP 표면을 공개하지 않았습니다. 커넥터는 벤더 관리입니다. 그것이 바뀌기 전까지 Muse는 콘텐츠와 데이터를 준비할 대상이며, 조회할 시스템이 아닙니다.
계층 배정은 영구적인가요? 아니요. 이 범주는 매달 바뀝니다. 팀을 워크플로에 투입하기 전에 벤더 문서를 다시 확인하고, 분기보다 오래된 계층 배정은 미검증으로 다루십시오.
이 작업에서 가장 흔한 실수는 무엇인가요? 실패한 API 호출을 실제 0으로 처리하는 것입니다. 에이전트가 브랜드에 AI 가시성이 없다고 보고했는데 근본 원인이 만료된 토큰이라면, 발견처럼 보이는 측정 실패입니다. 성공 경로를 신뢰하기 전에 반드시 실패 경로를 테스트하십시오.
Author: Julian Mercer, Auspia의 14년 경력 테크니컬 SEO 실무자. 크롤링 가능성, 스키마, 렌더링, 그리고 콘텐츠를 검색 엔진과 AI 에이전트 모두에게 읽히게 하는 기술적 기반에 대해 씁니다.