La mayoría de los equipos que siguen la visibilidad de marca en las respuestas de IA todavía trabajan a partir de una captura de pantalla. Le hacen una pregunta a ChatGPT, copian las citas y las pegan en un documento. Eso dice qué respondió un modelo una tarde. No dice a qué fuentes puede llegar realmente el motor de respuestas, y no le da a tu agente nada que consultar por su cuenta.
La versión más útil de este trabajo es un mapa de fuentes junto con una ruta de conexión. Tú decides qué fuentes de datos importan para tu categoría y luego conectas lo que sí puedes alcanzar directamente al agente que corre el monitoreo. Lo que queda es una lista corta de fuentes sobre las que solo puedes influir de forma indirecta, y esa lista suele ser más corta de lo que parece.
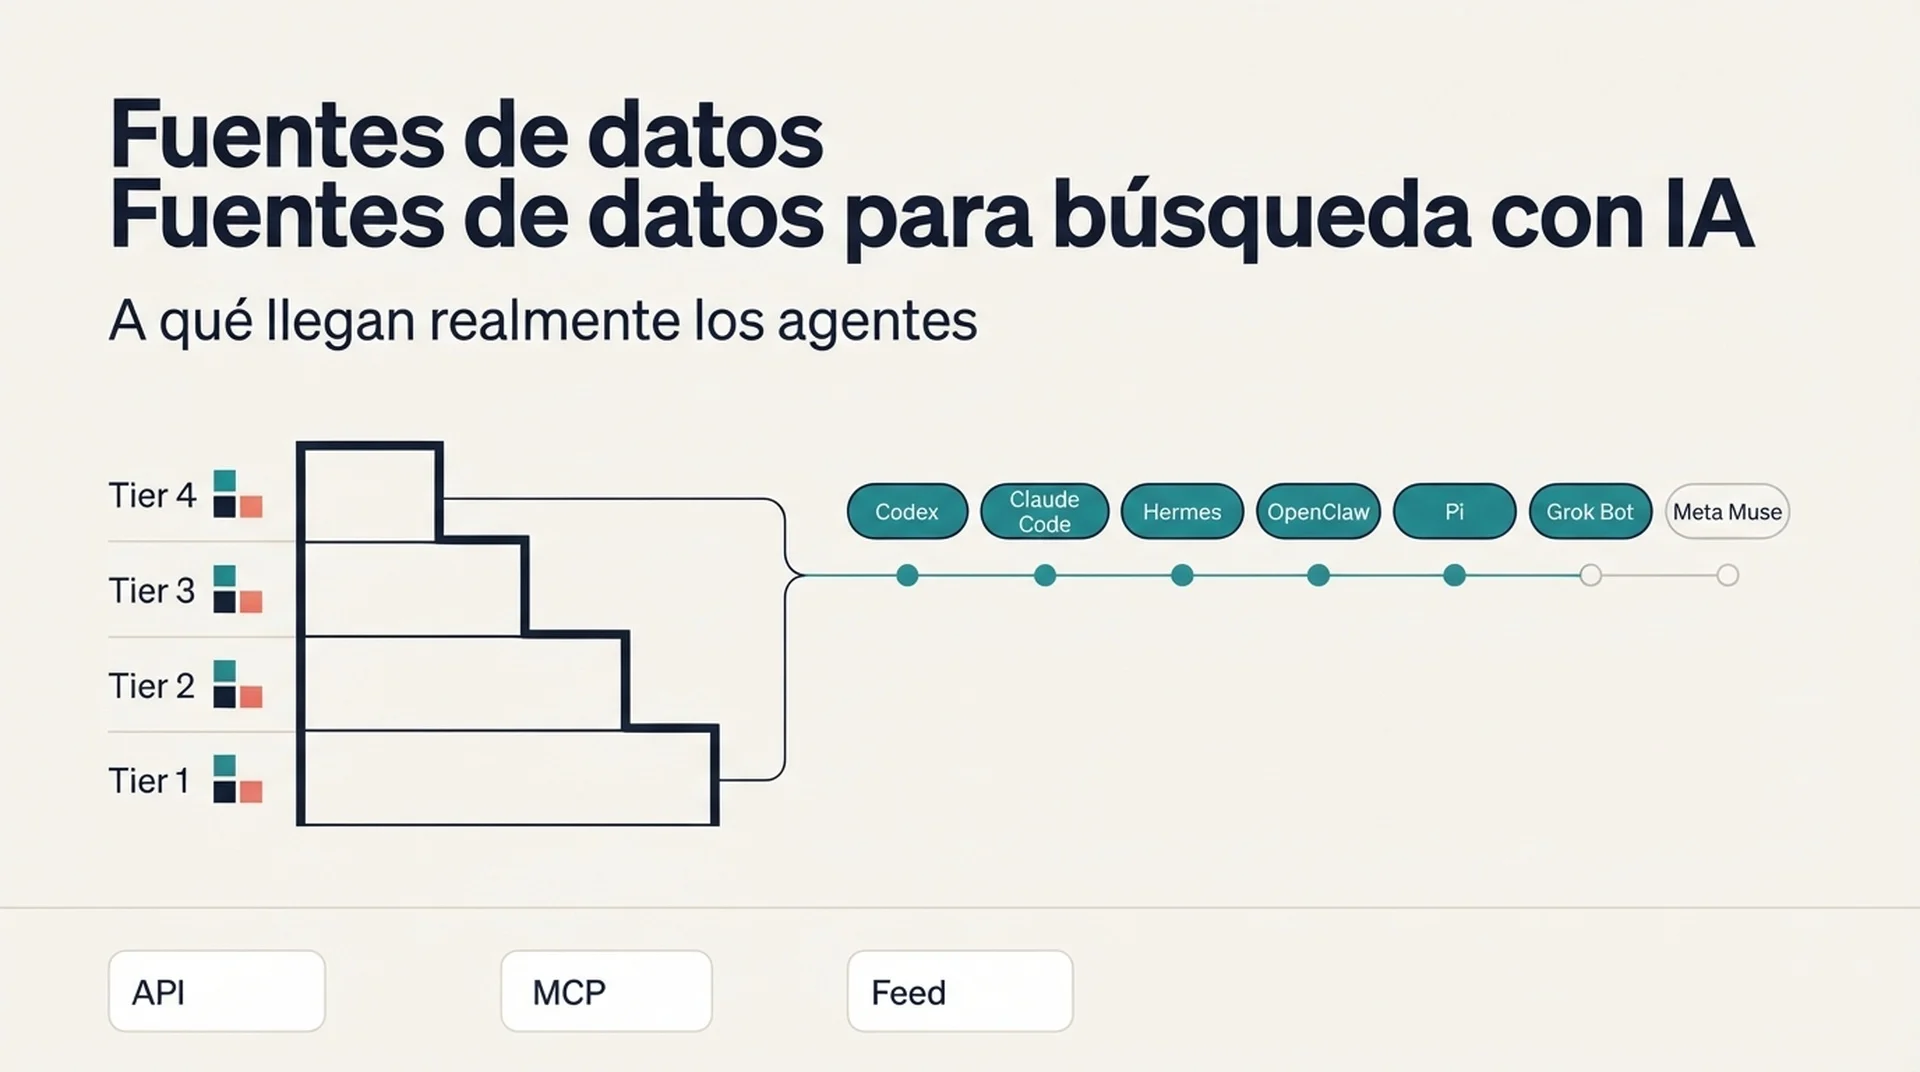
Este artículo hace tres cosas. Ordena por niveles las fuentes de datos que sostienen las respuestas de IA, según la fuerza de la evidencia y su vigencia. Da la ruta concreta de API o MCP para las que la tienen. Y recorre el método de conexión de Codex, Claude Code, Hermes Agent, OpenClaw, Pi Agent, Grok Bot y Meta Muse, incluidos los casos en que no existe un conector listo y hay que construir el puente.
La respuesta corta
Cuatro categorías de fuentes alimentan las respuestas de IA, y el alcance no es igual entre ellas.
Las fuentes de web y descubrimiento en búsqueda se alcanzan mediante API de grounding y mediante tus propias páginas rastreables. Los feeds comerciales estructurados se alcanzan mediante especificaciones de feed documentadas, pero el acceso está limitado por aprobación. Los corpus de conocimiento y comunidad se alcanzan en parte mediante API con licencia y en parte están cerrados detrás de la ingesta en el entrenamiento, sobre la que no tienes influencia. Y las superficies de acción de los agentes se alcanzan mediante especificaciones de protocolo que todavía se están asentando.
Traducido a un flujo de monitoreo conducido por un agente, esto se vuelve una regla práctica. Conecta lo que tenga API o servidor MCP documentado. Trata lo que tenga especificación de feed como un proyecto de calidad de datos. Y trata lo que no tenga ninguno de los dos como un proyecto de contenido y entidad, no como un proyecto de datos.
Cómo leer la tabla de niveles
Los niveles de abajo separan las fuentes por la fuerza de la evidencia de que hoy alimentan respuestas de IA y por si la conexión es actual o histórica. Aquí es donde fallan la mayoría de las listas de fuentes. Una fuente que moldeó un modelo en 2022 y una fuente que un modelo consulta hoy son cosas distintas, y mezclarlas produce una estrategia equivocada.
Nivel | Significado | Qué implica para tu flujo |
|---|---|---|
1 | Confirmado y actual | Grounding en vivo, recuperación o acciones. Conéctala, monitóreala y optimiza para ella. |
2 | Confirmado y actual | Entrenamiento o licencia. Influyes por contenido y alianzas, no por API. |
3 | Confirmado histórico | Solo preentrenamiento. Sin palanca en vivo. No montes un flujo de monitoreo alrededor de esto. |
4 | Evidencia fuerte, no confirmado | Inferencia de categoría. Vale la pena observar, no vale presupuesto todavía. |
Una advertencia antes de la tabla. Esta categoría cambia cada mes. La documentación del proveedor, los acuerdos de licencia y las especificaciones de feed, todo se mueve. Trata la clasificación por niveles como un punto de partida que vuelves a verificar en la documentación del propio proveedor antes de comprometer a un equipo con un flujo.
Nivel 1: fuentes en vivo a las que tu agente sí llega
Estas son las fuentes con conexión documentada hoy. Si tu agente va a extraer datos de visibilidad en IA por su cuenta, aquí es donde empieza.
Web y descubrimiento en búsqueda
Grounding con Google Search. La API de Gemini expone la herramienta google_search, que conecta el modelo con contenido web en tiempo real y devuelve citas a las URL de origen. Esto está documentado, es actual y es el ejemplo más claro de grounding en vivo del mercado. También significa que la palanca es la rastreabilidad y la estructura de tu página, no el feed.
Bing Search. Microsoft documenta que los resultados de Bing se usan para reforzar las respuestas de Copilot. La implicación práctica es la misma que en Google: si quieres aparecer, la página tiene que ser alcanzable y extraíble.
Páginas en vivo de editores. Se alcanzan en el momento de la inferencia mediante grounding de búsqueda, no por preentrenamiento. La selección de los resultados de recuperación y la rastreabilidad gobiernan la inclusión, y por eso el trabajo de SEO técnico sigue apareciendo en los resultados de visibilidad en IA.
Productos y compras
Google Merchant Center. Los datos de feed de comerciantes sostienen las superficies de compras de Google. Si vendes productos físicos y no estás en Merchant Center, estás ausente de una superficie que se está conectando activamente a las respuestas de IA.
Feeds de comerciantes y retail de OpenAI. Los comerciantes comparten un feed estructurado de productos, y la documentación de Agentic Commerce Protocol describe el esquema, las dos rutas de integración por carga de archivo y por API, y una cadencia de actualización que acepta cambios a lo largo del día. El acceso hoy está restringido a socios aprobados, así que es un proyecto con tiempo de espera, no un interruptor.
Local y lugares
Grounding con Google Maps. Documentado como herramienta junto al grounding de búsqueda, y da contexto geoespacial a los modelos. Por eso los negocios locales con perfiles precisos y completos aparecen en respuestas de IA sobre opciones cercanas.
Google Business Profile. Los datos del perfil de empresa sostienen las superficies locales de Google. Para negocios locales es una de las fuentes de mayor palanca y menor esfuerzo de la lista.
Yelp. Yelp licencia reseñas, fotos e información de negocios para recomendaciones locales en tiempo real, y la relación va más allá del grounding hacia las acciones. Es una de las pocas fuentes en las que una plataforma de reseñas es a la vez origen de cita y superficie de transacción.
Conocimiento y referencia
Wikipedia y Wikimedia. Presentes en la mezcla de preentrenamiento divulgada y ampliamente usadas como corpus de referencia en vivo. La licencia es inusualmente clara, lo que las vuelve un objetivo legítimo para trabajo de entidad.
Comunidad, preguntas y respuestas, y redes sociales
Reddit. Fuente de grounding en vivo por un acuerdo de licencia de datos, con el lado del entrenamiento reportado por separado. Trata el estado de renovación como inestable y no montes un flujo que presuponga acceso permanente.
Niveles 2 y 3: fuentes que influyes pero no consultas
Estas importan, pero no por una API que el agente pueda llamar.
Contenido con licencia de editores. Existen varias alianzas explícitas de licencia con editores grandes, con términos que varían por socio en entrenamiento, grounding y atribución. No puedes comprar tu lugar en esa lista como sitio pequeño, pero sí puedes ser el tipo de fuente que se cita cuando el corpus licenciado es escaso en tu tema.
Fuentes de desarrollador y técnicas. Los repositorios públicos de código y los corpus de documentación técnica son fuentes actuales confirmadas. Para empresas de herramientas para desarrolladores, este es el nivel de mayor valor de la lista, y se llega a él por la calidad de la documentación, no por un feed.
Corpus web históricos. Versiones derivadas y limpias de datos de rastreo común y archivos similares. Confirmados históricos, sin palanca en vivo. Útiles como contexto para entender por qué un modelo tiene cierta premisa, pero no sirven para un flujo de monitoreo.
La capa de conexión: a qué llega cada agente
Aquí el artículo se justifica. La tabla de abajo mapea cada agente al mecanismo de conexión que realmente soporta y al estado honesto de los conectores listos para las fuentes de arriba.
Agente | Mecanismo de conexión | Conectores listos | Lo que construyes |
|---|---|---|---|
Codex | MCP por stdio y streamable HTTP, configurado en | Registro creciente de servidores MCP de la comunidad | Un servidor MCP delgado para cualquier fuente con HTTP API |
Claude Code | MCP por HTTP, SSE, stdio y WebSocket | Directorio de conectores de Anthropic y servidores de la comunidad | El mismo servidor, agregado con |
Hermes Agent | MCP con filtrado de herramientas por servidor, más skills nativas | Catálogo MCP seleccionado con instalación en un clic | Una skill que envuelve la API cuando no hay MCP |
OpenClaw | Cliente y servidor MCP, más A2A JSON-RPC | Registro MCP de OpenClaw y definiciones de servidor guardadas | Una definición MCP guardada o un puente A2A |
Pi Agent | Extensiones en TypeScript y skills, sin cliente MCP nativo | Ninguno por defecto | Una extensión pequeña que llama a la API como herramienta |
Grok Bot | Herramientas MCP remotas declaradas en la petición de API | Cualquier servidor MCP remoto al que apuntes | Un servidor MCP remoto, ya que Grok gestiona la conexión |
Meta Muse | Conectores, sin superficie pública de MCP o API | Solo conectores gestionados por el proveedor | Solo trabajo indirecto: feeds, datos de entidad y páginas rastreables |
El patrón que vale la pena notar: cinco de los siete agentes hablan MCP, y los dos que no lo hablan están en extremos opuestos del espectro. Pi Agent es deliberadamente mínimo y espera que escribas una extensión. Meta Muse es un producto de consumo sin ninguna superficie para desarrolladores.
Eso significa que el movimiento eficiente es construir un servidor MCP para tu fuente de mayor valor y reutilizarlo en Codex, Claude Code, Hermes Agent, OpenClaw y Grok Bot. Lo escribes una vez.
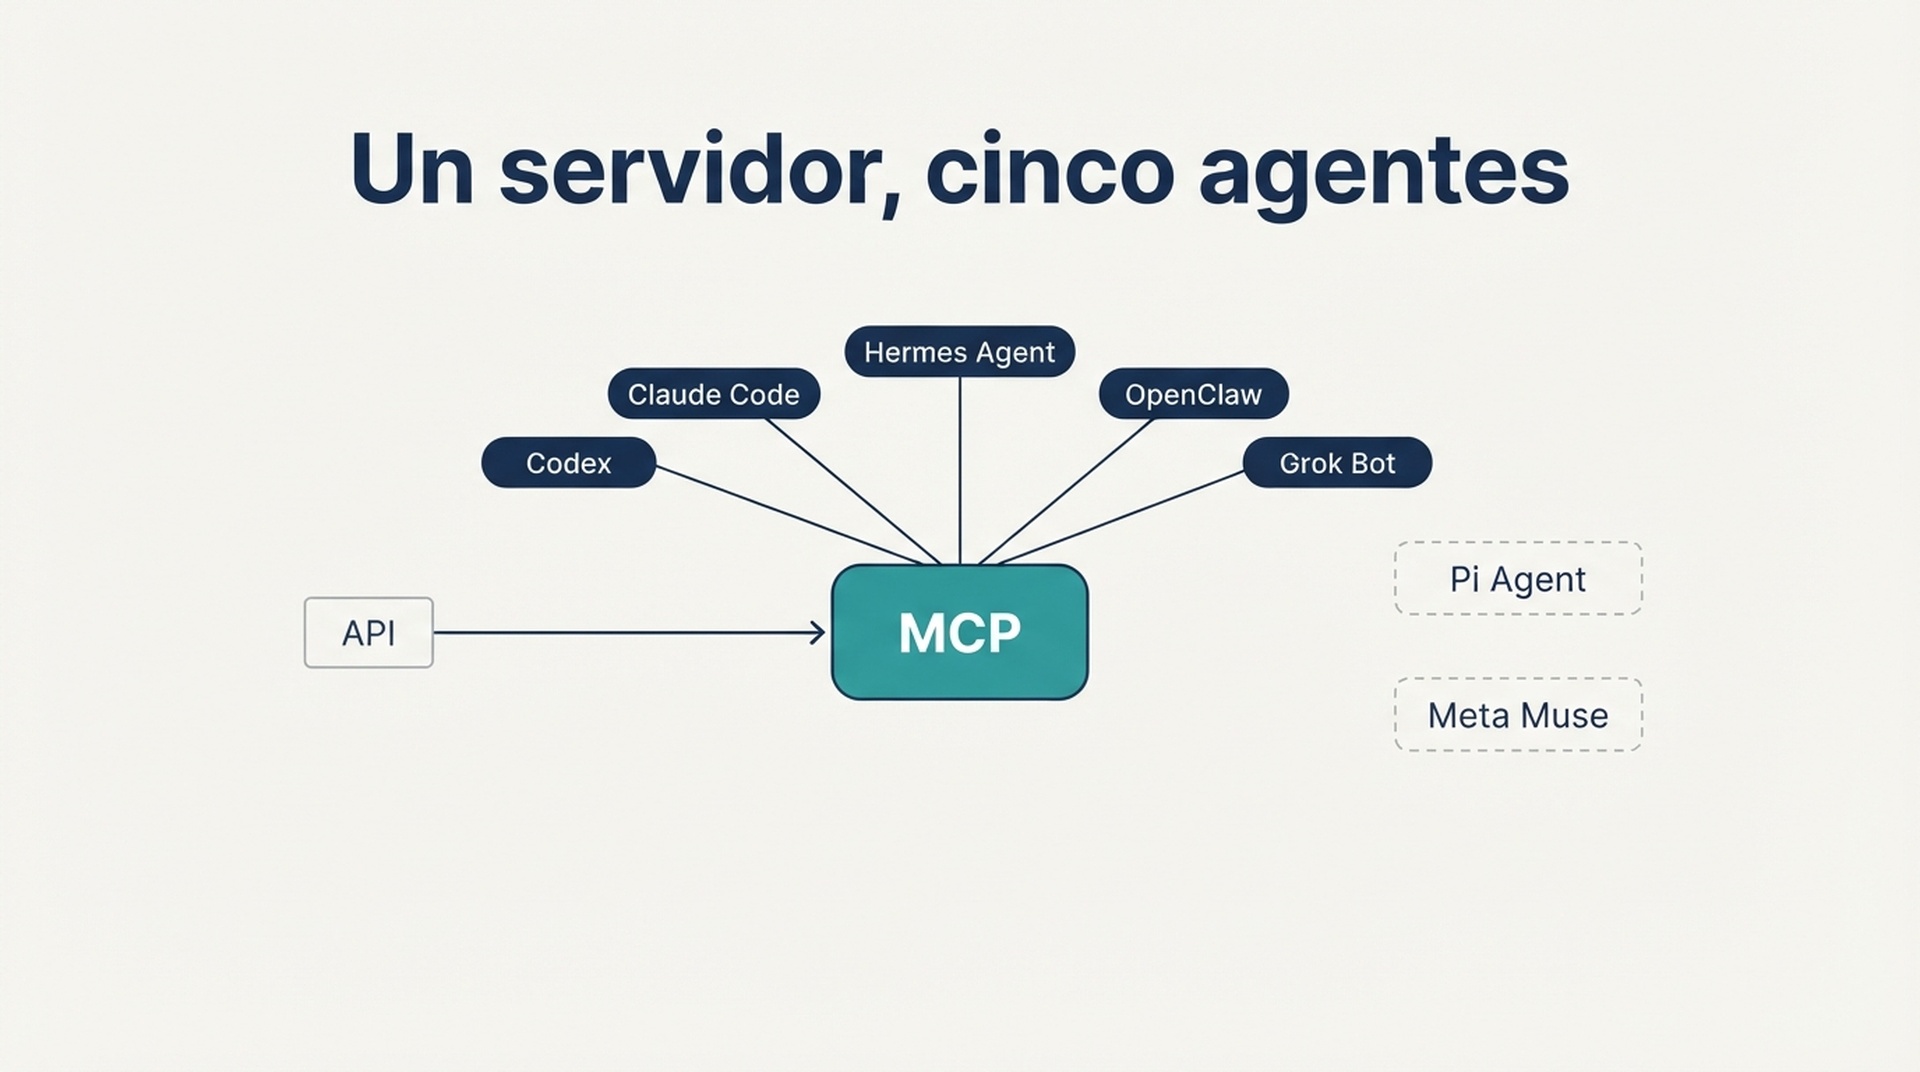
Un servidor cubre cinco de los siete agentes. Pi Agent y Meta Muse necesitan otra ruta.
Cómo conectar cada agente
Los pasos de abajo suponen que ya tienes una clave de API o un token para la fuente que estás conectando. No pongas credenciales en un archivo de configuración que vaya al repositorio.
Codex
Codex guarda la configuración de MCP en config.toml, ya sea en ~/.codex/config.toml o a nivel de proyecto en .codex/config.toml. La app de escritorio de ChatGPT, el CLI de Codex y la extensión de IDE comparten esta configuración, así que la defines una vez.
Para un servidor stdio:
codex mcp add my-source --env API_KEY=your-key -- npx -y @your-org/my-source-mcpPara un servidor streamable HTTP, agrega una tabla a config.toml:
[mcp_servers.my-source]
url = "https://mcp.example.com/mcp"
bearer_token_env_var = "MY_SOURCE_TOKEN"
Codex lee el campo instructions que el MCP devuelve en la inicialización y lo usa como guía para todo el servidor. Si estás construyendo el servidor, mantén los primeros 512 caracteres autosuficientes para que las restricciones más importantes estén a mano cuando el agente decida si llamar.
Ejecuta codex mcp list para confirmar que el servidor quedó registrado, y /mcp dentro del TUI para ver los servidores activos.
Claude Code
Claude Code soporta transporte HTTP remoto, SSE remoto, stdio local y WebSocket remoto. HTTP es la opción recomendada para servidores remotos.
claude mcp add --transport http my-source https://mcp.example.com/mcp \
  --header "Authorization: Bearer your-token"
Para un servidor local:
claude mcp add my-source -- npx -y @your-org/my-source-mcpDos detalles que hacen tropezar a la gente. Primero, una entrada en una configuración JSON con url pero sin type se trata como servidor stdio y se omite en silencio, así que define "type": "http" de forma explícita. Segundo, Claude Code define CLAUDE_PROJECT_DIR en el entorno del servidor que lanza, así que un servidor local puede resolver rutas relativas al proyecto sin depender del directorio de trabajo.
Hermes Agent
Hermes Agent viene con soporte de MCP en la instalación estándar. La configuración vive en ~/.hermes/config.yaml:
mcp_servers:
  my-source:
    command: "npx"
    args: ["-y", "@your-org/my-source-mcp"]
Hermes también soporta servidores MCP remotos por HTTP en la misma configuración, y soporta filtrado por servidor para exponer solo las herramientas que de verdad quieres que el agente vea. Este filtrado importa más aquí que en los otros agentes, porque Hermes corre sin supervisión en una agenda.
Si vienes de Claude Code, el comando hermes import-agent claude-code mapea el bloque mcpServers de ~/.claude.json a mcp_servers en la configuración de Hermes y trae skills e instrucciones al mismo tiempo.
Cuando no existe un servidor MCP para una fuente, el sistema de skills es la alternativa. Una skill es un directorio con un SKILL.md que le dice al agente cuándo usarla y qué hacer. Envuelve la llamada a la API en un script incluido y referéncialo desde la skill, y el agente gana la capacidad sin un servidor de protocolo.
OpenClaw
OpenClaw funciona como cliente MCP y como servidor MCP. Como cliente, gestionas definiciones de servidor guardadas con los subcomandos mcp registry, y puedes editar e inspeccionar servidores desde la página de ajustes del Control UI en el navegador.
openclaw mcp registry add my-source --transport streamable-http --url https://mcp.example.com/mcp
openclaw mcp status
OpenClaw también expone las conversaciones de sus canales vía MCP, que es la dirección inversa y resulta útil si quieres que otro agente lea lo que ha estado haciendo tu instancia de OpenClaw. Para agentes externos que no son clientes MCP, OpenClaw habla A2A sobre JSON-RPC.
La razón para elegir OpenClaw en este trabajo es el modelo de permisos. Tiene política de herramientas por chat y una ruta explícita de aprobación para la ejecución, que es justo lo que quieres cuando un agente lee una fuente de datos de pago y necesitas limitar cuánto puede gastar.
Pi Agent
Pi Agent no tiene cliente MCP nativo, y eso es una decisión de diseño, no un hueco. Su punto de extensión son módulos TypeScript que corren dentro del proceso de Pi y registran herramientas.
Crea una extensión en ~/.pi/agent/extensions/my-source.ts:
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.registerTool({
    name: "my_source_lookup",
    description: "Look up a record in My Source by query.",
    parameters: { type: "object", properties: { query: { type: "string" } }, required: ["query"] },
    handler: async ({ query }) => {
      const res = await fetch(`https://api.example.com/search?q=${encodeURIComponent(query)}`, {
        headers: { Authorization: `Bearer ${process.env.MY_SOURCE_TOKEN}` },
      });
      return await res.json();
    },
  });
}
Cárgala directamente durante el desarrollo con pi --extension ./my-source.ts y luego muévela al directorio de extensiones o empaquétala con pi install cuando esté estable.
El trade-off es real y vale decirlo sin rodeos. Una extensión corre con los mismos permisos de sistema operativo que el proceso de Pi y puede inspeccionar prompts, llamadas a herramientas, archivos y credenciales. Carga extensiones solo de fuentes en las que confíes, y lee el código antes de instalar.
Grok Bot
La API de Grok soporta herramientas MCP remotas, y xAI gestiona la conexión del servidor por ti. Declaras el servidor en el array tools de la petición:
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import mcp

client = Client(api_key=os.getenv("XAI_API_KEY"))
chat = client.chat.create(
    model="grok-4.7",
    tools=[mcp(server_url="https://mcp.example.com/mcp", server_label="my-source")],
)
Solo se soportan los transportes streaming HTTP y SSE en herramientas MCP remotas. Puedes restringir qué herramientas se exponen con allowed_tools y pasar un token de autorización que xAI define en la cabecera Authorization en las peticiones a tu servidor.
La ventaja aquí es que no corres ni mantienes una conexión del lado del cliente. La desventaja es que el servidor MCP tiene que ser alcanzable públicamente, así que cualquier cosa detrás de una VPN necesita otro enfoque.
Meta Muse
Muse se conecta a aplicaciones y servicios de terceros mediante conectores, y el agente en sí no tiene superficie pública de MCP o API para desarrolladores. Esa es la respuesta honesta, y cambia lo que puedes hacer.
No puedes conectar Muse a un flujo de monitoreo como haces con los otros seis agentes. Lo que sí puedes hacer es mejorar las fuentes que Muse lee. Eso significa datos precisos de producto y catálogo si vendes, información de negocio completa y consistente si eres local, y páginas rastreables con señales claras de entidad si eres editor. Muse es un objetivo de trabajo de preparación, no una fuente de datos que consultas.
Si Meta lanza una superficie para desarrolladores de Muse, esta sección cambia. Hasta entonces, trátalo como una audiencia para la que prepararse, no como un sistema con el que integrarse.
Construye un servidor y reutilízalo cinco veces
Si vas a construir algo, construye el servidor MCP para tu fuente de mayor valor y reutilízalo. Los cinco agentes con soporte de MCP de arriba aceptan un servidor streamable HTTP, así que un despliegue los cubre a todos.
Un servidor mínimo necesita cuatro cosas: una herramienta que acepta una consulta y devuelve datos estructurados, una comprobación de token bearer del lado del servidor, un límite de tasa para que un agente descontrolado no queme tu cuota de API, y un campo instructions que declare las restricciones en los primeros 512 caracteres.
Dos reglas que evitan la mayor parte del dolor. Devuelve datos estructurados en vez de prosa, para que el agente razone sobre campos en lugar de reparsear texto. Y mantén toda herramienta solo de lectura hasta que hayas visto al agente usarla un ciclo completo. Un servidor solo de lectura no puede estropear nada, y puedes ampliarlo después de ver los patrones reales de llamada.
Verifica la conexión antes de confiar en ella
No supongas que un servidor configurado es un servidor que funciona. Corre estas cuatro comprobaciones.
Confirma que el servidor está registrado. codex mcp list, claude mcp list u openclaw mcp status deberían mostrarlo. Un servidor que falló al parsear se omite en silencio en algunos clientes.
Confirma el inventario de herramientas. Pídele al agente que liste las herramientas que expone el servidor. Si esperabas seis y viste una, el servidor quedó registrado pero las herramientas no.
Confirma con una consulta real. Pide un registro específico que puedas verificar a mano. Una pregunta genérica como "qué datos puedes obtener" no prueba nada.
Confirma la ruta de fallo. Revoca el token y corre la consulta otra vez. Quieres un error claro de autenticación, no un resultado vacío y silencioso. Un agente que trata una llamada fallida como "sin datos" va a reportar un resultado limpio para una conexión rota, y ese es el modo de fallo más caro de todo este flujo.
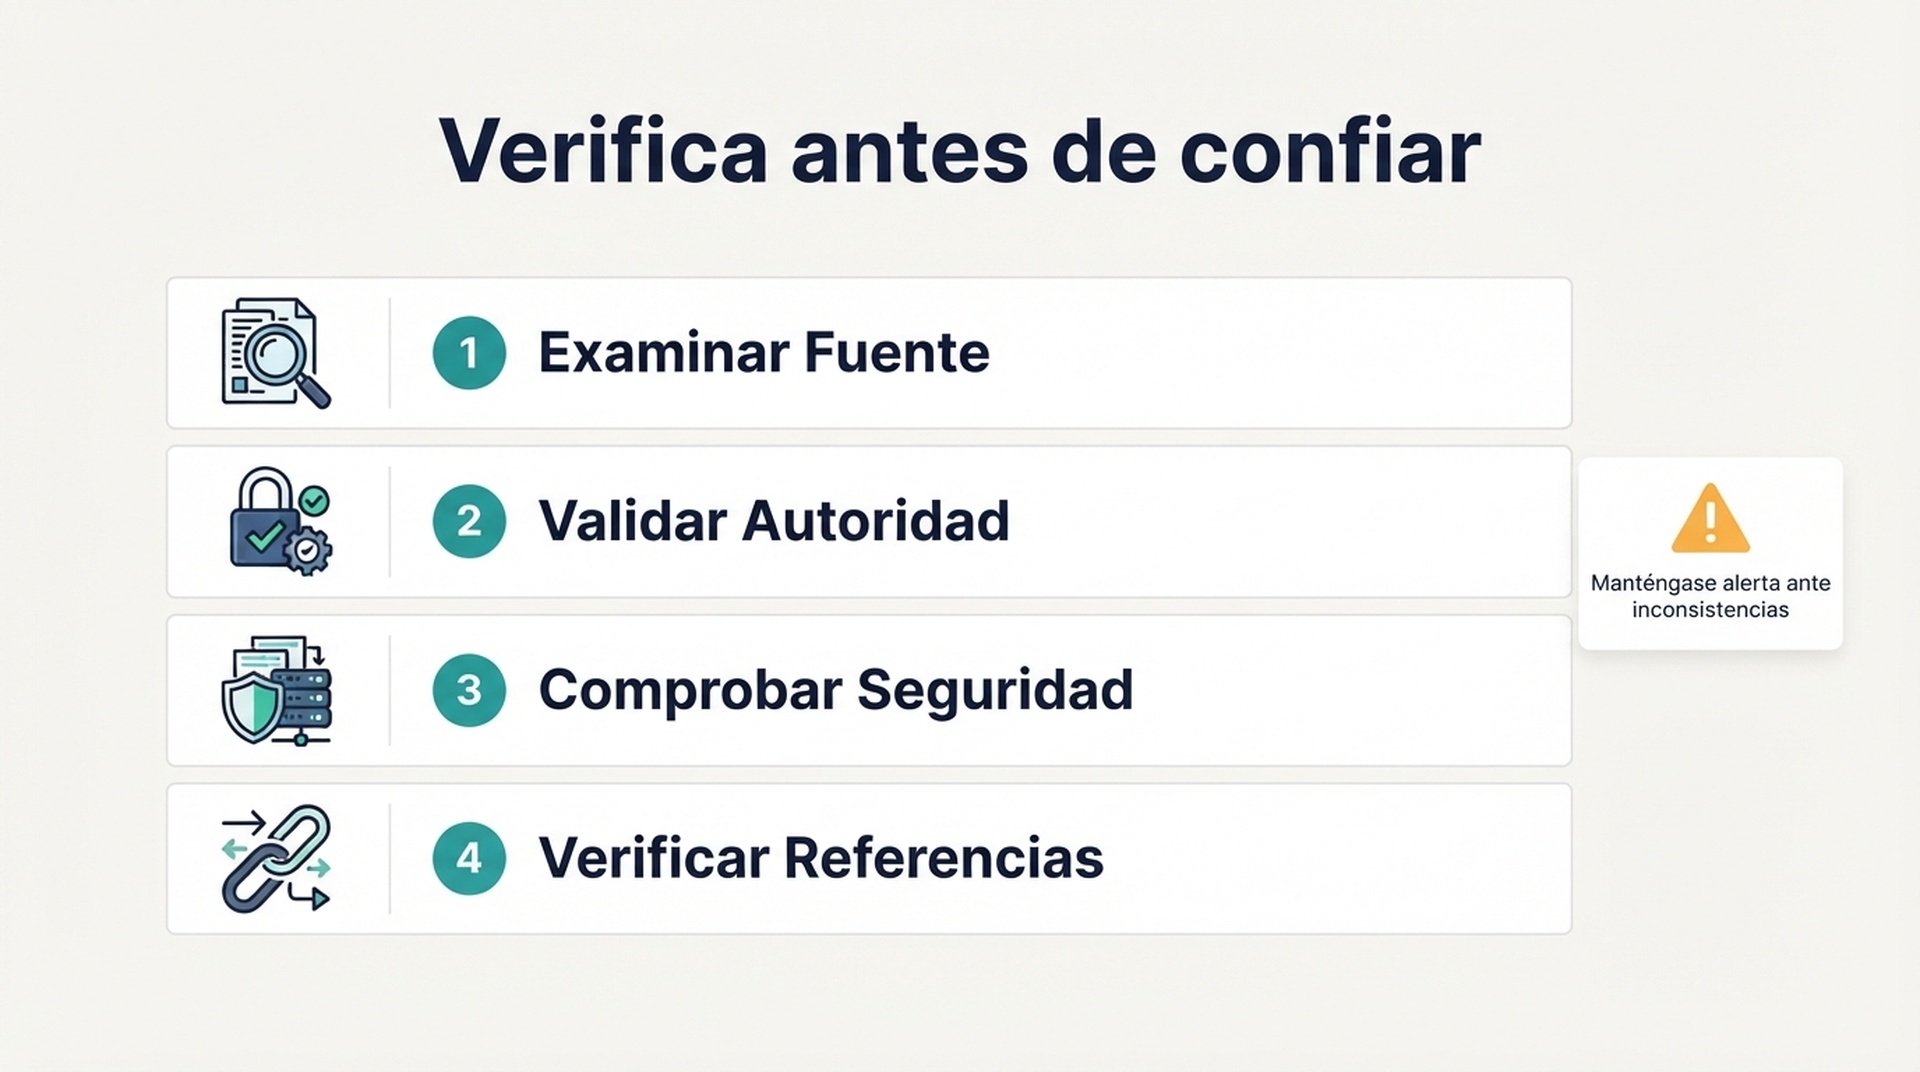
Cuatro comprobaciones. La última atrapa el fallo que parece un hallazgo.
Qué cambia esto en tus prioridades
La tabla de niveles y la de conexiones apuntan al mismo lado. Las fuentes que puedes conectar a un agente son las fuentes que puedes medir, y las fuentes que puedes medir son las que puedes mejorar contra una línea base.
Eso significa que el orden de trabajo no es el que usa la mayoría de los equipos. Empieza por la fuente que tiene a la vez conexión documentada e impacto real en tu negocio. Para negocio local es Google Business Profile y el grounding con Maps. Para empresa de productos es Merchant Center o un feed de productos. Para empresa de herramientas para desarrolladores es la calidad de la documentación. Para editor es la rastreabilidad y la extraibilidad de las páginas en vivo.
Luego construye el único servidor MCP que lleva esa fuente a tu agente y reutilízalo en los cinco agentes que hablan el protocolo. Deja las fuentes sin ruta de conexión como trabajo de contenido y entidad, y sé honesto en que no puedes medirlas del mismo modo.
Los equipos que se adelantan aquí no son los que tienen la lista de fuentes más larga. Son los que conectaron las dos o tres fuentes que importan y montaron un ciclo de monitoreo alrededor de ellas.
Preguntas frecuentes
¿Necesito MCP para darle a un agente acceso a una fuente de datos? No. MCP es el estándar que la mayoría de los agentes soporta hoy, lo que lo vuelve la opción más reutilizable, pero una skill con un script de API incluido funciona igual de bien para un solo agente. Si conectas una fuente a un agente, la skill da menos trabajo. Si conectas una fuente a cinco agentes, MCP se paga solo de inmediato.
¿Con qué agente empiezo? Empieza con el que encaje con donde ya está tu trabajo. Si el sitio está en un repositorio git, Codex o Claude Code. Si quieres ejecuciones programadas con memoria persistente, Hermes Agent. Si necesitas una frontera estricta de permisos en una fuente de datos de pago, OpenClaw. Si quieres la superficie más pequeña que puedas auditar de una sentada, Pi Agent.
¿Puedo conectar una fuente que no tiene servidor MCP? Sí, de tres formas. Escribe un servidor MCP delgado si la fuente tiene HTTP API y quieres reutilizarlo en varios agentes. Escribe una skill con un script incluido si necesitas un solo agente. O usa un agente que soporta herramientas MCP remotas y apunta a un servidor que aloje otra persona.
¿Por qué no puedo conectar Meta Muse? Meta no ha publicado API para desarrolladores ni superficie MCP de Muse. Los conectores los gestiona el proveedor. Hasta que eso cambie, Muse es una superficie para la que se prepara contenido y datos, no un sistema que consultas.
¿La clasificación por niveles es permanente? No. Esta categoría cambia cada mes. Vuelve a verificar la documentación del proveedor antes de comprometer a un equipo con un flujo, y trata cualquier clasificación con más de un trimestre como no verificada.
¿Cuál es el error más común en este trabajo? Tratar una llamada de API fallida como un cero real. Si el agente reporta que una marca no tiene visibilidad en IA y la causa raíz es un token caducado, tienes un fallo de medición disfrazado de hallazgo. Prueba siempre la ruta de fallo antes de confiar en la ruta de éxito.
Author: Julian Mercer, profesional de SEO técnico con 14 años de experiencia en Auspia. Escribe sobre rastreabilidad, esquemas, renderizado y los fundamentos técnicos que hacen que el contenido sea legible tanto para buscadores como para agentes de IA.