La maggior parte dei team che monitora la visibilità di un marchio nelle risposte IA lavora ancora da uno screenshot. Fanno una domanda a ChatGPT, copiano le citazioni e le incollano in un documento. Questo dice cosa ha risposto un modello in un pomeriggio. Non dice a quali fonti il motore di risposte riesce davvero ad arrivare, e non dà al tuo agente nulla da interrogare da solo.
La versione più utile di questo lavoro è una mappa delle fonti insieme a un percorso di connessione. Decidi quali fonti dati contano per la tua categoria, poi colleghi ciò che è raggiungibile direttamente all'agente che gestisce il monitoraggio. Quello che resta è una lista breve di fonti su cui puoi agire solo indirettamente, e quella lista è di solito più corta di quanto sembri.
Questo articolo fa tre cose. Ordina per livelli le fonti dati dietro le risposte IA, in base alla forza delle prove e all'attualità. Dà il percorso concreto di API o MCP per quelle che ne hanno uno. E illustra il metodo di connessione per Codex, Claude Code, Hermes Agent, OpenClaw, Pi Agent, Grok Bot e Meta Muse, compresi i casi in cui non esiste un connettore pronto e devi costruire il ponte da solo.
La risposta breve
Quattro categorie di fonti alimentano le risposte IA, e la raggiungibilità non è uguale.
Le fonti web e di scoperta tramite ricerca sono raggiungibili tramite API di grounding e tramite le tue pagine rese scansionabili. I feed commerciali strutturati sono raggiungibili tramite specifiche di feed documentate, ma l'accesso è limitato da approvazione. I corpora di conoscenza e community sono in parte raggiungibili tramite API su licenza e in parte chiusi dietro la raccolta in fase di addestramento, su cui non hai influenza. E le superfici di azione degli agenti sono raggiungibili tramite specifiche di protocollo che si stanno ancora assestando.
Tradotto in un flusso di monitoraggio guidato da un agente, diventa una regola pratica. Collega ciò che ha un'API o un server MCP documentato. Tratta ciò che ha una specifica di feed come un progetto di qualità dei dati. E tratta ciò che non ha né l'uno né l'altro come un progetto di contenuto ed entità, non come un progetto di dati.
Come leggere la tabella dei livelli
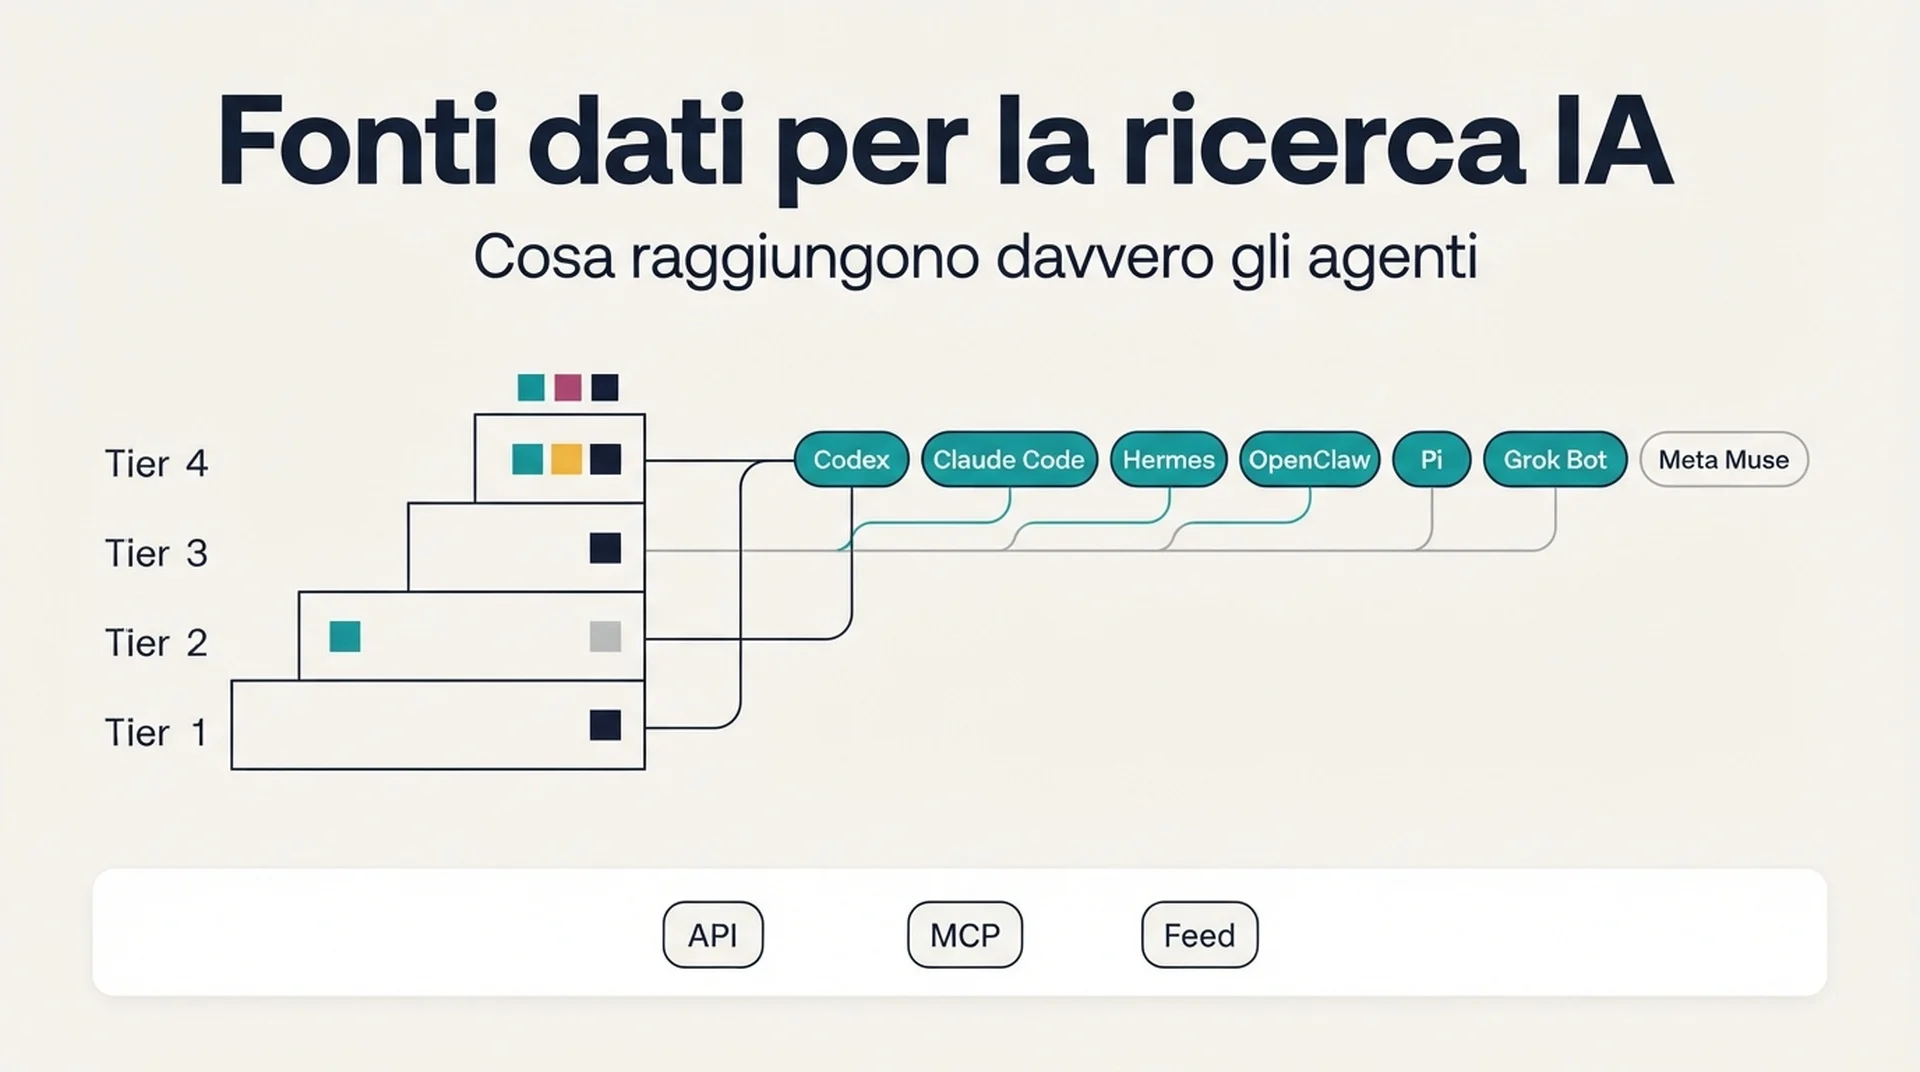
I livelli sotto separano le fonti in base alla forza delle prove che oggi alimentano le risposte IA e in base al fatto che la connessione sia attuale o storica. È qui che la maggior parte degli elenchi di fonti sbaglia. Una fonte che ha plasmato un modello nel 2022 e una fonte che un modello interroga oggi sono due cose diverse, e confonderle produce una strategia sbagliata.
Livello | Significato | Cosa significa per il tuo flusso |
|---|---|---|
1 | Confermato e attuale | Grounding dal vivo, recupero o azioni. Collega, monitora e ottimizza per essa. |
2 | Confermato e attuale | Addestramento o licenza. Influenzi tramite contenuti e partnership, non tramite API. |
3 | Confermato storico | Solo pre-addestramento. Nessuna leva dal vivo. Non costruire un flusso di monitoraggio attorno a questo. |
4 | Prove forti, non confermato | Inferenza di categoria. Da osservare, non ancora da mettere a budget. |
Un avvertimento prima della tabella. Questa categoria cambia ogni mese. Documentazione dei fornitori, accordi di licenza e specifiche di feed, tutto si muove. Tratta l'assegnazione dei livelli come punto di partenza che riverifichi nella documentazione del fornitore stesso prima di impegnare un team su un flusso.
Livello 1: fonti dal vivo che il tuo agente raggiunge davvero
Queste sono le fonti con una connessione documentata oggi. Se il tuo agente deve tirare da solo i dati di visibilità IA, si parte da qui.
Web e scoperta tramite ricerca
Grounding con Google Search. L'API Gemini espone lo strumento google_search, che collega il modello a contenuti web in tempo reale e restituisce citazioni verso gli URL di origine. È documentato, attuale ed è l'esempio più chiaro di grounding dal vivo sul mercato. Significa anche che la leva è la scansionabilità e la struttura della tua pagina, non il feed.
Bing Search. Microsoft documenta che i risultati di Bing vengono usati per rafforzare le risposte di Copilot. L'implicazione pratica è la stessa di Google: se vuoi comparire, la pagina deve essere raggiungibile ed estraibile.
Pagine dal vivo degli editori. Raggiunte al momento dell'inferenza tramite grounding di ricerca, non tramite pre-addestramento. La selezione dei risultati di recupero e la scansionabilità governano l'inclusione, ed è per questo che il lavoro di SEO tecnico compare ancora nei risultati di visibilità IA.
Prodotti e acquisti
Google Merchant Center. I dati dei feed dei commercianti sostengono le superfici di acquisto di Google. Se vendi prodotti fisici e non sei in Merchant Center, sei assente da una superficie che viene collegata attivamente alle risposte IA.
Feed commercianti e retail di OpenAI. I commercianti condividono un feed prodotti strutturato, e la documentazione di Agentic Commerce Protocol descrive lo schema, i due percorsi di integrazione tramite caricamento file e tramite API, e una cadenza di aggiornamento che accetta modifiche nell'arco della giornata. L'accesso oggi è limitato a partner approvati, quindi è un progetto con tempi di attesa, non un interruttore.
Locale e luoghi
Grounding con Google Maps. Documentato come strumento accanto al grounding di ricerca, dà ai modelli un contesto geospaziale. È per questo che le attività locali con profili accurati e completi compaiono nelle risposte IA sulle opzioni vicine.
Google Business Profile. I dati del profilo aziendale sostengono le superfici locali di Google. Per un'attività locale è una delle fonti con la leva più alta e lo sforzo più basso della lista.
Yelp. Yelp concede in licenza recensioni, foto e informazioni aziendali per raccomandazioni locali in tempo reale, e il rapporto va oltre il grounding fino alle azioni. È una delle poche fonti in cui una piattaforma di recensioni è insieme fonte di citazione e superficie di transazione.
Conoscenza e riferimento
Wikipedia e Wikimedia. Presenti nella miscela di pre-addestramento divulgata e ampiamente usate come corpus di riferimento dal vivo. La licenza è insolitamente chiara, il che le rende un obiettivo legittimo per il lavoro sulle entità.
Community, domande e risposte, social
Reddit. Fonte di grounding dal vivo tramite un accordo di licenza dei dati, con il lato addestramento riportato separatamente. Tratta lo stato di rinnovo come instabile e non costruire un flusso che presuppone accesso permanente.
Livelli 2 e 3: fonti su cui influisci ma che non interroghi
Queste contano, ma non tramite un'API che l'agente può chiamare.
Contenuti di editori su licenza. Esistono diverse partnership di licenza esplicite con grandi editori, con termini che variano per partner su addestramento, grounding e attribuzione. Non puoi comprarti un posto in questa lista come sito piccolo, ma puoi essere il tipo di fonte che viene citata quando il corpus su licenza è scarno sul tuo tema.
Fonti per sviluppatori e tecniche. Repository di codice pubblici e corpora di documentazione tecnica sono fonti attuali confermate. Per le aziende di strumenti per sviluppatori è il livello di maggior valore della lista, e ci si arriva tramite la qualità della documentazione, non tramite un feed.
Corpora web storici. Versioni derivate e ripulite di dati di scansione comuni e archivi simili. Confermati storici, senza leva dal vivo. Utili come contesto per capire perché un modello ha una certa premessa, ma inadatti a un flusso di monitoraggio.
Lo strato di connessione: cosa raggiunge ogni agente
Qui l'articolo si giustifica. La tabella sotto mappa ogni agente al meccanismo di connessione che supporta davvero, e allo stato onesto dei connettori pronti per le fonti sopra.
Agente | Meccanismo di connessione | Connettori pronti | Cosa costruisci |
|---|---|---|---|
Codex | MCP via stdio e streamable HTTP, configurato in | Registro crescente di server MCP della community | Un server MCP snello per qualsiasi fonte con HTTP API |
Claude Code | MCP via HTTP, SSE, stdio e WebSocket | Directory di connettori Anthropic e server della community | Lo stesso server, aggiunto con |
Hermes Agent | MCP con filtro degli strumenti per server, più skill native | Catalogo MCP selezionato con installazione in un clic | Una skill che avvolge l'API quando non c'è MCP |
OpenClaw | Client e server MCP, più A2A JSON-RPC | Registro MCP di OpenClaw e definizioni di server salvate | Una definizione MCP salvata o un ponte A2A |
Pi Agent | Estensioni TypeScript e skill, senza client MCP nativo | Nessuno per impostazione predefinita | Una piccola estensione che chiama l'API come strumento |
Grok Bot | Strumenti MCP remoti dichiarati nella richiesta API | Qualsiasi server MCP remoto a cui punti | Un server MCP remoto, dato che Grok gestisce la connessione |
Meta Muse | Connettori, senza superficie MCP o API pubblica | Solo connettori gestiti dal fornitore | Solo lavoro indiretto: feed, dati di entità e pagine scansionabili |
Lo schema da notare: cinque dei sette agenti parlano MCP, e i due che non lo parlano stanno agli estremi opposti dello spettro. Pi Agent è deliberatamente minimale e si aspetta che tu scriva un'estensione. Meta Muse è un prodotto di consumo senza alcuna superficie per sviluppatori.
Questo significa che la mossa efficiente è costruire un server MCP per la tua fonte di maggior valore e riusarlo in Codex, Claude Code, Hermes Agent, OpenClaw e Grok Bot. Lo scrivi una volta.
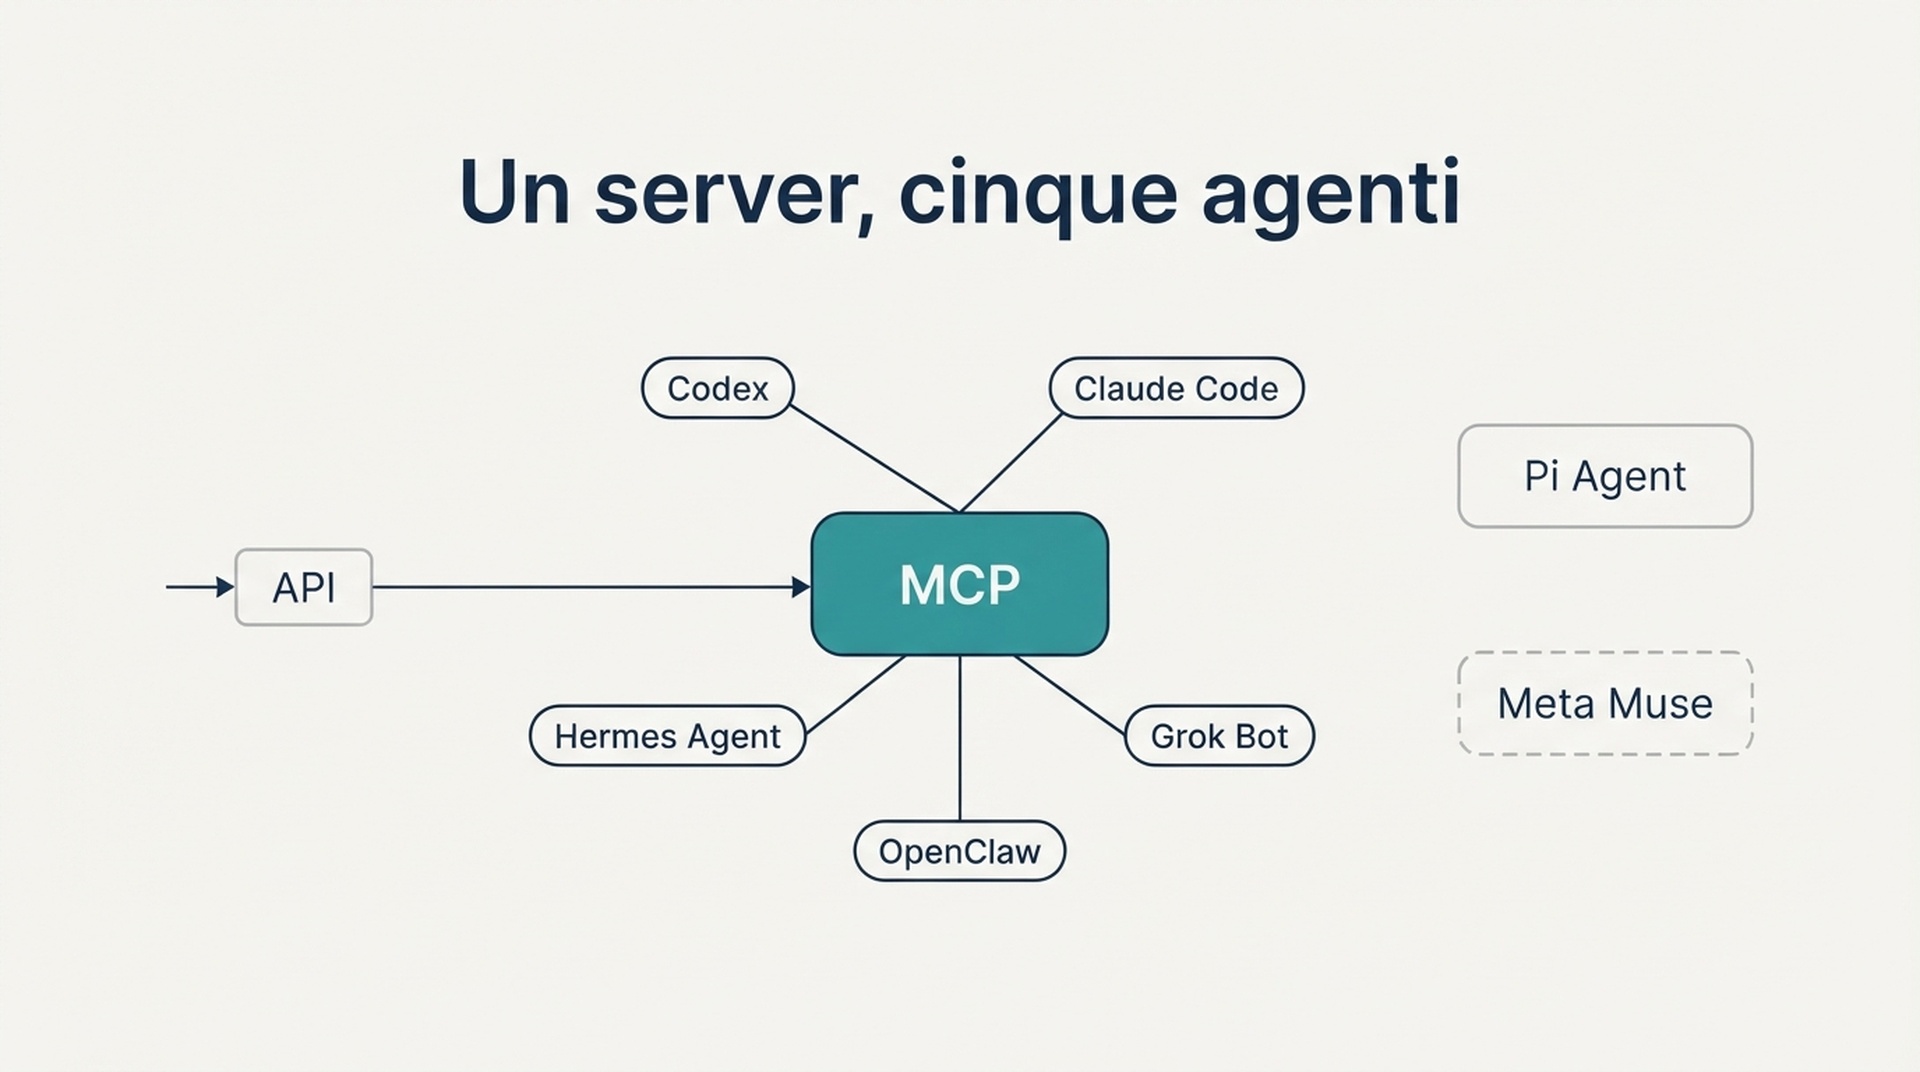
Un server copre cinque dei sette agenti. Pi Agent e Meta Muse hanno bisogno di un altro percorso.
Come connettere ogni agente
I passaggi sotto presuppongono che tu abbia già una chiave API o un token per la fonte che stai collegando. Non mettere credenziali in un file di configurazione che finisce nel repository.
Codex
Codex salva la configurazione MCP in config.toml, in ~/.codex/config.toml oppure a livello di progetto in .codex/config.toml. L'app desktop ChatGPT, la CLI di Codex e l'estensione IDE condividono questa configurazione, quindi la imposti una volta.
Per un server stdio:
codex mcp add my-source --env API_KEY=your-key -- npx -y @your-org/my-source-mcpPer un server streamable HTTP, aggiungi una tabella a config.toml:
[mcp_servers.my-source]
url = "https://mcp.example.com/mcp"
bearer_token_env_var = "MY_SOURCE_TOKEN"
Codex legge il campo instructions restituito dall'MCP all'inizializzazione e lo usa come guida a livello di server. Se stai costruendo il server, mantieni i primi 512 caratteri autosufficienti, così i vincoli più importanti sono a portata quando l'agente decide se chiamare.
Esegui codex mcp list per confermare che il server è registrato, e /mcp dentro la TUI per vedere i server attivi.
Claude Code
Claude Code supporta trasporto HTTP remoto, SSE remoto, stdio locale e WebSocket remoto. HTTP è l'opzione consigliata per i server remoti.
claude mcp add --transport http my-source https://mcp.example.com/mcp \
  --header "Authorization: Bearer your-token"
Per un server locale:
claude mcp add my-source -- npx -y @your-org/my-source-mcpDue dettagli su cui le persone inciampano. Primo, una voce in una configurazione JSON con url ma senza type viene trattata come server stdio e saltata silenziosamente, quindi imposta "type": "http" in modo esplicito. Secondo, Claude Code imposta CLAUDE_PROJECT_DIR nell'ambiente del server che avvia, così un server locale può risolvere percorsi relativi al progetto senza dipendere dalla directory di lavoro.
Hermes Agent
Hermes Agent include il supporto MCP nell'installazione standard. La configurazione sta in ~/.hermes/config.yaml:
mcp_servers:
  my-source:
    command: "npx"
    args: ["-y", "@your-org/my-source-mcp"]
Hermes supporta anche server MCP remoti via HTTP nella stessa configurazione, e supporta il filtro per server così esponi solo gli strumenti che vuoi davvero far vedere all'agente. Questo filtro conta più qui che negli altri agenti, perché Hermes gira senza supervisione secondo un programma.
Se arrivi da Claude Code, il comando hermes import-agent claude-code mappa il blocco mcpServers di ~/.claude.json su mcp_servers nella configurazione di Hermes e porta con sé anche skill e istruzioni.
Quando non esiste un server MCP per una fonte, il sistema di skill è l'alternativa. Una skill è una directory con un SKILL.md che dice all'agente quando usarla e cosa fare. Avvolgi la chiamata API in uno script incluso e richiamalo dalla skill, e l'agente ottiene la capacità senza un server di protocollo.
OpenClaw
OpenClaw funziona sia come client MCP sia come server MCP. Come client, gestisci le definizioni di server salvate tramite i sottocomandi mcp registry, e puoi modificare e ispezionare i server dalla pagina delle impostazioni del Control UI nel browser.
openclaw mcp registry add my-source --transport streamable-http --url https://mcp.example.com/mcp
openclaw mcp status
OpenClaw espone anche le conversazioni dei suoi canali via MCP, che è la direzione inversa ed è utile se vuoi che un altro agente legga cosa ha fatto la tua istanza di OpenClaw. Per gli agenti esterni che non sono client MCP, OpenClaw parla A2A su JSON-RPC.
Il motivo per scegliere OpenClaw per questo lavoro è il modello di permessi. Ha una politica degli strumenti per chat e un percorso di approvazione esplicito per l'esecuzione, esattamente ciò che serve quando un agente legge una fonte dati a pagamento e devi limitare quanto può spendere.
Pi Agent
Pi Agent non ha un client MCP nativo, ed è una scelta di design, non una lacuna. Il suo punto di estensione sono moduli TypeScript che girano nel processo Pi e registrano strumenti.
Crea un'estensione in ~/.pi/agent/extensions/my-source.ts:
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.registerTool({
    name: "my_source_lookup",
    description: "Look up a record in My Source by query.",
    parameters: { type: "object", properties: { query: { type: "string" } }, required: ["query"] },
    handler: async ({ query }) => {
      const res = await fetch(`https://api.example.com/search?q=${encodeURIComponent(query)}`, {
        headers: { Authorization: `Bearer ${process.env.MY_SOURCE_TOKEN}` },
      });
      return await res.json();
    },
  });
}
Caricala direttamente durante lo sviluppo con pi --extension ./my-source.ts, poi spostala nella directory delle estensioni o impacchettala con pi install quando è stabile.
Il compromesso è reale e va detto chiaramente. Un'estensione gira con gli stessi permessi di sistema del processo Pi e può ispezionare prompt, chiamate di strumenti, file e credenziali. Carica estensioni solo da fonti di cui ti fidi, e leggi il codice prima di installare.
Grok Bot
L'API di Grok supporta strumenti MCP remoti, e xAI gestisce la connessione al server per te. Dichiari il server nell'array tools della richiesta:
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import mcp

client = Client(api_key=os.getenv("XAI_API_KEY"))
chat = client.chat.create(
    model="grok-4.7",
    tools=[mcp(server_url="https://mcp.example.com/mcp", server_label="my-source")],
)
Per gli strumenti MCP remoti sono supportati solo i trasporti streaming HTTP e SSE. Puoi limitare quali strumenti vengono esposti con allowed_tools, e passare un token di autorizzazione che xAI imposta nell'header Authorization sulle richieste al tuo server.
Il vantaggio è che non gestisci né mantieni una connessione lato client. Lo svantaggio è che il server MCP deve essere raggiungibile pubblicamente, quindi qualsiasi cosa dietro una VPN richiede un approccio diverso.
Meta Muse
Muse si connette ad app e servizi di terze parti tramite connettori, e l'agente stesso non ha una superficie MCP o API pubblica per sviluppatori. Questa è la risposta onesta, e cambia ciò che puoi fare.
Non puoi collegare Muse a un flusso di monitoraggio come fai con gli altri sei agenti. Quello che puoi fare è rendere migliori le fonti che Muse legge. Significa dati di prodotto e catalogo accurati se vendi, informazioni aziendali complete e coerenti se sei locale, e pagine scansionabili con segnali di entità chiari se sei un editore. Muse è un obiettivo di lavoro di preparazione, non una fonte dati che interroghi.
Se Meta pubblica una superficie per sviluppatori di Muse, questa sezione cambia. Fino ad allora, trattalo come un pubblico per cui prepararsi, non come un sistema con cui integrarsi.
Costruisci un server e riusalo cinque volte
Se devi costruire qualcosa, costruisci il server MCP per la tua fonte di maggior valore e riusalo. I cinque agenti compatibili con MCP sopra accettano tutti un server streamable HTTP, quindi un solo deployment li copre tutti.
Un server minimo ha bisogno di quattro cose: uno strumento che accetta una query e restituisce dati strutturati, un controllo del token bearer lato server, un limite di frequenza perché un agente fuori controllo non bruci la tua quota API, e un campo instructions che dichiara i vincoli nei primi 512 caratteri.
Due regole che evitano la maggior parte del dolore. Restituisci dati strutturati invece di prosa, così l'agente ragiona sui campi invece di riparsare il testo. E tieni ogni strumento in sola lettura finché non hai visto l'agente usarlo per un ciclo completo. Un server in sola lettura non può rovinare nulla, e puoi ampliarlo dopo aver visto i pattern di chiamata reali.
Verifica la connessione prima di fidarti
Non dare per scontato che un server configurato sia un server funzionante. Esegui questi quattro controlli.
Verifica che il server sia registrato. codex mcp list, claude mcp list o openclaw mcp status dovrebbero mostrarlo. Un server il cui parsing è fallito viene saltato silenziosamente in alcuni client.
Verifica l'inventario degli strumenti. Chiedi all'agente di elencare gli strumenti che il server espone. Se ne aspettavi sei e ne vedi uno, il server è registrato ma gli strumenti no.
Verifica con una query reale. Chiedi un record specifico che puoi controllare a mano. Una domanda generica come "quali dati puoi ottenere" non prova nulla.
Verifica il percorso di errore. Revoca il token e riesegui la query. Vuoi un errore di autenticazione chiaro, non un risultato vuoto e silenzioso. Un agente che tratta una chiamata fallita come "nessun dato" riporterà un risultato pulito per una connessione rotta, e quello è il modo di fallire più costoso di tutto questo flusso.
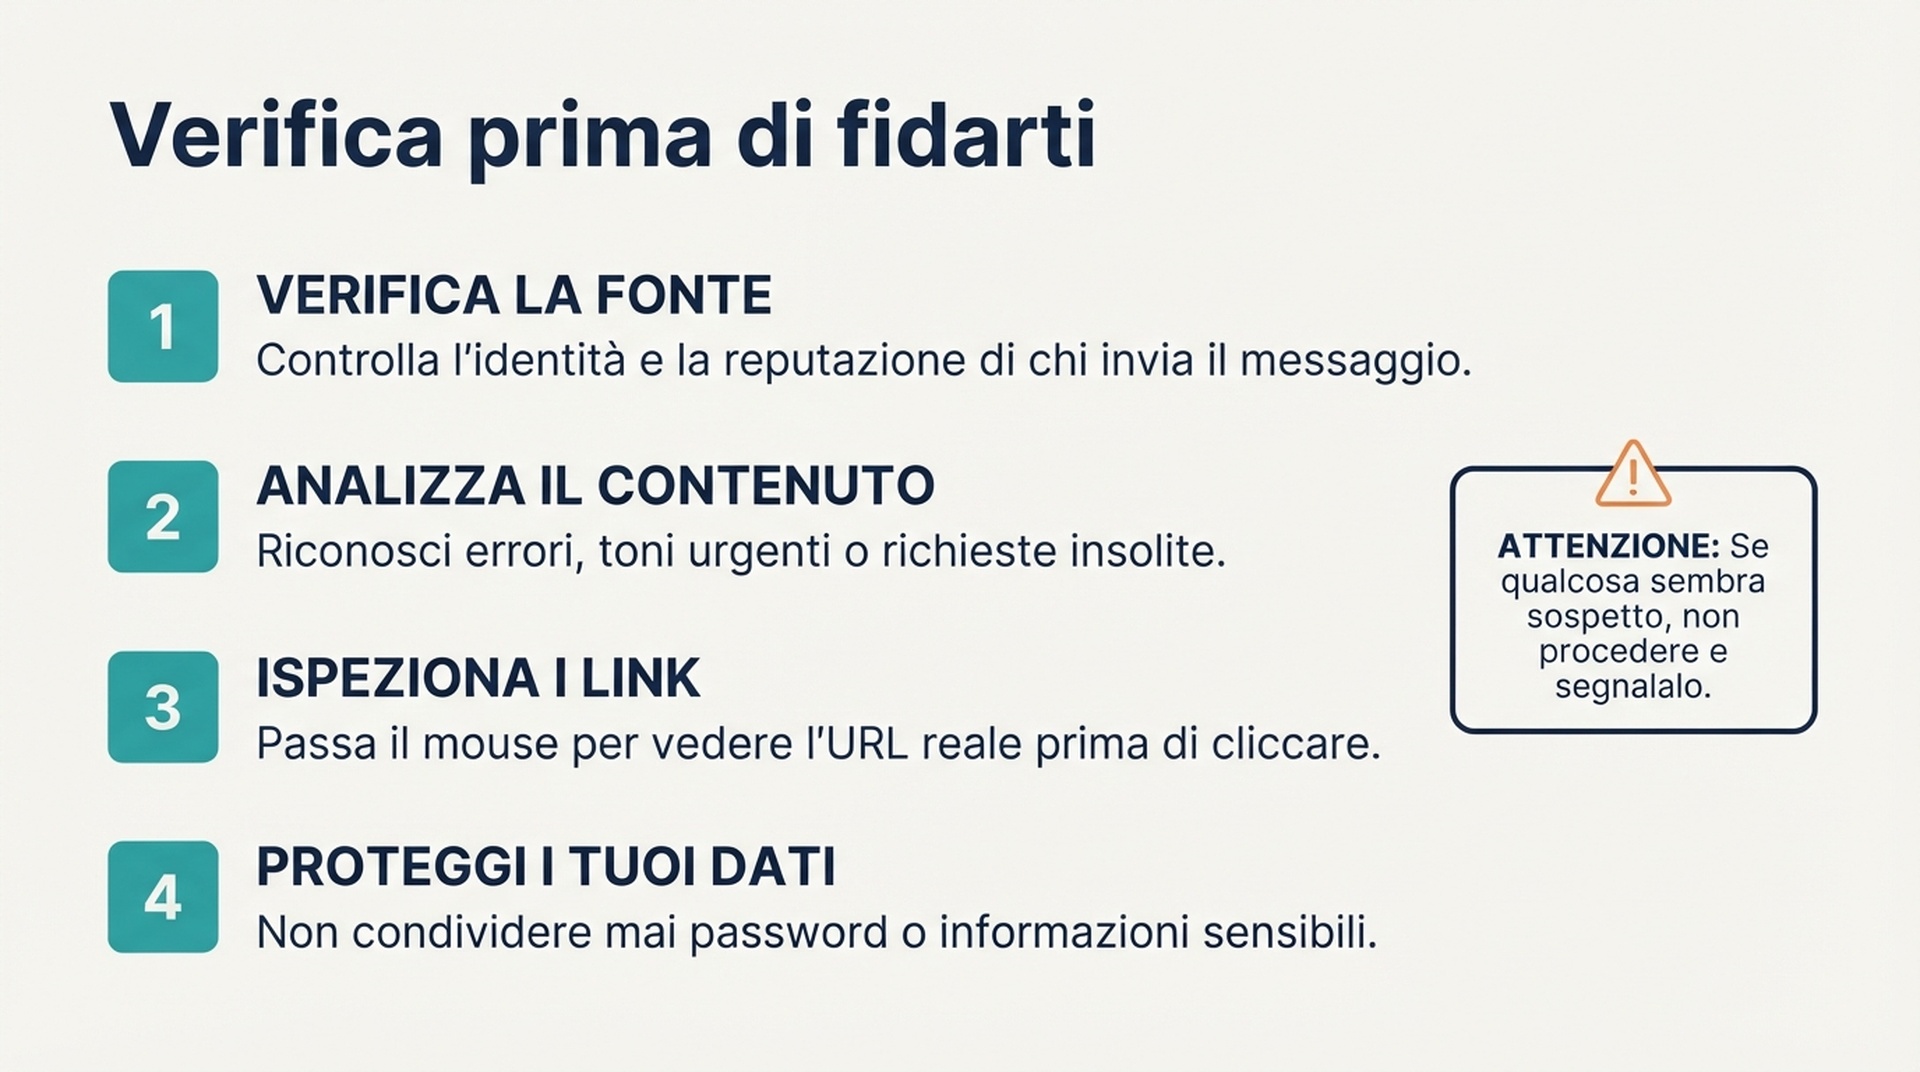
Quattro controlli. L'ultimo cattura l'errore che sembra un risultato.
Cosa cambia nelle tue priorità
La tabella dei livelli e quella delle connessioni puntano nella stessa direzione. Le fonti che puoi collegare a un agente sono le fonti che puoi misurare, e le fonti che puoi misurare sono quelle che puoi migliorare rispetto a una baseline.
Significa che l'ordine di lavoro non è quello che usa la maggior parte dei team. Parti dalla fonte che ha insieme una connessione documentata e un impatto reale sul tuo business. Per un'attività locale è Google Business Profile e il grounding con Maps. Per un'azienda di prodotti è Merchant Center o un feed prodotti. Per un'azienda di strumenti per sviluppatori è la qualità della documentazione. Per un editore è la scansionabilità e l'estraibilità delle pagine dal vivo.
Poi costruisci l'unico server MCP che porta quella fonte nel tuo agente, e riusalo nei cinque agenti che parlano il protocollo. Lascia le fonti senza percorso di connessione come lavoro di contenuto ed entità, e sii onesto sul fatto che non puoi misurarle allo stesso modo.
I team che qui prendono vantaggio non sono quelli con la lista di fonti più lunga. Sono quelli che hanno collegato le due o tre fonti che contano e costruito un ciclo di monitoraggio attorno a esse.
Domande frequenti
Serve MCP per dare a un agente accesso a una fonte dati? No. MCP è lo standard che oggi la maggior parte degli agenti supporta, il che lo rende l'opzione più riutilizzabile, ma una skill con uno script API incluso funziona altrettanto bene per un singolo agente. Se colleghi una fonte a un agente, la skill richiede meno lavoro. Se colleghi una fonte a cinque agenti, MCP si ripaga subito.
Da quale agente conviene iniziare? Inizia da quello che corrisponde a dove si trova già il tuo lavoro. Se il sito è in un repository git, Codex o Claude Code. Se vuoi esecuzioni pianificate con memoria persistente, Hermes Agent. Se ti serve un confine di permessi rigido su una fonte dati a pagamento, OpenClaw. Se vuoi la superficie più piccola che puoi verificare in una sessione, Pi Agent.
Posso collegare una fonte che non ha un server MCP? Sì, in tre modi. Scrivi un server MCP snello se la fonte ha una HTTP API e vuoi riusarlo su più agenti. Scrivi una skill con uno script incluso se ti serve un solo agente. Oppure usa un agente che supporta strumenti MCP remoti e punta a un server ospitato da altri.
Perché non posso collegare Meta Muse? Meta non ha pubblicato un'API per sviluppatori né una superficie MCP per Muse. I connettori sono gestiti dal fornitore. Finché non cambia, Muse è una superficie per cui preparare contenuti e dati, non un sistema che interroghi.
L'assegnazione dei livelli è permanente? No. Questa categoria cambia ogni mese. Riverifica la documentazione del fornitore prima di impegnare un team su un flusso, e tratta qualsiasi assegnazione più vecchia di un trimestre come non verificata.
Qual è l'errore più comune in questo lavoro? Trattare una chiamata API fallita come uno zero reale. Se l'agente riporta che un marchio non ha visibilità IA e la causa radice è un token scaduto, hai un guasto di misurazione mascherato da risultato. Prova sempre il percorso di errore prima di fidarti del percorso di successo.
Author: Julian Mercer, professionista di SEO tecnico con 14 anni di esperienza in Auspia. Scrive di scansionabilità, schemi, rendering e delle basi tecniche che rendono i contenuti leggibili sia ai motori di ricerca sia agli agenti IA.