La plupart des équipes qui suivent la visibilité d'une marque dans les réponses IA travaillent encore à partir d'une capture d'écran. Elles posent une question à ChatGPT, copient les citations et les collent dans un document. Cela vous dit ce qu'un modèle a répondu un après-midi. Cela ne vous dit pas à quelles sources le moteur de réponses peut réellement accéder, et cela ne donne à votre agent rien à interroger par lui-même.
La version plus utile de ce travail, c'est une carte des sources accompagnée d'un chemin de connexion. Vous décidez quelles sources de données comptent pour votre catégorie, puis vous connectez ce qui est atteignable directement à l'agent qui fait tourner la surveillance. Ce qui reste est une courte liste de sources sur lesquelles vous ne pouvez agir qu'indirectement, et cette liste est souvent plus courte qu'il n'y paraît.
Cet article fait trois choses. Il classe par niveaux les sources de données derrière les réponses IA, selon la force des preuves et leur actualité. Il donne le chemin API ou MCP concret pour celles qui en ont un. Et il détaille la méthode de connexion pour Codex, Claude Code, Hermes Agent, OpenClaw, Pi Agent, Grok Bot et Meta Muse, y compris les cas où il n'existe pas de connecteur prêt et où il faut construire le pont soi-même.
La réponse courte
Quatre catégories de sources alimentent les réponses IA, et l'accessibilité n'est pas la même.
Les sources web et de découverte par recherche sont accessibles via des API de grounding et via vos propres pages rendues explorables. Les flux commerciaux structurés sont accessibles via des spécifications de flux documentées, mais l'accès est limité par approbation. Les corpus de connaissances et de communautés sont en partie accessibles via des API sous licence et en partie verrouillés derrière la collecte à l'entraînement, sur laquelle vous n'avez aucune prise. Et les surfaces d'action des agents sont accessibles via des spécifications de protocole encore en train de se stabiliser.
Traduit en flux de surveillance piloté par un agent, cela devient une règle pratique. Connectez ce qui a une API ou un serveur MCP documenté. Traitez ce qui a une spécification de flux comme un projet de qualité de données. Et traitez ce qui n'a ni l'un ni l'autre comme un projet de contenu et d'entité, pas comme un projet de données.
Comment lire le tableau des niveaux
Les niveaux ci-dessous trient les sources selon la force des preuves qu'elles alimentent aujourd'hui les réponses IA, et selon que la connexion est actuelle ou historique. C'est ici que la plupart des listes de sources se trompent. Une source qui a façonné un modèle en 2022 et une source qu'un modèle interroge aujourd'hui sont deux choses différentes, et les confondre produit une mauvaise stratégie.
Niveau | Signification | Ce que cela implique pour votre flux |
|---|---|---|
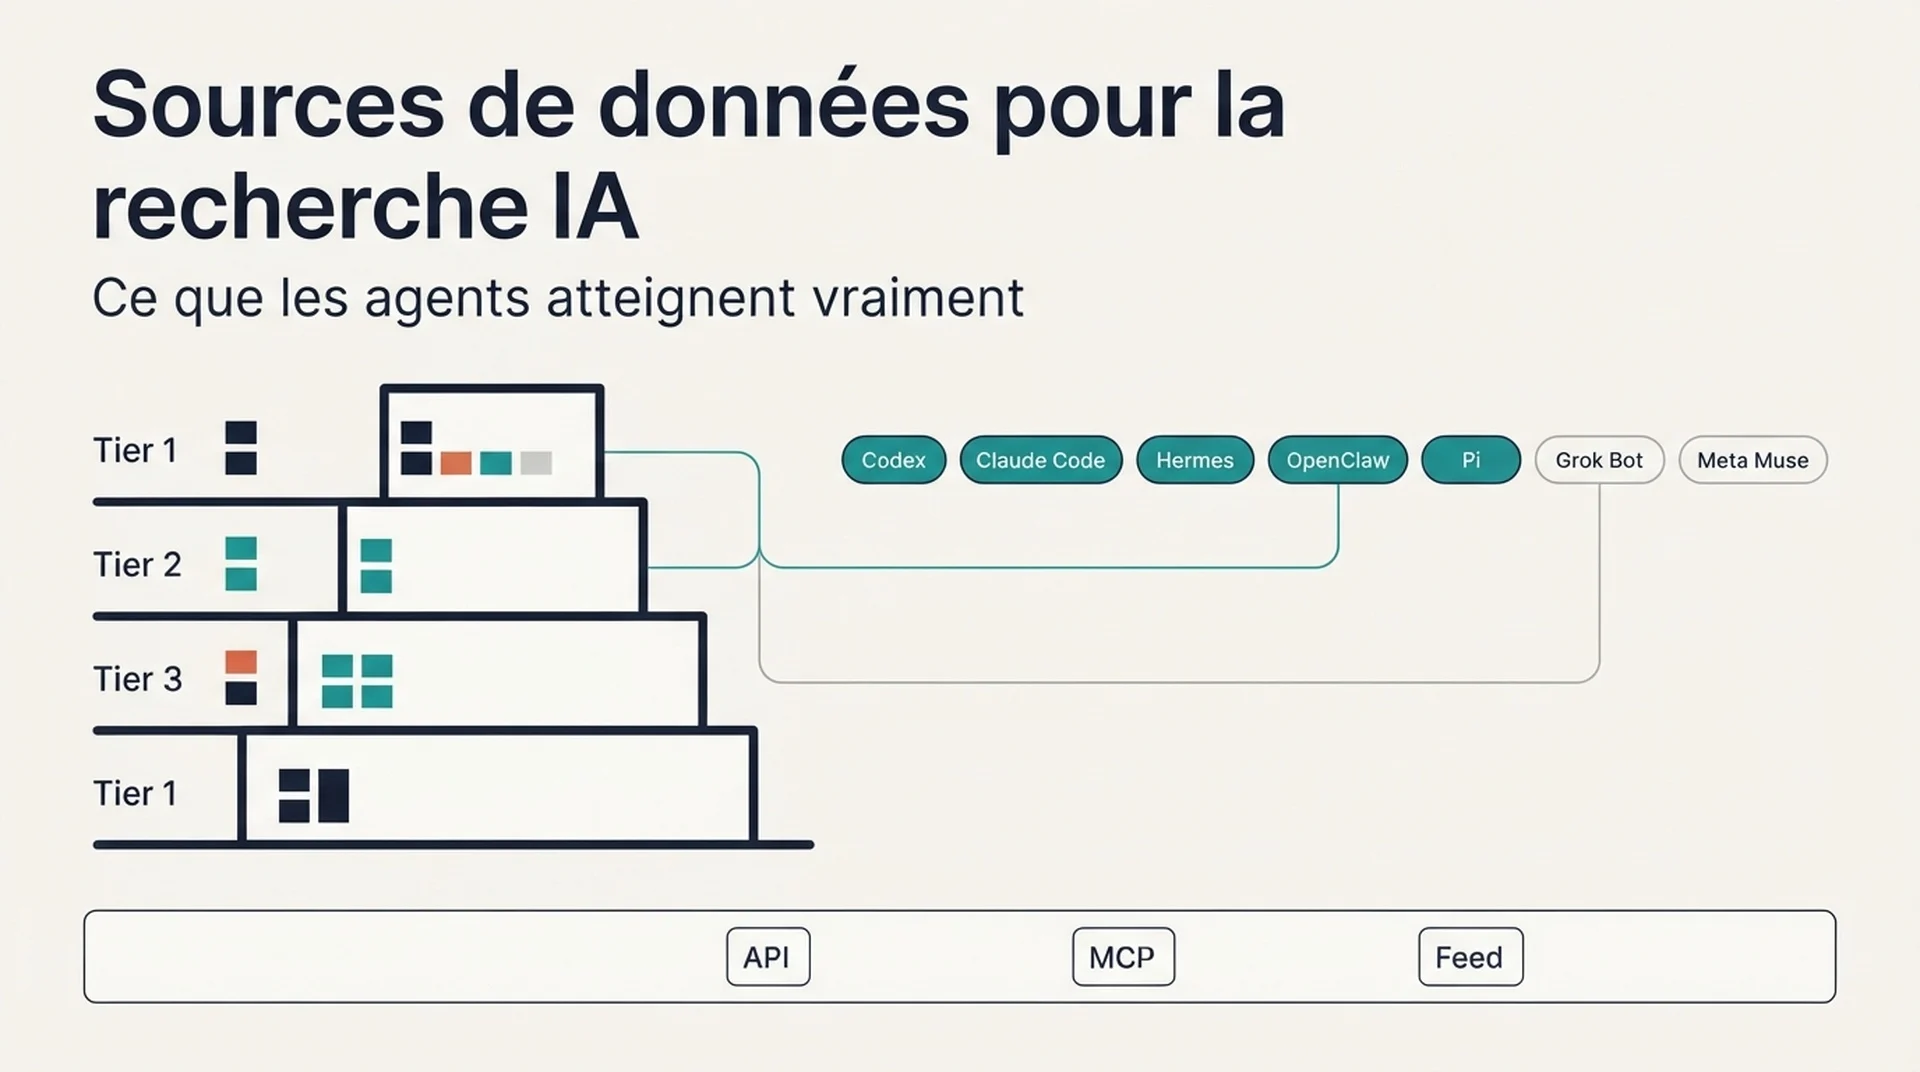
1 | Confirmé et actuel | Grounding en direct, récupération ou actions. Connectez, surveillez et optimisez pour elle. |
2 | Confirmé et actuel | Entraînement ou licence. Vous agissez par le contenu et les partenariats, pas par API. |
3 | Confirmé historique | Pré-entraînement uniquement. Aucun levier en direct. Ne bâtissez pas un flux de surveillance autour de cela. |
4 | Preuves solides, non confirmé | Inférence de catégorie. À surveiller, pas encore à budgéter. |
Une mise en garde avant le tableau. Cette catégorie change chaque mois. La documentation des fournisseurs, les accords de licence et les spécifications de flux, tout bouge. Traitez le classement par niveaux comme un point de départ que vous revérifiez dans la documentation du fournisseur lui-même avant d'engager une équipe sur un flux.
Niveau 1 : les sources en direct que votre agent atteint vraiment
Ce sont les sources qui ont une connexion documentée aujourd'hui. Si votre agent doit tirer lui-même des données de visibilité IA, c'est ici que cela commence.
Web et découverte par recherche
Grounding avec Google Search. L'API Gemini expose l'outil google_search, qui connecte le modèle au contenu web en temps réel et renvoie des citations vers les URL sources. C'est documenté, actuel, et c'est l'exemple le plus clair de grounding en direct sur le marché. Cela signifie aussi que le levier, c'est l'explorabilité et la structure de votre page, pas le flux.
Bing Search. Microsoft documente que les résultats Bing servent à renforcer les réponses de Copilot. L'implication pratique est la même que chez Google : si vous voulez apparaître, la page doit être atteignable et extractible.
Pages en direct des éditeurs. Atteintes au moment de l'inférence via le grounding de recherche, pas par pré-entraînement. La sélection des résultats de récupération et l'explorabilité gouvernent l'inclusion, et c'est pourquoi le travail de SEO technique apparaît encore dans les résultats de visibilité IA.
Produits et achats
Google Merchant Center. Les données de flux marchands sous-tendent les surfaces d'achat de Google. Si vous vendez des produits physiques et que vous n'êtes pas dans Merchant Center, vous êtes absent d'une surface activement reliée aux réponses IA.
Flux marchands et retail d'OpenAI. Les marchands partagent un flux produit structuré, et la documentation de l'Agentic Commerce Protocol décrit le schéma, les deux voies d'intégration par dépôt de fichier et par API, et une cadence de rafraîchissement qui accepte des mises à jour tout au long de la journée. L'accès est aujourd'hui réservé aux partenaires approuvés, c'est donc un projet avec un délai, pas un interrupteur.
Local et lieux
Grounding avec Google Maps. Documenté comme outil aux côtés du grounding de recherche, il donne aux modèles un contexte géospatial. C'est pourquoi les entreprises locales avec des profils précis et complets apparaissent dans les réponses IA sur les options proches.
Google Business Profile. Les données du profil d'entreprise sous-tendent les surfaces locales de Google. Pour une entreprise locale, c'est l'une des sources au plus fort levier et au moindre effort de la liste.
Yelp. Yelp licencie avis, photos et informations d'entreprise pour des recommandations locales en temps réel, et la relation dépasse le grounding pour aller jusqu'aux actions. C'est l'une des rares sources où une plateforme d'avis est à la fois source de citation et surface de transaction.
Connaissances et référence
Wikipedia et Wikimedia. Présents dans le mélange de pré-entraînement divulgué et largement utilisés comme corpus de référence en direct. La licence est inhabituellement claire, ce qui en fait une cible légitime pour le travail d'entité.
Communautés, questions-réponses et réseaux sociaux
Reddit. Source de grounding en direct via un accord de licence de données, le volet entraînement étant rapporté séparément. Traitez le statut de renouvellement comme instable et ne bâtissez pas un flux qui présuppose un accès permanent.
Niveaux 2 et 3 : les sources que vous influencez sans les interroger
Elles comptent, mais pas via une API que l'agent peut appeler.
Contenu d'éditeurs sous licence. Il existe plusieurs partenariats de licence explicites avec de grands éditeurs, dont les termes varient selon le partenaire sur l'entraînement, le grounding et l'attribution. Vous ne pouvez pas acheter votre place dans cette liste en tant que petit site, mais vous pouvez être le type de source citée quand le corpus sous licence est mince sur votre sujet.
Sources développeurs et techniques. Les dépôts de code publics et les corpus de documentation technique sont des sources actuelles confirmées. Pour les entreprises d'outils pour développeurs, c'est le niveau le plus précieux de la liste, et on y accède par la qualité de la documentation, pas par un flux.
Corpus web historiques. Versions dérivées et nettoyées de données de crawl courantes et archives similaires. Confirmés historiques, sans levier en direct. Utiles comme contexte pour comprendre pourquoi un modèle a telle prémisse, mais inadaptés à un flux de surveillance.
La couche de connexion : ce que chaque agent atteint
C'est ici que l'article se justifie. Le tableau ci-dessous associe chaque agent au mécanisme de connexion qu'il prend réellement en charge, et à l'état honnête des connecteurs prêts pour les sources ci-dessus.
Agent | Mécanisme de connexion | Connecteurs prêts | Ce que vous construisez |
|---|---|---|---|
Codex | MCP via stdio et streamable HTTP, configuré dans | Registre croissant de serveurs MCP communautaires | Un serveur MCP léger pour toute source avec HTTP API |
Claude Code | MCP via HTTP, SSE, stdio et WebSocket | Annuaire de connecteurs Anthropic et serveurs communautaires | Le même serveur, ajouté avec |
Hermes Agent | MCP avec filtrage des outils par serveur, plus des skills natives | Catalogue MCP sélectionné avec installation en un clic | Un skill qui enveloppe l'API quand il n'y a pas de MCP |
OpenClaw | Client et serveur MCP, plus A2A JSON-RPC | Registre MCP d'OpenClaw et définitions de serveur enregistrées | Une définition MCP enregistrée ou un pont A2A |
Pi Agent | Extensions TypeScript et skills, sans client MCP natif | Aucun par défaut | Une petite extension qui appelle l'API comme outil |
Grok Bot | Outils MCP distants déclarés dans la requête API | Tout serveur MCP distant vers lequel vous pointez | Un serveur MCP distant, puisque Grok gère la connexion |
Meta Muse | Connecteurs, sans surface MCP ou API publique | Uniquement des connecteurs gérés par le fournisseur | Uniquement du travail indirect : flux, données d'entité et pages explorables |
Le schéma à remarquer : cinq des sept agents parlent MCP, et les deux qui ne le parlent pas sont aux extrémités opposées du spectre. Pi Agent est délibérément minimal et attend que vous écriviez une extension. Meta Muse est un produit grand public sans aucune surface pour développeurs.
Cela signifie que le geste efficace est de construire un serveur MCP pour votre source la plus précieuse et de le réutiliser dans Codex, Claude Code, Hermes Agent, OpenClaw et Grok Bot. Vous l'écrivez une fois.
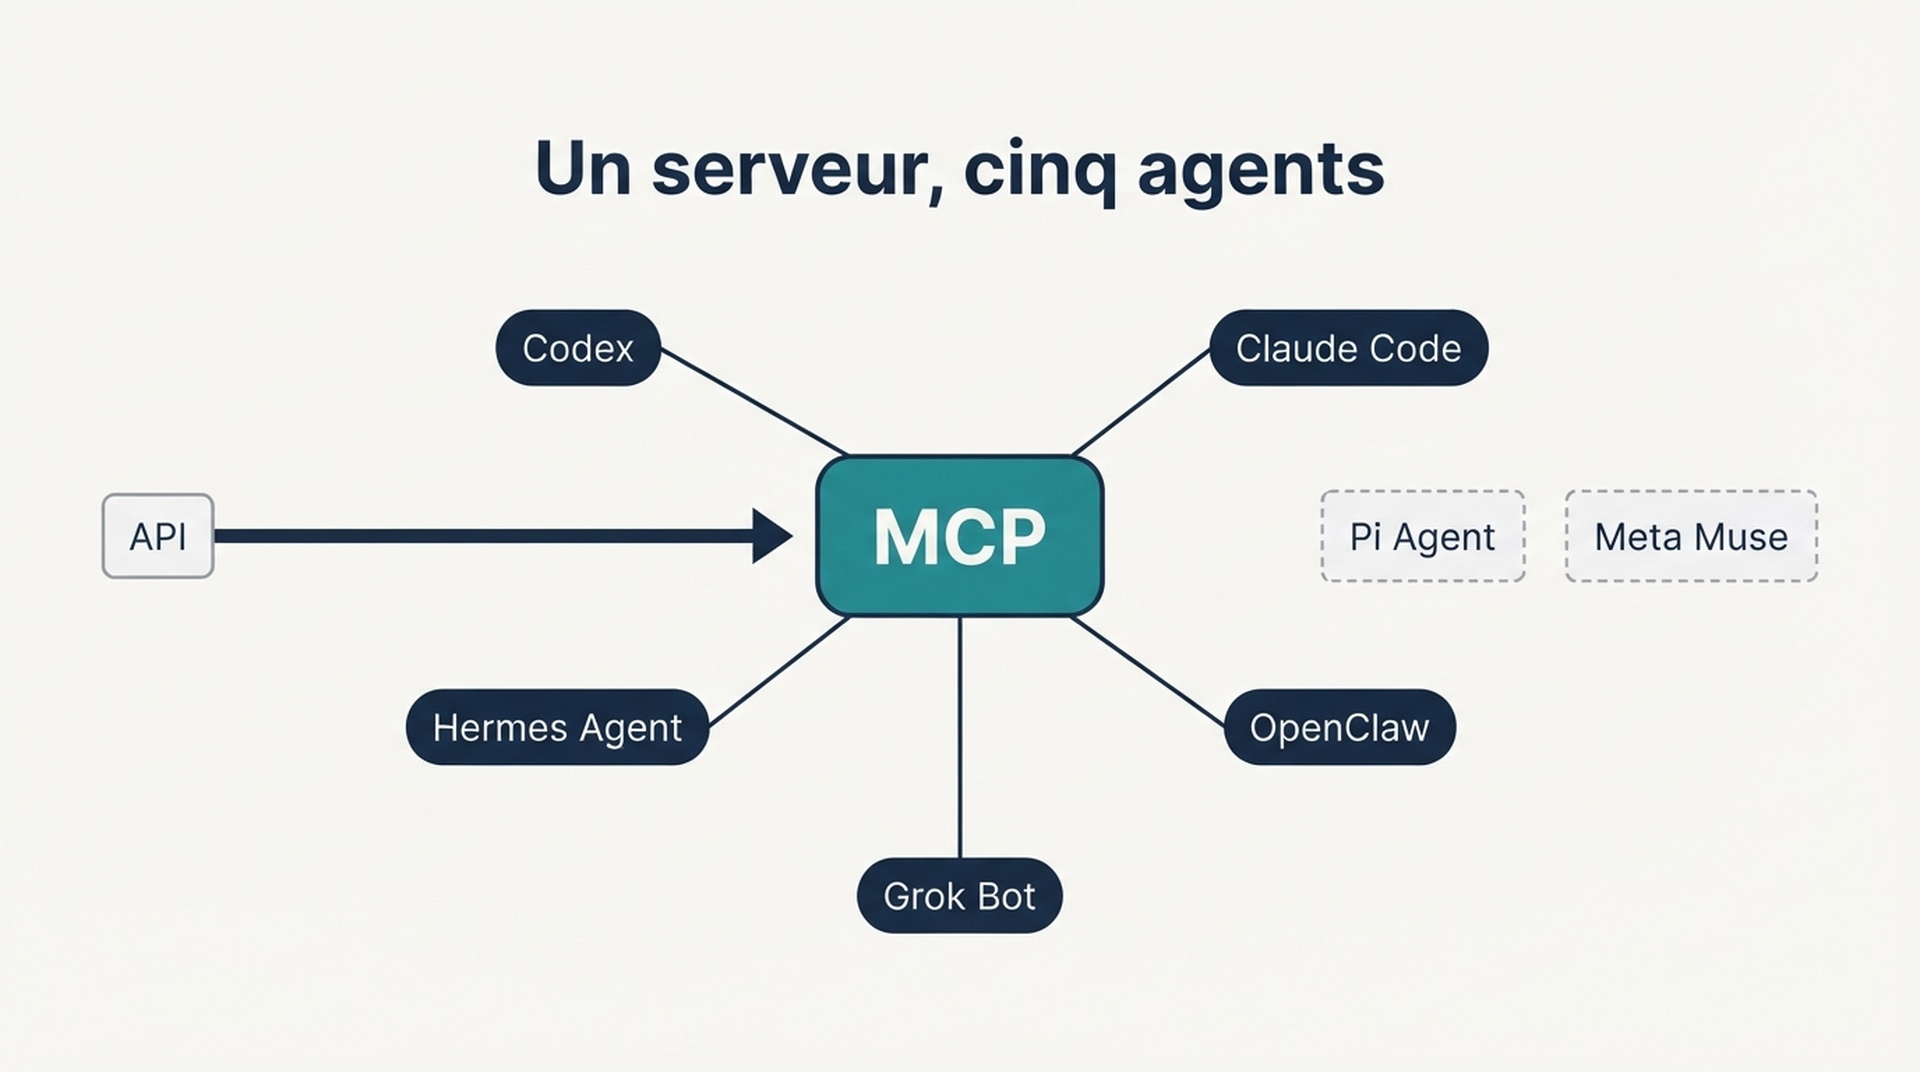
Un serveur couvre cinq des sept agents. Pi Agent et Meta Muse ont besoin d'un autre chemin.
Comment connecter chaque agent
Les étapes ci-dessous supposent que vous avez déjà une clé API ou un jeton pour la source que vous connectez. Ne mettez pas d'identifiants dans un fichier de configuration qui part dans le dépôt.
Codex
Codex stocke la configuration MCP dans config.toml, soit dans ~/.codex/config.toml, soit au niveau du projet dans .codex/config.toml. L'application de bureau ChatGPT, le CLI Codex et l'extension IDE partagent cette configuration, vous la définissez donc une fois.
Pour un serveur stdio :
codex mcp add my-source --env API_KEY=your-key -- npx -y @your-org/my-source-mcpPour un serveur streamable HTTP, ajoutez une table dans config.toml :
[mcp_servers.my-source]
url = "https://mcp.example.com/mcp"
bearer_token_env_var = "MY_SOURCE_TOKEN"
Codex lit le champ instructions renvoyé par le MCP à l'initialisation et l'utilise comme consigne à l'échelle du serveur. Si vous construisez le serveur, gardez les 512 premiers caractères autoportants pour que les contraintes les plus importantes soient à portée quand l'agent décide d'appeler ou non.
Lancez codex mcp list pour confirmer que le serveur est enregistré, et /mcp dans le TUI pour voir les serveurs actifs.
Claude Code
Claude Code prend en charge le transport HTTP distant, SSE distant, stdio local et WebSocket distant. HTTP est l'option recommandée pour les serveurs distants.
claude mcp add --transport http my-source https://mcp.example.com/mcp \
  --header "Authorization: Bearer your-token"
Pour un serveur local :
claude mcp add my-source -- npx -y @your-org/my-source-mcpDeux détails qui font trébucher. D'abord, une entrée dans une configuration JSON avec url mais sans type est traitée comme un serveur stdio et silencieusement ignorée, donc définissez "type": "http" explicitement. Ensuite, Claude Code définit CLAUDE_PROJECT_DIR dans l'environnement du serveur qu'il lance, ce qui permet à un serveur local de résoudre des chemins relatifs au projet sans dépendre du répertoire de travail.
Hermes Agent
Hermes Agent est livré avec le support MCP dans l'installation standard. La configuration se trouve dans ~/.hermes/config.yaml :
mcp_servers:
  my-source:
    command: "npx"
    args: ["-y", "@your-org/my-source-mcp"]
Hermes prend aussi en charge les serveurs MCP distants via HTTP dans la même configuration, et prend en charge le filtrage par serveur pour n'exposer que les outils que vous voulez réellement que l'agent voie. Ce filtrage compte plus ici que chez les autres agents, parce qu'Hermes tourne sans supervision selon un planning.
Si vous venez de Claude Code, la commande hermes import-agent claude-code mappe le bloc mcpServers de ~/.claude.json vers mcp_servers dans la configuration Hermes et récupère les skills et les instructions en même temps.
Quand il n'existe pas de serveur MCP pour une source, le système de skills est l'alternative. Un skill est un répertoire contenant un SKILL.md qui dit à l'agent quand l'utiliser et quoi faire. Enveloppez l'appel API dans un script fourni et référencez-le depuis le skill, et l'agent gagne la capacité sans serveur de protocole.
OpenClaw
OpenClaw fonctionne à la fois comme client MCP et comme serveur MCP. En tant que client, vous gérez les définitions de serveur enregistrées via les sous-commandes mcp registry, et vous pouvez modifier et inspecter les serveurs depuis la page de réglages du Control UI dans le navigateur.
openclaw mcp registry add my-source --transport streamable-http --url https://mcp.example.com/mcp
openclaw mcp status
OpenClaw expose aussi les conversations de ses canaux via MCP, ce qui est la direction inverse et utile si vous voulez qu'un autre agent lise ce que votre instance OpenClaw a fait. Pour les agents externes qui ne sont pas clients MCP, OpenClaw parle A2A sur JSON-RPC.
La raison de choisir OpenClaw pour ce travail est le modèle de permissions. Il a une politique d'outils par conversation et un chemin d'approbation explicite pour l'exécution, exactement ce qu'il faut quand un agent lit une source de données payante et que vous devez limiter ce qu'il peut dépenser.
Pi Agent
Pi Agent n'a pas de client MCP natif, et c'est un choix de conception, pas une lacune. Son point d'extension, ce sont des modules TypeScript qui tournent dans le processus Pi et enregistrent des outils.
Créez une extension dans ~/.pi/agent/extensions/my-source.ts :
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.registerTool({
    name: "my_source_lookup",
    description: "Look up a record in My Source by query.",
    parameters: { type: "object", properties: { query: { type: "string" } }, required: ["query"] },
    handler: async ({ query }) => {
      const res = await fetch(`https://api.example.com/search?q=${encodeURIComponent(query)}`, {
        headers: { Authorization: `Bearer ${process.env.MY_SOURCE_TOKEN}` },
      });
      return await res.json();
    },
  });
}
Chargez-la directement pendant le développement avec pi --extension ./my-source.ts, puis déplacez-la dans le répertoire des extensions ou empaquetez-la avec pi install quand elle est stable.
Le compromis est réel et mérite d'être dit franchement. Une extension tourne avec les mêmes permissions système que le processus Pi et peut inspecter les prompts, les appels d'outils, les fichiers et les identifiants. Ne chargez des extensions que depuis des sources fiables, et lisez le code avant d'installer.
Grok Bot
L'API Grok prend en charge les outils MCP distants, et xAI gère la connexion au serveur pour vous. Vous déclarez le serveur dans le tableau tools de la requête :
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import mcp

client = Client(api_key=os.getenv("XAI_API_KEY"))
chat = client.chat.create(
    model="grok-4.7",
    tools=[mcp(server_url="https://mcp.example.com/mcp", server_label="my-source")],
)
Seuls les transports streaming HTTP et SSE sont pris en charge pour les outils MCP distants. Vous pouvez restreindre les outils exposés avec allowed_tools, et passer un jeton d'autorisation que xAI place dans l'en-tête Authorization des requêtes vers votre serveur.
L'avantage ici est que vous n'exploitez ni ne maintenez de connexion côté client. L'inconvénient est que le serveur MCP doit être accessible publiquement, donc tout ce qui est derrière un VPN demande une autre approche.
Meta Muse
Muse se connecte à des applications et services tiers via des connecteurs, et l'agent lui-même n'a pas de surface MCP ou API publique pour les développeurs. C'est la réponse honnête, et elle change ce que vous pouvez faire.
Vous ne pouvez pas brancher Muse sur un flux de surveillance comme vous le faites avec les six autres agents. Ce que vous pouvez faire, c'est améliorer les sources que Muse lit. Cela veut dire des données produit et catalogue précises si vous vendez, des informations d'entreprise complètes et cohérentes si vous êtes local, et des pages explorables avec des signaux d'entité clairs si vous êtes éditeur. Muse est une cible de travail de préparation, pas une source de données que vous interrogez.
Si Meta publie une surface pour développeurs de Muse, cette section change. D'ici là, traitez-le comme une audience à laquelle se préparer, pas comme un système à intégrer.
Construisez un serveur et réutilisez-le cinq fois
Si vous construisez quelque chose, construisez le serveur MCP pour votre source la plus précieuse et réutilisez-le. Les cinq agents compatibles MCP ci-dessus acceptent tous un serveur streamable HTTP, donc un seul déploiement les couvre tous.
Un serveur minimal a besoin de quatre choses : un outil qui accepte une requête et renvoie des données structurées, une vérification de jeton bearer côté serveur, une limite de débit pour qu'un agent emballé ne brûle pas votre quota API, et un champ instructions qui énonce les contraintes dans les 512 premiers caractères.
Deux règles qui évitent l'essentiel de la douleur. Renvoyez des données structurées plutôt que de la prose, pour que l'agent raisonne sur des champs au lieu de reparcourir du texte. Et gardez chaque outil en lecture seule jusqu'à ce que vous ayez vu l'agent l'utiliser sur un cycle complet. Un serveur en lecture seule ne peut rien casser, et vous pouvez l'élargir après avoir vu les schémas d'appel réels.
Vérifiez la connexion avant de lui faire confiance
Ne supposez pas qu'un serveur configuré est un serveur qui fonctionne. Lancez ces quatre vérifications.
Vérifiez que le serveur est enregistré. codex mcp list, claude mcp list ou openclaw mcp status doivent l'afficher. Un serveur dont l'analyse a échoué est silencieusement ignoré dans certains clients.
Vérifiez l'inventaire des outils. Demandez à l'agent de lister les outils que le serveur expose. Si vous en attendiez six et que vous en voyez un, le serveur est enregistré mais pas les outils.
Vérifiez avec une requête réelle. Demandez un enregistrement précis que vous pouvez contrôler à la main. Une question générique comme « quelles données peux-tu obtenir » ne prouve rien.
Vérifiez le chemin d'échec. Révoquez le jeton et relancez la requête. Vous voulez une erreur d'authentification claire, pas un résultat vide et silencieux. Un agent qui traite un appel échoué comme « pas de données » signalera un résultat propre pour une connexion cassée, et c'est le mode d'échec le plus coûteux de tout ce flux.
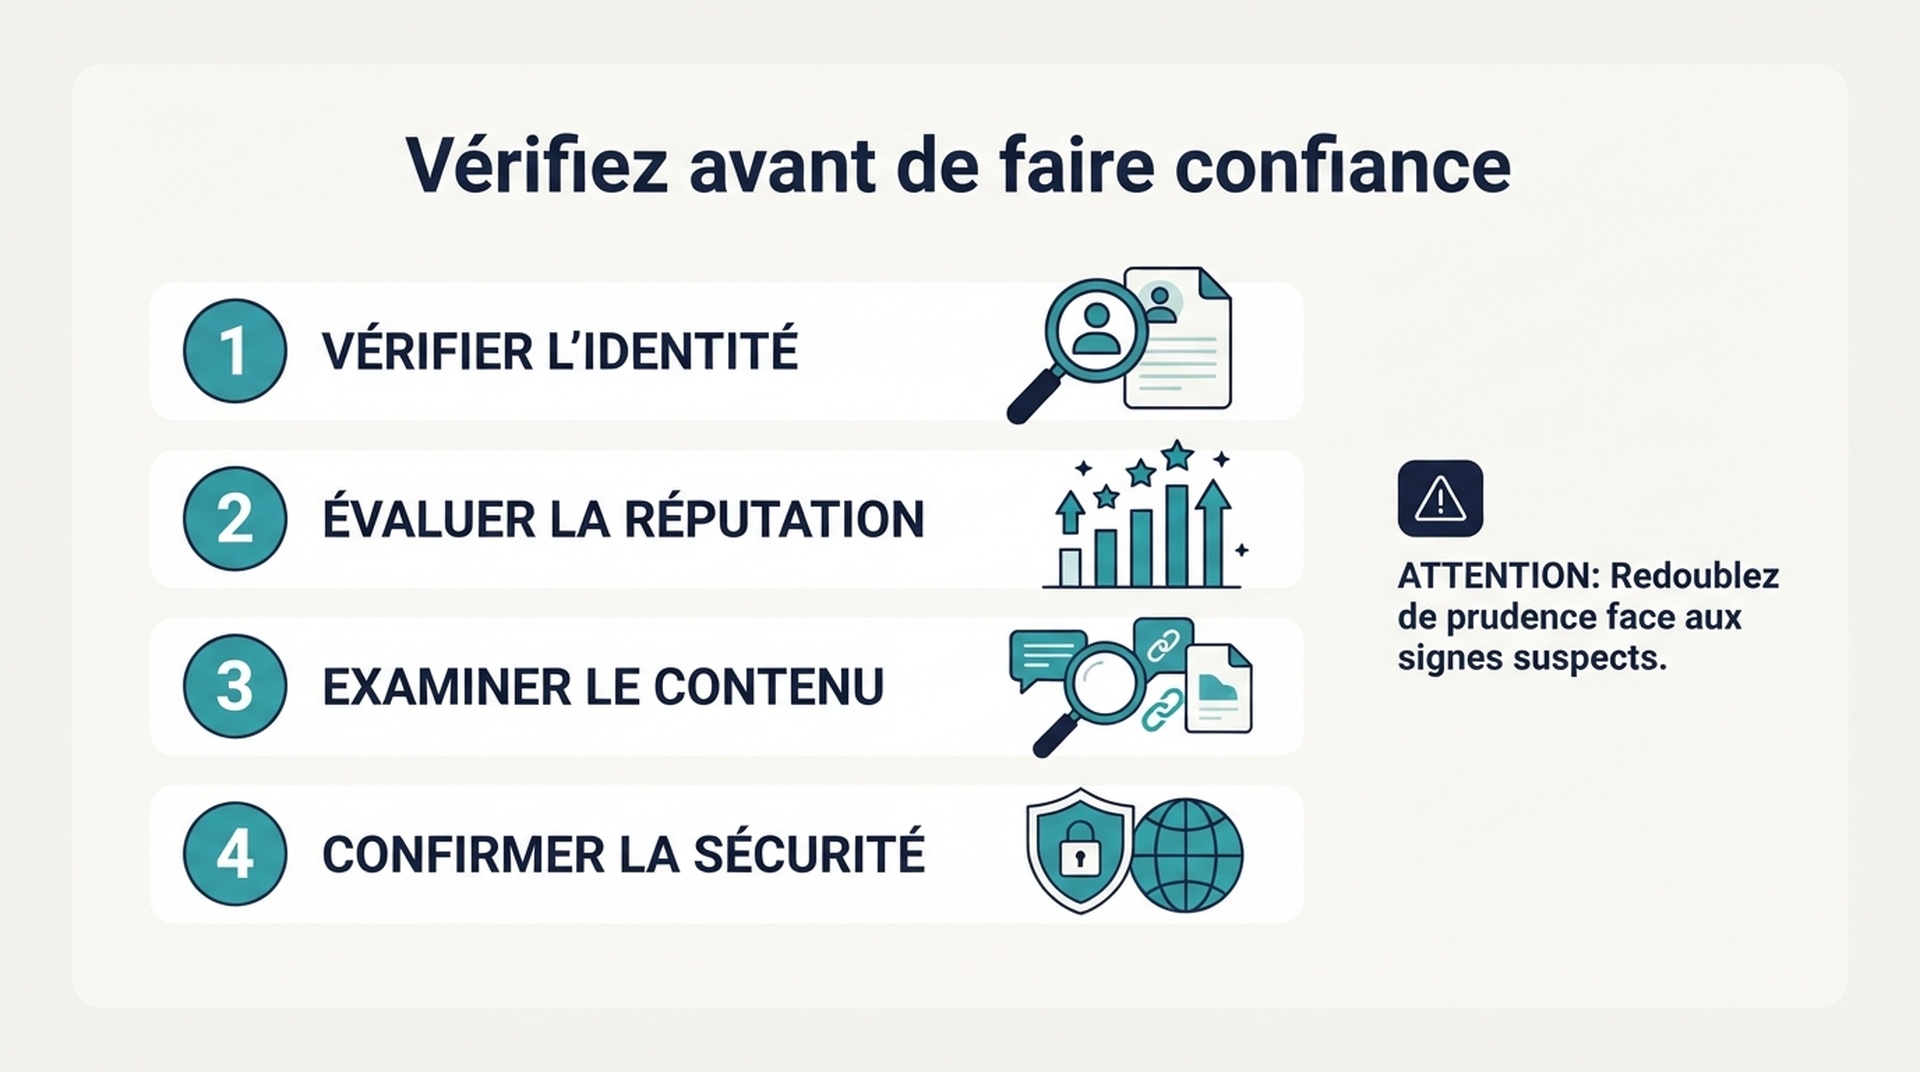
Quatre vérifications. La dernière attrape l'échec qui ressemble à une conclusion.
Ce que cela change dans vos priorités
Le tableau des niveaux et celui des connexions pointent dans la même direction. Les sources que vous pouvez connecter à un agent sont celles que vous pouvez mesurer, et les sources que vous pouvez mesurer sont celles que vous pouvez améliorer par rapport à une base de référence.
Cela signifie que l'ordre de travail n'est pas celui qu'utilisent la plupart des équipes. Commencez par la source qui a à la fois une connexion documentée et un impact réel sur votre activité. Pour une entreprise locale, c'est Google Business Profile et le grounding avec Maps. Pour une entreprise produit, c'est Merchant Center ou un flux produit. Pour une entreprise d'outils pour développeurs, c'est la qualité de la documentation. Pour un éditeur, c'est l'explorabilité et l'extractibilité des pages en direct.
Construisez ensuite l'unique serveur MCP qui fait entrer cette source dans votre agent, et réutilisez-le dans les cinq agents qui parlent le protocole. Laissez les sources sans chemin de connexion comme travail de contenu et d'entité, et soyez honnête sur le fait que vous ne pouvez pas les mesurer de la même façon.
Les équipes qui prennent de l'avance ici ne sont pas celles qui ont la plus longue liste de sources. Ce sont celles qui ont connecté les deux ou trois sources qui comptent et bâti une boucle de surveillance autour d'elles.
Questions fréquentes
Ai-je besoin de MCP pour donner à un agent accès à une source de données ? Non. MCP est le standard que la plupart des agents prennent en charge aujourd'hui, ce qui en fait l'option la plus réutilisable, mais un skill avec un script API fourni fonctionne tout aussi bien pour un seul agent. Si vous connectez une source à un agent, le skill demande moins de travail. Si vous connectez une source à cinq agents, MCP est rentable immédiatement.
Par quel agent commencer ? Commencez par celui qui correspond à l'endroit où se trouve déjà votre travail. Si le site est dans un dépôt git, Codex ou Claude Code. Si vous voulez des exécutions planifiées avec mémoire persistante, Hermes Agent. Si vous avez besoin d'une frontière de permissions stricte sur une source de données payante, OpenClaw. Si vous voulez la plus petite surface que vous pouvez auditer en une séance, Pi Agent.
Puis-je connecter une source qui n'a pas de serveur MCP ? Oui, de trois façons. Écrivez un serveur MCP léger si la source a une HTTP API et que vous voulez le réutiliser sur plusieurs agents. Écrivez un skill avec un script fourni si vous n'avez besoin que d'un agent. Ou utilisez un agent qui prend en charge les outils MCP distants et pointez vers un serveur hébergé par quelqu'un d'autre.
Pourquoi ne puis-je pas connecter Meta Muse ? Meta n'a pas publié d'API développeur ni de surface MCP pour Muse. Les connecteurs sont gérés par le fournisseur. Tant que cela ne change pas, Muse est une surface pour laquelle on prépare contenu et données, pas un système que vous interrogez.
Le classement par niveaux est-il permanent ? Non. Cette catégorie change chaque mois. Revérifiez la documentation du fournisseur avant d'engager une équipe sur un flux, et traitez tout classement de plus d'un trimestre comme non vérifié.
Quelle est l'erreur la plus courante dans ce travail ? Traiter un appel API échoué comme un zéro réel. Si l'agent signale qu'une marque n'a pas de visibilité IA et que la cause racine est un jeton expiré, vous avez une défaillance de mesure déguisée en conclusion. Testez toujours le chemin d'échec avant de faire confiance au chemin de succès.
Author: Julian Mercer, praticien SEO technique avec 14 ans d'expérience chez Auspia. Il écrit sur l'explorabilité, les schémas, le rendu et les fondations techniques qui rendent le contenu lisible à la fois pour les moteurs de recherche et pour les agents IA.