Die meisten Teams, die die Sichtbarkeit einer Marke in KI-Antworten verfolgen, arbeiten noch immer von einem Screenshot aus. Sie stellen ChatGPT eine Frage, kopieren die Zitate und fügen sie in ein Dokument ein. Das sagt dir, was ein Modell an einem Nachmittag geantwortet hat. Es sagt dir nicht, welche Quellen die Antwortmaschine tatsächlich erreichen kann, und es gibt deinem Agenten nichts, was er selbst abfragen könnte.
Die nützlichere Form dieser Arbeit ist eine Quellenkarte plus ein Verbindungspfad. Du entscheidest, welche Datenquellen für deine Kategorie wichtig sind, und verbindest dann das, was erreichbar ist, direkt mit dem Agenten, der das Monitoring fährt. Übrig bleibt eine kurze Liste von Quellen, auf die du nur indirekt einwirken kannst, und diese Liste ist meist kürzer, als es scheint.
Dieser Artikel macht drei Dinge. Er ordnet die Datenquellen hinter KI-Antworten in Stufen, nach der Stärke der Belege und nach Aktualität. Er gibt den konkreten API- oder MCP-Pfad für die, die einen haben. Und er geht die Verbindungsmethode für Codex, Claude Code, Hermes Agent, OpenClaw, Pi Agent, Grok Bot und Meta Muse durch, einschließlich der Fälle, in denen es keinen fertigen Konnektor gibt und du die Brücke selbst bauen musst.
Die kurze Antwort
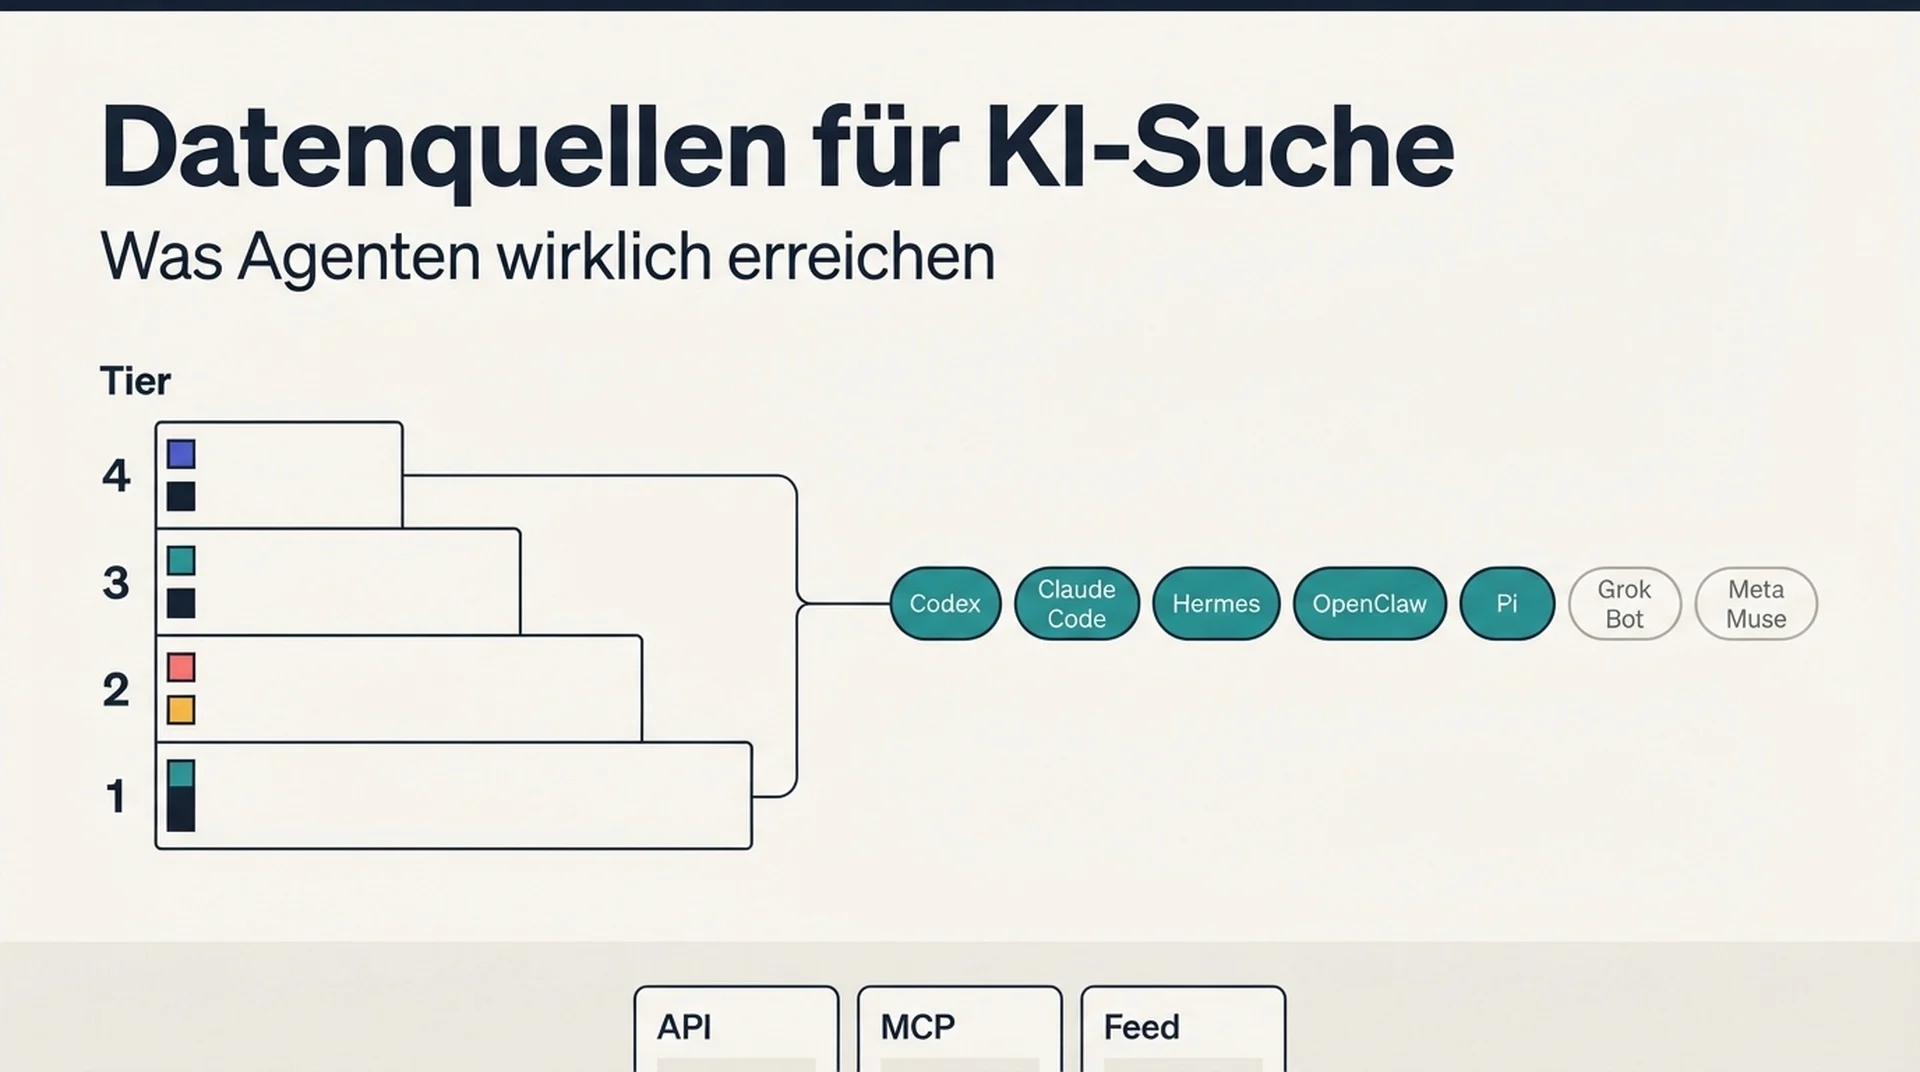
Vier Kategorien von Quellen speisen KI-Antworten, und die Erreichbarkeit ist nicht gleich.
Web- und Suchquellen sind über Grounding-APIs und über deine eigenen crawlbar gemachten Seiten erreichbar. Strukturierte Commerce-Feeds sind über dokumentierte Feed-Spezifikationen erreichbar, aber der Zugang ist durch Genehmigung begrenzt. Wissens- und Community-Korpora sind teils über lizenzierte APIs erreichbar und teils hinter der Erfassung im Training verschlossen, auf die du keinen Einfluss hast. Und Aktionsoberflächen von Agenten sind über Protokollspezifikationen erreichbar, die sich noch einpendeln.
Übersetzt in einen agentengesteuerten Monitoring-Workflow wird daraus eine praktische Regel. Verbinde, was eine dokumentierte API oder einen MCP-Server hat. Behandle, was eine Feed-Spezifikation hat, als Datenqualitätsprojekt. Und behandle, was beides nicht hat, als Content- und Entitätsprojekt, nicht als Datenprojekt.
Wie du die Stufentabelle liest
Die Stufen unten sortieren Quellen nach der Stärke der Belege, dass sie heute KI-Antworten speisen, und danach, ob die Verbindung aktuell oder historisch ist. Hier irren die meisten Quellenlisten. Eine Quelle, die 2022 ein Modell geformt hat, und eine Quelle, die ein Modell heute abfragt, sind zwei verschiedene Dinge, und ihre Vermischung führt zu schlechter Strategie.
Stufe | Bedeutung | Was sie für deinen Workflow bedeutet |
|---|---|---|
1 | Bestätigt und aktuell | Live-Grounding, Retrieval oder Aktionen. Verbinde, überwache und optimiere darauf. |
2 | Bestätigt und aktuell | Training oder Lizenzierung. Du wirkst über Inhalte und Partnerschaften ein, nicht über eine API. |
3 | Bestätigt historisch | Nur Vortraining. Kein Live-Hebel. Baue keinen Monitoring-Workflow darum. |
4 | Starke Belege, nicht bestätigt | Kategorie-Annahme. Beobachtenswert, noch kein Budget wert. |
Eine Einschränkung vor der Tabelle. Diese Kategorie ändert sich monatlich. Herstellerdokumentation, Lizenzvereinbarungen und Feed-Spezifikationen, alles bewegt sich. Behandle die Stufenzuordnung als Ausgangspunkt, den du gegen die Dokumentation des Herstellers selbst nachprüfst, bevor du ein Team auf einen Workflow festlegst.
Stufe 1: Live-Quellen, die dein Agent tatsächlich erreicht
Das sind die Quellen mit heute dokumentierter Verbindung. Wenn dein Agent Sichtbarkeitsdaten für KI selbst ziehen soll, fängt es hier an.
Web und Suchentdeckung
Grounding mit Google Search. Die Gemini-API stellt das Werkzeug google_search bereit, das das Modell mit Webinhalten in Echtzeit verbindet und Zitate zu den Quell-URLs zurückgibt. Das ist dokumentiert, aktuell und das klarste Beispiel für Live-Grounding am Markt. Es heißt auch, dass der Hebel die Crawlbarkeit und die Struktur deiner Seite ist, nicht der Feed.
Bing Search. Microsoft dokumentiert, dass Bing-Ergebnisse genutzt werden, um Copilot-Antworten zu verstärken. Die praktische Konsequenz ist dieselbe wie bei Google: Wenn du erscheinen willst, muss die Seite erreichbar und extrahierbar sein.
Live-Seiten von Publishern. Erreicht zur Inferenzzeit über Such-Grounding, nicht über Vortraining. Die Auswahl der Retrieval-Ergebnisse und die Crawlbarkeit bestimmen die Aufnahme, weshalb technische SEO-Arbeit weiterhin in KI-Sichtbarkeitsergebnissen auftaucht.
Produkte und Shopping
Google Merchant Center. Händler-Feed-Daten tragen die Shopping-Oberflächen von Google. Wenn du physische Produkte verkaufst und nicht im Merchant Center bist, fehlst du auf einer Oberfläche, die aktiv an KI-Antworten angebunden wird.
Händler- und Retail-Feeds von OpenAI. Händler teilen einen strukturierten Produktfeed, und die Dokumentation zum Agentic Commerce Protocol beschreibt das Schema, die beiden Integrationswege über Datei-Upload und über API sowie eine Aktualisierungsfrequenz, die Änderungen über den Tag hinweg annimmt. Der Zugang ist derzeit auf genehmigte Partner beschränkt, also ist es ein Projekt mit Vorlauf, kein Schalter.
Lokal und Orte
Grounding mit Google Maps. Dokumentiert als Werkzeug neben dem Such-Grounding, das Modellen geospatialen Kontext gibt. Deshalb erscheinen lokale Unternehmen mit präzisen und vollständigen Profilen in KI-Antworten zu Optionen in der Nähe.
Google Business Profile. Daten des Unternehmensprofils tragen die lokalen Oberflächen von Google. Für lokale Unternehmen ist das eine der Quellen mit dem höchsten Hebel und dem geringsten Aufwand auf der Liste.
Yelp. Yelp lizenziert Bewertungen, Fotos und Unternehmensinformationen für lokale Echtzeitempfehlungen, und die Beziehung reicht über Grounding hinaus bis zu Aktionen. Das ist eine der wenigen Quellen, bei denen eine Bewertungsplattform zugleich Zitatquelle und Transaktionsoberfläche ist.
Wissen und Referenz
Wikipedia und Wikimedia. In der offengelegten Vortrainingsmischung enthalten und breit als Live-Referenzkorpus genutzt. Die Lizenzierung ist ungewöhnlich klar, was sie zu einem legitimen Ziel für Entitätsarbeit macht.
Community, Fragen und Antworten, Social
Reddit. Live-Grounding-Quelle über eine Datenlizenzvereinbarung, wobei die Trainingsseite separat berichtet wird. Behandle den Verlängerungsstatus als instabil und baue keinen Workflow, der dauerhaften Zugang annimmt.
Stufen 2 und 3: Quellen, auf die du einwirkst, die du aber nicht abfragst
Diese sind wichtig, aber nicht über eine API, die der Agent aufrufen kann.
Lizenzierte Publisher-Inhalte. Es gibt mehrere ausdrückliche Lizenzpartnerschaften mit großen Publishern, deren Bedingungen sich je Partner bei Training, Grounding und Zuschreibung unterscheiden. Du kannst dir als kleine Seite keinen Platz in dieser Liste kaufen, aber du kannst die Art von Quelle sein, die zitiert wird, wenn das lizenzierte Korpus zu deinem Thema dünn ist.
Entwickler- und Technikquellen. Öffentliche Code-Repositories und technische Dokumentationskorpora sind bestätigte aktuelle Quellen. Für Unternehmen mit Entwicklerwerkzeugen ist das die wertvollste Stufe auf der Liste, und sie ist über Dokumentationsqualität erreichbar, nicht über einen Feed.
Historische Web-Korpora. Bereinigte Ableitungen gängiger Crawl-Daten und ähnliche Archive. Bestätigt historisch, kein Live-Hebel. Nützlich als Kontext, um zu verstehen, warum ein Modell eine bestimmte Annahme hat, aber nicht für einen Monitoring-Workflow.
Die Verbindungsschicht: Was jeder Agent erreicht
Hier rechtfertigt sich der Artikel. Die Tabelle unten ordnet jedem Agenten den Verbindungsmechanismus zu, den er tatsächlich unterstützt, und den ehrlichen Stand der fertigen Konnektoren für die obigen Quellen.
Agent | Verbindungsmechanismus | Fertige Quellen-Konnektoren | Was du baust |
|---|---|---|---|
Codex | MCP über stdio und streamable HTTP, konfiguriert in | Wachsendes Register von Community-MCP-Servern | Einen schlanken MCP-Server für jede Quelle mit HTTP-API |
Claude Code | MCP über HTTP, SSE, stdio und WebSocket | Konnektorverzeichnis von Anthropic plus Community-Server | Denselben Server, hinzugefügt mit |
Hermes Agent | MCP mit Filterung pro Server, plus native Skills | Kuratiertes MCP-Katalog mit Ein-Klick-Installation | Einen Skill, der die API umhüllt, wenn es kein MCP gibt |
OpenClaw | MCP-Client und -Server, plus A2A JSON-RPC | MCP-Register von OpenClaw und gespeicherte Serverdefinitionen | Eine gespeicherte MCP-Definition oder eine A2A-Brücke |
Pi Agent | TypeScript-Erweiterungen und Skills, kein nativer MCP-Client | Standardmäßig keine | Eine kleine Erweiterung, die die API als Werkzeug aufruft |
Grok Bot | Remote-MCP-Werkzeuge, die in der API-Anfrage deklariert werden | Jeder Remote-MCP-Server, auf den du zeigst | Einen Remote-MCP-Server, da Grok die Verbindung verwaltet |
Meta Muse | Konnektoren, keine öffentliche MCP- oder API-Oberfläche | Nur herstellerverwaltete Konnektoren | Nur indirekte Arbeit: Feeds, Entitätsdaten und crawlbar gemachte Seiten |
Das Muster, das auffällt: Fünf der sieben Agenten sprechen MCP, und die beiden, die es nicht tun, liegen an entgegengesetzten Enden des Spektrums. Pi Agent ist bewusst minimal und erwartet, dass du eine Erweiterung schreibst. Meta Muse ist ein Verbraucherprodukt ohne jede Entwickleroberfläche.
Das heißt, der effiziente Schritt ist, einen MCP-Server für deine wertvollste Quelle zu bauen und ihn in Codex, Claude Code, Hermes Agent, OpenClaw und Grok Bot wiederzuverwenden. Du schreibst ihn einmal.
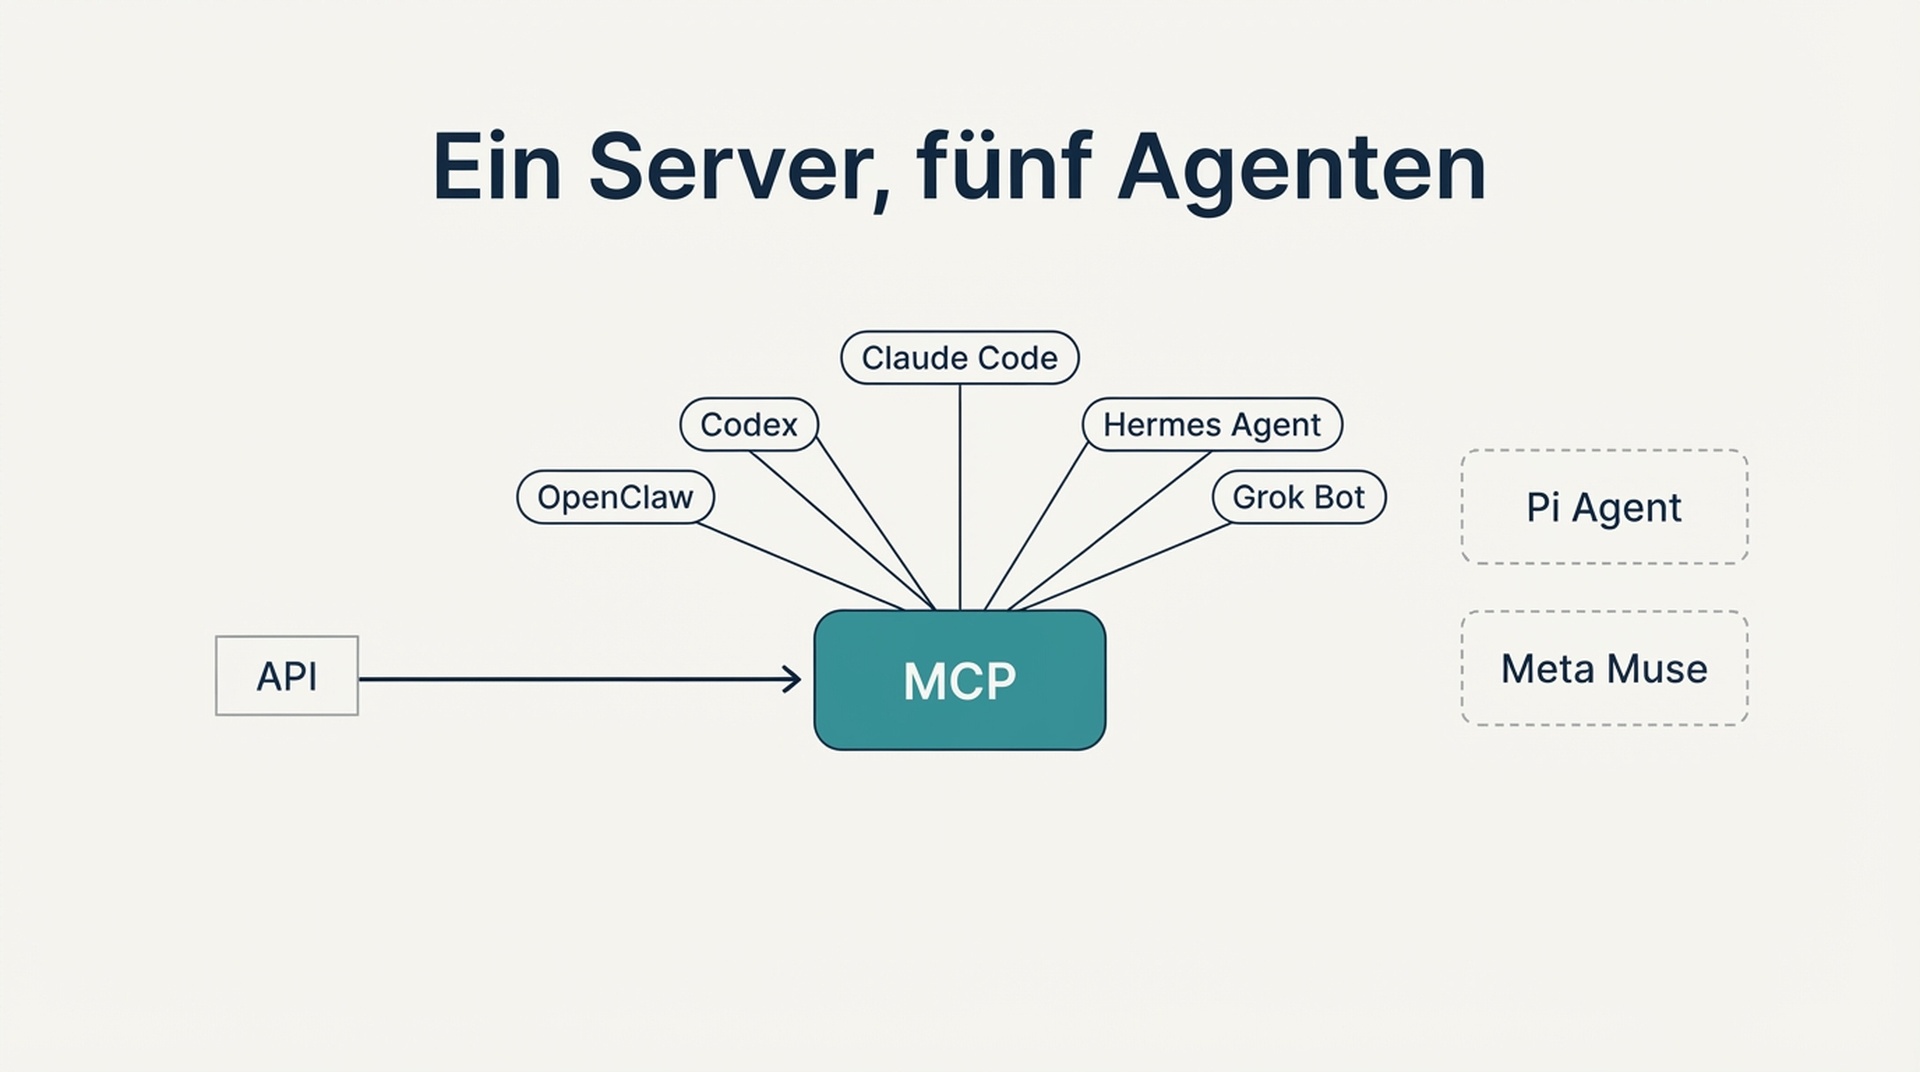
Ein Server deckt fünf der sieben Agenten ab. Pi Agent und Meta Muse brauchen einen anderen Weg.
Wie du jeden Agenten verbindest
Die Schritte unten setzen voraus, dass du bereits einen API-Schlüssel oder Token für die Quelle hast, die du verbindest. Lege Zugangsdaten nicht in eine Konfigurationsdatei, die ins Repository geht.
Codex
Codex speichert die MCP-Konfiguration in config.toml, entweder in ~/.codex/config.toml oder projektbezogen in .codex/config.toml. Die ChatGPT-Desktop-App, die Codex-CLI und die IDE-Erweiterung teilen diese Konfiguration, du richtest sie also einmal ein.
Für einen stdio-Server:
codex mcp add my-source --env API_KEY=your-key -- npx -y @your-org/my-source-mcpFür einen streamable-HTTP-Server füge eine Tabelle in config.toml hinzu:
[mcp_servers.my-source]
url = "https://mcp.example.com/mcp"
bearer_token_env_var = "MY_SOURCE_TOKEN"
Codex liest das instructions-Feld, das MCP bei der Initialisierung zurückgibt, und nutzt es als serverweite Anleitung. Wenn du den Server baust, halte die ersten 512 Zeichen selbsttragend, damit die wichtigsten Einschränkungen zur Hand sind, wenn der Agent entscheidet, ob er aufruft.
Führe codex mcp list aus, um zu bestätigen, dass der Server registriert ist, und /mcp in der TUI, um aktive Server zu sehen.
Claude Code
Claude Code unterstützt Remote-HTTP, Remote-SSE, lokales stdio und Remote-WebSocket. HTTP ist die empfohlene Option für Remote-Server.
claude mcp add --transport http my-source https://mcp.example.com/mcp \
  --header "Authorization: Bearer your-token"
Für einen lokalen Server:
claude mcp add my-source -- npx -y @your-org/my-source-mcpZwei Details, über die Leute stolpern. Erstens: Ein Eintrag in einer JSON-Konfiguration mit url, aber ohne type, wird als stdio-Server behandelt und still übersprungen, also setze "type": "http" ausdrücklich. Zweitens: Claude Code setzt CLAUDE_PROJECT_DIR in der Umgebung des gestarteten Servers, sodass ein lokaler Server projektrelative Pfade auflösen kann, ohne vom Arbeitsverzeichnis abzuhängen.
Hermes Agent
Hermes Agent bringt MCP-Unterstützung in der Standardinstallation mit. Die Konfiguration liegt in ~/.hermes/config.yaml:
mcp_servers:
  my-source:
    command: "npx"
    args: ["-y", "@your-org/my-source-mcp"]
Hermes unterstützt in derselben Konfiguration auch Remote-MCP-Server über HTTP und unterstützt Filterung pro Server, sodass du nur die Werkzeuge freigibst, die der Agent wirklich sehen soll. Diese Filterung ist hier wichtiger als bei den anderen Agenten, weil Hermes unbeaufsichtigt nach Zeitplan läuft.
Wenn du von Claude Code kommst, ordnet hermes import-agent claude-code den mcpServers-Block aus ~/.claude.json dem Feld mcp_servers in der Hermes-Konfiguration zu und übernimmt Skills und Anweisungen gleich mit.
Wenn es keinen MCP-Server für eine Quelle gibt, ist das Skill-System die Alternative. Ein Skill ist ein Verzeichnis mit einer SKILL.md, die dem Agenten sagt, wann er sie nutzt und was zu tun ist. Umhülle den API-Aufruf in einem mitgelieferten Skript und verweise aus dem Skill darauf, und der Agent bekommt die Fähigkeit ohne Protokollserver.
OpenClaw
OpenClaw arbeitet sowohl als MCP-Client als auch als MCP-Server. Als Client verwaltest du gespeicherte Serverdefinitionen über die Unterbefehle von mcp registry, und du kannst Server auf der Einstellungsseite der Control UI im Browser bearbeiten und prüfen.
openclaw mcp registry add my-source --transport streamable-http --url https://mcp.example.com/mcp
openclaw mcp status
OpenClaw stellt auch seine Kanalgespräche über MCP bereit, was die umgekehrte Richtung ist und nützlich, wenn ein anderer Agent lesen soll, was deine OpenClaw-Instanz getan hat. Für externe Agenten, die keine MCP-Clients sind, spricht OpenClaw A2A über JSON-RPC.
Der Grund, für diese Arbeit OpenClaw zu wählen, ist das Berechtigungsmodell. Es hat eine Werkzeugrichtlinie pro Chat und einen ausdrücklichen Genehmigungspfad für die Ausführung, genau das, was du brauchst, wenn ein Agent eine kostenpflichtige Datenquelle liest und du begrenzen musst, was er ausgeben darf.
Pi Agent
Pi Agent hat keinen nativen MCP-Client, und das ist eine Designentscheidung, keine Lücke. Sein Erweiterungspunkt sind TypeScript-Module, die im Pi-Prozess laufen und Werkzeuge registrieren.
Erstelle eine Erweiterung unter ~/.pi/agent/extensions/my-source.ts:
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.registerTool({
    name: "my_source_lookup",
    description: "Look up a record in My Source by query.",
    parameters: { type: "object", properties: { query: { type: "string" } }, required: ["query"] },
    handler: async ({ query }) => {
      const res = await fetch(`https://api.example.com/search?q=${encodeURIComponent(query)}`, {
        headers: { Authorization: `Bearer ${process.env.MY_SOURCE_TOKEN}` },
      });
      return await res.json();
    },
  });
}
Lade sie während der Entwicklung direkt mit pi --extension ./my-source.ts und verschiebe sie dann ins Erweiterungsverzeichnis oder paketiere sie mit pi install, wenn sie stabil ist.
Der Kompromiss ist real und sollte klar benannt werden. Eine Erweiterung läuft mit denselben Betriebssystemrechten wie der Pi-Prozess und kann Prompts, Werkzeugaufrufe, Dateien und Zugangsdaten einsehen. Lade Erweiterungen nur aus Quellen, denen du vertraust, und lies den Code vor der Installation.
Grok Bot
Die Grok-API unterstützt Remote-MCP-Werkzeuge, und xAI verwaltet die Serververbindung für dich. Du deklarierst den Server im tools-Array der Anfrage:
from xai_sdk import Client
from xai_sdk.chat import user
from xai_sdk.tools import mcp

client = Client(api_key=os.getenv("XAI_API_KEY"))
chat = client.chat.create(
    model="grok-4.7",
    tools=[mcp(server_url="https://mcp.example.com/mcp", server_label="my-source")],
)
Bei Remote-MCP-Werkzeugen werden nur die Transporte streaming HTTP und SSE unterstützt. Du kannst mit allowed_tools einschränken, welche Werkzeuge freigegeben werden, und ein Autorisierungstoken übergeben, das xAI im Authorization-Header bei Anfragen an deinen Server setzt.
Der Vorteil ist, dass du keine clientseitige Verbindung betreiben oder pflegen musst. Der Nachteil ist, dass der MCP-Server öffentlich erreichbar sein muss, also braucht alles hinter einem VPN einen anderen Ansatz.
Meta Muse
Muse verbindet sich über Konnektoren mit Apps und Diensten Dritter, und der Agent selbst hat keine öffentliche MCP- oder Entwickler-API-Oberfläche. Das ist die ehrliche Antwort, und sie ändert, was du tun kannst.
Du kannst Muse nicht wie die anderen sechs Agenten an einen Monitoring-Workflow anbinden. Was du tun kannst, ist die Quellen besser zu machen, die Muse liest. Das heißt präzise Produkt- und Katalogdaten, wenn du verkaufst, vollständige und konsistente Unternehmensinformationen, wenn du lokal bist, und crawlbar gemachte Seiten mit klaren Entitätssignalen, wenn du Publisher bist. Muse ist ein Ziel für Bereitschaftsarbeit, keine Datenquelle, die du abfragst.
Wenn Meta eine Entwickleroberfläche für Muse herausbringt, ändert sich dieser Abschnitt. Bis dahin behandle es als Publikum, auf das man sich vorbereitet, nicht als System zur Integration.
Baue einen Server und verwende ihn fünfmal
Wenn du etwas baust, baue den MCP-Server für deine wertvollste Quelle und verwende ihn wieder. Die fünf MCP-fähigen Agenten oben akzeptieren alle einen streamable-HTTP-Server, ein Deployment deckt also alle ab.
Ein minimaler Server braucht vier Dinge: ein Werkzeug, das eine Abfrage annimmt und strukturierte Daten zurückgibt; eine Bearer-Token-Prüfung auf Serverseite; eine Ratenbegrenzung, damit ein durchgehender Agent dein API-Kontingent nicht verbrennt; und ein instructions-Feld, das die Einschränkungen in den ersten 512 Zeichen nennt.
Zwei Regeln, die den meisten Schmerz verhindern. Gib strukturierte Daten statt Prosa zurück, damit der Agent über Felder nachdenkt, statt Text neu zu parsen. Und halte jedes Werkzeug nur lesend, bis du gesehen hast, wie der Agent es einen vollen Zyklus lang nutzt. Ein reiner Leseserver kann nichts kaputt machen, und du kannst ihn erweitern, nachdem du die tatsächlichen Aufrufmuster gesehen hast.
Prüfe die Verbindung, bevor du ihr vertraust
Nimm nicht an, dass ein konfigurierter Server ein funktionierender Server ist. Führe diese vier Prüfungen aus.
Stelle sicher, dass der Server registriert ist. codex mcp list, claude mcp list oder openclaw mcp status sollten ihn zeigen. Ein Server, dessen Parsing fehlgeschlagen ist, wird in manchen Clients still übersprungen.
Prüfe das Werkzeuginventar. Lass den Agenten die Werkzeuge auflisten, die der Server bereitstellt. Wenn du sechs erwartet hast und eines siehst, ist der Server registriert, die Werkzeuge aber nicht.
Prüfe mit einer echten Abfrage. Verlange einen konkreten Datensatz, den du von Hand verifizieren kannst. Eine allgemeine Frage wie "welche Daten kannst du bekommen" beweist nichts.
Prüfe den Fehlerpfad. Widerrufe das Token und führe die Abfrage erneut aus. Du willst einen klaren Authentifizierungsfehler, kein stilles leeres Ergebnis. Ein Agent, der einen fehlgeschlagenen Aufruf als "keine Daten" behandelt, meldet ein sauberes Ergebnis für eine kaputte Verbindung, und das ist der teuerste Fehlermodus in diesem ganzen Workflow.
Vier Prüfungen. Die letzte fängt den Fehler, der wie ein Befund aussieht.
Was das an deinen Prioritäten ändert
Die Stufentabelle und die Verbindungstabelle zeigen in dieselbe Richtung. Die Quellen, die du mit einem Agenten verbinden kannst, sind die Quellen, die du messen kannst, und die Quellen, die du messen kannst, sind die, die du gegen eine Grundlinie verbessern kannst.
Das heißt, die Arbeitsreihenfolge ist nicht die, die die meisten Teams nutzen. Fange mit der Quelle an, die sowohl eine dokumentierte Verbindung als auch echte Geschäftswirkung für dich hat. Für lokale Unternehmen ist das Google Business Profile und Grounding mit Maps. Für Produktunternehmen ist es Merchant Center oder ein Produktfeed. Für Unternehmen mit Entwicklerwerkzeugen ist es die Dokumentationsqualität. Für Publisher ist es Crawlbarkeit und Extrahierbarkeit der Live-Seiten.
Dann baue den einen MCP-Server, der diese Quelle in deinen Agenten bringt, und verwende ihn in den fünf Agenten wieder, die das Protokoll sprechen. Lass die Quellen ohne Verbindungspfad als Content- und Entitätsarbeit liegen und sei ehrlich, dass du sie nicht auf dieselbe Weise messen kannst.
Die Teams, die hier vorankommen, sind nicht die mit der längsten Quellenliste. Es sind die, die die zwei oder drei wichtigen Quellen verbunden und einen Monitoring-Zyklus darum gebaut haben.
Häufige Fragen
Brauche ich MCP, um einem Agenten Zugang zu einer Datenquelle zu geben? Nein. MCP ist der Standard, den die meisten Agenten heute unterstützen, was es zur wiederverwendbarsten Option macht, aber ein Skill mit mitgeliefertem API-Skript funktioniert für einen einzelnen Agenten genauso gut. Wenn du eine Quelle mit einem Agenten verbindest, ist ein Skill weniger Arbeit. Wenn du eine Quelle mit fünf Agenten verbindest, zahlt sich MCP sofort aus.
Mit welchem Agenten sollte ich anfangen? Fange mit dem an, der dazu passt, wo deine Arbeit schon liegt. Wenn die Website in einem Git-Repository liegt, Codex oder Claude Code. Wenn du geplante Läufe mit dauerhaftem Gedächtnis willst, Hermes Agent. Wenn du eine harte Berechtigungsgrenze bei einer kostenpflichtigen Datenquelle brauchst, OpenClaw. Wenn du die kleinste Oberfläche willst, die du in einem Durchgang prüfen kannst, Pi Agent.
Kann ich eine Quelle verbinden, die keinen MCP-Server hat? Ja, auf drei Wegen. Schreibe einen schlanken MCP-Server, wenn die Quelle eine HTTP-API hat und du sie in mehreren Agenten wiederverwenden willst. Schreibe einen Skill mit mitgeliefertem Skript, wenn du nur einen Agenten brauchst. Oder nutze einen Agenten, der Remote-MCP-Werkzeuge unterstützt, und zeige auf einen Server, den jemand anderes hostet.
Warum kann ich Meta Muse nicht verbinden? Meta hat keine Entwickler-API und keine MCP-Oberfläche für Muse veröffentlicht. Die Konnektoren werden vom Hersteller verwaltet. Bis sich das ändert, ist Muse eine Oberfläche, für die man Inhalte und Daten vorbereitet, kein System, das du abfragst.
Ist die Stufenzuordnung dauerhaft? Nein. Diese Kategorie ändert sich monatlich. Prüfe die Herstellerdokumentation nach, bevor du ein Team auf einen Workflow festlegst, und behandle jede Stufenzuordnung, die älter als ein Quartal ist, als unbestätigt.
Was ist der häufigste Fehler in dieser Arbeit? Einen fehlgeschlagenen API-Aufruf als echte Null zu behandeln. Wenn der Agent meldet, dass eine Marke keine KI-Sichtbarkeit hat, und die Ursache ein abgelaufenes Token ist, hast du einen Messfehler, der sich als Befund verkleidet. Teste immer den Fehlerpfad, bevor du dem Erfolgspfad vertraust.
Author: Julian Mercer, technischer SEO-Praktiker mit 14 Jahren Erfahrung bei Auspia. Er schreibt über Crawlbarkeit, Schemata, Rendering und die technischen Grundlagen, die Inhalte sowohl für Suchmaschinen als auch für KI-Agenten lesbar machen.