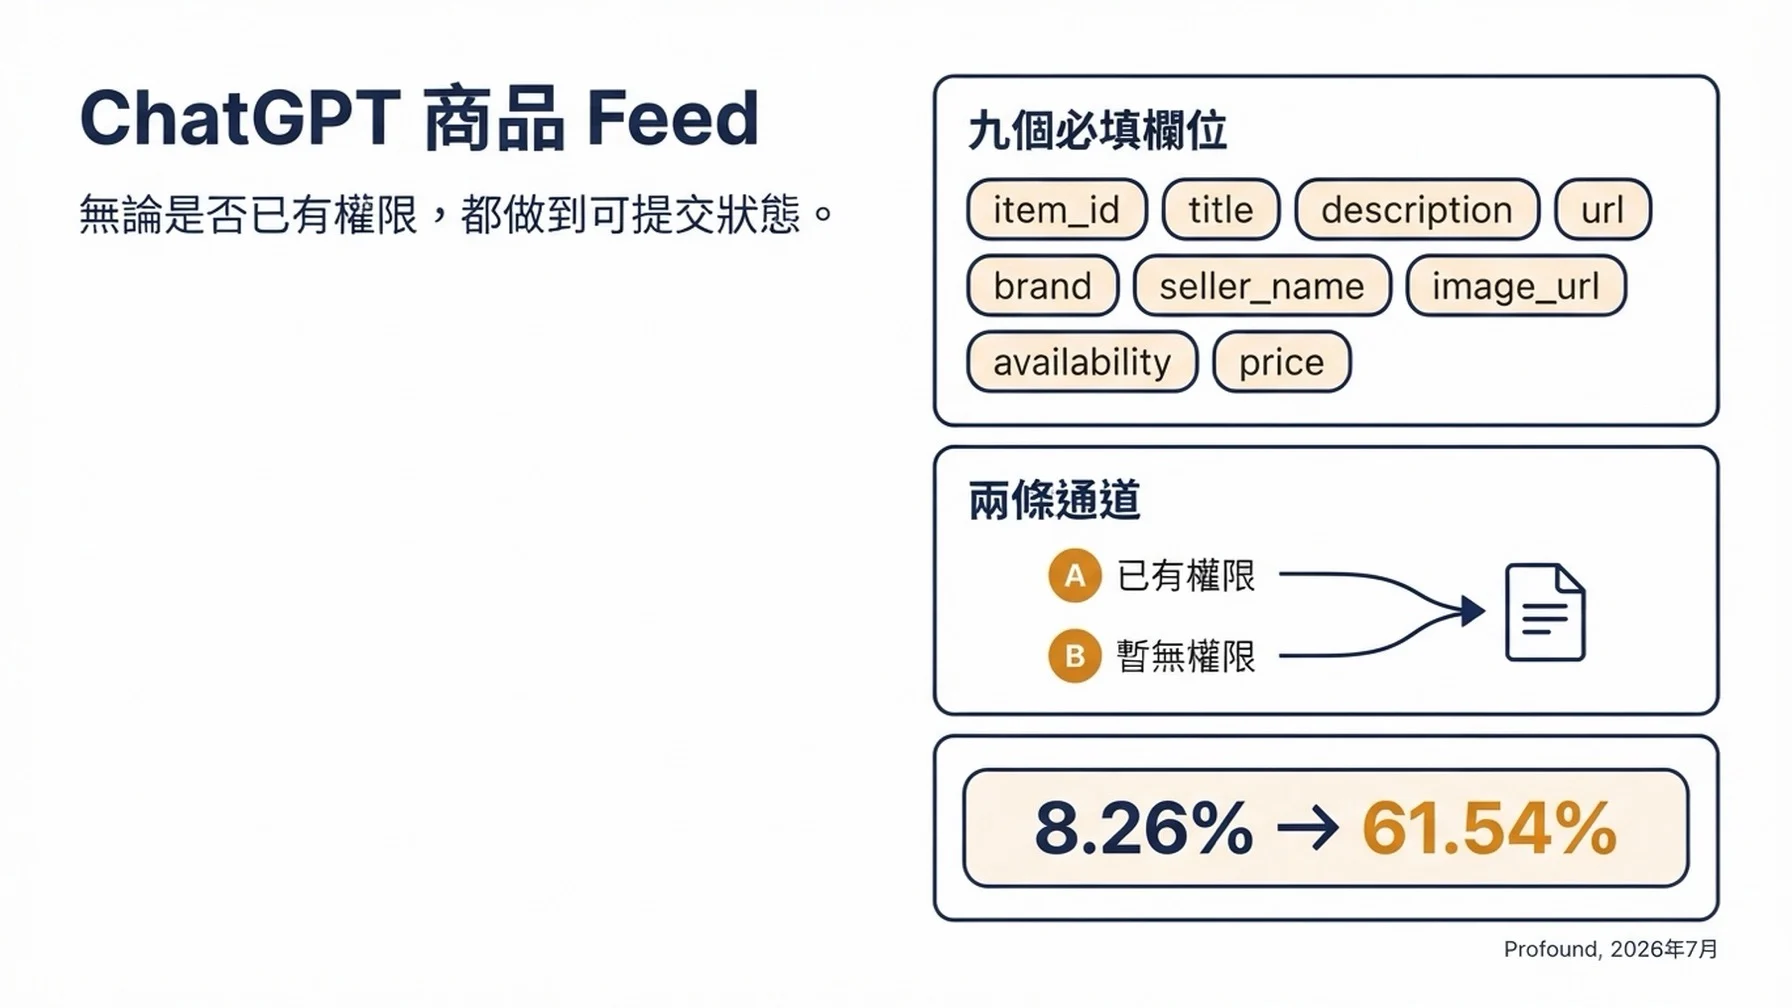
2026 年 7 月,ChatGPT 的購物推薦換了主要的資訊來源。如果你的商品資料沒有跟上這個變化,再怎麼優化商品頁面也補不回來。這套流程的作用,是把商品目錄做到可通過驗證、可提交的狀態。無論你今天能不能提交 feed,它都成立。
目標讀者 | 負責大約 500 到 100,000 個 SKU 商品資料的電商 SEO、feed 營運與商家營運負責人 |
交付物 | 一份通過全部九項必填欄位驗證的商品檔案,外加一份標註了負責人的例外清單,記錄被攔下的 SKU |
前置條件 | 能把商品目錄匯出為 CSV、TSV 或 JSONL;一個 staging 目錄;能自行編輯或提交變更申請修改 |
接入前提 | 你今天可能提交不了 feed。OpenAI 的 feed 專案是受邀制的,結帳是需要單獨啟用的接入,標準上傳目前面向美國。即便如此,這套流程依然能把檔案做出來 |
預計耗時 | 商品數低於 5,000 的目錄首次約 4 到 6 小時。耗時的是欄位稽核,不是技術設定 |
完成標準 | 每一列都通過九項必填欄位驗證;略過的 SKU 全部進入標註了負責人的例外清單;OpenAI 的搜尋爬蟲能抓取範例商品 URL 並讀到真實資料;該次執行可從留存的匯出檔案重現 |
變化本身,以及它逼出來的一個判斷
OpenAI 於 2026 年 7 月 9 日發布了 ChatGPT 5.6 模型。隔天,ChatGPT 購物推薦中來自商家商品 feed 而非開放網路搜尋的比例,從 8.26% 跳到 61.54%。這組數字來自 Profound 公開的研究,該公司追蹤了 2026 年 7 月期間的 1,757,723 次 ChatGPT 購物提示。僅僅一天,基於 feed 的檢索就從少數來源變成主導來源。
這個數字是第三方觀測,不是 OpenAI 的揭露。OpenAI 沒有確認 7 月 10 日的變化,也從未公布過任何檢索佔比。哪些結論有資料支撐、哪些沒有,我放在文章後段的一個章節裡統一說明。方向上請認真對待,精確度上請放寬。
這個方向逼出來的,是一個思維轉換。商品資料現在不僅要作為內容正確,還要作為資料正確。 一個寫得漂亮的商品頁面,如果 GTIN 檢查碼缺失,對基於 feed 的推薦引擎來說就是一行驗證失敗的紀錄。
以下全部是操作流程。7 月 10 日那組數字站不站得住,都不影響每一步的價值,因為一份乾淨、完整、機器可讀的商品目錄,在往後所有購物場景裡都用得上。
先判斷你在哪一條通道上
這套流程分成兩條通道。「做完」的含義在兩條通道上不同,所以開工前你得先知道自己在哪條。通道 A 能證明已被收錄。通道 B 能證明的到「準備就緒」為止。兩條通道產出的是同一份檔案。
四項接入判定
每一項都請如實回答。
問題 | 算作「是」的憑據 | 不算數的 |
|---|---|---|
你是否已向 OpenAI 註冊並收到 feed 接入的書面確認? | 點名提到你的 feed 的確認 | 「我送過意向表」 |
你的目錄是否面向美國市場? | 目前標準上傳範圍涵蓋到你的確認 | 假設自己的市場也在範圍內 |
結帳接入是否已單獨啟用? | 接入過程中明確的確認 | 自己把開關打開 |
你是否提交過範例或完整檔案並收到受理回覆? | 提到你這次提交的回覆 | 送出去了但沒有任何回音 |
只要有一項沒有「指得出來的憑據」支撐,你就在通道 B。這是預設位置,不是失敗狀態。有兩點值得額外說明:打開資格欄位並不會完成結帳的接入流程;註冊能拿到的只是商家顯示名稱,拿不到 feed 的其他任何東西。
通道 A:feed 接入已確認
你會拿到註冊專屬的欄位清單,以及接入流程中確認的提交管道。提交機制本身是在接入流程裡確定的。 是 SFTP,還是往白名單端點做加密 HTTPS 推送,各家公開的說法並不一致。在 OpenAI 明確告訴你適用哪一種之前,別按任何一種說法去搭你的管道。
通道 B:還沒有接入,以及哪些事不會白做
今天不需要任何許可就能推進的有三件事:爬蟲存取、商品頁面本身的結構化資料與描述品質,以及把檔案做好並驗證通過。本文中段的目錄工作沒有任何門檻。現在就做出檔案並驗證,等接入開通那天直接提交一份本來就合格的。
如果你用 Shopify,商品資料會透過 Shopify Catalog 到達 ChatGPT,商家端不需要額外工作。真正需要直接 feed 的是時效性,以及預設不會帶過去的那些欄位。有一點要留意:有一個二手來源把這項接入標為 2026 年 3 月,但那個日期未經查核,當作閒聊素材即可,別寫進計畫。
為讀取你商品的爬蟲開門
這是兩條通道都能立刻見效的第一步,也是性價比最高的一步。
打開 robots.txt,查看針對 OpenAI 各 agent 的指令。對商品可見性真正關鍵的是 OAI-SearchBot。它一旦被封鎖,你的內容就不會出現在 ChatGPT 的商品結果裡,feed 再乾淨也沒用。它不用於模型訓練,封鎖它保護不了任何東西。
需要明確判斷的 agent 名稱有四個。
Agent | 作用 | 對商品可見性的影響 |
|---|---|---|
| 為搜尋場景索引內容 | 封鎖後商品會被隱藏,與 feed 品質無關 |
| 抓取使用者明確詢問的頁面 | 封鎖後即時讀頁會失效 |
| 訓練用爬蟲 | 與購物可見性無關 |
| 代理式瀏覽 | 影響經由代理的結帳路徑 |
這裡最重要的品質檢查不是 `robots.txt`。 而是被放行的爬蟲真的到達之後,能不能讀到東西。用爬蟲的 user agent 抓一個代表性商品 URL,然後檢查回應內容。如果傳回的只是一個應用外殼,沒有伺服器端渲染的標題、價格、庫存狀態和描述,那這次抓取成功了,卻什麼有用的東西都沒傳回。很多店面前端只在客戶端渲染商品資料,這類店面無論 robots 檔案怎麼寫,在沒有 feed 的探索路徑裡都是隱形的。
這項檢查可以用 Auspia 的 OpenAI search crawler simulator 執行,它會以 OpenAI 爬蟲的身分抓取公開頁面,並顯示它能讀到什麼。
補救路徑。 如果 robots.txt 被平台或代理商鎖住,把變更申請連同日期記錄下來,然後繼續往下走。這一步不是攔截點,它會成為通道 B 紀錄裡的證據。
讓商品頁面對機器可讀
feed 不是通往購物推薦的唯一路徑,對通道 B 的商家來說目前根本用不上。頁面上的結構化資料用得上。
為所有商品範本加上 JSON-LD 格式的 Product 結構化資料,並且讓它和商品目錄匯出同源。後半句是團隊最容易漏掉的地方。如果 schema 在主題裡手動維護,而 feed 來自 PIM,兩者會在一個季度內走偏,而價格和庫存訊號互相打架,比乾脆沒有更糟。
至少包含 name、description、image、SKU、brand,以及帶 price、price currency、availability 的 offers 區塊。取值要和 feed 裡一致。如果目錄裡有 GTIN、condition、material、color、size、dimensions,也一併放進去,這些正是對話式查詢真正會用到的屬性。
品質檢查。 從差異最大的品類裡各挑一個商品 URL,一共三個,用爬蟲看到的那條渲染路徑去驗證,而不是用登入狀態的瀏覽器。
補救路徑。 如果平台不允許往商品範本注入 JSON-LD,就透過代碼管理工具塞進 head,並把它記為技術債。能用,但脆弱,得有人負責撤下它。
面向對話式查詢重寫描述
這一步裡,SEO 的老規矩會反過來傷你。
商品目錄的描述通常是為了涵蓋關鍵字、和在貨架上說服人而寫的:品牌敘事、堆關鍵字的標題、賣點羅列。對話式購物查詢完全不是這個形狀。有人問「辦公室開放式座位用的、150 美元以下的靜音機械鍵盤」,能回答這個問題的屬性是噪音水準、軸體類型和配列。這些屬性要能被擷取,就必須存在,而且必須是事實。
把商品描述寫成一份事實規格表,前面帶一句給人看的簡短引言。一句話說清它是什麼、適合誰。然後不加行銷修飾地把屬性列出來。「重量:780 g」勝過「令人驚豔的輕量化設計」。要下判斷,就把它寫得具體、可驗證。
在大舉投入之前,有件事得知道。OpenAI 的購物文件寫明,ChatGPT 可能會生成簡化過的商品標題和描述。你的文案是推薦的輸入,不是有保證的輸出。把來源資料寫得乾淨、基於事實,然後接受表層可能改寫它這個事實。
品質檢查。 挑出銷量前十的商品,為每個寫下買家做決定時需要的四個屬性。如果一個描述裡出現不到三個,那它沒在做事。
補救路徑。 如果描述來自你控制不了的供應商 feed,手動重寫銷量最高的那一成,讓長尾慢慢跟上。局部涵蓋也比專案停擺強。
動第一列資料之前,先寫下欄位契約
從這裡進入 feed 本體。在任何匯出之前,把「什麼算對」一次性寫清楚。這麼做的結果,是把稽核從辯論變成機械處理。
九個必填欄位,以及各自會在哪裡崩
每一列都需要這九個。這張表就是契約。
欄位 | 可接受的格式 | 最常見的失敗 | 後果 |
|---|---|---|---|
| 每個商品或變體穩定、唯一的字串 | 在變體間重複使用,或每次匯出重新產生 | 重複列與孤立列 |
| 純字串,建議不超過 150 字元 | 從詞中間截斷,或在標題裡帶上價格 | 整列被拒或錯誤匹配 |
| 純文字,最多 5,000 字元 | CMS 殘留的 HTML 或 markdown | 整列被拒 |
| 商品頁面 URL | 帶追蹤參數,或會跳轉的 URL | 該列解析不到任何東西 |
| 品牌名稱字串 | 無品牌 SKU 上完全缺失 | 整列被拒 |
| 商家名稱字串 | 整個目錄裡寫法不一致 | 商家訊號被削弱 |
| 直達圖片的 URL | 佔位圖,或需要工作階段才能存取的 URL | 該列沒有視覺素材 |
| 只能是 | 來自內部庫存詞彙的自創值 | 整列被拒 |
|
| 帶千分位分隔符,或沒有幣別的裸數字 | 整列被拒 |
有兩個欄位值得單獨強調,因為它們會悄悄失敗並拖垮整條商品線。
availability 欄位只接受五個值。省略、留空或無法識別的值都會導致整列被拒。如果你的平台匯出的是 IN STOCK、available 或 1,這些列全都會失敗。把內部詞彙顯式映射到五個可接受值,映射不了的送進人工佇列,別預設落到 unknown。unknown 是合法取值,但它是一個有意的狀態,不是什麼都往裡塞的垃圾桶。
price 欄位是 金額、一個空格,然後是大寫幣別代碼。也就是 79.99 USD,不是 $79.99,不是 79,99 USD,也不是 7.999e1。不能有千分位分隔符,不能有科學記號。
會悄悄拒列的規則
還有四條限制值得寫進驗證腳本。
GTIN。 必須正好是 8、12、13 或 14 位,且檢查碼有效。不接受 ISBN-10。保留前導零,也就是說,在所有會經過的地方都要把這一欄當文字處理。這是整份規格裡最常見的一個隱形破壞點,因為試算表和 CSV 匯出預設會丟掉前導零。
促銷價。 必須大於零,且在同一幣別下嚴格小於原價。促銷價等於原價、或原價留空的促銷列都會失敗。
標題長度。 建議不超過 150 字元。截斷時請在詞邊界處切。
日期欄位不排程任何東西。 規格明確寫著,契約裡的日期不會為價格或庫存變更排程。想讓促銷在午夜切換,必須由你的管道把新值推上去。
有意識地決定資格欄位
有三個欄位決定一列通過驗證之後會發生什麼。
欄位 | 省略或留空時的預設值 | 作用 |
|---|---|---|
|
| 設為 |
| 需要搜尋資格 | 要設為 |
| 關閉 | 控制一條獨立的廣告處理路徑 |
它們也可能以 enable_search、enable_checkout、is_eligible_ads 出現。這些是別名,別把用舊拼寫的範本當成另外一個欄位。
一條實務建議:讓 is_eligible_search 和那個已經知道商品下架或隱藏的系統保持同步。如果你另有一份「從通路隱藏」的名單,而它到不了 feed,你就是在把過期的上架資訊往推薦裡送。
按什麼順序開啟選填欄位組
選填欄位大約有 50 個。這裡按每投入一小時能拿回多少來排,而不是按規格順序。
- 變體(
group_id、listing_has_variations、variant_dict、offer_id、gtin、mpn)。如果你賣服裝、鞋、家居,或任何有尺寸顏色的東西,這是第一優先。 - 商品資訊(
condition、product_category、material、color、size、gender、age_group,以及尺寸重量欄位)。這些是讓對話式匹配跑起來的東西。 - 媒體(
additional_image_urls)。 - 退貨(
accepts_returns、return_deadline_in_days、return_policy)。 - 評價(
review_count、star_rating),加上店鋪層級的store_review_count與store_star_rating。 - 履約、商家與地區(
shipping_price、shipping、seller_url、target_countries、store_country)。 - 只在接入時開放的欄位。
marketplace_seller、size_system、accepts_exchanges、is_digital,廣告那一對(is_ads_eligible、ads_metadata),結帳那一對(is_eligible_checkout、seller_privacy_policy、seller_tos),都需要在接入流程中確認。它們不是自助的。第一輪先放一放。
品質檢查。 九個必填欄位都要映射到某一欄,且該欄在至少 95% 的 SKU 上解析出真實資料。低於這個門檻的欄位不是映射任務,而是一個採購決策。
補救路徑。 如果某個必填欄位根本沒有來源,比如無品牌商品線上的 brand,那就停下來,在做檔案之前先和業務負責人把採購問題定下來。格式層面的工作修不好不存在的資料。
實際允許提交的檔案格式
用接入流程中針對你註冊 feed 確認過的格式。除此之外,還有一條 Google 相容路徑,接受 UTF-8 的定位點分隔 .txt 或 .tsv,以及逗號分隔 .csv,並支援 .txt.gz、.txt.gzip、.tsv.gz、.csv.gz 形式的 gzip 壓縮。
在這條相容路徑上,JSON、試算表、XML、RSS、Atom 都不受支援。不要逐列混用格式,整份上傳只用一種。
正規化最容易崩掉的四個欄位
凍結一份匯出
只匯出一次,給檔案打上時間戳並算出雜湊值。後面每一步都針對這份凍結檔案執行。可重現的特性,決定了三週後有人問「這個 SKU 為什麼不見了」時,這次稽核能不能交代得清。
四項正規化
GTIN 前導零。 把該欄按文字匯出,驗證位數是 8、12、13、14 中的一個,並驗證檢查碼。絕大多數靜默失敗都出在這裡。
價格格式。 去掉千分位分隔符,保留小數點,清掉科學記號,把幣別代碼作為獨立記號附上。把結果丟進一個只接受 ^\d+\.\d{2} [A-Z]{3}$ 的正規表達式,其餘進佇列。
庫存狀態映射。 把內部詞彙顯式映射到五個可接受值。統計每個桶落進了多少列,又有多少列落進人工複核。人工複核多,說明不是 feed 壞了,而是你的庫存詞彙需要一張映射表。
標題與描述清理。 標題在 150 字元處按詞邊界截斷。描述剝掉標記,按純文字限制在 5,000 字元以內。
品質檢查。 把正規化後的檔案重新匯入一個新的試算表,確認 GTIN 欄仍然顯示前導零。這樣能抓出那種繞過其他所有檢查的數字匯出陷阱。
補救路徑。 如果 feed 平台或 PIM 替你做這些正規化,別信成功提示,用同一套檢查去驗證它的輸出。
稽核每一列,並維護一份例外清單
到這裡,把檢查跑遍整份檔案。這一步把商品目錄變成一份工作任務書。
不用驗證器就能做的九項機械檢查
對每一列:九個必填欄位都存在且非空;availability 落在五個列舉值裡;gtin 位數與檢查碼有效;price 符合金額加幣別的形狀;sale_price 嚴格小於 price、大於零且幣別相同;title 不超過 150 字元;description 是純文字且不超過 5,000 字元;url 回傳 200 且在伺服器端渲染出商品資料;image_url 解析到真實圖片而非佔位圖。
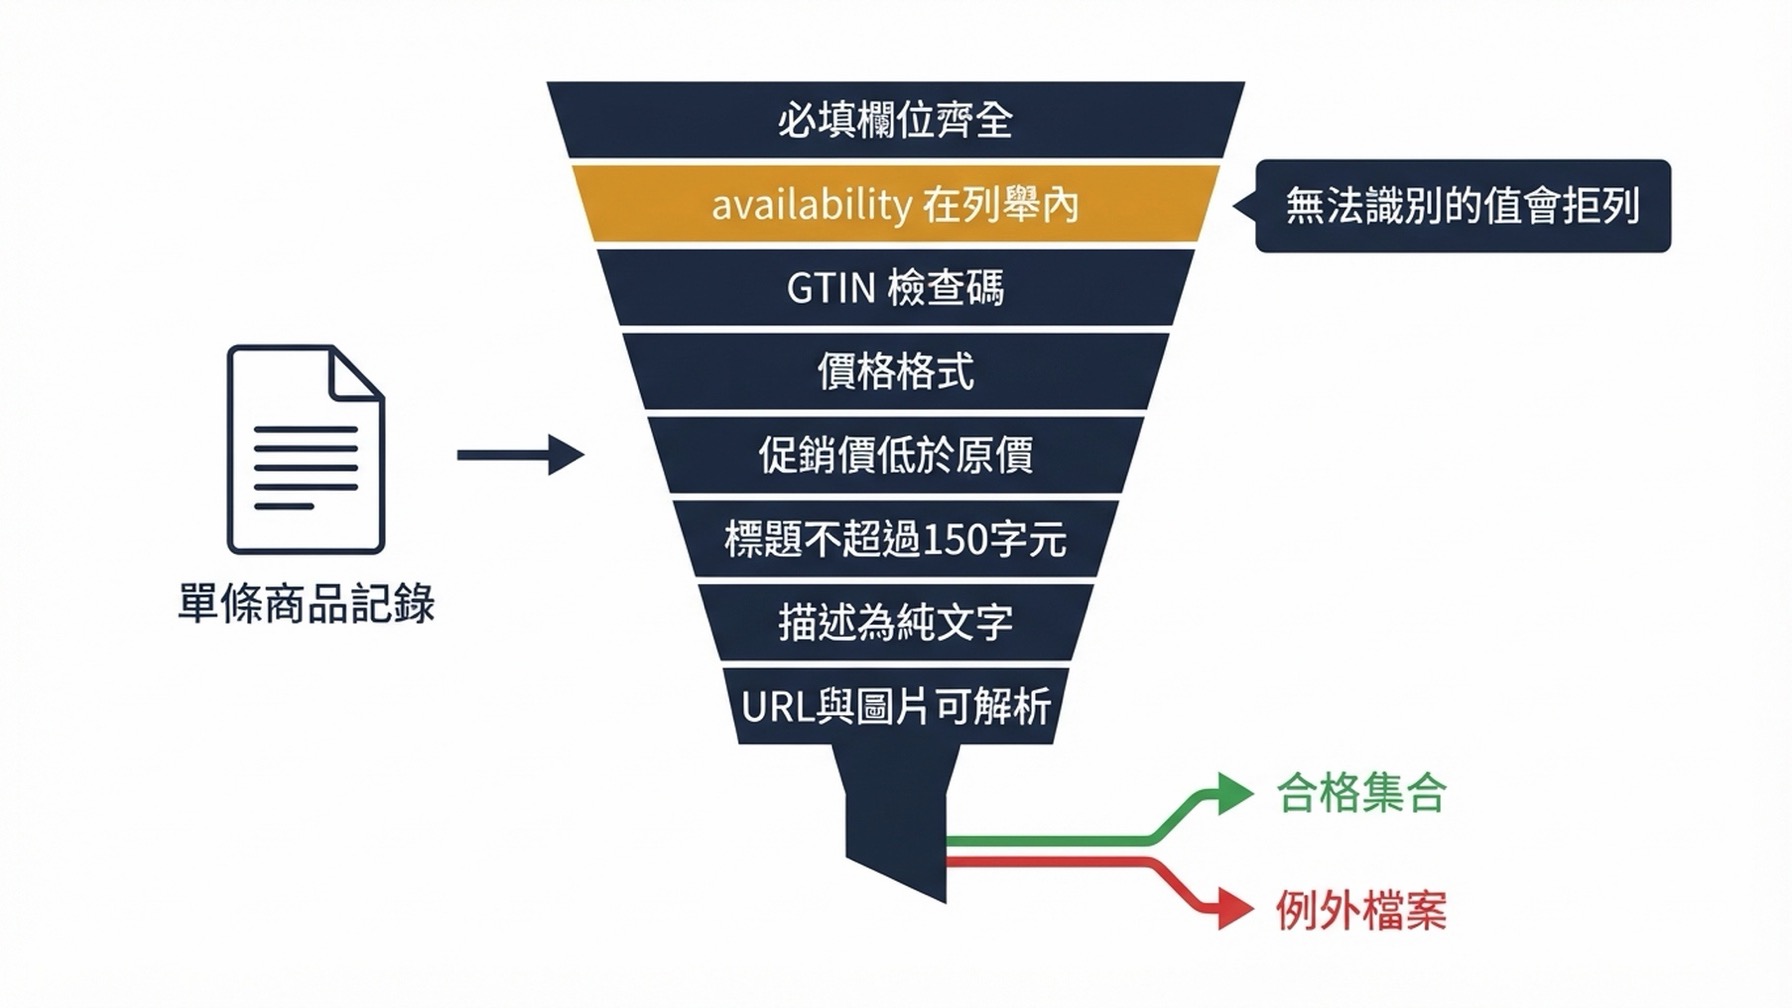
一列資料要麼穿過所有閘門,要麼帶著失敗的那道閘門名字落進例外檔案。拒列最多的是 availability 這道閘門,因為自創庫存詞彙是商品目錄失敗最常見的原因。
做一份例外檔案,而不是一份完美目錄
兩欄加一個負責人:item_id、卡點、以及誰來修。
品質檢查。 對於一個整理得還行的目錄,例外檔案應該不到總列數的 10%。超過 30%,問題就在上游的資料治理,誠實的做法是去修來源系統,而不是給檔案打補丁。
補救路徑。 如果某個必填欄位是整類商品缺失而不是零散 SKU 缺失,把它當作一個需要業務負責人參與的採購決策來處理。別為了讓稽核通過就把這些列改成 unknown。unknown 是一個有明確含義的合法取值,用它來通過檢查是在污染你自己的資料。
關於更新頻率,有一句誠實的補充。規格沒有說明更新節奏,也沒有說明 feed 是全量快照還是增量更新。公開的廠商說法對這兩點都言之鑿鑿,但那些內容不在 OpenAI 的文件裡。規格真正要求的是:提交目前價格,在促銷開始和結束時更新,在商品售罄或恢復時更新庫存狀態。把你的管道圍繞這兩類事件搭建,更新頻率的問題留到接入流程裡去確認。
用平台會用的方式驗證檔案
用你打算提交的那種格式,重新解析你打算提交的那份確切位元組,數一數進去多少列、出來多少列。
這一步能抓出試算表掩蓋掉的失敗。一個在 Excel 裡打開很漂亮的檔案,和一個能被當 CSV 解析的檔案不是一回事,因為未轉義的分隔符或描述欄位裡的換行,在螢幕上看著沒問題,卻會破壞解析。
品質檢查。 進出的列數相等,且自動檢查與人工稽核結果一致。兩者對不上就是有一方錯了,通常錯的是人工那方。
補救路徑。 編碼問題幾乎總能靠重新匯出為 UTF-8 解決。引號問題幾乎總是未轉義的分隔符,或描述裡的多餘換行。
如果團隊裡有編碼 agent,這裡是寫個小腳本最划算的地方,因為它能把稽核從季度專案變成一次重跑。
驗證它真的生效了
能證明什麼,取決你在哪條通道。這一點值得說準,不要含糊過去。
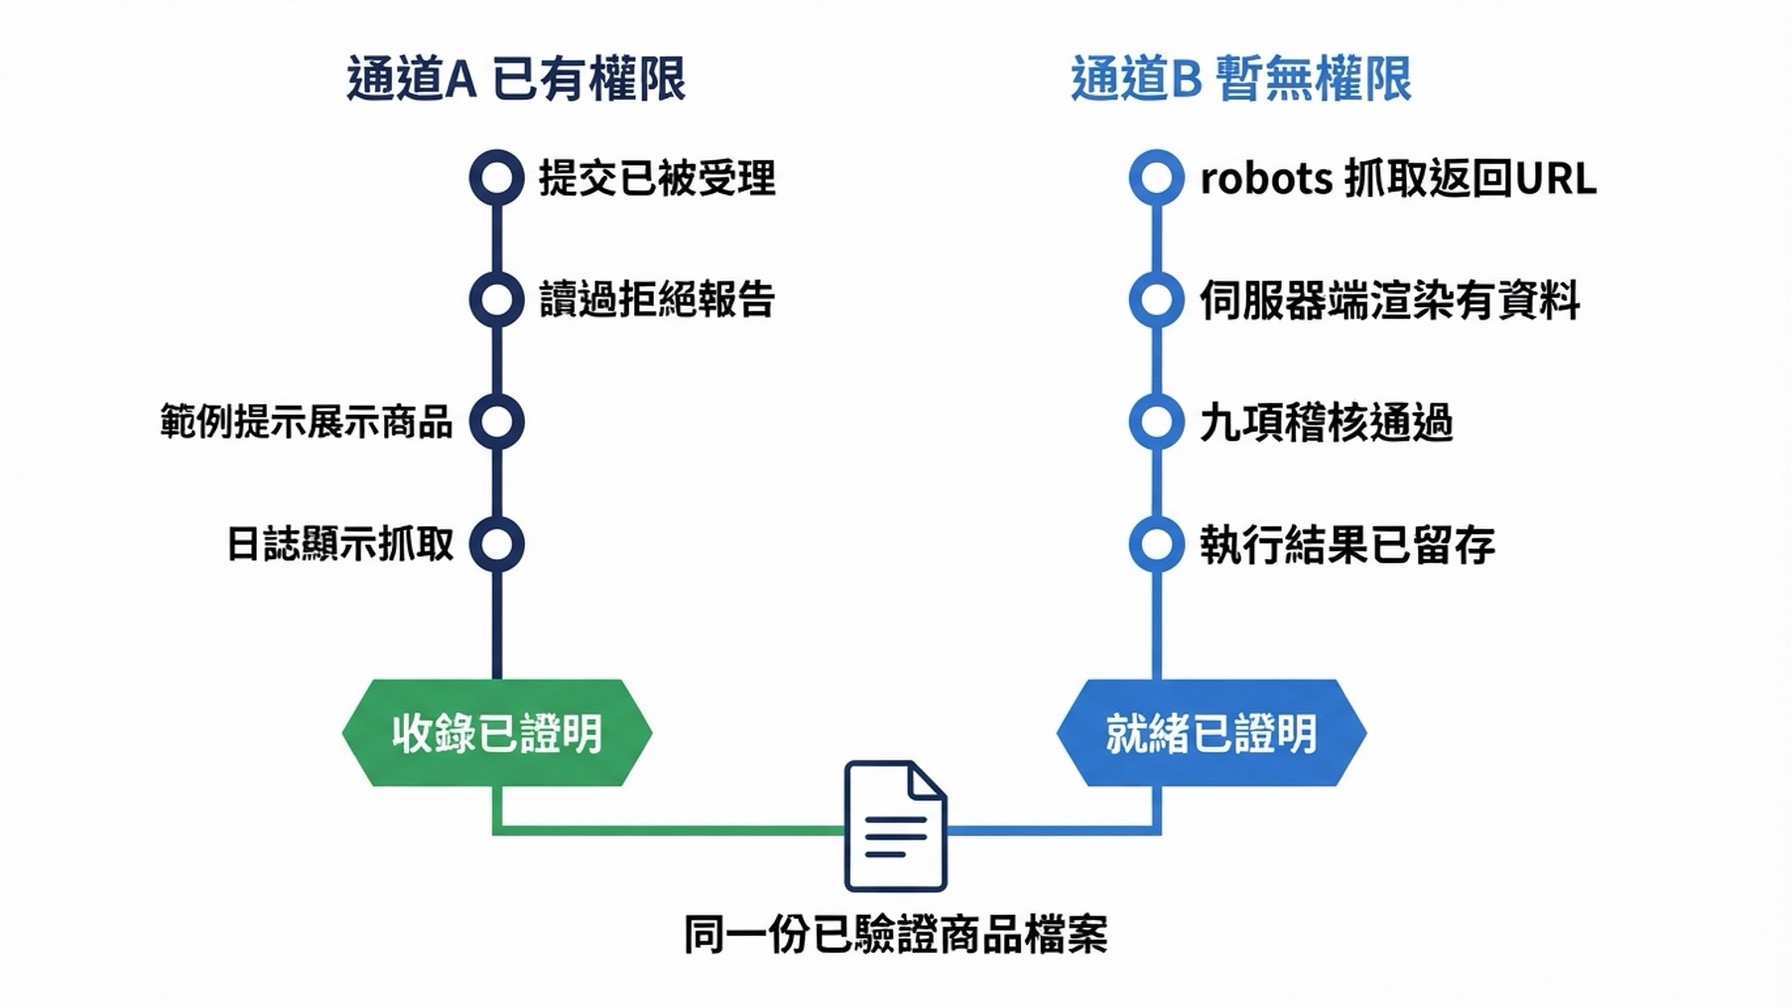
通道 A 能證明已被收錄。通道 B 能證明準備就緒。通道和分叉都不會改變檔案本身,這正是「在拿到接入之前先把檔案做好」的意義。
有接入時(通道 A)
四項檢查:提交已被受理;逐列拒絕報告讀過,每一條拒絕都已解決或已記錄;範例購物提示開始展示你的某個商品;伺服器日誌顯示有檢索 agent 抓取了你的商品 URL。
沒有接入時(通道 B)
四項檢查:robots.txt 抓取為 OAI-SearchBot 回傳了商品 URL;該 URL 的伺服器端渲染結果裡有標題、價格、庫存狀態和描述;九項稽核通過;凍結的匯出與檢查執行被保存在下一個人能重現的位置。
準備就緒是真實且可證偽的成果,但它和被收錄不是同一回事,也不該被當成同一回事來回報。
最後一個重要的數字
從 ChatGPT 跳出的外部連結會自動帶上 utm_source=chatgpt.com。也就是說,點擊確實發生過的第一方證據只存在於你自己的分析工具裡。趁現在還不需要,先把篩選器建好。
同時說清它到底在測什麼:它是基於點擊的流量歸因,不是可見性指標。一個商品可能被推薦很多次卻從未被點擊,而不具備資格的商品根本不會被點擊。
這套流程控制不了的東西
它控制不了 feed 集合內部的排序。 規格定義的是單列的契約,沒有定義排序規則。通過全部欄位檢查,意味著這個商品獲得了被檢索的資格,它對十列合格紀錄裡哪一列會展示隻字未提。開頭引用的那份研究測的是檢索來源,不是檢索集合內部的排名。
7 月 10 日那組數字是觀測值,且來自單一廠商。 它們描述的是 Profound 的追蹤提示面板,而不是真實的購物工作階段或購買路徑。OpenAI 沒有確認那次變化,也沒有揭露任何檢索佔比。2026 年 9 月 3 日開始的 GPT-6 Astra 鋪開,與那份研究較晚的測量視窗重疊,是一個實實在在的混淆變數。
集中度數字帶著同樣的局限。前十店鋪引用佔比從 22.5% 升到 41.8%、獨立商家數從 13,524 降到 10,607,都來自同一個面板。而「檢索來源變化解釋了 517 個變動客戶中 83% 的可見性波動」這個發現,是面板內部的解釋比例,不是一個可以拿來制定計畫的因果係數。
廠商部落格上流傳的部分說法不在規格裡。 下面每一條都請謹慎對待。
說法 | 來源 | 狀態 |
|---|---|---|
feed 每 15 分鐘更新,比每日 feed 頻繁 96 倍 | 廠商部落格 | 不在 OpenAI 規格裡,規格未說明更新節奏 |
feed 是全量快照而非增量更新 | 一家未引用 OpenAI 文件的廠商 | 未解決。留待接入時確認 |
需要大約 100 個商品的樣本 | 廠商部落格 | OpenAI 說明文件只提到「樣品或完整 feed 提交」,未涉及數量 |
透過 SFTP 提交 | 一家說 SFTP,另一家說加密 HTTPS 推送 | 來源互相矛盾。機制由接入流程確定 |
| 單一彙整來源 | 不在規格欄位清單裡。規格中的評價欄位是 |
結構化 feed 的轉換率約為抓取資料的兩倍 | 無出處的廠商說法 | 不要當作前提 |
它控制不了你的文案會被怎麼呈現。 ChatGPT 可能會生成簡化過的商品標題和描述。另外,購物結果由 ChatGPT 獨立挑選,不是廣告。這一點回答的是商業影響的問題,不是檢索來源的問題。如果你要的是付費曝光,OpenAI 另有一條基於商品 feed 建構的廣告路徑,那是另一套流程,不在本文範圍內。
常見問題
今天能向 ChatGPT 提交商品 feed 嗎?
不能自助提交。接入是按商家逐一確認的,結帳需要一個單獨啟用的接入,標準上傳目前面向美國。註冊只會給你商家顯示名稱,你可能處在「已註冊但沒有實際上傳權限」的狀態。跑一遍上面的四項接入判定,就知道自己在哪。
feed 應該多久更新一次?
規格沒有說明更新節奏。有兩家廠商部落格聲稱是 15 分鐘,但那個數字沒有出現在 OpenAI 的文件裡。務實的答案是:圍繞規格明確要求保持最新的兩件事來驅動更新,也就是價格和庫存狀態事件。
傳送整個檔案,還是只傳變更的列?
未解決。有一家廠商聲稱是全量快照,且沒有引用 OpenAI 文件作為依據。在搭建任何依賴某一答案的管道之前,先在接入流程裡確認。
100 個商品的樣本要求是真的嗎?
OpenAI 的說明文件在提到首次樣品或完整 feed 提交時沒有給出數量。100 這個數字來自廠商部落格。如果你要準備樣本,請涵蓋各類選填欄位組的代表性情形,而不是瞄準某個具體數目。
一份好的 feed 能提升我的商品在 ChatGPT 購物結果裡的排名嗎?
在這個問題通常暗示的意義上,不能。feed 讓商品變得有資格、可被描述。檢索集合內部的排序沒有公開文件,而現有公開研究測的是檢索來源,不是排名。把欄位合規當作前提條件,而不是槓桿。
我在 Shopify 上賣東西,這套流程還需要嗎?
基礎接入不需要。商品資料透過 Shopify Catalog 到達 ChatGPT,商家端不用額外工作。真正需要直接 feed 的是時效性,以及預設不會帶過去的那些欄位。
作者:Eva Laurent,Auspia 的電商搜尋策略師,負責過一萬多個商品頁面。她撰寫電商搜尋、商品探索,以及商品資料如何進入 AI 購物場景的內容。