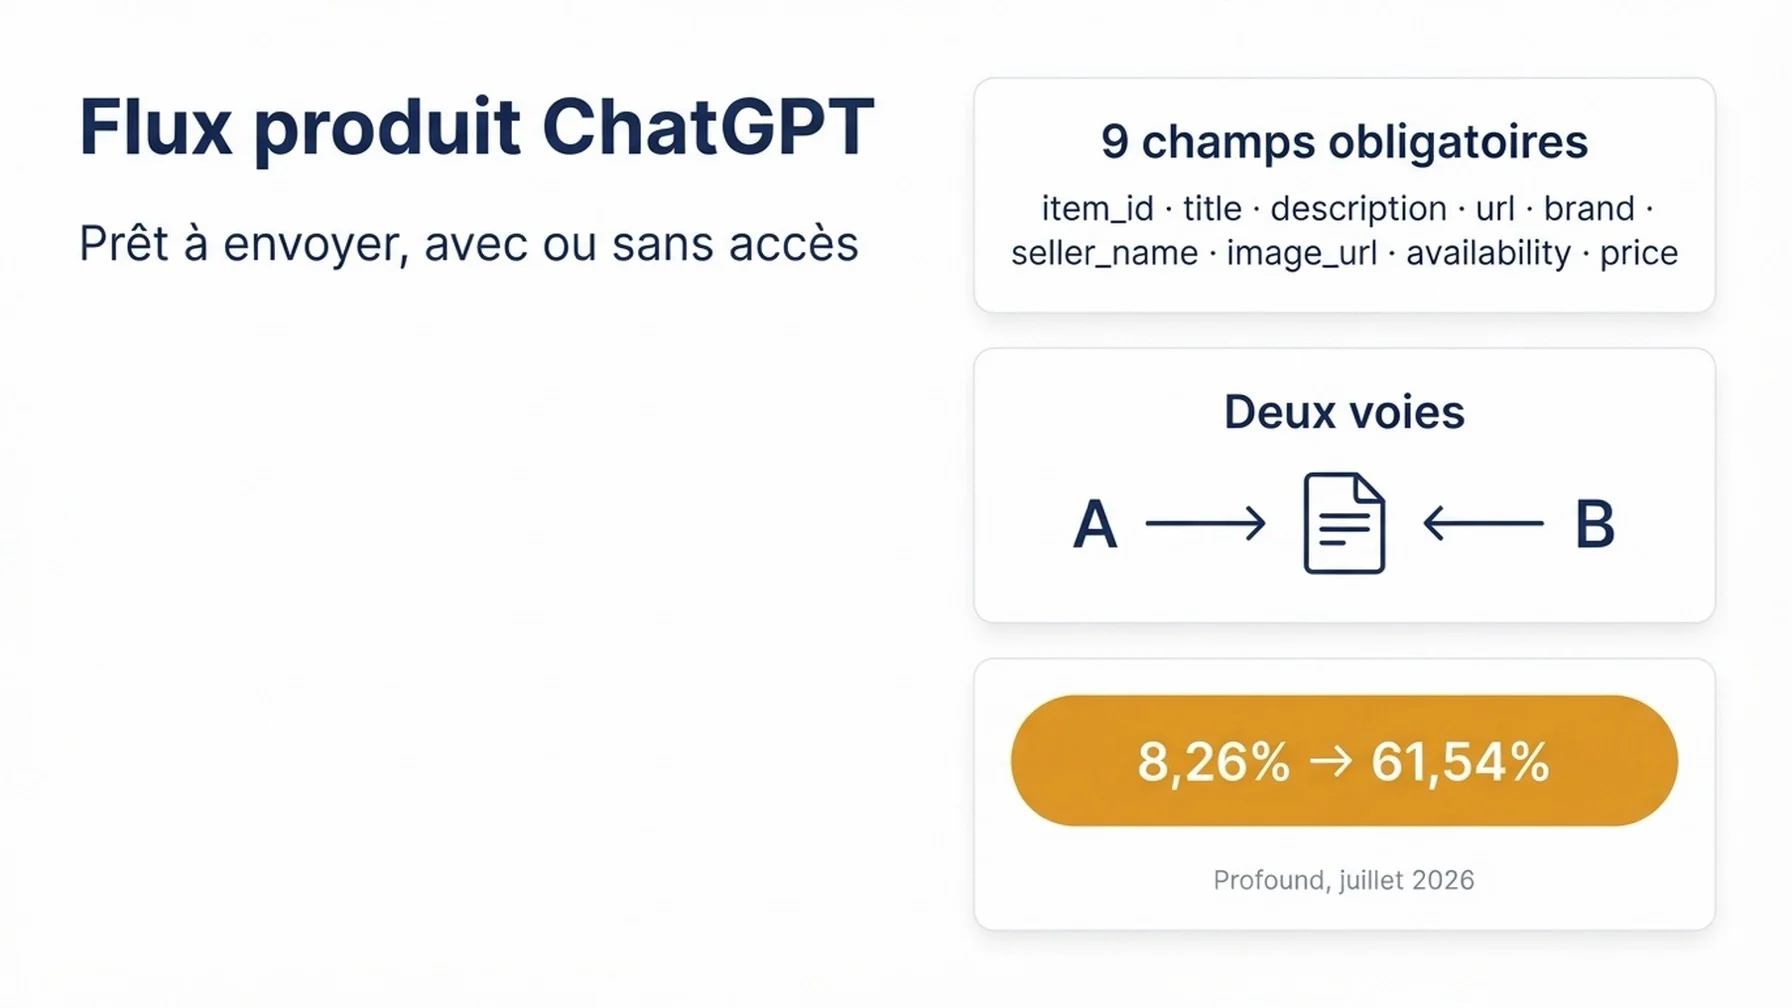
En juillet 2026, les recommandations d'achat de ChatGPT ont changé de source principale. Si les données de votre catalogue ne sont pas prêtes pour ce changement, aucune optimisation des pages produit ne compense ce retard. Ce guide opérationnel amène votre catalogue à un état validé et prêt à soumettre, et il fonctionne que vous puissiez ou non soumettre un flux dès aujourd'hui.
Pour qui | Responsables SEO e-commerce, gestionnaires de flux et responsables des opérations marchands en charge de données produit sur environ 500 à 100 000 SKU |
Le résultat | Un fichier produit validé qui passe les neuf contrôles de champs obligatoires, plus une liste d'exceptions des SKU bloqués avec des responsables nommés |
Prérequis | Pouvoir exporter votre catalogue en CSV, TSV ou JSONL ; un répertoire de préparation ; pouvoir modifier |
Hypothèse d'accès | Vous ne pouvez peut-être pas soumettre de flux aujourd'hui. Le programme de flux d'OpenAI est soumis à autorisation, le paiement est une intégration activée séparément, et l'envoi standard cible actuellement les États-Unis. Ce guide produit le fichier dans les deux cas |
Temps nécessaire | Quatre à six heures pour une première passe sur un catalogue de moins de 5 000 SKU. L'audit des champs est la partie longue, pas la configuration technique |
Définition de la réussite | Chaque ligne passe les neuf contrôles de champs obligatoires, chaque SKU écarté figure sur une liste d'exceptions nommée, le robot de recherche d'OpenAI peut récupérer une URL produit échantillonnée et y lire des données réelles, et l'exécution est reproductible à partir d'un export sauvegardé |
Ce qui a changé, et la décision unique que cela impose
OpenAI a publié ses modèles ChatGPT 5.6 le 9 juillet 2026. Le lendemain, la part des recommandations d'achat de ChatGPT provenant des flux produit des marchands plutôt que de la recherche web ouverte est passée de 8,26% à 61,54%, selon une étude publiée par Profound, qui a suivi 1 757 723 requêtes d'achat ChatGPT sur juillet 2026. En une journée, la récupération alimentée par flux est passée d'une source minoritaire à la source dominante.
Ce chiffre est une mesure tierce, pas une divulgation d'OpenAI. OpenAI n'a confirmé aucun changement le 10 juillet et n'a publié aucune répartition de récupération, et les sections en fin d'article détaillent ce que ces données étayent et ce qu'elles n'étayent pas. Prenez la tendance au sérieux et le chiffre précis avec prudence.
Ce que cette tendance impose, c'est un recadrage unique : les données produit doivent désormais être correctes en tant que données, pas seulement en tant que contenu. Une page produit magnifiquement écrite mais dotée d'une clé de contrôle GTIN manquante est, pour un moteur de recommandation basé sur les flux, une ligne qui échoue à la validation.
Tout ce qui suit est un guide opérationnel. Chaque étape vaut la peine d'être suivie, que les chiffres du 10 juillet se confirment ou non, car un catalogue propre, complet et lisible par une machine sert toute surface d'achat qui comptera pour vous à l'avenir.
Déterminez dans quelle voie vous vous trouvez
Ce guide se divise en deux voies, et vous devez savoir laquelle est la vôtre avant de commencer, car cela change ce que signifie « terminé » pour vous. La voie A peut prouver l'ingestion. La voie B ne peut prouver que la préparation. Les deux produisent le même fichier.
Le test d'accès en quatre points
Répondez honnêtement à chacune de ces questions.
Question | Ce qui compte comme un oui | Ce qui ne compte pas |
|---|---|---|
Vous êtes-vous enregistré auprès d'OpenAI et avez-vous reçu une confirmation écrite d'accès au flux ? | Une confirmation nommant votre flux | « J'ai rempli le formulaire d'intérêt » |
Votre catalogue est-il éligible au marché américain ? | Confirmé pour la portée actuelle de l'envoi standard | Une hypothèse selon laquelle cela s'applique à votre marché |
Une intégration de paiement a-t-elle été activée séparément pour vous ? | Confirmation explicite lors de l'intégration | Activer un indicateur vous-même |
Avez-vous soumis un fichier d'échantillon ou complet et reçu un accusé de réception ? | Une réponse faisant référence à votre soumission | L'envoyer sans obtenir de réponse |
Si l'une de ces réponses ne repose sur rien de concret, vous êtes en voie B. C'est la position par défaut, et ce n'est pas un échec. Deux précisions importantes : activer un indicateur d'éligibilité ne finalise pas l'intégration de paiement, et l'enregistrement ne fournit que le nom d'affichage de votre marchand, pas le reste de votre flux.
Voie A : vous avez confirmé l'accès au flux
Vous obtiendrez une liste de champs spécifique à votre enregistrement et un canal de soumission confirmé lors de l'intégration. Le mécanisme de soumission lui-même est confirmé durant l'intégration. Les comptes de fournisseurs publiés ne s'accordent pas sur le fait qu'il s'agisse de SFTP ou d'un envoi HTTPS chiffré vers un point de terminaison autorisé, donc ne construisez pas de pipeline sur l'une ou l'autre description avant qu'OpenAI ne vous indique laquelle s'applique à vous.
Voie B : vous ne l'avez pas, et voici ce qui n'est pas perdu
Trois choses vous sont ouvertes dès aujourd'hui sans aucune autorisation requise : l'accès du robot, la qualité des données structurées et des descriptions sur les pages produit elles-mêmes, et le fichier validé. Le travail sur le catalogue au cœur de cet article n'a aucun verrou. Vous construisez et validez le fichier maintenant, et le jour où l'accès arrive, vous soumettez quelque chose qui passe déjà les contrôles.
Si vous êtes sur Shopify, les données produit atteignent ChatGPT via Shopify Catalog sans travail supplémentaire côté marchand. Un flux direct sert la fraîcheur des données et les champs que le système par défaut ne transporte pas. Une réserve : une source secondaire date cette synchronisation à mars 2026, et cette date n'est pas confirmée, donc traitez-la comme un point de départ de conversation plutôt qu'un fait sur lequel planifier.
Ouvrez la porte au robot qui lit vos produits
C'est la première étape qui prend effet immédiatement dans les deux voies, et c'est le gain le moins coûteux à votre disposition.
Ouvrez votre robots.txt et vérifiez les directives concernant les agents d'OpenAI. OAI-SearchBot est celui qui compte pour la visibilité produit. S'il est bloqué, votre contenu n'apparaîtra pas dans les résultats produit de ChatGPT, quelle que soit la propreté de votre flux. Il n'est pas utilisé pour l'entraînement des modèles, donc le bloquer ne protège rien.
Les quatre noms d'agents qui méritent une décision explicite :
Agent | Ce qu'il fait | Impact sur la visibilité produit |
|---|---|---|
| Indexe le contenu pour les surfaces de recherche | Le bloquer masque vos produits quelle que soit la qualité du flux |
| Récupère les pages qu'un utilisateur demande explicitement | Le bloquer casse les lectures de page en direct |
| Robot d'entraînement | Sans lien avec la visibilité d'achat |
| Navigation agentique | Affecte les parcours de paiement pilotés par agent |
Le contrôle de qualité le plus important ici n'est pas `robots.txt`. C'est de savoir si un robot autorisé peut réellement lire quelque chose une fois arrivé. Récupérez une URL produit représentative avec l'agent utilisateur du robot et inspectez le corps de la réponse. Si vous obtenez une coquille d'application sans titre, prix, disponibilité ou description rendus côté serveur, le crawl réussit mais ne renvoie rien d'utile. De nombreuses vitrines ne rendent les données produit que côté client, et ces boutiques sont invisibles pour la découverte sans flux, quoi que dise leur fichier robots.
Vous pouvez exécuter ce contrôle avec le simulateur de robot de recherche OpenAI d'Auspia, qui récupère une page publique comme le robot d'OpenAI et vous montre ce qu'il peut lire.
Solution de repli. Si robots.txt est verrouillé par votre plateforme ou votre agence, enregistrez la demande de modification avec une date et continuez. Cette étape devient une preuve pour votre dossier voie B plutôt qu'un blocage.
Rendez vos pages produit lisibles par une machine
Le flux n'est pas la seule voie vers les recommandations d'achat, et pour les marchands en voie B, il n'est actuellement pas disponible du tout. Les données structurées sur la page, elles, le sont.
Ajoutez des données structurées Product en JSON-LD à chaque modèle de produit, et alimentez-les à partir de la même source que votre export de catalogue. Cette dernière précision est ce que les équipes négligent. Si votre schéma est maintenu à la main dans le thème et que votre flux provient du PIM, les deux se contrediront en un trimestre, et des signaux de prix et de disponibilité contradictoires sont pires qu'absents.
Incluez au minimum le nom, la description, l'image, le SKU, la marque, et un bloc offers portant le prix, la devise du prix et la disponibilité. Reflétez les valeurs que vous mettriez dans le flux. Là où votre catalogue dispose du GTIN, de l'état, du matériau, de la couleur, de la taille ou des dimensions, incluez-les aussi, car ce sont les attributs que les requêtes conversationnelles utilisent réellement.
Contrôle de qualité. Validez trois URL produit, une de chacune de vos catégories les plus différentes, en utilisant le même chemin de rendu qu'un robot voit plutôt que votre navigateur connecté.
Solution de repli. Si votre plateforme ne vous permet pas d'injecter du JSON-LD dans le modèle produit, placez-le dans l'en-tête via votre gestionnaire de balises et enregistrez-le comme dette technique. Cela fonctionne, c'est fragile, et quelqu'un devrait avoir la responsabilité de le retirer.
Réécrivez les descriptions pour les requêtes conversationnelles
C'est l'étape où la discipline SEO se retourne activement contre vous.
Les descriptions de catalogue sont généralement écrites pour la couverture de mots-clés et l'attrait visuel : une voix de marque, un titre bourré de mots-clés, une liste à puces d'arguments. Les requêtes d'achat conversationnelles ne ressemblent en rien à cela. Quelqu'un demande « un clavier mécanique silencieux pour un bureau ouvert à moins de 150 dollars » et les attributs qui répondent à la question sont le niveau de bruit, le type de commutateur et le format. Ces attributs doivent être présents et factuels pour être extractibles.
Rédigez les descriptions produit comme une spécification factuelle avec une courte ouverture humaine. Commencez par une phrase sur ce qu'est le produit et à qui il convient. Puis énoncez les attributs simplement, sans qualificatifs marketing. « Poids : 780 g » vaut mieux que « construction incroyablement légère ». Si vous faites une affirmation, rendez-la spécifique et vérifiable.
Une chose à savoir avant d'investir massivement ici : la documentation d'achat d'OpenAI note que ChatGPT peut générer des titres et descriptions de produit simplifiés. Votre texte est une entrée pour la recommandation, pas un résultat garanti. Rédigez des données source propres et factuelles, et acceptez que la surface puisse les paraphraser.
Contrôle de qualité. Sélectionnez vos dix produits les plus rentables et, pour chacun, listez les quatre attributs dont un acheteur aurait besoin pour décider. Si moins de trois apparaissent dans la description, la description ne fait pas son travail.
Solution de repli. Si vos descriptions proviennent d'un flux fournisseur que vous ne contrôlez pas, réécrivez à la main le décile supérieur par chiffre d'affaires et laissez la longue traîne suivre. Une couverture partielle vaut mieux qu'un projet à l'arrêt.
Rédigez le contrat de champs avant de toucher une ligne
Passons maintenant au flux lui-même. Avant d'exporter quoi que ce soit, écrivez une fois ce que signifie « correct ». Cela transforme l'audit en une passe mécanique plutôt qu'en débat.
Les neuf champs obligatoires et où chacun échoue
Chaque ligne a besoin de ces neuf champs. Ce tableau est le contrat.
Champ | Forme acceptée | Échec le plus courant | Conséquence |
|---|---|---|---|
| Chaîne unique stable par article ou variante | Réutilisée entre variantes, ou régénérée à chaque export | Lignes dupliquées et orphelines |
| Chaîne simple, viser 150 caractères ou moins | Troncature en plein mot, ou titre portant le prix | Ligne rejetée ou mal associée |
| Texte brut, jusqu'à 5 000 caractères | HTML ou markdown laissé par le CMS | Ligne rejetée |
| URL de la page produit | Paramètres de suivi, ou URL qui redirige | Ligne qui ne mène à rien |
| Chaîne du nom de marque | Manquante entièrement sur les SKU sans marque | Ligne rejetée |
| Chaîne du nom du marchand | Orthographes incohérentes dans le catalogue | Signal marchand faible |
| URL d'image directe | Un espace réservé, ou une URL nécessitant une session | Ligne sans visuel |
| Une valeur parmi | Une valeur personnalisée issue de votre vocabulaire de stock interne | Ligne rejetée |
|
| Séparateurs de milliers, ou nombre brut sans devise | Ligne rejetée |
Deux entrées méritent d'être soulignées car elles échouent silencieusement et emportent des lignes de produits entières avec elles.
Le champ availability accepte exactement cinq valeurs. Les valeurs omises, vides ou non reconnues rejettent la ligne. Si votre plateforme exporte IN STOCK ou available ou 1, chacune de ces lignes échoue. Faites correspondre votre vocabulaire interne aux cinq valeurs acceptées de manière explicite, et acheminez tout ce que vous ne pouvez pas faire correspondre vers une file manuelle plutôt que de le définir par défaut sur unknown. unknown est une valeur légale, mais c'est un état délibéré, pas un fourre-tout.
Le champ price est un montant, un espace, puis un code devise en majuscules. Cela signifie 79.99 USD, pas 79,99 €, pas 79,99 USD, et pas 7.999e1. Aucun séparateur de milliers, aucune notation exponentielle.
Les règles qui rejettent les lignes silencieusement
Quatre contraintes supplémentaires à inscrire dans vos contrôles de validation :
GTIN. Exactement 8, 12, 13 ou 14 chiffres incluant une clé de contrôle valide. L'ISBN-10 n'est pas accepté. Préservez les zéros de tête, ce qui signifie conserver la colonne en texte partout où elle circule. C'est le point de rupture silencieux le plus courant de toute la spécification, car les tableurs et les exports CSV suppriment les zéros de tête par défaut.
Prix promotionnel. Doit être supérieur à zéro et strictement inférieur au prix normal, dans la même devise. Un prix promotionnel égal au prix normal, ou une ligne promotionnelle où le prix normal a été laissé vide, échoue.
Longueur du titre. Viser 150 caractères ou moins. Quand vous tronquez, tronquez à une limite de mot.
Les champs de date ne programment rien. La spécification est explicite : les dates dans le contrat ne programment pas les changements de prix ou de disponibilité. Si vous voulez qu'une promotion démarre à minuit, votre pipeline doit envoyer la nouvelle valeur.
Décidez vos indicateurs d'éligibilité délibérément
Trois indicateurs contrôlent ce qui arrive à une ligne après sa validation.
Indicateur | Valeur par défaut si omis ou vide | Ce qu'il fait |
|---|---|---|
|
|
|
| Nécessite l'éligibilité de recherche |
|
| Désactivé | Contrôle le chemin de traitement publicitaire séparé |
Vous pouvez aussi les rencontrer sous les noms enable_search, enable_checkout, et is_eligible_ads. Ce sont des alias, donc ne traitez pas un modèle utilisant l'orthographe plus ancienne comme un champ différent.
Conseil pratique : synchronisez is_eligible_search avec le système qui sait déjà qu'un produit est discontinué ou masqué. Si vous gérez une liste « masquer du canal » séparée qui n'atteint jamais le flux, vous expédierez des annonces obsolètes dans les recommandations.
Quels groupes optionnels activer, et dans quel ordre
Il y a environ cinquante champs optionnels. Classés par rendement par heure de travail, et non par ordre de la spécification :
- Variantes (
group_id,listing_has_variations,variant_dict,offer_id,gtin,mpn). Priorité la plus élevée si vous vendez des vêtements, des chaussures, des articles pour la maison, ou tout ce qui a une taille ou une couleur. - Informations produit (
condition,product_category,material,color,size,gender,age_group, et les champs de dimensions et de poids). C'est ce qui fait fonctionner la correspondance conversationnelle. - Médias (
additional_image_urls). - Retours (
accepts_returns,return_deadline_in_days,return_policy). - Avis (
review_count,star_rating), plus les champs au niveau boutiquestore_review_countetstore_star_rating. - Logistique, marchand et zone géographique (
shipping_price,shipping,seller_url,target_countries,store_country). - Champs soumis à configuration.
marketplace_seller,size_system,accepts_exchanges,is_digital, la paire publicitaire (is_ads_eligible,ads_metadata), et la paire paiement (is_eligible_checkout,seller_privacy_policy,seller_tos) nécessitent tous une confirmation lors de l'intégration. Ils ne sont pas en libre-service. Laissez-les de côté lors de votre première passe.
Contrôle de qualité. Chacun des neuf champs obligatoires devrait correspondre à une colonne de catalogue qui contient des données réelles sur au moins 95% de vos SKU. Les champs sous ce seuil ne sont pas des tâches de correspondance, ce sont des décisions d'approvisionnement.
Solution de repli. Si un champ obligatoire n'a aucune source du tout, comme brand sur une gamme sans marque, arrêtez-vous et réglez la question d'approvisionnement avec un responsable métier avant de construire le fichier. Le travail de formatage ne peut pas réparer des données absentes.
Quel format de fichier vous êtes réellement autorisé à envoyer
Utilisez le format que confirme OpenAI pour votre flux enregistré lors de l'intégration. Au-delà, il existe une voie compatible Google qui accepte les fichiers .txt ou .tsv délimités par tabulations en UTF-8, ou .csv délimités par virgules, avec un support gzip pour .txt.gz, .txt.gzip, .tsv.gz, et .csv.gz.
JSON, les tableurs, XML, RSS et Atom ne sont pas pris en charge sur cette voie de compatibilité. Utilisez un seul format pour l'ensemble de l'envoi plutôt que de mélanger les formats ligne par ligne.
Normalisez les quatre champs qui cassent le plus de lignes
Extrayez un export figé
Exportez une fois, horodatez le fichier, et calculez un hash. Chaque étape suivante s'exécute sur ce fichier figé. La reproductibilité est ce qui rend l'audit défendable trois semaines plus tard, quand quelqu'un demande pourquoi un SKU manque.
Les quatre normalisations
Zéros de tête du GTIN. Exportez la colonne en texte, puis vérifiez que le nombre de chiffres est 8, 12, 13, ou 14, et vérifiez la clé de contrôle. C'est là que vivent la majorité des échecs silencieux.
Formatage du prix. Retirez les séparateurs de milliers, conservez le point décimal, supprimez toute notation exponentielle, et ajoutez le code devise comme jeton séparé. Passez le résultat dans une expression régulière qui n'accepte que ^\d+\.\d{2} [A-Z]{3}$ et mettez le reste en file d'attente.
Correspondance de disponibilité. Faites correspondre votre vocabulaire interne aux cinq valeurs acceptées de manière explicite. Comptez combien de lignes tombent dans chaque catégorie et combien passent en revue manuelle. Un nombre élevé de révisions manuelles signifie que votre vocabulaire de stock a besoin d'une table de correspondance, pas que votre flux est cassé.
Nettoyage du titre et de la description. Tronquez les titres à 150 caractères sur une limite de mot. Retirez le balisage des descriptions et limitez à 5 000 caractères de texte brut.
Contrôle de qualité. Réimportez le fichier normalisé dans un nouveau tableur et confirmez que la colonne GTIN affiche toujours les zéros de tête. Cela attrape le piège de l'export en nombre qui survit à tous les autres contrôles.
Solution de repli. Si votre plateforme de flux ou votre PIM effectue ces normalisations pour vous, validez sa sortie avec les mêmes contrôles plutôt que de faire confiance à son message de succès.
Auditez chaque ligne et tenez une liste d'exceptions
Exécutez maintenant les contrôles sur l'ensemble du fichier. C'est l'étape qui transforme un catalogue en plan de travail.
Les neuf mécaniques vérifiables sans validateur
Pour chaque ligne : les neuf champs obligatoires présents et non vides ; availability dans l'énumération à cinq valeurs ; nombre de chiffres et clé de contrôle du gtin valides ; price correspondant à la forme montant-et-devise ; sale_price strictement inférieur à price et supérieur à zéro, même devise ; title à 150 caractères ou moins ; description en texte brut à 5 000 caractères ou moins ; url retournant 200 et rendant les données produit côté serveur ; image_url résolvant vers une image réelle plutôt qu'un espace réservé.
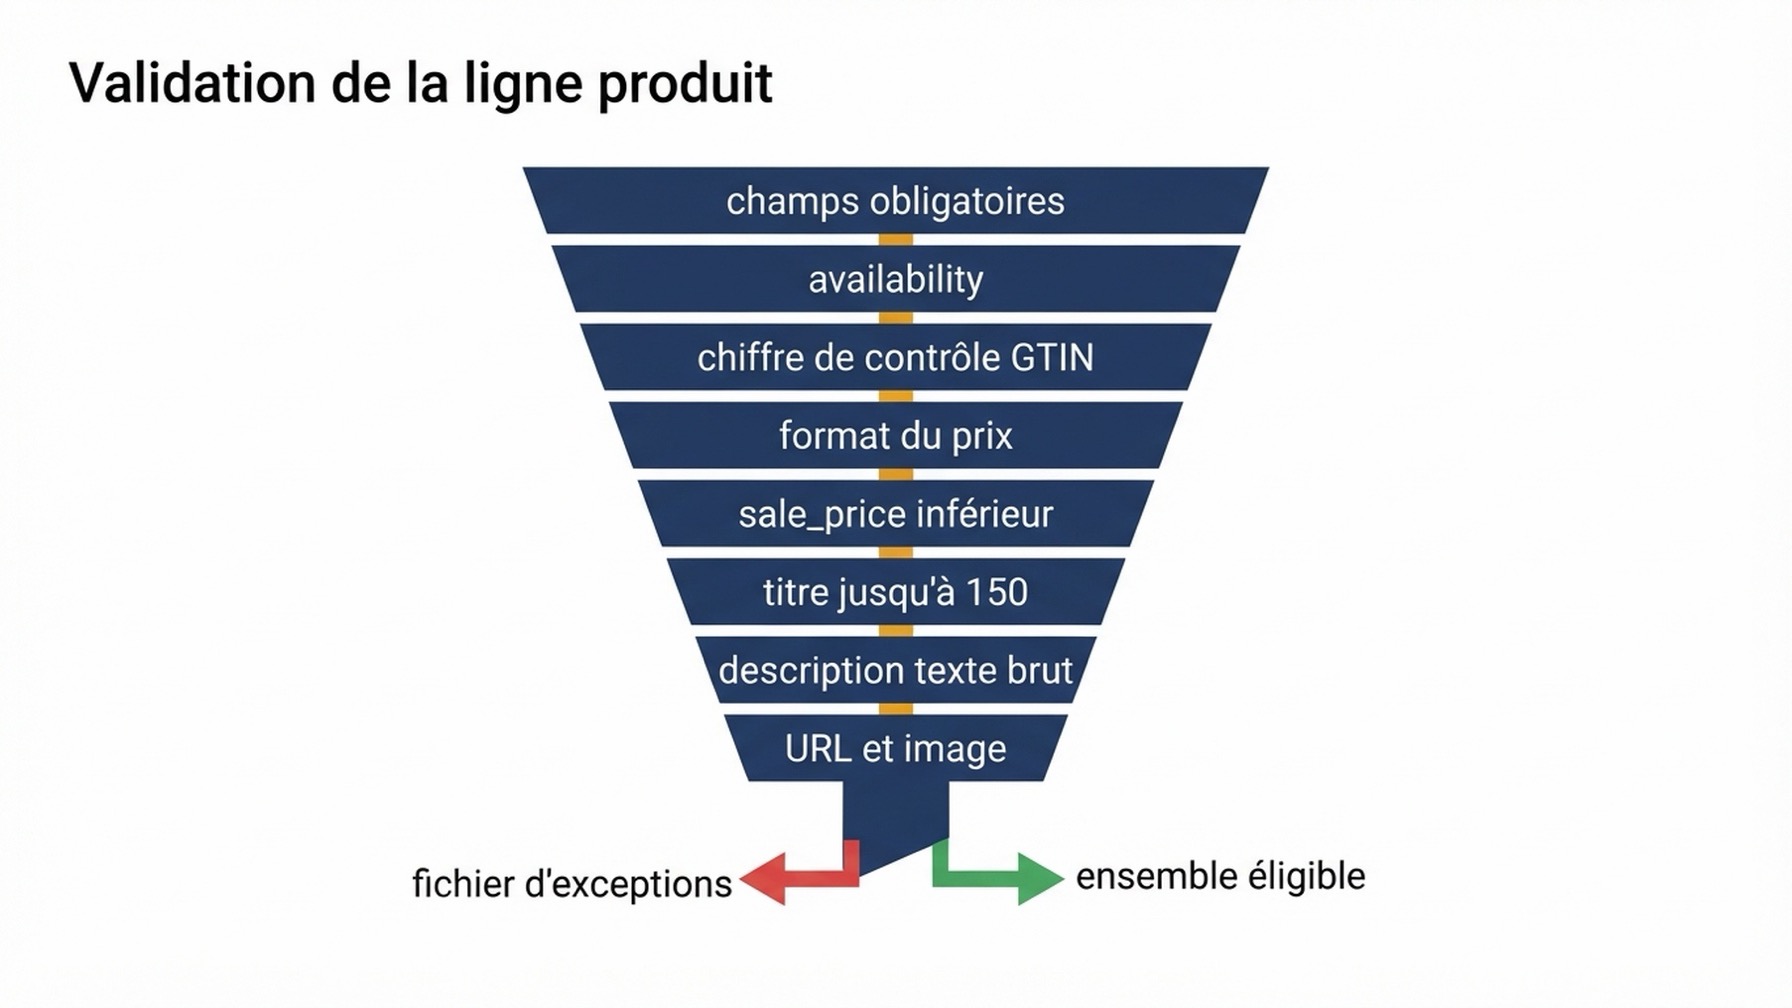
Une seule ligne franchit soit toutes les portes, soit atterrit dans le fichier d'exceptions avec la porte défaillante nommée. La porte de disponibilité rejette le plus de lignes, car un vocabulaire de stock personnalisé est la façon la plus courante dont un catalogue échoue.
Construisez le fichier d'exceptions, pas un catalogue parfait
Deux colonnes et un responsable : item_id, le blocage, et qui le corrige.
Contrôle de qualité. Sur un catalogue raisonnablement propre, le fichier d'exceptions devrait représenter moins de 10% des lignes. S'il dépasse 30%, le problème relève de la gouvernance des données en amont, et le mouvement honnête est de corriger le système source plutôt que de rafistoler le fichier.
Solution de repli. Si un champ obligatoire manque sur une catégorie entière plutôt que sur des SKU dispersés, traitez cela comme une décision d'approvisionnement avec un responsable métier. Ne marquez pas ces lignes unknown pour passer l'audit, car unknown est une valeur légitime qui signifie quelque chose de précis, et l'utiliser pour faire passer un contrôle pollue vos propres données.
Une note honnête sur l'actualisation : la spécification ne précise aucune cadence de mise à jour, et elle ne dit pas si les flux sont des instantanés complets ou des mises à jour incrémentales. Les comptes de fournisseurs publiés affirment les deux avec assurance sans que cela figure dans la documentation d'OpenAI. Ce que la spécification vous dit de faire, c'est de soumettre le prix actuel, de mettre à jour quand une promotion commence ou se termine, et de mettre à jour la disponibilité quand un article est épuisé ou revient. Construisez votre pipeline autour de ces deux événements et confirmez la question de la cadence lors de l'intégration.
Validez le fichier comme le fera la plateforme
Réanalysez les octets exacts que vous avez l'intention de soumettre, dans le format que vous avez l'intention de soumettre, et comptez les lignes entrantes par rapport aux lignes sortantes.
Cela attrape l'échec qu'un tableur masque. Un fichier qui s'ouvre proprement dans Excel n'est pas le même fichier qui s'analyse comme CSV, car des délimiteurs non échappés et des retours à la ligne à l'intérieur des champs de description cassent l'analyse tout en paraissant corrects à l'écran.
Contrôle de qualité. Les lignes entrantes égalent les lignes sortantes, et les contrôles automatisés s'accordent avec votre audit manuel. Un écart entre les deux signifie que l'un des deux a tort, et c'est généralement la passe manuelle.
Solution de repli. Les échecs d'encodage se résolvent presque toujours en réexportant en UTF-8. Les échecs de guillemets sont presque toujours des délimiteurs non échappés ou des retours à la ligne parasites dans les descriptions.
Si votre équipe dispose d'un agent de code, c'est le seul endroit où un petit script se justifie pleinement, car il transforme l'audit d'un projet trimestriel en une simple ré-exécution.
Vérifiez que ça a fonctionné
Ce que vous pouvez prouver dépend de votre voie, et il est utile d'être précis sur cette différence plutôt que de l'estomper.
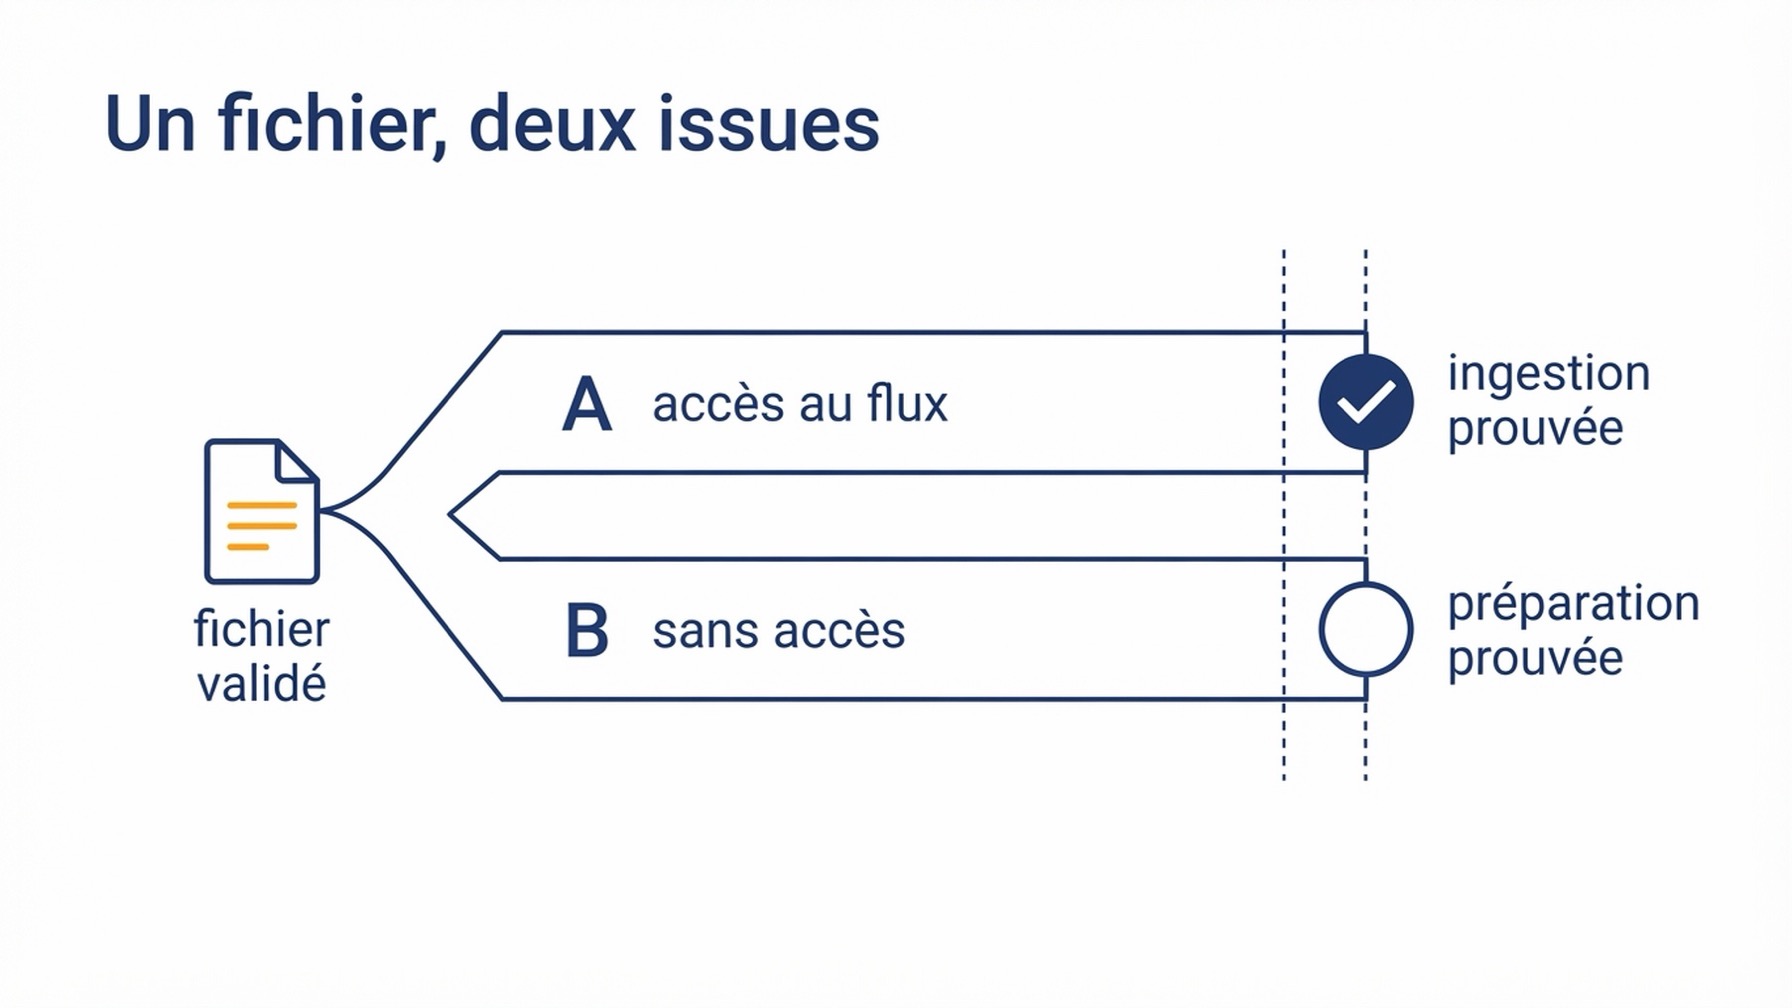
La voie A peut prouver l'ingestion. La voie B peut prouver la préparation. Ni la voie ni la branche ne changent le fichier, ce qui est tout l'intérêt de le construire avant d'avoir l'accès.
Si vous avez l'accès (voie A)
Quatre contrôles. Votre soumission a été accusée réception. Le rapport de rejet ligne par ligne a été lu et chaque rejet résolu ou consigné. Une requête d'achat échantillon fait maintenant apparaître un de vos produits. Vos journaux serveur montrent l'agent de récupération allant chercher des URL produit.
Si vous ne l'avez pas (voie B)
Quatre contrôles. Une récupération de robots.txt renvoie une URL produit à OAI-SearchBot. Une récupération rendue côté serveur de cette URL contient le titre, le prix, la disponibilité et la description. L'audit à neuf contrôles passe. L'export figé et l'exécution de contrôle sont stockés quelque part où la prochaine personne peut les reproduire.
La préparation est un résultat réel et falsifiable. Ce n'est simplement pas le même résultat que l'ingestion, et vous ne devriez pas le présenter comme tel.
Le seul chiffre qui compte à la fin
Les liens sortants de ChatGPT portent automatiquement utm_source=chatgpt.com. Cela fait de vos propres analyses la seule preuve de première partie qu'un clic a eu lieu. Configurez le filtre maintenant, avant d'avoir besoin des données.
Soyez clair sur ce qu'il mesure. C'est une attribution de trafic à partir d'un clic, pas une mesure de visibilité. Un produit peut être recommandé de nombreuses fois et n'être cliqué jamais, et un produit non éligible ne peut jamais être cliqué du tout.
Ce que ce guide opérationnel ne contrôle pas
Il ne contrôle pas le classement à l'intérieur de l'ensemble du flux. La spécification définit un contrat de ligne. Elle ne définit pas de règle d'ordonnancement. Passer tous les contrôles de champs rend un produit éligible à la récupération. Cela ne dit rien sur laquelle de dix lignes conformes est affichée. La recherche citée en haut mesure la source de récupération, pas le classement au sein d'un ensemble récupéré.
Les chiffres du 10 juillet sont observationnels et proviennent d'un seul fournisseur. Ils décrivent le panel de requêtes suivies de Profound, pas de véritables sessions d'achat ou de parcours d'achat. OpenAI n'a pas confirmé le changement et n'a divulgué aucune répartition de récupération. Un déploiement de GPT-6 Astra a commencé le 3 septembre 2026, ce qui recoupe la fenêtre de mesure ultérieure de cette recherche et constitue un facteur de confusion authentique.
Les chiffres de concentration portent les mêmes limites. La hausse des références aux boutiques du top 10 de 22,5% à 41,8% et le déclin des marchands uniques de 13 524 à 10 607 proviennent tous deux de ce même panel. Et le constat que les changements de source de récupération expliquent 83% de la variation de visibilité chez 517 clients en mouvement est une part explicative au sein du panel, pas un coefficient causal sur lequel planifier.
Certaines affirmations circulant dans les blogs de fournisseurs ne figurent pas dans la spécification. Traitez chacune avec prudence :
Affirmation | Source | Statut |
|---|---|---|
Les flux s'actualisent toutes les 15 minutes, 96 fois plus souvent que les flux quotidiens | Blogs de fournisseurs | Absent de la spécification d'OpenAI, qui ne précise aucune cadence |
Les flux sont des instantanés complets, pas des mises à jour incrémentales | Un fournisseur, sans citer de documentation OpenAI | Non résolu ; à confirmer lors de l'intégration |
Un échantillon d'environ 100 produits est requis | Blogs de fournisseurs | Le texte d'aide d'OpenAI mentionne un échantillon initial ou un flux complet sans quantité |
La soumission se fait par SFTP | Un fournisseur ; un autre dit envoi HTTPS chiffré | Sources contradictoires ; le mécanisme est confirmé lors de l'intégration |
| Une source agrégée | Absent de la liste de champs de la spécification. Les champs d'avis de la spécification sont |
Les flux structurés convertissent environ deux fois mieux que les données extraites | Affirmation de fournisseur non sourcée | Ne planifiez pas là-dessus |
Il ne contrôle pas la façon dont votre texte est rendu. ChatGPT peut générer des titres et descriptions de produit simplifiés. Et les résultats d'achat sont sélectionnés de façon indépendante par ChatGPT et ne sont pas des publicités, ce qui répond à une question sur l'influence commerciale plutôt que sur la source de récupération. Si le placement payant est ce que vous recherchez, OpenAI exploite bien un chemin publicitaire séparé construit à partir des flux produit. C'est un guide opérationnel différent, et cet article n'en traite pas.
FAQ
Puis-je soumettre un flux produit à ChatGPT aujourd'hui ?
Pas sur demande. L'accès est confirmé par marchand, le paiement nécessite une intégration activée séparément, et l'envoi standard cible actuellement les États-Unis. L'enregistrement fournit uniquement le nom d'affichage de votre marchand, et vous pouvez être enregistré sans avoir d'accès d'envoi actif. Effectuez le test d'accès en quatre points ci-dessus pour vous situer.
À quelle fréquence dois-je actualiser le flux ?
La spécification ne précise aucune cadence. Deux blogs de fournisseurs affirment quinze minutes, et ce chiffre n'apparaît pas dans la documentation d'OpenAI. La réponse pratique est de piloter les actualisations à partir de vos propres événements de prix et de disponibilité, car ce sont les deux choses que la spécification vous dit explicitement de tenir à jour.
Dois-je envoyer un fichier complet ou seulement les lignes modifiées ?
Non résolu. Un fournisseur affirme des instantanés complets sans citer de documentation OpenAI à ce sujet. Confirmez cela lors de l'intégration avant de construire un pipeline qui dépend de l'une ou l'autre réponse.
L'exigence d'échantillon de 100 produits est-elle réelle ?
Le texte d'aide d'OpenAI mentionne une soumission d'échantillon initial ou de flux complet sans quantité associée. Le chiffre de 100 produits provient de blogs de fournisseurs. Si vous préparez un échantillon, rendez-le représentatif en couvrant chaque cas de groupe optionnel plutôt qu'en visant un compte précis.
Un bon flux fera-t-il mieux classer mes produits dans les résultats d'achat de ChatGPT ?
Pas dans le sens où la question est généralement posée. Un flux rend un produit éligible et descriptible. Le classement au sein de l'ensemble récupéré n'est pas documenté, et la recherche publique mesure la source de récupération plutôt que l'ordonnancement. Considérez la conformité des champs comme un prérequis, pas un levier.
Ai-je besoin de tout cela si je vends sur Shopify ?
Pas pour la synchronisation de base, puisque les données produit atteignent ChatGPT via Shopify Catalog sans travail côté marchand. Un flux direct sert la fraîcheur des données et les champs que le système par défaut ne transporte pas.
Auteur : Eva Laurent, stratège de recherche e-commerce pour plus de 10 000 pages produit chez Auspia. Eva écrit sur la recherche e-commerce, la découverte produit, et comment les données produit atteignent les surfaces d'achat IA.