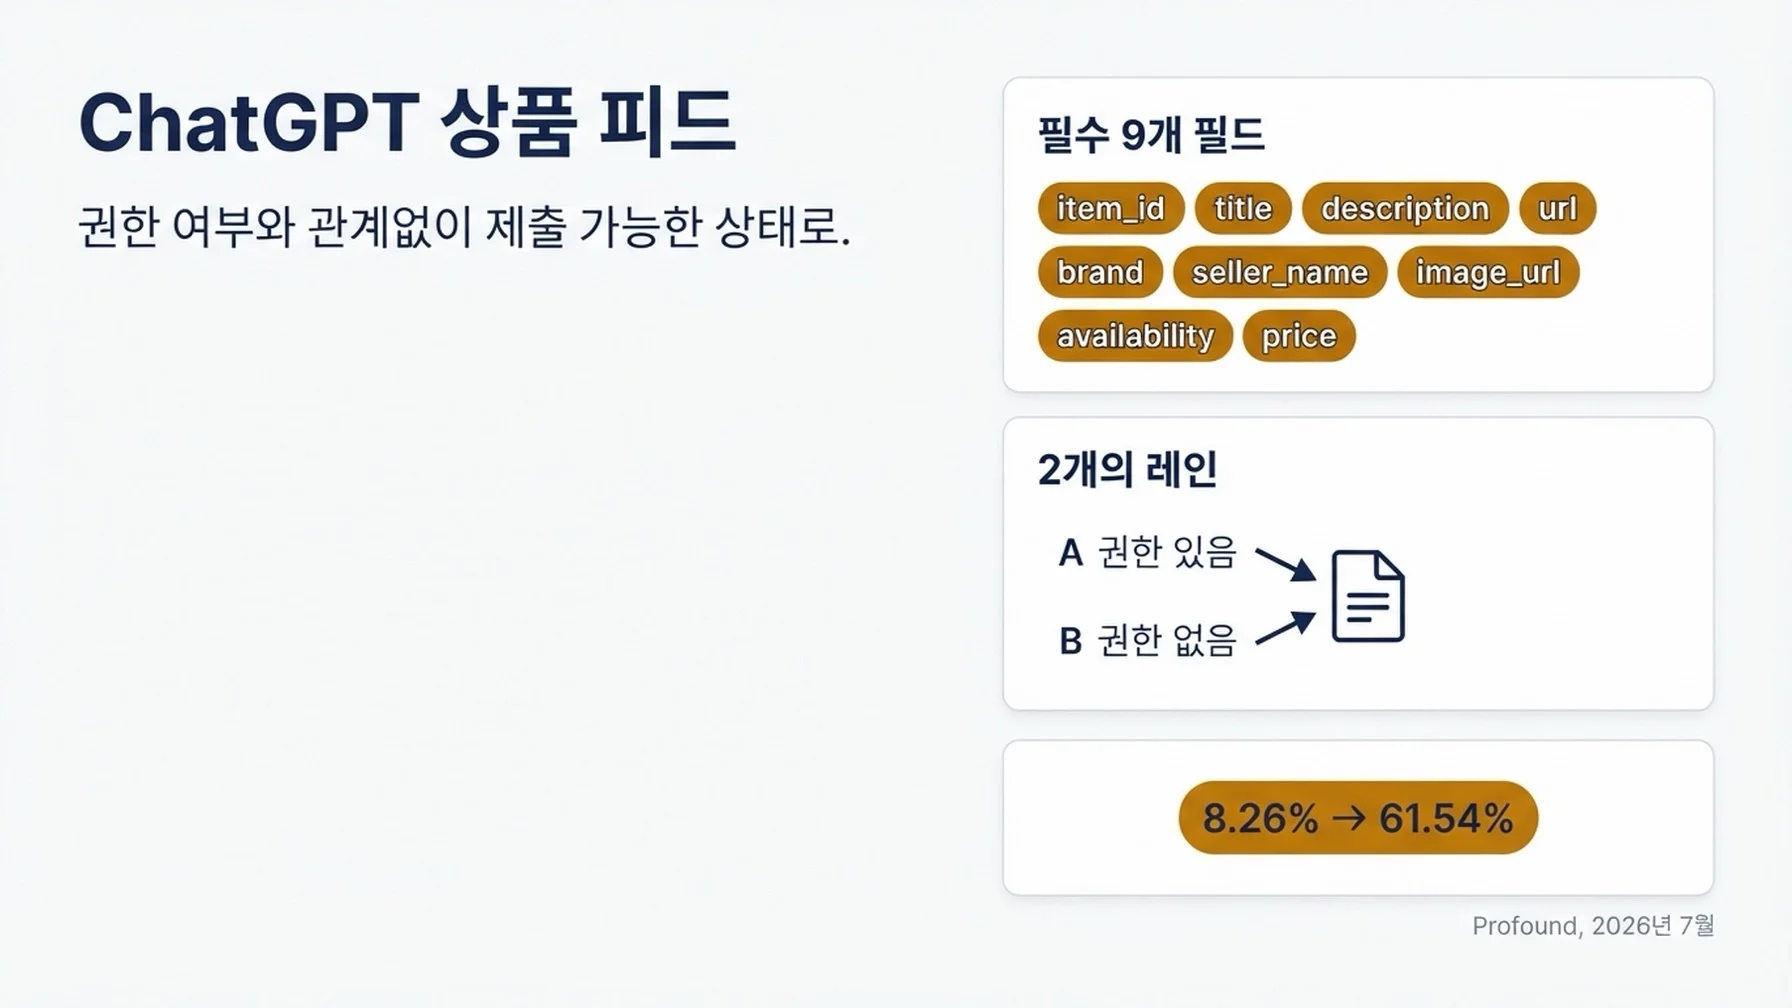
2026년 7월, ChatGPT의 쇼핑 추천은 정보 출처를 바꿨습니다. 카탈로그 데이터가 그 변화를 따라가지 못하면 상품 페이지 최적화를 아무리 쌓아도 메울 수 없습니다. 이 워크플로는 카탈로그를 검증된 제출 가능 상태까지 끌어올립니다. 오늘 피드를 제출할 수 있든 없든 작동합니다.
대상 독자 | 대략 500~100,000 SKU의 상품 데이터를 담당하는 이커머스 SEO 담당자, 피드 관리자, 머천트 운영 책임자 |
산출물 | 9개 필수 필드 검사를 모두 통과한 검증된 상품 파일과, 차단된 SKU를 담당자 이름과 함께 정리한 예외 목록 |
사전 준비 | 카탈로그를 CSV, TSV 또는 JSONL로 내보낼 수 있어야 합니다. 스테이징 디렉터리. |
접근 전제 | 오늘 피드를 제출하지 못할 수 있습니다. OpenAI의 피드 프로그램은 게이트가 걸려 있고, 결제는 별도로 활성화해야 하는 연동이며, 표준 업로드는 현재 미국 대상입니다. 그래도 이 워크플로는 파일을 완성합니다 |
소요 시간 | 5,000 SKU 미만 카탈로그 기준 첫 회 4~6시간. 시간이 걸리는 것은 기술 설정이 아니라 필드 감사입니다 |
완료 기준 | 모든 행이 9개 필수 필드 검사를 통과하고, 건너뛴 SKU는 모두 담당자 이름이 붙은 예외 목록에 올라가 있고, OpenAI의 검색 크롤러가 샘플 상품 URL을 가져와 실제 데이터를 읽을 수 있고, 그 실행이 저장된 내보내기에서 재현 가능 |
무엇이 바뀌었고, 그것이 강제하는 하나의 결정
OpenAI는 2026년 7월 9일에 ChatGPT 5.6 모델을 출시했습니다. 그다음 날, ChatGPT 쇼핑 추천 중 오픈 웹 검색이 아니라 머천트 상품 피드에서 가져오는 비중이 8.26%에서 61.54%로 뛰었습니다. Profound가 공개한 조사에 따른 수치이며, 이 회사는 2026년 7월 한 달간 ChatGPT 쇼핑 프롬프트 1,757,723건을 추적했습니다. 하루 만에 피드 기반 검색은 소수 출처에서 지배적 출처로 바뀌었습니다.
이 숫자는 제3자 측정이며 OpenAI의 공개가 아닙니다. OpenAI는 7월 10일의 변화를 확인하지 않았고 검색 비중도 공개한 적이 없습니다. 무엇이 데이터로 뒷받침되고 무엇이 아닌지는 이 글 후반부의 섹션에 정리했습니다. 방향은 진지하게 받아들이되 정밀도는 느슨하게 보세요.
이 방향이 강제하는 발상의 전환은 하나입니다. 상품 데이터는 이제 콘텐츠로서만이 아니라 데이터로서도 정확해야 합니다. 잘 쓴 상품 페이지라도 GTIN 체크 디지트가 없으면 피드 기반 추천 엔진에게는 검증에 실패한 한 행일 뿐입니다.
아래는 전부 워크플로입니다. 7월 10일의 숫자가 버티든 못 버티든 여기 있는 각 단계는 해둘 가치가 있습니다. 깨끗하고 완전하며 기계가 읽을 수 있는 카탈로그는 앞으로 관여할 모든 쇼핑 표면에서 쓸모가 있기 때문입니다.
자신이 어느 레인에 있는지 판별하기
이 워크플로는 두 개의 레인으로 갈립니다. "완료"의 의미가 레인마다 다르므로 시작 전에 자기 레인을 알아야 합니다. 레인 A는 수집을 증명할 수 있습니다. 레인 B가 증명할 수 있는 것은 준비 완료까지입니다. 둘 다 같은 파일을 만들어냅니다.
4개 항목 접근 판정
각 항목에 솔직하게 답하세요.
질문 | "예"로 인정되는 것 | 인정되지 않는 것 |
|---|---|---|
OpenAI에 등록하고 피드 접근에 대한 서면 확인을 받았습니까? | 내 피드를 지목한 확인 | "관심 있음 폼을 제출했다" |
내 카탈로그가 미국 시장 대상입니까? | 현재 표준 업로드 범위에서 대상이라는 확인 | 내 시장에도 해당될 것이라는 가정 |
결제 연동이 별도로 활성화되었습니까? | 온보딩 중 명시적 확인 | 직접 플래그를 켜는 것 |
샘플 또는 전체 파일을 제출하고 접수 응답을 받았습니까? | 내 제출물을 언급한 응답 | 보냈지만 아무것도 돌아오지 않음 |
하나라도 "가리킬 수 있는 것"으로 뒷받침되지 않으면 당신은 레인 B입니다. 이것이 기본 위치이며 실패 상태가 아닙니다. 중요한 보충이 둘 있습니다. 자격 플래그를 켜도 결제 온보딩은 끝나지 않고, 등록으로 얻는 것은 머천트 표시 이름뿐이며 피드의 나머지 부분은 얻지 못합니다.
레인 A: 피드 접근이 확인된 경우
등록 고유의 필드 목록과 온보딩에서 확인된 제출 채널을 받습니다. 제출 방식 자체는 온보딩에서 확정됩니다. SFTP인지, 허용 목록에 올린 엔드포인트로의 암호화 HTTPS 푸시인지, 공개된 벤더 설명들은 서로 일치하지 않습니다. OpenAI가 어느 쪽이 해당된다고 알려주기 전까지 어느 설명에 맞춰 파이프라인을 만들지 마세요.
레인 B: 아직 없는 경우, 그리고 헛되지 않은 것
오늘 허가 없이 열려 있는 것이 셋입니다. 크롤러 접근, 상품 페이지 자체의 구조화 데이터와 설명문 품질, 그리고 검증된 파일입니다. 이 글 중반의 카탈로그 작업에는 아무 게이트도 없습니다. 지금 파일을 만들어 검증해 두면 접근이 열리는 날 이미 통과하는 것을 제출합니다.
Shopify를 쓴다면 상품 데이터는 Shopify Catalog를 통해 머천트 측 추가 작업 없이 ChatGPT에 도달합니다. 직접 피드가 필요한 것은 최신성과, 기본적으로 실리지 않는 필드 때문입니다. 주의할 점이 하나 있습니다. 한 2차 출처는 이 연동을 2026년 3월로 표기하지만 그 날짜는 확인되지 않았으므로 계획의 전제가 아니라 대화의 소재로 다루세요.
상품을 읽는 크롤러를 위해 문을 열기
양쪽 레인 모두에서 즉시 효과가 나는 첫 단계이며, 가장 싸게 얻는 성과입니다.
robots.txt를 열고 OpenAI 에이전트에 대한 지시문을 확인하세요. 상품 가시성에서 중요한 것은 OAI-SearchBot입니다. 이게 차단되면 피드가 아무리 깨끗해도 ChatGPT 상품 결과에 콘텐츠가 나타나지 않습니다. 모델 학습에는 쓰이지 않으므로 차단해도 지켜지는 것이 없습니다.
명시적으로 판단해야 할 에이전트 이름은 넷입니다.
에이전트 | 역할 | 상품 가시성 영향 |
|---|---|---|
| 검색 표면을 위해 콘텐츠를 색인 | 차단하면 피드 품질과 무관하게 상품이 가려짐 |
| 사용자가 명시적으로 요청한 페이지를 가져옴 | 차단하면 실시간 페이지 읽기가 깨짐 |
| 학습용 크롤러 | 쇼핑 가시성과 무관 |
| 에이전트형 브라우징 | 에이전트 경유 결제 경로에 영향 |
여기서 가장 중요한 품질 검사는 `robots.txt`가 아닙니다. 허용된 크롤러가 실제로 도착해 무언가를 읽을 수 있는지입니다. 크롤러 사용자 에이전트로 대표 상품 URL을 가져오고 응답 본문을 검사하세요. 서버 렌더링된 제목, 가격, 재고 상태, 설명이 없는 앱 셸만 돌아온다면 크롤링은 성공했지만 유용한 것을 하나도 돌려주지 않은 것입니다. 많은 스토어프론트가 상품 데이터를 클라이언트에서만 렌더링하며, 그런 상점은 로봇 파일에 무엇이 적혀 있든 피드 없는 발견 경로에서는 보이지 않습니다.
이 검사는 Auspia의 OpenAI search crawler simulator로 실행할 수 있습니다. OpenAI 크롤러로서 공개 페이지를 가져와 무엇을 읽을 수 있는지 보여줍니다.
복구 절차. robots.txt가 플랫폼이나 대행사에 잠겨 있다면 변경 요청을 날짜와 함께 기록하고 넘어가세요. 이 단계는 차단 요소가 아니라 레인 B 기록을 위한 증거가 됩니다.
상품 페이지를 기계가 읽을 수 있게 만들기
피드는 쇼핑 추천으로 가는 유일한 경로가 아니며, 레인 B 머천트에게는 현재 아예 쓸 수 없습니다. 페이지 위의 구조화 데이터는 쓸 수 있습니다.
모든 상품 템플릿에 JSON-LD로 Product 구조화 데이터를 추가하고, 그것을 카탈로그 내보내기와 같은 원천에서 생성하세요. 뒤쪽 조건을 팀이 놓칩니다. 스키마가 테마 안에서 손으로 유지되고 피드는 PIM에서 오면 둘은 분기 안에 어긋나며, 가격과 재고 상태 신호가 서로 어긋나는 것은 아예 없는 것보다 나쁩니다.
최소한 name, description, image, SKU, brand, 그리고 price, price currency, availability를 가진 offers 블록을 포함하세요. 피드에 넣는 것과 같은 값을 반영합니다. 카탈로그에 GTIN, condition, material, color, size, dimensions가 있으면 그것도 포함하세요. 대화형 쿼리가 실제로 쓰는 속성이기 때문입니다.
품질 검사. 성격이 가장 다른 카테고리에서 각각 하나씩 상품 URL 세 개를 골라, 로그인한 브라우저가 아니라 크롤러가 보는 것과 같은 렌더링 경로로 검증하세요.
복구 절차. 플랫폼이 상품 템플릿에 JSON-LD 주입을 허용하지 않으면 태그 매니저로 head에 넣고 기술 부채로 기록하세요. 작동은 하지만 깨지기 쉬우며, 누군가 제거 책임을 맡아야 합니다.
대화형 쿼리를 위해 설명문을 다시 쓰기
SEO 규율이 오히려 해를 끼치는 단계입니다.
카탈로그 설명문은 보통 키워드 커버리지와 진열대에서의 설득을 위해 쓰입니다. 브랜드 서사, 키워드를 채운 제목, 장점 불릿. 대화형 쇼핑 쿼리는 그것과 전혀 닮지 않았습니다. 누군가 "오픈 플랜 사무실용 150달러 이하 조용한 기계식 키보드"를 묻고, 그 질문에 답하는 속성은 소음 수준, 스위치 종류, 폼팩터입니다. 그 속성들은 추출되려면 존재해야 하고 사실이어야 합니다.
상품 설명은 짧은 사람용 도입부를 곁들인 사실 명세로 쓰세요. 그 상품이 무엇이고 누구에게 맞는지 한 문장으로 말합니다. 그다음 속성을 마케팅 수식어 없이 간결하게 제시합니다. "무게: 780 g"이 "놀랍도록 가벼운 디자인"을 이깁니다. 주장을 하려면 구체적이고 검증 가능하게 하세요.
여기에 크게 투자하기 전에 하나 알아두세요. OpenAI의 쇼핑 문서는 ChatGPT가 상품 제목과 설명을 단순화해 생성할 수 있다고 밝힙니다. 당신의 카피는 추천에 들어가는 입력이며 보장된 출력이 아닙니다. 깨끗하고 사실에 기반한 원본 데이터를 쓰고, 표면이 그것을 바꿔 말할 수 있음을 받아들이세요.
품질 검사. 매출 상위 10개 상품을 골라 각각에 대해 구매자가 판단에 필요로 하는 속성 네 개를 적으세요. 설명문에 셋 미만만 나타나면 그 설명문은 역할을 하지 못하고 있는 것입니다.
복구 절차. 설명문이 직접 통제할 수 없는 공급업체 피드에서 온다면 매출 상위 10%를 손으로 다시 쓰고 롱테일에 뒤따라오게 하세요. 부분적 커버리지가 멈춰버린 프로젝트보다 낫습니다.
한 행을 건드리기 전에 필드 계약서 쓰기
여기서부터 피드 본체입니다. 무엇이든 내보내기 전에 "올바름"이 무엇인지 딱 한 번 적어 두세요. 그러면 감사가 논쟁이 아니라 기계적 처리로 바뀝니다.
9개 필수 필드와 각각이 깨지는 지점
모든 행에 이 아홉 개가 필요합니다. 이 표가 계약서입니다.
필드 | 허용 형식 | 가장 흔한 실패 | 결과 |
|---|---|---|---|
| 상품 또는 변형별로 안정적이고 고유한 문자열 | 변형 간 재사용하거나 내보낼 때마다 재생성 | 중복 행과 고아 행 |
| 일반 문자열, 150자 이하 권장 | 단어 중간에서 잘림, 또는 가격을 포함한 제목 | 행 거부 또는 오매칭 |
| 일반 텍스트, 최대 5,000자 | CMS에서 남은 HTML이나 markdown | 행 거부 |
| 상품 페이지 URL | 추적 파라미터, 또는 리디렉션되는 URL | 행이 아무것도 해결하지 못함 |
| 브랜드 이름 문자열 | 무브랜드 SKU에서 완전 누락 | 행 거부 |
| 머천트 이름 문자열 | 카탈로그 전체에서 표기 흔들림 | 머천트 신호 약화 |
| 이미지로 가는 직접 URL | 플레이스홀더, 또는 세션을 요구하는 URL | 비주얼 없는 행 |
|
| 사내 재고 용어에서 온 임의 값 | 행 거부 |
|
| 자릿수 구분 기호, 또는 통화 없는 맨 숫자 | 행 거부 |
두 항목은 조용히 실패하면서 상품 라인 전체를 끌고 가므로 강조할 가치가 있습니다.
availability 필드가 받는 값은 정확히 다섯입니다. 생략, 공백, 또는 인식되지 않는 값은 행을 거부합니다. 플랫폼이 IN STOCK, available, 1을 내보낸다면 그 행은 전부 실패합니다. 사내 용어를 다섯 개 허용 값에 명시적으로 매핑하고, 매핑할 수 없는 것은 unknown으로 기본 처리하지 말고 수동 큐로 보내세요. unknown은 합법적인 값이지만 의도된 상태이며 무엇이든 들어가는 쓰레기통이 아닙니다.
price 필드는 금액, 공백, 그리고 대문자 통화 코드입니다. 즉 79.99 USD이며 $79.99도, 79,99 USD도, 7.999e1도 아닙니다. 자릿수 구분 기호도 지수 표기도 없습니다.
조용히 행을 거부하는 규칙
검증 검사에 적어 넣을 가치가 있는 제약이 넷 더 있습니다.
GTIN. 유효한 체크 디지트를 포함해 정확히 8, 12, 13 또는 14자리. ISBN-10은 허용되지 않습니다. 앞자리 0을 유지하세요. 즉 그것이 통과하는 모든 지점에서 열을 텍스트로 유지한다는 뜻입니다. 이것이 명세 전체에서 가장 흔한 조용한 파괴 요인입니다. 스프레드시트와 CSV 내보내기가 기본적으로 앞자리 0을 떨어뜨리기 때문입니다.
세일 가격. 0보다 크고 같은 통화로 정가보다 엄격히 작아야 합니다. 세일 가격이 정가와 같거나 정가를 비워 둔 프로모션 행은 실패합니다.
제목 길이. 150자 이하 권장. 자를 때는 단어 경계에서 자르세요.
날짜 필드는 아무것도 예약하지 않습니다. 명세는 계약 안의 날짜가 가격이나 재고 상태 변경을 예약하지 않는다고 명시합니다. 자정에 프로모션을 바꾸고 싶다면 파이프라인이 새 값을 밀어 넣어야 합니다.
자격 플래그를 의도적으로 결정하기
세 개의 플래그가 행이 검증을 통과한 뒤 무슨 일이 일어나는지를 통제합니다.
플래그 | 생략 또는 공백일 때 기본값 | 역할 |
|---|---|---|
|
|
|
| 검색 자격이 필요 |
|
| 비활성 | 별도의 광고 처리 경로를 통제 |
enable_search, enable_checkout, is_eligible_ads로 나타날 수도 있습니다. 별칭이므로 예전 철자를 쓰는 템플릿을 다른 필드로 취급하지 마세요.
실무 조언입니다. is_eligible_search는 상품이 단종되었거나 숨겨졌다고 이미 아는 시스템과 동기화하세요. 별도의 "채널에서 숨기기" 목록을 운영하면서 그것이 피드에 도달하지 않으면, 오래된 등록 정보를 추천으로 밀어 넣게 됩니다.
어떤 선택 그룹을 어떤 순서로 켤지
선택 필드는 대략 50개입니다. 명세 순서가 아니라 작업 1시간당 회수 순으로 정렬합니다.
- 변형(
group_id,listing_has_variations,variant_dict,offer_id,gtin,mpn). 의류, 신발, 홈, 사이즈나 색상이 있는 것을 판다면 최우선입니다. - 상품 정보(
condition,product_category,material,color,size,gender,age_group, 그리고 치수와 무게 필드). 이것이 대화형 매칭을 작동시킵니다. - 미디어(
additional_image_urls). - 반품(
accepts_returns,return_deadline_in_days,return_policy). - 리뷰(
review_count,star_rating), 그리고 스토어 수준의store_review_count와store_star_rating. - 이행, 머천트, 지역(
shipping_price,shipping,seller_url,target_countries,store_country). - 설정 시 한정되는 필드.
marketplace_seller,size_system,accepts_exchanges,is_digital, 광고 쌍(is_ads_eligible,ads_metadata), 결제 쌍(is_eligible_checkout,seller_privacy_policy,seller_tos)은 모두 온보딩 확인이 필요합니다. 셀프서비스가 아닙니다. 첫 회차에서는 빼 두세요.
품질 검사. 9개 필수 필드 모두가 SKU의 최소 95%에서 실제 데이터로 해석되는 카탈로그 열에 매핑되어야 합니다. 그 임계값 아래의 필드는 매핑 작업이 아니라 조달 결정입니다.
복구 절차. 필수 필드에 원천이 아예 없다면, 예컨대 무브랜드 라인업의 brand라면 멈추고 파일을 만들기 전에 비즈니스 오너와 조달 질문을 정리하세요. 형식 작업으로는 존재하지 않는 데이터를 고칠 수 없습니다.
실제로 보내도 되는 파일 형식
온보딩에서 등록된 피드에 대해 OpenAI가 확인한 형식을 쓰세요. 그와 별개로 UTF-8 탭 구분 .txt 또는 .tsv, 또는 쉼표 구분 .csv를 받아들이고 .txt.gz, .txt.gzip, .tsv.gz, .csv.gz의 gzip을 지원하는 Google 호환 경로가 있습니다.
JSON, 스프레드시트, XML, RSS, Atom은 그 호환 경로에서 지원되지 않습니다. 행마다 형식을 섞지 말고 업로드 전체에서 하나의 형식을 쓰세요.
가장 많은 행을 깨뜨리는 네 개 필드를 정규화하기
고정된 내보내기 하나를 떠놓기
딱 한 번 내보내고 파일에 타임스탬프를 붙이고 해시를 계산하세요. 이후 모든 단계는 그 고정 파일에 대해 실행합니다. 재현 가능성이 있어야 3주 뒤에 누군가 "이 SKU가 왜 빠졌나"라고 물었을 때 감사가 변명 가능해집니다.
네 가지 정규화
GTIN 앞자리 0. 열을 텍스트로 내보내고, 자릿수가 8, 12, 13, 14 중 하나인지와 체크 디지트를 검증하세요. 조용한 실패의 대부분이 여기 있습니다.
가격 형식. 자릿수 구분 기호를 떼고 소수점은 남기고 지수 표기를 없앤 뒤 통화 코드를 별도 토큰으로 붙입니다. 결과를 ^\d+\.\d{2} [A-Z]{3}$만 받는 정규식에 통과시키고 나머지는 큐에 넣으세요.
재고 상태 매핑. 사내 용어를 다섯 개 허용 값에 명시적으로 매핑합니다. 각 버킷에 몇 행이 들어갔고 몇 행이 수동 검토로 빠졌는지 세세요. 수동 검토가 많다는 것은 피드가 깨진 것이 아니라 재고 용어에 매핑 테이블이 필요하다는 뜻입니다.
제목과 설명문 정리. 제목은 150자에서 단어 경계로 자릅니다. 설명문에서 마크업을 벗기고 일반 텍스트로 5,000자에 상한을 둡니다.
품질 검사. 정규화한 파일을 새 스프레드시트로 다시 불러와 GTIN 열이 여전히 앞자리 0을 표시하는지 확인하세요. 그러면 다른 모든 검사를 빠져나가는 숫자 내보내기 함정을 잡을 수 있습니다.
복구 절차. 피드 플랫폼이나 PIM이 이 정규화를 한다면 성공 메시지를 믿지 말고 같은 검사로 그 출력을 검증하세요.
모든 행을 감사하고 예외 목록을 유지하기
여기서 파일 전체에 검사를 돌립니다. 카탈로그를 작업 계획으로 바꾸는 단계입니다.
검증기 없이 확인할 수 있는 9가지 기계적 검사
모든 행에 대해. 9개 필수 필드가 모두 존재하고 비어 있지 않을 것. availability가 다섯 값 열거에 있을 것. gtin 자릿수와 체크 디지트가 유효할 것. price가 금액과 통화 형태에 맞을 것. sale_price가 price보다 엄격히 작고 0보다 크며 같은 통화일 것. title이 150자 이하일 것. description이 일반 텍스트로 5,000자 이하일 것. url이 200을 반환하고 서버 측에서 상품 데이터를 렌더링할 것. image_url이 플레이스홀더가 아니라 실제 이미지로 해석될 것.
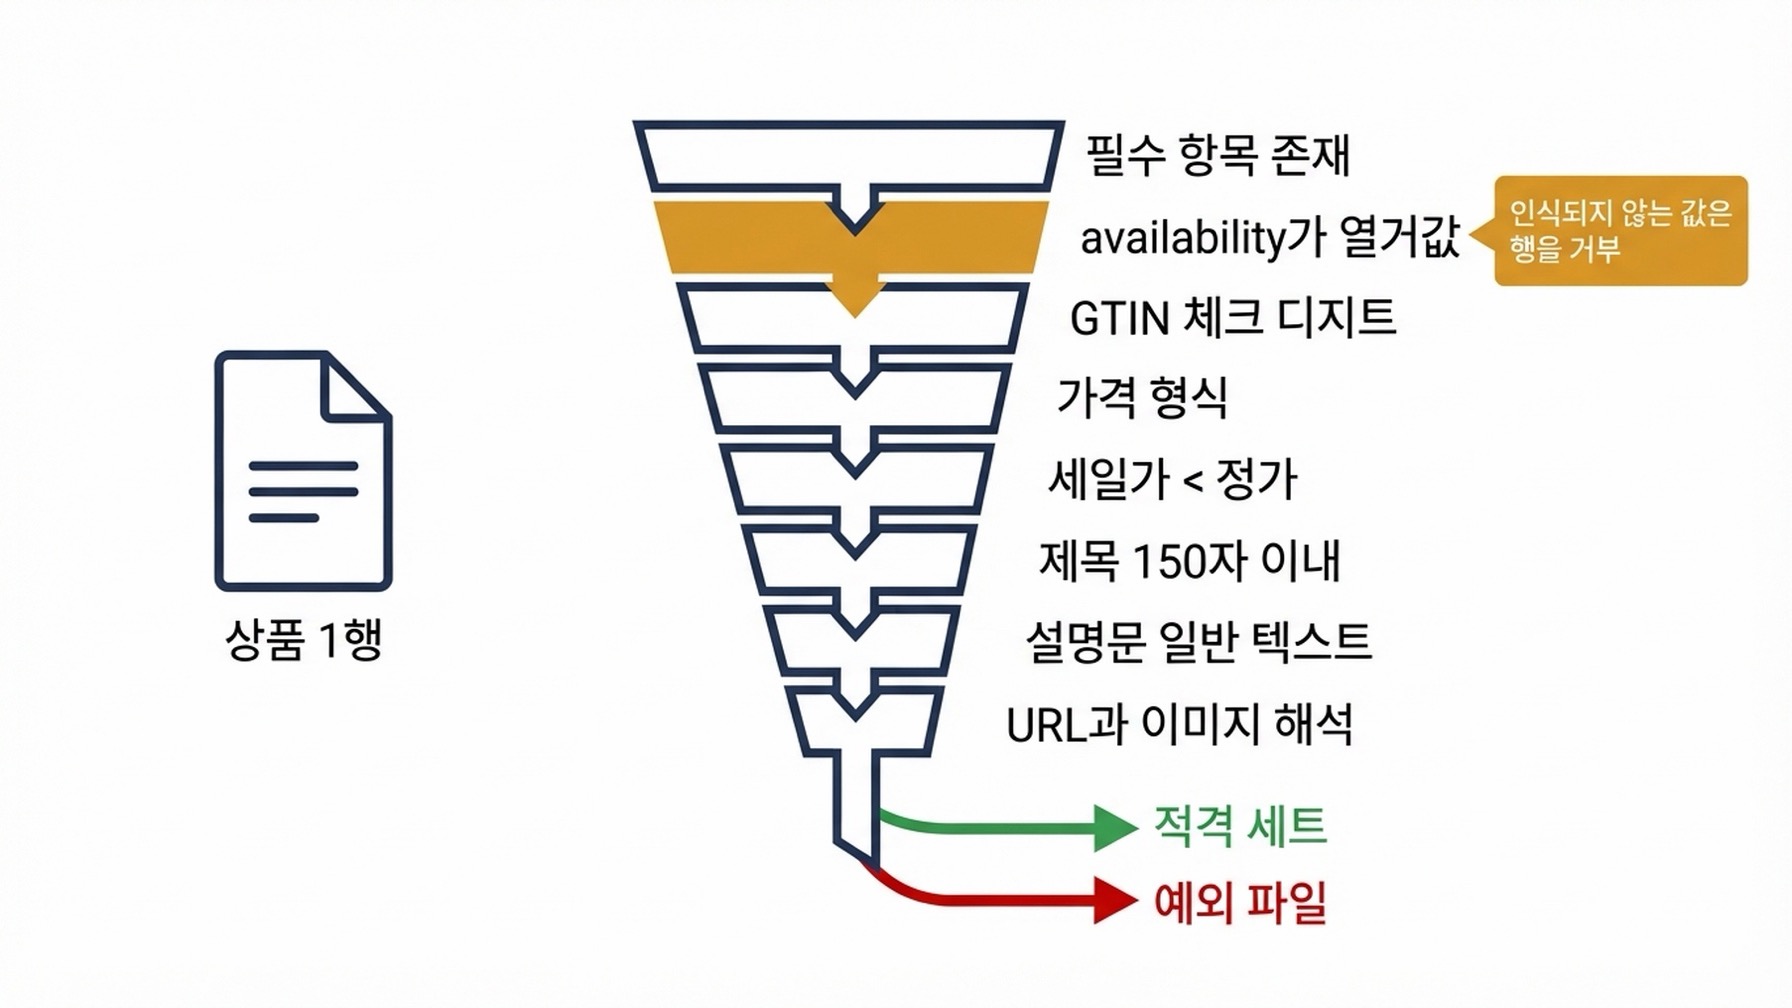
하나의 행은 모든 게이트를 통과하거나, 실패한 게이트 이름과 함께 예외 파일로 떨어지거나 둘 중 하나입니다. 가장 많은 행을 거부하는 것은 availability 게이트입니다. 자체 재고 용어가 카탈로그가 실패하는 가장 흔한 이유이기 때문입니다.
완벽한 카탈로그가 아니라 예외 파일 만들기
두 개의 열과 담당자 한 명. item_id, 차단 요소, 그리고 누가 고치는지.
품질 검사. 어느 정도 정리된 카탈로그라면 예외 파일은 행의 10% 미만이어야 합니다. 30%를 넘으면 문제는 상류의 데이터 거버넌스이며, 파일에 패치를 대는 대신 원본 시스템을 고치는 것이 정직한 대응입니다.
복구 절차. 필수 필드가 산발적 SKU가 아니라 카테고리 전체에서 빠져 있다면 비즈니스 오너가 함께하는 조달 결정으로 다루세요. 감사를 통과시키려고 그 행을 unknown으로 만들지 마세요. unknown은 특정한 의미를 가진 정당한 값이며, 검사를 통과시키려고 쓰면 자기 데이터를 오염시킵니다.
갱신에 대한 정직한 보충입니다. 명세는 갱신 주기를 밝히지 않고, 피드가 전체 스냅샷인지 증분 갱신인지도 밝히지 않습니다. 공개된 벤더 설명들은 둘 다에 대해 자신 있게 주장하지만 그것은 OpenAI 문서에 없습니다. 명세가 실제로 지시하는 것은 현재 가격을 제출하고, 세일이 시작되거나 끝날 때 갱신하고, 상품이 품절되거나 돌아올 때 재고 상태를 갱신하라는 것입니다. 파이프라인은 이 두 이벤트를 축으로 짜고 갱신 주기 질문은 온보딩에서 확인하세요.
플랫폼이 하는 방식대로 파일 검증하기
제출하려는 정확한 바이트열을 제출하려는 형식으로 다시 파싱하고, 들어간 행과 나온 행을 세세요.
이것이 스프레드시트가 감추는 실패를 잡습니다. Excel에서 깔끔하게 열리는 파일이 CSV로 파싱되는 파일과 같지 않습니다. 이스케이프되지 않은 구분자나 설명문 필드 안의 줄바꿈은 화면에서는 멀쩡해 보이면서 파싱을 깨뜨리기 때문입니다.
품질 검사. 들어간 행 수와 나온 행 수가 같고 자동 검사가 수동 감사와 일치할 것. 둘이 다르면 한쪽이 틀린 것이며 대개 수동 쪽입니다.
복구 절차. 인코딩 실패는 거의 항상 UTF-8로 다시 내보내면 해결됩니다. 따옴표 실패는 거의 항상 이스케이프되지 않은 구분자이거나 설명문 안의 여분 줄바꿈입니다.
팀에 코딩 에이전트가 있다면 여기가 작은 스크립트가 값을 하는 유일한 지점입니다. 감사를 분기별 프로젝트에서 재실행으로 바꿔주기 때문입니다.
제대로 됐는지 검증하기
무엇을 증명할 수 있는지는 레인마다 다릅니다. 모호하게 넘기지 말고 그 차이에 대해 정확해질 가치가 있습니다.
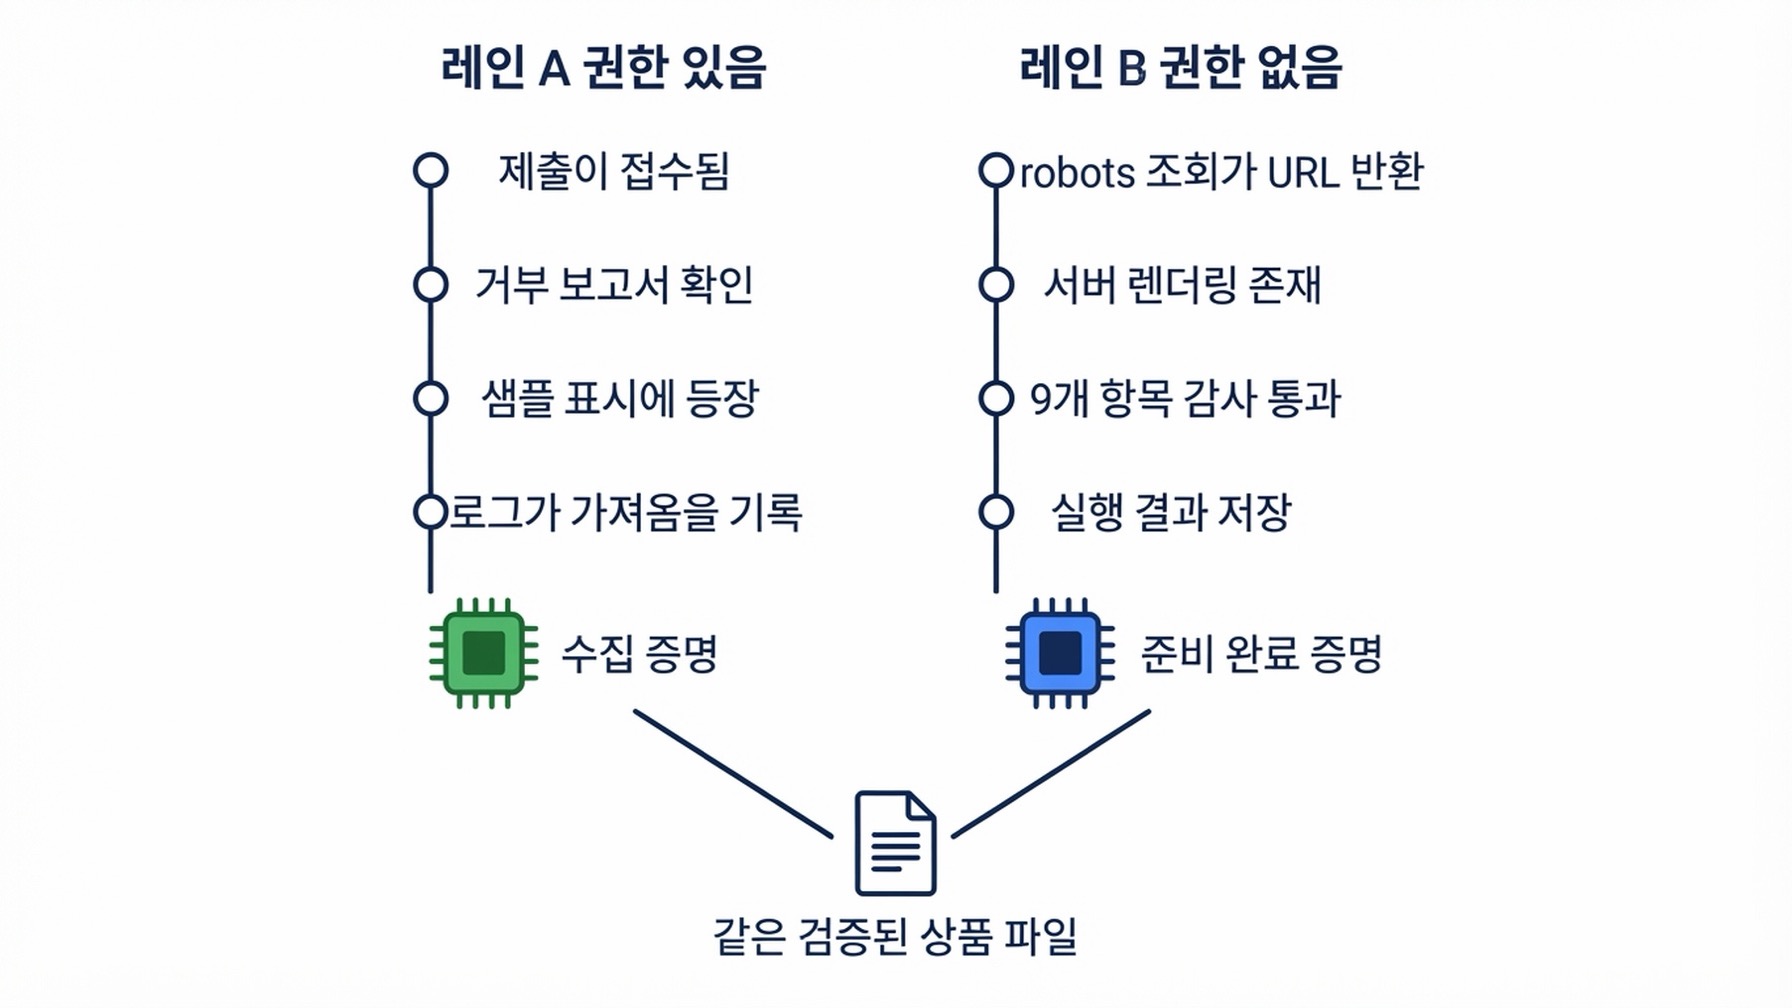
레인 A는 수집을 증명할 수 있습니다. 레인 B는 준비 완료를 증명할 수 있습니다. 레인도 분기도 파일을 바꾸지 않습니다. 그래서 접근을 얻기 전에 파일을 만드는 것이 의미가 있습니다.
접근이 있는 경우(레인 A)
네 가지 검사. 제출이 접수되었습니다. 행 수준 거부 보고서를 읽고 모든 거부를 해결하거나 기록했습니다. 샘플 쇼핑 프롬프트가 내 상품 하나를 표시하기 시작했습니다. 서버 로그가 상품 URL을 가져오는 검색 에이전트를 보여줍니다.
없는 경우(레인 B)
네 가지 검사. robots.txt 조회가 OAI-SearchBot에 상품 URL을 반환합니다. 그 URL의 서버 렌더링 결과에 제목, 가격, 재고 상태, 설명이 들어 있습니다. 9개 항목 감사가 통과합니다. 고정된 내보내기와 검사 실행이 다음 사람이 재현할 수 있는 곳에 저장되어 있습니다.
준비 완료는 진짜이고 반증 가능한 성과입니다. 다만 그것이 수집과 같지는 않으며, 같은 것인 양 보고해서도 안 됩니다.
마지막으로 중요한 숫자 하나
ChatGPT에서 나가는 외부 링크에는 utm_source=chatgpt.com이 자동으로 붙습니다. 즉 클릭이 일어났다는 1자 증거는 자기 분석 도구에만 있습니다. 필요해지기 전에 지금 필터를 설정하세요.
그것이 무엇을 재는지 분명히 하세요. 클릭 기반 트래픽 귀속이며 가시성 지표가 아닙니다. 상품은 여러 번 추천되고도 한 번도 클릭되지 않을 수 있고, 자격이 없는 상품은 애초에 클릭될 수가 없습니다.
이 워크플로가 통제하지 않는 것
피드 세트 안에서의 순위는 통제하지 않습니다. 명세가 정의하는 것은 행의 계약입니다. 정렬 규칙은 정의하지 않습니다. 모든 필드 검사를 통과한다는 것은 그 상품이 검색될 자격을 얻는다는 뜻입니다. 적합한 행 열 개 중 어느 것이 표시되는지에 대해서는 아무것도 말하지 않습니다. 서두에서 인용한 조사가 재는 것은 검색 출처이며 검색된 집합 안의 순위가 아닙니다.
7월 10일 숫자는 관측치이며 한 벤더의 것입니다. 그것들은 실제 쇼핑 세션이나 구매 여정이 아니라 Profound의 추적 프롬프트 패널을 기술합니다. OpenAI는 그 변화를 확인하지 않았고 검색 비중도 공개하지 않았습니다. 2026년 9월 3일에 GPT-6 Astra 배포가 시작되었고, 그것은 이 조사의 후반 측정 구간과 겹치며 명백한 교란 요인입니다.
집중도 수치도 같은 한계를 안고 있습니다. 상위 10개 스토어 참조가 22.5%에서 41.8%로 오른 것과 고유 머천트 수가 13,524에서 10,607로 줄어든 것은 둘 다 같은 패널에서 나왔습니다. 그리고 검색 출처 변화가 517개 변동 고객에 걸친 가시성 변동의 83%를 설명했다는 발견은 그 패널 안에서의 설명 비중이며, 계획의 전제로 삼을 인과 계수가 아닙니다.
벤더 블로그에 도는 주장 중 일부는 명세에 없습니다. 각각 신중하게 다루세요.
주장 | 출처 | 상태 |
|---|---|---|
피드가 15분마다 갱신되어 일일 피드보다 96배 자주 | 벤더 블로그 | OpenAI 명세에 없으며, 명세는 갱신 주기를 밝히지 않음 |
피드가 증분 갱신이 아니라 전체 스냅샷 | OpenAI 문서를 인용하지 않은 한 벤더 | 미해결. 온보딩에서 확인 |
약 100개 상품 샘플이 필요 | 벤더 블로그 | OpenAI 도움말 문서는 수량을 언급하지 않고 처음 샘플 또는 전체 피드 제출만 언급 |
제출이 SFTP 경유 | 한 곳은 SFTP, 다른 곳은 암호화 HTTPS 푸시 | 출처가 상충. 방식은 온보딩에서 확정 |
| 집계된 출처 하나 | 명세 필드 목록에 없음. 명세의 리뷰 필드는 |
구조화 피드가 스크래핑 데이터보다 약 2배 전환된다 | 출처 없는 벤더 주장 | 전제로 삼지 말 것 |
당신의 카피가 어떻게 그려질지는 통제하지 않습니다. ChatGPT는 상품 제목과 설명을 단순화해 생성할 수 있습니다. 또한 쇼핑 결과는 ChatGPT가 독립적으로 선택하며 광고가 아닙니다. 이것은 검색 출처가 아니라 상업적 영향에 대한 질문에 답하는 것입니다. 유료 노출을 원한다면 OpenAI는 상품 피드로 구축되는 별도의 광고 경로를 운영합니다. 그것은 다른 워크플로이며 이 글의 범위가 아닙니다.
FAQ
오늘 ChatGPT에 상품 피드를 제출할 수 있습니까?
주문형으로는 안 됩니다. 접근은 머천트별로 확인되고, 결제에는 별도로 활성화해야 하는 연동이 필요하며, 표준 업로드는 현재 미국 대상입니다. 등록으로 얻는 것은 머천트 표시 이름뿐이고, 라이브 업로드 접근 없이 등록된 상태일 수 있습니다. 위의 4개 항목 접근 판정을 실행해 자기 위치를 확인하세요.
피드를 얼마나 자주 갱신해야 합니까?
명세는 갱신 주기를 밝히지 않습니다. 벤더 블로그 두 곳이 15분이라고 주장하지만 그 숫자는 OpenAI 문서에 나오지 않습니다. 실무적 답은 명세가 명시적으로 최신으로 유지하라고 지시하는 두 가지, 즉 가격과 재고 상태 이벤트를 축으로 갱신을 구동하는 것입니다.
전체 파일을 보내나요, 변경된 행만 보내나요?
미해결입니다. 한 벤더가 전체 스냅샷이라고 주장하며 그 근거로 OpenAI 문서를 인용하지 않습니다. 어느 답에든 의존하는 파이프라인을 만들기 전에 온보딩에서 확인하세요.
100개 상품 샘플 요건은 사실입니까?
OpenAI 도움말 문서는 수량을 붙이지 않고 처음 샘플 또는 전체 피드 제출을 언급합니다. 100개라는 숫자는 벤더 블로그에서 왔습니다. 샘플을 준비한다면 특정 개수를 겨냥하지 말고 각 선택 그룹의 사례를 아우르는 대표성을 갖추세요.
좋은 피드가 ChatGPT 쇼핑 결과에서 상품 순위를 올립니까?
그 질문이 보통 함축하는 의미에서는 아닙니다. 피드는 상품을 자격 있고 서술 가능하게 만듭니다. 검색된 집합 안의 순위는 문서화되어 있지 않고, 공개된 조사가 재는 것은 정렬이 아니라 검색 출처입니다. 필드 적합성은 전제 조건으로 다루고 지렛대로 다루지 마세요.
Shopify에서 판다면 이것이 필요합니까?
기본 연동에는 필요하지 않습니다. 상품 데이터는 머천트 측 작업 없이 Shopify Catalog를 통해 ChatGPT에 도달합니다. 직접 피드가 필요한 것은 최신성과, 기본적으로 실리지 않는 필드 때문입니다.
작성자: Eva Laurent, Auspia에서 1만 개 이상의 상품 페이지를 담당하는 이커머스 검색 전략가. 이커머스 검색, 상품 디스커버리, 그리고 상품 데이터가 AI 쇼핑 표면에 어떻게 도달하는지를 씁니다.