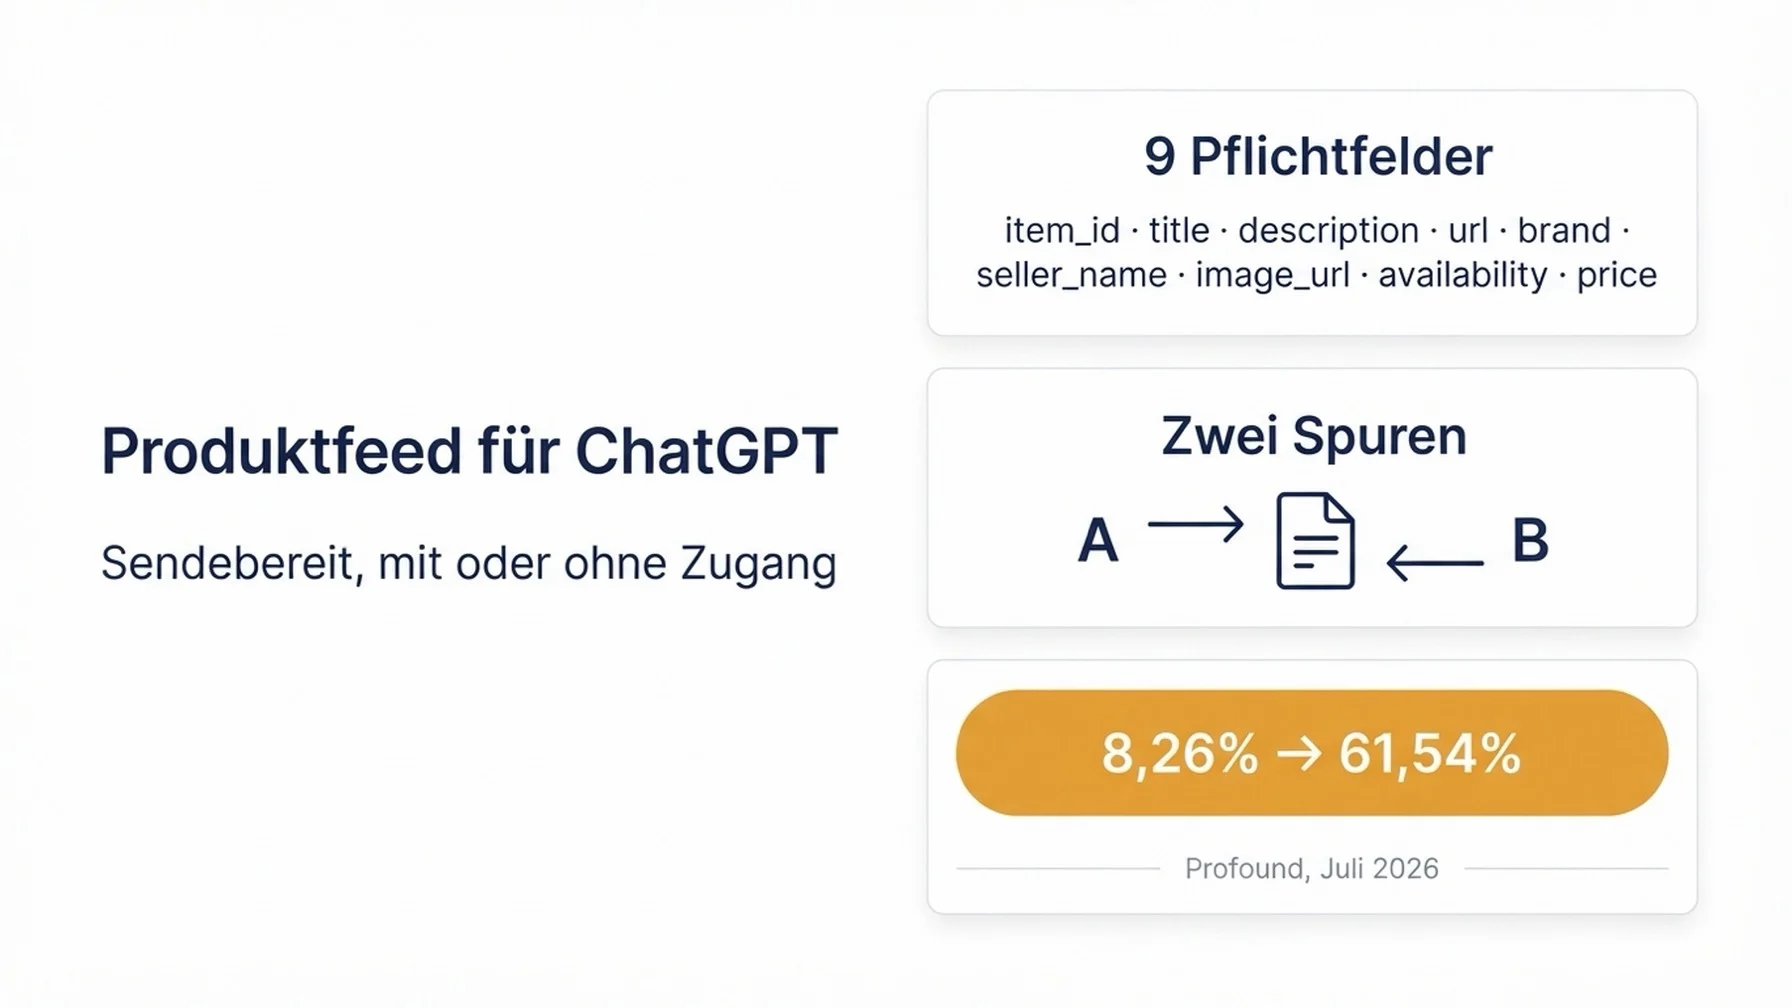
Im Juli 2026 haben die Shopping-Empfehlungen von ChatGPT ihre Hauptquelle gewechselt. Wenn Ihr Katalog diese Änderung nicht mitgemacht hat, gleicht die Optimierung der Produktseiten das nicht aus. Dieser Workflow bringt den Katalog in einen geprüften, sendebereiten Zustand. Er funktioniert unabhängig davon, ob Sie heute einen Feed einreichen können.
Für wen | E-Commerce-SEO-Verantwortliche, Feed-Manager und Leiter des Merchant-Betriebs, die Kataloge von etwa 500 bis 100.000 SKUs verantworten |
Was am Ende steht | Eine Produktdatei, die alle neun Pflichtfeldprüfungen besteht, plus eine Ausnahmeliste mit benannter Zuständigkeit für jede blockierte SKU |
Was Sie vorher brauchen | Die Möglichkeit, den Katalog als CSV, TSV oder JSONL zu exportieren. Ein Staging-Verzeichnis. Die Fähigkeit, |
Zum Zugang | Möglicherweise können Sie heute keinen Feed einreichen. Das Feed-Programm von OpenAI ist einladungsbasiert, der Checkout ist eine separat zu aktivierende Integration, und der Standard-Upload richtet sich derzeit auf die USA. Trotzdem bringt dieser Workflow die Datei zustande |
Zeitaufwand | 4 bis 6 Stunden im ersten Durchlauf bei einem Katalog unter 5.000 SKUs. Die Zeit geht in die Feldprüfung, nicht in die technische Einrichtung |
Definition von fertig | Jede Zeile besteht die neun Pflichtprüfungen; jede übersprungene SKU steht mit benannter Zuständigkeit in der Ausnahmeliste; der Suchcrawler von OpenAI kann eine Beispiel-Produkt-URL abrufen und echte Daten lesen; der Durchlauf lässt sich aus dem gespeicherten Export reproduzieren |
Was sich geändert hat und welche eine Entscheidung daraus folgt
OpenAI hat am 9. Juli 2026 die Modelle ChatGPT 5.6 veröffentlicht. Am Tag darauf sprang der Anteil der Shopping-Empfehlungen in ChatGPT, der aus Produktfeeds von Merchants statt aus der offenen Websuche stammte, von 8,26% auf 61,54%. Die Zahl stammt aus einer veröffentlichten Studie von Profound, die im Juli 2026 1.757.723 Shopping-Prompt-Läufe in ChatGPT verfolgt hat. An einem einzigen Tag wurde die Feed-basierte Abfrage von einer Nebenquelle zur Hauptquelle.
Diese Zahl ist eine Beobachtung Dritter, keine Offenlegung von OpenAI. OpenAI hat die Änderung vom 10. Juli nicht bestätigt und nie ein Abfrageverhältnis veröffentlicht. Was die Daten tragen und was nicht, habe ich in einem Abschnitt gegen Ende des Artikels zusammengefasst. Nehmen Sie die Richtung ernst und die Genauigkeit gelassen.
Die Richtung erzwingt einen Denkwechsel. Produktdaten müssen jetzt als Daten korrekt sein, nicht nur als Inhalt. Eine gut geschriebene Produktseite ohne GTIN-Prüfziffer ist für eine feed-basierte Empfehlungsmaschine ein Datensatz, der die Validierung nicht besteht.
Ab hier folgt nur noch der Workflow. Ob die Zahl vom 10. Juli der Prüfung standhält oder nicht, jeder Schritt hier lohnt sich: Ein sauberer, vollständiger und maschinenlesbarer Katalog zahlt sich auf jeder Handelsfläche aus, die Ihnen noch begegnet.
Bestimmen Sie, in welcher Spur Sie sind
Der Prozess teilt sich in zwei Spuren, weil "fertig" in jeder etwas anderes bedeutet. Sie müssen vor dem Start wissen, wo Sie stehen. Spur A beweist die Indexaufnahme. Spur B beweist die Bereitschaft. Beide erzeugen dieselbe Datei.
Die Zugangsprüfung in vier Fragen
Antworten Sie ehrlich, eine nach der anderen.
Frage | Was als Nachweis für "ja" zählt | Was nicht zählt |
|---|---|---|
Haben Sie sich bei OpenAI registriert und eine schriftliche Bestätigung des Feed-Zugangs erhalten? | Eine Bestätigung, die Ihren Feed benennt | "Ich habe das Interessenformular abgeschickt" |
Richtet sich Ihr Katalog auf den US-Markt? | Eine Bestätigung, dass der aktuelle Standard-Upload-Bereich Sie abdeckt | Die Annahme, dass Ihr Markt dazugehört |
Ist die Checkout-Integration separat aktiviert? | Eine ausdrückliche Bestätigung im Onboarding | Dass Sie das Flag selbst gesetzt haben |
Haben Sie eine Test- oder Volldatei eingereicht und eine Empfangsbestätigung erhalten? | Eine Antwort, die Ihre Einreichung nennt | Einreichen und nichts hören |
Wenn eine Antwort nichts hat, worauf Sie "zeigen" können, sind Sie in Spur B. Das ist der Ausgangszustand, keine Niederlage. Zwei wichtige Einschränkungen: Das Setzen der Eligibility-Flags schließt die Checkout-Integration nicht ab, und die Registrierung verschafft nur den Anzeigenamen des Merchants, nichts Weiteres rund um den Feed.
Spur A: Feed-Zugang bestätigt
Sie erhalten eine auf Ihre Registrierung zugeschnittene Feldliste und einen im Onboarding bestätigten Übertragungskanal. Der Übertragungsmechanismus selbst wird im Onboarding festgelegt. Die veröffentlichten Beschreibungen der Anbieter widersprechen sich darin, ob es SFTP oder verschlüsselte HTTPS-Übermittlung an einen zugelassenen Endpunkt ist. Bauen Sie daher keine Pipeline nach einer der beiden Beschreibungen, bis OpenAI Ihnen sagt, welche für Sie gilt.
Spur B: noch kein Zugang, und was davon nicht verloren geht
Drei Dinge sind heute ohne jede Berechtigung offen: der Crawler-Zugang, strukturierte Daten und Beschreibungsqualität auf den Produktseiten sowie eine geprüfte, sendebereite Datei. Die Katalogarbeit im Mittelteil dieses Artikels hat keinerlei Sperre. Bauen und prüfen Sie die Datei jetzt, und senden Sie am Tag des Zugangs das, was ohnehin besteht.
Wenn Sie Shopify nutzen, erreichen die Produktdaten ChatGPT über den Shopify Catalog ohne zusätzliche Merchant-Arbeit. Ein direkter Feed existiert wegen der Aktualität und wegen Feldern, die standardmäßig nicht übertragen werden. Eine Einschränkung: Eine Sekundärquelle datiert diese Integration auf März 2026, aber das Datum ist unbestätigt, also behandeln Sie es als Nachfrage, nicht als Planungsgrundlage.
Öffnen Sie die Tür für den Crawler, der Ihre Produkte liest
Dies ist der erste Schritt, der sofort in beiden Spuren wirkt, und der billigste Erfolg.
Öffnen Sie robots.txt und prüfen Sie die Direktiven für die OpenAI-Agenten. Für die Produktsichtbarkeit zählt OAI-SearchBot. Ist er blockiert, erscheint Ihr Inhalt nicht in den Produktergebnissen von ChatGPT, so sauber der Feed auch sein mag. Er wird nicht zum Modelltraining verwendet, eine Sperre schützt also nichts.
Vier Agentennamen sollten ausdrücklich bewertet werden.
Agent | Aufgabe | Wirkung auf die Produktsichtbarkeit |
|---|---|---|
| Indexiert Inhalte für die Suchflächen | Eine Sperre verbirgt Produkte unabhängig von der Feed-Qualität |
| Ruft Seiten ab, nach denen der Nutzer direkt fragt | Eine Sperre bricht das Echtzeit-Lesen von Seiten |
| Trainingscrawler | Ohne Bezug zur Sichtbarkeit im Shopping |
| Agentisches Browsen | Beeinflusst den Checkout-Pfad über den Agenten |
Die wichtigste Qualitätsprüfung hier ist nicht `robots.txt`. Sondern ob der erlaubte Crawler ankommt und etwas lesen kann. Fragen Sie eine repräsentative Produkt-URL mit dem User-Agent des Crawlers ab und sehen Sie sich den Antwortrumpf an. Kommt nur eine App-Hülle ohne serverseitig gerenderten Titel, Preis, Verfügbarkeit und Beschreibung zurück, war der Zugriff erfolgreich und hat nichts Nützliches geliefert. Viele Schaufenster rendern Produktdaten nur im Client, und solche Shops sind auf dem Feed-losen Entdeckungspfad unsichtbar, egal was die robots-Datei sagt.
Diese Prüfung lässt sich im OpenAI search crawler simulator von Auspia durchführen. Er ruft öffentliche Seiten im Namen des OpenAI-Crawlers ab und zeigt, wie viel sich lesen lässt.
Wenn Sie es nicht lösen können. Ist robots.txt durch Plattform oder Agentur gesperrt, protokollieren Sie die Änderungsanfrage mit Datum und machen Sie weiter. Dieser Schritt ist keine Blockade, er wird zum Nachweis für die Aufzeichnungen von Spur B.
Machen Sie die Produktseiten maschinenlesbar
Der Feed ist nicht der einzige Weg zu Shopping-Empfehlungen, und für Merchants in Spur B ist er derzeit gar nicht verfügbar. Strukturierte Daten auf der Seite schon.
Ergänzen Sie strukturierte Product-Daten als JSON-LD in allen Produkttemplates und erzeugen Sie sie aus derselben Quelle, die den Katalogexport speist. Der zweite Teil ist das, was Teams übersehen. Wird das Schema im Template per Hand gepflegt, während der Feed aus einem PIM kommt, laufen beide binnen eines Quartals auseinander, und widersprüchliche Preis- und Verfügbarkeitssignale sind schlechter als gar keine.
Nehmen Sie mindestens name, description, image, SKU, brand und einen offers-Block mit price, price currency und availability auf. Die Werte müssen mit denen übereinstimmen, die in den Feed gehen. Hat der Katalog GTIN, condition, material, color, size, dimensions, nehmen Sie sie mit, denn genau diese Attribute nutzen konversationelle Anfragen tatsächlich.
Qualitätsprüfung. Nehmen Sie je eine Produkt-URL aus den drei unterschiedlichsten Kategorien und prüfen Sie sie über denselben Renderingpfad, den der Crawler sieht, nicht über einen eingeloggten Browser.
Wenn Sie es nicht lösen können. Erlaubt die Plattform kein JSON-LD in den Produkttemplates, ergänzen Sie es über den Tag-Manager und erfassen Sie es als technische Schuld. Es funktioniert, ist aber fragil, und jemand muss dafür zuständig sein, es wieder abzubauen.
Schreiben Sie Beschreibungen für konversationelle Anfragen neu
An diesem Schritt beginnt die klassische SEO-Disziplin, Ihnen zu schaden.
Katalogbeschreibungen werden meist auf Keyword-Abdeckung und Regalwirkung hin geschrieben: Markengeschichte, ein mit Begriffen gefüllter Titel, eine Liste von Vorteilen. Konversationelle Anfragen im Shopping sehen ganz anders aus. Jemand fragt nach "leise mechanische Tastatur bis 150 Dollar für Großraumbüro", und was darauf antwortet, sind Geräuschpegel, Schaltertyp und Formfaktor. Damit diese Attribute extrahiert werden können, müssen sie als Tatsache existieren.
Schreiben Sie die Produktbeschreibung als Fakten-Spezifikation mit einem kurzen menschlichen Einstieg. Ein Satz dazu, was es ist und für wen. Danach Attribute ohne Marketingbeiworte. "Gewicht: 780 g" ist besser als "unglaublich leichte Konstruktion". Wenn Sie eine Aussage treffen, machen Sie sie konkret und überprüfbar.
Bevor Sie hier stark investieren, sollten Sie eines wissen. Die Shopping-Dokumentation von OpenAI sagt, dass ChatGPT vereinfachte Produkttitel und -beschreibungen erzeugen kann. Ihr Text ist Eingabe für die Empfehlungen, keine garantierte Ausgabe. Schreiben Sie saubere, faktenbasierte Daten und akzeptieren Sie, dass die Fläche sie umformulieren kann.
Qualitätsprüfung. Nehmen Sie die zehn meistverkauften Produkte und notieren Sie für jedes die vier Attribute, die ein Käufer zum Entscheiden braucht. Stehen weniger als drei in der Beschreibung, erfüllt sie ihre Aufgabe nicht.
Wenn Sie es nicht lösen können. Kommen die Beschreibungen aus einem Lieferantenfeed, den Sie nicht kontrollieren, schreiben Sie die obersten 10% nach Verkauf von Hand und lassen Sie den langen Rest nachziehen. Teilweise Abdeckung ist besser als ein festgefahrenes Projekt.
Schreiben Sie den Feldvertrag, bevor Sie die erste Zeile anfassen
Hier beginnt der Feed selbst. Definieren Sie vor jedem Export einmal, was "korrekt" heißt. Das macht die Prüfung aus einer Diskussion zu einem mechanischen Verfahren.
Die neun Pflichtfelder und wo jedes bricht
Alle neun werden in jeder Zeile gebraucht. Diese Tabelle ist der Vertrag.
Feld | Zulässiges Format | Häufigster Fehler | Folge |
|---|---|---|---|
| Stabile, eindeutige Zeichenkette für Produkt oder Variante | Wiederverwendung über Varianten hinweg oder Neuerzeugung bei jedem Export | Doppelte Zeilen und verwaiste Datensätze |
| Klartext, ungefähr bis 150 Zeichen | Mitten im Wort abschneiden oder den Preis in den Namen setzen | Zeile abgelehnt oder falsch zugeordnet |
| Klartext, bis 5.000 Zeichen | HTML- oder Markdown-Reste aus dem CMS | Zeile abgelehnt |
| URL der Produktseite | Tracking-Parameter oder eine weiterleitende URL | Eine Zeile, die nirgendwohin führt |
| Zeichenkette mit dem Markennamen | Fehlt ganz bei SKUs ohne Marke | Zeile abgelehnt |
| Zeichenkette mit dem Merchant-Namen | Uneinheitliche Schreibweise im ganzen Katalog | Merchant-Signal geschwächt |
| Direkte Bild-URL | Platzhalter oder eine URL, die eine Sitzung verlangt | Zeile ohne Visual |
| Nur | Selbstgebaute Werte aus dem Lagerjargon | Zeile abgelehnt |
|
| Tausendertrennzeichen oder eine Zahl ohne Währung | Zeile abgelehnt |
Zwei Felder verdienen besondere Betonung, weil sie still scheitern und die ganze Produktlinie mitnehmen.
availability akzeptiert genau fünf Werte. Fehlend, leer oder unbekannt lehnt die Zeile ab. Exportiert Ihre Plattform IN STOCK, available oder 1, fallen all diese Zeilen durch. Bilden Sie das interne Vokabular ausdrücklich auf die fünf erlaubten Werte ab und schicken Sie, was nicht passt, in eine manuelle Warteschlange, statt es standardmäßig zu unknown zu machen. unknown ist ein legitimer Wert, aber eine bewusste Entscheidung, kein Resteimer.
price ist der Betrag, ein Leerzeichen und der Währungscode in Großbuchstaben. Also 79.99 USD, nicht $79.99, nicht 79,99 USD und nicht 7.999e1. Kein Tausendertrennzeichen und keine Exponentialschreibweise.
Regeln, die Zeilen still ablehnen
Vier weitere Einschränkungen gehören ins Prüfskript.
GTIN. Genau 8, 12, 13 oder 14 Ziffern mit gültiger Prüfziffer. ISBN-10 wird nicht akzeptiert. Bewahren Sie führende Nullen, was heißt: die Spalte überall, wo sie durchläuft, als Text halten. Das ist der häufigste stille Zerstörer der ganzen Spezifikation: Tabellen und CSV-Exporte verwerfen führende Nullen standardmäßig.
Aktionspreis. Muss größer als null und strikt kleiner als der Normalpreis in derselben Währung sein. Eine Aktionszeile, in der der Aktionspreis dem Normalpreis entspricht oder der Normalpreis leer blieb, besteht nicht.
Titellänge. Ungefähr bis 150 Zeichen. Beim Kürzen an der Wortgrenze schneiden.
Datumsfelder planen nichts. Die Spezifikation sagt ausdrücklich, dass Datumsangaben im Vertrag keine Preis- oder Verfügbarkeitsänderungen planen. Soll eine Aktion um Mitternacht umschalten, muss Ihre Pipeline die neuen Werte senden.
Entscheiden Sie die Eligibility-Flags bewusst
Drei Flags bestimmen, was mit der Zeile nach bestandener Validierung passiert.
Flag | Standard bei fehlendem oder leerem Wert | Rolle |
|---|---|---|
|
|
|
| Such-Eligibility erforderlich | Für |
| Aus | Steuert einen separaten Werbebehandlungspfad |
Sie können auch als enable_search, enable_checkout und is_eligible_ads auftreten. Das sind Aliasse, also halten Sie ein Template mit dem alten Namen nicht für ein anderes Feld.
Ein praktischer Rat: Synchronisieren Sie is_eligible_search mit dem System, das ohnehin weiß, dass ein Produkt ausgelistet oder verborgen ist. Führen Sie eine separate Liste "aus dem Kanal verbergen" und erreicht diese Liste den Feed nicht, senden Sie veraltete Angebote in die Empfehlungen.
In welcher Reihenfolge Sie die optionalen Gruppen aktivieren
Es gibt rund 50 optionale Felder. Sortieren wir sie nach Ertrag pro Arbeitsstunde, nicht nach der Reihenfolge der Spezifikation.
- Varianten (
group_id,listing_has_variations,variant_dict,offer_id,gtin,mpn). Verkaufen Sie Bekleidung, Schuhe, Wohnen oder irgendetwas mit Größe und Farbe, ist das die erste Priorität. - Artikelinformationen (
condition,product_category,material,color,size,gender,age_group, dazu die Maß- und Gewichtsfelder). Sie bringen das konversationelle Matching zum Laufen. - Medien (
additional_image_urls). - Retouren (
accepts_returns,return_deadline_in_days,return_policy). - Bewertungen (
review_count,star_rating), dazustore_review_countundstore_star_ratingauf Shopebene. - Versand, Merchant und Geografie (
shipping_price,shipping,seller_url,target_countries,store_country). - Nur im Onboarding verfügbare Felder.
marketplace_seller,size_system,accepts_exchanges,is_digital, das Werbepaar (is_ads_eligible,ads_metadata) und das Checkout-Paar (is_eligible_checkout,seller_privacy_policy,seller_tos) verlangen eine Bestätigung im Onboarding. Sie sind nicht self-service. Lassen Sie sie im ersten Durchlauf weg.
Qualitätsprüfung. Alle neun Pflichtfelder müssen auf eine Katalogspalte abbilden, die bei mindestens 95% der SKUs echte Daten liefert. Ein Feld unterhalb dieser Schwelle ist keine Zuordnungsaufgabe, sondern eine Beschaffungsentscheidung.
Wenn Sie es nicht lösen können. Hat ein Pflichtfeld überhaupt keine Quelle, etwa brand in einer markenlosen Linie, halten Sie an und klären Sie die Beschaffungsfrage mit der Geschäftsführung, bevor Sie die Datei bauen. Formatierungsarbeit repariert keine Daten, die es nicht gibt.
Dateiformate, die sich wirklich senden lassen
Nutzen Sie das Format, das OpenAI für Ihren registrierten Feed im Onboarding bestätigt. Daneben existiert ein Google-kompatibler Weg, der .txt oder tabulatorgetrenntes .tsv in UTF-8 sowie kommagetrenntes .csv akzeptiert und gzip als .txt.gz, .txt.gzip, .tsv.gz und .csv.gz unterstützt.
JSON, Tabellen, XML, RSS und Atom werden auf diesem kompatiblen Weg nicht unterstützt. Mischen Sie keine Formate über Zeilen hinweg, nutzen Sie ein einziges Format für den gesamten Upload.
Normalisieren Sie die vier Felder, die die meisten Zeilen brechen
Frieren Sie einen Export ein
Exportieren Sie genau einmal, versehen Sie die Datei mit einem Zeitstempel und berechnen Sie einen Hash. Alle folgenden Schritte laufen auf der eingefrorenen Datei. Reproduzierbarkeit entscheidet, ob die Prüfung Sie deckt, wenn drei Wochen später jemand fragt, warum eine bestimmte SKU verschwunden ist.
Die vier Normalisierungen
Führende Nullen im GTIN. Exportieren Sie die Spalte als Text, prüfen Sie, ob die Länge 8, 12, 13 oder 14 beträgt, und validieren Sie die Prüfziffer. Hier wohnen die meisten stillen Fehlschläge.
Preisformat. Entfernen Sie Tausendertrennzeichen, behalten Sie den Dezimalpunkt, beseitigen Sie die Exponentialschreibweise und hängen Sie den Währungscode als eigenes Token an. Prüfen Sie das Ergebnis dann mit einem regulären Ausdruck, der nur ^\d+\.\d{2} [A-Z]{3}$ akzeptiert, und schicken Sie den Rest in die Warteschlange.
Verfügbarkeitsmapping. Bilden Sie das interne Vokabular ausdrücklich auf die fünf erlaubten Werte ab. Zählen Sie, wie viele Zeilen in welchem Topf landen und wie viele zur manuellen Prüfung gingen. Eine große manuelle Warteschlange heißt nicht, dass der Feed kaputt ist, sondern dass das Lager-Vokabular eine Mapping-Tabelle braucht.
Bereinigung von Titel und Beschreibung. Der Titel wird an der Wortgrenze bei 150 Zeichen gekürzt. Die Beschreibung verliert das Markup und wird auf 5.000 Zeichen Klartext gekürzt.
Qualitätsprüfung. Importieren Sie die normalisierte Datei in eine neue Tabelle und bestätigen Sie, dass die GTIN-Spalte noch führende Nullen zeigt. So fangen Sie die Falle des numerischen Exports, die alle anderen Prüfungen besteht.
Wenn Sie es nicht lösen können. Findet die Normalisierung in der Feed-Plattform oder im PIM statt, verlassen Sie sich nicht auf die Erfolgsmeldung. Prüfen Sie deren Ausgabe mit denselben Tests.
Prüfen Sie jede Zeile und führen Sie eine Ausnahmeliste
Hier laufen die Prüfungen über die ganze Datei. Dieser Schritt macht aus dem Katalog einen Arbeitsplan.
Neun mechanische Prüfungen, die ohne Validator laufen
Pro Zeile: alle neun Pflichtfelder sind vorhanden und nicht leer; availability liegt im Enum der fünf Werte; gtin hat korrekte Länge und Prüfziffer; price entspricht der Form aus Betrag und Währung; sale_price ist strikt kleiner als price, größer als null und in derselben Währung; title überschreitet 150 Zeichen nicht; description ist Klartext mit höchstens 5.000 Zeichen; url antwortet mit 200 und rendert Produktdaten serverseitig; image_url zeigt auf ein echtes Bild, nicht auf einen Platzhalter.
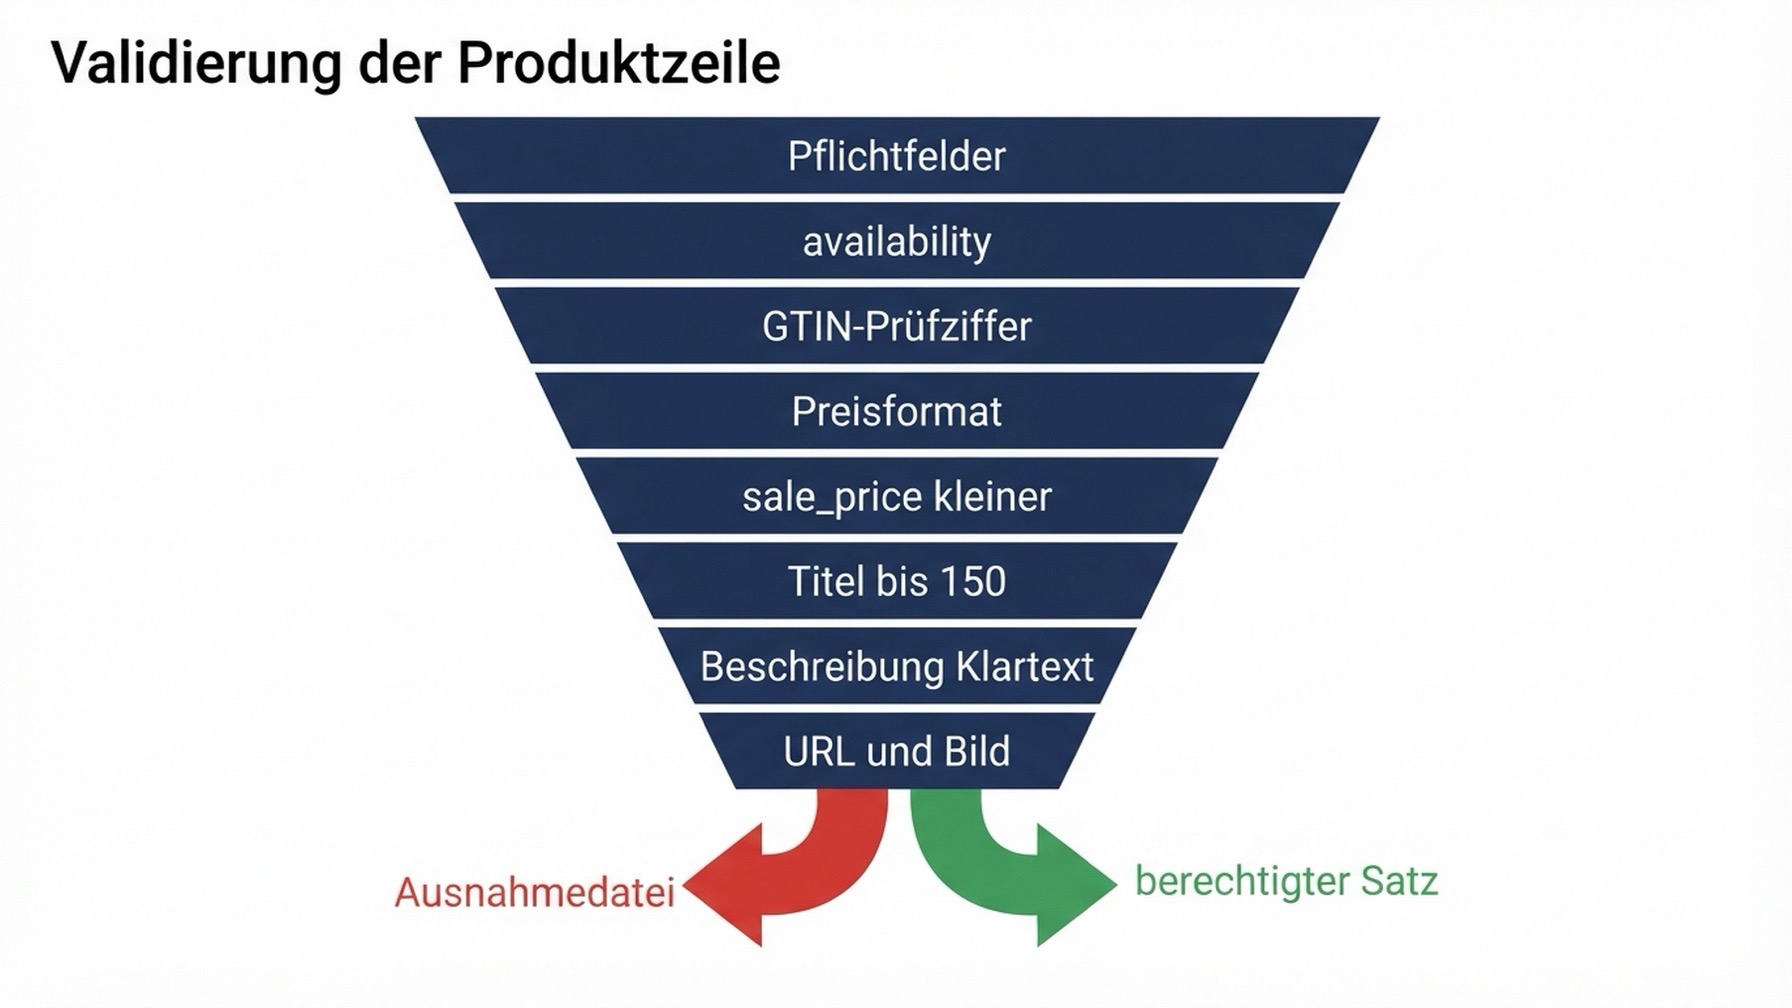
Eine Zeile besteht entweder alle Tore oder fällt in die Ausgabedatei, benannt nach dem Tor, das sie abgelehnt hat. Das availability-Tor lehnt mehr Zeilen ab als jedes andere: selbstgebauter Lagerjargon ist die häufigste Ursache dafür, dass ein ganzer Katalog durchfällt.
Machen Sie eine Ausgabedatei, keinen perfekten Katalog
Zwei Spalten und eine Zuständigkeit: item_id, der Blocker und wer ihn behebt.
Qualitätsprüfung. Bei einem halbwegs aufgeräumten Katalog sollte die Ausgabedatei unter 10% der Zeilen liegen. Liegt sie über 30%, liegt das Problem in der Datenhaltung weiter oben, und der ehrliche Weg ist, das Quellsystem zu reparieren, statt die Datei zu flicken.
Wenn Sie es nicht lösen können. Fehlt ein Pflichtfeld in einer ganzen Produktkategorie statt bei einzelnen SKUs, behandeln Sie es als Beschaffungsentscheidung mit der Geschäftsführung. Machen Sie solche Zeilen nicht zu unknown, um die Prüfung zu bestehen. unknown ist ein legitimer Wert mit einer konkreten Bedeutung, und ihn zum Bestehen einer Prüfung zu missbrauchen, verunreinigt die eigenen Daten.
Eine ehrliche Einschränkung zu Aktualisierungen. Die Spezifikation nennt keine Aktualisierungsfrequenz und sagt nicht, ob der Feed ein Vollsnapshot oder eine inkrementelle Aktualisierung ist. Öffentliche Anbieterbeschreibungen behaupten beides mit Überzeugung, und keines davon steht in der OpenAI-Dokumentation. Die Spezifikation verlangt tatsächlich, aktuelle Preise zu senden, sie zu Beginn und Ende einer Aktion zu aktualisieren und die Verfügbarkeit zu aktualisieren, wenn ein Artikel ausverkauft ist oder zurückkommt. Bauen Sie die Pipeline um diese zwei Ereignisse und klären Sie die Frequenz im Onboarding.
Validieren Sie die Datei so, wie die Plattform es tun wird
Parsen Sie genau die Bytes neu, die Sie senden wollen, in dem Format, das Sie nutzen wollen, und zählen Sie, wie viele Zeilen hineingehen und wie viele herauskommen.
Das fängt die Fehler, die die Tabelle verbirgt. Eine Datei, die in Excel hübsch aussieht, und eine Datei, die als CSV parst, sind nicht dasselbe: nicht escapte Trennzeichen oder Zeilenumbrüche im Beschreibungsfeld sehen auf dem Bildschirm normal aus und brechen das Parsen.
Qualitätsprüfung. Die Zeilenzahl beim Eingang und beim Ausgang stimmt überein, und die automatischen Prüfungen decken sich mit der manuellen Prüfung. Weichen sie voneinander ab, liegt eine Seite falsch, und meist ist es die manuelle.
Wenn Sie es nicht lösen können. Kodierungsprobleme lassen sich fast immer durch einen erneuten Export in UTF-8 lösen. Anführungszeichenprobleme sind fast immer ein nicht escaptes Trennzeichen oder ein überzähliger Zeilenumbruch in der Beschreibung.
Hat das Team einen Agenten, der Code schreibt, ist dies die einzige Stelle, an der ein kleines Skript sich rechnet: Es macht aus der Prüfung ein Quartalsprojekt einen erneuten Lauf.
Prüfen Sie, ob es funktioniert hat
Was Sie belegen können, hängt von der Spur ab. Hier lohnt es sich, präzise zu sein und den Unterschied nicht zu verwischen.
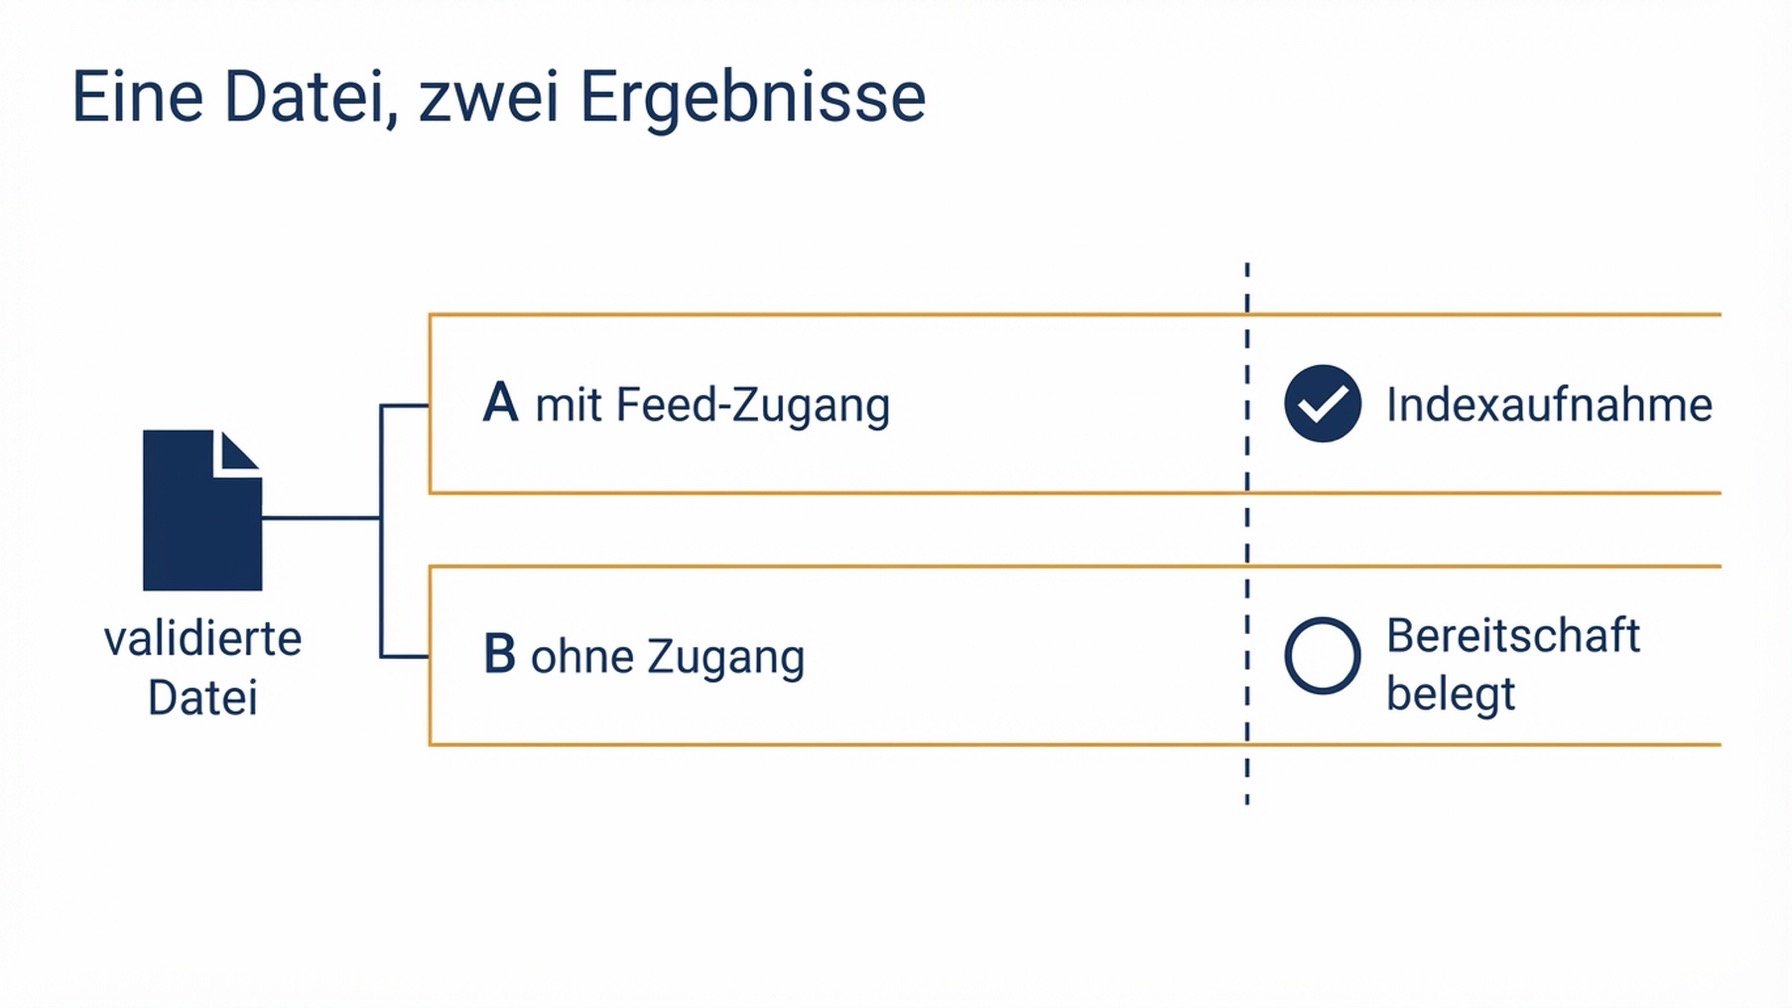
Spur A kann die Indexaufnahme belegen. Spur B kann die Bereitschaft belegen. Weder die Spur noch die Gabelung ändern die Datei, und genau deshalb lohnt es sich, sie vor dem Zugang zu bauen.
Wenn Sie Zugang haben (Spur A)
Vier Prüfungen. Die Einreichung wurde angenommen. Der Ablehnungsbericht pro Zeile wurde gelesen und jede Ablehnung entweder behoben oder dokumentiert. Eine Shopping-Suche zeigt eines Ihrer Produkte. Die Server-Logs zeigen einen Abfrage-Agenten, der die URL Ihres Produkts anfordert.
Wenn Sie keinen Zugang haben (Spur B)
Vier Prüfungen. Die robots.txt-Abfrage liefert eine Produkt-URL für OAI-SearchBot. Das serverseitige Rendering dieser URL enthält Titel, Preis, Verfügbarkeit und Beschreibung. Die Neun-Punkte-Prüfung besteht. Und der eingefrorene Export samt Prüflauf liegt dort, wo die nächste Person ihn reproduzieren kann.
Bereitschaft ist ein echtes und widerlegbares Ergebnis. Sie ist aber nicht dasselbe wie Indexaufnahme, und man sollte sie nicht so berichten, als wäre sie es.
Eine letzte Zahl, die zählt
Ausgehende Links aus ChatGPT erhalten automatisch utm_source=chatgpt.com. Das heißt: Der einzige Erstanbieter-Nachweis, dass ein Klick stattfand, liegt in Ihrer eigenen Analytics. Richten Sie den Filter im Voraus ein, bevor Sie ihn brauchen.
Und machen Sie klar, was er misst: Es ist Klick-Traffic-Attribution, kein Sichtbarkeitsmaß. Ein Produkt kann vielfach empfohlen werden und nie einen Klick bekommen, und ein nicht berechtigtes Produkt lässt sich überhaupt nicht anklicken.
Was dieser Prozess nicht steuert
Er steuert nicht die Reihenfolge innerhalb des abgerufenen Feedsatzes. Die Spezifikation definiert den Zeilenvertrag. Rankingregeln definiert sie nicht. Alle Feldprüfungen zu bestehen verschafft Abruf-Eligibility, und das sagt nichts darüber, welche von zehn berechtigten Zeilen gezeigt wird. Die eingangs zitierte Studie misst die Abrufquelle, nicht die Position innerhalb des abgerufenen Satzes.
Die Zahlen vom 10. Juli sind beobachtend und von einem einzigen Anbieter. Sie beschreiben ein Panel verfolgter Prompts von Profound, keine echten Käufersitzungen oder Kaufpfade. OpenAI hat die Änderung nicht bestätigt und kein Abfrageverhältnis offengelegt. Der Rollout von GPT-6 Astra begann am 3. September 2026 und überlappt mit dem späteren Messfenster jener Studie, was ein echter Störfaktor ist.
Die Konzentrationszahlen tragen dieselben Einschränkungen. Der Anstieg der Verweise auf Top-10-Shops von 22,5% auf 41,8% und der Rückgang der Zahl eindeutiger Merchants von 13.524 auf 10.607 stammen aus demselben Panel. Und die Schlussfolgerung, dass Änderungen der Abrufquelle 83% der Sichtbarkeitsvarianz bei 517 bewegten Kunden erklären, ist ein erklärender Anteil innerhalb des Panels, kein kausaler Koeffizient, auf den man eine Planung stützt.
Manche Aussagen, die in Anbieterblogs kursieren, stehen nicht in der Spezifikation. Behandeln Sie jede mit Vorsicht.
Aussage | Quelle | Status |
|---|---|---|
Der Feed aktualisiert alle 15 Minuten, 96-mal schneller als täglich | Anbieterblog | Steht nicht in der OpenAI-Spezifikation, die keine Frequenz nennt |
Der Feed ist ein Vollsnapshot, keine inkrementelle Aktualisierung | Ein Anbieter, der keine OpenAI-Dokumentation zitiert | Ungelöst. Klären Sie es im Onboarding |
Es braucht eine Stichprobe von etwa 100 Produkten | Anbieterblog | Die OpenAI-Hilfe nennt eine Beispiel- oder Voll-Feed-Einreichung ohne Mengenangabe |
Übermittlung per SFTP | Eine Quelle nennt SFTP, eine andere verschlüsselte HTTPS-Übermittlung | Die Quellen widersprechen sich. Der Mechanismus wird im Onboarding festgelegt |
| Eine einzelne aggregierende Quelle | Sie stehen nicht in der Feldliste der Spezifikation. Die Bewertungsfelder der Spezifikation sind |
Strukturierte Feeds konvertieren etwa doppelt so gut wie gescrapte Daten | Anbieteraussage ohne Quelle | Nehmen Sie es nicht als gegeben |
Er steuert nicht, wie Ihr Text präsentiert wird. ChatGPT kann vereinfachte Produkttitel und -beschreibungen erzeugen. Und Shopping-Ergebnisse werden von ChatGPT unabhängig ausgewählt und sind keine Werbung. Das beantwortet eine Frage nach kommerziellem Einfluss, nicht nach der Abrufquelle. Wollen Sie bezahlte Platzierung, hat OpenAI einen separaten Werbepfad, der auf Produktfeeds aufbaut: ein anderer Workflow und außerhalb des Rahmens dieses Artikels.
Häufige Fragen
Kann man heute einen Produktfeed an ChatGPT senden?
Auf eigene Faust nicht. Der Zugang wird pro Merchant bestätigt, der Checkout ist eine separat zu aktivierende Integration, und der Standard-Upload richtet sich derzeit auf die USA. Die Registrierung verschafft nur den Anzeigenamen des Merchants, und Sie können im Zustand "registriert, aber ohne Upload-Zugang" sein. Führen Sie die Zugangsprüfung in vier Fragen oben durch, um zu sehen, wo Sie stehen.
Wie oft sollte ich den Feed aktualisieren?
Die Spezifikation nennt keine Frequenz. Zwei Anbieterblogs behaupten alle 15 Minuten, aber diese Zahl steht nicht in der OpenAI-Dokumentation. Die praktische Antwort: Steuern Sie die Aktualisierungen über Ihre eigenen Preis- und Verfügbarkeitsereignisse, denn genau diese beiden Dinge verlangt die Spezifikation ausdrücklich aktuell zu halten.
Ganze Datei senden oder nur geänderte Zeilen?
Ungelöst. Ein Anbieter behauptet, es sei ein Vollsnapshot, und zitiert keine OpenAI-Dokumentation. Klären Sie es im Onboarding, bevor Sie eine Pipeline bauen, die von einer der beiden Antworten abhängt.
Stimmt die Vorgabe einer Stichprobe von 100 Produkten?
Die OpenAI-Hilfe nennt die erste Beispiel- oder Voll-Feed-Einreichung, ohne eine Menge zu nennen. Die Zahl 100 stammt aus einem Anbieterblog. Wenn Sie eine Stichprobe vorbereiten, decken Sie repräsentative Fälle je optionaler Feldgruppe ab, statt einer konkreten Zahl nachzujagen.
Hebt ein guter Feed das Ranking meiner Produkte in den Shopping-Ergebnissen von ChatGPT?
In dem Sinn, in dem diese Frage meist gemeint ist, nein. Der Feed macht ein Produkt berechtigt und beschreibbar. Die Reihenfolge innerhalb des abgerufenen Satzes ist nicht dokumentiert, und die verfügbare öffentliche Forschung misst die Abrufquelle, nicht das Ranking. Behandeln Sie Felderkonformität als Voraussetzung, nicht als Hebel.
Ich verkaufe auf Shopify. Brauche ich diesen Prozess?
Für die grundlegende Anbindung nicht. Die Produktdaten erreichen ChatGPT über den Shopify Catalog ohne zusätzliche Merchant-Arbeit. Ein direkter Feed existiert wegen der Aktualität und wegen Feldern, die standardmäßig nicht übertragen werden.
Autor: Eva Laurent, E-Commerce-Search-Strategin bei Auspia, mit über 10.000 Produktseiten im Rücken. Sie schreibt über E-Commerce-Suche, Produktentdeckung und darüber, wie Produktdaten auf KI-gesteuerte Handelsflächen gelangen.