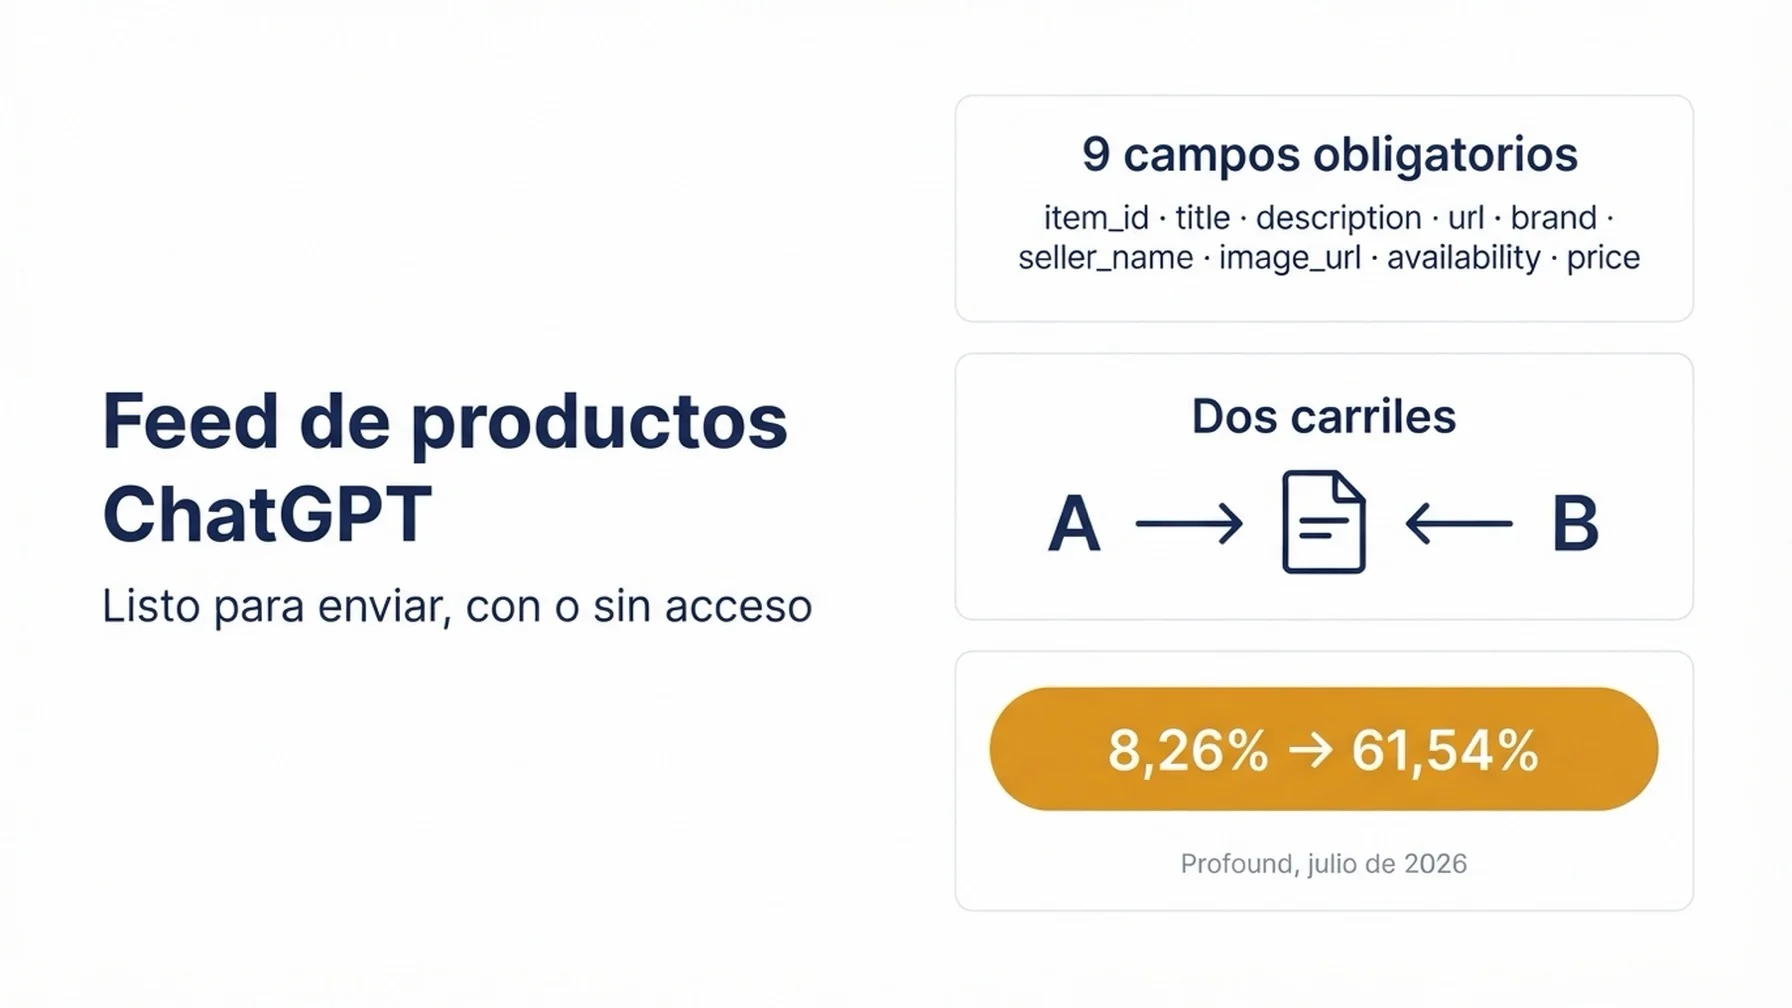
En julio de 2026, las recomendaciones de compra de ChatGPT cambiaron de fuente principal. Si tu catálogo no se adaptó a ese cambio, optimizar las páginas de producto no lo compensa. Este flujo de trabajo lleva el catálogo hasta un estado verificado y listo para enviar. Funciona tengas o no acceso al feed hoy.
Para quién es | Profesionales de SEO de ecommerce, responsables de feeds y líderes de operaciones de merchant a cargo de catálogos de unos 500 a 100.000 SKU |
Con qué terminas | Un archivo de productos aprobado en las nueve comprobaciones de campos obligatorios, más una lista de excepciones con el responsable nombrado de cada SKU bloqueado |
Qué necesitas antes | Poder exportar el catálogo a CSV, TSV o JSONL. Un directorio de staging. Capacidad de editar el |
Sobre el acceso | Puede que hoy no puedas enviar un feed. El programa de feeds de OpenAI es por invitación, el pago es una integración que se activa por separado y la carga estándar está orientada hoy a Estados Unidos. Aun así, este flujo de trabajo deja el archivo hecho |
Cuánto tarda | De 4 a 6 horas en la primera pasada para un catálogo de menos de 5.000 SKU. El tiempo se va en auditar campos, no en configuración técnica |
Definición de terminado | Cada fila pasa las nueve comprobaciones obligatorias; cada SKU omitido tiene entrada en la lista de excepciones con responsable nombrado; el rastreador de búsqueda de OpenAI puede pedir una URL de producto de ejemplo y leer datos reales; la ejecución se reproduce desde la exportación guardada |
Qué cambió y la única decisión que impone
OpenAI lanzó los modelos ChatGPT 5.6 el 9 de julio de 2026. Al día siguiente, la cuota de recomendaciones de compra en ChatGPT que venían de feeds de producto de merchants, en lugar de la búsqueda abierta en la web, pasó del 8,26% al 61,54%. La cifra procede de un estudio publicado por Profound, que siguió 1.757.723 ejecuciones de prompts de compra en ChatGPT durante julio de 2026. En un solo día, la recuperación desde feed dejó de ser una fuente secundaria y pasó a ser la principal.
Esa cifra es una observación de terceros, no una divulgación de OpenAI. OpenAI no ha confirmado el cambio del 10 de julio y nunca ha publicado ningún reparto de recuperación. Lo que sostienen los datos y lo que no lo he reunido en una sección al final del artículo. Trata la dirección con seriedad y la precisión con indulgencia.
La dirección impone un cambio de mentalidad. Los datos de producto ahora tienen que ser correctos como datos, no solo como contenido. Una página de producto bien escrita a la que le falta el dígito de control del GTIN es, para un motor de recomendación basado en feed, un registro que no pasó la validación.
A partir de aquí solo hay flujo de trabajo. Aguante o no el escrutinio la cifra del 10 de julio, cada paso de aquí merece la pena: un catálogo limpio, completo y legible por máquina se paga en todas las superficies de comercio que aún te quedan por afrontar.
Identifica en qué carril estás
El proceso se divide en dos carriles, porque el significado de "terminado" es distinto en cada uno. Necesitas saber dónde estás antes de empezar. El carril A demuestra la inclusión en el índice. El carril B demuestra la preparación. Los dos producen el mismo archivo.
La comprobación de acceso en cuatro preguntas
Responde con honestidad, una por una.
Pregunta | Qué cuenta como prueba de "sí" | Qué no cuenta |
|---|---|---|
¿Te registraste en OpenAI y recibiste confirmación por escrito del acceso al feed? | Una confirmación que nombra tu feed | "Envié el formulario de interés" |
¿Tu catálogo apunta al mercado estadounidense? | Confirmación de que el alcance actual de carga estándar te cubre | Suponer que tu mercado está incluido |
¿La integración de pago está activada por separado? | Confirmación explícita durante el onboarding | Que tú mismo hayas marcado la casilla |
¿Enviaste un archivo de prueba o completo y recibiste respuesta de recepción? | Una respuesta que menciona tu envío | Enviarlo y no oír nada |
Si alguna respuesta no tiene nada que puedas "señalar", estás en el carril B. Ese es el estado por defecto, no una derrota. Dos matices importantes: activar las marcas de elegibilidad no completa la integración de pago, y el registro solo concede el nombre visible del merchant, nada más de lo que tiene que ver con el feed.
Carril A: acceso al feed confirmado
Recibes una lista de campos específica de tu registro y un canal de envío confirmado en el onboarding. El mecanismo de envío en sí se define en el onboarding. Si es SFTP o un envío HTTPS cifrado a un endpoint permitido, las descripciones públicas de los proveedores no coinciden. No montes un pipeline sobre la versión de nadie hasta que OpenAI diga cuál se aplica a ti.
Carril B: todavía sin acceso, y qué no se pierde
Hay tres cosas abiertas hoy sin permiso alguno: el acceso de los rastreadores, los datos estructurados y la calidad de las descripciones en las páginas de producto, y un archivo ya verificado y listo para enviar. El trabajo de catálogo de la parte central de este artículo no tiene ninguna barrera. Monta y valida el archivo ahora y, el día que tengas acceso, envía lo que ya pasa.
Si usas Shopify, los datos de producto llegan a ChatGPT a través de Shopify Catalog sin trabajo adicional del merchant. Un feed directo existe por la frescura y por los campos que no se envían por defecto. Un matiz: una fuente secundaria sitúa esa integración en marzo de 2026, pero la fecha no está confirmada, así que tómalo como tema que preguntar, no como base de un plan.
Abre la puerta al rastreador que lee tus productos
Este es el primer paso que rinde en los dos carriles de inmediato, y la victoria más barata.
Abre el robots.txt y revisa las directivas para los agentes de OpenAI. El que importa para la visibilidad de productos es OAI-SearchBot. Si está bloqueado, tu contenido no aparece en los resultados de producto de ChatGPT, por limpio que esté el feed. No se usa para entrenar modelos, así que bloquearlo no protege nada.
Hay cuatro nombres de agente que conviene evaluar de forma explícita.
Agente | Función | Efecto en la visibilidad de productos |
|---|---|---|
| Indexa contenido para las superficies de búsqueda | Bloquearlo esconde productos al margen de la calidad del feed |
| Recupera páginas cuando el usuario pregunta por ellas directamente | Bloquearlo rompe la lectura de páginas en tiempo real |
| Rastreador de entrenamiento | No tiene relación con la visibilidad en compras |
| Navegación agéntica | Afecta al camino de pago a través del agente |
La comprobación de calidad más importante aquí no es el `robots.txt`. Es si el rastreador autorizado llega y consigue leer algo. Pide una URL de producto representativa con el user agent del rastreador y examina el cuerpo de la respuesta. Si solo vuelve un armazón de aplicación sin título, precio, disponibilidad y descripción renderizados en el servidor, el acceso ha funcionado y no ha devuelto nada útil. Muchos escaparates renderizan los datos de producto solo en el cliente, y esas tiendas son invisibles en la vía de descubrimiento sin feed, diga lo que diga el archivo de robots.
Puedes hacer esta comprobación en el OpenAI search crawler simulator de Auspia, que pide páginas públicas en nombre del rastreador de OpenAI y muestra cuánto se puede leer.
Si no consigues resolverlo. Si el robots.txt está bloqueado por la plataforma o la agencia, registra la solicitud de cambio con fecha y sigue adelante. Este paso no es un bloqueo, pasa a ser evidencia para los registros del carril B.
Haz que las páginas de producto sean legibles por máquina
El feed no es el único camino hacia las recomendaciones de compra, y para los merchants del carril B ni siquiera está disponible ahora. Los datos estructurados en la página sí.
Añade datos estructurados Product en JSON-LD a todas las plantillas de producto y genéralos desde la misma fuente que alimenta la exportación del catálogo. Esa segunda parte es la que se les escapa a los equipos. Si el esquema se mantiene a mano en la plantilla pero el feed viene de un PIM, en un trimestre los dos divergen, y unas señales de precio y disponibilidad que se contradicen son peores que no tener señal ninguna.
Incluye como mínimo name, description, image, SKU, brand y un bloque offers con price, price currency y availability. Los valores tienen que coincidir con los que entran en el feed. Si el catálogo tiene GTIN, condition, material, color, size, dimensions, añádelos también, porque son esos atributos los que las consultas conversacionales usan de verdad.
Comprobación de calidad. Coge una URL de producto de cada una de las tres categorías más dispares y verifícalas por el mismo camino de renderizado que ve el rastreador, no con un navegador con sesión iniciada.
Si no consigues resolverlo. Si la plataforma no permite inyectar JSON-LD en las plantillas de producto, añádelo desde el gestor de etiquetas y anótalo como deuda técnica. Funciona, pero es frágil, y hace falta alguien que sea responsable de retirarlo.
Reescribe las descripciones para consultas conversacionales
Este paso es donde la disciplina clásica de SEO empieza a hacerte daño.
Las descripciones de catálogo suelen escribirse para cubrir palabras clave y para convencer en el estante: historia de marca, un título cargado de términos, una lista de ventajas. Las consultas conversacionales en compras son muy distintas. Alguien pregunta por "teclado mecánico silencioso de menos de 150 dólares para oficina abierta", y lo que responde a eso es el nivel de ruido, el tipo de interruptor y el formato. Para que esos atributos se puedan extraer, tienen que existir como hecho.
Escribe la descripción del producto como una especificación de hechos, con una introducción humana breve. Una frase sobre qué es y para quién. Después atributos sin adjetivos de marketing. "Peso: 780 g" es mejor que "construcción increíblemente ligera". Si haces una afirmación, hazla concreta y verificable.
Antes de invertir a fondo aquí, conviene saber una cosa. La documentación de compras de OpenAI dice que ChatGPT puede generar títulos y descripciones de producto simplificados. Tu texto es una entrada para las recomendaciones, no una salida garantizada. Escribe datos limpios y basados en hechos, y acepta que la superficie puede reformularlos.
Comprobación de calidad. Coge los diez productos más vendidos y, para cada uno, escribe los cuatro atributos que un comprador necesita para decidir. Si la descripción tiene menos de tres, no está haciendo su trabajo.
Si no consigues resolverlo. Si las descripciones vienen de un feed de proveedor que no controlas, reescribe a mano el 10% que más vende y deja que la cola larga venga después. Una cobertura parcial es mejor que un proyecto atascado.
Escribe el contrato de campos antes de tocar la primera fila
Aquí empieza el feed en sí. Antes de cualquier exportación, define qué significa "correcto" una sola vez. Eso convierte la auditoría de una discusión en un procedimiento mecánico.
Los nueve campos obligatorios y dónde falla cada uno
Los nueve hacen falta en todas las filas. Esta tabla es el contrato.
Campo | Formato aceptado | Error más frecuente | Consecuencia |
|---|---|---|---|
| Cadena estable y única para el producto o la variante | Reutilizarla entre variantes o regenerarla en cada exportación | Filas duplicadas y registros huérfanos |
| Texto plano, aproximadamente hasta 150 caracteres | Cortar a mitad de palabra, o meter el precio en el nombre | Fila rechazada o mal emparejada |
| Texto plano, hasta 5.000 caracteres | Restos de HTML o markdown que vienen del CMS | Fila rechazada |
| URL de la página de producto | Parámetros de seguimiento o una URL que redirige | Una fila que no lleva a nada |
| Cadena con el nombre de la marca | Ausencia total en SKU sin marca | Fila rechazada |
| Cadena con el nombre del merchant | Grafía distinta en distintas partes del catálogo | Señal de merchant debilitada |
| URL directa de la imagen | Un placeholder, o una URL que exige sesión | Fila sin elemento visual |
| Solo | Valores caseros del vocabulario del almacén | Fila rechazada |
|
| Separadores de millares, o un número sin moneda | Fila rechazada |
Dos campos merecen un énfasis aparte, porque fallan en silencio y se llevan por delante toda la línea de producto.
availability acepta exactamente cinco valores. Ausente, vacío o no reconocido rechaza la fila. Si tu plataforma exporta IN STOCK, available o 1, todas esas filas caen. Mapea el vocabulario interno a los cinco valores permitidos de forma explícita y manda lo que no encaje a una cola manual, en lugar de convertirlo en unknown por defecto. unknown es un valor legítimo, pero es una decisión consciente, no un cajón de sastre.
price es la cantidad, un espacio y el código de moneda en mayúsculas. Es decir, 79.99 USD, no $79.99, no 79,99 USD y no 7.999e1. Sin separador de millares y sin notación científica.
Reglas que rechazan filas en silencio
Hay cuatro restricciones más que conviene incrustar en el script de verificación.
GTIN. Exactamente 8, 12, 13 o 14 dígitos, con un dígito de control válido. El ISBN-10 no se acepta. Conserva los ceros a la izquierda, lo que significa mantener la columna como texto en todos los sitios por donde pase. Este es el destructor silencioso más común de toda la especificación: las hojas de cálculo y las exportaciones CSV descartan los ceros a la izquierda por defecto.
Precio rebajado. Tiene que ser mayor que cero y estrictamente menor que el precio normal en la misma moneda. Una fila de promoción en la que el precio rebajado iguala al normal, o en la que el normal se quedó vacío, no pasa.
Longitud del título. Aproximadamente hasta 150 caracteres. Al recortar, corta en el límite de palabra.
Los campos de fecha no programan nada. La especificación dice explícitamente que las fechas del contrato no programan cambios de precio ni de disponibilidad. Si quieres que una promoción cambie a medianoche, tu pipeline tiene que enviar los valores nuevos.
Decide las marcas de elegibilidad a conciencia
Tres marcas definen qué pasa con la fila una vez que pasa la validación.
Marca | Valor por defecto si falta o está vacía | Papel |
|---|---|---|
|
|
|
| Exige elegibilidad de búsqueda | Para ser |
| Desactivado | Controla una vía de tratamiento publicitario aparte |
También pueden aparecer como enable_search, enable_checkout y is_eligible_ads. Son alias, así que no trates una plantilla con el nombre antiguo como si fuera otro campo.
Un consejo práctico: sincroniza is_eligible_search con el sistema que ya sabe que un producto está descatalogado u oculto. Si mantienes una lista aparte de "ocultar del canal" y esa lista no llega al feed, estás enviando ofertas caducadas a las recomendaciones.
En qué orden activar los grupos opcionales
Hay unos 50 campos opcionales. Vamos a ordenarlos por retorno por hora de trabajo, no por el orden de la especificación.
- Variantes (
group_id,listing_has_variations,variant_dict,offer_id,gtin,mpn). Si vendes ropa, calzado, hogar o cualquier cosa con talla y color, esta es la primera prioridad. - Información del artículo (
condition,product_category,material,color,size,gender,age_group, más los campos de dimensiones y peso). Son los que hacen funcionar el emparejamiento conversacional. - Medios (
additional_image_urls). - Devoluciones (
accepts_returns,return_deadline_in_days,return_policy). - Reseñas (
review_count,star_rating), másstore_review_countystore_star_ratinga nivel de tienda. - Logística, merchant y geografía (
shipping_price,shipping,seller_url,target_countries,store_country). - Campos que solo están disponibles en el onboarding.
marketplace_seller,size_system,accepts_exchanges,is_digital, la pareja de publicidad (is_ads_eligible,ads_metadata) y la pareja de pago (is_eligible_checkout,seller_privacy_policy,seller_tos) exigen confirmación en el onboarding. No son de autoservicio. Déjalos para la primera pasada.
Comprobación de calidad. Los nueve campos obligatorios tienen que mapear a una columna del catálogo que resuelva datos reales en al menos el 95% de los SKU. Un campo por debajo de ese umbral no es una tarea de mapeo, es una decisión de compras.
Si no consigues resolverlo. Si un campo obligatorio no tiene ninguna fuente, como brand en una línea sin marca, para y resuelve la cuestión de compras con el dueño del negocio antes de montar el archivo. El trabajo de formato no arregla datos que no existen.
Formatos de archivo que de verdad se pueden enviar
Usa el formato que OpenAI confirme para tu feed registrado, en el onboarding. Fuera de eso, existe una vía compatible con Google que acepta .txt o .tsv delimitado por tabuladores en UTF-8, y .csv delimitado por comas, y que admite gzip como .txt.gz, .txt.gzip, .tsv.gz y .csv.gz.
JSON, hojas de cálculo, XML, RSS y Atom no están soportados en esa vía compatible. No mezcles formatos entre filas: usa un solo formato en toda la carga.
Normaliza los cuatro campos que más filas rompen
Congela una exportación
Haz la exportación una sola vez, ponle marca temporal al archivo y calcula un hash. Todos los pasos siguientes se ejecutan sobre el archivo congelado. La reproducibilidad es lo que decide si la auditoría te defiende cuando alguien pregunte, tres semanas después, por qué desapareció un SKU concreto.
Las cuatro normalizaciones
Ceros a la izquierda en el GTIN. Exporta la columna como texto, comprueba que la longitud es 8, 12, 13 o 14 y valida el dígito de control. Ahí vive la mayoría de los fallos silenciosos.
Formato del precio. Quita los separadores de millares, conserva el punto decimal, elimina la notación científica y añade el código de moneda como token aparte. Después pásalo por una expresión regular que solo acepte ^\d+\.\d{2} [A-Z]{3}$ y manda el resto a la cola.
Mapeo de disponibilidad. Mapea el vocabulario interno a los cinco valores permitidos de forma explícita. Cuenta cuántas filas cayeron en cada cesta y cuántas se fueron a revisión manual. Una cola manual grande no significa que el feed esté roto, significa que el vocabulario de tu almacén necesita una tabla de mapeo.
Limpieza de título y descripción. El título se recorta en el límite de palabra a los 150 caracteres. La descripción pierde el marcado y se recorta a 5.000 caracteres de texto plano.
Comprobación de calidad. Importa el archivo normalizado en una tabla nueva y confirma que la columna del GTIN sigue mostrando los ceros a la izquierda. Así es como pillas la trampa de la exportación numérica que pasa todas las demás comprobaciones.
Si no consigues resolverlo. Si la normalización ocurre en la plataforma de feed o en el PIM, no te fíes del mensaje de éxito. Verifica su salida con las mismas pruebas.
Verifica cada fila y mantén una lista de excepciones
Aquí las comprobaciones se ejecutan sobre el archivo entero. Este paso convierte el catálogo en un plan de trabajo.
Nueve comprobaciones mecánicas que puedes ejecutar sin validador
Por fila: los nueve campos obligatorios están presentes y no vacíos; availability está en el enumerado de cinco valores; gtin tiene la longitud y el dígito de control correctos; price encaja con la forma de cantidad y moneda; sale_price es estrictamente menor que price, mayor que cero y en la misma moneda; title no pasa de 150 caracteres; description es texto plano de como máximo 5.000 caracteres; url responde 200 y renderiza los datos de producto en el servidor; image_url apunta a una imagen real, no a un placeholder.
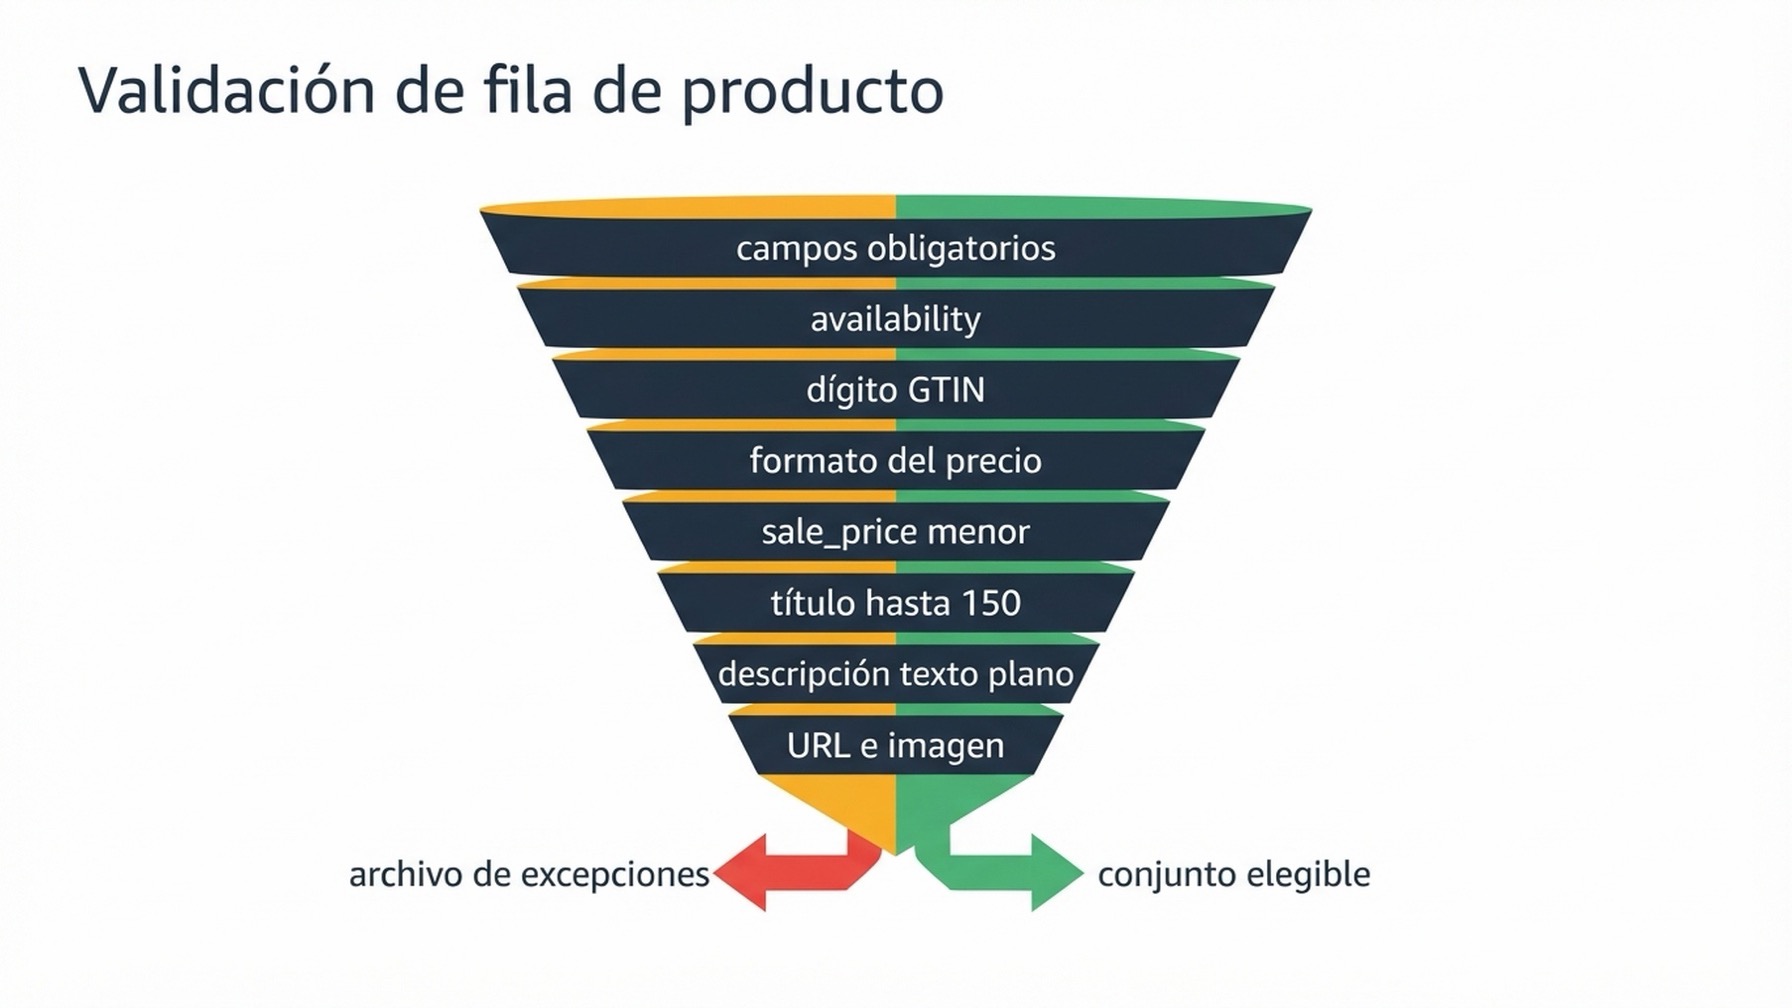
Una fila o pasa todas las puertas o cae en el archivo de excepciones con el nombre de la puerta que la rechazó. La puerta de availability rechaza más filas que ninguna otra: el vocabulario casero de almacén es la causa más común de que un catálogo entero suspenda.
Haz un archivo de excepciones, no un catálogo perfecto
Dos columnas y un responsable: item_id, el bloqueo y quién lo arregla.
Comprobación de calidad. Para un catálogo más o menos ordenado, el archivo de excepciones debería quedar por debajo del 10% de las filas. Si pasa del 30%, el problema está en el gobierno del dato aguas arriba, y lo honesto es arreglar el sistema de origen, no parchear el archivo.
Si no consigues resolverlo. Si un campo obligatorio falta en una categoría entera de productos, y no en SKU sueltos, trátalo como una decisión de compras con el dueño del negocio. No conviertas esas filas en unknown para pasar la auditoría. unknown es un valor legítimo con un significado concreto, y usarlo para pasar una comprobación es ensuciar tus propios datos.
Un matiz honesto sobre las actualizaciones. La especificación no fija ninguna cadencia de actualización y no dice si el feed es una instantánea completa o una actualización incremental. Las descripciones públicas de los proveedores afirman las dos cosas con confianza, y ninguna de las dos está en la documentación de OpenAI. La especificación sí exige enviar los precios actuales, actualizarlos al empezar y al acabar una promoción y actualizar la disponibilidad cuando un artículo se agota o vuelve. Monta el pipeline en torno a esos dos eventos y aclara la cadencia en el onboarding.
Valida el archivo como lo va a validar la plataforma
Vuelve a parsear exactamente los bytes que vas a enviar, con el formato que vas a usar, y cuenta cuántas filas entran y cuántas salen.
Esto pilla los fallos que la hoja de cálculo esconde. Un archivo que se abre bonito en Excel y un archivo que se parsea como CSV no son lo mismo: los delimitadores o los saltos de línea sin escapar dentro del campo de descripción se ven normales en pantalla y rompen el parseo.
Comprobación de calidad. El recuento de filas de entrada y de salida coincide, y las comprobaciones automáticas concuerdan con la auditoría manual. Si no concuerdan, uno de los dos lados se equivoca, y normalmente es el manual.
Si no consigues resolverlo. Los problemas de codificación casi siempre se resuelven reexportando en UTF-8. Los problemas de comillas casi siempre son un delimitador sin escapar o un salto de línea de más en la descripción.
Si el equipo tiene un agente que escribe código, este es el único sitio donde un script pequeño se amortiza: convierte la auditoría de un proyecto trimestral en una nueva ejecución.
Comprueba que ha funcionado
Lo que puedes demostrar depende del carril. Aquí conviene ser preciso y no difuminar la diferencia.
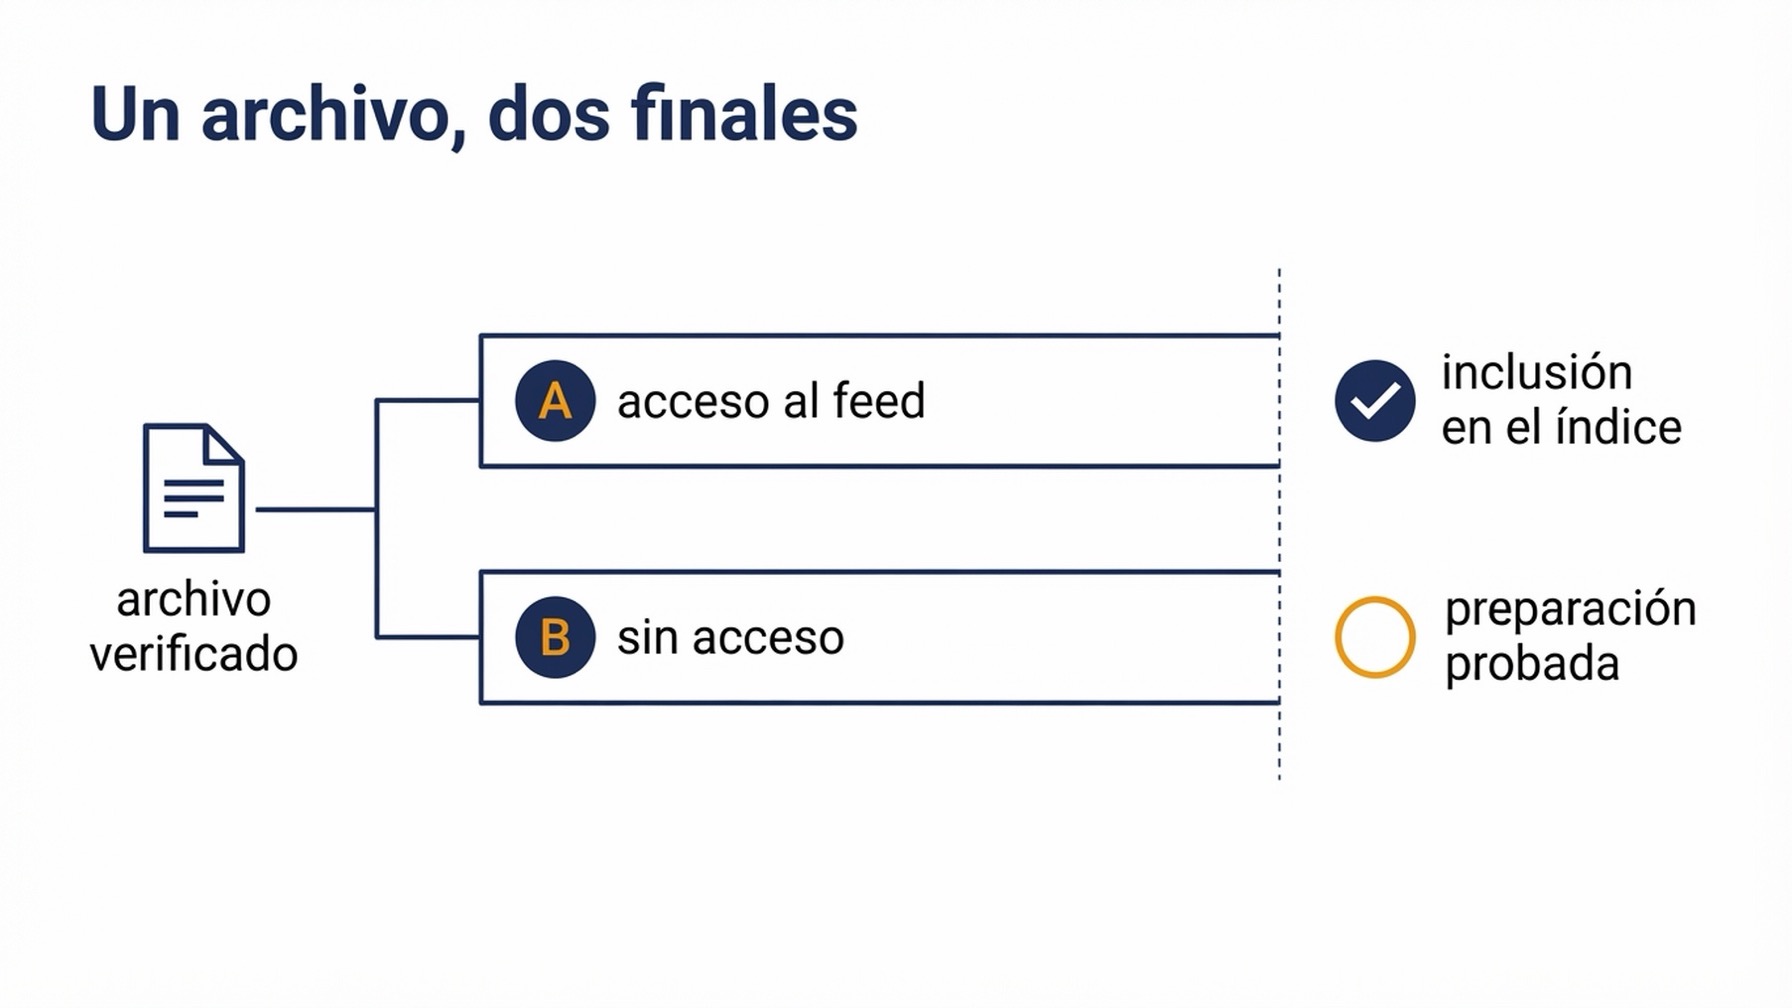
El carril A puede demostrar la inclusión en el índice. El carril B puede demostrar la preparación. Ni el carril ni la bifurcación cambian el archivo, y por eso conviene hacerlo antes de tener acceso.
Si tienes acceso (carril A)
Cuatro comprobaciones. El envío se ha aceptado. El informe de rechazos por fila se ha leído y cada rechazo se ha corregido o documentado. Una búsqueda en compras ha empezado a mostrar uno de tus productos. Los registros del servidor muestran a un agente de recuperación pidiendo la URL de tu producto.
Si no tienes acceso (carril B)
Cuatro comprobaciones. La petición de robots.txt devuelve una URL de producto para OAI-SearchBot. El renderizado en servidor de esa URL trae título, precio, disponibilidad y descripción. La auditoría de nueve puntos pasa. Y la exportación congelada y la ejecución de las comprobaciones están guardadas donde la siguiente persona puede reproducirlas.
La preparación es un resultado real y refutable. Pero no es lo mismo que la inclusión en el índice, y no conviene presentarla como si lo fuera.
Un último dato que importa
Los enlaces de salida de ChatGPT reciben utm_source=chatgpt.com de forma automática. Es decir, la única evidencia de primera parte de que hubo clic está en tu propia analítica. Configura el filtro con antelación, antes de necesitarlo.
Y deja claro qué mide: es atribución de tráfico por clic, no una medida de visibilidad. Un producto puede ser recomendado muchas veces y no recibir ni un clic, y un producto no elegible no se puede clicar en absoluto.
Lo que este proceso no controla
No controla el orden dentro del conjunto recuperado del feed. La especificación define el contrato de la fila. No define reglas de posicionamiento. Pasar todas las comprobaciones de campos da elegibilidad para ser recuperado, y eso no dice nada sobre cuál de diez filas elegibles se mostrará. El estudio citado al principio mide la fuente de la recuperación, no la posición dentro del conjunto recuperado.
Las cifras del 10 de julio son observacionales y de un solo proveedor. Describen un panel de prompts rastreados de Profound, no sesiones reales de compradores ni recorridos de compra. OpenAI no ha confirmado el cambio ni ha divulgado ningún reparto de recuperación. El despliegue de GPT-6 Astra empezó el 3 de septiembre de 2026 y se solapa con la ventana de medición más tardía de ese estudio, lo cual es un factor de confusión real.
Las cifras de concentración arrastran las mismas limitaciones. La subida de las referencias a tiendas del top 10, del 22,5% al 41,8%, y la caída del número de merchants únicos, de 13.524 a 10.607, vienen del mismo panel. Y la conclusión de que los cambios en la fuente de recuperación explican el 83% de la variación de visibilidad en 517 clientes que se movieron es una proporción explicativa dentro del panel, no un coeficiente causal sobre el que basar una planificación.
Algunas afirmaciones que circulan por blogs de proveedores no están en la especificación. Trata cada una con cautela.
Afirmación | Fuente | Situación |
|---|---|---|
El feed se actualiza cada 15 minutos, 96 veces más rápido que a diario | Blog de proveedor | No está en la especificación de OpenAI, que no fija cadencia |
El feed es una instantánea completa, no una actualización incremental | Un proveedor que no cita documentación de OpenAI | Sin resolver. Acláralo en el onboarding |
Hace falta una muestra de unos 100 productos | Blog de proveedor | La ayuda de OpenAI menciona el envío de un feed de muestra o completo, sin cantidad |
El envío es por SFTP | Una fuente dice SFTP, otra dice envío HTTPS cifrado | Las fuentes se contradicen. El mecanismo se define en el onboarding |
| Una única fuente agregada | No están en la lista de campos de la especificación. Los campos de reseñas de la especificación son |
Los feeds estructurados convierten unas dos veces mejor que los datos raspados | Afirmación de proveedor sin fuente | No lo des por sentado |
No controla cómo se presentará tu texto. ChatGPT puede generar títulos y descripciones de producto simplificados. Y los resultados de compras los selecciona ChatGPT de forma independiente, no son publicidad. Eso responde a una pregunta sobre influencia comercial, no sobre la fuente de la recuperación. Si quieres presencia de pago, OpenAI tiene una vía publicitaria aparte construida a partir de feeds de producto: es otro flujo de trabajo y queda fuera del alcance de este artículo.
Preguntas frecuentes
¿Se puede enviar hoy un feed de productos a ChatGPT?
Por tu cuenta, no. El acceso se confirma merchant a merchant, el pago es una integración que se activa por separado y la carga estándar está orientada hoy a Estados Unidos. El registro solo concede el nombre visible del merchant, y puedes estar en el estado "registrado pero sin acceso de carga". Ejecuta la comprobación de acceso en cuatro preguntas de arriba para ver dónde estás.
¿Con qué frecuencia debo actualizar el feed?
La especificación no trae cadencia. Dos blogs de proveedores afirman que cada 15 minutos, pero esa cifra no está en la documentación de OpenAI. La respuesta práctica es actualizar a partir de los dos eventos que la especificación exige mantener al día: precios y disponibilidad.
¿Envío el archivo entero o solo las filas que cambian?
Sin resolver. Un proveedor afirma que es una instantánea completa y no cita documentación de OpenAI. Acláralo en el onboarding antes de montar un pipeline que dependa de cualquiera de las dos respuestas.
¿Es cierto el requisito de una muestra de 100 productos?
La ayuda de OpenAI menciona el primer envío de un feed de muestra o completo, sin citar cantidad. El número 100 viene de un blog de proveedor. Si vas a preparar una muestra, cubre casos representativos de cada grupo de campos opcionales en lugar de perseguir una cifra concreta.
¿Un buen feed subirá el posicionamiento de mis productos en los resultados de compra de ChatGPT?
En el sentido en que suele hacerse esa pregunta, no. El feed hace que un producto sea elegible y describible. El orden dentro del conjunto recuperado no está documentado, y la investigación pública disponible mide la fuente de la recuperación, no el posicionamiento. Trata el cumplimiento de campos como un requisito previo, no como una palanca.
Vendo en Shopify. ¿Necesito este proceso?
Para la integración básica, no. Los datos de producto llegan a ChatGPT a través de Shopify Catalog sin trabajo adicional del merchant. Un feed directo existe por la frescura y por los campos que no se envían por defecto.
Autor: Eva Laurent, estratega de búsqueda en ecommerce en Auspia, con más de 10.000 páginas de producto a sus espaldas. Escribe sobre búsqueda en ecommerce, descubrimiento de productos y cómo los datos de producto llegan a las superficies de comercio con IA.