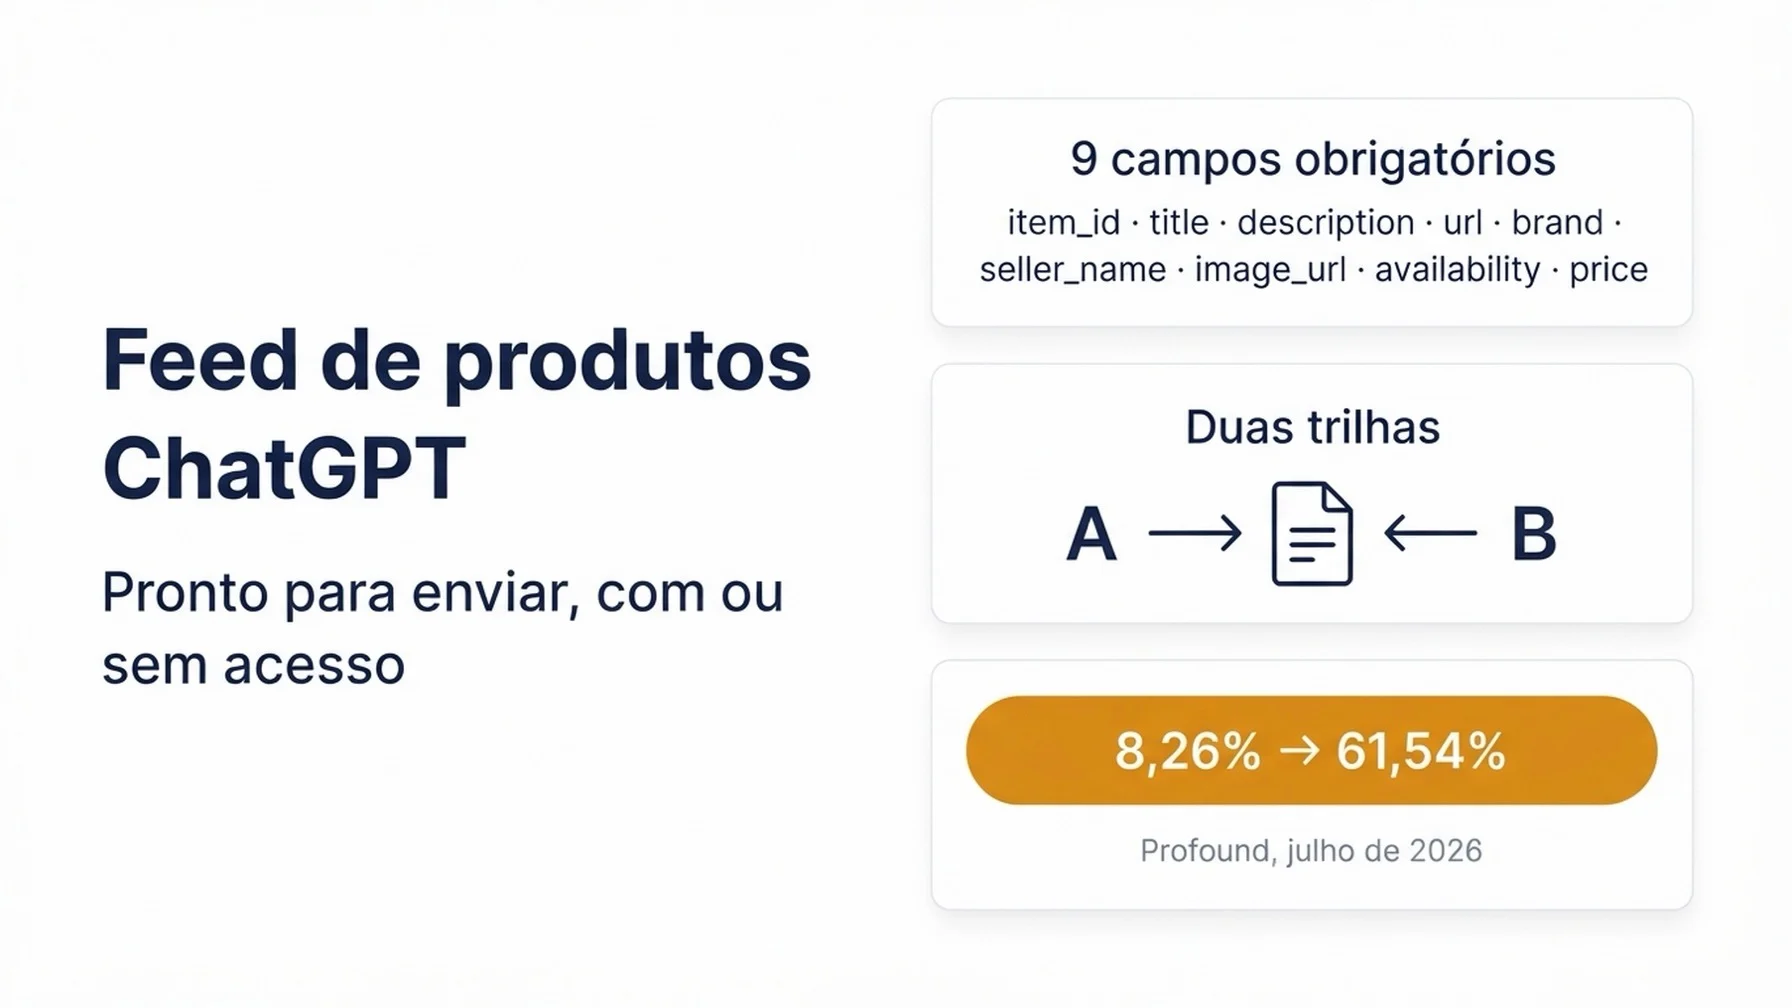
Em julho de 2026, as recomendações de compras do ChatGPT trocaram de fonte principal. Se o seu catálogo não acompanhou essa mudança, otimizar as páginas de produto não compensa. Este fluxo de trabalho leva o catálogo até um estado verificado e pronto para envio. Ele funciona tenha você acesso ao feed hoje ou não.
Para quem é | Profissionais de SEO de e-commerce, operadores de feed e líderes de operações de merchant responsáveis por catálogos de aproximadamente 500 a 100.000 SKUs |
O que você termina com | Um arquivo de produtos aprovado nas nove verificações de campos obrigatórios, mais uma lista de exceções nomeando o responsável por cada SKU bloqueado |
Pré-requisitos | Conseguir exportar o catálogo em CSV, TSV ou JSONL. Um diretório de staging. Capacidade de editar o |
Sobre o acesso | Talvez você não consiga enviar um feed hoje. O programa de feeds da OpenAI é por convite, o checkout é uma integração habilitada separadamente, e o upload padrão hoje é voltado aos Estados Unidos. Ainda assim, este fluxo de trabalho produz o arquivo |
Quanto tempo leva | De 4 a 6 horas na primeira passada para um catálogo com menos de 5.000 SKUs. O tempo vai para a auditoria de campos, não para configuração técnica |
Definição de pronto | Toda linha passa nas nove verificações obrigatórias; cada SKU ignorado tem entrada na lista de exceções com responsável nomeado; o crawler de busca da OpenAI consegue solicitar uma URL de produto de exemplo e ler dados reais; a execução pode ser reproduzida a partir da exportação salva |
O que mudou e a única decisão que isso impõe
A OpenAI lançou os modelos ChatGPT 5.6 em 9 de julho de 2026. No dia seguinte, a fatia das recomendações de compras no ChatGPT vindas de feeds de produtos de merchants, em vez da busca aberta na web, saltou de 8,26% para 61,54%. O número vem de um estudo publicado pela Profound, que acompanhou 1.757.723 execuções de prompts de compras no ChatGPT ao longo de julho de 2026. Em um único dia, a recuperação via feed deixou de ser um canal secundário para se tornar a principal.
Esse número é observação de terceiros, não divulgação da OpenAI. A OpenAI não confirmou a mudança de 10 de julho e nunca divulgou qualquer divisão de recuperação. O que os dados sustentam e o que não sustentam eu reuni em uma seção no fim do artigo. Trate a direção com seriedade e a precisão com generosidade.
A direção impõe uma mudança de mentalidade. Os dados de produto agora precisam estar corretos como dados, não apenas como conteúdo. Uma página de produto bem escrita sem o dígito verificador do GTIN é, para um mecanismo de recomendação baseado em feed, um registro que falhou na validação.
Daqui em diante é só fluxo de trabalho. Os números de 10 de julho resistindo ou não ao escrutínio, cada passo aqui vale a pena: um catálogo limpo, completo e legível por máquina se paga em todas as superfícies de comércio que você ainda vai enfrentar.
Identifique em qual trilha você está
O processo se divide em duas trilhas, porque o significado de "pronto" é diferente em cada uma. Você precisa saber onde está antes de começar. A trilha A prova a inclusão no índice. A trilha B prova a prontidão. As duas produzem o mesmo arquivo.
A verificação de acesso em quatro perguntas
Responda com honestidade, uma por uma.
Pergunta | O que conta como prova de "sim" | O que não conta |
|---|---|---|
Você se registrou na OpenAI e recebeu confirmação por escrito do acesso ao feed? | Uma confirmação que nomeia o seu feed | "Eu enviei o formulário de interesse" |
Seu catálogo tem como alvo o mercado americano? | Confirmação de que o escopo atual de upload padrão cobre você | Presumir que o seu mercado está incluído |
A integração de checkout está habilitada separadamente? | Confirmação explícita durante o onboarding | Você mesmo ter marcado a flag |
Você enviou um arquivo de teste ou completo e recebeu resposta de recebimento? | Uma resposta que menciona o seu envio | Enviar e não ouvir nada |
Se alguma resposta não tiver nada que você possa "apontar", você está na trilha B. Esse é o estado padrão, não uma derrota. Duas ressalvas importantes: ativar as flags de elegibilidade não conclui a integração de checkout, e o registro concede apenas o nome de exibição do merchant, nada mais do que se relaciona ao feed.
Trilha A: acesso ao feed confirmado
Você recebe uma lista de campos específica do seu registro e um canal de envio confirmado no onboarding. O mecanismo de envio em si é definido no onboarding. Se é SFTP ou envio HTTPS criptografado para um endpoint permitido, as descrições públicas de fornecedores divergem. Não construa um pipeline na versão de ninguém até a OpenAI dizer qual se aplica a você.
Trilha B: ainda sem acesso, e o que não se perde
Três coisas estão abertas hoje sem permissão alguma: acesso de crawler, dados estruturados e qualidade de descrição nas páginas de produto, e um arquivo verificado e pronto para envio. O trabalho de catálogo no meio deste artigo não tem portão nenhum. Monte e valide o arquivo agora e, no dia em que tiver acesso, envie o que já passa.
Se você está no Shopify, os dados de produto chegam ao ChatGPT pelo Shopify Catalog sem trabalho extra do merchant. Um feed direto existe por causa da atualidade e dos campos que não são enviados por padrão. Uma ressalva: uma fonte secundária situa essa integração em março de 2026, mas a data não está confirmada, então trate como assunto para perguntar, não como base para um plano.
Abra a porta para o crawler que lê seus produtos
Este é o primeiro passo que rende nas duas trilhas imediatamente, e a vitória mais barata.
Abra o robots.txt e verifique as diretivas para os agentes da OpenAI. O que importa para a visibilidade de produtos é o OAI-SearchBot. Se ele estiver bloqueado, seu conteúdo não aparece nos resultados de produtos do ChatGPT, por mais limpo que o feed esteja. Ele não é usado para treinar modelos, então bloqueá-lo não protege nada.
Quatro nomes de agente precisam de avaliação explícita.
Agente | Função | Efeito na visibilidade de produtos |
|---|---|---|
| Indexa conteúdo para as superfícies de busca | Bloquear esconde produtos independentemente da qualidade do feed |
| Busca páginas quando o usuário pergunta sobre elas diretamente | Bloquear quebra a leitura de páginas em tempo real |
| Crawler de treinamento | Não tem relação com visibilidade em compras |
| Navegação agêntica | Afeta o caminho de checkout via agente |
A verificação de qualidade mais importante aqui não é o `robots.txt`. É se o crawler autorizado consegue chegar e ler alguma coisa. Solicite uma URL de produto representativa com o user agent do crawler e inspecione o corpo da resposta. Se voltar só um shell de aplicação sem título, preço, disponibilidade e descrição renderizados no servidor, o acesso foi bem-sucedido e não devolveu nada útil. Muitas vitrines renderizam dados de produto só no cliente, e essas lojas ficam invisíveis no caminho de descoberta sem feed, diga o que disser o arquivo de robots.
Dá para rodar essa checagem no OpenAI search crawler simulator da Auspia, que solicita páginas públicas em nome do crawler da OpenAI e mostra o quanto dá para ler.
Se não conseguir resolver. Se o robots.txt estiver travado por plataforma ou agência, registre a solicitação de alteração com data e siga em frente. Este passo não é um bloqueio, ele vira evidência para os registros da trilha B.
Torne as páginas de produto legíveis por máquina
O feed não é o único caminho até as recomendações de compras, e para merchants na trilha B ele nem está disponível agora. Os dados estruturados na página estão.
Adicione dados estruturados Product em JSON-LD a todos os templates de produto e gere-os a partir da mesma fonte que alimenta a exportação do catálogo. Essa segunda parte é o que as equipes deixam passar. Se o schema é mantido à mão no tema e o feed vem de um PIM, em um trimestre os dois divergem, e sinais conflitantes de preço e disponibilidade são piores do que sinal nenhum.
Inclua no mínimo name, description, image, SKU, brand e um bloco offers com price, price currency e availability. Os valores precisam bater com os que entram no feed. Se o catálogo tiver GTIN, condition, material, color, size, dimensions, inclua também, porque são esses atributos que as consultas conversacionais realmente usam.
Verificação de qualidade. Pegue uma URL de produto de cada uma das três categorias mais diferentes entre si e verifique pelo mesmo caminho de renderização que o crawler vê, não por um navegador com sessão iniciada.
Se não conseguir resolver. Se a plataforma não permitir injetar JSON-LD nos templates de produto, adicione pelo gerenciador de tags e registre como dívida técnica. Funciona, mas é frágil, e alguém precisa ser dono de removê-la.
Reescreva as descrições para consultas conversacionais
Este passo é onde a disciplina clássica de SEO começa a atrapalhar.
Descrições de catálogo costumam ser escritas para cobertura de palavras-chave e para convencer na prateleira: história da marca, um título cheio de termos, uma lista de benefícios. Consultas conversacionais em compras são bem diferentes. Alguém pergunta por "teclado mecânico silencioso até 150 dólares para escritório aberto", e o que responde isso é nível de ruído, tipo de switch e fator de forma. Para esses atributos serem extraídos, eles precisam existir como fato.
Escreva a descrição do produto como uma especificação de fatos, com uma abertura humana curta. Uma frase sobre o que é e para quem. Depois atributos sem adjetivo de marketing. "Peso: 780 g" é melhor que "construção incrivelmente leve". Se fizer uma afirmação, faça-a específica e verificável.
Antes de investir pesado aqui, vale saber de uma coisa. A documentação de compras da OpenAI diz que o ChatGPT pode gerar títulos e descrições de produto simplificados. Seu texto é entrada para as recomendações, não saída garantida. Escreva dados limpos e baseados em fatos, e aceite que a superfície pode reformular.
Verificação de qualidade. Pegue os dez produtos mais vendidos e, para cada um, escreva os quatro atributos que um comprador precisa para decidir. Se a descrição tem menos de três, ela não está fazendo o trabalho.
Se não conseguir resolver. Se as descrições vêm de um feed de fornecedor fora do seu controle, reescreva à mão os 10% que mais vendem e deixe a cauda longa vir depois. Cobertura parcial é melhor que um projeto travado.
Escreva o contrato de campos antes de tocar na primeira linha
Aqui começa o feed em si. Antes de qualquer exportação, defina o que significa "correto" uma única vez. Isso transforma a auditoria de uma discussão em um procedimento mecânico.
Os nove campos obrigatórios e onde cada um quebra
Os nove são necessários em todas as linhas. Esta tabela é o contrato.
Campo | Formato aceito | Erro mais comum | Consequência |
|---|---|---|---|
| String estável e única para o produto ou a variação | Reutilizar entre variações ou regenerar a cada exportação | Linhas duplicadas e registros órfãos |
| Texto simples, aproximadamente até 150 caracteres | Cortar no meio de uma palavra, ou colocar preço no nome | Linha rejeitada ou mal correspondida |
| Texto simples, até 5.000 caracteres | Sobras de HTML ou markdown vindas do CMS | Linha rejeitada |
| URL da página do produto | Parâmetros de rastreamento ou URL que redireciona | Linha que não leva a nada |
| String com o nome da marca | Ausência total em SKUs sem marca | Linha rejeitada |
| String com o nome do merchant | Grafia inconsistente no catálogo inteiro | Sinal de merchant enfraquecido |
| URL direta da imagem | Placeholder, ou URL que exige sessão | Linha sem visual |
| Apenas | Valores caseiros do vocabulário do armazém | Linha rejeitada |
|
| Separadores de milhar, ou número sem moeda | Linha rejeitada |
Dois campos merecem destaque extra, porque falham em silêncio e levam junto a linha inteira de produtos.
availability aceita exatamente cinco valores. Ausente, vazio ou não reconhecido rejeita a linha. Se a sua plataforma exporta IN STOCK, available ou 1, todas essas linhas caem. Mapeie o vocabulário interno para os cinco valores permitidos de forma explícita e mande o que não mapeia para uma fila manual, em vez de virar unknown por padrão. unknown é um valor legítimo, mas é uma escolha deliberada, não uma caixa de resto.
price é valor, um espaço e o código da moeda em maiúsculas. Ou seja, 79.99 USD, não $79.99, não 79,99 USD e não 7.999e1. Sem separador de milhar e sem notação científica.
Regras que rejeitam linhas em silêncio
Há mais quatro restrições que valem embutir no script de verificação.
GTIN. Exatamente 8, 12, 13 ou 14 dígitos, com dígito verificador válido. ISBN-10 não é aceito. Preserve os zeros à esquerda, o que significa manter a coluna como texto em todo lugar por onde ela passa. Esse é o destruidor silencioso mais comum da especificação inteira: planilhas e exportações CSV descartam zeros à esquerda por padrão.
Preço promocional. Precisa ser maior que zero e estritamente menor que o preço normal na mesma moeda. Uma linha promocional em que o preço promocional é igual ao normal, ou em que o normal ficou vazio, não passa.
Comprimento do título. Aproximadamente até 150 caracteres. Ao cortar, corte no limite de palavra.
Campos de data não agendam nada. A especificação diz explicitamente que datas no contrato não agendam mudanças de preço ou disponibilidade. Se você quer que uma promoção vire à meia-noite, seu pipeline precisa enviar os novos valores.
Decida as flags de elegibilidade de propósito
Três flags definem o que acontece com a linha depois que ela passa na validação.
Flag | Padrão quando ausente ou vazio | Papel |
|---|---|---|
|
|
|
| Exige elegibilidade de busca | Para ser |
| Desligado | Controla um caminho separado de tratamento de anúncios |
Elas também podem aparecer como enable_search, enable_checkout e is_eligible_ads. São aliases, então não trate um template com o nome antigo como um campo diferente.
Conselho prático: sincronize is_eligible_search com o sistema que já sabe que um produto foi descontinuado ou está oculto. Se você mantém uma lista separada de "ocultar do canal" e ela não chega ao feed, você está enviando ofertas desatualizadas para as recomendações.
Em que ordem habilitar os grupos opcionais
São cerca de 50 campos opcionais. Vamos ordená-los por retorno por hora de trabalho, não pela ordem da especificação.
- Variações (
group_id,listing_has_variations,variant_dict,offer_id,gtin,mpn). Se você vende roupa, calçado, casa ou qualquer coisa com tamanho e cor, esta é a primeira prioridade. - Informações do item (
condition,product_category,material,color,size,gender,age_group, mais os campos de dimensão e peso). São esses que fazem a correspondência conversacional funcionar. - Mídia (
additional_image_urls). - Devoluções (
accepts_returns,return_deadline_in_days,return_policy). - Avaliações (
review_count,star_rating), maisstore_review_countestore_star_ratingno nível da loja. - Logística, merchant e geografia (
shipping_price,shipping,seller_url,target_countries,store_country). - Campos disponíveis só no onboarding.
marketplace_seller,size_system,accepts_exchanges,is_digital, o par de anúncios (is_ads_eligible,ads_metadata) e o par de checkout (is_eligible_checkout,seller_privacy_policy,seller_tos) exigem confirmação no onboarding. Não são de autoatendimento. Deixe-os para a primeira passada.
Verificação de qualidade. Os nove campos obrigatórios precisam mapear para uma coluna do catálogo que resolva dados reais em pelo menos 95% dos SKUs. Um campo abaixo desse patamar não é uma tarefa de mapeamento, é uma decisão de compras.
Se não conseguir resolver. Se um campo obrigatório não tiver fonte alguma, como brand em uma linha sem marca, pare e resolva a questão de compras com o dono do negócio antes de montar o arquivo. Trabalho de formato não conserta dado que não existe.
Formatos de arquivo que dá para enviar de verdade
Use o formato que a OpenAI confirmar para o seu feed registrado, no onboarding. Fora isso, existe um caminho compatível com o Google que aceita .txt ou .tsv delimitado por tabulação em UTF-8, e .csv delimitado por vírgula, e que suporta gzip como .txt.gz, .txt.gzip, .tsv.gz e .csv.gz.
JSON, planilhas, XML, RSS e Atom não são suportados nesse caminho compatível. Não misture formatos entre linhas, use um formato só na carga inteira.
Normalize os quatro campos que mais quebram linhas
Congele uma exportação
Faça a exportação uma única vez, carimbe a data no arquivo e calcule um hash. Todos os passos seguintes rodam sobre o arquivo congelado. A reprodutibilidade é o que decide se a auditoria te defende quando alguém perguntar, três semanas depois, por que um SKU específico sumiu.
As quatro normalizações
Zeros à esquerda no GTIN. Exporte a coluna como texto, verifique se o comprimento é 8, 12, 13 ou 14 e valide o dígito verificador. A maioria das falhas silenciosas mora aqui.
Formato de preço. Remova separadores de milhar, mantenha o ponto decimal, elimine notação científica e acrescente o código da moeda como token separado. Depois valide com uma expressão regular que aceite apenas ^\d+\.\d{2} [A-Z]{3}$ e mande o resto para a fila.
Mapeamento de disponibilidade. Mapeie o vocabulário interno para os cinco valores permitidos de forma explícita. Conte quantas linhas caíram em cada balde e quantas foram para revisão manual. Uma fila manual grande não significa que o feed está quebrado, significa que o vocabulário do seu armazém precisa de uma tabela de mapeamento.
Limpeza de título e descrição. O título é cortado no limite de palavra aos 150 caracteres. A descrição perde a marcação e é cortada em 5.000 caracteres de texto simples.
Verificação de qualidade. Importe o arquivo normalizado em uma tabela nova e confirme que a coluna de GTIN ainda mostra os zeros à esquerda. É assim que você pega a armadilha da exportação numérica que passa em todas as outras checagens.
Se não conseguir resolver. Se a normalização acontece na plataforma de feed ou no PIM, não confie na mensagem de sucesso. Verifique a saída deles com os mesmos testes.
Verifique cada linha e mantenha uma lista de exceções
Aqui as checagens rodam sobre o arquivo inteiro. Este passo transforma o catálogo em um plano de trabalho.
Nove checagens mecânicas que dá para rodar sem validador
Por linha: os nove campos obrigatórios estão presentes e não vazios; availability está no enum de cinco valores; gtin tem comprimento e dígito verificador corretos; price bate com a forma de valor e moeda; sale_price é estritamente menor que price, maior que zero e na mesma moeda; title não passa de 150 caracteres; description é texto simples com no máximo 5.000 caracteres; url responde 200 e renderiza dados de produto no servidor; image_url aponta para uma imagem real, não um placeholder.
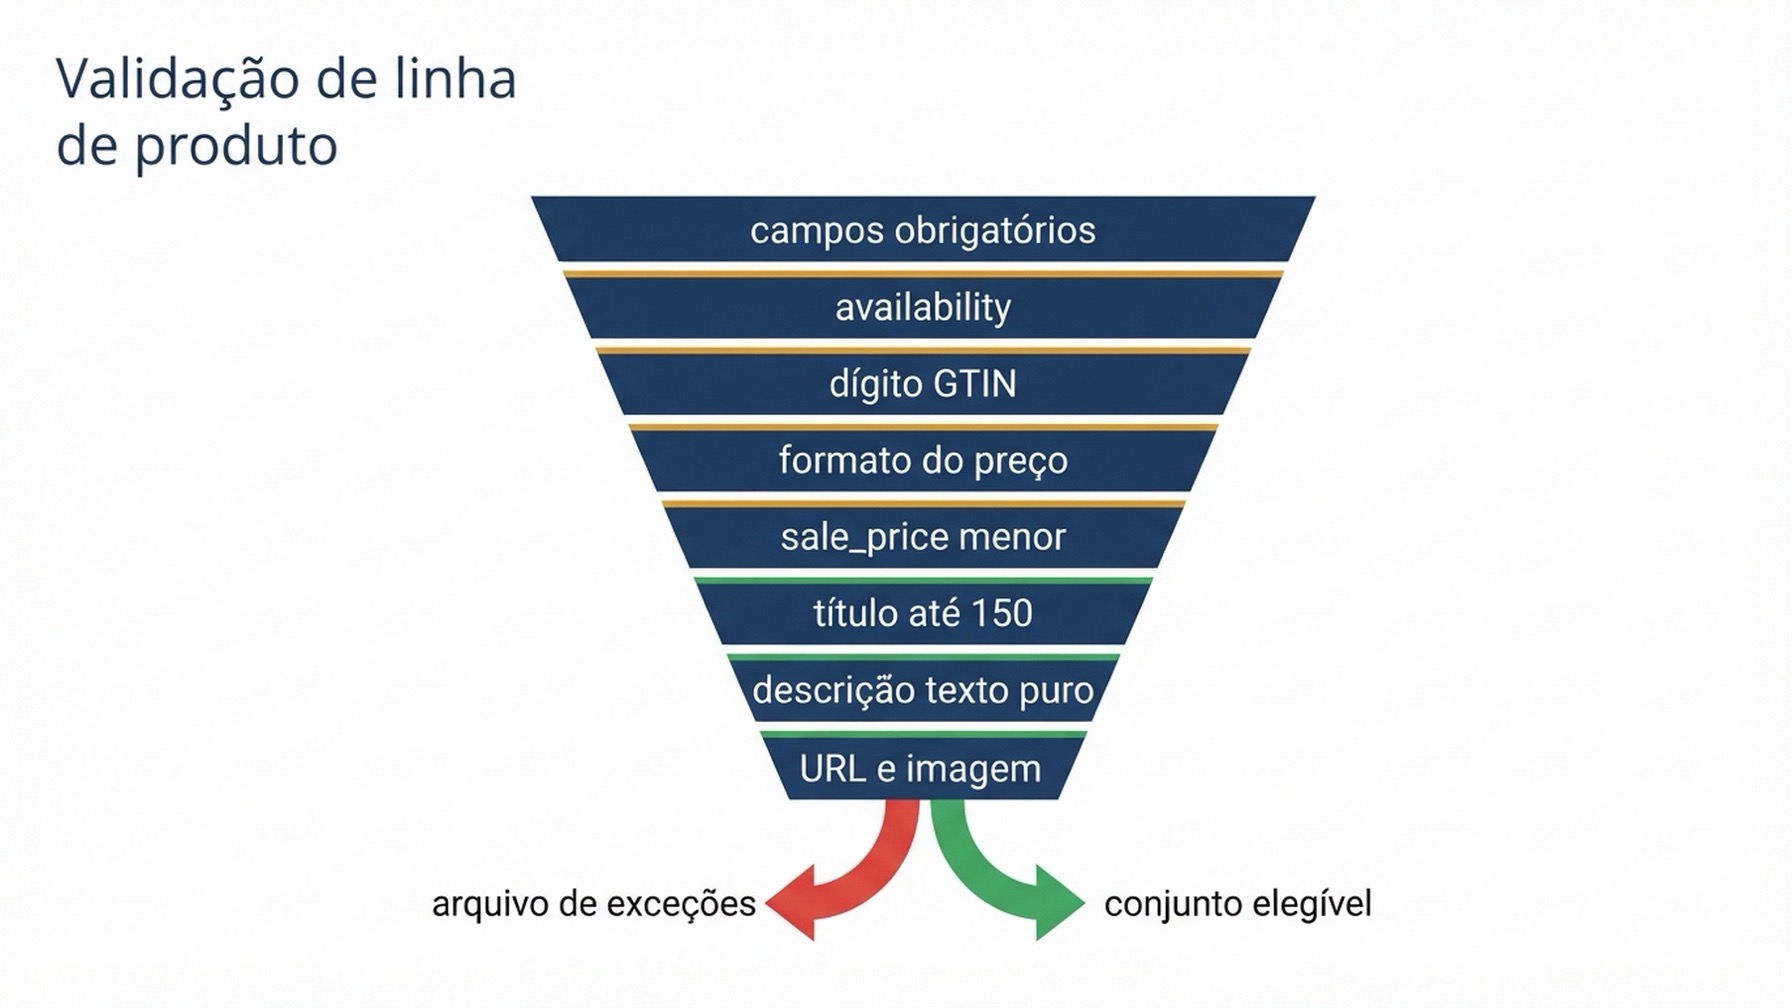
Uma linha ou passa por todos os portões ou cai no arquivo de exceções com o nome do portão que a rejeitou. O portão de availability rejeita mais linhas que qualquer outro: vocabulário caseiro de armazém é a causa mais comum de um catálogo inteiro reprovar.
Faça um arquivo de exceções, não um catálogo perfeito
Duas colunas e um responsável: item_id, o bloqueio e quem corrige.
Verificação de qualidade. Para um catálogo mais ou menos arrumado, o arquivo de exceções deve ficar abaixo de 10% das linhas. Se passar de 30%, o problema está na governança de dados a montante, e o caminho honesto é consertar o sistema de origem, não remendar o arquivo.
Se não conseguir resolver. Se um campo obrigatório está ausente em uma categoria inteira de produtos, e não em SKUs isolados, trate como decisão de compras com o dono do negócio. Não transforme essas linhas em unknown para passar na auditoria. unknown é um valor legítimo com um significado específico, e usá-lo para passar numa checagem é sujar os próprios dados.
Uma ressalva honesta sobre atualizações. A especificação não define cadência de atualização e não diz se o feed é um snapshot completo ou uma atualização incremental. Descrições públicas de fornecedores afirmam as duas coisas com confiança, e nenhuma delas está na documentação da OpenAI. A especificação exige de fato enviar os preços atuais, atualizá-los no início e no fim de uma promoção, e atualizar a disponibilidade quando um item esgota ou volta. Construa o pipeline em torno desses dois eventos e esclareça a cadência no onboarding.
Valide o arquivo do jeito que a plataforma vai validar
Reparsa exatamente os bytes que você vai enviar, no formato que vai usar, e conte quantas linhas entram e quantas saem.
Isso pega as falhas que a planilha esconde. Um arquivo que abre bonito no Excel e um arquivo que parseia como CSV não são a mesma coisa: delimitadores ou quebras de linha não escapados dentro do campo de descrição parecem normais na tela e quebram o parsing.
Verificação de qualidade. A contagem de linhas na entrada e na saída bate, e as checagens automáticas concordam com a auditoria manual. Se discordarem, um dos lados está errado, e normalmente é o manual.
Se não conseguir resolver. Problemas de codificação quase sempre se resolvem reexportando em UTF-8. Problemas de aspas quase sempre são um delimitador não escapado ou uma quebra de linha sobrando na descrição.
Se a equipe tem um agente que escreve código, este é o único lugar em que um script pequeno se paga: ele transforma a auditoria de um projeto trimestral em uma nova execução.
Verifique se funcionou
O que você consegue provar depende da trilha. Aqui vale ser preciso e não borrar a diferença.
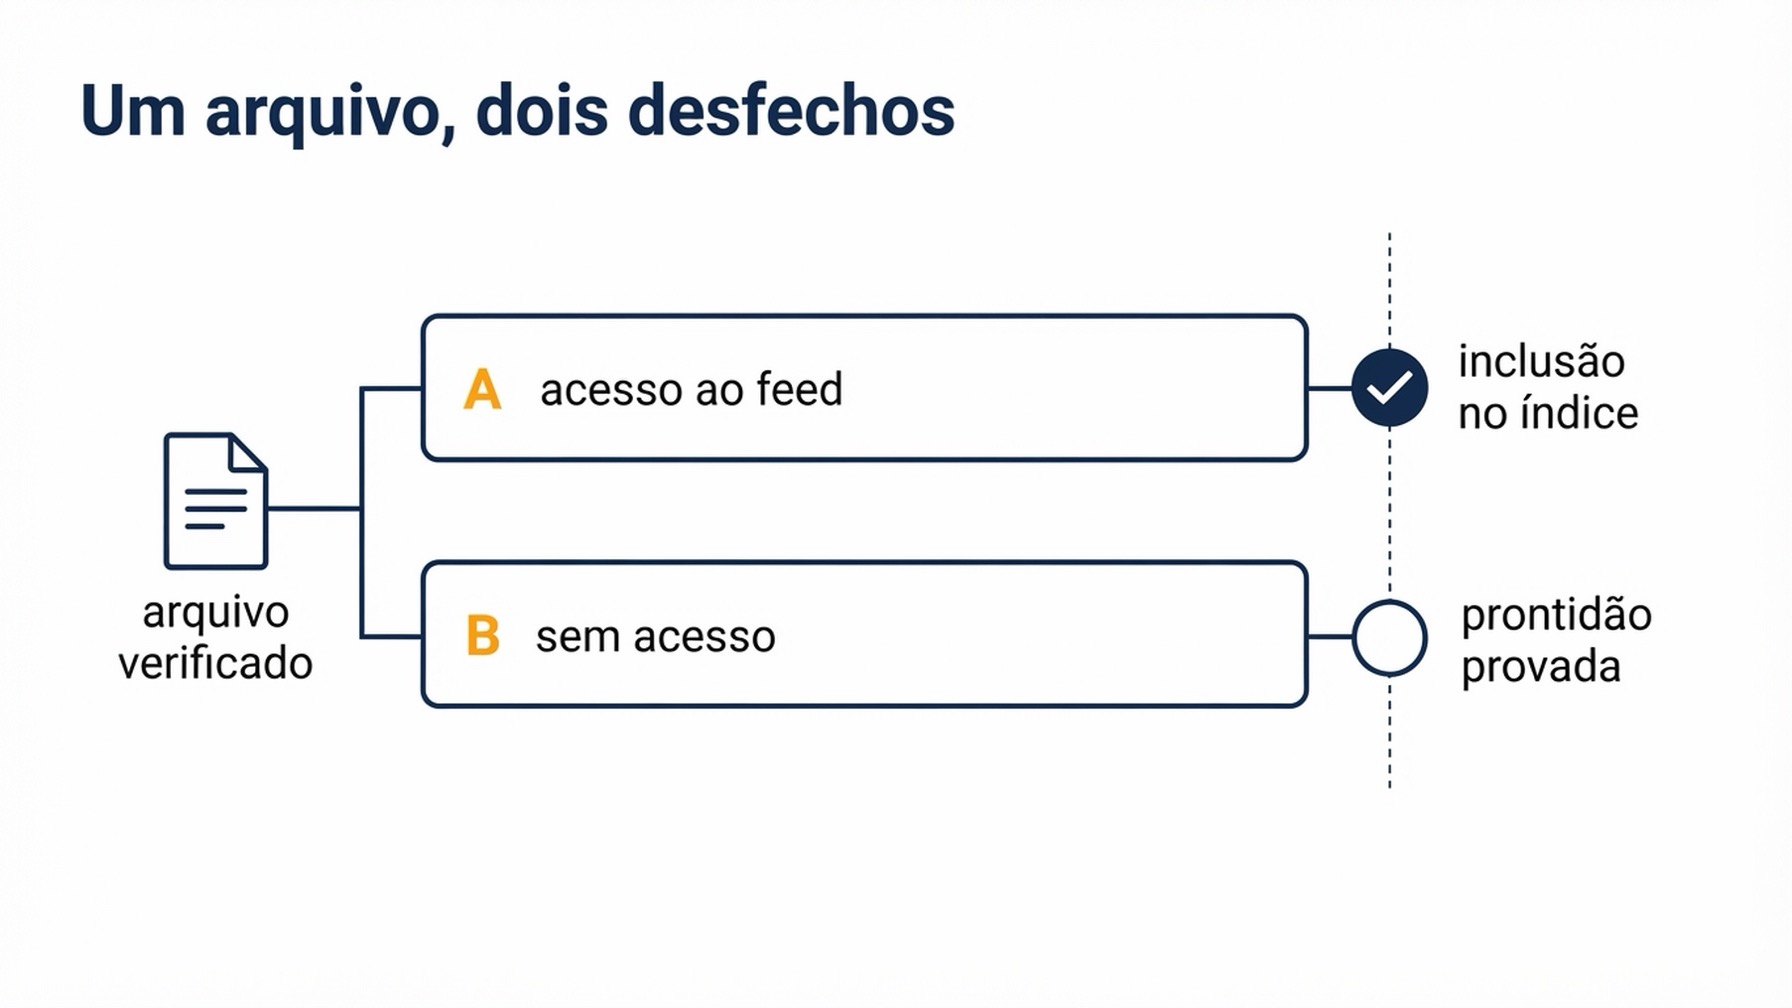
A trilha A prova a inclusão no índice. A trilha B prova a prontidão. Nem a trilha nem a bifurcação mudam o arquivo, e é por isso que vale montá-lo antes de ter acesso.
Se você tem acesso (trilha A)
Quatro checagens. O envio foi aceito. O relatório de rejeição por linha foi lido e cada rejeição foi corrigida ou documentada. Uma busca em compras passou a mostrar um dos seus produtos. Os logs do servidor mostram um agente de recuperação solicitando a URL do seu produto.
Se você não tem acesso (trilha B)
Quatro checagens. A solicitação de robots.txt retorna uma URL de produto para o OAI-SearchBot. A renderização no servidor dessa URL traz título, preço, disponibilidade e descrição. A auditoria de nove pontos passa. E a exportação congelada e a execução das checagens estão guardadas onde a próxima pessoa consegue reproduzi-las.
Prontidão é um resultado real e falseável. Mas não é a mesma coisa que inclusão no índice, e não vale relatá-la como se fosse.
Um último número que importa
Links de saída do ChatGPT recebem utm_source=chatgpt.com automaticamente. Ou seja, a única evidência de primeira parte de que houve clique está na sua própria análise. Configure o filtro com antecedência, antes de precisar dele.
E deixe claro o que ele mede: é atribuição de tráfego por clique, não uma medida de visibilidade. Um produto pode ser recomendado muitas vezes e nunca ser clicado, e um produto inelegível não pode ser clicado de jeito nenhum.
O que este processo não controla
Ele não controla a ordem dentro do conjunto recuperado do feed. A especificação define o contrato da linha. Não define regras de ranqueamento. Passar em todas as checagens de campo dá elegibilidade para ser recuperado, e isso não diz nada sobre qual de dez linhas elegíveis será exibida. O estudo citado no início mede a fonte da recuperação, não a posição dentro do conjunto recuperado.
Os números de 10 de julho são observacionais, de um único fornecedor. Eles descrevem um painel de prompts rastreados da Profound, não sessões reais de compradores nem jornadas de compra. A OpenAI não confirmou a mudança e não divulgou nenhuma divisão de recuperação. O lançamento do GPT-6 Astra começou em 3 de setembro de 2026 e se sobrepõe à janela de medição mais tardia daquele estudo, o que é um confundidor real.
Os números de concentração carregam as mesmas limitações. A alta nas referências a lojas do top 10, de 22,5% para 41,8%, e a queda no número de merchants únicos, de 13.524 para 10.607, vêm do mesmo painel. E a conclusão de que mudanças na fonte de recuperação explicam 83% da variação de visibilidade em 517 clientes que se moveram é uma parcela explicativa dentro do painel, não um coeficiente causal no qual basear planejamento.
Algumas afirmações que circulam em blogs de fornecedores não estão na especificação. Trate cada uma com cautela.
Afirmação | Fonte | Situação |
|---|---|---|
O feed atualiza a cada 15 minutos, 96 vezes mais rápido que o diário | Blog de fornecedor | Não está na especificação da OpenAI, que não define cadência |
O feed é um snapshot completo, não uma atualização incremental | Um fornecedor que não cita documentação da OpenAI | Não resolvido. Esclareça no onboarding |
É preciso uma amostra de cerca de 100 produtos | Blog de fornecedor | A ajuda da OpenAI menciona envio de feed de amostra ou completo, sem quantidade |
Envio por SFTP | Uma fonte diz SFTP, outra diz envio HTTPS criptografado | As fontes se contradizem. O mecanismo é definido no onboarding |
| Uma fonte agregadora | Não estão na lista de campos da especificação. Os campos de avaliação na especificação são |
Feeds estruturados convertem cerca de duas vezes melhor que dados raspados | Afirmação de fornecedor sem fonte | Não tome como dado |
Ele não controla como o seu texto será apresentado. O ChatGPT pode gerar títulos e descrições de produto simplificados. E os resultados de compras são selecionados pelo ChatGPT de forma independente, não são anúncios. Isso responde a uma pergunta sobre influência comercial, não sobre a fonte da recuperação. Se você quer exibição paga, a OpenAI tem um caminho de anúncios separado, construído a partir de feeds de produtos: é outro fluxo de trabalho e está fora do escopo deste artigo.
Perguntas frequentes
Dá para enviar um feed de produtos para o ChatGPT hoje?
Por conta própria, não. O acesso é confirmado por merchant, o checkout é uma integração habilitada separadamente, e o upload padrão hoje é voltado aos Estados Unidos. O registro concede apenas o nome de exibição do merchant, e você pode estar no estado "registrado, mas sem acesso de upload". Rode a verificação de acesso em quatro perguntas acima para ver onde você está.
Com que frequência devo atualizar o feed?
A especificação não traz cadência. Dois blogs de fornecedores afirmam a cada 15 minutos, mas esse número não está na documentação da OpenAI. A resposta prática é atualizar a partir dos dois eventos que a especificação exige manter atuais: preços e disponibilidade.
Envio o arquivo inteiro ou só as linhas alteradas?
Não resolvido. Um fornecedor afirma que é um snapshot completo e não cita documentação da OpenAI. Esclareça no onboarding antes de construir um pipeline que dependa de qualquer das respostas.
O requisito de amostra de 100 produtos é verdadeiro?
A ajuda da OpenAI menciona o primeiro envio de feed de amostra ou completo, sem citar quantidade. O número 100 vem de um blog de fornecedor. Se for preparar uma amostra, cubra casos representativos de cada grupo de campos opcionais em vez de perseguir um número específico.
Um feed bom vai subir o ranqueamento dos meus produtos nos resultados de compras do ChatGPT?
No sentido que essa pergunta costuma ter, não. O feed torna um produto elegível e descritível. A ordem dentro do conjunto recuperado não é documentada, e as pesquisas públicas disponíveis medem a fonte da recuperação, não o ranqueamento. Trate a conformidade de campos como pré-requisito, não como alavanca.
Vendo no Shopify. Preciso deste processo?
Para a integração básica, não. Os dados de produto chegam ao ChatGPT pelo Shopify Catalog sem trabalho extra do merchant. Um feed direto existe por causa da atualidade e dos campos que não são enviados por padrão.
Autor: Eva Laurent, estrategista de busca em e-commerce da Auspia, com mais de 10.000 páginas de produto no currículo. Escreve sobre busca em e-commerce, descoberta de produtos e como os dados de produto chegam às superfícies de comércio com IA.