「エージェントSEOをやっています」と言うチームのほとんどは、実態としてチャット画面に長いプロンプトを貼っているだけです。それで最初の1回はうまくいきます。問題は2回目です。出力の形が変わり、データは1週間前のままで、数値が動いたのかプロンプトがぶれたのか、誰にも判別できなくなります。
長く使えるやり方は、1点だけ明確に違います。手順がメッセージではなくファイルの中に住んでいることです。手順を一度書いてエージェントに渡せば、こちらが指示し忘れていても、同じチェックが毎回必ず走ります。
それがこの考え方のすべてです。ここからは、その組み立て方、どの作業にどのエージェントを向けるか、そしてどこで静かに壊れるかを扱います。
「エージェント型」が実際に変えるもの
自動化できるものは3つあり、それらは同じものではありません。
ワークフロー自動化 | AI支援型SEO | エージェントSEO | |
|---|---|---|---|
手順を決めるのは誰か | あなたが事前に決める | あなたが会話ごとに決める | あなたが一度、文書化した手順として決める |
データの出どころ | 組み込みの連携 | あなたが貼り付けたもの | エージェント自身が取得する |
想定外の入力が来たら | 壊れる | 言い回し次第 | 決めたルールに従うか、エスカレーションする |
実行ごとの一貫性 | 完璧だが融通が利かない | 低い | 高く、かつ適応できる |
向いている用途 | 大量で変化のない作業 | 探索や単発の質問 | 判断を伴う定常的な分析 |
実務上の違いは、あなたがやらなくなる作業に現れます。チャット型のワークフローでは、サイト、読者、優先順位のルール、出力形式を毎回説明し直します。その説明し直すたびに、どれか一つを忘れる余地が生まれます。エージェント型では、それらはエージェントが毎回読むファイルの中にあり、プロンプトは「9月分のコンテンツ劣化チェックを実行して」の一行に縮みます。
ただしコストもあります。その作業が毎回本当に違うのであれば、書き留めるべき手順は存在せず、作るだけ無駄な overhead になります。5万件のURLのステータスコードを確認するのは、スクリプトの仕事であってエージェントの仕事ではありません。判断の分かれ目は、その作業が繰り返すかどうか、そして判断を必要とするかどうかです。両方に当てはまればエージェント型の勝ちです。どちらかが外れていれば、手を出さないほうがいい。
4つのレイヤーと、それぞれの役割
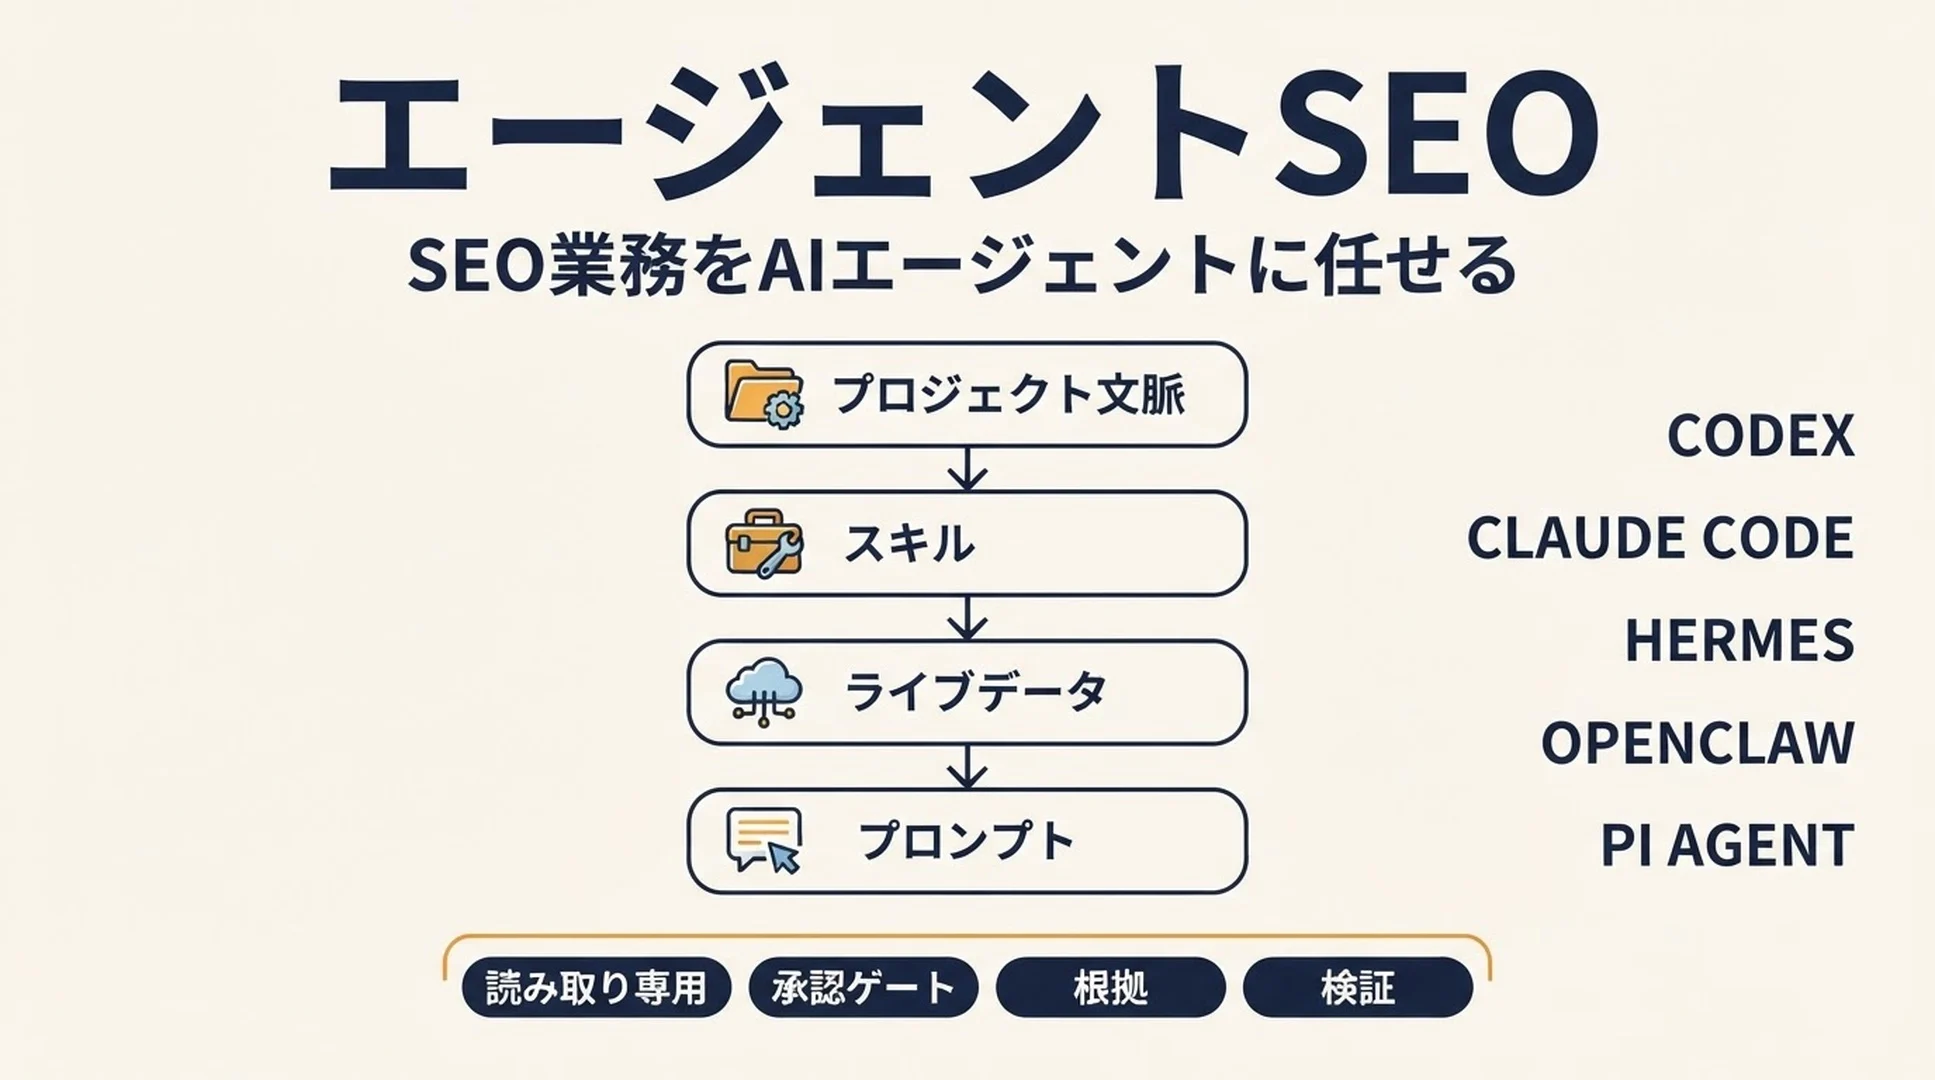
生き残るエージェントSEOの構成には、必ず同じ4つの部品があります。1つでも欠けると、決まった形の失敗が起きます。
プロジェクト文脈。変わらないものを入れておくフォルダです。サイト、対象市場、誰がなぜ買うのか、何をコンバージョンと呼ぶのか、本当の競合は誰か、編集ルール。これが、エージェントがビジネスを理解しないまま一般論を書くのを止めます。このレイヤーを飛ばすと、自信満々で、もっともらしくて、役に立たない出力が返ってきます。
スキル。文書化された手順です。それぞれが、いつ使うか、どのデータが必要か、手順の順番、採点ルール、出力形式、そしてどの操作にあなたの承認が必要かを書いています。ワークフローを再現可能にするのがこのレイヤーで、そしてほとんどのチームが飛ばすのもこのレイヤーです。
ライブデータアクセス。エクスポートを待って貼り付けるのではなく、エージェントが現在の数値を自分で取ってくるための接続です。自社の実績ならSearch Console。行動データならアナリティクス。自社プロパティでは見えない部分ならランキングやSERPのデータソース。ページ単位の事実ならクローラーやCMSへの接続。これがなければ、先月のスプレッドシートで作業する、とても優秀なアナリストが出来上がるだけです。
プロンプト。今回のタスク、それだけです。プロンプトが文脈や手順を運んでいるなら、それらは1番目と2番目のレイヤーに属します。
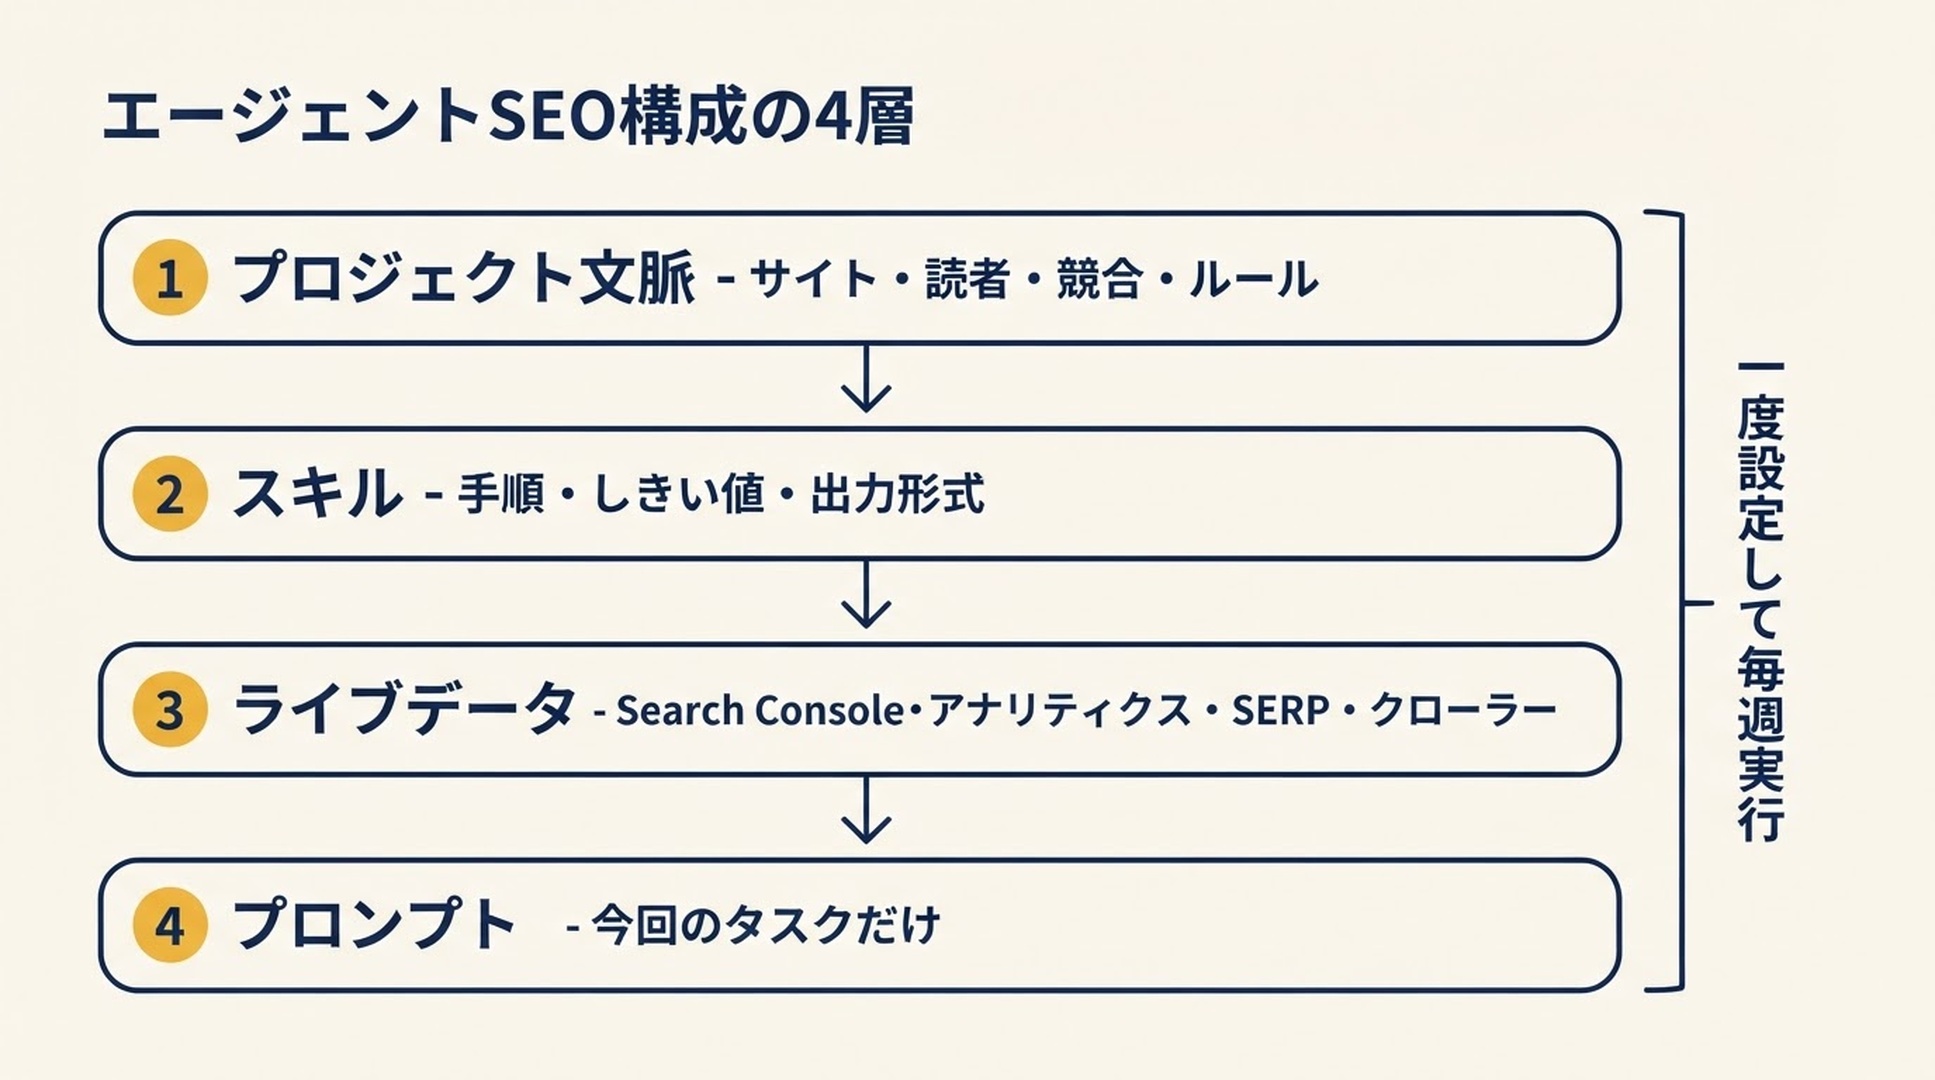
4層を一度整えれば、毎週の実行は一行で済みます。実行結果がおかしいときは、プロンプトを書き直す前にどのレイヤーが失敗したかを確認します。
Auspiaの見解: 4層モデルはこの領域で最も役に立つ考え方であり、同時にほとんどのチームが早すぎる段階で止まる場所でもあります。文脈フォルダだけ作ってスキルを飛ばし、よく情報を持ったチャットボットで終わってしまう。製品なのはスキルのほうです。それ以外は配管です。
どの作業にどのエージェントを向けるか
これが最も多く聞かれる質問ですが、正直に言えば、違いは構成の差ほど重要ではありません。ここに挙げるものは、強く押せばほとんどのSEO作業をこなせます。差が出るのは、それぞれが「最も気まずくない」領域であり、それが3週目にまだ使い続けているかどうかを決めます。
エージェント | 最も得意なこと | アクセスの形 | 最初に向くSEO作業 |
|---|---|---|---|
Codex | リポジトリ作業、定時実行、レビュー可能な差分 | ローカルファイル、ターミナル、git、自動化 | 週次のスナップショットをリポジトリに保存し、レポート付きのプルリクエストを開く |
Claude Code | 明文化された方針に沿った長文コンテキストのレビュー | ターミナル、プロジェクトのメモリファイル、MCP接続 | Search Consoleのエクスポートとページのソースを読み、根拠付きの判定を出す |
Hermes Agent | セッションをまたいで記憶する反復可能なスキル | スキル機構と永続メモリを備えたオープンソースのエージェント | スキルを1つ入れて、同じワークフローを同じ周期で回す |
OpenClaw | 厳格な権限の下でのブラウザ証拠の収集 | まずブラウザ、次にローカルファイル | モバイルで検索結果が実際に何を返すかを取得し、そこで止める |
Pi Agent | 何か月経っても小さく予測可能であり続けること | 最小限のコア、拡張点としてのMarkdownスキル | 何ができるかをすべて監査したい場面で、狭く読める手順を実行する |
2つ注意点があります。この領域は毎月変わるので、チームを一つに決める前に、各ベンダーの公式ドキュメントで現在の制限と価格を確認してください。そしてこの表は出発点であって、上限ではありません。
初心者向けの安全な導入方法は、Codex、Claude Code、Hermes Agent、OpenClaw のそれぞれについて個別のガイドを用意しています。4つとも形は同じです。まず読み取り専用、承認された変更は一度に一つ、出荷前に検証する。
実務的な選び方は、あなたの作業がすでにどこにあるかで決まります。サイトがgitリポジトリにあり、ページの変更がコードの変更であるなら、CodexかClaude Codeから始めます。作業の中心がエクスポート、会話、判断なら、スキルベースのエージェントから始めます。実際のブラウザが何を返すかを見る必要があるなら、ブラウザアクセスと厳格な権限境界が必要です。一息で端から端まで読み切れる最小の面を求めるなら、Pi Agentの最小コアはまさにそのための設計で、代償として必要なものは自分で足すスキルの中に入ります。
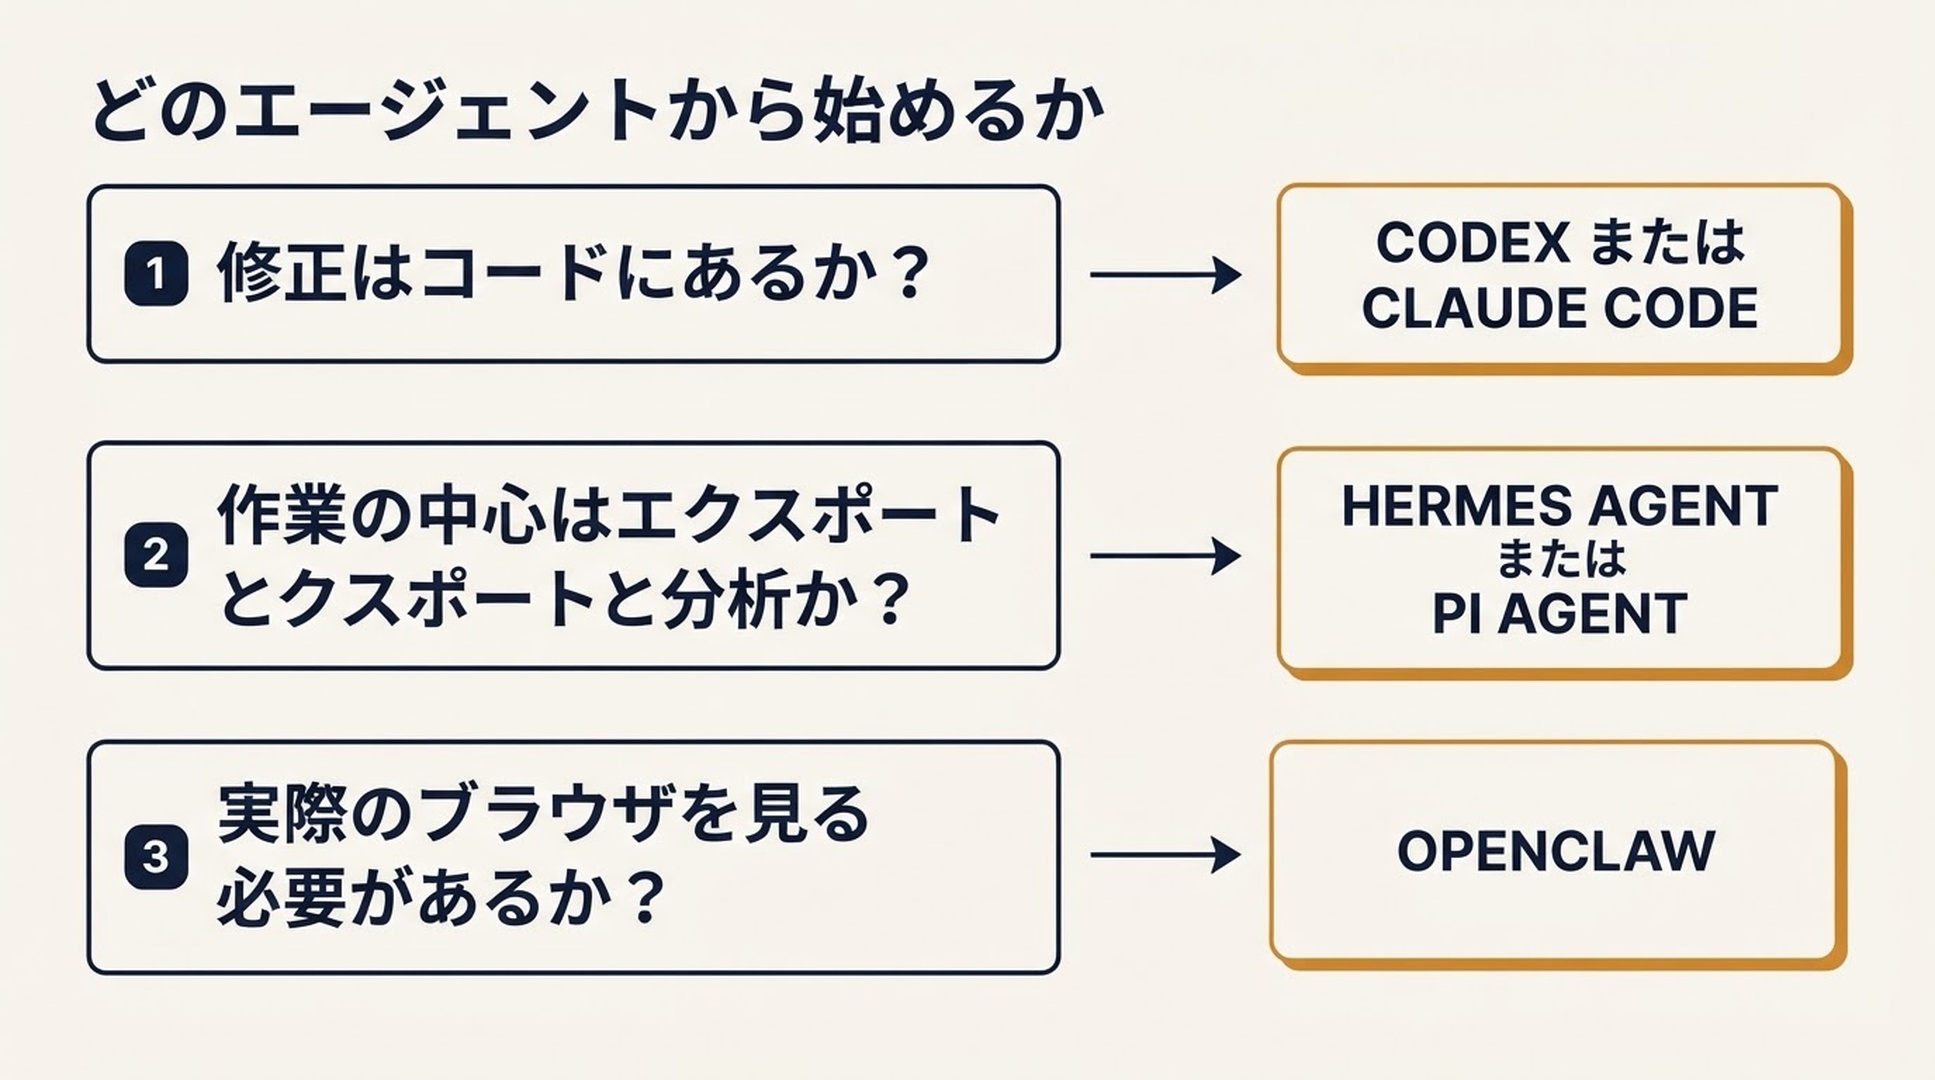
3つの問いで、5つのエージェントは1つに絞られます。機能を比べる前に、まずこの問いに答えてください。
最初に任せる価値のある作業
面白いものから始めないでください。地味で、定期的に繰り返し、人が読む成果物を出すものから始めます。それが最も早く元を取れます。
コンテンツ劣化のトリアージ。前期間比較の実績を取得し、重要度のしきい値を下回るものを落とし、何よりも先にインデックス状況を確認し、そのうえでランキング、需要、リンク、カニバリゼーションを見ます。失ったクリック数、推定原因、その根拠、第一候補と代替のアクションを並べたURLの表が得られます。順位を落としたページは書き直しが必要です。需要を失ったページには何も要りません。canonicalを失ったページは5分で直ります。チームはこの3つを常に取り違えますが、その取り違えは安くありません。
技術的な問題のトリアージ。問題を種類ではなく根本原因でまとめ、影響するURLをトラフィックとランキングに結合し、影響度を工数に対して採点し、修正リストを書く前に上位項目を実際のページで検証します。価値はこのまとめ方にあります。「一時リダイレクト」の10行はたいてい1つの根本原因で、テンプレートを1つ直すほうが10個のURLを直すより効きます。
競合の動き。トラフィック変化の背後にあるページとキーワードを切り出し、指名検索と非指名検索を分け、それぞれの変化を名前の付いた要因(新規コンテンツ、順位改善、季節性、移行、データのアーティファクト)に対して検証します。答えになるのは要因と信頼度です。信頼度が低い大きな数字は、反応する理由ではなく、詳しく見る理由です。
内部リンクと孤立ページ。すでに順位やリンクを獲得しているページから候補を集め、各リンク先に直接関係する箇所を見つけ、読者価値のテストを当てます。この文の途中にいる人が、次にそこへ行きたいと思うか。出力のうち構造に関する半分は、リンクそのものより価値があることが多いです。2番目に大きいページに内部リンクが1本も向いていないと分かれば、5分の修正で大きな効果が出ます。
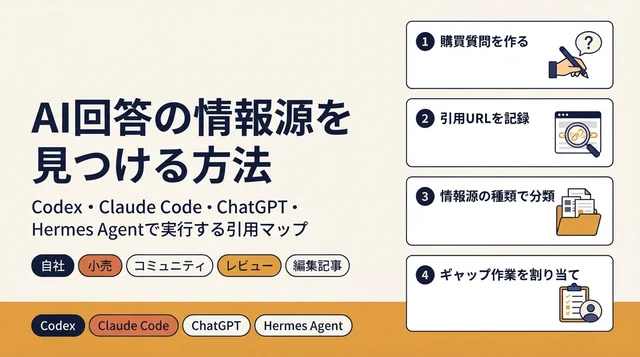
引用ギャップのマッピング。プロンプトをトピックと購買段階でまとめ、最も多く引用されているドメインとページを見つけ、ソースの種類を分け、引用されたページを読んで実際に何が言及を獲得するかを割り出します。出力のかなりの部分は、アプローチしないのが正解のソースになります。フォーラムや競合が所有するプロパティは、売り込み先ではありません。
リリース後のリグレッション確認。リリース前後のクロールを同じ設定で比較し、差分を取る前に比較可能かどうかを確認し、各差分を「想定どおり」「想定どおりだが実装が誤っている」「想定外」に分類します。この分類がレポートを使えるものにします。これがなければ、差分の壁と、判断の不在が残るだけです。
よく出てくるものについては、より詳しい手順を用意しています。週次のランキングレポート、日次のモニタリング、被リンクプロファイルの作業、そして溺れないアラート設計です。
部門ではなく、スキル1つから始める
最も多い失敗は、一度も実行しないうちにスキル8個、接続7個、スケジューラを組み上げてしまうことです。すると何も動かず、16個の部品のどれが原因か分からなくなります。
代わりにこの順番で進めてください。
目に見える成果のある作業を1つ選ぶ。最も早く効果を確認できるのは技術的な問題のトリアージです。すでに持っているクロールに向ければ、数分で結果を判断できます。Search Consoleの履歴があれば、コンテンツ劣化が2番目に簡単です。
何かを接続する前にスキルを書く。スキルファイルは1ページに収まり、6つの問いに答えるべきです。いつ使うか、どのデータが必要か、手順の順番、採点やしきい値のルール、出力形式、そしてどの操作に承認が必要か。1ページに収まらないなら、その作業はまだ自動化できるほど定義されていません。
データソースを1つだけ接続する。そのスキルが実際に必要とするものです。使っていない接続は、価値を足さずに面だけを広げます。
読み取り専用で実行し、出力を手で確認する。2つの所見を取り、元データに対して自分で検証します。エージェントの説明が見ているものと合わないなら、問題はモデルではなくスキルにあります。
2つ目のスキルを足す前に承認ゲートを入れる。すべての書き込み操作(公開、リダイレクト、削除、コード編集、マージ、外部への送信)は止まって待つべきです。まだスキルが1つのうちに、この習慣を定着させてください。
失敗を防ぐガードレール
これは初日にプロジェクト指示へ入れておきたいルールです。意図的に地味にしていますが、そこが要点です。
- 書き込み操作を承認するまで、本番ツールは読み取り専用に保つ。
- 複数ステップのワークフローを始める前に計画を出させる。
- 前提で埋めず、接続されたツールで証拠を取得させる。
- スキルが存在する場合は、即興せずそのスキルに従わせる。
- ツール呼び出しが失敗したら一度だけ再試行し、それでも失敗したら回避せずエラーを表面化させる。
- 各所見について、根拠を一文で説明させる。
- 確定した所見と仮説を、出力の中で分離させる。
- 欠損データや信頼度の低い結論は、穴を埋めずに明示させる。
- 合意したURL、行数、APIユニットの上限を超えたら停止させる。
- 公開、リダイレクト、削除、コード編集、マージ、外部への送信の前に承認を求める。
このうち2つは他より多くの仕事をします。確定した所見と仮説を分けることは、出力を行動に移せる程度に信頼できるものにします。上限は、設定を誤ったループが一晩でAPI予算を焼き尽くすのを止めます。
どこで壊れるか
コンバージョンデータが薄い。すべてのURLを維持、更新、統合、リダイレクト、削除、要調査に分類するコンテンツポートフォリオの判定エンジンは、判断のためにコンバージョンデータを必要とします。計測がきちんと設定されていなければ、ゼロが大量に返り、それが直るまでレポートは役に立ちません。エージェントは仕事をしました。入力が間違っていたのです。
構造の判断。エージェントは、人間が書いたブリーフが見落とした4つの点を見つけられます。たとえば、まったく別種の検索結果を呼び出すためにそのページに置くべきでないキーワードなどです。しかし記事をどう構成するかは決められません。その判断は人間に残ります。そうでないふりをすると、部品から組み立てたような文章が出来上がります。
静かな説明エラー。エージェントはデータの段階では大きな音を立てて失敗し、説明の段階では静かに失敗します。エクスポートが欠けていればエラーが出ます。自信満々の誤った原因は、エラーを出しません。だからこそ、所見ごとの根拠というルールが見た目以上に効きます。
想定していなかったツールの隙間。接続ではまったく届かないデータもあります。ランキングデータの接続は、クロールプロジェクトの作成、クロールの起動、クロール済みURLセットの完全なエクスポートができないことがあります。接続が実際に何を返せるかを前提にワークフローを設計しないと、スキルは途中で止まります。
ループを信頼する前に結果を検証する
最初の3回はこのチェックを実行し、その後は月に一度行います。
- 所見を無作為に2つ選び、元データに対して手で検証する。
- データに依存する主張すべてに、エージェントがソースと日付を明記しているか確認する。
- 少なくとも1つの所見が低信頼とラベル付けされているか確認する。すべてに自信があるエージェントは、見分けがついていません。
- 出力の形が前回と一致するか確認する。ずれているなら、スキルファイルが変わったか、エージェントが従うのをやめています。
- 承認ステップが発火せずに、何かが書かれ、公開され、送信されていないか確認する。
5つすべてが3回連続で通れば、それはワークフローです。どれかが失敗したら、プロンプトを書き直すのではなく、原因となったレイヤーを直してください。
FAQ
エージェントSEOとは何ですか?エージェントSEOとは、定義されたSEOワークフローをAIエージェントに渡し、エージェントが自分でデータを取得し、文書化された手順に従い、実行のたびに同じ形の分析を返すことです。決め手は自律性ではなく再現性です。手順が会話の外にあるため、指示し忘れても同じチェックが適用されます。
AI支援型SEOとはどう違いますか?違いは、次に何が起きるかを誰が決めるかです。AI支援型SEOでは、会話ごとにあなたが手順を選び、データを貼り付けます。エージェントSEOでは、手順を一度定義し、エージェントが自分でデータを取得し、想定外の入力に当たったときは文書化されたルールに従います。ワークフロー自動化は3つ目のもので、一貫性は完璧ですが適応性はありません。
コーディングエージェントは必要ですか?いいえ。CodexやClaude Codeのようなコーディングエージェントは、修正がコード変更である場合や、サイトがリポジトリにある場合に向いています。作業の中心がエクスポート、分析、判断なら、スキルベースのエージェントがターミナルに触れずにカバーします。
最初にスキルをいくつ作るべきですか? 1つです。目に見える成果のある作業を選び、1ページに収まるスキルを書き、必要なデータソースだけを接続し、出力が信頼できるまで読み取り専用で回します。1つも動かさずに8つ作るチームは、たいていプロジェクトを放棄します。
エージェントSEOのワークフローは勝手にコンテンツを公開できますか?できますが、すべきではありません。公開、リダイレクト、削除、コード編集、マージ、外部へのメッセージ送信は、明示的な承認ゲートの後ろに置いてください。ワークフローの価値は、それが組み立てる証拠にあり、与えられた権限にはありません。
運用コストはどれくらいですか?エージェントではなくデータソース次第です。Search Consoleは自社プロパティなら無料です。継続的なコストがかかるのはランキングデータ、SERPデータ、クロールサービスで、そのほとんどには、本格的に契約する前に1つのワークフローを試すのに十分な無料枠があります。
著者: Aaron Wolfe(アーロン・ウルフ)、AuspiaのSEO/GEO領域で15年の経験を持つオーガニック成長システム設計者。AIエージェント、データ、レビューの各ステップを、四半期の計画サイクルをまたいで機能し続ける検索ワークフローにどう組み込むかを執筆しています。