讀完這篇你會得到什麼
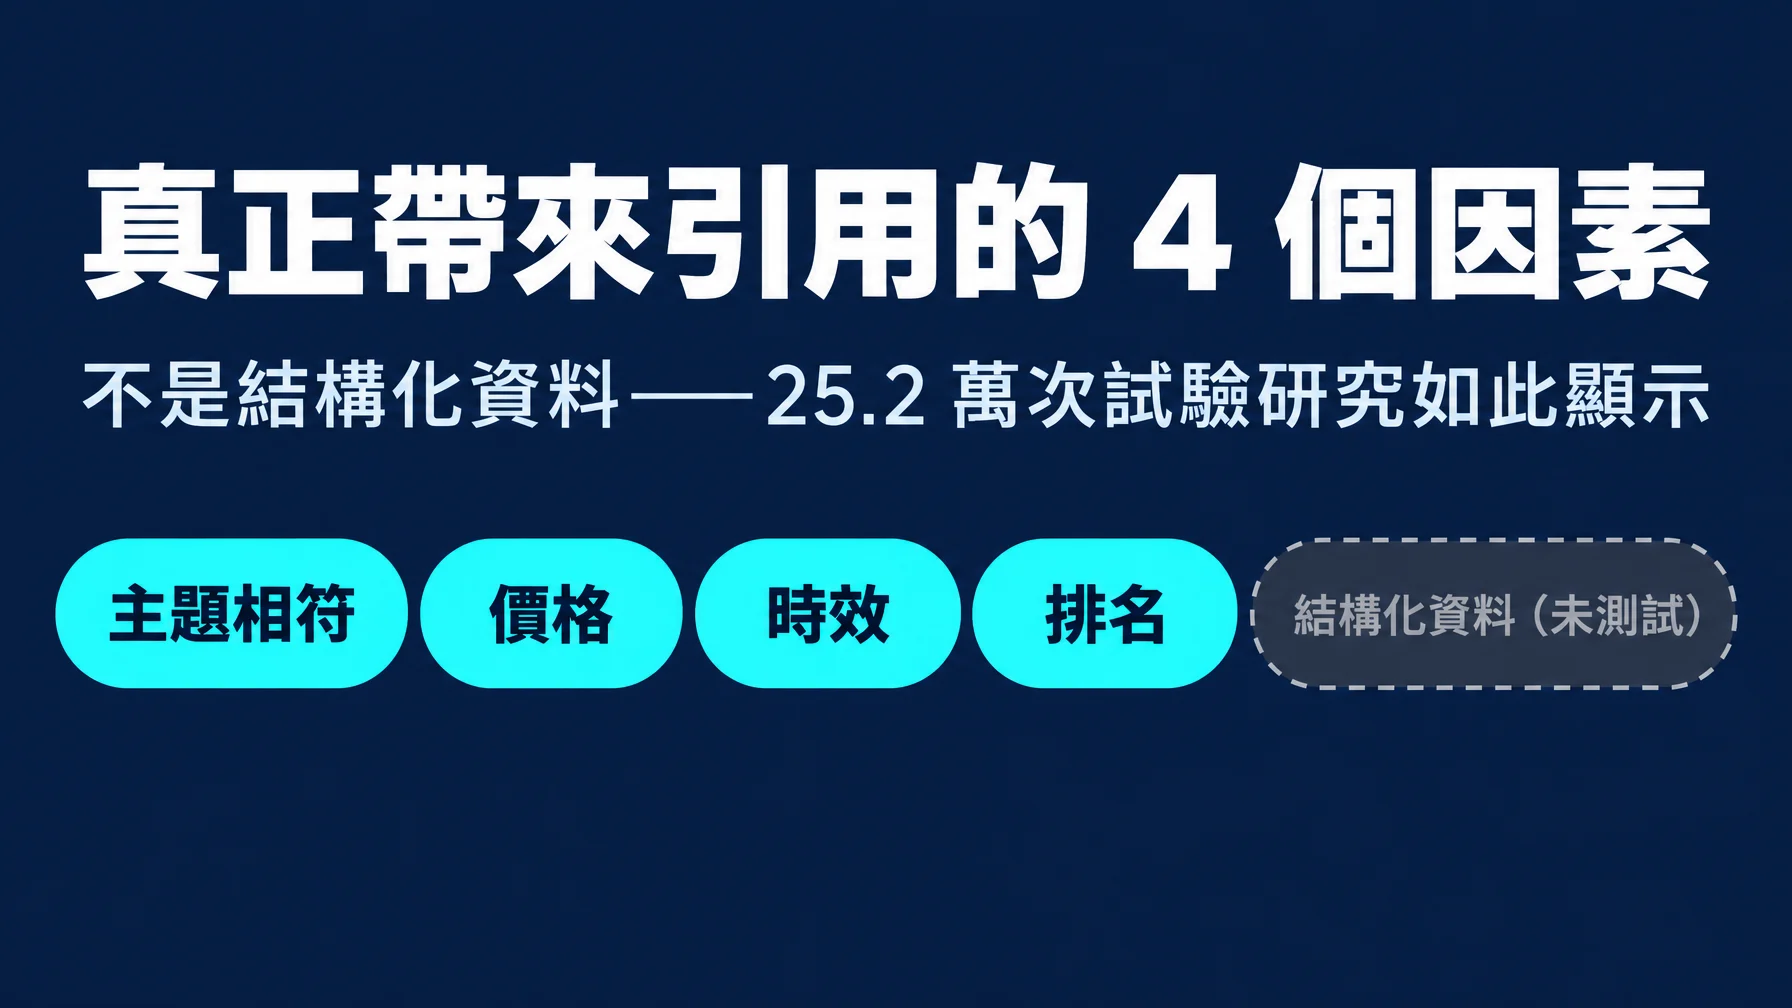
一套以頁面為單位的稽核方法,用來檢查一項進行了 25 萬 2,000 次試驗的對照研究認定為 AI 引用關鍵的四個因素;以及在這些因素到位後才發揮作用的七個次要因素之修正順序。你同時會知道,為什麼「Schema 標記對 AI 引用完全沒有影響」這個廣為流傳的說法並不是該研究的實際結論,並附上出處,讓你不會把一整個衝刺浪費在錯誤的修正上。
適合誰閱讀: 負責網站頁面層級 SEO 或 GEO、希望內容被 ChatGPT、Gemini、Perplexity、Claude 或 Google AI 回答引用的任何人。
所需時間: 每頁 30 至 45 分鐘(含稽核與第一輪修正)。
完成標準: 你稽核的頁面通過全部四項關卡檢查,而且你手上有一份仍待處理的次要因素清單。
開始之前:這份清單的依據,以及它修正了什麼
在 SEO/GEO 圈子裡流傳的一則貼文主張,SIGIR 的一項研究在六個 LLM 上執行了 25 萬 2,000 次試驗,發現 Schema 與 JSON-LD 對 AI 引用的「實測效果為零」,而價格、時效、規格與深度則能大幅左右結果。
研究是真的。試驗次數沒錯。那則貼文裡的勝算比也接近真實數字。站不住腳的地方在於:那份研究從未測試 Schema 標記。不是 Schema「被測出零效果」,而是 Schema 根本不在被測量的清單上。
論文是 "What Gets Cited: Competitive GEO in AI Answer Engines"(Vishwakarma、Kumar、Jamidar,Sprinklr;SIGIR '26,墨爾本)。設計方式是把恰好兩個候選來源注入六個 LLM(Gemini-2.5-Flash、Claude-3.5-Sonnet、Kimi-K2-Thinking,以及三款 GPT-5 變體),每一對只在 18 項內容因素中的恰好一項不同,再記錄哪一個來源先被引用。這 18 項因素涵蓋內容相符度、完整性、可信度、可讀性、競爭地位與時效。結構化資料格式不在這 18 項之中——這是直接比對論文自己的分類表確認的。
如果你想知道 Schema 的真正答案,來源是另一份研究:Ahrefs 於 2026 年 5 月執行的對照研究,針對 1,885 個加上了 JSON-LD 的頁面,與 4,000 個對照頁面比對。結果是:在 Google AI Overviews 上沒有有意義的引用提升(-4.6%,一個幅度小但統計上顯著的下降),Google AI Mode 為 +2.4%(不顯著),ChatGPT 為 +2.2%(不顯著)。另一項 searchVIU 的測試則發現,ChatGPT、Claude、Perplexity、Gemini 與 Google AI Mode 在即時檢索時根本不讀取 JSON-LD、隱藏的 Microdata 或隱藏的 RDFa。
進行這份稽核前,請把這兩件事分清楚:SIGIR 的研究告訴你頁面上該優先處理什麼;Ahrefs 的研究告訴你,就引用量而言 Schema 不是那些優先事項之一,儘管它在複合式搜尋結果與實體清晰度等其他面向上仍然有意義。
步驟 1:執行關卡稽核
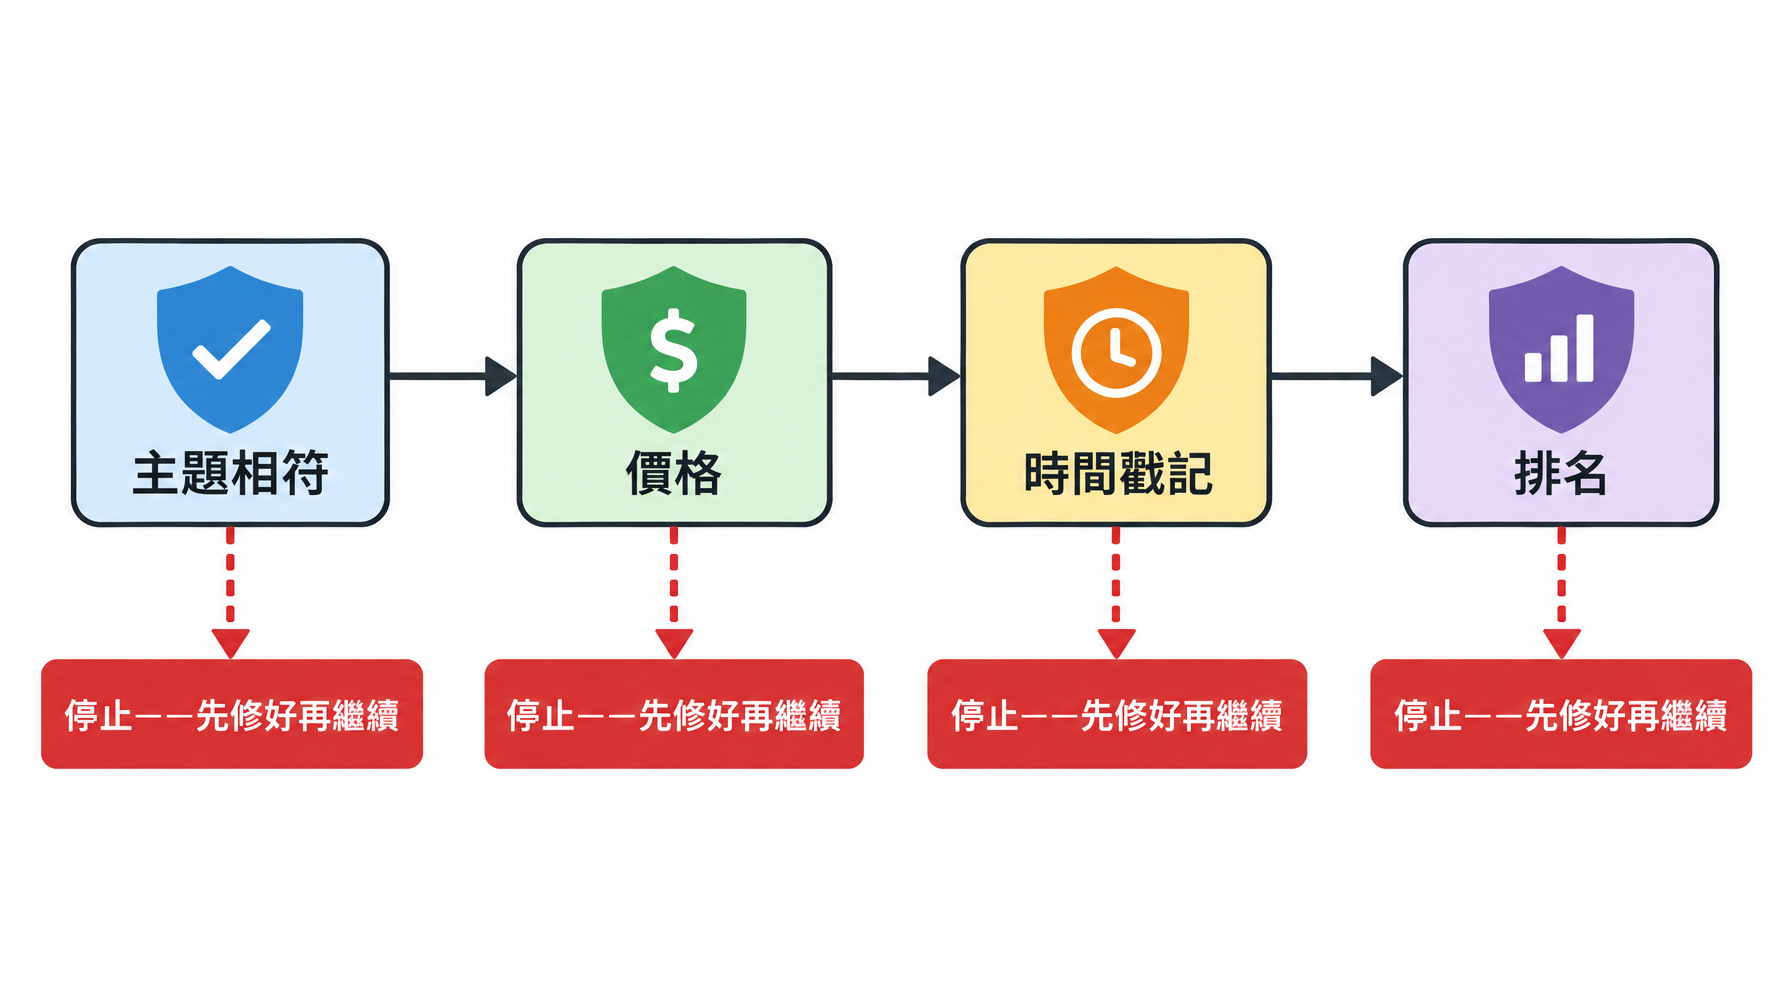
拿你的頁面逐項對照這四個因素。SIGIR 研究發現這四項在六個模型上全數一致成立,效果極為巨大(多數模型中的勝算比超過 100)。任何一項失敗,都可能讓引用機會消失,無論頁面其餘部分多強。
關卡 | 檢查內容 | 勝算比範圍(六個受測模型) |
|---|---|---|
主題相符 | 這個頁面是否直接回答它想爭取的查詢,而不是回答一個相近的主題? | 六個模型中有五個具決定性 |
標示價格 | 頁面上是否看得到具體價格,而不是藏在「聯絡我們」之後? | 6.26 至超過 10,000 |
最新時間戳記 | 是否顯示目前且準確的發佈日或最後審閱日? | 14.4 至超過 10,000 |
排名位置 | 這個頁面在該查詢的候選中是否傾向排第一,而不是第二? | 1,795 至超過 10,000 |
執行動作: 把頁面與目標查詢並排打開。讀前 150 個字,問自己是否直接回答了該查詢。在頁面上搜尋價格;如果需要填表或打電話,那就是失敗。把顯示的日期與內容實際最後更新的時間對照。確認你在該查詢上目前的排名或引用佔比。
預期產出: 四列各自的通過或失敗。
品質檢查: 如果主題相符失敗,就停在這裡——後面的步驟都救不了一個答錯問題的頁面。
補救路徑: 價格與時間戳記的失敗當天就能修好(步驟 2)。排名位置的失敗不是內容問題;那意味著這個頁面要能競爭引用之前,底層的 SEO 基本功必須先補起來,任何頁面上的打磨都取代不了這件事。
步驟 2:先修好任何失敗的關卡
在做任何其他事之前先完成這些。它們是這份清單上槓桿最大、投入最少的項目。
如果缺價格: 放上實際數字。如果價格會變動,就公佈真實的起始價或明確的價格區間,而不是用聯絡表單取代。這是研究中四項關卡之一。
如果時間戳記過舊或缺漏: 更新發佈日或最後審閱日,但必須在你真正修訂內容之後才做。沒有實質更新卻改日期,是一個一旦有人查證就站不住腳的時效訊號。
如果主題相符偏弱: 改寫開頭 150 個字,讓它直接回答該查詢的任務,而不是一個相關主題。不要把新的開場硬接到舊結構上,要整段換掉。
品質檢查: 把自己當成那個查詢,重讀一次頁面。陌生人能在第一段就得到具體答案嗎?
補救路徑: 如果真實價格無法公開(客製報價、企業合約),就公佈一個具代表性的起始價或典型區間,而不是留空——研究測量的失敗狀態是「未提及價格」,而不是「價格有變動」。
步驟 3:處理次要的差異化因素
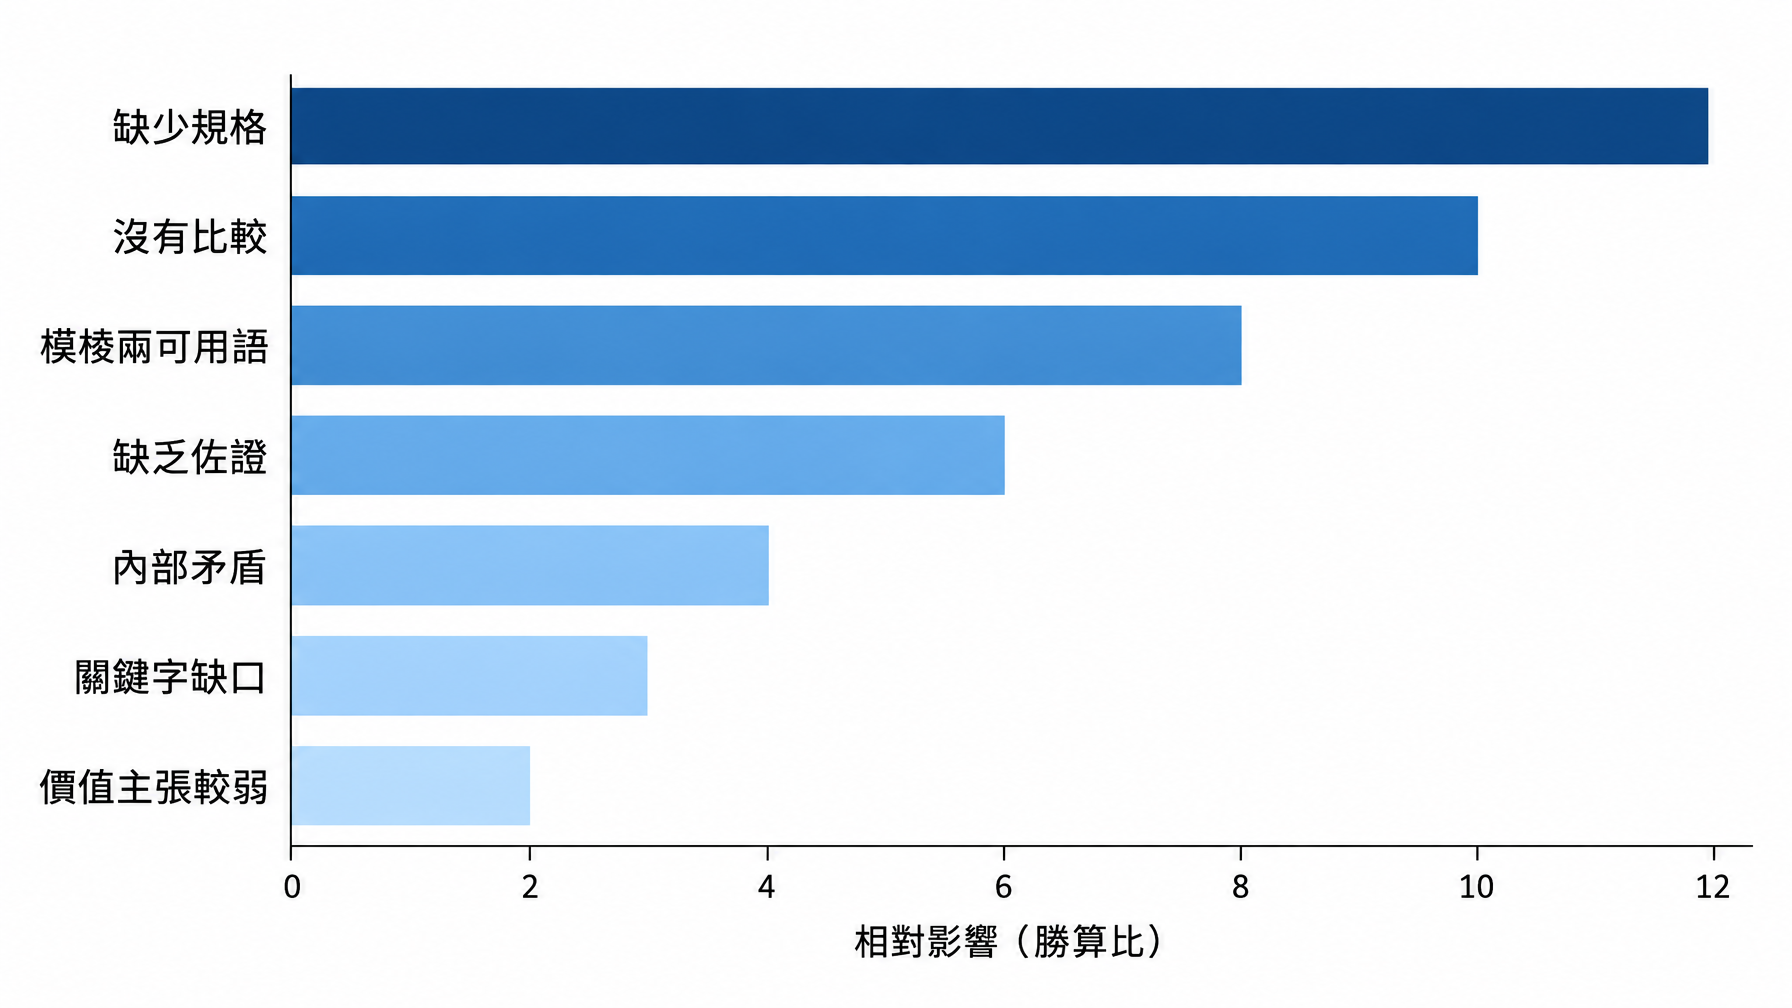
四項關卡通過後,以下七個因素會帶來次要的差異化,勝算比依模型不同約在 2 至 243 之間。請照這個順序修正:
- 缺少規格。 補上買家真正會比較的技術規格(尺寸、材質、容量、相容性)。各模型的勝算比為 8.63 至 243,是次要因素中效果最大的一項。
- 沒有比較。 加入至少一個指名替代品的直接比較。勝算比 1.61 至 7.45。
- 模稜兩可的用語。 把「可能」、「也許」、「或許」換成頁面真的撐得住的明確陳述。
- 缺乏佐證的主張。 為主張附上證據:測試結果、認證、具名方法論。
- 內部矛盾。 確認同一頁面各段落之間的數字與主張彼此一致;這在編輯過程中很容易產生,在審閱時又很容易漏掉。
- 關鍵字缺口。 確認頁面真的含有目標查詢使用的具體詞彙,而不只是同義詞。
- 價值主張較弱。 對照競品頁面所提供的內容,把你具體的效益主張磨得更銳利。
執行動作: 由上而下依序檢查,修正適用的項目。不是每個頁面都會有全部七個問題。
預期產出: 一個所有主張都具體、可比較或有所佐證的頁面。
品質檢查: 抱持懷疑的讀者,能不能在頁面上找到哪怕一句含糊或沒有依據的話?
補救路徑: 如果時間不夠,做到第 1 與第 2 項(規格與比較)就可以停——它們是這七項中勝算比最大的。
步驟 4:跳過只改排版的調整
該研究明確指出,把段落改寫成項目符號、為了易讀性加上小標、或重新整理散落的資訊,都沒有發現一致的效果,因為受測模型會解析內容,不受視覺結構影響。如果你的頁面已通過上述檢查,就不要為了期待引用提升而把一整個衝刺花在排版打磨上。為你的真人讀者排版,而不是為一個資料並不支持的引用增益。
步驟 5:讓 Schema 待在該待的位置
讓 Schema 標記保持技術上有效,因為它確實有實際作用:它協助 Google 與 Bing 解析複合式搜尋結果,也讓搜尋系統明確理解一個頁面與實體是什麼。但根據目前最好的對照證據,它不會改變 AI 引用的勝算。不要因為「Schema 是引用槓桿」這個說法,就把 Schema 工作排在步驟 1 至 3 之前——沒有任何對照研究支持這點,而唯一被拿來當依據的那份研究根本沒測過 Schema。如果你想知道 Ahrefs 那項 Schema 研究實際測了什麼的完整拆解,請看我們的 2026 年語意 SEO 指南。
驗證完成後的結果
修正之後,在該頁面上重新執行一次步驟 1 的稽核。四項關卡現在都應該通過。抽查步驟 3 中你修過的兩到三項次要因素。如果你能使用 AI 能見度或引用追蹤工具,例如 AI Search Visibility Checker,在前往下一頁之前,先記下該頁面在目標查詢上目前的引用率當作基準,這樣日後才能判斷這些改動有沒有造成變化。
維持成果
每次頁面有實質更新時,就重新檢查時間戳記這道關卡,而不是照固定行事曆走。對於流失引用佔比的頁面,先從四項關卡重新稽核,再假設是某個次要因素掉了。
常見問題
SIGIR 的研究有測試 Schema 標記或 JSON-LD 嗎?沒有。它的 18 項因素分類涵蓋內容相符度、完整性、可信度、可讀性、競爭地位、時效與排名位置。結構化資料格式不在受測的類別或因素之中——這是直接查閱論文分類表確認的。
Schema 標記對 AI 引用到底有沒有幫助?目前最好的對照證據——Ahrefs 於 2026 年 5 月以 1,885 個頁面對比 4,000 個配對對照組的研究——發現加入 JSON-LD 後,在 Google AI Overviews、Google AI Mode 或 ChatGPT 上都沒有有意義的引用提升。另一項測試則發現數個主要 AI 模型在即時檢索時並不讀取結構化資料。這不代表 Schema 在其他地方毫無價值;它只是不是一個影響引用量的槓桿。
那則瘋傳貼文裡的具體數字(6.3、14、4 到 8.6)是從哪來的?它們與 SIGIR 論文結果表中的真實勝算比相似,但那些數字屬於價格、時效與規格/比較類因素,而不是 Schema。論文是以逐模型方式報告數據,而非合併成單一平均值,而且在六個受測 LLM 之間的範圍差異相當大。
如果我只有一小時,該先修什麼?四項關卡:主題相符、價格、時間戳記與排名位置。任何一項失敗,都可能讓引用機會消失,與頁面上其他一切無關。
我應該完全停止做 Schema 嗎?不應該。為了複合式搜尋結果與實體清晰度,請讓它保持有效。但如果 AI 引用量才是真正的目標,就不要把新的 Schema 工作排在那四項關卡修正之前。
作者:Bennett Hayes,Auspia 的應用 GEO 分析師,負責超過 400 件實作審閱。Bennett 撰寫實務導向的 GEO 執行、稽核,以及以對照研究實際測量了什麼為依據的實作筆記。