Claude SEO स्किल एक फ़ोल्डर है जिसमें एक Markdown फ़ाइल रखी होती है। वह फ़ाइल एजेंट को बताती है कि स्किल क्या करती है, कब इस्तेमाल करनी है, और काम कैसे चलाना है। Claude Code, Codex और इस परंपरा का समर्थन करने वाले दूसरे एजेंट एक ही प्रारूप पढ़ते हैं: ऊपर मेटाडेटा का छोटा ब्लॉक, और उसके बाद निर्देश।
हर टीम लगभग दो हफ़्ते में जिस सवाल से टकराती है वह यह है कि इनमें से कौन-सी इंस्टॉल करनी है। सब इंस्टॉल कर लें तो चिंता रहती है कि कॉन्टेक्स्ट विंडो भर जाएगी। कुछ भी इंस्टॉल न करें तो नोट्स ऐप से प्रॉम्प्ट कॉपी करने के दिन लौट आते हैं।
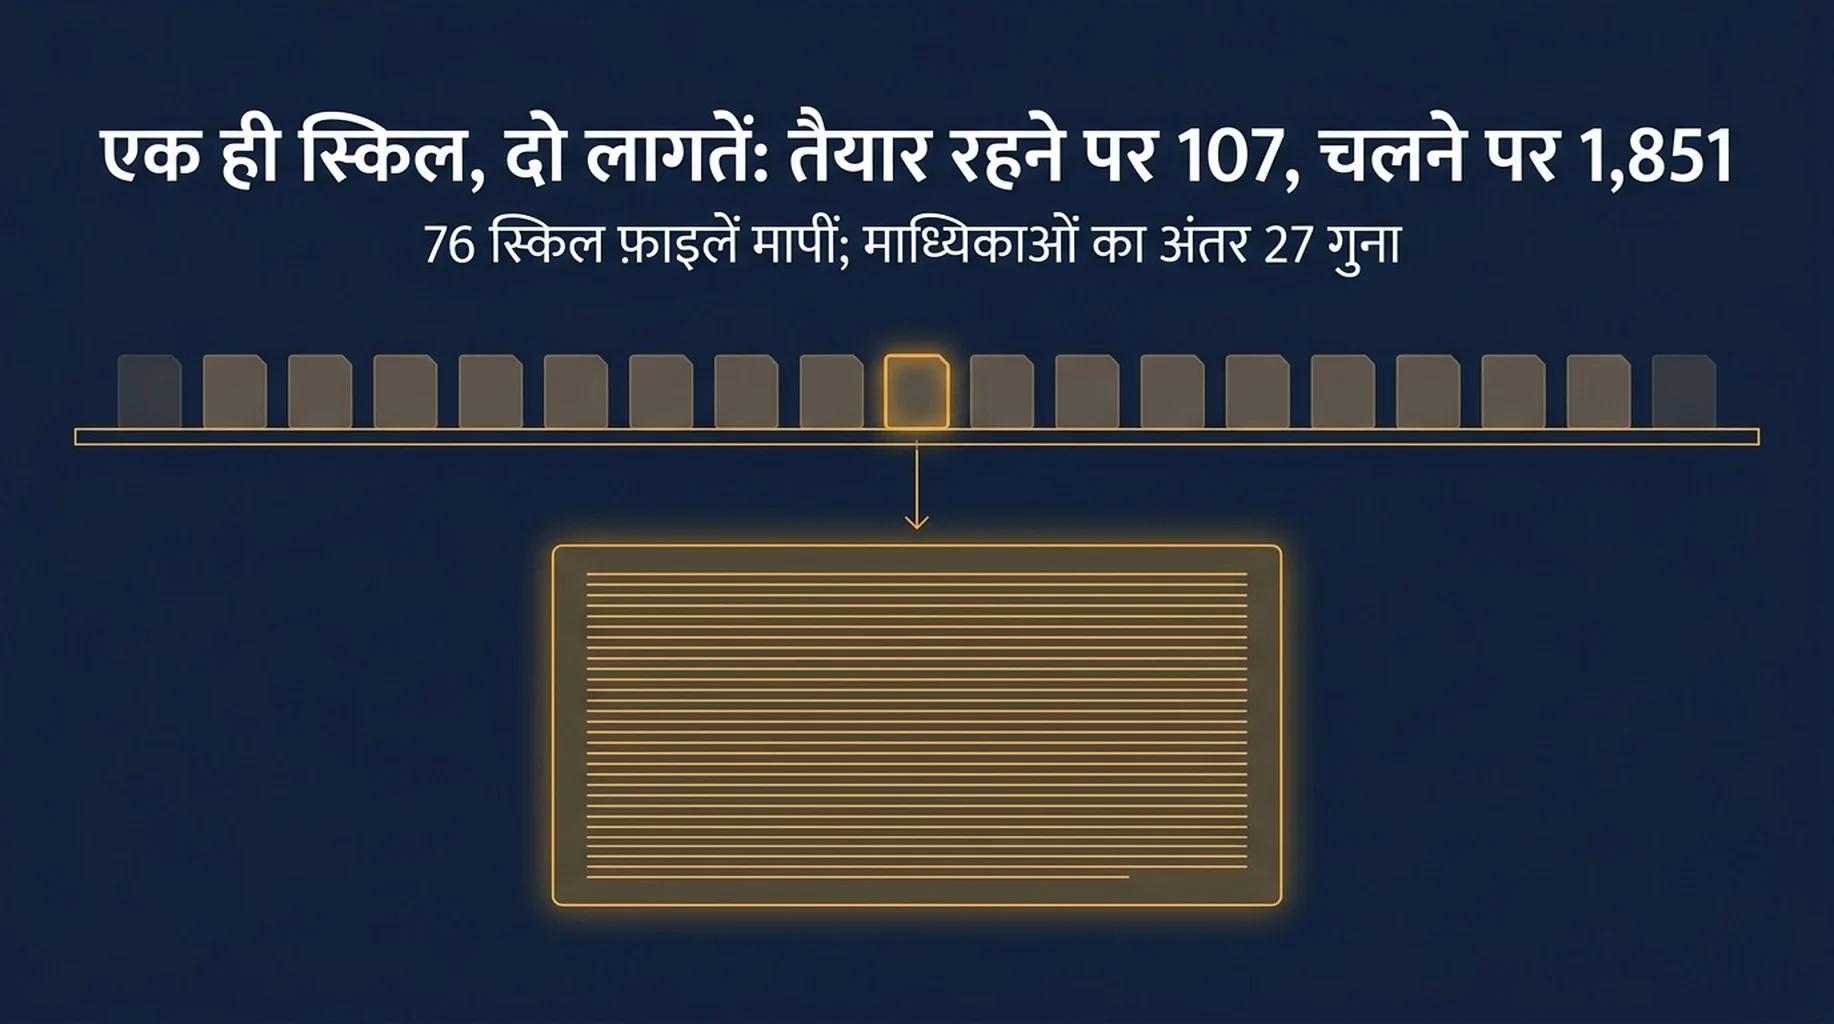
इसका जवाब देने के लिए हमने अपनी ही लाइब्रेरी नापी, और जवाब साफ़-साफ़ दो हिस्सों में बँटता है। स्किल जब बिना इस्तेमाल पड़ी रहती है तो उसकी लागत लगभग शून्य है। जब वह चलती है तो असली कॉन्टेक्स्ट खर्च करती है। हमारी लाइब्रेरी का माध्यिका मान 107 टोकन इंतज़ार वाला मेटाडेटा और 1,851 टोकन निर्देश हैं। इन दोनों संख्याओं को आपके फ़ैसले में अलग-अलग भूमिका निभानी चाहिए।
मापन
हमने एक ही मशीन की दो स्किल रूट्स में मौजूद हर SKILL.md फ़ाइल को पार्स किया और हर फ़ाइल को frontmatter की सीमा पर काटा।
मापदंड | मान |
|---|---|
पार्स की गई स्किल फ़ाइलें | 76 |
अलग-अलग स्किल नाम | 75 |
कुल मेटाडेटा ब्लॉक | 8,231 टोकन (अनुमानित) |
कुल निर्देश सामग्री | 222,952 टोकन (अनुमानित) |
सामग्री और मेटाडेटा का अनुपात | 27 बनाम 1 |
टोकन की गिनती चार अक्षर प्रति टोकन पर अनुमानित है, जो अंग्रेज़ी तकनीकी लेखन के लिए अच्छा अनुमान है पर सटीक नहीं। इन्हें तुलनात्मक संख्या मानें, शाब्दिक नहीं। असली खोज अनुपात और वितरण में है; निरपेक्ष संख्या आपकी फ़ाइलों के साथ बदलेगी।
शेल्फ़ की लागत छोटी क्यों रहती है
स्किल सिस्टम क्रमिक प्रकटीकरण इस्तेमाल करते हैं। मेटाडेटा ब्लॉक इसलिए लोड होता है कि एजेंट को पता रहे कि स्किल मौजूद है और कब लागू होती है। सामग्री तभी पढ़ी जाती है जब स्किल चलाई जाए।
यह डिज़ाइन एक ऐसा वितरण देता है जिसे एक बार देखना बनता है।
प्रतिशतक | प्रति स्किल इंतज़ार लागत | प्रति स्किल सामग्री लागत |
|---|---|---|
सबसे छोटी | 43 टोकन | 428 टोकन |
माध्यिका | 107 टोकन | 1,851 टोकन |
90वाँ प्रतिशतक | 161 टोकन | 7,125 टोकन |
सबसे बड़ी | 246 टोकन | 21,702 टोकन |
पूरी 76 फ़ाइलों की लाइब्रेरी इंतज़ार वाला 8,231 टोकन मेटाडेटा ढोती है। यह लगभग एक लंबे लेख के बराबर है, और यह वह क़ीमत है जो एजेंट कुछ भी करने से पहले 75 स्किलों के होने की जानकारी के लिए चुकाता है। लाइब्रेरी में सबसे बड़ा एकल मेटाडेटा ब्लॉक 246 टोकन का है।
दिलचस्प अधिकतम है। लाइब्रेरी की सबसे बातूनी स्किल एजेंट को यह बताने में 246 टोकन खर्च करती है कि उसे कब इस्तेमाल करना है, और यह अब भी इतना छोटा है कि स्किलों की एक शेल्फ़ किसी सेशन को डुबो नहीं देगी। अगर आपको डर है कि पाँच SEO स्किल इंस्टॉल करने से आपके डेटा की जगह छिन जाएगी, तो मापन कहता है कि भीड़ शेल्फ़ पर नहीं होती।
लागत असल में कहाँ रहती है
असली बात सामग्री में है, और फैलाव चौड़ा है। 75 में से 15 स्किलें चलने पर 1,000 टोकन से कम लोड करती हैं। 11 स्किलें 5,000 से ऊपर लोड करती हैं। सबसे बड़ी 21,702 लोड करती है।
SEO प्रोग्राम के लिए यही दायरा योजना बनाने का आधार है, क्योंकि यह बताता है कि स्किल कितना काम करती है। एक पेज का ऑडिट करने वाली स्किल सस्ती है। पूरी साइट क्रॉल करने, बेसलाइन से तुलना करने और रिपोर्ट लिखने वाली स्किल में बहुत निर्देश होते हैं क्योंकि उसमें बहुत चरण होते हैं।
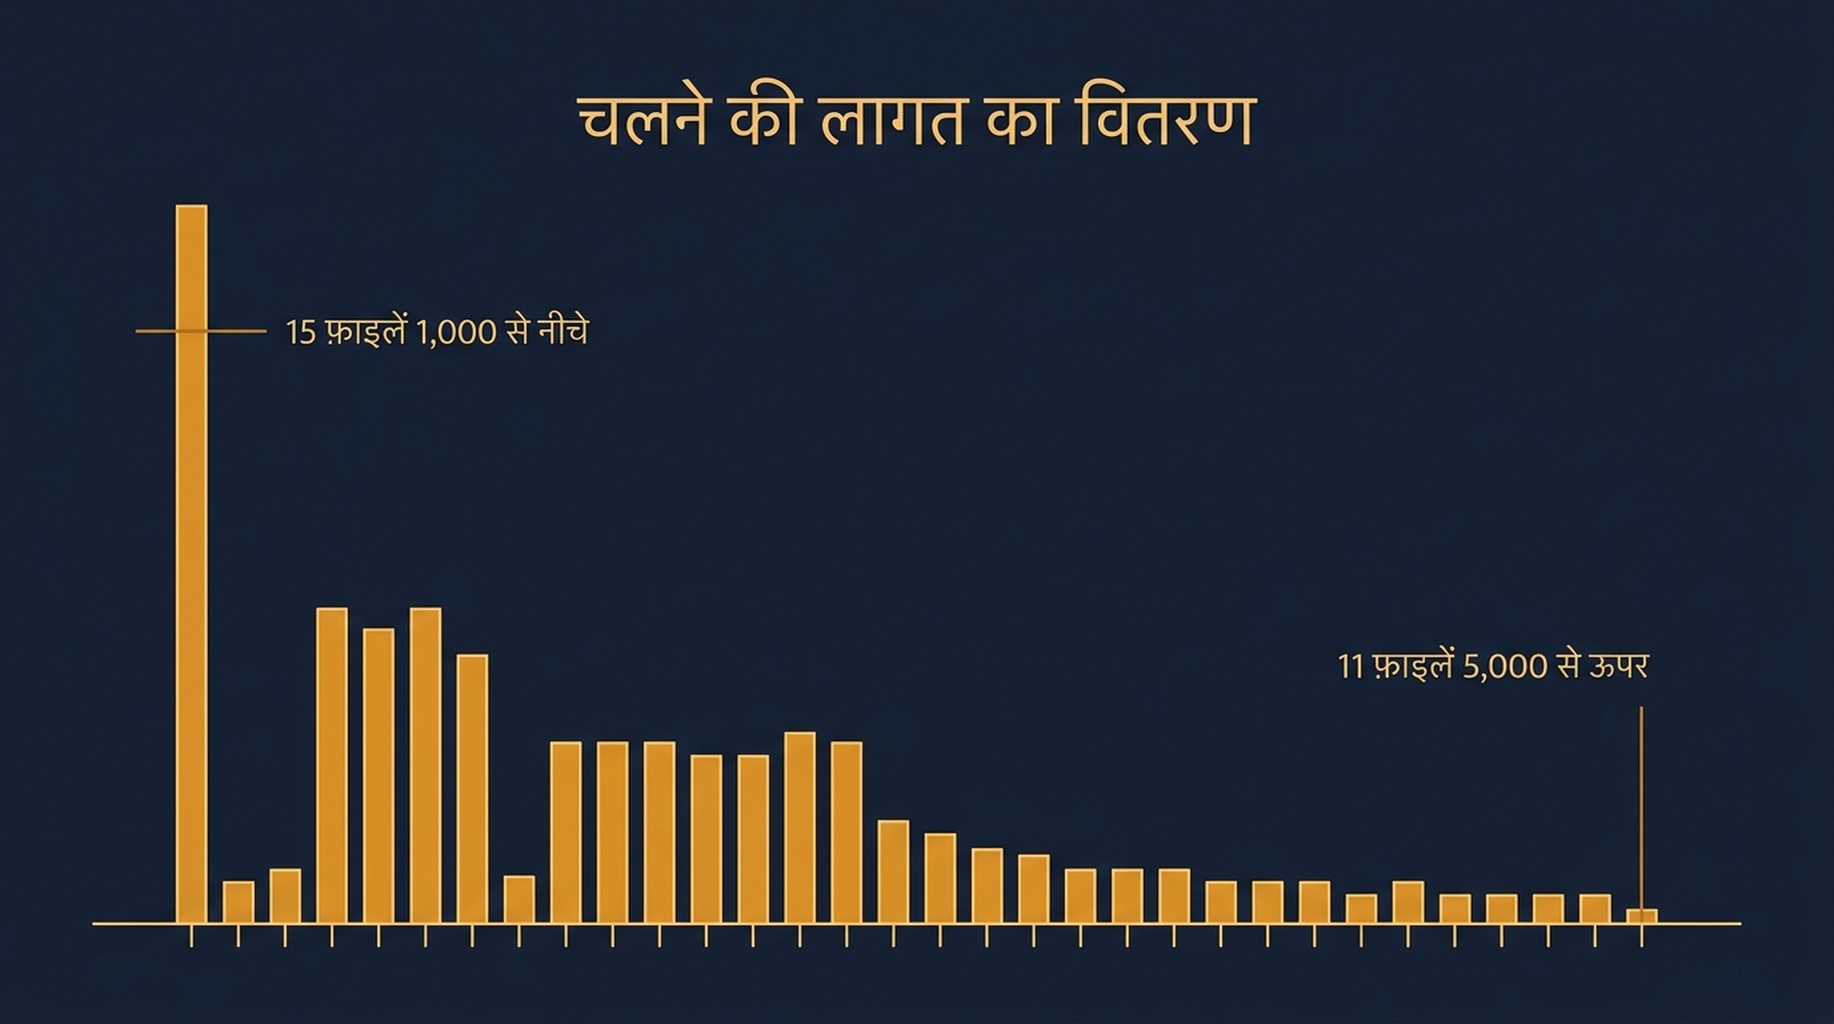
इनवोकेशन लागत निचले सिरे पर जमा होती है और फिर लंबी होती जाती है, 5,000 टोकन से ऊपर 11 स्किलों के साथ।
यह हमारा खोज और मापन सेट है, उसी तरीक़े से नापा गया।
स्किल | इंतज़ार | चलने पर |
|---|---|---|
tool-cluster-builder | 70 टोकन | 428 टोकन |
seo-tools-local | 102 टोकन | 638 टोकन |
geo-operator | 101 टोकन | 665 टोकन |
dataforseo-toolkit | 238 टोकन | 849 टोकन |
ahrefs-2026-content-refresh | 51 टोकन | 958 टोकन |
search-engine-visibility-audit | 49 टोकन | 1,121 टोकन |
codex-link-equity-audit | 96 टोकन | 1,163 टोकन |
gsc | 116 टोकन | 1,309 टोकन |
bing-webmaster | 135 टोकन | 1,685 टोकन |
seo-beginner-automation | 98 टोकन | 1,836 टोकन |
दसों मिलाकर | 1,055 टोकन | 10,652 टोकन |
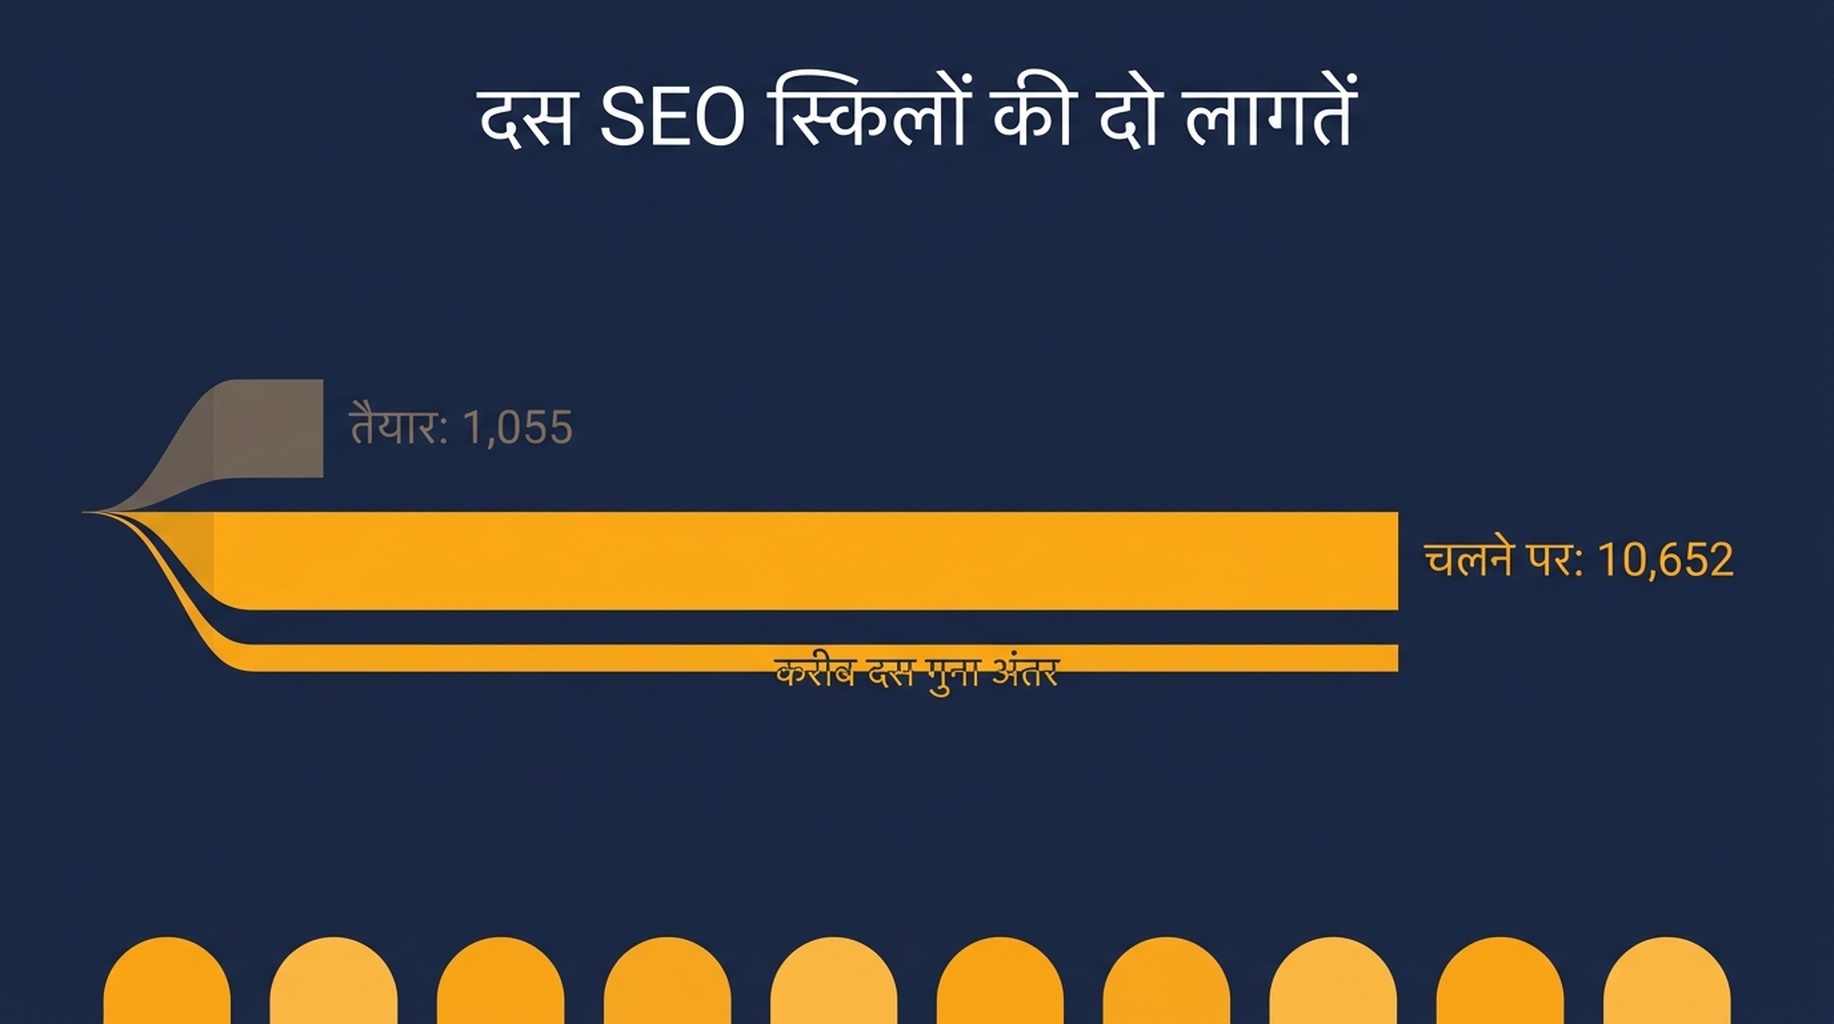
दस SEO स्किलें शेल्फ़ पर लगभग 1,000 टोकन और सबके चलने पर लगभग 10,000 टोकन की पड़ती हैं।
इस तालिका से दो बातें निकलती हैं।
इंतज़ार वाला कॉलम लगभग सपाट है। दस SEO स्किलें उपलब्ध रखने की लागत 1,055 टोकन है। सर्च नतीजों के एक पेज या क्रॉल एक्सपोर्ट के मुक़ाबले यह राउंडिंग की त्रुटि है, और यह वह तर्क है कि आप वह शेल्फ़ लगाएँ जो आप चाहते हैं, वह नहीं जिसे आप जुटा सकते हैं।
चलने वाला कॉलम सपाट नहीं है। यह सेट 428 से 1,836 टोकन तक जाता है, यानी चार गुना। व्यवहार में आप एक सेशन में शायद ही एक या दो से ज़्यादा चलाते हैं, इसलिए ईमानदार योजना संख्या 10,652 नहीं है। वह कुछ हज़ार टोकन है, उस डेटा के ऊपर जो सेशन पहले से उठाए हुए है।
स्किल चुनते समय ये संख्याएँ क्या मतलब रखती हैं
मापन से निकलने वाले तीन चयन नियम।
सामग्री को परखें, विवरण को नहीं। मेटाडेटा ब्लॉक स्किल का विज्ञापन है। किसी स्किल का विवरण 50 टोकन का और सामग्री 7,000 टोकन की हो सकती है। इंस्टॉल करने से पहले फ़ाइल पढ़ें, और frontmatter के नीचे की हर चीज़ की लंबाई देखें। अगर तेज़ फ़िल्टर चाहिए तो फ़ाइल का आकार और पंक्तियों की गिनती इस बात का ठीक संकेत हैं कि स्किल कितना कुछ खींचेगी।
डेटा पढ़ने वाली स्किलों को, डेटा भीतर रखने वाली स्किलों पर तरजीह दें। जो स्किल किसी API को कॉल करके जवाब पढ़ती है, उसकी लागत तय है, चाहे आपके पास कितने भी कीवर्ड हों। जो स्किल Markdown के भीतर लुकअप तालिका या टेम्पलेट लाइब्रेरी ढोती है, वह उतनी ही पड़ती है, आपको वह तालिका चाहिए या नहीं। इसीलिए 849 टोकन वाला DataForSEO रैपर व्यवहार में दिखने से सस्ता है, और इसीलिए टेम्पलेट आधारित बड़ी कंटेंट स्किल अपने विवरण के भान से महँगी पड़ती है।
बजट सेशन का बनाएँ, शेल्फ़ का नहीं। असली संख्या एक सक्रिय सेशन के कुल टोकन हैं, और स्किलें उसमें कई इनपुट में से एक हैं। जिस सेशन में क्रॉल एक्सपोर्ट चिपका हो और तीन स्किलें लोड हों, वह कॉन्टेक्स्ट की समस्या है। जिस सेशन में बीस स्किलें उपलब्ध हों और एक लोड हो, वह नहीं है।
स्किल कब सही चुनाव है, और कब नहीं
स्किलें और MCP सर्वर एक ही समस्या के अलग-अलग आधे हल करते हैं, और काम के लिए ग़लत आधा इस्तेमाल करना ही वह वजह है जिससे टीमों के पास आख़िर में कुछ नहीं बचता।
स्किल निर्देश है और कुछ नहीं जानती। यह दोहराए जाने वाले निर्णय के लिए सही स्वरूप है, जैसे रैंकिंग गिरावट को कैसे छाँटें, ऑडिट का आउटपुट कैसे गढ़ें, या लिंक प्रोफ़ाइल समीक्षा को कौन-से सबूत चाहिए। इसकी लागत कॉन्टेक्स्ट है, और वह हर सेशन में चुकाई जाती है।
MCP सर्वर एक जीवित कनेक्शन है। यह उस डेटा के लिए सही स्वरूप है जहाँ एजेंट किसी और तरह नहीं पहुँच सकता, जैसे Search Console या बैकलिंक इंडेक्स। इसकी लागत कॉन्फ़िगरेशन, क्रेडेंशियल और अनुमतियाँ हैं, और वह एक बार चुकाई जाती है। अगर आप जानना चाहते हैं कि ये कनेक्शन असल में क्या खोलते हैं, तो चार SEO MCP सर्वरों की हमारी तुलना इस जाँच में है।
काम करने वाली जोड़ी: हर डेटा स्रोत के लिए एक कनेक्शन, हर दोहराए जाने वाले निर्णय के लिए एक स्किल। हमारे अपने वर्कफ़्लो में Search Console कनेक्शन एक सर्वर है और रोज़ाना की निगरानी दिनचर्या एक स्किल है, क्योंकि दोहराने वाला हिस्सा निर्णय है।
इंस्टॉल करने से पहले क्या जाँचें
सत्यापन का छोटा दौर, क्योंकि यह प्रारूप लिखना आसान है और बुरा लिखना भी आसान है।
- frontmatter पढ़ें और पुष्टि करें कि विवरण किसी ठोस ट्रिगर का नाम लेता है। "SEO में मदद करता है" जैसा विवरण ग़लत मौकों पर लोड होगा।
- frontmatter के नीचे की पंक्तियाँ गिनें। 100 से कम पंक्तियाँ केंद्रित स्किल हैं। 500 से ऊपर हों तो देखें कि ब्यौरा ऐसी संदर्भ सामग्री तो नहीं जिसे अलग फ़ाइल होना चाहिए जिसे स्किल ज़रूरत पर पढ़े।
- फ़ाइल में क्रेडेंशियल और कठोर कोडित पाथ खोजें। स्किल को कॉन्फ़िगरेशन एनवायरनमेंट से पढ़ना चाहिए, टोकन ढोना नहीं।
- देखें कि वह आपकी साइट पर लिखती है या नहीं। सिर्फ़ पढ़ने वाली स्किल लाइव प्रॉपर्टी पर आज़माना सुरक्षित है। फ़ाइलें बदलने वाली स्किल में कुछ भी बदलने से पहले समीक्षा का चरण होना चाहिए।
- इसे किसी ऐसी प्रॉपर्टी पर एक बार चलाएँ जिसकी आपको परवाह न हो, और आउटपुट पढ़ें। ज़्यादातर स्किलें अपने आउटपुट प्रारूप से परखी जाती हैं, निर्देशों से नहीं।
अक्सर पूछे जाने वाले सवाल
क्या इंस्टॉल की गई स्किलें हर सेशन को धीमा करती हैं? सिर्फ़ अपने मेटाडेटा ब्लॉक के बराबर। हमारी लाइब्रेरी में माध्यिका 107 टोकन है और 76 फ़ाइलों का कुल 8,231 टोकन। निर्देश तब लोड होते हैं जब स्किल इस्तेमाल होती है, पहले नहीं।
कितनी SEO स्किलें इंस्टॉल रखनी चाहिए? हमारे सेट में दस खोज और मापन स्किलें लगभग 1,000 टोकन इंतज़ार वाला मेटाडेटा लेती हैं। सीमा कभी-कभार ही कॉन्टेक्स्ट होती है। असली सीमा आपकी अपनी यह याद रखने की क्षमता है कि कौन-सी किस काम की है।
बड़ी स्किल फ़ाइल बुरा संकेत है? अपने आप नहीं। संदर्भ-भारी स्किलें जायज़ तौर पर लंबी होती हैं। पर लंबाई को स्किल के काम से न्यायसंगत होना चाहिए। अगर 500 पंक्तियों की स्किल ढेर सारी व्याख्या के साथ एक ही API कॉल करती है, तो वह क्षमता नहीं, दस्तावेज़ीकरण की समस्या है।
क्या मैं अपनी ख़ुद की Claude SEO स्किल लिख सकता/सकती हूँ? हाँ, और जैसे ही आपके पास कोई दोहराई जाने वाली दिनचर्या हो, यह सबसे ज़्यादा रिटर्न वाला विकल्प है। शुरुआत में वह काम हाथ से दो बार कीजिए, जो चरण नहीं बदले उन्हें लिख लीजिए, और उन्हें सामग्री में डाल दीजिए। frontmatter 150 टोकन से नीचे रखें और ट्रिगर सटीकता से बताएँ।
क्या ये संख्याएँ ख़ास तौर पर Claude Code पर लागू होती हैं? प्रारूप और क्रमिक प्रकटीकरण का मॉडल उन सभी एजेंटों में साझा है जो SKILL.md का समर्थन करते हैं, जिनमें Claude Code और Codex शामिल हैं। मापन हमारी अपनी लाइब्रेरी से है, इसलिए मान लीजिए कि आपका वितरण आपकी फ़ाइलों के आकार के साथ अलग होगा।
Auspia की राय: वह शेल्फ़ लगाइए जो आप चाहते हैं, फिर जाँचिए कि असल में क्या चलता है। स्किल लाइब्रेरी की इंतज़ार लागत इतनी छोटी है कि उसकी चिंता छोड़ी जा सके, और बुरी तरह लिखी स्किल असल में चलने वाली लागत पर ही चोट पहुँचाती है। अगर आपने अपना सेट कभी नापा नहीं, तो हर फ़ाइल में frontmatter के नीचे की पंक्तियाँ गिनने में लगभग दस मिनट लगते हैं और पता चल जाता है कि वज़न कहाँ है। GEO के काम में स्किल और सर्वर का विस्तृत बँटवारा हमारे GEO स्किल नोट्स में है।
लेखन: Alice Monroe, Auspia में 150 से अधिक टूल कवर करते हुए AI SEO टूल विश्लेषण। AI SEO टूल, स्किल और सर्वर आर्किटेक्चर, और एजेंट स्टैक की हर परत की असल लागत पर लिखते हैं।