Uma skill de Claude SEO é uma pasta com um arquivo Markdown dentro. O arquivo diz ao agente o que a skill faz, quando usá-la e como executar a tarefa. Claude Code, Codex e outros agentes que suportam a convenção leem o mesmo formato: um bloco curto de metadados no topo, depois as instruções.
A pergunta com que toda equipe esbarra por volta da segunda semana é quais delas instalar. Instale todas e você se preocupa em encher a janela de contexto. Não instale nenhuma e você volta a copiar prompts de um aplicativo de notas.
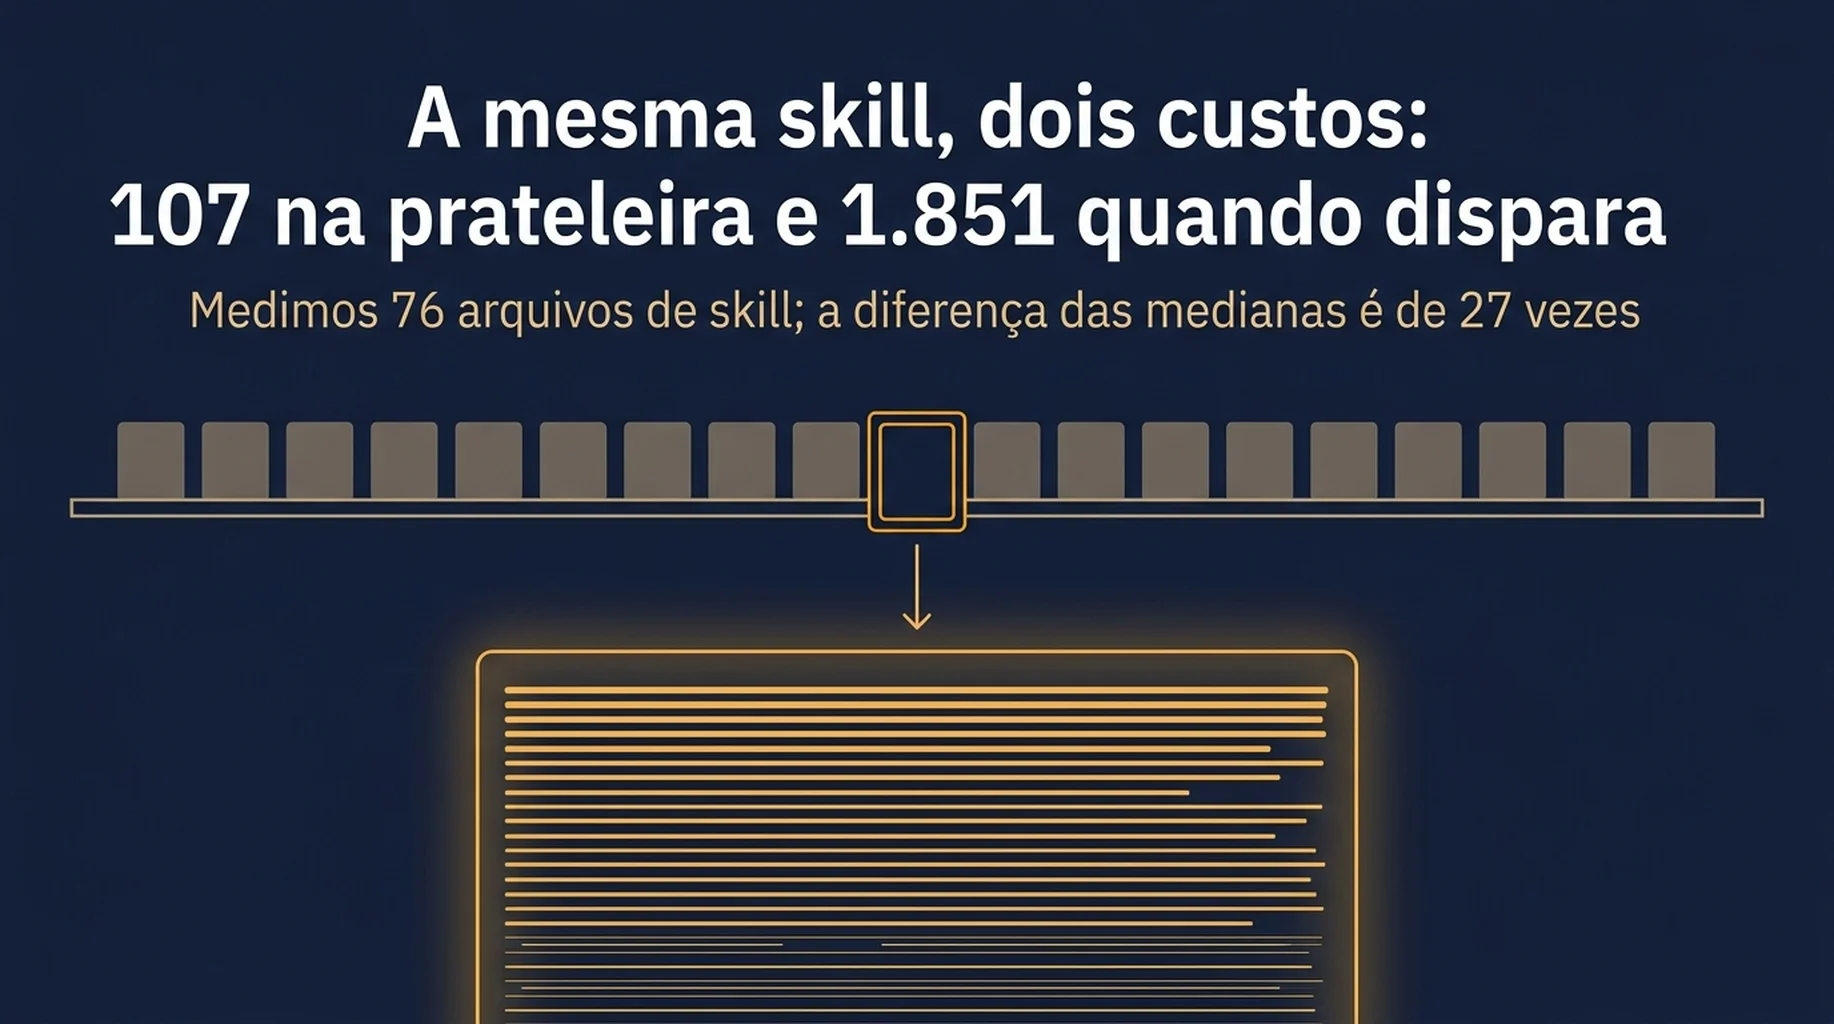
Medimos nossa própria biblioteca para responder isso, e a resposta se divide limpo em duas. Uma skill quase não custa nada enquanto fica parada sem uso. Ela custa contexto real quando dispara. A mediana da nossa biblioteca é 107 tokens de metadados em espera e 1.851 tokens de instruções. Esses dois números deveriam cumprir papéis diferentes na sua decisão.
A medição
Analisamos cada arquivo SKILL.md nas duas raízes de skills de uma máquina e cortamos cada arquivo na fronteira do frontmatter.
Medida | Valor |
|---|---|
Arquivos de skill analisados | 76 |
Nomes de skill distintos | 75 |
Bloco de metadados total | 8.231 tokens (estimado) |
Corpo de instruções total | 222.952 tokens (estimado) |
Razão corpo/metadados | 27 para 1 |
As contagens de tokens são estimadas em quatro caracteres por token, uma boa aproximação para escrita técnica em inglês, mas não exata. Trate-as como comparativas, não literais. O achado está na razão e na distribuição; o número absoluto vai mudar com os seus arquivos.
Por que o custo de prateleira continua pequeno
Sistemas de skills usam divulgação progressiva. O bloco de metadados é carregado para que o agente saiba que a skill existe e quando ela se aplica. O corpo só é lido quando a skill é invocada.
Esse desenho produz uma distribuição que vale a pena olhar.
Percentil | Custo em espera por skill | Custo do corpo por skill |
|---|---|---|
Menor | 43 tokens | 428 tokens |
Mediana | 107 tokens | 1.851 tokens |
Percentil 90 | 161 tokens | 7.125 tokens |
Maior | 246 tokens | 21.702 tokens |
A biblioteca inteira de 76 arquivos carrega 8.231 tokens de metadados em espera. É mais ou menos o tamanho de um artigo longo, e é o preço de o agente saber que existem 75 skills antes de ter feito qualquer coisa. O maior bloco de metadados da biblioteca tem 246 tokens.
O máximo é o interessante. A skill mais verbosa da biblioteca gasta 246 tokens dizendo ao agente quando usá-la, o que ainda é pequeno o bastante para que uma prateleira de skills não afunde uma sessão. Se você teme que instalar cinco skills de SEO vá disputar espaço com seus dados, a medição diz que a prateleira não é onde o aperto acontece.
Onde o custo realmente mora
O corpo é onde fica real, e a dispersão é ampla. 15 das 75 skills carregam menos de 1.000 tokens quando disparam. 11 carregam mais de 5.000. A maior carrega 21.702.
Para um programa de SEO, essa faixa é o que se deve planejar, porque ela acompanha quanto trabalho a skill faz. Uma skill que audita uma página é barata. Uma skill que roda um rastreamento completo do site, compara com uma linha de base e escreve um relatório tem muitas instruções porque tem muitos passos.
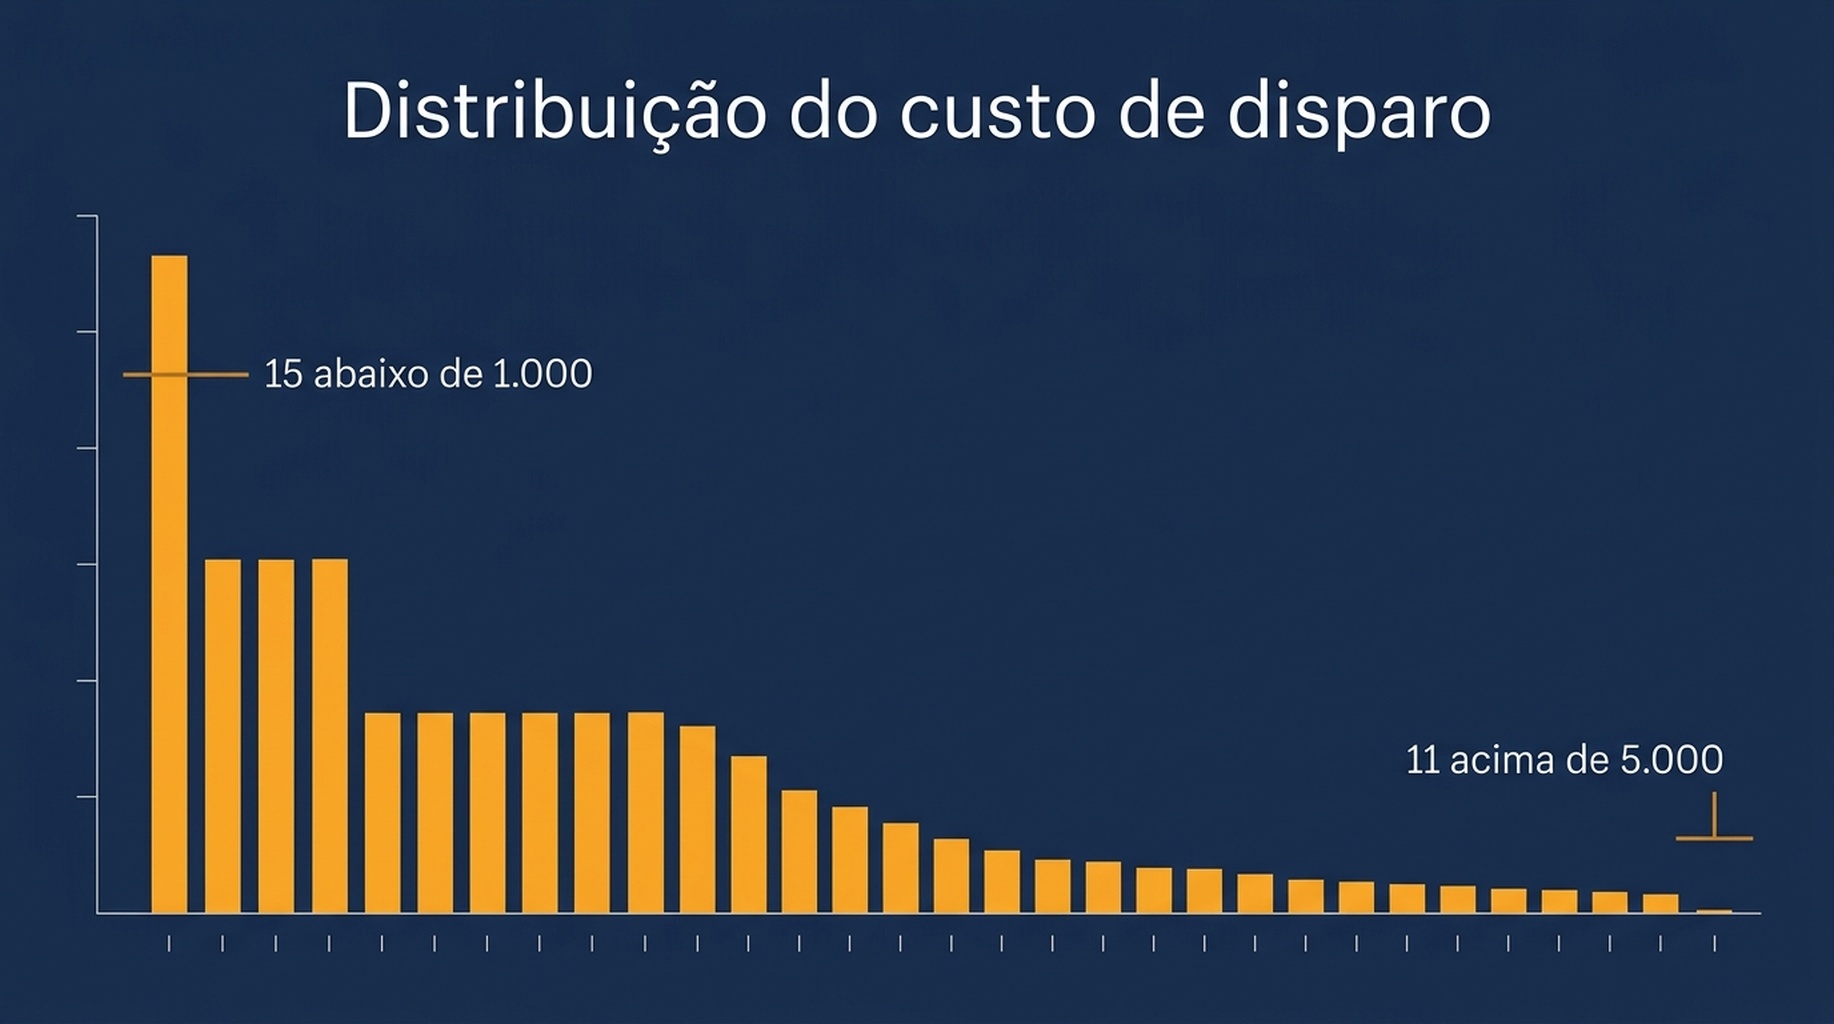
O custo de invocação se concentra na ponta baixa e depois se estica, com 11 skills acima de 5.000 tokens.
Aqui está o nosso conjunto de busca e medição, medido do mesmo jeito.
Skill | Em espera | Quando dispara |
|---|---|---|
tool-cluster-builder | 70 tokens | 428 tokens |
seo-tools-local | 102 tokens | 638 tokens |
geo-operator | 101 tokens | 665 tokens |
dataforseo-toolkit | 238 tokens | 849 tokens |
ahrefs-2026-content-refresh | 51 tokens | 958 tokens |
search-engine-visibility-audit | 49 tokens | 1.121 tokens |
codex-link-equity-audit | 96 tokens | 1.163 tokens |
gsc | 116 tokens | 1.309 tokens |
bing-webmaster | 135 tokens | 1.685 tokens |
seo-beginner-automation | 98 tokens | 1.836 tokens |
As dez juntas | 1.055 tokens | 10.652 tokens |
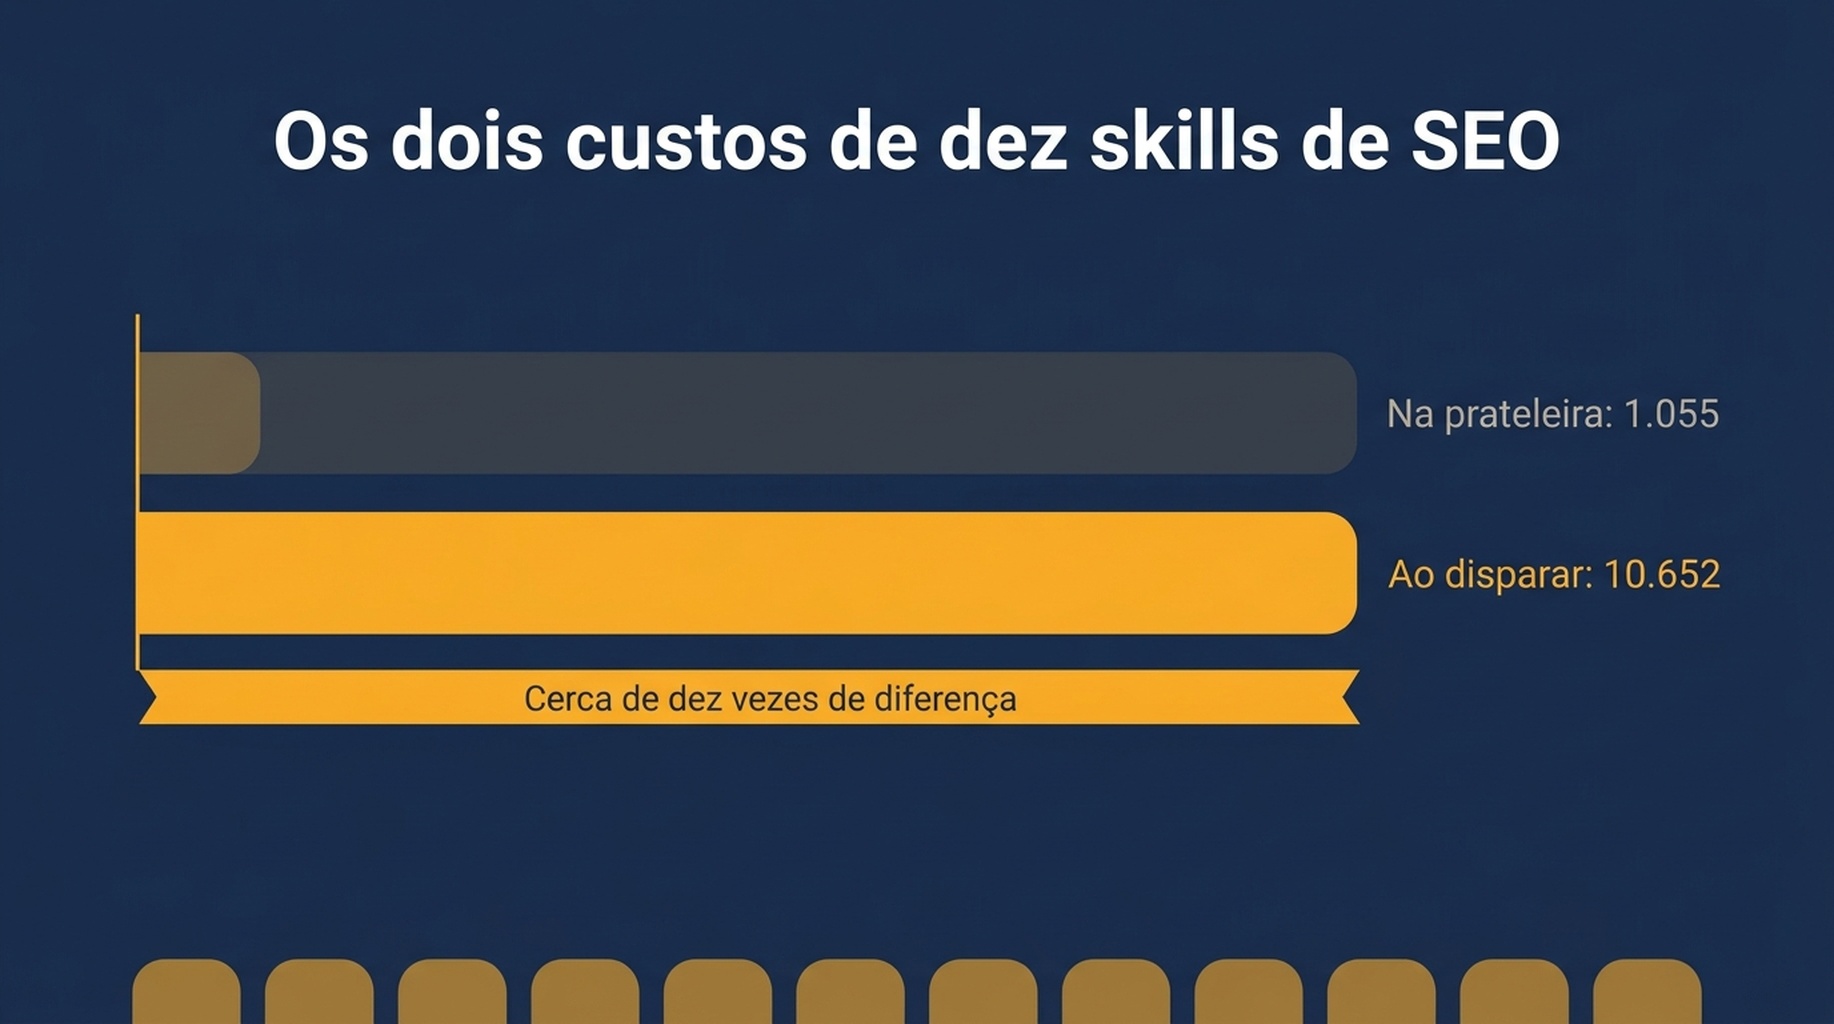
Dez skills de SEO custam cerca de 1.000 tokens na prateleira e cerca de 10.000 tokens quando todas disparam.
Duas coisas caem dessa tabela.
A coluna de espera é quase plana. Dez skills de SEO custam 1.055 tokens para estarem disponíveis. Isso é erro de arredondamento ao lado de uma página de resultados de busca ou de uma exportação de rastreamento, e é o argumento para instalar a prateleira que você quer, não a prateleira que você acha que pode pagar.
A coluna de invocação não é plana. O conjunto vai de 428 a 1.836 tokens, um fator de quatro. Na prática você raramente dispara mais de uma ou duas por sessão, então o número honesto de planejamento não é 10.652. É alguns milhares de tokens em cima do que a sessão já está carregando.
O que os números significam quando você escolhe uma skill
Três regras de seleção que decorrem da medição.
Julgue o corpo, não a descrição. O bloco de metadados é o anúncio da skill. Uma skill pode ter uma descrição de 50 tokens e um corpo de 7.000. Leia o arquivo antes de instalar, e confira o comprimento de tudo abaixo do frontmatter. Se quiser um filtro rápido, tamanho de arquivo e número de linhas são um proxy razoável de quanto a skill vai puxar.
Prefira skills que leem dados a skills que embutem dados. Uma skill que chama uma API e lê a resposta custa um valor fixo, não importa quantas palavras-chave você tenha. Uma skill que carrega uma tabela de consulta ou uma biblioteca de modelos dentro do Markdown custa o mesmo, você precisando da tabela ou não. É por isso que um wrapper de DataForSEO de 849 tokens é mais barato na prática do que parece, e por isso uma skill grande de conteúdo guiada por modelos é mais cara do que a descrição sugere.
Faça orçamento da sessão, não da prateleira. O número que importa é o total de tokens numa sessão ativa, e as skills são uma entrada entre várias. Uma sessão com uma exportação de rastreamento colada e três skills carregadas é um problema de contexto. Uma sessão com vinte skills disponíveis e uma carregada não é.
Onde uma skill é a escolha certa, e onde não é
Skills e servidores MCP resolvem metades diferentes do mesmo problema, e usar a metade errada para a tarefa é o motivo pelo qual as equipes acabam sem nenhuma das duas.
Uma skill é instrução e não sabe nada. É o formato certo para um julgamento repetível, como triar uma queda de ranking, estruturar a saída de uma auditoria ou definir que evidência uma revisão de perfil de links precisa. Seu custo é contexto, e é pago por sessão.
Um servidor MCP é uma conexão viva. É o formato certo para dados que o agente não alcança de outra forma, como o Search Console ou um índice de backlinks. Seu custo é configuração, credenciais e permissões, e é pago uma vez. Se você quer saber o que essas conexões realmente expõem antes de ligar uma, nossa comparação de quatro servidores MCP de SEO está neste teste.
O par que funciona: uma conexão por fonte de dados, uma skill por julgamento recorrente. No nosso próprio fluxo de trabalho, a conexão com o Search Console é um servidor e a rotina de monitoramento diário é uma skill, porque o julgamento é a parte que se repete.
O que verificar antes de instalar uma
Uma passada curta de verificação, porque o formato é fácil de escrever e fácil de escrever mal.
- Leia o frontmatter e confirme que a descrição nomeia um gatilho específico. Uma descrição que diz "ajuda com SEO" vai carregar nos momentos errados.
- Conte as linhas abaixo do frontmatter. Menos de 100 linhas é uma skill focada. Acima de 500 linhas, verifique se o detalhe é material de referência que deveria ser um arquivo separado que a skill lê sob demanda.
- Procure no arquivo por credenciais e caminhos fixos no código. Uma skill deve ler configuração do ambiente, não carregar um token.
- Verifique se ela escreve no seu site. Uma skill que só lê é segura de testar numa propriedade real. Uma skill que edita arquivos deve ter um passo de revisão antes que qualquer coisa mude.
- Rode uma vez numa propriedade com que você não se importa e leia a saída. A maioria das skills é julgada pelo formato da saída, não pelas instruções.
Perguntas frequentes
Skills instaladas deixam toda sessão mais lenta? Só pelos seus blocos de metadados. Na nossa biblioteca a mediana é 107 tokens e o total nos 76 arquivos é 8.231 tokens. As instruções carregam quando a skill é usada, não antes.
Quantas skills de SEO devo manter instaladas? No nosso conjunto, dez skills de busca e medição custam cerca de 1.000 tokens de metadados em espera. O limite raramente é o contexto. O limite real é a sua própria capacidade de lembrar para que serve cada uma.
Um arquivo de skill grande é mau sinal? Não automaticamente. Skills com muita referência são legitimamente longas. Mas o comprimento deve ser justificado pelo que a skill faz. Se uma skill de 500 linhas roda uma única chamada de API com muita explicação, isso é um problema de documentação, não de capacidade.
Posso escrever minha própria skill de Claude SEO? Pode, e é a opção de maior retorno assim que você tiver uma rotina que se repete. Comece rodando a tarefa manualmente duas vezes, anote os passos que não mudaram e coloque esses no corpo. Mantenha o frontmatter abaixo de 150 tokens e descreva o gatilho com precisão.
Esses números valem especificamente para o Claude Code? O formato e o modelo de divulgação progressiva são compartilhados entre agentes que suportam SKILL.md, incluindo Claude Code e Codex. A medição vem da nossa própria biblioteca, então espere que sua distribuição seja diferente conforme o tamanho dos seus arquivos.
Visão da Auspia: instale a prateleira que você quer e depois audite o que dispara. O custo em espera de uma biblioteca de skills é pequeno o bastante para você parar de se preocupar com ele, e o custo de invocação é onde uma skill mal escrita realmente machuca. Se você nunca mediu o seu conjunto, contar as linhas abaixo do frontmatter em cada arquivo leva uns dez minutos e mostra onde está o peso. A divisão detalhada entre skill e servidor para trabalho de GEO está em nossas notas de skills de GEO.
Autor: Alice Monroe, análise de ferramentas de SEO com IA cobrindo mais de 150 ferramentas na Auspia. Escreve sobre ferramentas de SEO com IA, arquitetura de skills e servidores, e o que cada camada de uma pilha de agentes realmente custa.