Un skill Claude SEO, c'est un dossier contenant un fichier Markdown. Ce fichier indique à l'agent ce que fait le skill, quand l'utiliser et comment exécuter la tâche. Claude Code, Codex et les autres agents qui prennent en charge cette convention lisent le même format : un court bloc de métadonnées en haut, puis les instructions.
La question sur laquelle toute équipe bute au bout de deux semaines est de savoir lesquels installer. Installez tout et vous vous inquiétez de saturer la fenêtre de contexte. N'installez rien et vous revenez à copier des prompts depuis une application de notes.
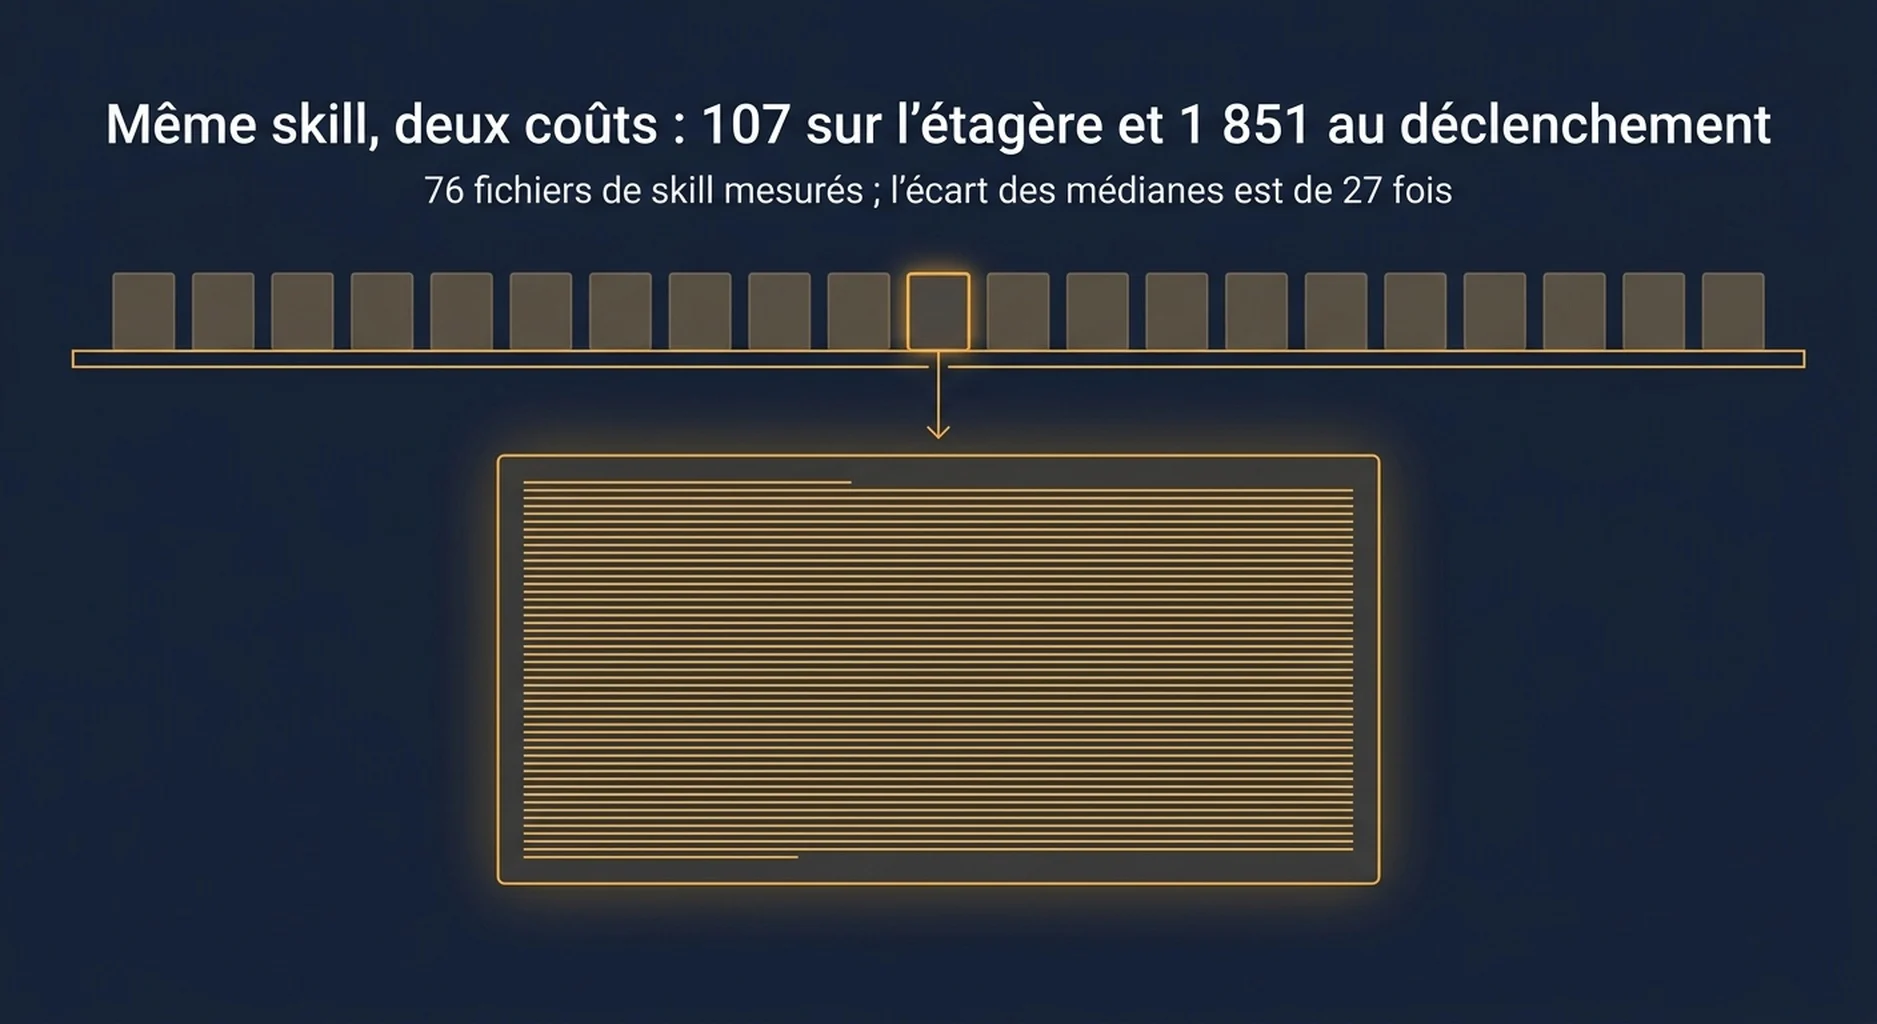
Nous avons mesuré notre propre bibliothèque pour y répondre, et la réponse se scinde nettement en deux. Un skill ne coûte presque rien tant qu'il reste inutilisé. Il coûte du contexte réel quand il se déclenche. La médiane de notre bibliothèque est de 107 tokens de métadonnées en attente et 1 851 tokens d'instructions. Ces deux chiffres devraient jouer des rôles différents dans votre décision.
La mesure
Nous avons analysé chaque fichier SKILL.md des deux racines de skills d'une même machine et découpé chaque fichier à la frontière du frontmatter.
Mesure | Valeur |
|---|---|
Fichiers de skill analysés | 76 |
Noms de skill distincts | 75 |
Bloc de métadonnées total | 8 231 tokens (estimé) |
Corps d'instructions total | 222 952 tokens (estimé) |
Rapport corps/métadonnées | 27 pour 1 |
Les décomptes de tokens sont estimés à quatre caractères par token, une bonne approximation pour l'écriture technique en anglais, mais pas exacte. Traitez-les comme des valeurs comparatives, pas littérales. La découverte tient au rapport et à la distribution ; la valeur absolue bougera avec vos propres fichiers.
Pourquoi le coût en rayon reste faible
Les systèmes de skills utilisent la divulgation progressive. Le bloc de métadonnées est chargé pour que l'agent sache que le skill existe et quand il s'applique. Le corps n'est lu que lorsque le skill est invoqué.
Cette conception produit une distribution qui mérite un coup d'œil.
Centile | Coût en attente par skill | Coût du corps par skill |
|---|---|---|
Le plus petit | 43 tokens | 428 tokens |
Médiane | 107 tokens | 1 851 tokens |
90e centile | 161 tokens | 7 125 tokens |
Le plus grand | 246 tokens | 21 702 tokens |
La bibliothèque entière de 76 fichiers porte 8 231 tokens de métadonnées en attente. C'est à peu près la taille d'un long article, et c'est le prix pour que l'agent sache que 75 skills existent avant d'avoir fait quoi que ce soit. Le plus gros bloc de métadonnées de la bibliothèque fait 246 tokens.
Le maximum est le plus intéressant. Le skill le plus bavard de la bibliothèque dépense 246 tokens pour dire à l'agent quand l'utiliser, ce qui reste assez petit pour qu'une étagère de skills ne fasse pas couler une session. Si vous craignez que l'installation de cinq skills SEO ne prenne la place de vos données, la mesure répond que l'encombrement ne se produit pas sur l'étagère.
Où le coût se loge réellement
Le corps est l'endroit où cela devient concret, et l'écart est large. 15 des 75 skills chargent moins de 1 000 tokens lorsqu'ils se déclenchent. 11 chargent plus de 5 000. Le plus gros charge 21 702.
Pour un programme SEO, c'est cette plage qu'il faut prendre comme base de planification, car elle correspond à la quantité de travail que le skill effectue. Un skill qui audite une page est bon marché. Un skill qui lance un crawl complet du site, compare à une base de référence et rédige un rapport contient beaucoup d'instructions parce qu'il comporte beaucoup d'étapes.
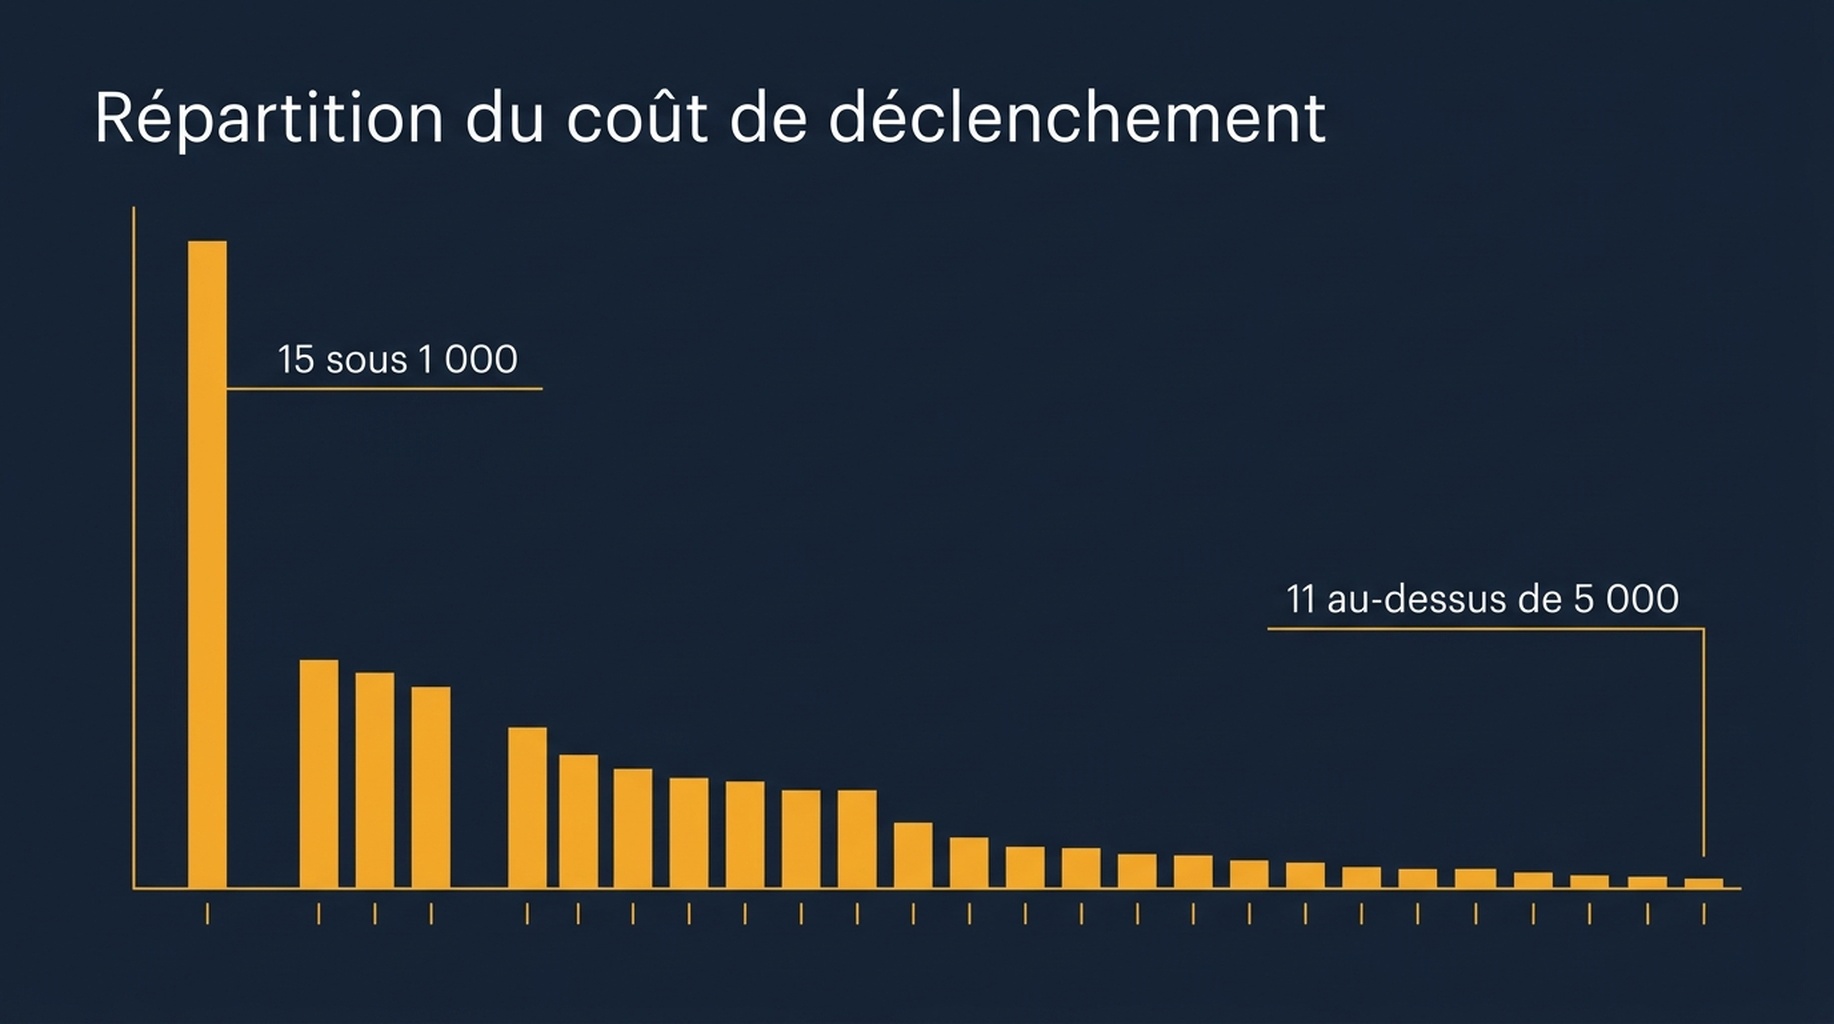
Le coût d'invocation se concentre en bas de l'échelle puis s'étire, avec 11 skills au-dessus de 5 000 tokens.
Voici notre ensemble recherche et mesure, mesuré de la même manière.
Skill | En attente | Au déclenchement |
|---|---|---|
tool-cluster-builder | 70 tokens | 428 tokens |
seo-tools-local | 102 tokens | 638 tokens |
geo-operator | 101 tokens | 665 tokens |
dataforseo-toolkit | 238 tokens | 849 tokens |
ahrefs-2026-content-refresh | 51 tokens | 958 tokens |
search-engine-visibility-audit | 49 tokens | 1 121 tokens |
codex-link-equity-audit | 96 tokens | 1 163 tokens |
gsc | 116 tokens | 1 309 tokens |
bing-webmaster | 135 tokens | 1 685 tokens |
seo-beginner-automation | 98 tokens | 1 836 tokens |
Les dix ensemble | 1 055 tokens | 10 652 tokens |
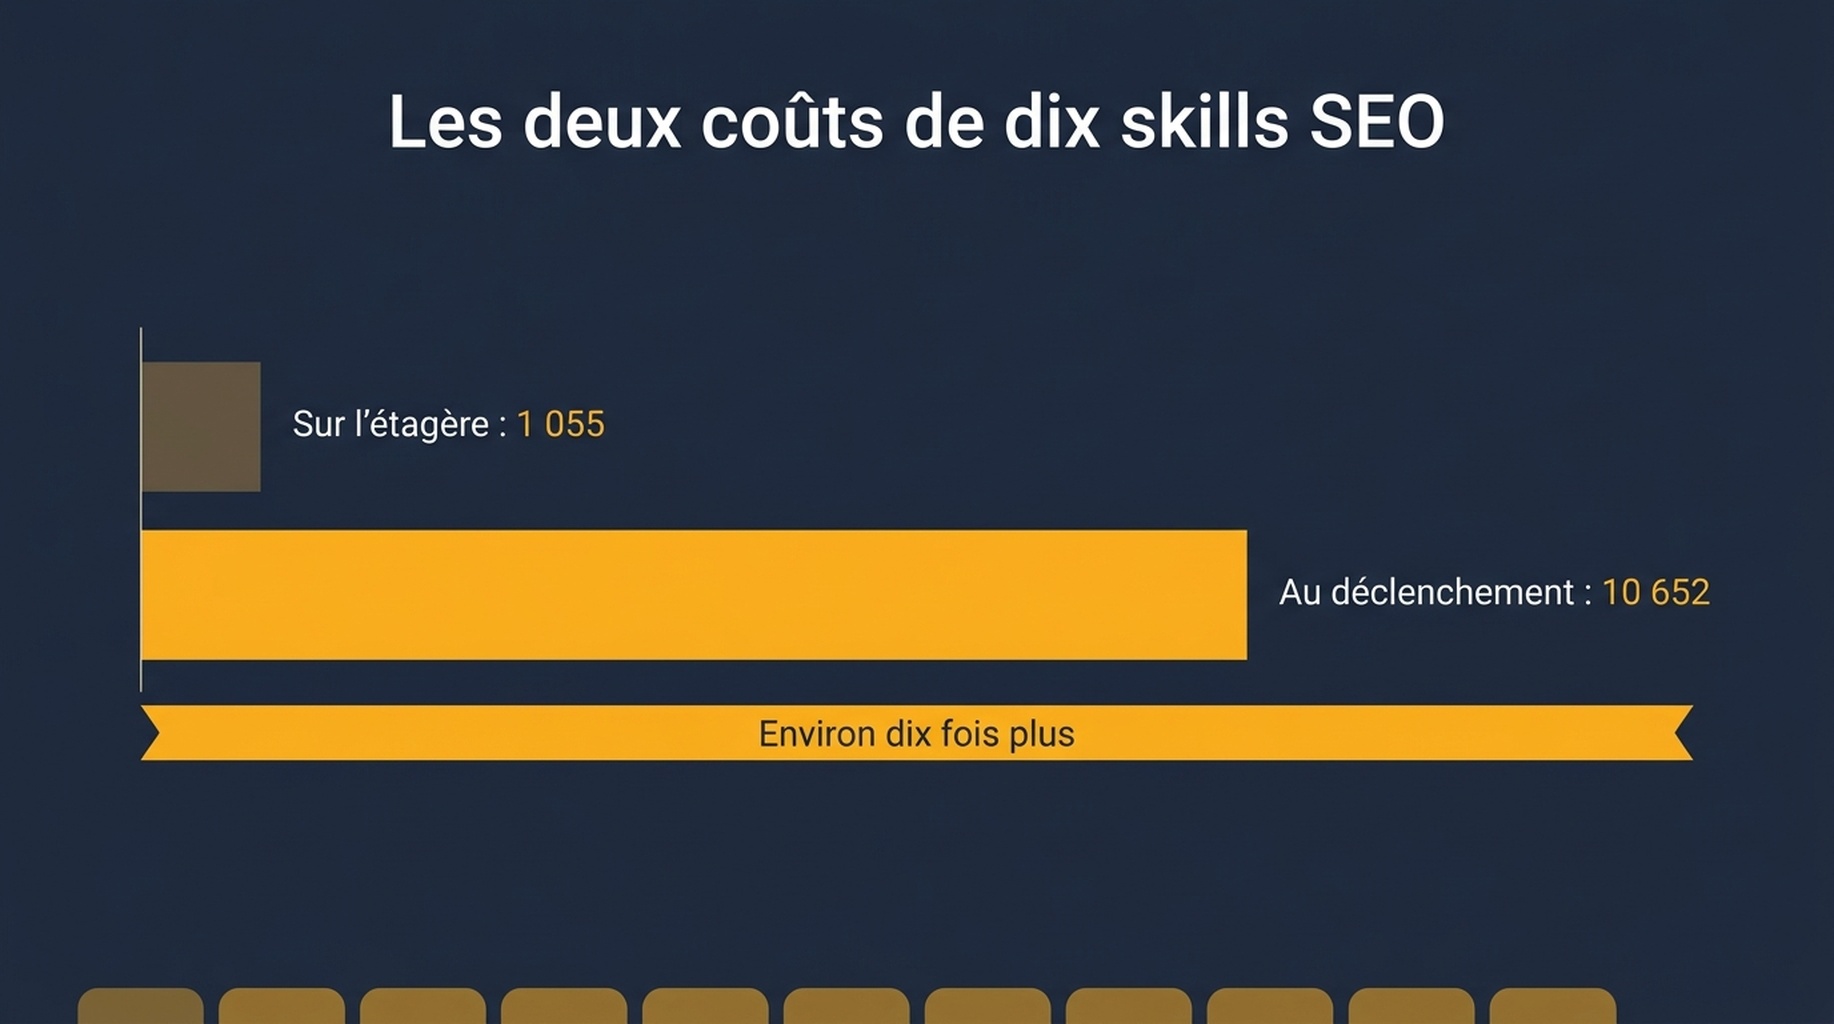
Dix skills SEO coûtent environ 1 000 tokens sur l'étagère et environ 10 000 tokens lorsqu'ils se déclenchent tous.
Deux choses tombent de ce tableau.
La colonne de l'attente est presque plate. Dix skills SEO coûtent 1 055 tokens pour être disponibles. C'est une erreur d'arrondi à côté d'une page de résultats de recherche ou d'un export de crawl, et c'est l'argument pour installer l'étagère que vous voulez plutôt que celle que vous croyez pouvoir vous permettre.
La colonne de l'invocation n'est pas plate. L'ensemble va de 428 à 1 836 tokens, un facteur de quatre. En pratique, vous en déclenchez rarement plus d'un ou deux par session, donc le chiffre honnête pour planifier n'est pas 10 652. C'est quelques milliers de tokens en plus des données que la session porte déjà.
Ce que les chiffres signifient quand vous choisissez un skill
Trois règles de sélection qui découlent de la mesure.
Jugez le corps, pas la description. Le bloc de métadonnées est la publicité du skill. Un skill peut avoir une description de 50 tokens et un corps de 7 000. Lisez le fichier avant de l'installer et vérifiez la longueur de tout ce qui se trouve sous le frontmatter. Si vous voulez un filtre rapide, la taille du fichier et le nombre de lignes sont un bon indicateur de ce que le skill va tirer.
Préférez les skills qui lisent les données à ceux qui les intègrent. Un skill qui appelle une API et lit la réponse coûte un montant fixe, quel que soit le nombre de mots-clés. Un skill qui transporte une table de correspondance ou une bibliothèque de modèles dans le Markdown coûte la même chose, que vous ayez besoin de la table ou non. C'est pourquoi un wrapper DataForSEO de 849 tokens est en pratique moins cher qu'il n'y paraît, et pourquoi un gros skill de contenu piloté par modèles coûte plus cher que sa description ne le suggère.
Budgettez la session, pas l'étagère. Le chiffre qui compte est le total de tokens d'une session active, et les skills ne sont qu'une entrée parmi plusieurs. Une session dans laquelle un export de crawl est collé et trois skills sont chargés est un problème de contexte. Une session avec vingt skills disponibles et un seul chargé n'en est pas un.
Quand un skill est le bon choix, et quand il ne l'est pas
Les skills et les serveurs MCP résolvent deux moitiés différentes du même problème, et utiliser la mauvaise moitié est la raison pour laquelle les équipes finissent sans aucune des deux.
Un skill, ce sont des instructions, et il ne sait rien. C'est la bonne forme pour un jugement répétable : comment trier une chute de classement, comment structurer la sortie d'un audit, ou quelles preuves exige une revue de profil de liens. Son coût est le contexte, et il se paie à chaque session.
Un serveur MCP est une connexion vivante. C'est la bonne forme pour des données que l'agent ne peut pas atteindre autrement, comme Search Console ou un index de backlinks. Son coût est la configuration, les identifiants et les permissions, et il se paie une fois. Si vous voulez savoir ce que ces connexions exposent réellement avant d'en câbler une, notre comparaison de quatre serveurs MCP SEO est dans ce test.
La paire qui fonctionne : une connexion par source de données, un skill par jugement récurrent. Dans notre propre flux de travail, la connexion Search Console est un serveur et la routine de surveillance quotidienne est un skill, parce que c'est le jugement qui se répète.
Ce qu'il faut vérifier avant d'en installer un
Une courte passe de vérification, car le format est facile à écrire et facile à mal écrire.
- Lisez le frontmatter et confirmez que la description nomme un déclencheur précis. Une description qui dit « aide pour le SEO » se chargera aux mauvais moments.
- Comptez les lignes sous le frontmatter. Moins de 100 lignes, c'est un skill ciblé. Au-delà de 500 lignes, vérifiez si le détail est un matériau de référence qui devrait être un fichier séparé que le skill lit à la demande.
- Cherchez dans le fichier des identifiants et des chemins codés en dur. Un skill doit lire sa configuration depuis l'environnement, pas transporter un token.
- Vérifiez s'il écrit sur votre site. Un skill qui ne fait que lire peut être testé sans risque sur une propriété en production. Un skill qui modifie des fichiers devrait avoir une étape de relecture avant que quoi que ce soit change.
- Exécutez-le une fois sur une propriété qui vous indiffère et lisez la sortie. La plupart des skills se jugent sur leur format de sortie, pas sur leurs instructions.
Questions fréquentes
Les skills installés ralentissent-ils chaque session ? Uniquement par leurs blocs de métadonnées. Dans notre bibliothèque, la médiane est de 107 tokens et le total sur 76 fichiers de 8 231 tokens. Les instructions se chargent quand le skill est utilisé, pas avant.
Combien de skills SEO dois-je garder installés ? Dans notre ensemble, dix skills de recherche et de mesure coûtent environ 1 000 tokens de métadonnées en attente. La limite est rarement le contexte. La vraie limite, c'est votre propre capacité à vous souvenir de ce à quoi sert chacun.
Un gros fichier de skill est-il mauvais signe ? Pas automatiquement. Les skills riches en références sont légitimement longs. Mais la longueur doit être justifiée par ce que fait le skill. Si un skill de 500 lignes exécute un seul appel d'API avec beaucoup d'explications, c'est un problème de documentation, pas de capacité.
Puis-je écrire mon propre skill Claude SEO ? Oui, et c'est l'option au meilleur rendement dès que vous avez une routine qui se répète. Commencez par exécuter la tâche à la main deux fois, notez les étapes qui n'ont pas changé et mettez-les dans le corps. Gardez le frontmatter sous 150 tokens et décrivez le déclencheur avec précision.
Ces chiffres s'appliquent-ils spécifiquement à Claude Code ? Le format et le modèle de divulgation progressive sont communs aux agents qui prennent en charge SKILL.md, dont Claude Code et Codex. La mesure vient de notre propre bibliothèque, attendez-vous donc à ce que votre distribution diffère selon la taille de vos fichiers.
Vue d'Auspia : installez l'étagère que vous voulez, puis auditez ce qui se déclenche. Le coût en attente d'une bibliothèque de skills est assez faible pour cesser de vous en soucier, et le coût d'invocation est l'endroit où un skill mal écrit fait vraiment mal. Si vous n'avez jamais mesuré votre propre ensemble, compter les lignes sous le frontmatter de chaque fichier prend une dizaine de minutes et vous dit où se trouve le poids. La répartition détaillée entre skill et serveur pour le travail GEO est traitée dans nos notes sur les skills GEO.
Rédaction : Alice Monroe, analyse d'outils SEO par IA couvrant plus de 150 outils chez Auspia. Écrit sur les outils SEO par IA, l'architecture des skills et des serveurs, et ce que coûte réellement chaque couche d'une pile d'agents.