Claude SEO 技能就是一个文件夹,里面放着一个 Markdown 文件。这个文件告诉智能体:技能是做什么的、什么时候该用、任务怎么跑。Claude Code、Codex 以及其他支持这套约定的智能体读的是同一种格式:顶部一小段元数据块,然后是具体指令。
每个团队跑到第二周左右都会撞上同一个问题:这些技能里该装哪些。全装,你担心把上下文窗口填满;一个不装,你又回到从笔记应用里复制提示词的日子。
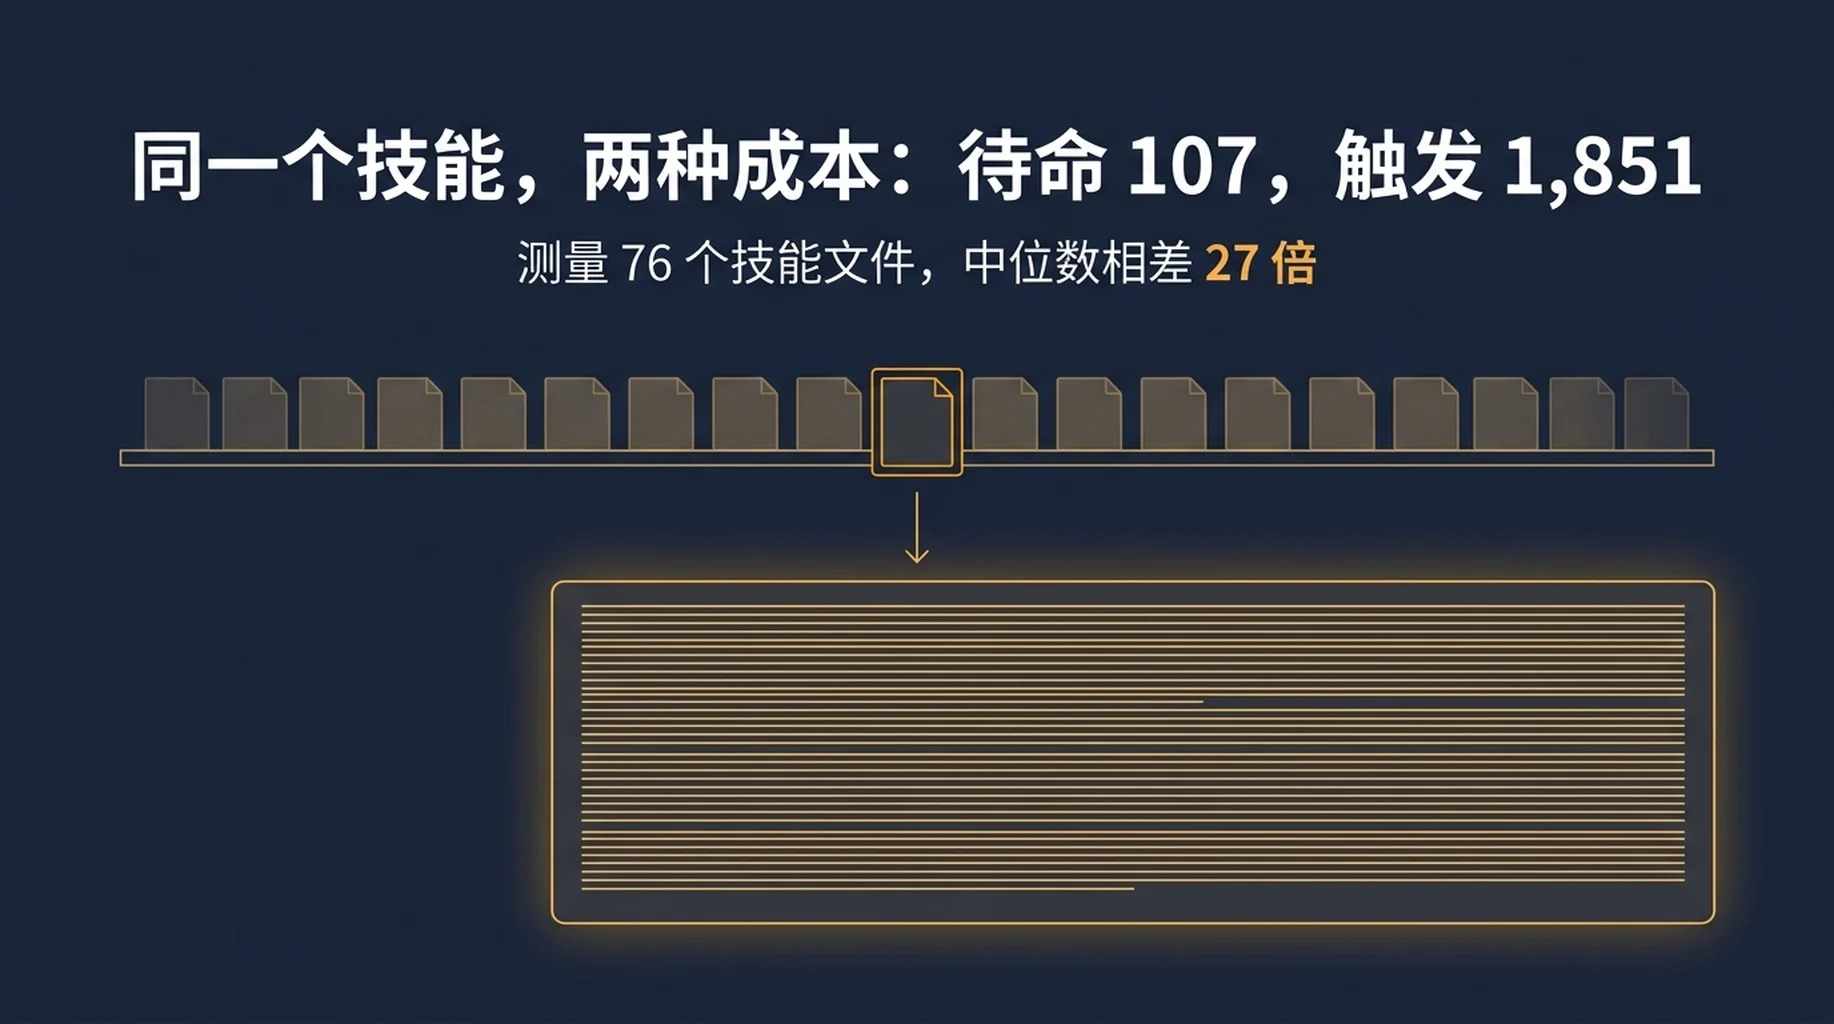
为了回答这个问题,我们测量了自己的技能库,答案干脆利落地分成两半。技能闲置在架子上时几乎不花钱;真正触发时才占用实实在在的上下文。我们库里的中位数是:待机元数据 107 token,指令正文 1,851 token。这两个数字在你的决策里应该承担不同的角色。
测量方法
我们解析了同一台机器上两个技能根目录里的每一个 SKILL.md 文件,并在 frontmatter 边界处把每个文件切开。
指标 | 数值 |
|---|---|
解析的技能文件 | 76 |
去重后的技能名 | 75 |
元数据块总量 | 8,231 token(估算) |
指令正文总量 | 222,952 token(估算) |
正文与元数据之比 | 27 比 1 |
token 数按 4 个字符折 1 个 token 估算。对英文技术写作来说这是不错的近似,但并不精确。请把它当作比较用的数字,而不是字面值。真正的发现是比例和分布,绝对值会随你自己的文件而变化。
为什么架子上的成本一直很小
技能系统用的是渐进式披露。元数据块会被加载,好让智能体知道技能存在、什么时候适用。正文只有在技能被调用时才读。
这个设计产生的分布值得看一眼。
分位 | 每技能待机成本 | 每技能正文成本 |
|---|---|---|
最小 | 43 token | 428 token |
中位数 | 107 token | 1,851 token |
90 分位 | 161 token | 7,125 token |
最大 | 246 token | 21,702 token |
76 个文件整库加起来,待机元数据是 8,231 token。大约相当于一篇长文,这就是让智能体在什么都没做之前先知道有 75 个技能存在的代价。库里最大的单个元数据块是 246 token。
最大值才是最有意思的。库里最啰嗦的技能也只花 246 token 来告诉智能体何时该用它,这个量级仍然小到不会让一排技能拖垮一次会话。如果你担心装五个 SEO 技能会挤掉数据的位置,测量给出的答案是:拥挤并不发生在架子上。
成本真正住的地方
真正见真章的是正文,而且离散度很宽。75 个技能里有 15 个触发时加载不到 1,000 token,11 个超过 5,000,最大的一个加载 21,702。
对一个 SEO 项目来说,这个区间才是要做规划的依据,因为它对应着技能干了多少活。只审计一个页面的技能很便宜。要跑整站抓取、对比基线、再写出一份报告的技能,步骤多,指令自然就多。
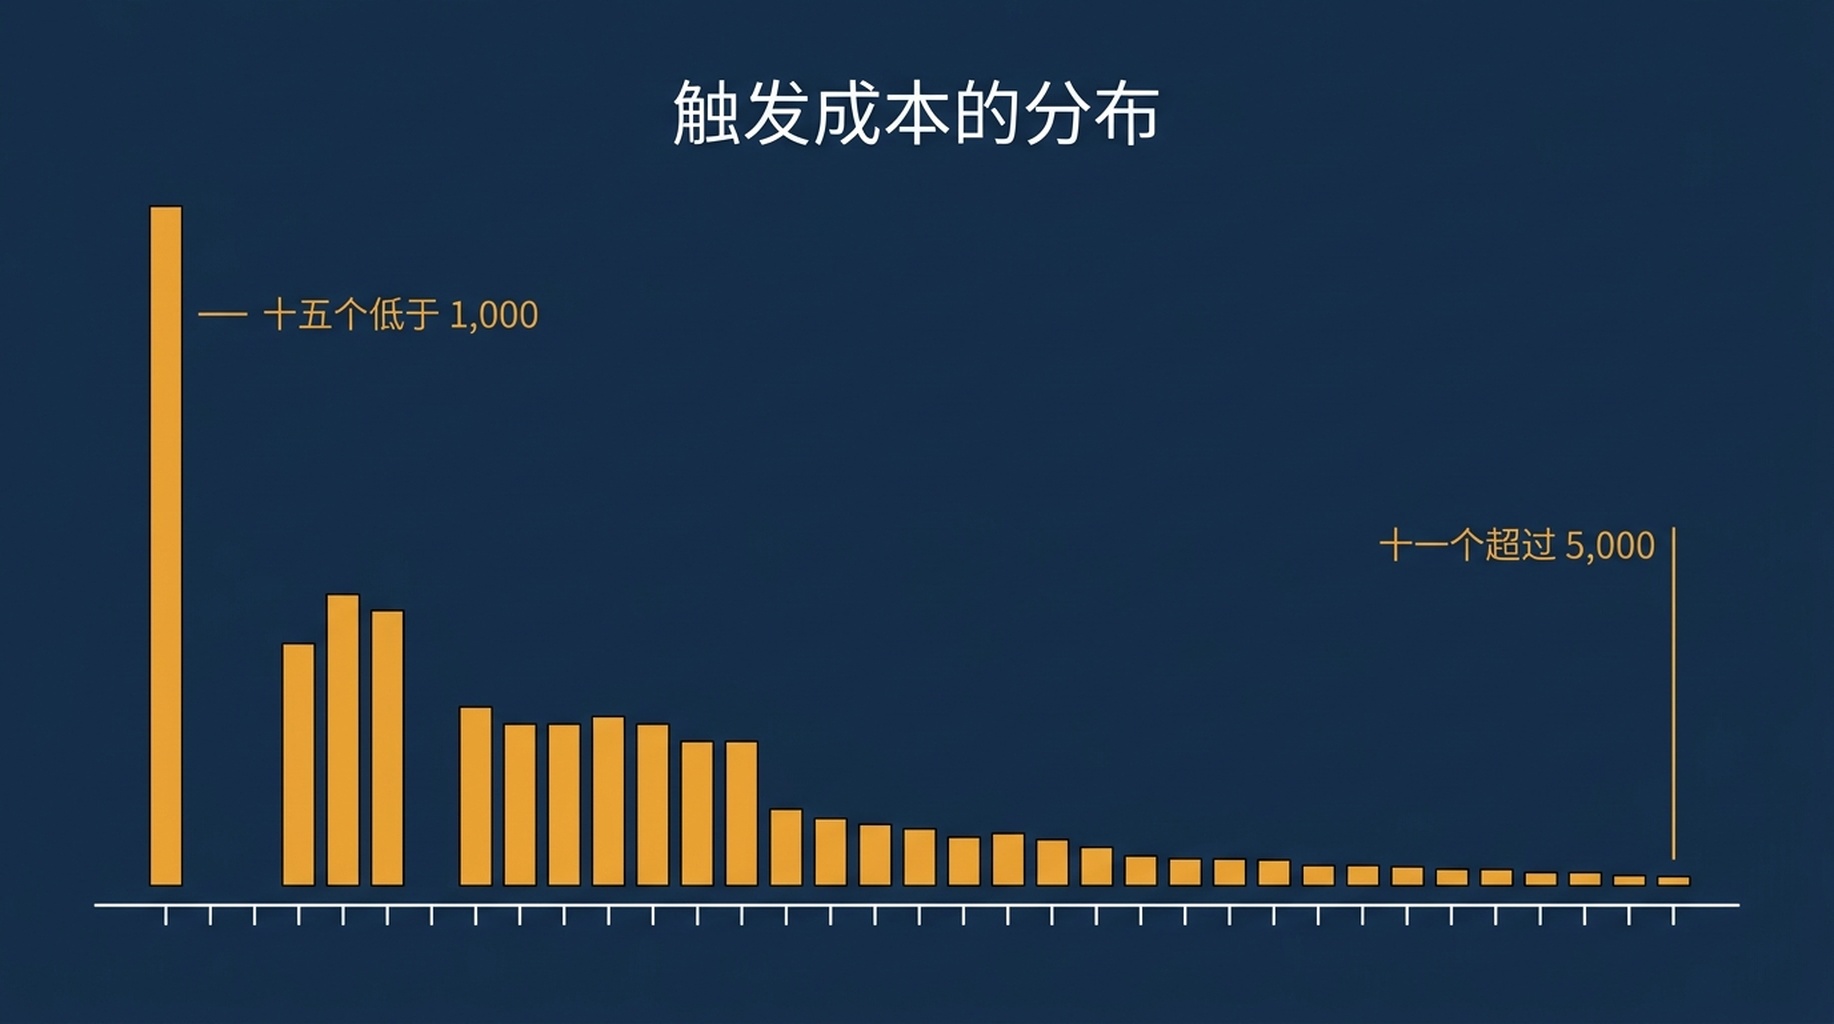
调用成本集中在下限,然后拖出一条长尾,有 11 个技能超过 5,000 token。
下面是我们自己那套搜索与测量技能,用同样的方法测得的结果。
技能 | 待机 | 触发时 |
|---|---|---|
tool-cluster-builder | 70 token | 428 token |
seo-tools-local | 102 token | 638 token |
geo-operator | 101 token | 665 token |
dataforseo-toolkit | 238 token | 849 token |
ahrefs-2026-content-refresh | 51 token | 958 token |
search-engine-visibility-audit | 49 token | 1,121 token |
codex-link-equity-audit | 96 token | 1,163 token |
gsc | 116 token | 1,309 token |
bing-webmaster | 135 token | 1,685 token |
seo-beginner-automation | 98 token | 1,836 token |
十个合计 | 1,055 token | 10,652 token |
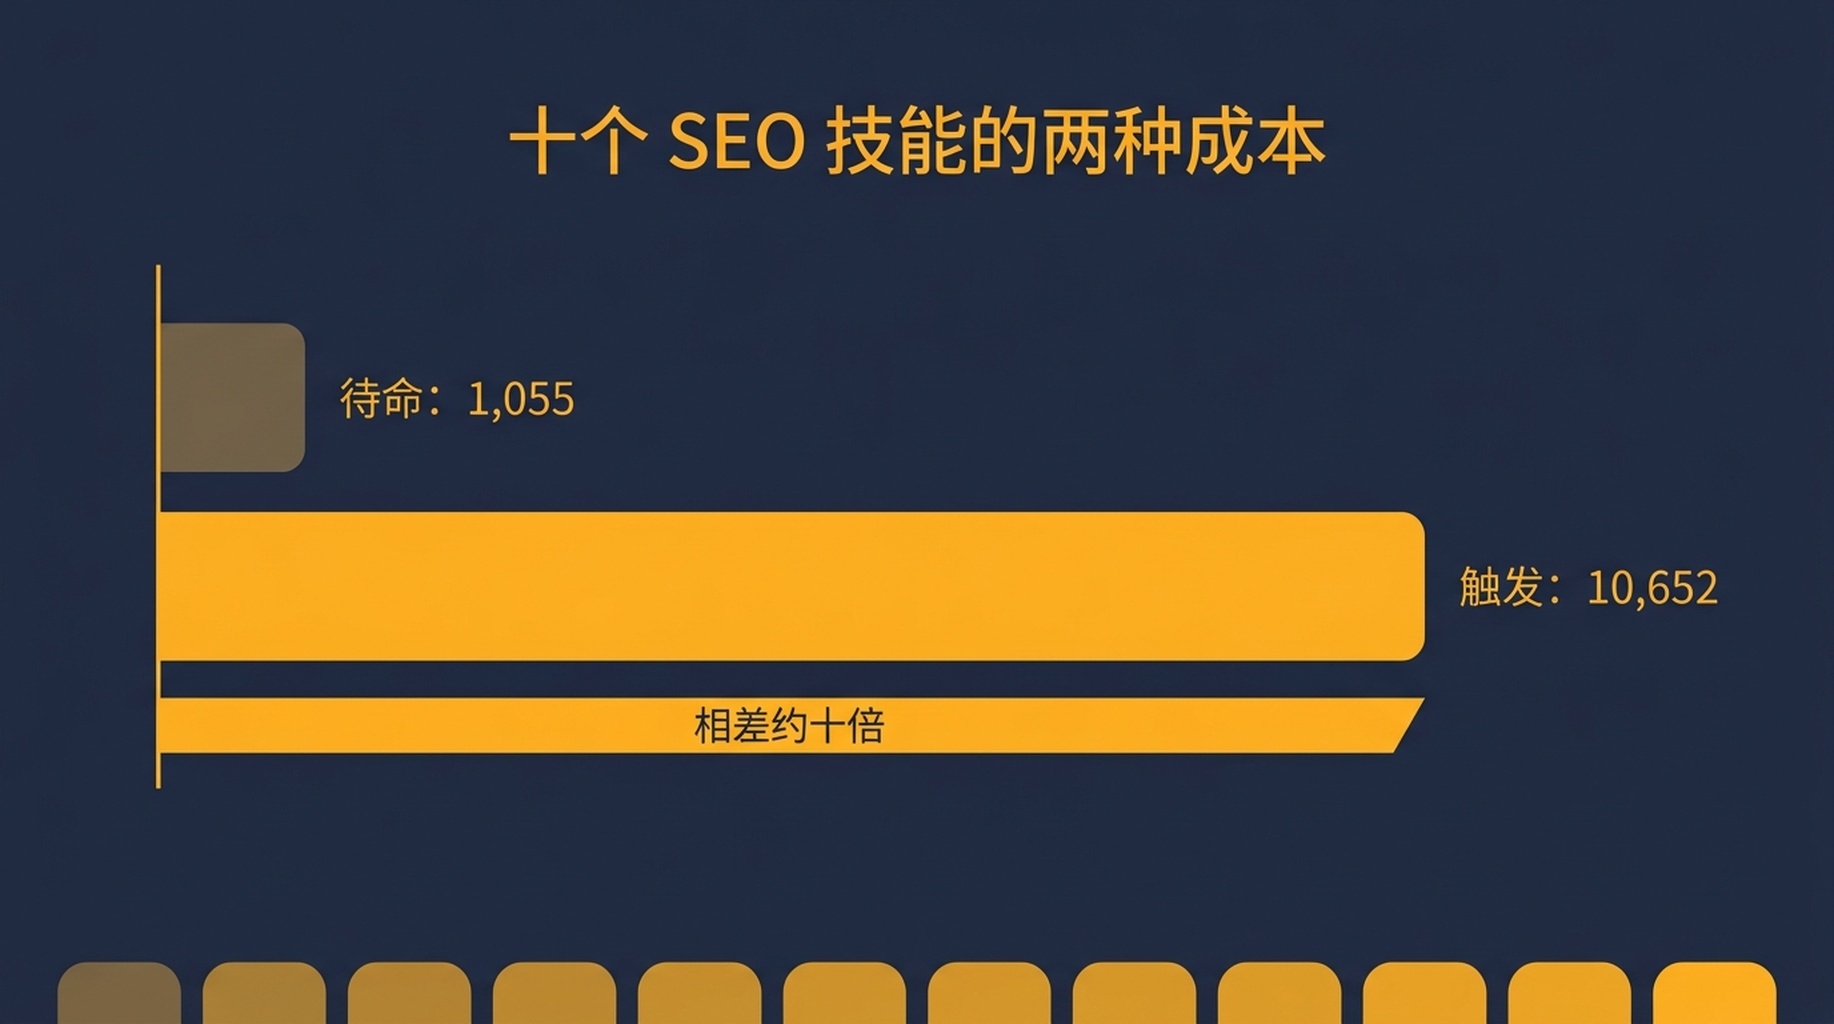
十个 SEO 技能在架子上约花 1,000 token,全部触发时约花 10,000 token。
从这张表里能掉出两件事。
待机那一列几乎是平的。十个 SEO 技能常备成本 1,055 token。相比一页搜索结果或一份抓取导出,这是舍入误差,也是「装你想要的那排技能,而不是你以为装得起的那排」的理由。
触发那一列不平。这套技能从 428 到 1,836 token,相差四倍。实际上一次会话里你很少触发超过一两个,所以诚实的规划数字不是 10,652,而是在会话已经持有的数据之上多加几千 token。
选技能时,这些数字意味着什么
从测量中直接得出的三条选择规则。
看正文,别看描述。 元数据块是技能的广告。一个技能完全可以是 50 token 的描述配 7,000 token 的正文。装之前先读文件,看看 frontmatter 以下有多长。想要快速筛选的话,文件大小和行数是不错的代理指标,能说明这个技能会拉进来多少东西。
优先选读数据的技能,而不是把数据内嵌进去的技能。 一个调用 API 并读取响应的技能,成本是固定的,跟你有多少关键词无关。一个把查找表或模板库背在 Markdown 里的技能,不管你用不用那张表,都得付同样的成本。这就是为什么 849 token 的 DataForSEO 封装实际比看上去便宜,也是为什么模板驱动的大型内容技能比它的描述更贵。
给会话做预算,而不是给架子做预算。 真正重要的数字是一次活跃会话的总 token 数,技能只是其中一项输入。一次会话里贴了一份抓取导出、又加载了三个技能,那是上下文问题。一次会话里有二十个技能可用、只加载了一个,那不是问题。
什么时候该用技能,什么时候不该用
技能和 MCP 服务器解决的是同一个问题的两半,用错那一半,结果往往是两样都没做好。
技能是指令,本身什么都不知道。它适合承载可重复的判断,比如怎么给排名下跌分类、审计输出该怎么组织、链接档案评审需要哪些证据。它的成本是上下文,按会话支付。
MCP 服务器是活的连接。它适合承载智能体用别的方式够不到的数据,比如 Search Console 或外链索引。它的成本是配置、凭据和权限,只需付一次。如果你想知道这些连接究竟暴露了什么再决定要不要接,我们对四个 SEO MCP 服务器的对比就在这次实测里。
真正管用的搭配是:每个数据源一条连接,每个重复出现的判断一个技能。在我们自己的工作流里,Search Console 连接是服务器,而每日监控例程是技能,因为会重复的是判断那一部分。
装之前要检查什么
一段简短的验收流程,因为这个格式好写,也好写坏。
- 读 frontmatter,确认描述点名了一个具体的触发条件。写着「对 SEO 有帮助」的描述,会在错误的时刻被加载。
- 数一数 frontmatter 以下的行数。100 行以内是聚焦的技能。超过 500 行,就要检查那些细节是不是本该成为技能按需读取的独立参考文件。
- 在文件里搜一下凭据和硬编码路径。技能应该从环境里读配置,而不是自己带着 token。
- 检查它会不会写你的站点。只读的技能可以放心在真实站点上试。会编辑文件的技能,应该在任何东西改变之前有一个复核步骤。
- 先在一个你不在乎的站点上跑一次,读它的输出。大多数技能是靠输出格式被评判的,不是靠指令。
常见问题
装上的技能会拖慢每一次会话吗? 只会拖慢元数据块那部分。在我们库里,中位数是 107 token,76 个文件合计 8,231 token。指令是在技能被使用时才加载,而不是提前加载。
我该常备多少个 SEO 技能? 在我们自己这套里,十个搜索与测量技能常备成本约 1,000 token。上限很少是上下文。真正的上限是你自己记住每个技能是干什么用的能力。
技能文件很大是坏信号吗? 不能一概而论。参考材料多的技能本来就该长。但长度应该由技能做的事来证明。如果一个 500 行的技能只是做一次 API 调用却配了大段解释,那是文档问题,不是能力问题。
我可以自己写 Claude SEO 技能吗? 可以,而且一旦你有了一段会重复的例程,这是回报最高的选择。先把那件事手动跑两遍,把没变过的步骤写下来放进正文。frontmatter 控制在 150 token 以内,并把触发条件描述准确。
这些数字专门适用于 Claude Code 吗? 这套格式和渐进式披露模型在支持 SKILL.md 的智能体之间是共通的,包括 Claude Code 和 Codex。测量来自我们自己的库,所以你的分布会随你自己的文件大小而不同。
Auspia 观点:装你想要的那排技能,然后审计到底触发了什么。技能库的待机成本小到可以不再操心,而一个写得糟糕的技能真正造成伤害的地方是调用成本。如果你还没量过自己那套,把每个文件 frontmatter 以下的行数数一遍大约花十分钟,就能告诉你重量压在哪里。GEO 工作中技能与服务器的详细分工,见我们的 GEO 技能笔记。
作者:Alice Monroe,Auspia 的 AI SEO 工具分析师,覆盖 150 多个工具。撰写 AI SEO 工具、技能与服务器架构,以及智能体栈的每一层实际要花多少钱。