Claude SEO 技能就是一個資料夾,裡面放著一個 Markdown 檔案。這個檔案告訴代理:技能是做什麼的、什麼時候該用、任務怎麼跑。Claude Code、Codex 以及其他支援這套慣例的代理讀的是同一種格式:頂部一小段中繼資料區塊,然後是具體指令。
每個團隊跑到第二週左右都會撞上同一個問題:這些技能裡該裝哪些。全裝,你擔心把上下文視窗填滿;一個都不裝,你又回到從筆記應用裡複製提示詞的日子。
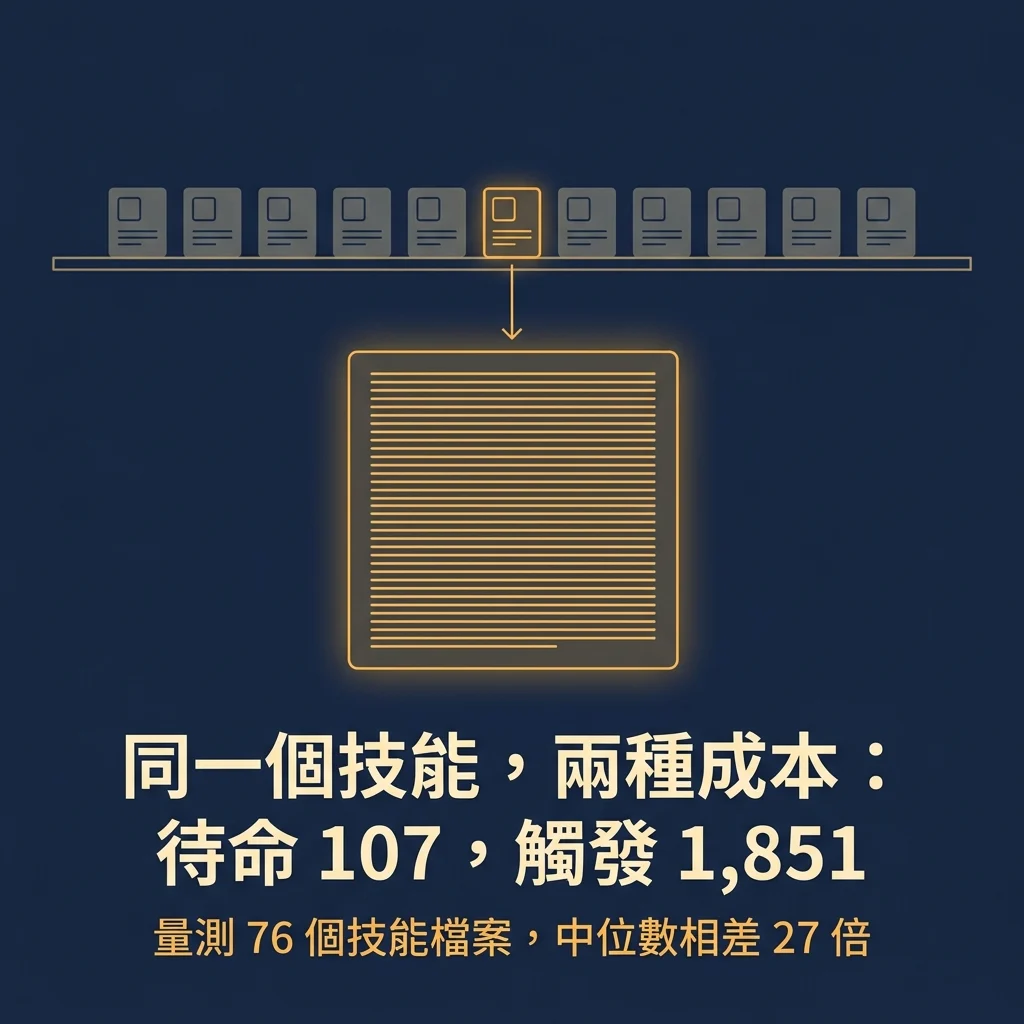
為了回答這個問題,我們量測了自己的技能庫,答案乾淨俐落地分成兩半。技能閒置在架上時幾乎不花錢;真正觸發時才佔用實實在在的上下文。我們庫裡的中位數是:待機中繼資料 107 token,指令本文 1,851 token。這兩個數字在你的決策裡應該承擔不同的角色。
量測方法
我們解析了同一台機器上兩個技能根目錄裡的每一個 SKILL.md 檔案,並在 frontmatter 邊界處把每個檔案切開。
指標 | 數值 |
|---|---|
解析的技能檔案 | 76 |
去重後的技能名稱 | 75 |
中繼資料區塊總量 | 8,231 token(估算) |
指令本文總量 | 222,952 token(估算) |
本文與中繼資料之比 | 27 比 1 |
token 數按 4 個字元折 1 個 token 估算。對英文技術寫作來說這是相當好的近似,但並不精確。請把它當作比較用的數字,而不是字面值。真正的發現是比例與分布,絕對值會隨你自己的檔案而變動。
為什麼架上的成本一直很小
技能系統用的是漸進式揭露。中繼資料區塊會被載入,好讓代理知道技能存在、什麼時候適用。本文只有在技能被呼叫時才讀取。
這個設計產生的分布值得看一眼。
百分位 | 每技能待機成本 | 每技能本文成本 |
|---|---|---|
最小 | 43 token | 428 token |
中位數 | 107 token | 1,851 token |
第 90 百分位 | 161 token | 7,125 token |
最大 | 246 token | 21,702 token |
76 個檔案整庫加起來,待機中繼資料是 8,231 token。大約等於一篇長文,這就是讓代理在什麼都還沒做之前先知道有 75 個技能存在的代價。庫裡最大的單一中繼資料區塊是 246 token。
最大值才是最有意思的。庫裡最囉唆的技能也只花 246 token 來告訴代理何時該用它,這個量級仍然小到不會讓一整排技能拖垮一次工作階段。如果你擔心裝五個 SEO 技能會擠掉資料的位置,量測給出的答案是:擁擠並不發生在架上。
成本真正住的地方
真正見真章的是本文,而且離散度很寬。75 個技能裡有 15 個觸發時載入不到 1,000 token,11 個超過 5,000,最大的一個載入 21,702。
對一個 SEO 專案來說,這個區間才是規劃的依據,因為它對應著技能做了多少事。只稽核一個頁面的技能很便宜。要跑整站爬取、比對基準線、再寫出一份報告的技能,步驟多,指令自然就多。
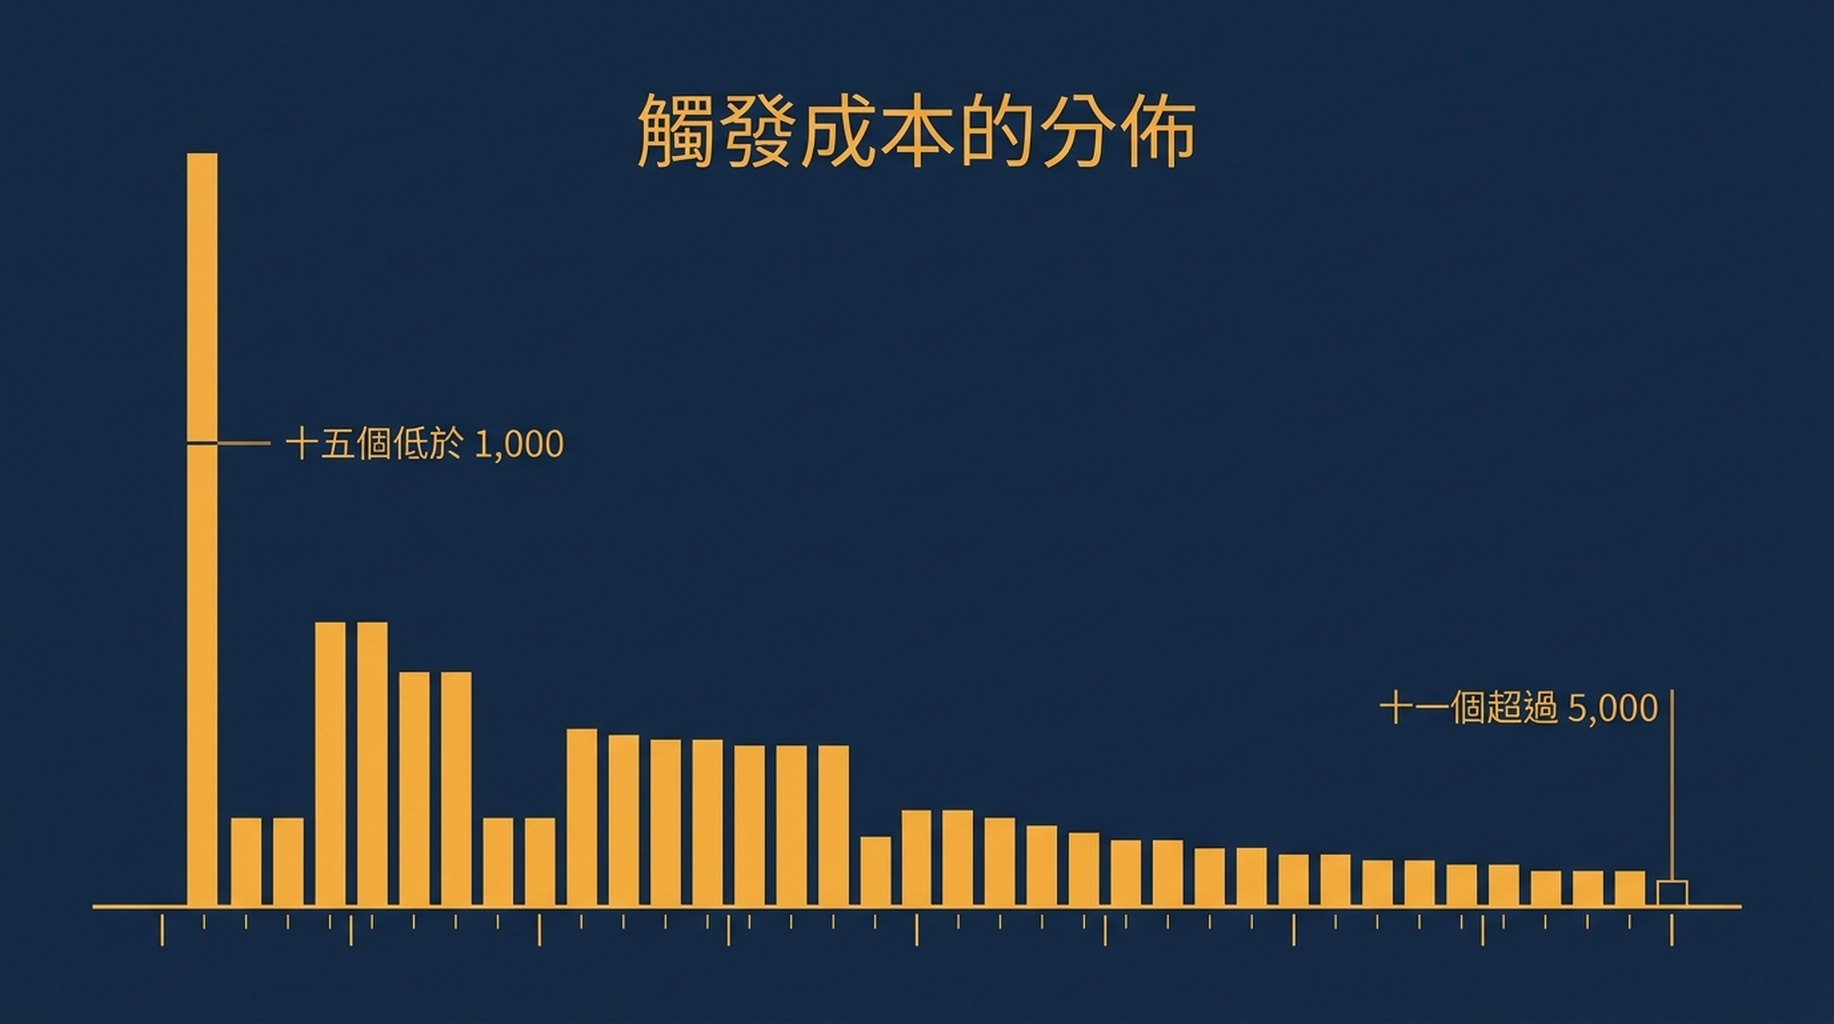
呼叫成本集中在下限,然後拖出一條長尾,有 11 個技能超過 5,000 token。
以下是我們自己那套搜尋與量測技能,用同樣方法量到的結果。
技能 | 待機 | 觸發時 |
|---|---|---|
tool-cluster-builder | 70 token | 428 token |
seo-tools-local | 102 token | 638 token |
geo-operator | 101 token | 665 token |
dataforseo-toolkit | 238 token | 849 token |
ahrefs-2026-content-refresh | 51 token | 958 token |
search-engine-visibility-audit | 49 token | 1,121 token |
codex-link-equity-audit | 96 token | 1,163 token |
gsc | 116 token | 1,309 token |
bing-webmaster | 135 token | 1,685 token |
seo-beginner-automation | 98 token | 1,836 token |
十個合計 | 1,055 token | 10,652 token |
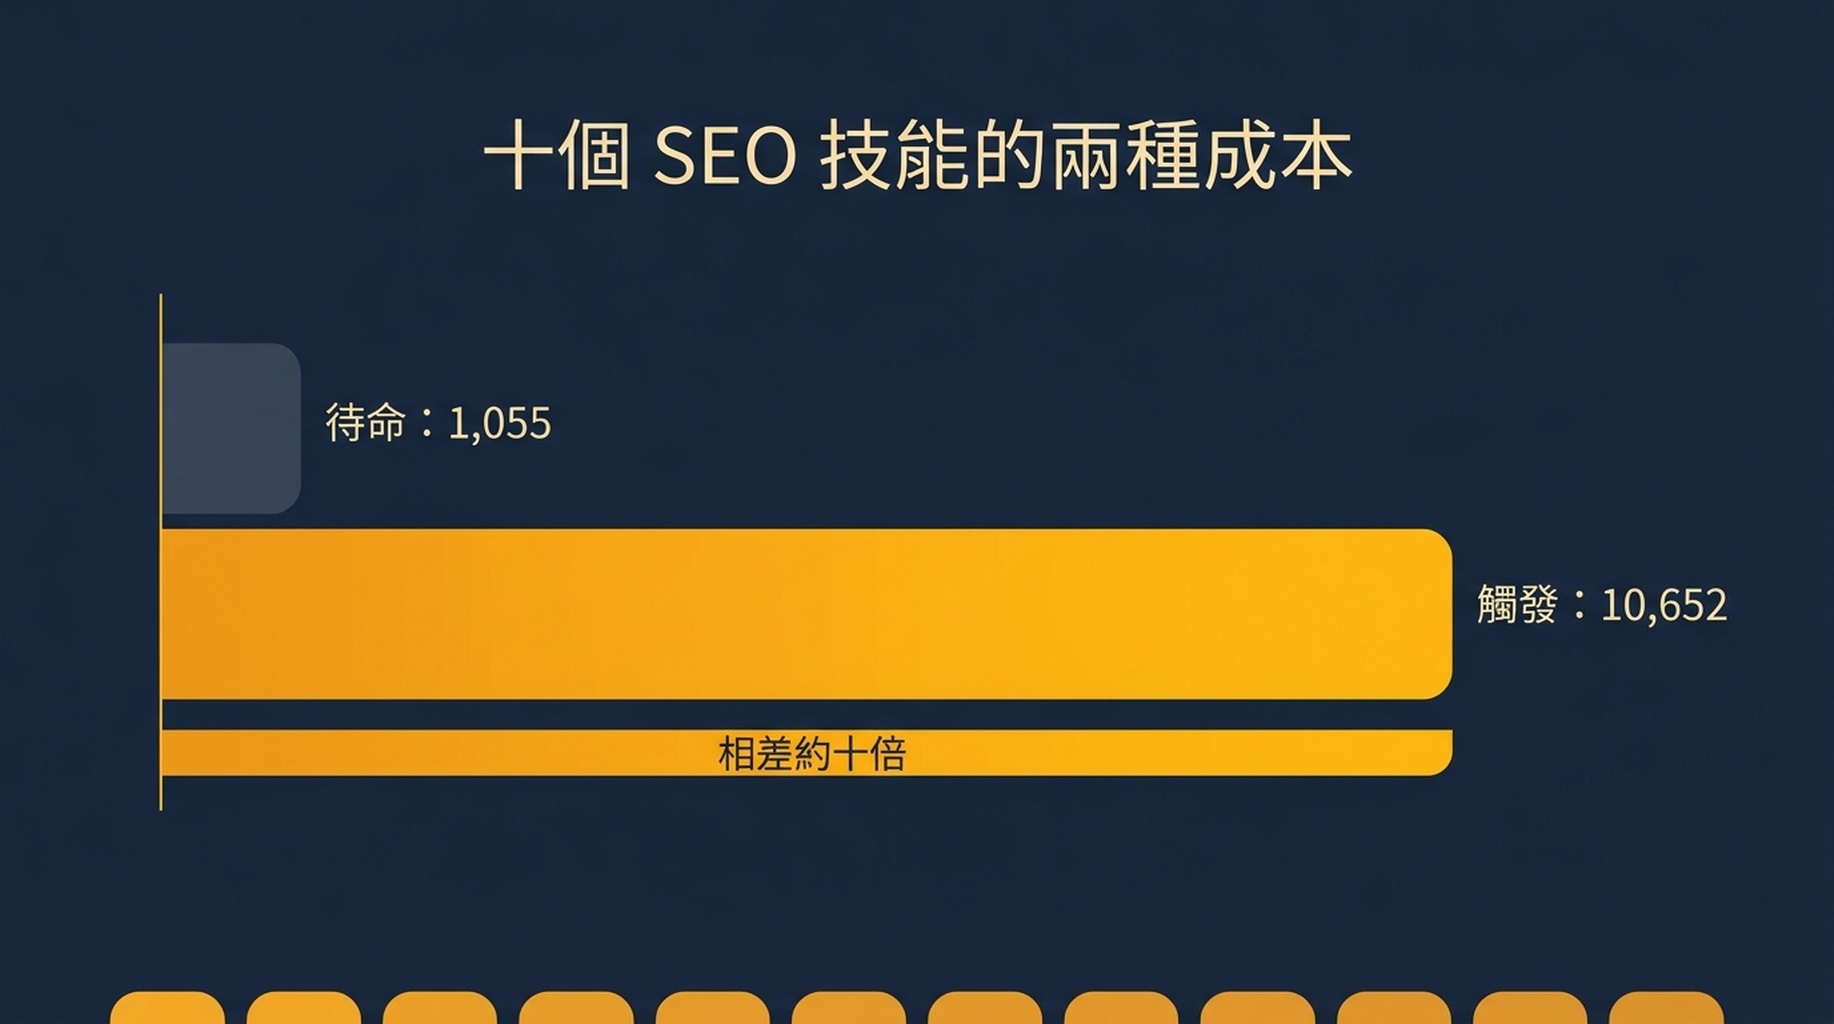
十個 SEO 技能在架上約花 1,000 token,全部觸發時約花 10,000 token。
從這張表裡能掉出兩件事。
待機那一欄幾乎是平的。十個 SEO 技能常備成本 1,055 token。相比一頁搜尋結果或一份爬取匯出,這是捨入誤差,也是「裝你想要的那排技能,而不是你以為裝得起的那排」的理由。
觸發那一欄不平。這套技能從 428 到 1,836 token,相差四倍。實際上一次工作階段裡你很少觸發超過一兩個,所以誠實的規劃數字不是 10,652,而是在工作階段已經持有的資料之上多加幾千 token。
選技能時,這些數字意味著什麼
從量測中直接得出的三條選擇規則。
看本文,別看描述。 中繼資料區塊是技能的廣告。一個技能完全可以是 50 token 的描述配 7,000 token 的本文。裝之前先讀檔案,看看 frontmatter 以下有多長。想要快速篩選的話,檔案大小和行數是不錯的代理指標,能說明這個技能會拉進來多少東西。
優先選讀資料的技能,而不是把資料內嵌進去的技能。 一個呼叫 API 並讀取回應的技能,成本是固定的,跟你有多少關鍵字無關。一個把查找表或範本庫背在 Markdown 裡的技能,不管你用不用那張表,都得付同樣的成本。這就是為什麼 849 token 的 DataForSEO 封裝實際比看起來便宜,也是為什麼範本驅動的大型內容技能比它的描述更貴。
給工作階段做預算,而不是給架子做預算。 真正重要的數字是一次進行中工作階段的總 token 數,技能只是其中一項輸入。一次工作階段裡貼了一份爬取匯出、又載入了三個技能,那是上下文問題。一次工作階段裡有二十個技能可用、只載入了一個,那不是問題。
什麼時候該用技能,什麼時候不該用
技能和 MCP 伺服器解決的是同一個問題的兩半,用錯那一半,結果往往是兩樣都沒做好。
技能是指令,本身什麼都不知道。它適合承載可重複的判斷,比如怎麼替排名下跌分類、稽核輸出該怎麼組織、連結檔案審查需要哪些證據。它的成本是上下文,按工作階段支付。
MCP 伺服器是活的連線。它適合承載代理用別的方式搆不到的資料,比如 Search Console 或反向連結索引。它的成本是設定、憑證和權限,只需付一次。如果你想知道這些連線究竟暴露了什麼再決定要不要接,我們對四個 SEO MCP 伺服器的比較就在這次實測裡。
真正管用的搭配是:每個資料來源一條連線,每個重複出現的判斷一個技能。在我們自己的工作流裡,Search Console 連線是伺服器,而每日監控例行程序是技能,因為會重複的是判斷那一部分。
裝之前要檢查什麼
一段簡短的驗收流程,因為這個格式好寫,也好寫壞。
- 讀 frontmatter,確認描述點名了一個具體的觸發條件。寫著「對 SEO 有幫助」的描述,會在錯誤的時刻被載入。
- 數一數 frontmatter 以下的行數。100 行以內是聚焦的技能。超過 500 行,就要檢查那些細節是不是本來就該成為技能按需讀取的獨立參考檔案。
- 在檔案裡搜一下憑證和寫死的路徑。技能應該從環境裡讀設定,而不是自己帶著 token。
- 檢查它會不會寫你的站點。唯讀的技能可以放心在真實站點上試。會編輯檔案的技能,應該在任何東西改變之前有一個複核步驟。
- 先在一個你不在乎的站點上跑一次,讀它的輸出。大多數技能是靠輸出格式被評判的,不是靠指令。
常見問題
裝上的技能會拖慢每一次工作階段嗎? 只會拖慢中繼資料區塊那部分。在我們庫裡,中位數是 107 token,76 個檔案合計 8,231 token。指令是在技能被使用時才載入,而不是提前載入。
我該常備多少個 SEO 技能? 在我們自己這套裡,十個搜尋與量測技能常備成本約 1,000 token。上限很少是上下文。真正的上限是你自己記住每個技能是幹什麼用的能力。
技能檔案很大是壞訊號嗎? 不能一概而論。參考材料多的技能本來就該長。但長度應該由技能做的事來證明。如果一個 500 行的技能只是做一次 API 呼叫卻配了大段解釋,那是文件問題,不是能力問題。
我可以自己寫 Claude SEO 技能嗎? 可以,而且一旦你有了一段會重複的例行程序,這是回報最高的選擇。先把那件事手動跑兩遍,把沒變過的步驟寫下來放進本文。frontmatter 控制在 150 token 以內,並把觸發條件描述準確。
這些數字專門適用於 Claude Code 嗎? 這套格式和漸進式揭露模型在支援 SKILL.md 的代理之間是共通的,包括 Claude Code 和 Codex。量測來自我們自己的庫,所以你的分布會隨你自己的檔案大小而不同。
Auspia 觀點:裝你想要的那排技能,然後稽核到底觸發了什麼。技能庫的待機成本小到可以不再操心,而一個寫得糟糕的技能真正造成傷害的地方是呼叫成本。如果你還沒量過自己那套,把每個檔案 frontmatter 以下的行數數一遍大約花十分鐘,就能告訴你重量壓在哪裡。GEO 工作中技能與伺服器的詳細分工,見我們的 GEO 技能筆記。
作者:Alice Monroe,Auspia 的 AI SEO 工具分析師,涵蓋 150 多個工具。撰寫 AI SEO 工具、技能與伺服器架構,以及代理堆疊的每一層實際要花多少錢。