この記事を読み終えると得られるもの
25万2,000回の試行を実施した対照研究がAI引用の決め手と結論づけた4つの要因に対するページ単位の監査と、その4つが整った後に効いてくる7つの二次要因の修正順序です。あわせて、「スキーママークアップはAI引用にまったく効果がない」という広く出回っている主張が、その研究の実際の結論ではない理由を出典付きで理解できます。間違った修正にスプリントを浪費することを避けられます。
対象読者: ChatGPT、Gemini、Perplexity、Claude、GoogleのAI回答に引用されたいサイトの、ページ単位のSEOまたはGEOを担当している方。
所要時間: 1ページあたり30〜45分(監査と一次修正まで)。
完了条件: 監査対象のページが4つのゲートキーパー検査をすべて通過し、まだ対応が必要な二次要因の一覧が手元に書き出されている状態。
はじめる前に:このチェックリストの根拠と、それが正すもの
SEO/GEOの界隈で出回っている投稿に、SIGIRの研究が6つのLLMで25万2,000回の試行を行い、スキーマとJSON-LDはAI引用に「測定可能な効果ゼロ」だった一方、価格・鮮度・仕様・網羅性は大きく効果を動かした、という主張があります。
研究は実在します。試行回数も正しい。その投稿に載っているオッズ比も、実際の数値に近いものです。成り立たないのは一点、その研究はスキーママークアップを検証していません。スキーマが「効果ゼロと測定された」のではなく、そもそも測定対象のリストにスキーマが入っていなかったのです。
論文は "What Gets Cited: Competitive GEO in AI Answer Engines"(Vishwakarma、Kumar、Jamidar、Sprinklr、SIGIR '26、メルボルン)。設計は、6つのLLM(Gemini-2.5-Flash、Claude-3.5-Sonnet、Kimi-K2-Thinking、GPT-5系3種)に候補ソースをちょうど2つ注入し、各ペアが18のコンテンツ要因のうちちょうど1つだけ異なるようにして、どちらが先に引用されるかを記録するものです。18の要因は、コンテンツの一致度、網羅性、信頼性、可読性、競合上の位置づけ、鮮度にまたがります。構造化データ形式は18のどれにも含まれていません。これは論文自身の分類表を直接確認して裏付けました。
スキーマについての本当の答えを知りたいなら、出典は別にあります。Ahrefsが2026年5月に実施した対照研究で、JSON-LDを追加した1,885ページを4,000の対照ページと比較しました。結果は、Google AI Overviewsで意味のある引用増加はなく(-4.6%、小さくはあるが統計的に有意な減少)、Google AI Mode(+2.4%、有意差なし)、ChatGPT(+2.2%、有意差なし)でした。別のsearchVIUの検証では、ChatGPT、Claude、Perplexity、Gemini、Google AI Modeは、ライブ検索時にJSON-LD、非表示のMicrodata、非表示のRDFaをそもそも読んでいないことが確認されています。
この監査に臨む前に、2つの事実を混同しないでください。SIGIRの研究はページ上で何を優先すべきかを教えてくれます。Ahrefsの研究は、スキーマが引用数の観点ではその優先事項の一つではないことを教えてくれます。ただし、リッチリザルトやエンティティの明確化といった別の場面では今も意味を持ちます。
ステップ1:ゲートキーパー監査を実行する
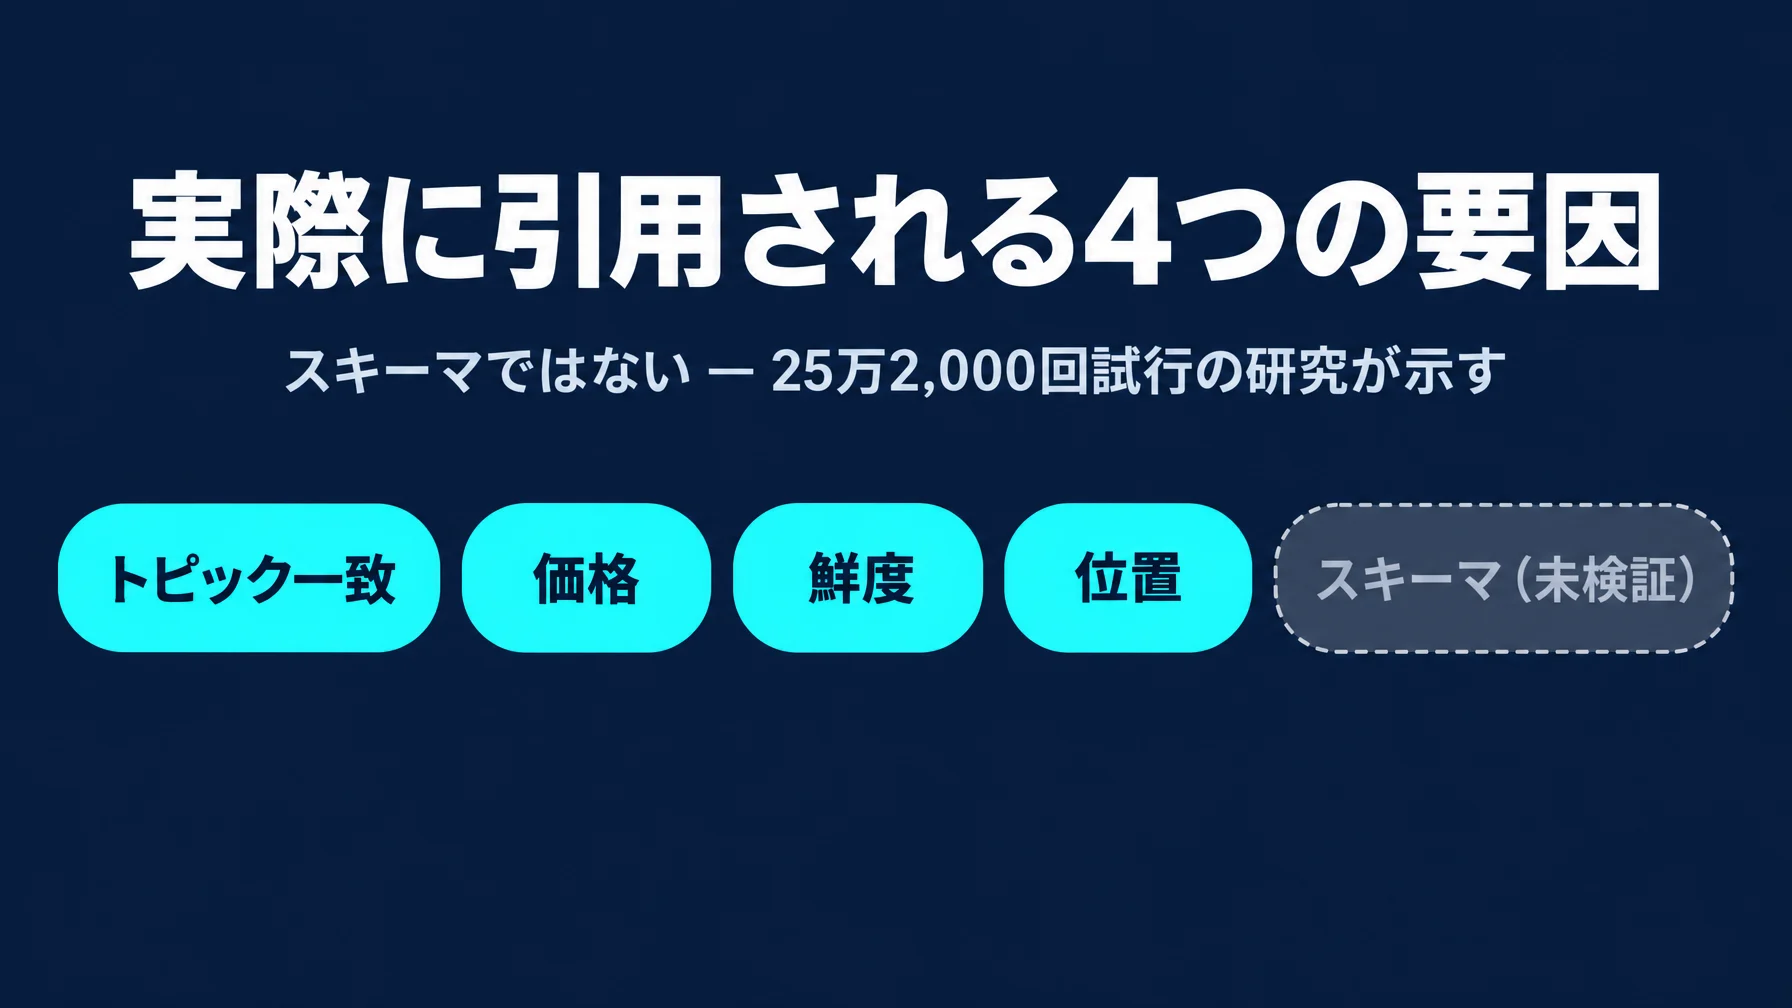
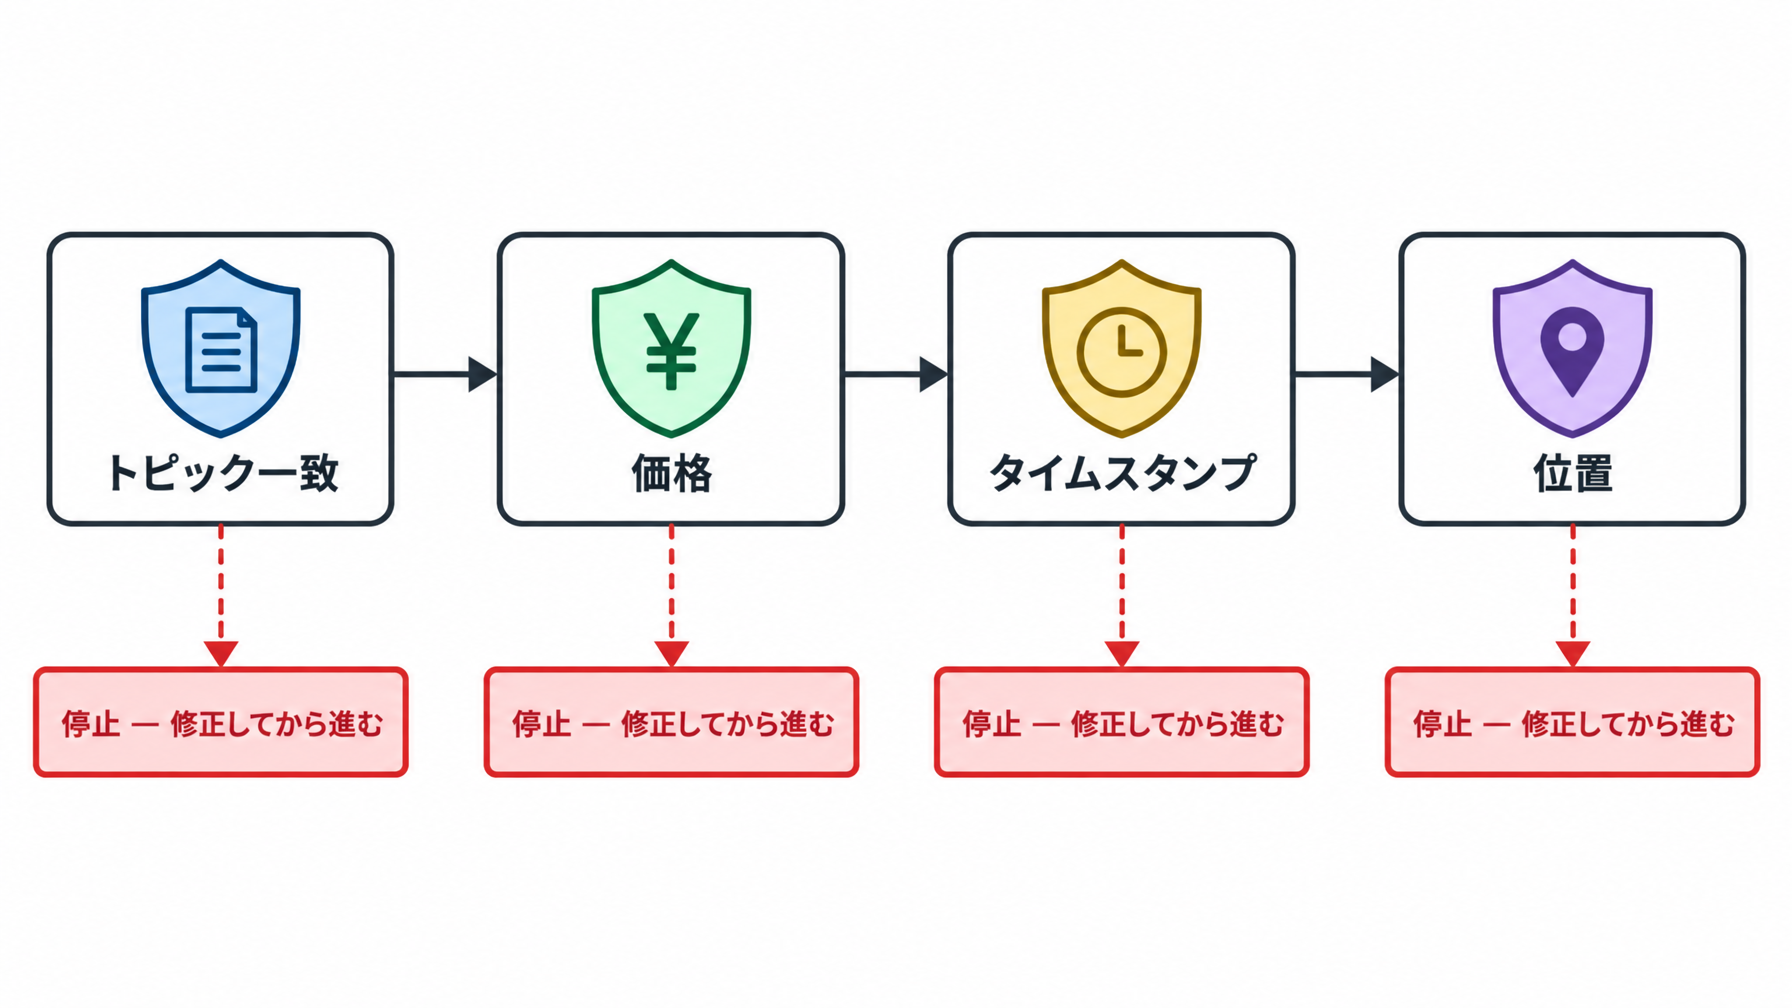
ページを次の4つの要因に照らして確認します。SIGIRの研究では、6モデルすべてでこの4つが全会一致で決定的とされ、効果は非常に大きなものでした(ほとんどのモデルでオッズ比100超)。どれか1つでも失敗すると、ページの他の部分がどれほど強くても引用の可能性は消えます。
ゲートキーパー | チェック内容 | オッズ比の範囲(検証した6モデル) |
|---|---|---|
トピックの一致 | そのページは、対象とするクエリに直接答えているか(近い別の話題ではなく)? | 6モデル中5モデルで事実上決定的 |
価格の明示 | 具体的な価格がページ上に見えているか(「お問い合わせ」の奥に隠れていないか)? | 6.26〜10,000超 |
最新のタイムスタンプ | 現在の公開日または最終確認日が表示され、正確か? | 14.4〜10,000超 |
リスト上の位置 | そのクエリの候補の中で、2番目ではなく1番目にランクされる傾向があるか? | 1,795〜10,000超 |
実行内容: 対象クエリと並べてページを開きます。最初の150語を読み、クエリに直接答えているかを自問します。ページ内で価格を検索し、フォームや電話が必要なら失敗です。表示されている日付が、実際に最後に更新した時と一致するか確認します。そのクエリでの現在の順位または引用シェアを確認します。
期待される成果物: 4行それぞれの合否。
品質チェック: トピックの一致で失敗したら、ここで止めます。後の手順はどれも、間違った問いに答えているページを救えません。
復旧手順: 価格とタイムスタンプの失敗は当日中に直せます(ステップ2)。リスト上の位置の失敗はコンテンツの修正では解決しません。このページが引用を争えるようになる前にSEOの基礎体力そのものを作り直す必要があるという意味で、ページ上の小手先の調整では代わりになりません。
ステップ2:ゲートキーパーの失敗を先に直す
他に手をつける前にこれをやります。このリストの中で最も効果が大きく、最も手間が少ない項目です。
価格が欠けている場合: 実際の数値を載せます。価格が変動するなら、「お問い合わせ」フォームの代わりに実際の最低価格または明確な価格帯を公開します。これは研究における4つのゲートキーパーの一つでした。
タイムスタンプが古い、または欠けている場合: 公開日または最終確認日を更新します。ただし、実際に内容を改訂した後に限ります。実質的な更新を伴わない日付の変更は、誰かが確認すれば裏付けの取れない鮮度シグナルになります。
トピックの一致が弱い場合: 冒頭の150語を、関連する話題ではなくクエリのタスクに直接答えるよう書き直します。古い構成に新しい導入文を継ぎ足すのではなく、置き換えます。
品質チェック: 自分がそのクエリになったつもりでページを読み直します。初対面の読者が最初の段落で具体的な答えを得られるでしょうか。
復旧手順: 本当の価格を公開できない場合(カスタム見積もり、エンタープライズ契約など)は、空欄のままにせず、代表的な最低価格や典型的な価格帯を公開します。研究が失敗状態として測定したのは「価格が記載されていない」ことであり、「価格が変動する」ことではありません。
ステップ3:二次的な差別化要因に取り組む
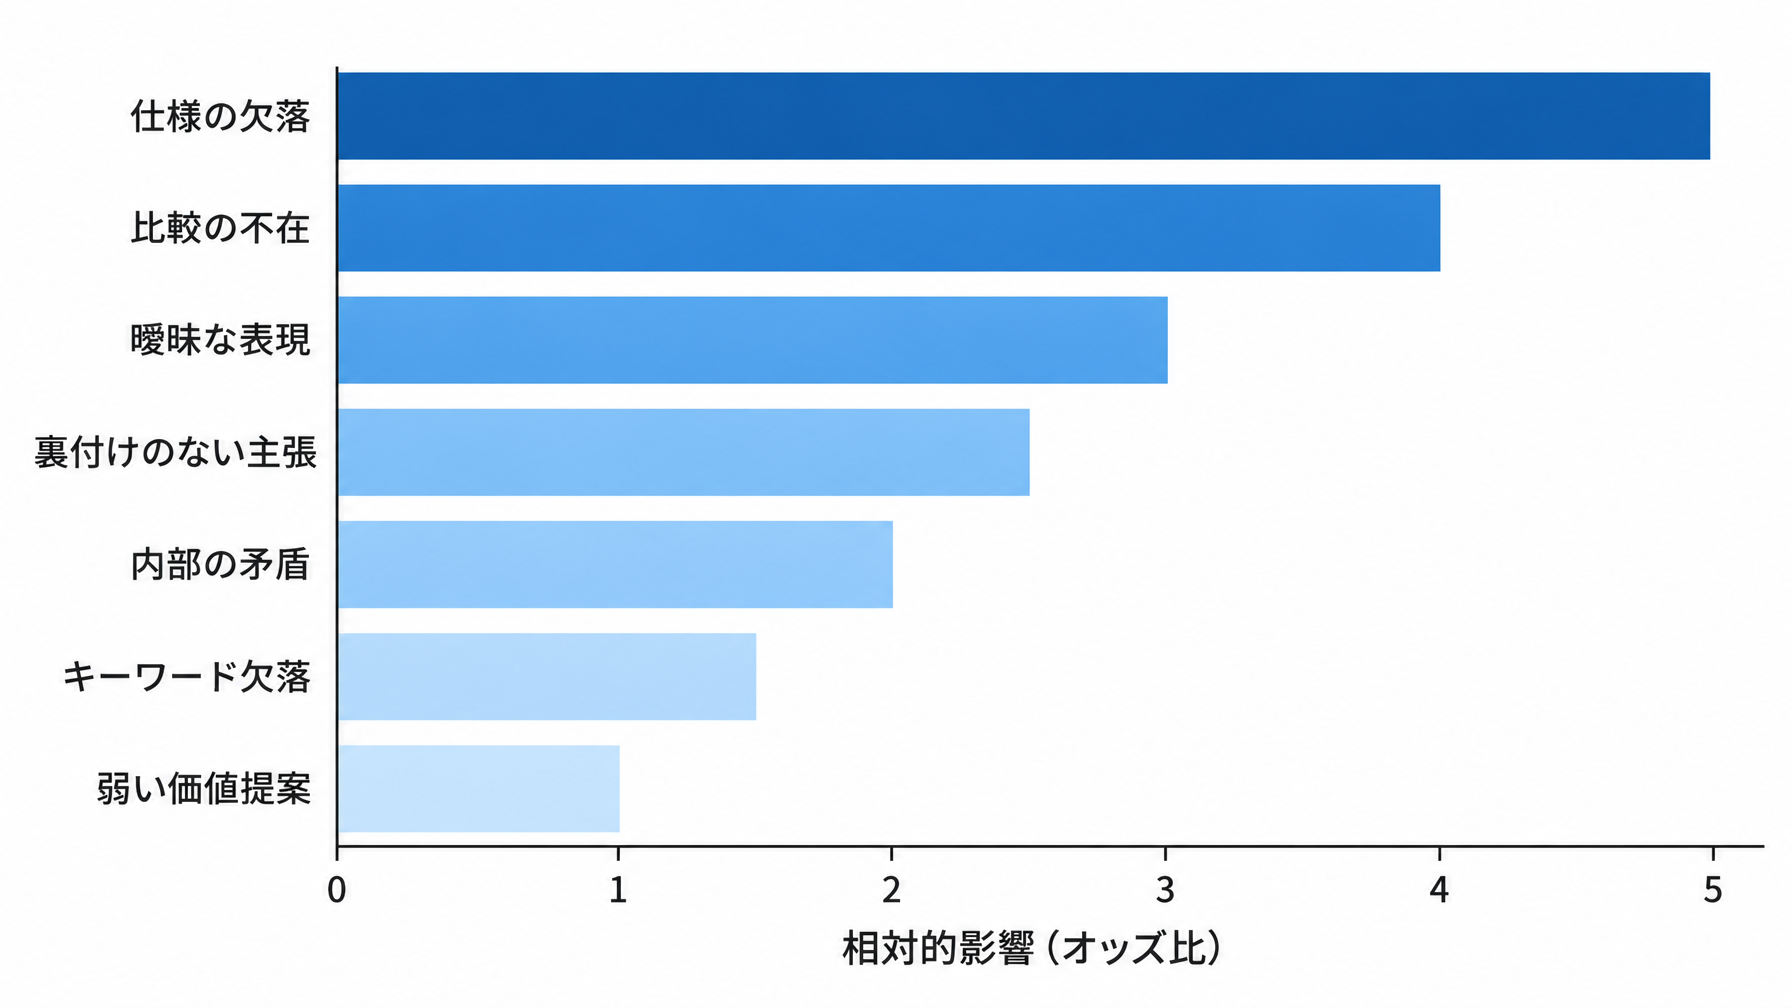
4つのゲートキーパーを通過したら、次の7つの要因が二次的な差別化をもたらします。オッズ比はモデルによって約2〜243の範囲です。この順番で修正します。
- 仕様の欠落。 購入者が実際に比較する技術仕様(寸法、素材、容量、互換性)を追加します。モデル別のオッズ比は8.63〜243で、二次要因の中でも最大級の効果です。
- 比較の欠如。 少なくとも1つの具体的な代替製品との直接比較を追加します。オッズ比1.61〜7.45。
- 曖昧な表現。 「かもしれない」「可能性がある」「おそらく」を、ページが実際に裏付けられる断定的な表現に置き換えます。
- 裏付けのない主張。 主張に証拠を添えます。試験結果、認証、手法の明示などです。
- 内部の矛盾。 同じページ内で数値と主張が矛盾していないか確認します。編集時に混入しやすく、レビュー時に見落としやすい項目です。
- キーワードの欠落。 対象クエリが使う具体的な語句が、同義語だけでなくページ内に実際に含まれているか確認します。
- 弱い価値提案。 競合ページが提示する内容に対して、自社の具体的な便益の主張を研ぎ澄まします。
実行内容: リストを上から順に確認し、当てはまるものを修正します。すべてのページが7つすべての問題を抱えているわけではありません。
期待される成果物: すべての主張が、具体的であるか、比較されているか、裏付けられているかのいずれかになっているページ。
品質チェック: 懐疑的な読者が、曖昧な文や裏付けのない文を1つでも見つけてしまうでしょうか。
復旧手順: 時間が足りない場合は、項目1と2(仕様と比較)で止めても構いません。7つの中で最も大きなオッズ比を持っています。
ステップ4:書式だけの変更は飛ばす
研究は、段落を箇条書きに組み替えること、読みやすさのために小見出しを追加すること、散在する情報を整理し直すことに、一貫した効果が認められなかったと明示しています。検証されたモデルは視覚的な構造に関係なくコンテンツを解析したためです。ページがここまでのチェックを通過しているなら、引用増加を期待して書式の磨き込みにスプリントを費やさないでください。データが支持しない引用効果のためではなく、人間の読者のために整えてください。
ステップ5:スキーマは本来の役割に置いておく
スキーママークアップは技術的に有効な状態に保ちましょう。実際に役割を果たしているからです。GoogleとBingがリッチリザルトを解析するのを助け、検索システムに対してページとエンティティが何であるかを曖昧さなく伝えます。一方で、利用可能な最良の対照研究によれば、AI引用のオッズを動かすことはしません。スキーマが引用のレバーになるという理屈で、ステップ1〜3より先にスキーマ作業を持ち込まないでください。それを支持する対照研究は存在せず、根拠として引用される唯一の研究はスキーマをまったく検証していません。Ahrefsのスキーマ研究が実際に何を測定したかの詳細な内訳は、2026年のセマンティックSEOガイドをご覧ください。
仕上がりを検証する
修正後に、そのページでステップ1の監査を再実行します。4つのゲートキーパーはすべて通過するはずです。ステップ3で修正した二次要因のうち2〜3つを抜き取り確認します。AI Search Visibility CheckerのようなAI可視性・引用追跡ツールを使える場合は、次のページへ移る前に、対象クエリに対するそのページの現在の引用率をベースラインとして記録しておきます。そうすれば、後で変更が何かを動かしたかを判断できます。
結果を維持する
タイムスタンプのゲートキーパーは、固定のカレンダーではなく、ページに実質的な更新をかけるたびに再確認します。引用シェアを失ったページは、二次要因が崩れたと決めつける前に、4つのゲートキーパーから再監査します。
よくある質問
SIGIRの研究はスキーママークアップやJSON-LDを検証しましたか?いいえ。その18要因の分類は、コンテンツの一致度、網羅性、信頼性、可読性、競合上の位置づけ、鮮度、リスト上の位置を対象としています。構造化データ形式は、検証されたカテゴリにも要因にも含まれていません。論文の分類表を直接確認して裏付けました。
スキーママークアップはAI引用に少しも役立たないのですか?利用可能な最良の対照研究、つまりAhrefsが2026年5月に1,885ページを4,000の対照と比較した研究では、JSON-LDの追加による意味のある引用増加は、Google AI Overviews、Google AI Mode、ChatGPTのいずれでも確認されませんでした。別の検証では、主要なAIモデルのいくつかがライブ検索時に構造化データを読んでいないことが分かっています。とはいえ、それはスキーマが他の場面で無価値だという意味ではありません。引用数に効くレバーではない、というだけです。
話題になった投稿の具体的な数値(6.3、14、4〜8.6)はどこから来たのですか? SIGIR論文の結果表にある実際のオッズ比に似ていますが、それらはスキーマではなく、価格、鮮度、仕様・比較の要因に属する数値です。論文は数値を1つの平均にまとめずモデルごとに報告しており、検証された6つのLLM間で範囲は大きく異なります。
1時間しかない場合、何から直すべきですか? 4つのゲートキーパーです。トピックの一致、価格、タイムスタンプ、リスト上の位置。どれか1つでも失敗すれば、ページ上の他のすべてに関係なく引用の可能性は消えます。
スキーマの作業は完全にやめるべきですか?いいえ。リッチリザルトとエンティティの明確化のために有効な状態は保ってください。ただし、AI引用数が本当の目的であるなら、ゲートキーパーの修正より新規のスキーマ作業を優先しないことです。
著者:Bennett Hayes(AuspiaのApplied GEO Analyst、400件以上の実装レビューを担当)。実践的なGEOの実行、監査、そして対照研究が実際に何を測定したかに基づく実装ノートについて執筆しています。