從 AI 讓使用者失敗的地方開始
Agent Readiness 不是加上 llms.txt、schema 或 WebMCP 後就得到的單一分數。更實用的問題是:當搜尋引擎、答案引擎或已授權的 agent 接觸你的網站時,它能否找到正確頁面、理解事實、不歪曲品牌,並安全完成使用者要求的任務?
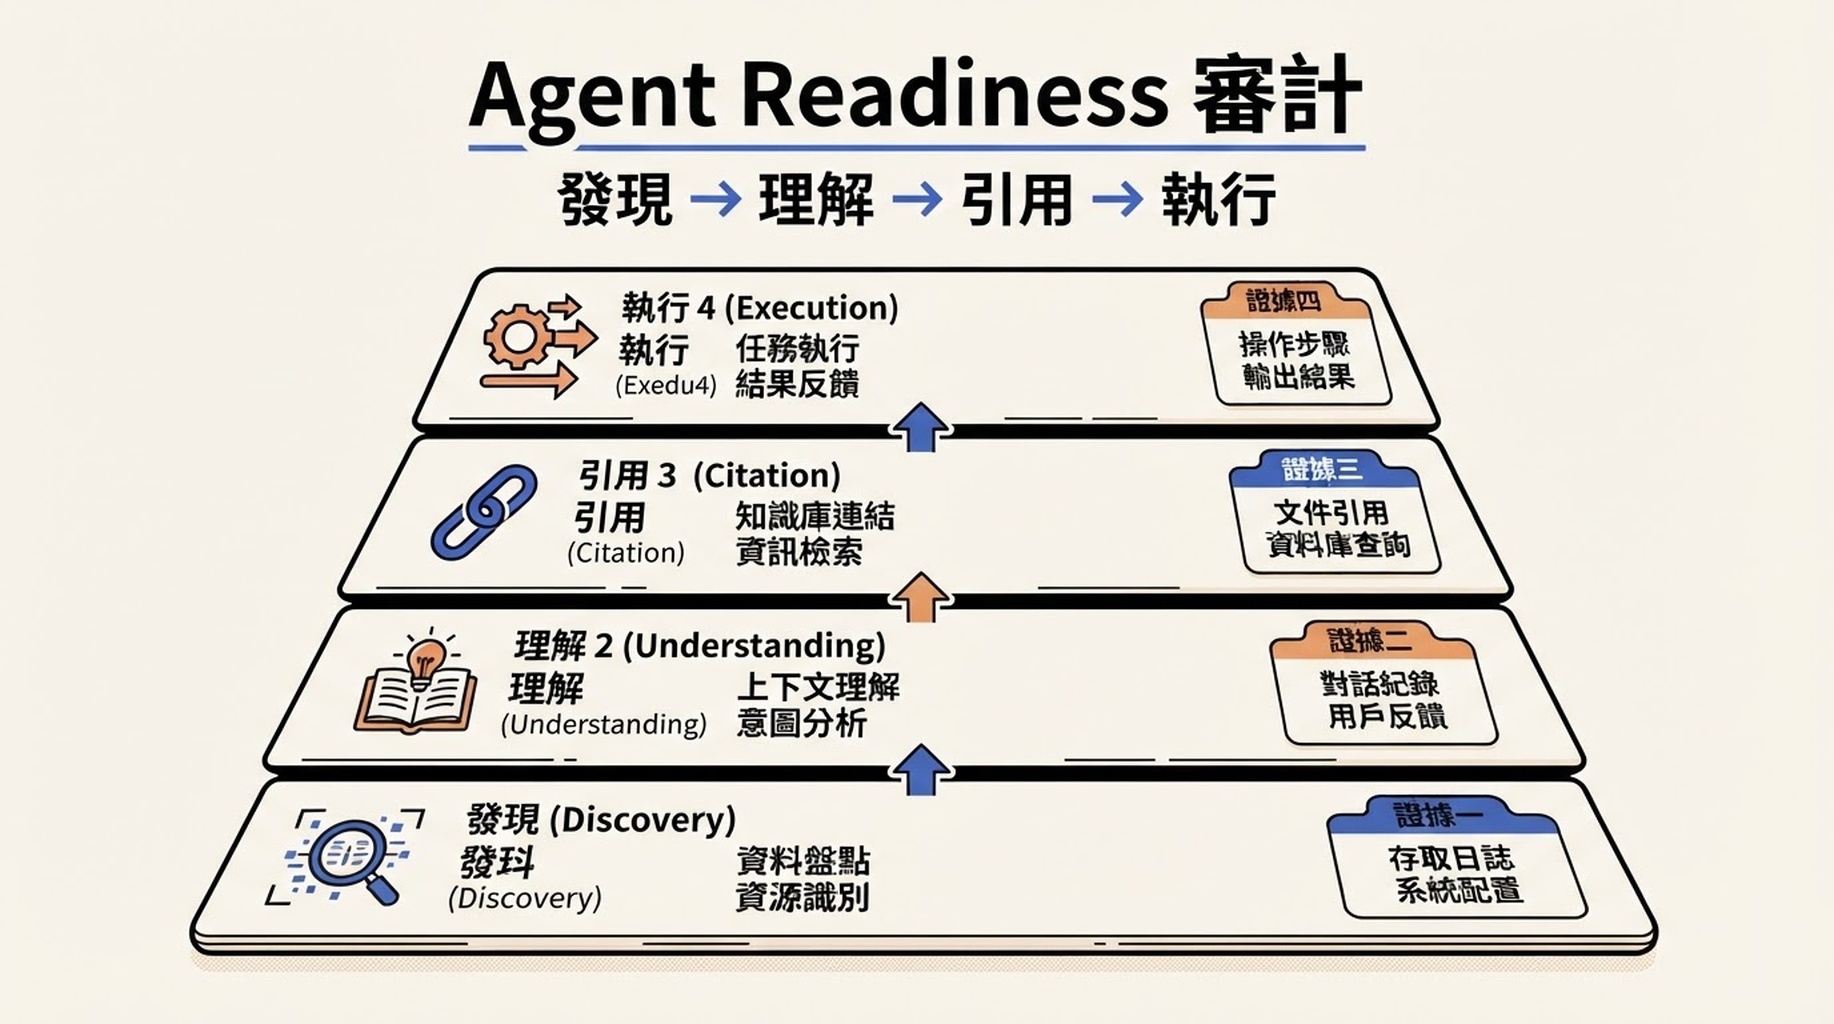
這套審計有四層:可發現、可理解、可引用、可執行。應由下往上修。較低層的失敗,會讓較高層的最佳化變得脆弱。
這是審計與優先排序框架,不是要把所有網站都改成自動化 agent。對多數企業來說,前三層已能解決較大的 SEO 與 GEO 問題。第四層只適用於確實有 agent 任務價值、權限邊界與有意義確認體驗的情況。
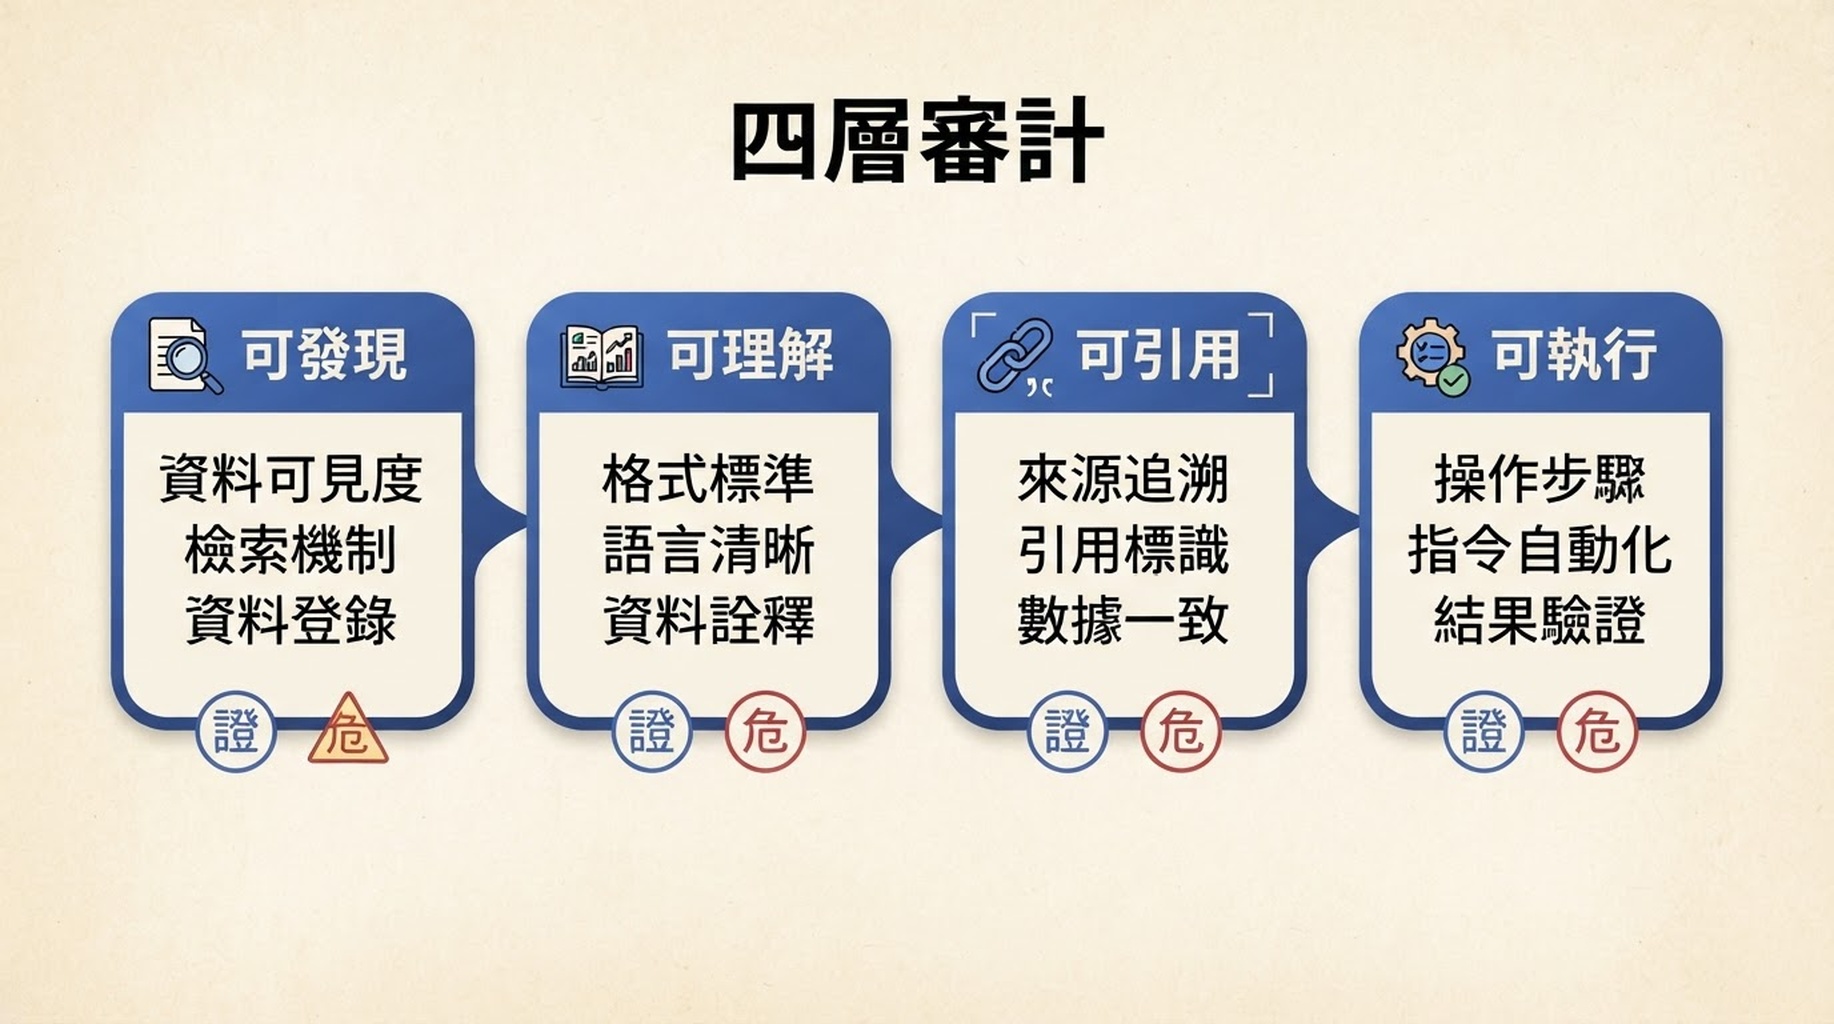
由下往上修。可發現是基礎,可理解建立事實,可引用取得答案適格性,可執行則放在最後。
第一層:可發現
這仍是 SEO 的地基。合適的 crawler 必須能到達、渲染、取得並索引頁面。重要頁面需要穩定 URL、內部連結與正確 canonicalization。穩定狀態、可用 HTML、清楚導覽與可預期錯誤也能幫助 agent。
檢查項目:
- 重要的產品、服務、文件、政策與說明頁有穩定且可索引的 URL。
- robots 規則、認證牆、JavaScript 渲染或 canonical 沒有意外阻擋內容。
- 關鍵事實不只存在於圖片、影片或登入後介面。
- 內部連結將核心任務頁與支持證據頁連接起來。
- 載入失敗、空狀態、語言或地區變更時,有可解釋的替代路徑。
不要只檢查部落格是否被索引。價格、限制、退貨、整合、供應情況與支援政策頁,往往才是 AI 回答或 agent 決策必須核對的資訊。
第二層:可理解
這一層要求系統能辨識你是誰、提供什麼、適合誰,以及適用條件是什麼。它比關鍵字覆蓋更接近實體與產品事實管理。
每個高意圖頁面都應有可獨立成立的答案:定義產品或服務、指出對象、說明有意義的限制,並連到證據。不要讓人或模型從三段行銷文字猜測價格條件、地區或相容性。
頁面類型 | 必須立即清楚的事實 | 常見缺口 |
|---|---|---|
產品頁 | 類別、使用對象、能力、限制、價格或價格條件 | 只有沒有邊界的口號 |
服務頁 | 範圍、地點、交付物、資格、預約方式 | 地點與適合度藏在 FAQ |
比較頁 | 標準、版本日期、共同點、實際差異 | 沒有證據地攻擊競品 |
說明頁 | 問題、前置條件、步驟、失敗方式 | 步驟無法獨立完成 |
政策頁 | 生效日、地區、例外、聯絡管道 | 舊新政策彼此矛盾 |
第三層:可引用
GEO 不只是讓品牌名稱被提到。更好的目標是:系統在回答特定問題時,能重用內容中清楚、有來源、有邊界的一段,且不會說錯品牌或規則。
引用準備度不會因為堆疊 FAQ 而出現。它來自直接回答、可驗證事實、清楚命名的實體、支持主張的證據、可區分的章節,以及必要的日期、地區與限制。
不要只問泛泛的推薦。選擇 20 個真實買家、支援或比較問題做測試。對每個回答記錄:是否提到品牌、是否引用正確 URL、主要事實是否正確、重要限制是否被保留。每兩到四週重測,並把錯誤模式映回頁面。
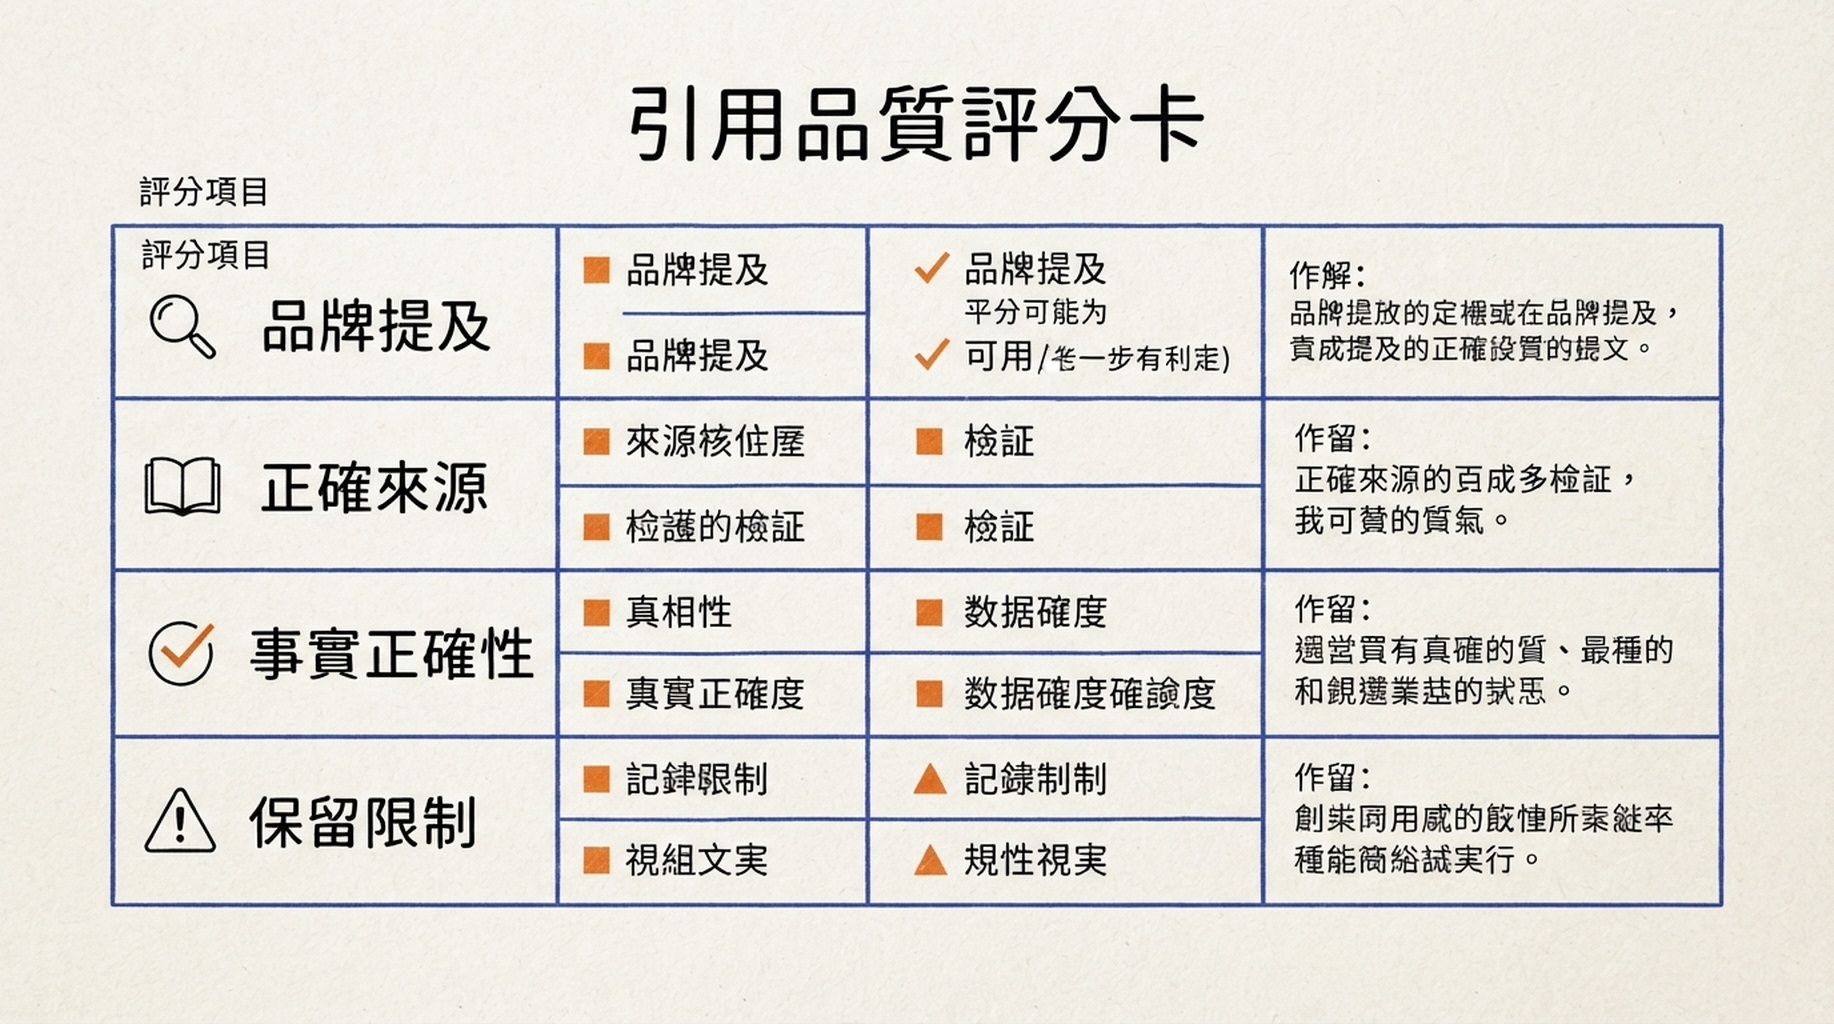
引用不是二元結果。品牌提及、正確來源、事實正確性與限制保留應分別記錄。
第四層:可執行
只有這一層是 Agent Readiness 的任務面。網站必須把真實任務拆清楚:需要哪些輸入、權限從哪裡來、結果如何預覽、哪裡必須確認、使用者如何從失敗中恢復。給人用的介面仍必須能正常運作。agent 是新增的協作者,不是可繞過一般安全模型的超級使用者。
WebMCP 是一種可能的實作方式。它可以把瀏覽器中的 JavaScript 函式或 HTML 表單公開為結構化工具,減少 agent 對 DOM 的猜測。但不要因為有協定就把它放入路線圖。應先證明任務值得自動化,並完成威脅建模。
若要釐清內容、SEO、GEO 與工具的邊界,請閱讀WebMCP、SEO 與 GEO:AI Agent 網站最佳化到底在最佳化什麼?。如果準備做原型,請採用WebMCP 安全檢查清單中的可信任 origin、不可信內容、讀寫與確認控制。
優先矩陣:不要把低層失敗包裝成高層創新
發現問題 | 所在層級 | 風險 | 下一步 |
|---|---|---|---|
產品頁在 crawler 看來是空 shell | 可發現 | 高 | GEO 前先修渲染與可存取內容 |
品牌頁沒有對象、價格條件與限制 | 可理解 | 高 | 建立事實頁面模組並檢討產品、服務模板 |
AI 回答提及品牌但漏掉地區限制 | 可引用 | 中高 | 在前段加入可驗證範圍說明,重測 prompt |
agent 在搜尋任務中選錯篩選條件 | 可執行 | 中 | 結構化工具前先改善表單狀態、標籤與錯誤 |
agent 能讀評論並建立退款 | 可執行 | 嚴重 | 停止自動化,為權限、UGC 與確認做威脅建模 |
這也說明「WebMCP 是否影響 SEO」問錯了重點。第一層的抓取問題不會被 WebMCP 修好。第三層缺少事實,並不會因為有工具就變得可引用。它最多改善第四層中已驗證的一項任務。
從證據開始的 30 天計畫
第 1 週:選擇範圍並建立基準
選一條產品線或一項高價值服務,而不是一次審整個網站。列出 10 個關鍵 URL、20 個真實問題與 3 項高頻任務。記錄索引與渲染、事實缺口、AI 回答錯誤類型,以及每項任務的人工路徑。
第 2 週:修復可發現與可理解
修正被阻擋的抓取、錯誤 canonical、空 shell 渲染、過時政策與斷裂內鏈。為最重要頁面加入清楚定義、目標對象、限制、證據與下一步。在事實經過審查前,不要用 AI 大量重寫頁面。
第 3 週:建立引用測試
在相關回答介面測試同一組問題。記錄來源 URL、回答正確性、保留限制、競品出現情況與可能的下一步。根據錯誤模式更新頁面,不要只看品牌提及次數。
第 4 週:選一個安全的任務原型
只有前三層沒有明確阻礙時,才選擇一個公開、唯讀、低影響任務。定義輸入與輸出,保留人工確認與失敗備援。在把 UGC 或第三方資料回傳給 agent 前先審查。Google Chrome 的 WebMCP 工具安全指引很清楚:untrustedContentHint、readOnlyHint 與精確的 origin 公開,是工具作者的責任。
用分數排工作,不要用分數取代判斷
可使用 Auspia Agent Readiness Score進行第一次盤點,但總分只適合排序工作。一個內容結構很好的網站,如果把訂單查詢公開給不可信任 origin,仍然不安全。反過來,沒有 agent 工具的網站,若前三層很強,也可能已有扎實的 SEO 與 GEO 基礎。
每層保留三種證據:頁面樣本、真實測試結果、明確負責人。當 AI 平台或 Web 標準改變時,團隊可以更新證據與流程,而不是追逐新標籤。
FAQ
做 GEO 需要完成四層嗎?
不需要。GEO 核心是可理解與可引用,並以可發現為基礎。可執行層只在 agent 必須完成實際站內任務時適用。
llms.txt 屬於哪一層?
它最多是補充的發現或引導訊號,不能取代可存取頁面、清楚事實、證據或測試。應確認平台支援並以實測使用。
如何選 20 個 AI 測試問題?
從有搜尋需求、銷售通話或支援紀錄支持的問題開始:產品適配、比較、價格條件、地區可用性、設定、限制與疑難排解。每個問題都應對應到有負責人的頁面。
WebMCP 是可執行層唯一的選擇嗎?
不是。更好的表單、穩定 API、可存取 HTML 與清楚確認,往往能先改善許多任務。WebMCP 是瀏覽器 agent 的結構化介面候選方案,仍處於早期階段。
資料來源
作者:Ethan Marlowe,Auspia 負責 500 多個 prompt 的 GEO 衡量。Ethan 專注於 prompt 追蹤、引用報告、可見性儀表板與 AI 回答品質檢查。