Google 排名监控器大多用同一套方式配置:定一个阈值,排名变动超过阈值就告警,如此而已。多数工具的默认阈值在 3 位左右,因为 3 这个数字听起来像是有意义的变动。
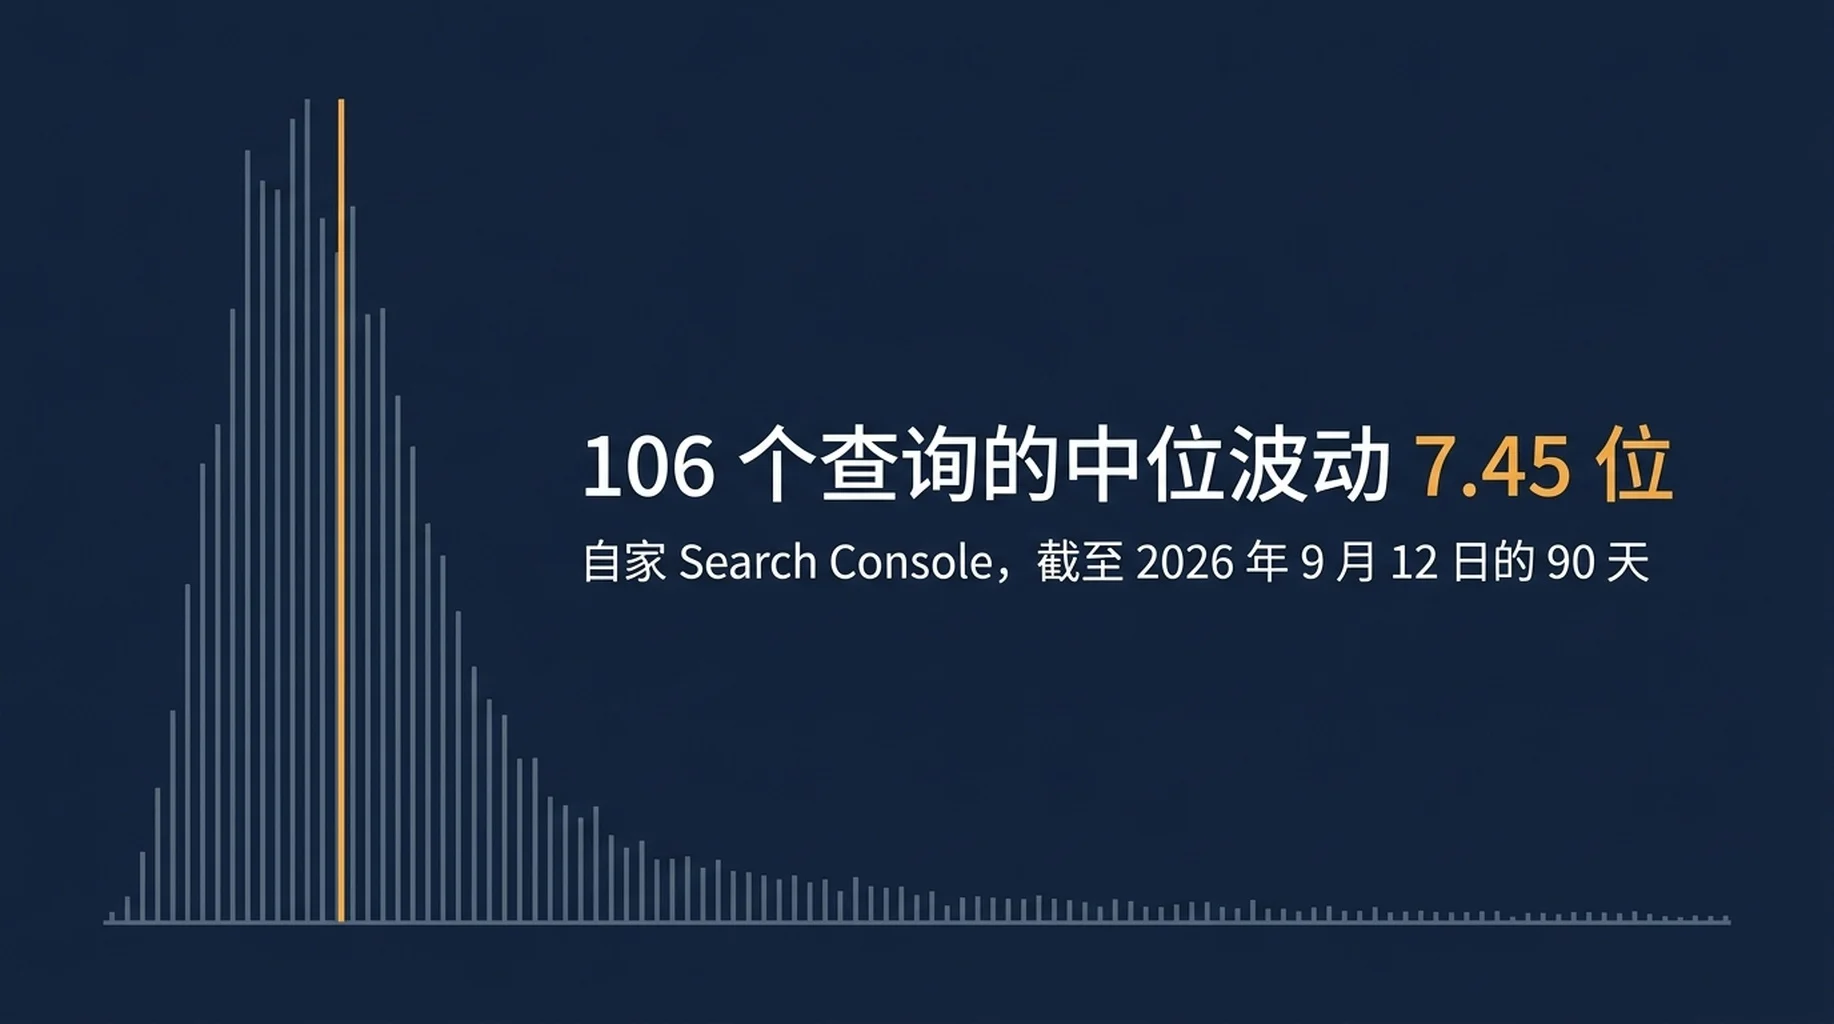
在我们自己的数据里不是这样。看 90 天内曝光 30 次以上的 106 个查询,逐查询排名标准差的中位数是 7.45。对一个典型查询来说,3 位的变动不是信号,而是这个数字的日常表现。
监控器没有坏,它只是没有被校准过。下面就是不用默认值、而是用自己的历史校准之后的样子。
监控器假设了什么,哪些假设会失效
每条告警规则背后都有四个假设,成立的只有一个。
排名足够稳定,阈值才有意义。 失效。波动幅度按查询相差一个数量级,我们在下面做了实测。
同样大小的变动在任何排名位置含义相同。 失效。第 3 位和第 6 位之间的距离,与第 41 位和第 44 位之间的距离,在点击和含义上都不等价。
所有查询都配得上同一个阈值。 失效。品牌词和竞争激烈的头部词在统计上没有共同点。
查得越勤信息越好。 超过某个点就失效。每天检查得到的读数是一周一次的 7 倍,在多数查询集上,同一条信号周围的噪声也是 7 倍。
本文剩下的部分,就是把这四个假设逐条换成实测。
我们自己的查询实际怎么动
方法:我们自己的 Search Console 资源,截至 2026 年 9 月 12 日的 90 天,维度为 query 和 date,共 8,020 行,筛选出期间曝光 30 次以上的 106 个查询。对每个查询计算日均排名的标准差,以及它停留在自身中位数 3 位以内的天数占比。
指标 | 数值 |
|---|---|
样本查询数 | 106 |
日均排名标准差的中位数 | 7.45 位 |
标准差低于 2 位的查询 | 106 个中的 12 个(11%) |
标准差在 10 以上的查询 | 106 个中的 40 个(38%) |
停留在自身中位数 3 位以内的天数占比中位数 | 59% |
从同一个样本里挑四个查询,同一个站点上它们的表现差异就是这样。
查询 | 中位排名 | 标准差 | 处于中位数 3 位以内的天数 |
|---|---|---|---|
amazon echo keywords | 14.1 | 1.29 | 100% |
on page seo audit | 92.2 | 4.99 | 63% |
perplexity seo checker | 31.9 | 12.87 | 22% |
geo | 70.4 | 9.83 | 30% |
务实的解读:稳定到足以让固定 3 位规则有意义的查询,大约十来个里才有一个。十个里有四个,变动大到只要阈值低于 10 位,就会一直响。
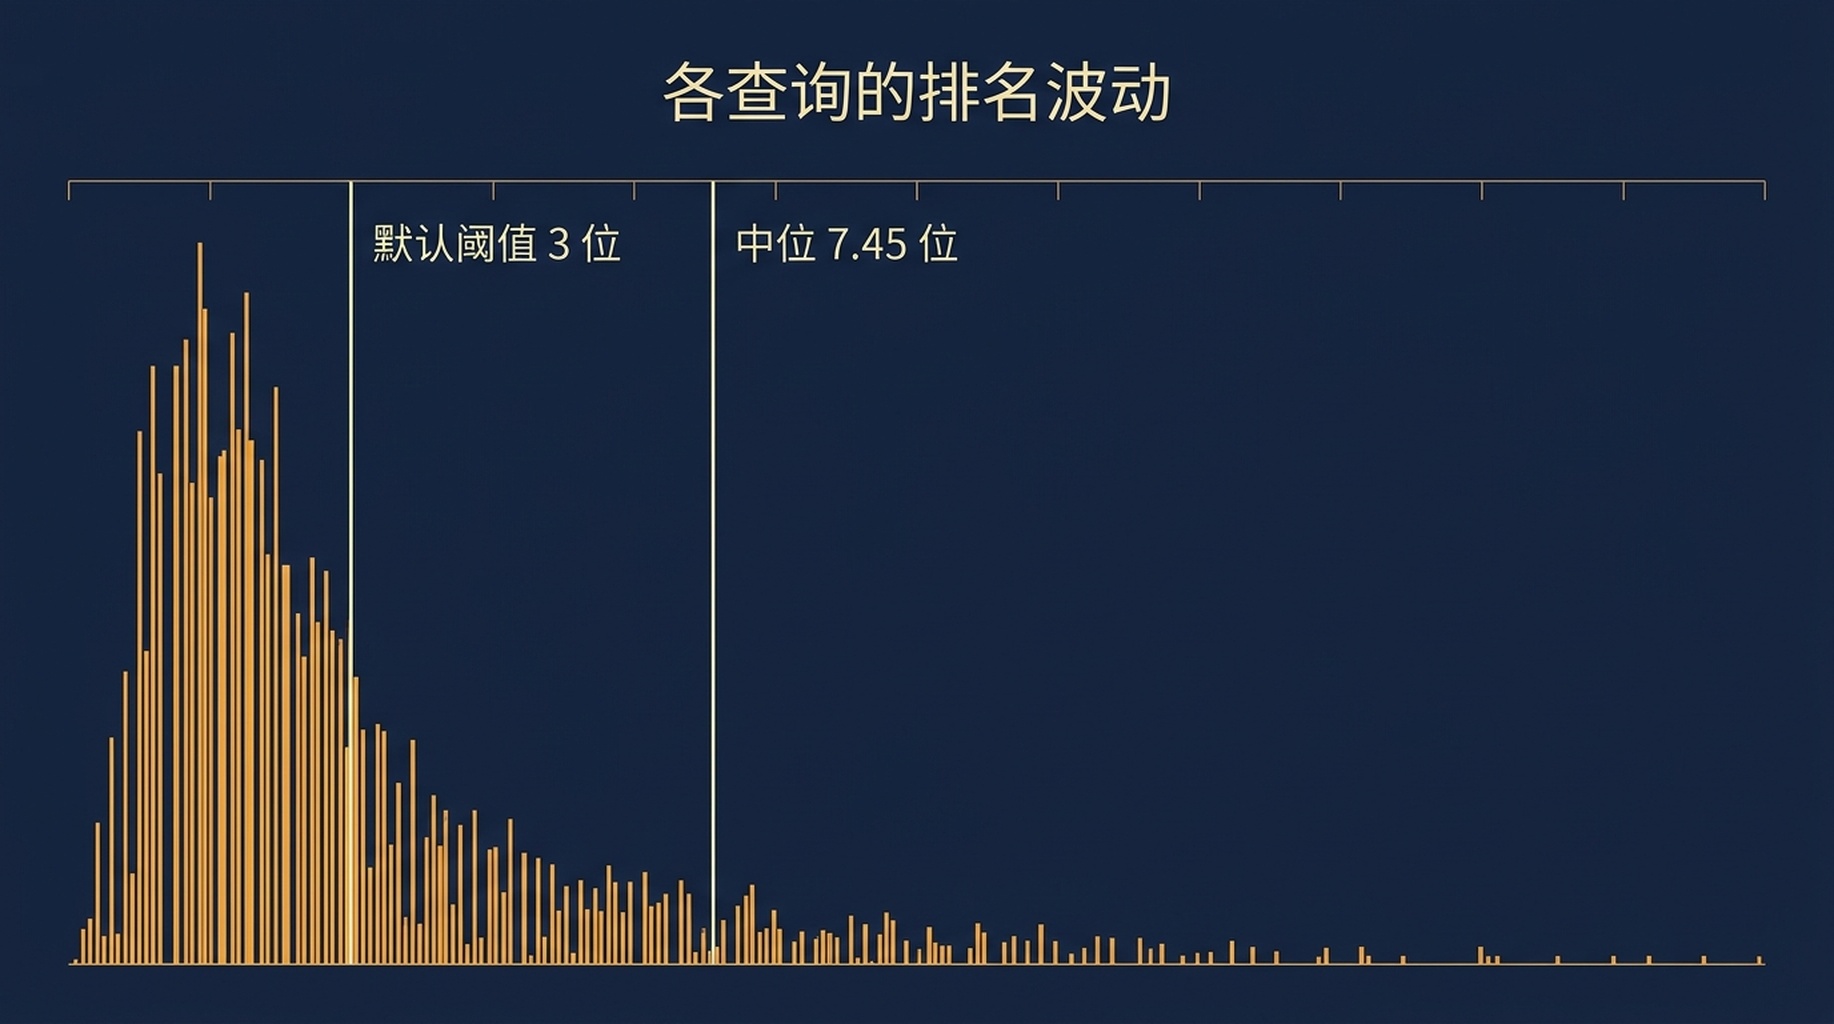
多数查询的变动幅度,远大于默认告警阈值所假设的水平。
校准规则 1:按查询设区间,而不是按站点
全站阈值是互不相同的行为的平均值。解法是让每个查询的区间由它自己的历史算出,一次 Search Console 导出加几行算术就够了。
对每个查询,用的是它自身的分布,而不是一个全局数字。
- Normal: 在自身中位数一个标准差以内。
- Watch: 在一个到两个标准差之间,或该查询跌出自身中间 80% 区间。
- Investigate: 超过两个标准差,且在连续第二次运行时被确认。
在上面的样本里,这会让告警量发生剧变。标准差 1.29 的查询,要动约 3 位才够到 watch 区间。标准差 12.87 的查询要约 13 位,于是除非真出了事,几乎不会告警。
这跟告警区间设计指南用于定时监控的逻辑相同,只是从账户级下沉到了查询级。如果你读完本文只改一处,就把阈值从常数改成逐查询取值。
校准规则 2:设一个最低曝光下限
排名是平均值,3 次曝光的平均值不算测量。期间曝光低于约 30 次,底下的样本太小,数字自己就会动。
由此有两条推论,实现都很简单。
不给低曝光查询告警。 继续监控,但把排名当上下文而不是信号。例外是突然起量的查询,那是曝光事件,本身值得知道。
给每个排名配上曝光。 曝光稳定时的 5 位下跌,和曝光掉了 60% 时的 5 位下跌,含义不同。后者更接近索引或资格问题,前者更接近竞争。只报排名的监控器丢掉了这个区别,而这正是这套排查顺序要捕捉的失效模式。
校准规则 3:告警前先拆开设备和地区
合成排名是各设备、各地区结果的加权平均。构成比一变,页面上什么都没发生,平均值也会动。我们实测同一查询的移动端与桌面端差异最高达 11 位,所以这不是舍入误差,它和你试图检测的噪声同量级。
实现朴素且便宜:按设备分别取排名,两个都存,在出现变动的那台设备上告警。如果只追一个合成数字,就把设备构成比写进输出,让构成变化是看得见而不是猜出来的。查询形态在设备拆分步骤里讲。
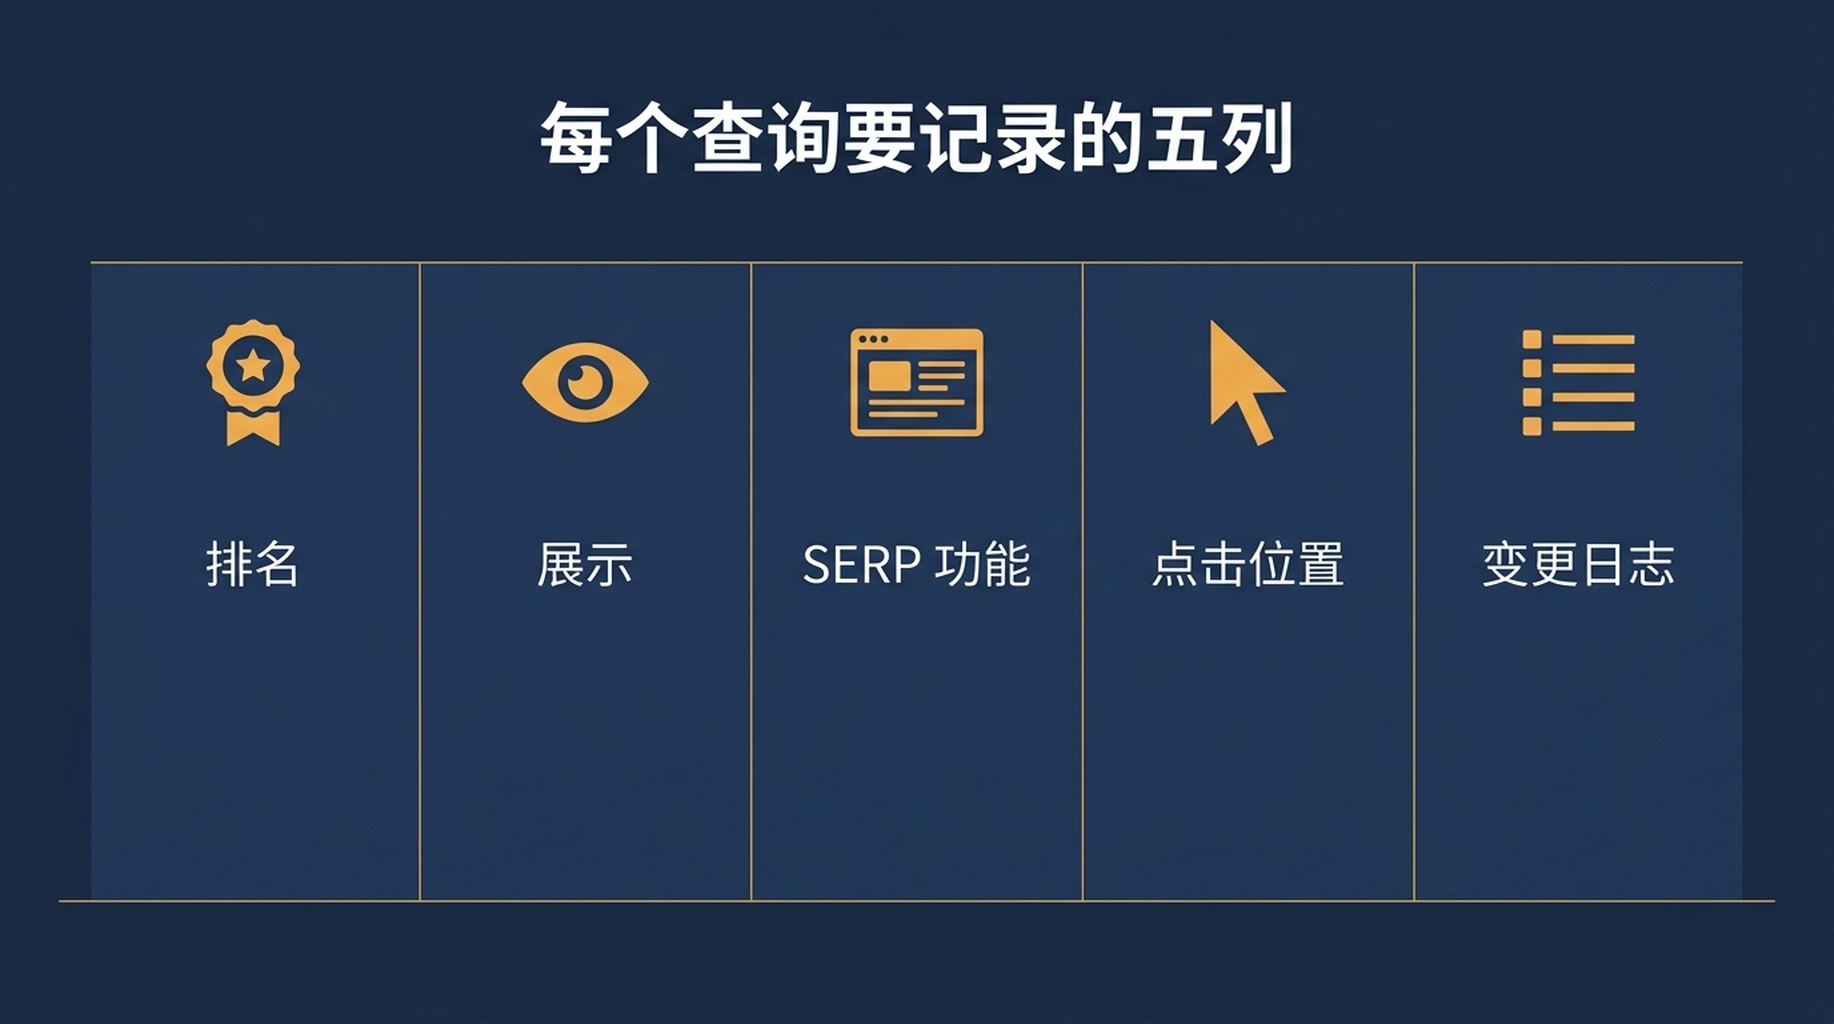
五个字段把一条告警变成一次有起点的调查。
除了排名还该监控什么
排名只是其中一列。变动是否值得人看,由另外四个决定。
曝光。 需求侧。它一动,所有排名数字的含义都变了。
SERP 功能状态。 该查询有没有 AI Overview、视频块、本地包。功能变化会在页面毫无改动的情况下推动排名。
点击曲线上的位置。 不只是你在列表里的位置,还有你相对于功能的位置。AI Overview 下方的第 1 位不是第 1 位。要正确追踪功能状态,该存哪些字段见AI Overview 追踪器搭建。
变更日志条目。 自己的发布、模板改动、内容编辑,放在同一条时间线上。我们排查过的真实下跌,多数背后都有一次提交。
把这五项按查询、按天存下来,告警就不再是一个看着吓人的数字和一个得靠回忆重建那一周的人,而是一次有起点的调查。
动手前先算频率
监控成本按 关键词数 × 检查次数 增长,所以频率应由查询数量决定,而不是热情。
- 每天检查 30 个重点查询,每月 900 次请求。几乎任何方案都付得起,多数团队应该从这里开始。
- 每天检查 200 个查询,每月 6,000 次请求,在波动大的集合上,大部分告警是它自己造出来的噪声。
- 同样 200 个查询按周检查,每月约 1,400 次请求,而真实变动持续超过一周,所以实质性的变化大多还能抓到。
两者都要,就按下注大小而不是偏好来分:直接挂在收入上的短名单每天查,其余的每周查。如果自己搭采集,双数据源追踪器讲了请求形态和比较规则。
信任任何监控器之前的检查清单
五个问题。任何一条过不了的监控器,消耗的注意力都比它省下的多。
- 它存的是原始结果,还是只存算出来的排名? 如果事后没法问页面上还出现过什么,你就解释不了告警。
- 地区和设备是按查询固定并记录的吗? 否则历史会混着不同条件。
- 阈值是逐查询的,还是账户一个数? 一个数就是默认值,不是校准。
- 它区分故障和下跌吗? Google 公开了带故障历史的状态面板,先看一眼比任何排查都便宜。
- 它告诉你什么变了,还是只告诉你出了变化? 后者的告警是待办清单,前者才是判断。
Auspia 观点:排名监控器的价值,等于它的校准水平。默认 3 位阈值之所以错,不是因为工具偷懒,而是因为那是套在单个查询上的总体平均。量一量自己的查询,按各自的分布设区间,剩下的告警就是你真的会去处理的那些。
常见问题
Google 排名监控器应该忽略多大的正常排名波动? 没有通用数字,这正是重点。在我们的样本里,中位查询 90 天内动了 7.45 位,而十个里有一个始终在 2 位以内。正确的阈值来自每个查询自身的历史,通常是一个标准差。
排名监控器应该多久查一次排名? 常规集合按周,直接挂在收入上的短名单按天。对大集合每天检查成本翻倍,而抓到的多是噪声,因为真实排名变动持续超过一天。
为什么监控器显示的日间波动,Search Console 里没有? 因为它们是两种测量。监控器是对某个时点、某个地区的真实搜索结果页做一次快照。Search Console 是在日期范围和设备构成上对曝光取平均。两者都没错,直接对比会让你去追一个只存在于其中一边的下跌。
该监控所有有排名的关键词吗? 不该。监控曝光足以支撑测量的查询。在我们的数据里,几千个里只有 106 个。低于曝光下限的那些,与其逐个告警,不如成组跟踪,比如数一数究竟有多少查询有排名。
校准监控器需要付费工具吗? 不需要。一次带 query 和 date 维度的 Search Console 导出,就能算出逐查询的中位数和标准差,校准要的只有这些。付费工具加的是便利和跨厂商数据,不是统计。
作者:Miles Carter,在 Auspia 负责 8,000 个查询的排名数据分析。写作方向:排名测量、告警校准,以及如何区分数据的变化和搜索结果的变化。