מנטרי דירוג של Google נבנים בדרך כלל באותה צורה: קובעים סף, מתריעים כשהדירוג זז יותר ממנו, וזהו. ברירת המחדל ברוב הכלים היא בסביבות 3 מקומות, כי המספר 3 נשמע כמו שינוי משמעותי.
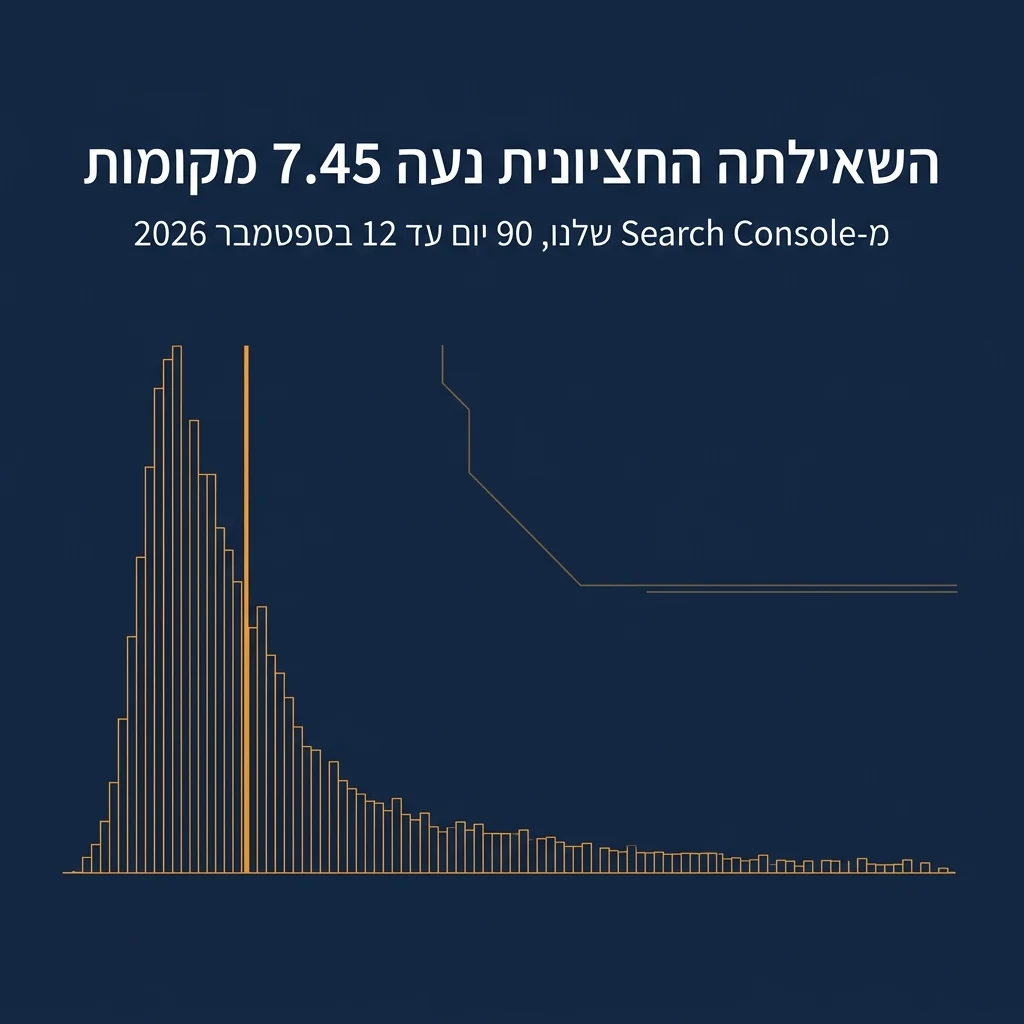
בנתונים שלנו זה לא המצב. מבין 106 שאילתות עם 30 חשיפות או יותר ב-90 יום, החציון של סטיית התקן בדירוג היומי לכל שאילתה היה 7.45. עבור שאילתה טיפוסית, תזוזה של 3 מקומות אינה אות — היא ההתנהגות היומיומית של המספר הזה.
המנטר לא שבור, הוא פשוט לא מכויל. כך הוא נראה כשמכיילים אותו מההיסטוריה שלכם ולא מברירות המחדל.
מה המנטר מניח, ואילו הנחות קורסות
מאחורי כל כלל התראה עומדות ארבע הנחות, ורק אחת מהן מחזיקה.
הדירוג יציב מספיק שסף יעבוד. קורסת. הפיזור שונה בין שאילתות בסדר גודל, ומדדנו אותו למטה.
תנועה באותו גודל משמעותה זהה בכל מקום בדירוג. קורסת. המרחק בין מקום 3 ל-6 אינו שקול למרחק בין 41 ל-44, לא בקליקים ולא במשמעות.
כל השאילתות ראויות לאותו סף. קורסת. לשאילתות מיתוג ולמונחי ראש תחרותיים אין דבר משותף סטטיסטית.
בדיקה תכופה יותר מניבה מידע טוב יותר. קורסת מעבר לנקודה מסוימת. בדיקה יומית מניבה פי שבעה קריאות מזו השבועית, ובמרבית מערכי השאילתות גם פי שבעה רעש סביב אותו אות.
שאר המאמר מחליף את ארבע ההנחות האלה במדידה, אחת לאחת.
איך השאילתות שלנו מתנהגות בפועל
שיטה: הנכס שלנו ב-Search Console, 90 יום המסתיימים ב-12 בספטמבר 2026, במימדים query ו-date, 8,020 שורות, מסוננות ל-106 שאילתות עם 30 חשיפות או יותר בתקופה. לכל שאילתה חישבנו את סטיית התקן של הדירוג היומי הממוצע, ואת שיעור הימים שבהם היא נשארה בטווח 3 מקומות מהחציון של עצמה.
מדד | ערך |
|---|---|
שאילתות במדגם | 106 |
חציון סטיית התקן של הדירוג היומי | 7.45 מקומות |
שאילתות עם סטיית תקן מתחת ל-2 מקומות | 12 מתוך 106 (11%) |
שאילתות עם סטיית תקן 10 ומעלה | 40 מתוך 106 (38%) |
חציון שיעור הימים בתוך 3 מקומות מהחציון של השאילתה עצמה | 59% |
קחו ארבע שאילתות מאותו מדגם, וההבדל בהתנהגות באותו אתר נראה כך.
שאילתה | חציון הדירוג | סטיית תקן | ימים בתוך 3 מהחציון |
|---|---|---|---|
amazon echo keywords | 14.1 | 1.29 | 100% |
on page seo audit | 92.2 | 4.99 | 63% |
perplexity seo checker | 31.9 | 12.87 | 22% |
geo | 70.4 | 9.83 | 30% |
הקריאה המעשית: שאילתות יציבות מספיק כדי שלכלל קבוע של 3 מקומות תהיה משמעות הן בערך אחת מעשר. ארבע מתוך עשר זזות מספיק כדי להתריע ללא הרף בכל סף שקטן מ-10 מקומות.
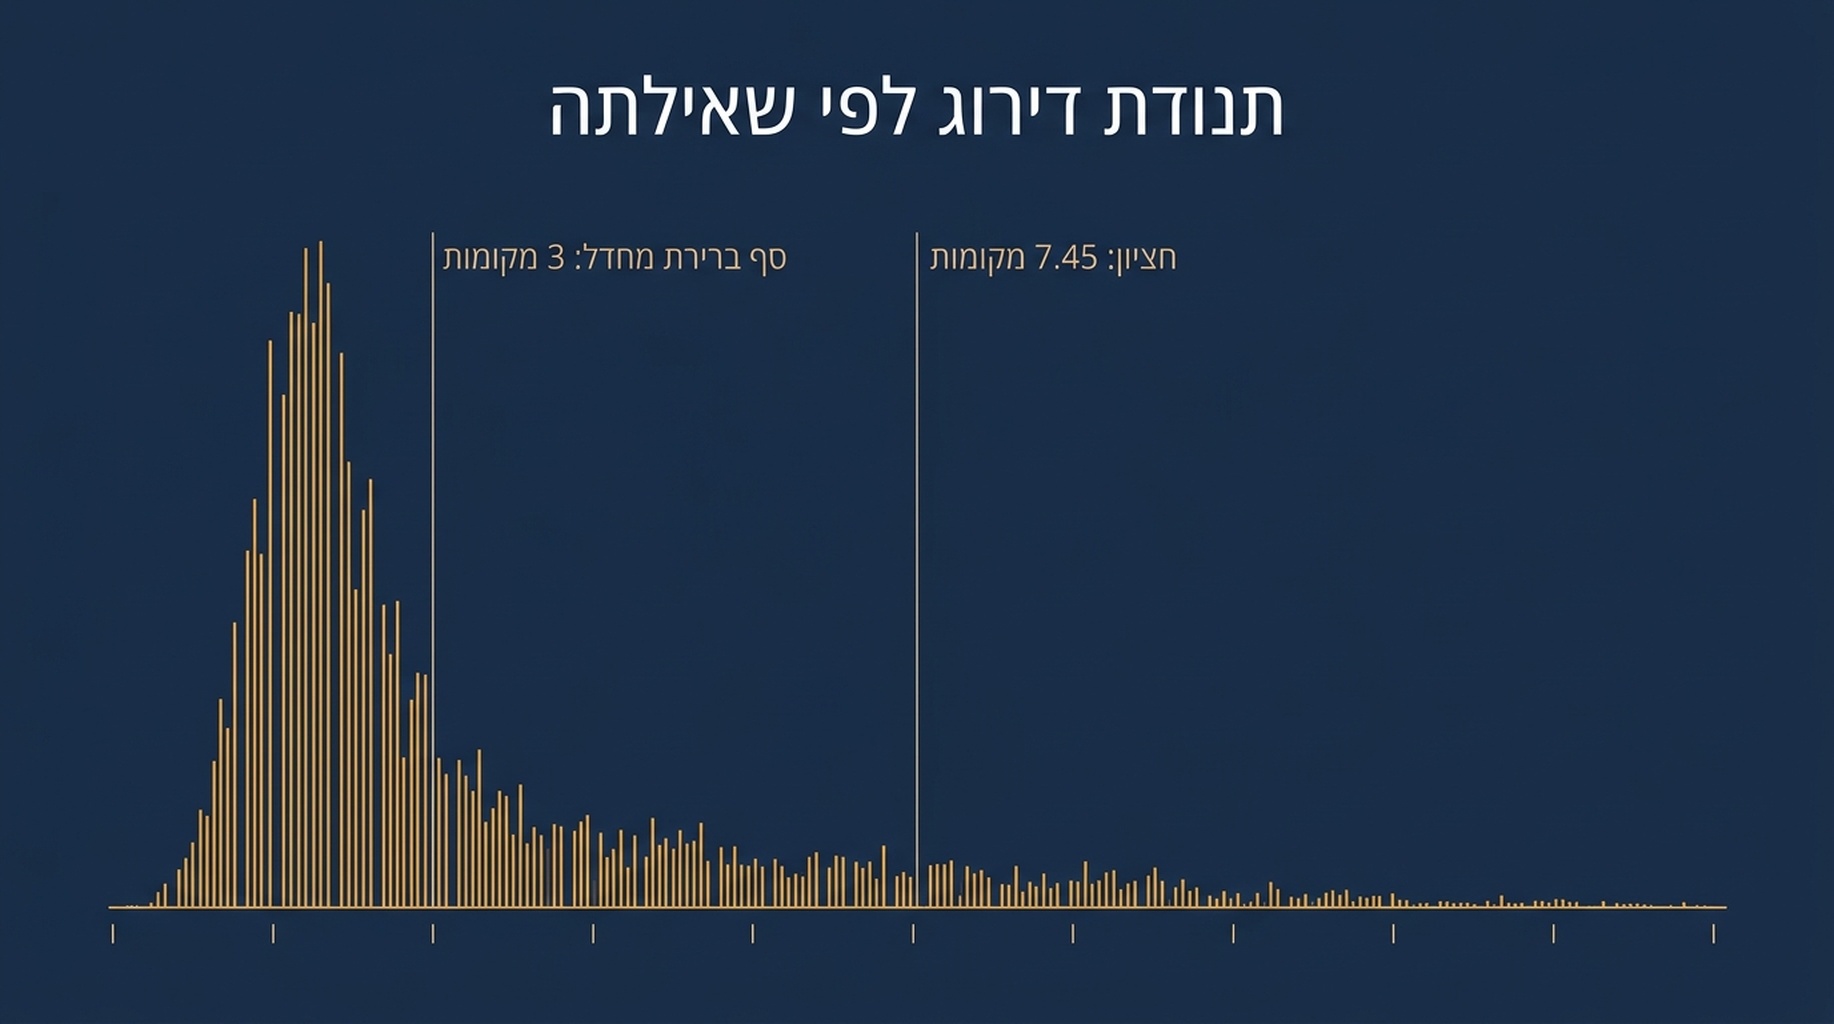
רוב השאילתות זזות הרבה יותר ממה שסף ההתראה המוגדר כברירת מחדל מניח.
כלל כיוול 1: בנו טווחים לכל שאילתה, לא לכל אתר
סף ברמת האתר הוא ממוצע של התנהגויות שאינן דומות זו לזו. הפתרון הוא לחשב את הטווח של כל שאילתה מההיסטוריה שלה עצמה, ולא נדרש לשם כך אלא ייצוא אחד מ-Search Console וכמה שורות חשבון.
לכל שאילתה השתמשו בהתפלגות שלה ולא במספר גלובלי.
- Normal: בתוך סטיית תקן אחת מהחציון של השאילתה עצמה.
- Watch: בין סטיית תקן אחת לשתיים, או כשהשאילתה יוצאת מהטווח האמצעי של 80% של עצמה.
- Investigate: מעבר לשתי סטיות תקן, ובאישור בהרצה שנייה ברציפות.
במדגם שלמעלה זה משנה את נפח ההתראות באופן דרמטי. שאילתה עם סטיית תקן 1.29 צריכה תנועה של כ-3 מקומות כדי להגיע לטווח המעקב. שאילתה עם סטיית תקן 12.87 צריכה כ-13, כך שכמעט לא ייצא ממנה התראה עד שמשהו אמיתי קורה.
זה אותו היגיון שבו משתמש מדריך תכנון טווחי ההתראה לניטור מתוזמן, מיושם ברמת השאילתה ולא ברמת החשבון. ואם תשנו דבר אחד אחרי קריאת המאמר הזה, הפכו את הסף מקבוע לערך לכל שאילתה.
כלל כיוול 2: קבעו רצפת חשיפות מינימלית
דירוג הוא ממוצע, וממוצע של 3 חשיפות אינו מדידה. ומתחת לכ-30 חשיפות בתקופה, מדגם הבסיס קטן כל כך שהמספר זז מעצמו.
מכאן נובעות שתי מסקנות, ושתיהן פשוטות למימוש.
אל תתריעו על שאילתות עם חשיפה נמוכה. עקבו אחריהן, אבל התייחסו לדירוג כהקשר ולא כאות. היוצא מן הכלל הוא שאילתה שצוברת נפח בפתאומיות — זה ארוע חשיפה שראוי לדעת עליו בפני עצמו.
הצמידו חשיפות לכל דירוג. ירידה של 5 מקומות כשהחשיפות יציבות שונה במשמעותה מירידה של 5 מקומות כשנעלמו 60% מהחשיפות. השנייה קרובה יותר לבעיית אינדוקס או כשירות, הראשונה קרובה יותר לתחרות. מנטר שמדווח על דירוג בלבד משליך את ההבחנה הזו, וזה בדיוק מצב הכשל שפירוק התנודתיות נועד לאתר.
כלל כיוול 3: הפרידו מכשיר ומיקום לפני ההתראה
דירוג משוקלל הוא ממוצע משוקלל של תוצאות לפי מכשיר ולפי אזור. כשהמשקלים משתנים, הממוצע זז בלי שקרה משהו לדף. מדדנו פער של עד 11 מקומות בין מכשיר לנייח באותה שאילתה, כך שזה אינו שגיאת עיגול — זה באותו סדר גודל של הרעש שאתם מנסים לזהות.
המימוש אינו נוצץ וזול: משכו דירוג לכל מכשיר, שמרו את שניהם, והתריעו על המכשיר שבו אירעה התנועה. ואם אתם עוקבים אחרי מספר משוקלל אחד, כתבו את משקלי המכשירים בפלט כדי ששינוי בהרכב יהיה גלוי ולא משוער. וצורת השאילתה מוסברת בפירוק לפי מכשיר.
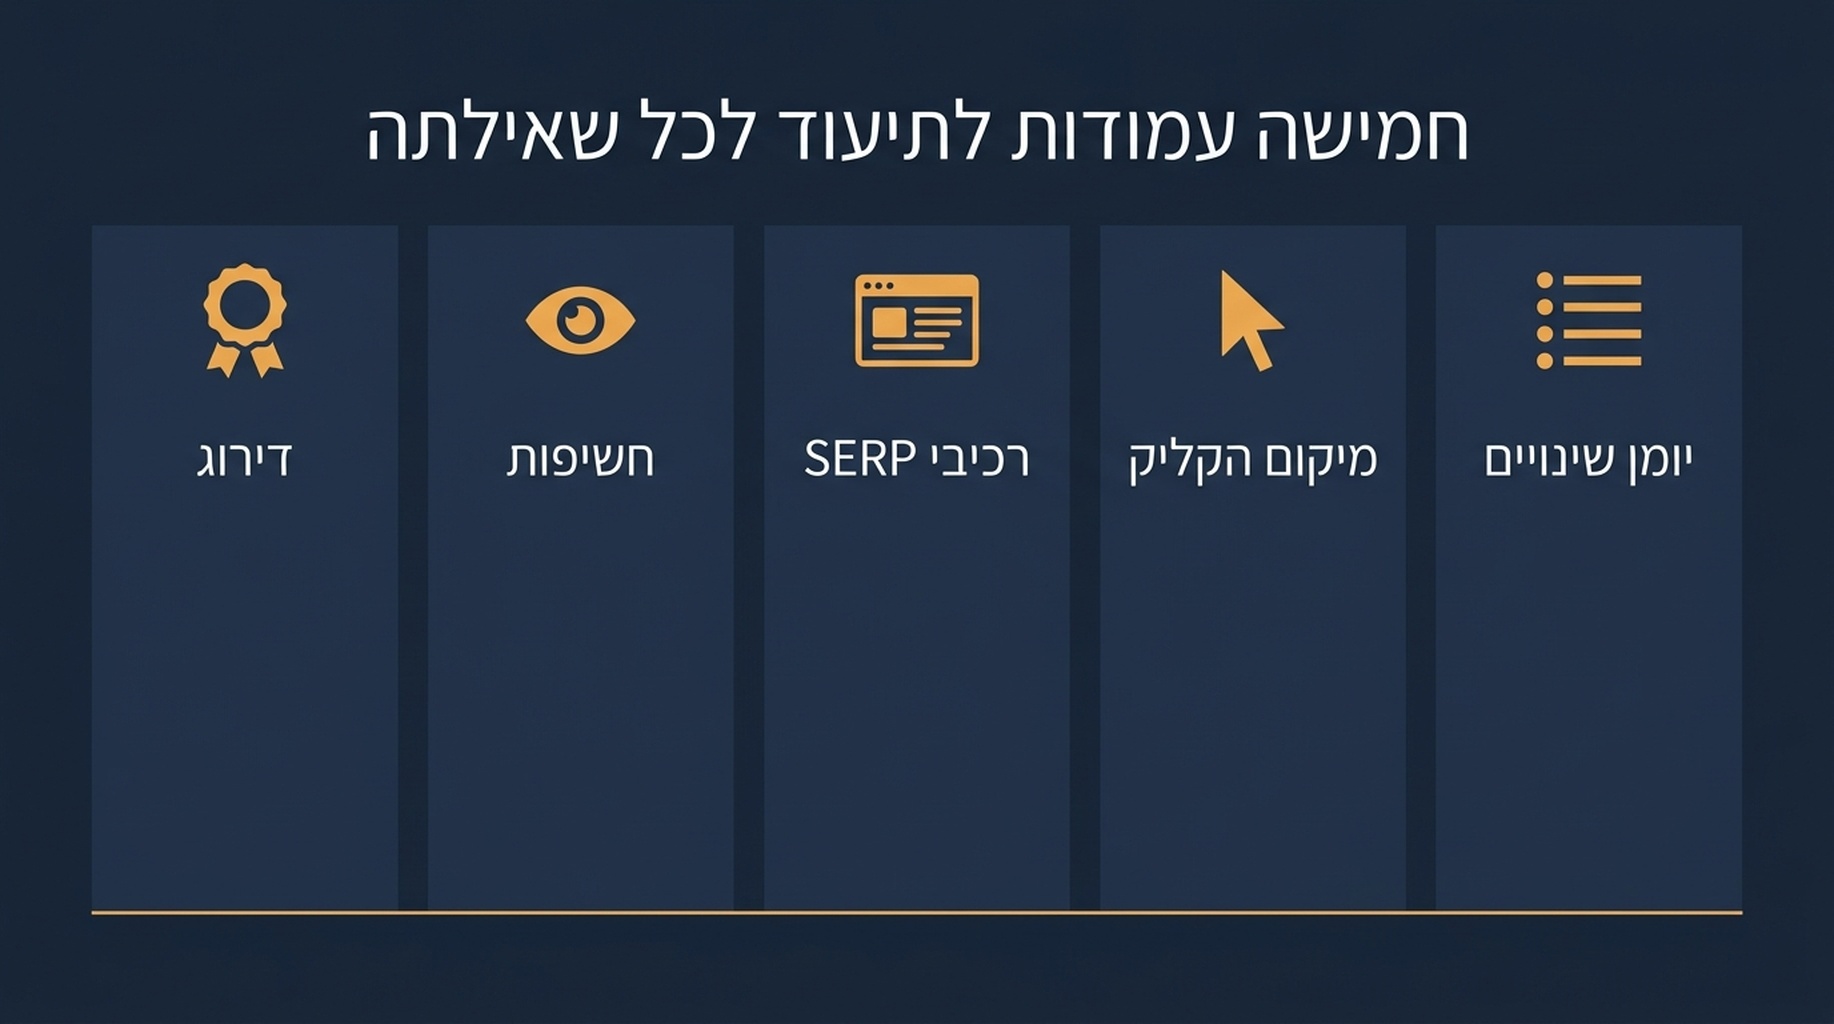
חמישה שדות הופכים התראה לחקירה שיש לה נקודת התחלה.
מה כדאי לנטר מלבד הדירוג
דירוג הוא עמודה אחת בלבד. ארבעה אחרים הם שקובעים אם תנועה ראויה לתשומת לב אנושית.
חשיפות. צד הביקוש. כשזה זז, משמעותם של כל מספרי הדירוג משתנה.
מצב תכונות SERP. אם יש בשאילתה הזו AI Overview, בלוק וידאו או חבילה מקומית. שינוי בתכונות מזיז דירוג בלי שום שינוי בדף.
מיקום על עקומת הקליקים. לא רק היכן אתם ברשימה, אלא היכן אתם ביחס לתכונות. מקום 1 מתחת ל-AI Overview אינו מקום 1. ואם תרצו לעקוב אחרי מצב התכונות כראוי, השדות שכדאי לשמור מוסברים בבניית מנטר AI Overview.
רשומת שינויים. הפרסומים שלכם, שינויי תבנית ועריכות תוכן על אותו ציר זמן. ברוב הירידות האמיתיות שחקרנו עמד קומיט מאחוריהן.
שמרו את החמישה האלה לכל שאילתה ולכל יום, וההתראה תהפוך מחקירה שיש לה נקודת התחלה — במקום מספר שנראה מדאיג ואדם שצריך לשחזר את השבוע ההוא מהזיכרון.
חשבו את הקצב לפני שמתחייבים
עלות הניטור גדלה במספר המילים כפול מספר הבדיקות, ולכן הקצב נקבע ממספר השאילתות ולא מהתלהבות.
- בדיקה יומית של 30 שאילתות חשובות היא 900 בקשות בחודש. את זה כמעט כל תוכנית סופגת, ורוב הצוותים צריכים להתחיל כאן.
- בדיקה יומית של 200 שאילתות היא 6,000 בקשות בחודש, ובמערכים תנודתיים היא מייצרת את רוב ההתראות מהרעש.
- אותה בדיקה של 200 השאילתות על בסיס שבועי היא כ-1,400 בקשות בחודש, והיא תופסת את רוב התנועות האמיתיות, כי שינוי אמיתי נמשך יותר משבוע.
ואם צריך את שניהם, חלקו לפי גובה ההימור ולא לפי העדפה: רשימה קצרה שקושרה ישירות להכנסה — יומית, והשאר — שבועית. ואם אתם בונים את המשיכה בעצמכם, המנטר הדו-מקורי מסביר את צורת הבקשות ואת כללי ההשוואה.
רשימת הבדיקה לפני שסומכים על מנטר כלשהו
חמש שאלות. ומנטר שנכשל באחת מהן גובה יותר קשב משהוא חוסך.
- האם הוא שומר תוצאות גולמיות או רק דירוג מחושב? אם לא תוכלו לשאול אותו אחר כך מה עוד הופיע בדף, לא תוכלו להסביר את ההתראה.
- האם האזור והמכשיר קבועים ומתועדים לכל שאילתה? אחרת ההיסטוריה מערבבת תנאים שונים.
- האם הסף הוא לכל שאילתה או מספר אחד לכל החשבון? מספר אחד הוא ברירת מחדל, לא כיוול.
- האם הוא מבחין בין תקלה לירידה? Google מפרסמת לוח מצב עם היסטוריית תקלות, והבטה בו קודם זולה מכל חקירה.
- האם הוא מספר לכם מה השתנה, או רק שמשהו השתנה? התראה מהסוג השני היא רשימת מטלות; הראשונה היא שיפוט.
עמדת Auspia: ערכו של מנטר דירוג שווה לאיכות הכיוול שלו. סף ברירת המחדל של 3 מקומות שגוי לא מפני שהכלים עצלים, אלא מפני שהוא ממוצע אוכלוסייה שמוחל על שאילתות בודדות. מדדו את השאילתות שלכם וקבעו טווחים מההתפלגות של כל אחת, ומה שיישאר מההתראות הוא מה שאכן תפעלו לפיו.
שאלות נפוצות
כמה תנודת דירוג רגילה מנטר דירוג של Google צריך להתעלם ממנה? אין מספר אוניברסלי, וזו בדיוק הנקודה. במדגם שלנו השאילתה החציונית זזה 7.45 מקומות ב-90 יום, בעוד אחת מעשר נשארה בתוך שני מקומות. הסף הנכון נגזר מההיסטוריה של כל שאילתה, ובדרך כלל הוא סטיית תקן אחת.
באיזו תדירות מנטר דירוג צריך לבדוק דירוגים? מערכים רגילים — שבועית, ורשימות קצרות הקשורות ישירות להכנסה — יומית. בדיקה יומית של מערך גדול מכפילה את העלות ותופסת בעיקר רעש, כי שינוי דירוג אמיתי נמשך יותר מיום.
למה המנטר מציג תנודות יומיות שלא מופיעות ב-Search Console? מפני שאלה שתי מדידות שונות. המנטר מצלם פעם אחת עמוד תוצאות אמיתי בזמן נתון ובאזור נתון. Search Console ממצע חשיפות על פני טווח תאריכים והרכב מכשירים. אף אחד מהם אינו טועה, והשוואה ישירה ביניהם תגרום לכם לרדוף אחרי ירידה שקיימת רק באחד הצדדים.
האם כדאי לנטר כל מילה שיש לה דירוג? לא. נטרו שאילתות שיש להן מספיק חשיפות כדי למדוד. בנתונים שלנו אלה היו 106 מתוך אלפים. את אלה שמתחת לרצפת החשיפות עדיף לעקוב כקבוצה, למשל בספירת כמה שאילתות בכלל מדורגות, ולא בהתראה נפרדת לכל אחת.
האם כיוול מנטר דורש כלי בתשלום? לא. ייצוא אחד מ-Search Console עם המימדים query ו-date מספיק כדי לחשב חציון וסטיית תקן לכל שאילתה, וזה כל מה שהכיוול דורש. כלים בתשלום מוסיפים נוחות ונתונים חוצי-ספקים, לא סטטיסטיקה.
מחבר/ת: Miles Carter, ניתוח נתוני דירוג של 8,000 שאילתות ב-Auspia. כותב/ת על מדידת דירוג, כיוול התראות, ואיך להבדיל בין שינוי בנתונים לשינוי בתוצאות החיפוש.